
Lộ trình
Dãy thời gian trong Python
20 giờ
Huấn luyện một mô hình máy học cho chuỗi thời gian không hề đơn giản; nó khá khác so với các bài toán phân loại hay hồi quy truyền thống. Bạn cần tạo các cửa sổ và độ trễ (lags) để sinh đặc trưng mới từ dữ liệu hiện có, và ngay cả khi đó, mô hình vẫn có thể không hoạt động tốt. Không chỉ các mô hình hồi quy tuyến tính gặp khó, ngay cả các mô hình học sâu như LSTM và GRU cũng có thể cho kết quả kém khi dự báo thị trường chứng khoán.
Chúng ta có cần một mô hình giống GPT-4o dành cho chuỗi thời gian, hoạt động tốt trên mọi loại tập dữ liệu không? Chắc chắn là có. TimeGPT là một mô hình nền tảng tối tân có khả năng dự báo ngay cả trên các tập dữ liệu chưa từng thấy.
Trong hướng dẫn này, chúng ta sẽ khám phá kiến trúc của TimeGPT, cách nó được huấn luyện và các benchmark. Bên cạnh đó, chúng ta sẽ học cách sử dụng API Nixtla để truy cập mô hình TimeGPT nhằm dự báo, phát hiện bất thường, trực quan hóa chuỗi thời gian và đánh giá mô hình.
Hình ảnh bởi Tác giả | Canva
TimeGPT-1 là một mô hình chuỗi thời gian dựa trên Transformer với cơ chế tự tập trung (self-attention) mà bạn có thể truy cập thông qua API Nixtla. Đây là mô hình nền tảng đầu tiên cho các tập dữ liệu chuỗi thời gian, cho độ chính xác khá tốt trên dữ liệu chưa từng thấy. Tất cả những gì bạn cần làm là fine-tune trên tập dữ liệu của mình, và chỉ trong vài giây, nó sẽ cho hiệu năng hàng đầu.
Kiến trúc TimeGPT gồm cấu trúc encoder-decoder với nhiều tầng, mỗi tầng có kết nối dư (residual) và chuẩn hóa tầng (layer normalization). Lớp đầu ra là tuyến tính và ánh xạ đầu ra của decoder tới kích thước cửa sổ dự báo.
Mô hình được huấn luyện trên bộ sưu tập dữ liệu chuỗi thời gian công khai lớn nhất, đồng nghĩa nó có thể dự báo tập dữ liệu chưa từng thấy mà không cần huấn luyện lại. Để tạo dự báo, TimeGPT lấy một cửa sổ các giá trị trước đó và thêm bộ mã hóa vị trí cục bộ để tăng cường đầu vào.
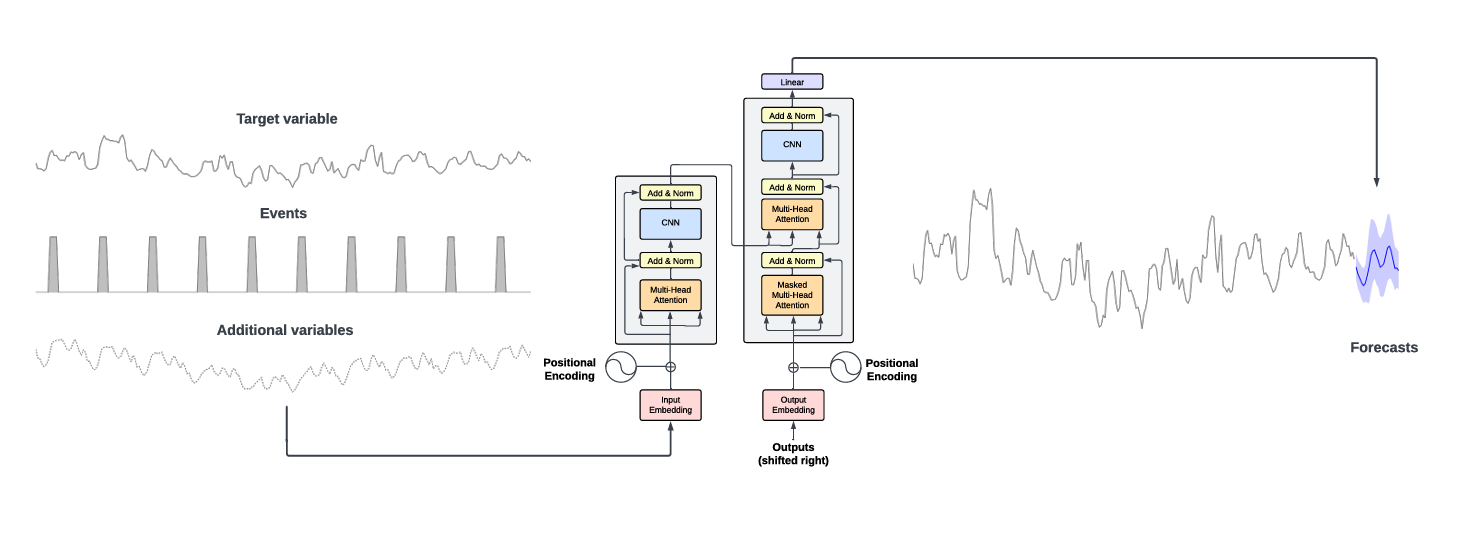
Nguồn: 2310.03589 (arxiv.org) | TimeGPT lấy các giá trị lịch sử của biến mục tiêu và các biến ngoại sinh bổ sung làm đầu vào để tạo ra dự báo.
Mô hình TimeGPT vượt trội hơn các phương pháp thống kê, máy học và học sâu đã có, thể hiện khả năng suy luận zero-shot, hiệu quả và đơn giản vượt trội. Như thể hiện trong benchmark dưới đây, TimeGPT nổi bật trên nhiều thước đo máy học ngay cả khi không cần kỹ thuật đặc trưng.
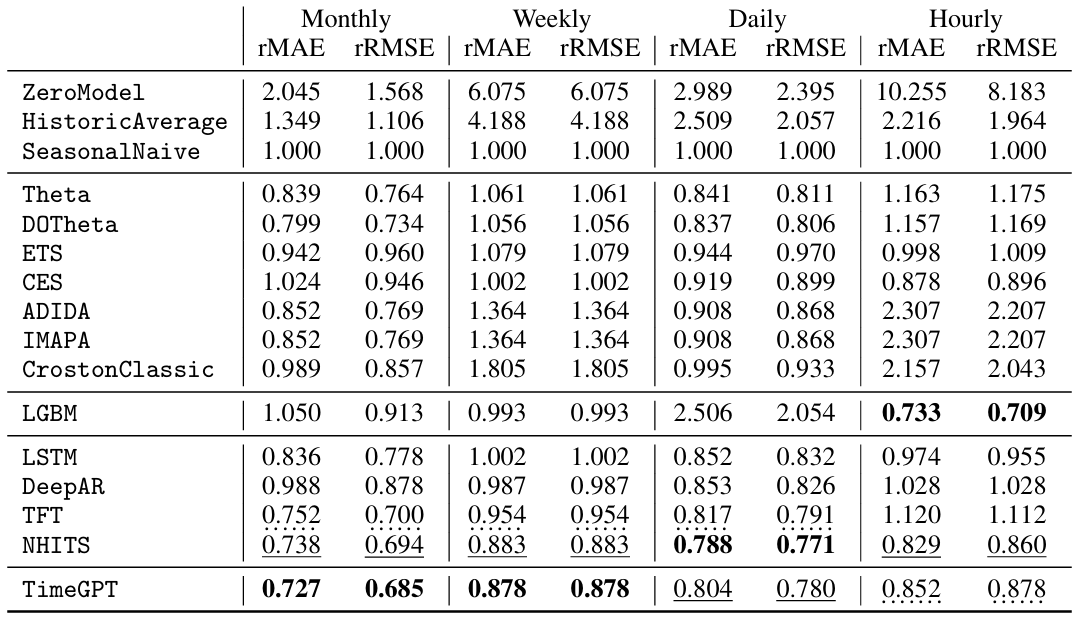
Nguồn: 2310.03589 (arxiv.org) | Các mô hình benchmark đo bằng rMAE và rRMSE, điểm thấp hơn là tốt hơn.
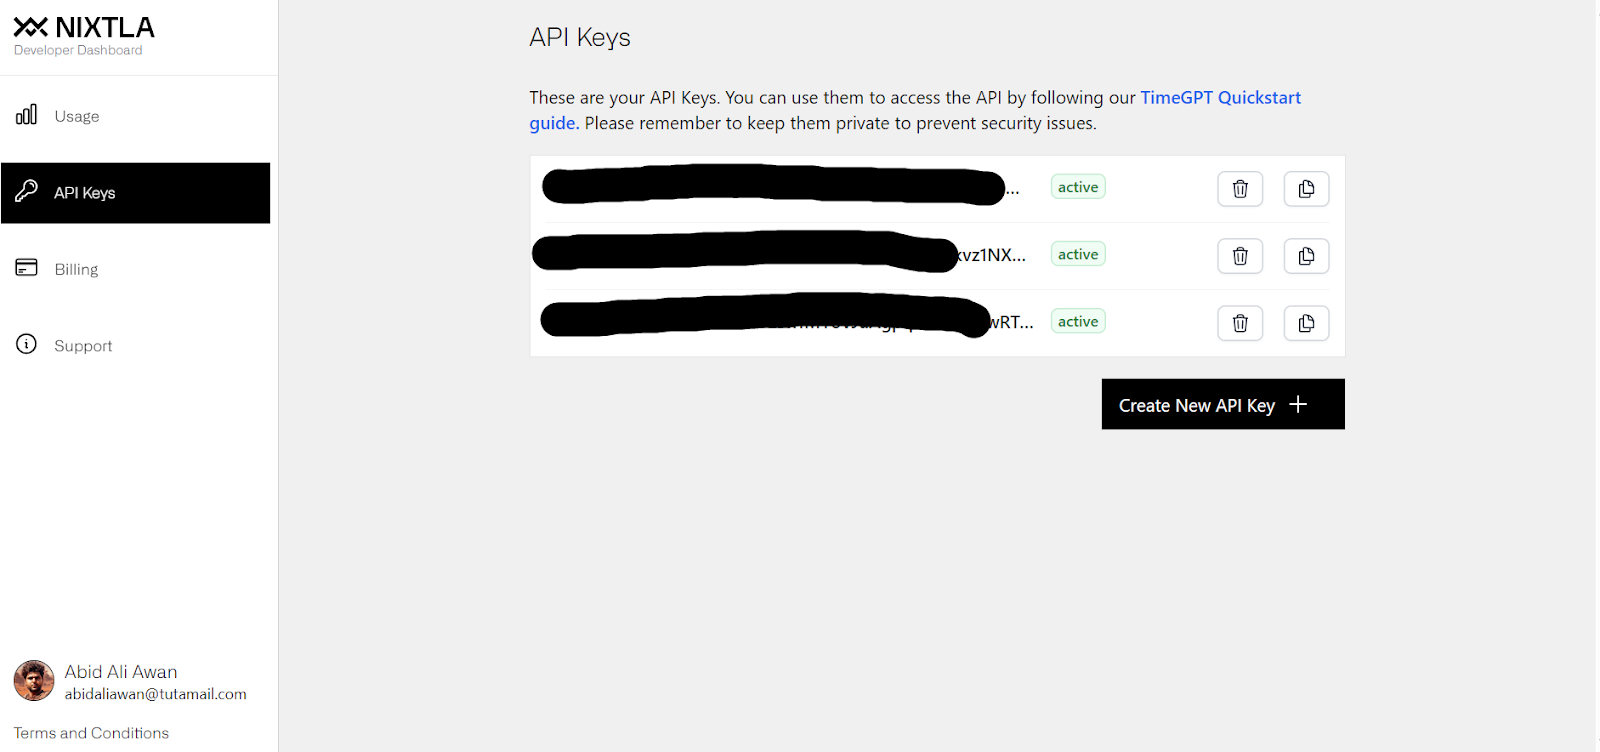
Mô hình TimeGPT không phải mã nguồn mở, và bạn chỉ có thể truy cập thông qua API Nixtla. Phần này sẽ hướng dẫn bạn thiết lập API Nixtla để truy cập mô hình TimeGPT và dự báo dữ liệu cổ phiếu Amazon.
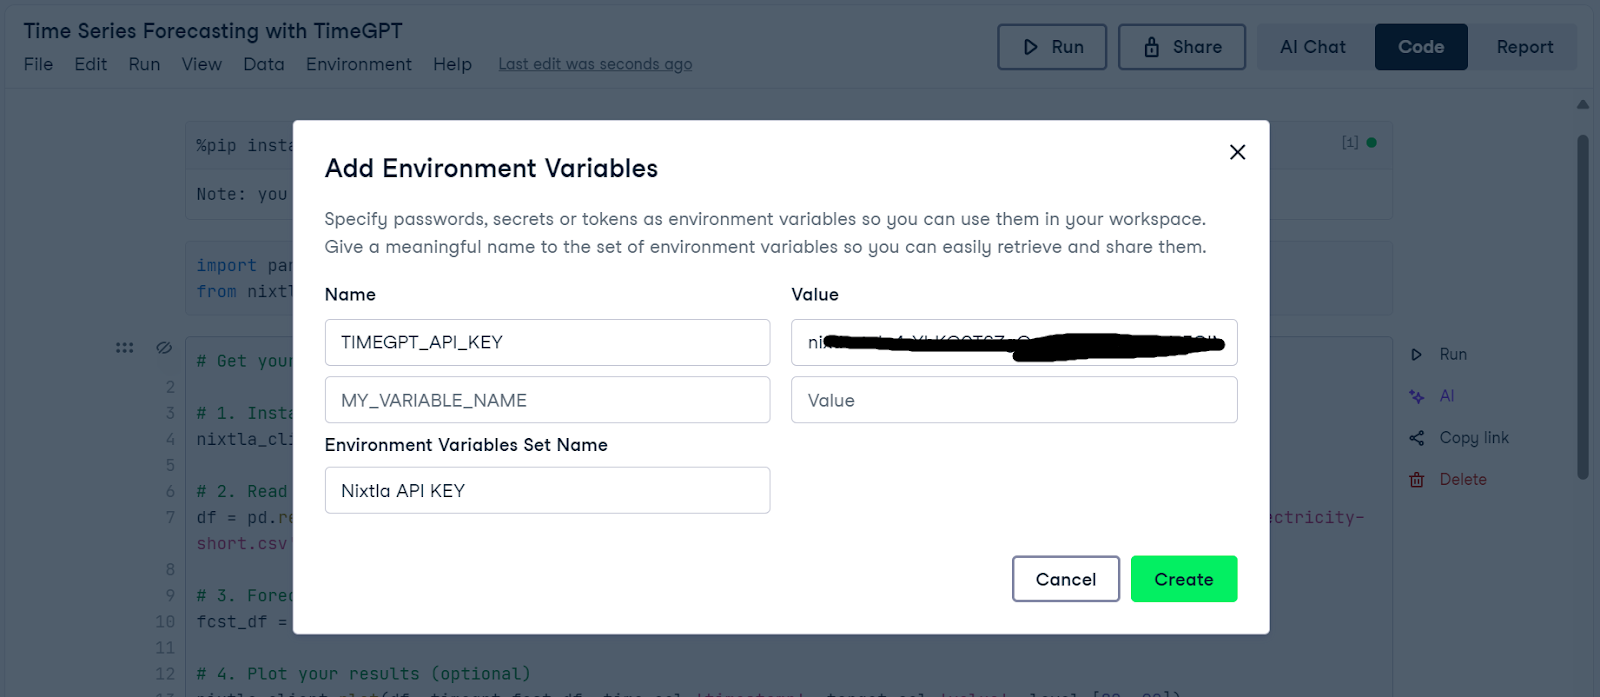
%%capture
%pip install nixtla>=0.5.1
%pip install yfinanceimport pandas as pd
import yfinance as yf
from nixtla import NixtlaClient
import os
timegpt_api_key = os.environ["TIMEGPT_API_KEY"]
# Setup NixtlaClient
nixtla_client = NixtlaClient(api_key = timegpt_api_key)
# Downloading Amazon stock price data
ticker = 'AMZN'
amazon_stock_data = yf.download(ticker)
amazon_stock_data = amazon_stock_data.reset_index()
# Displaying the dataset
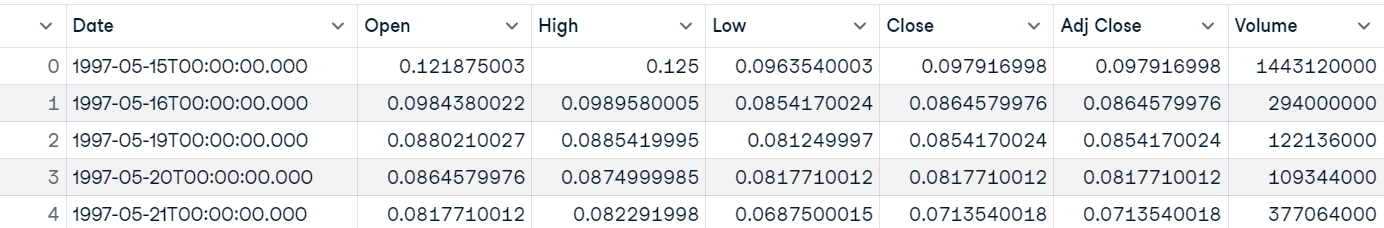
amazon_stock_data.head()Chúng ta có dữ liệu giá cổ phiếu Amazon từ năm 1997 đến hiện tại.
nixtla_client.plot(amazon_stock_data, time_col='Date', target_col='Close')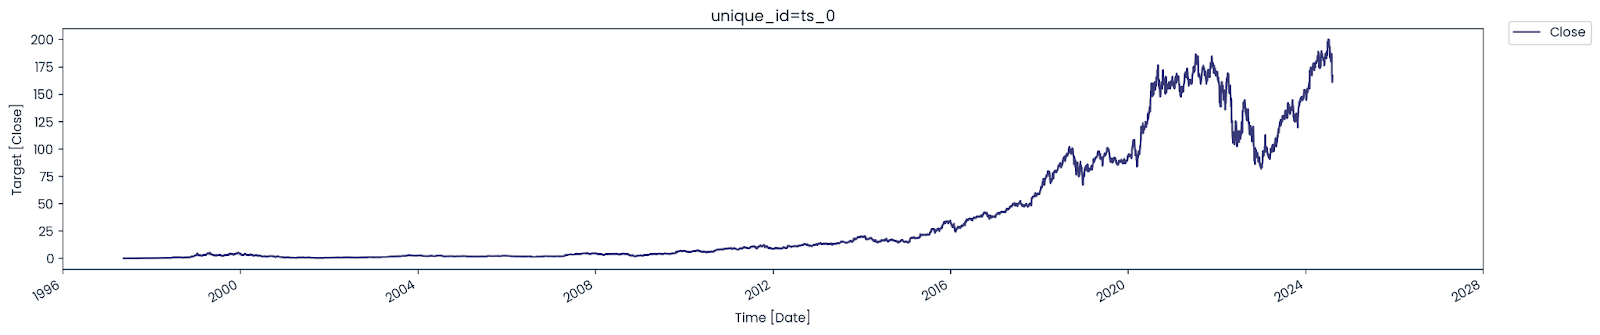
Khám phá cách tạo biểu đồ đường chuỗi thời gian bằng Matplotlib qua hướng dẫn Matplotlib Time Series Line Plot này.
.forecast dữ liệu cổ phiếu, tên mô hình, chân trời dự báo (tương đương 24 ngày), tần suất, cột thời gian và cột mục tiêu. Vì sàn chứng khoán đóng cửa cuối tuần, chúng ta chọn tần suất "ngày làm việc (B)".model = nixtla_client.forecast(
df=amazon_stock_data,
model="timegpt-1",
h=24,
freq="B",
time_col="Date",
target_col="Close",
)
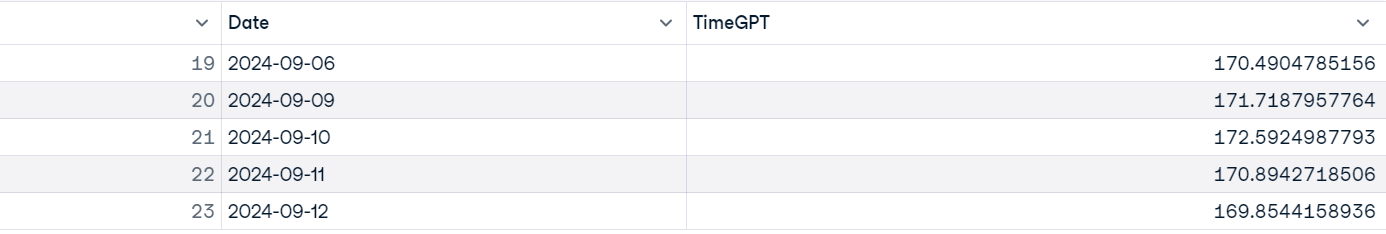
model.tail()
nixtla_client.plot(
    amazon_stock_data,
    model,
    time_col="Date",
    target_col="Close",
    max_insample_length=60,
)
Như ta thấy, chỉ trong vài giây, mô hình TimeGPT đã dự đoán khá chính xác giá đóng cửa của Amazon trong tương lai.
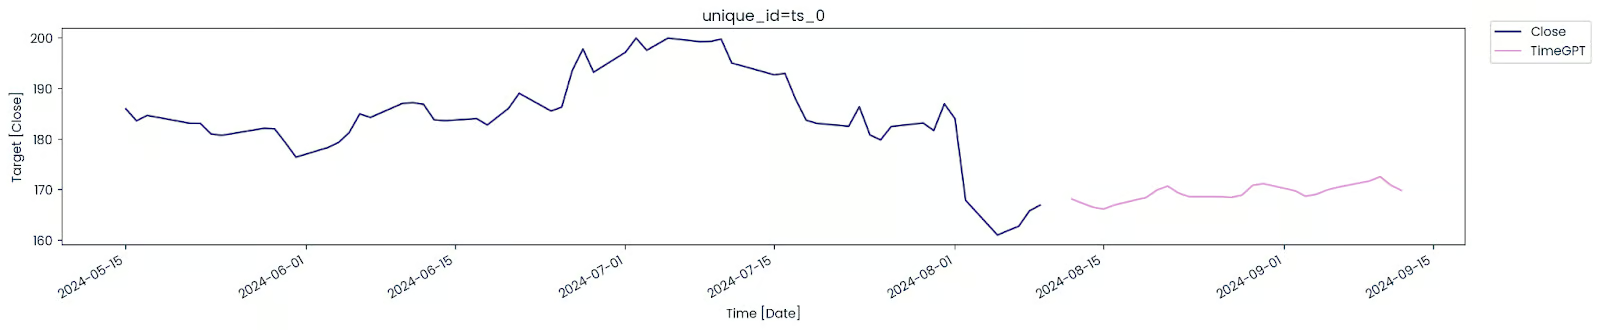
Đây là ví dụ cho người mới bắt đầu. Ở phần tiếp theo, chúng ta sẽ làm việc với tập dữ liệu phức tạp hơn và khám phá nhiều tính năng của API Nixtla.
Trong phần này, chúng ta sẽ sử dụng tập dữ liệu phức tạp hơn về Nhu cầu điện của Úc và sử dụng mô hình TimeGPT để dự báo nhiều giá trị cùng lúc.
Tập dữ liệu gồm 5 chuỗi thời gian đại diện cho nhu cầu điện mỗi nửa giờ của 5 bang ở Úc: Victoria, New South Wales, Queensland, Tasmania và Nam Úc.
Chúng ta cũng sẽ học cách fine-tune mô hình và sử dụng các siêu tham số để nâng cao hiệu năng. Cuối cùng, chúng ta sẽ thực hiện cross-validation và so sánh hiệu năng mô hình với các mô hình truyền thống để có đánh giá toàn diện.
Không có cách đơn giản để tải tệp .tsf trong thư viện pandas. Chúng ta phải tự viết hàm tùy biến để tải và xử lý dữ liệu rồi chuyển thành dataframe Pandas.
import pandas as pd


def read_tsf_from_file(file_path):
    data = []
    start_date = pd.to_datetime("2002-01-01 00:00:00")

    # Open and read the file from the directory

    with open(file_path, "r") as file:
        for line in file:
            if line.startswith("T"):
                parts = line.strip().split(":")
                unique_id = parts[0] + "-" + parts[1]
                values = list(map(float, parts[3].split(",")[:-1]))

                # Generate datetime index at half-hour intervals

                periods = len(values)
                date_range = pd.date_range(
                    start=start_date, periods=periods, freq="30min"
                )

                # Append to data list

                for dt, value in zip(date_range, values):
                    data.append([unique_id, dt, value])
    # Convert the list of data into a DataFrame

    return pd.DataFrame(data, columns=["unique_id", "ds", "y"])


# Example usage

file_path = "australian_electricity_demand_dataset.tsf"
demand_df = read_tsf_from_file(file_path)

# Display the dataframe

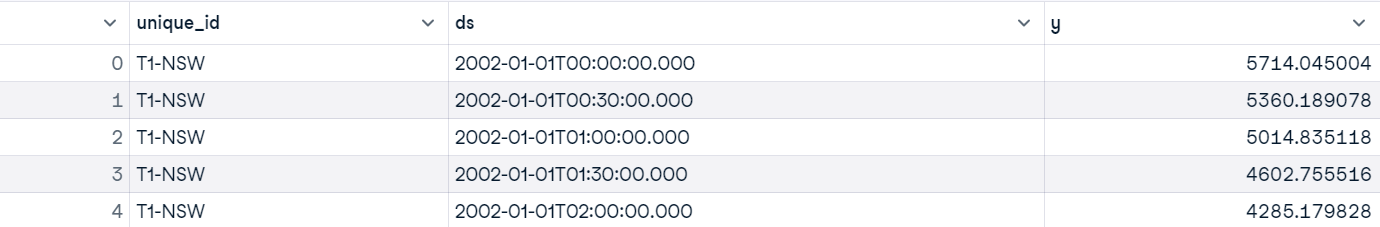
demand_df.head()
Tập dữ liệu của chúng ta có ba cột:
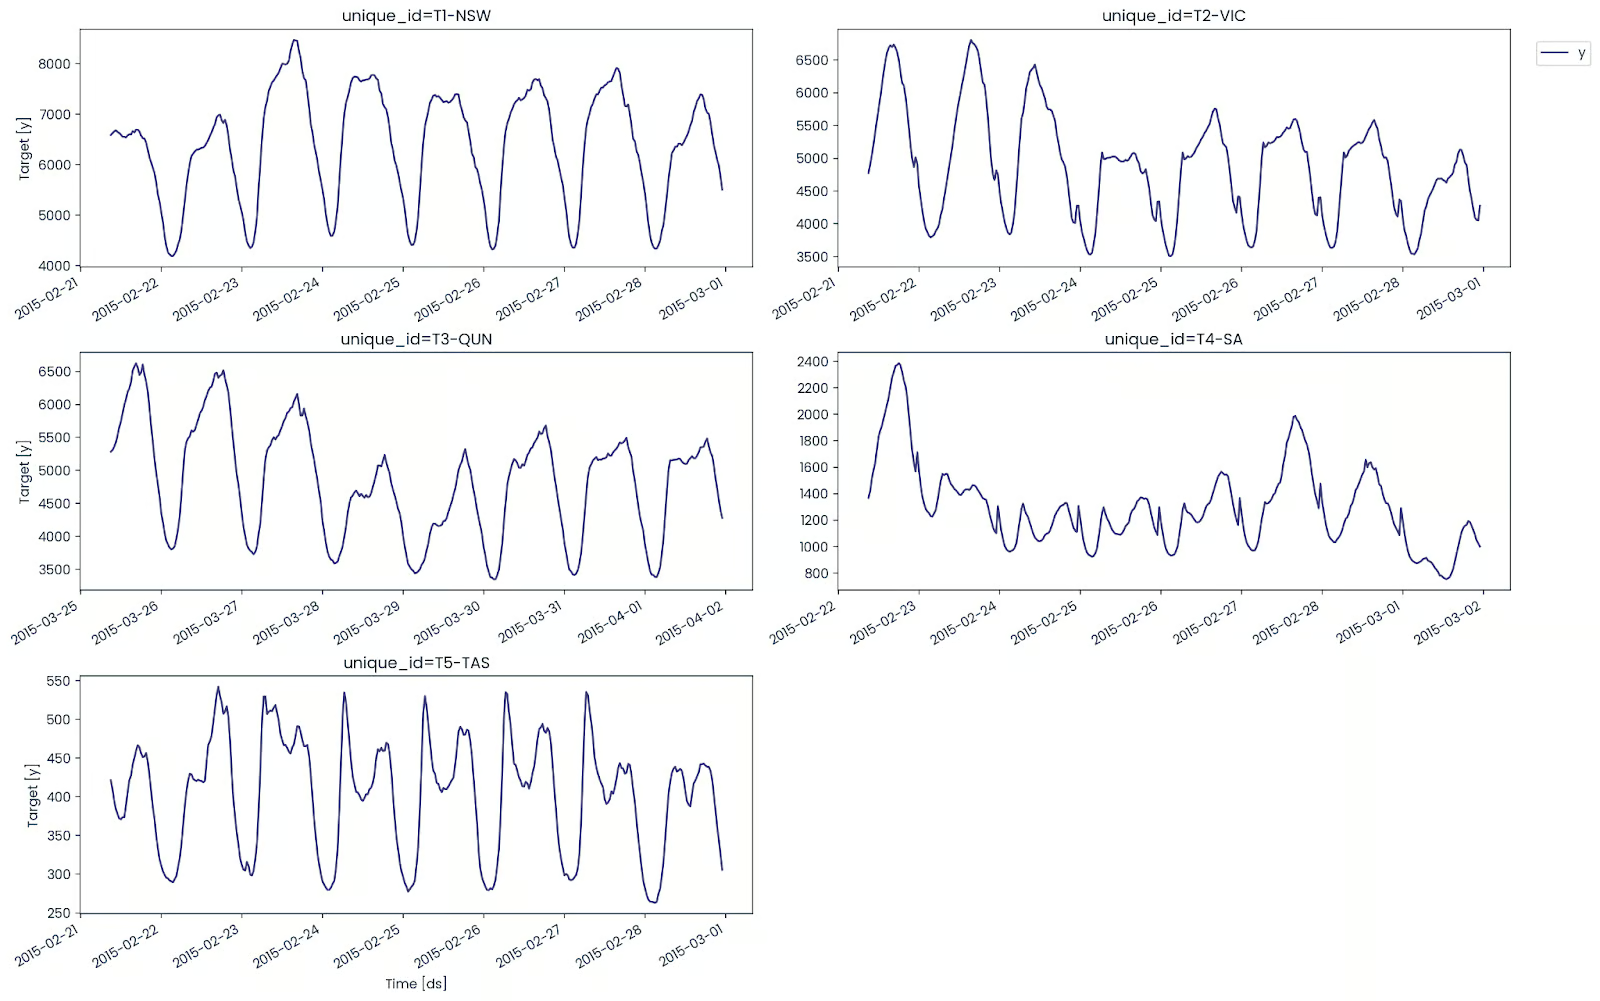
Hàm plot rất tiện lợi vì tự động nhận diện cột unique_id và tạo năm biểu đồ chuỗi thời gian khác nhau.
nixtla_client.plot(
    demand_df,
    max_insample_length=365,
)
Biểu đồ dưới đây hiển thị mức tiêu thụ điện của 5 bang, và tất cả đều có các mẫu hình khác nhau.
Học phân tích chuỗi thời gian bằng cách tham gia phiên code-along trực tiếp trên DataCamp, nơi bạn sẽ đào sâu vào các tập dữ liệu tài chính bằng Python.
Trong phiên này, chúng ta sẽ khám phá nhiều cổ phiếu, trực quan hóa hiệu suất của chúng và thực hiện dự báo bằng các mô hình khác nhau.
Trước khi dự báo, chúng ta sẽ xác định các bất thường trong tập dữ liệu để hiểu rõ bài toán hơn.
Hàm .detect_anomalies nhận tập dữ liệu, cột thời gian và cột mục tiêu, và tần suất.
# Detect anomalies
anomalies_df = nixtla_client.detect_anomalies(
    demand_df,
    time_col='ds',
    target_col='y',
    freq='H',
)
anomalies_df[anomalies_df["anomaly"]==1].head()
Chúng ta đã hiển thị tất cả các trường hợp phát hiện bất thường.
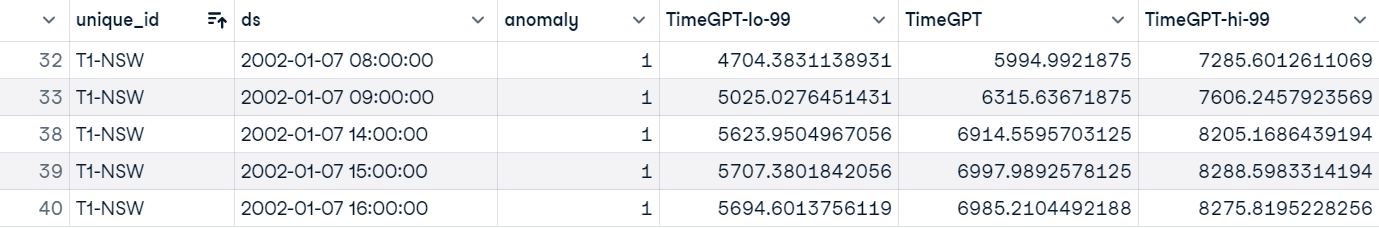
Tổng số bất thường trong cả 5 chuỗi thời gian là 17.316, con số khá lớn.
anomalies_df.anomaly.value_counts()
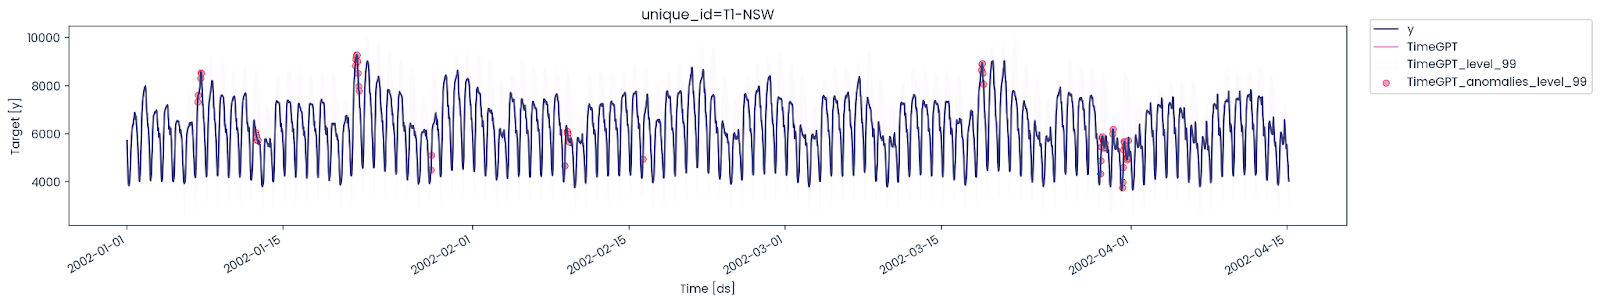
Bây giờ, chúng ta sẽ vẽ các điểm bất thường trên dữ liệu thực tế để xem chúng xảy ra ở đâu và tần suất ra sao theo ngày. Để đơn giản hóa, ta chỉ hiển thị 5.000 mẫu từ New South Wales.
# Plot anomalies
nixtla_client.plot(
    demand_df[demand_df["unique_id"]=="T1-NSW"][0:5000],
    anomalies_df[anomalies_df["unique_id"]=="T1-NSW"][0:5000],
    time_col='ds',
    target_col='y',

)
Các bất thường theo ngày không phổ biến, nhưng có những ngày nhiều bất thường xảy ra trong cùng một ngày.
Giờ chúng ta sẽ dự báo nhu cầu điện của New South Wales. Để làm vậy, ta lọc chỉ các giá trị cho "T1-NSW".
T1_df = demand_df[demand_df["unique_id"]=="T1-NSW"]
T1_df.head()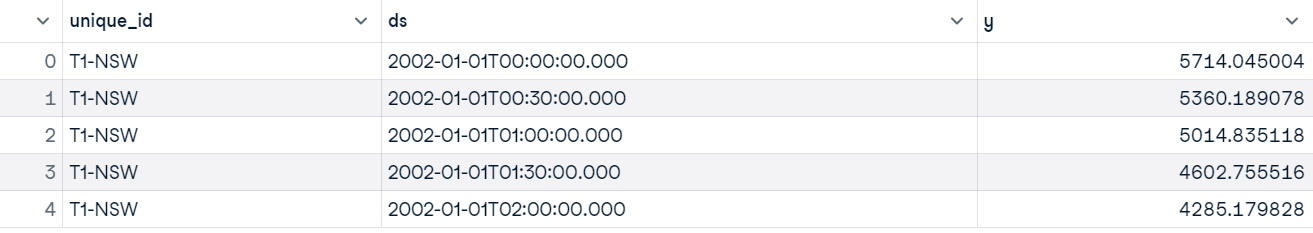
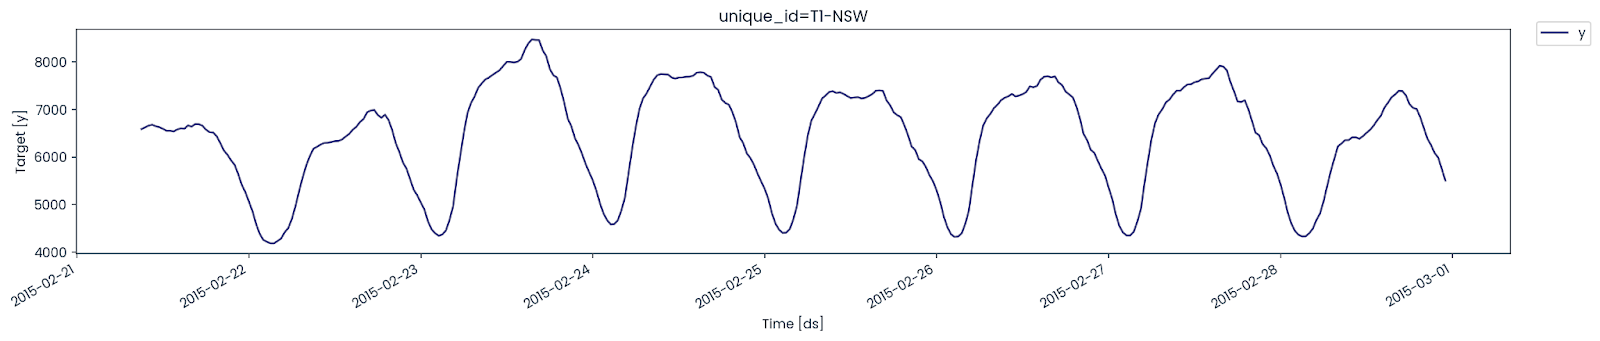
Vẽ 365 giá trị gần nhất để hiểu mẫu hình tiêu thụ điện.
nixtla_client.plot(
    T1_df,
    max_insample_length=365,
)
Giờ chúng ta sẽ đánh giá hiệu năng mô hình. Để làm vậy, cần chia tập dữ liệu thành tập huấn luyện và kiểm tra.
Tập huấn luyện gồm 144 giá trị, tương đương 3 ngày, và tập kiểm tra gồm 1200 giá trị, tương đương 25 ngày.
test_df = T1_df.tail(144) # 3 days = (144 * 0.5h *  1 day/24h)
train_df = T1_df.iloc[-1344:-144] # 25 days = (1200 *0.5h * 1 day/24h)
Để dự báo, chúng ta sẽ chọn một mô hình tốt hơn và đặt các tham số để cải thiện hiệu năng, cụ thể:
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],  # Generate a 90% confidence interval
    finetune_steps=60,  # Specify the number of steps for fine-tuning
    finetune_loss="mae",  # Use the MAE as the loss function for fine-tuning
    model="timegpt-1-long-horizon",  # Use the model for long-horizon forecasting
    time_col="ds",
    target_col="y",
)
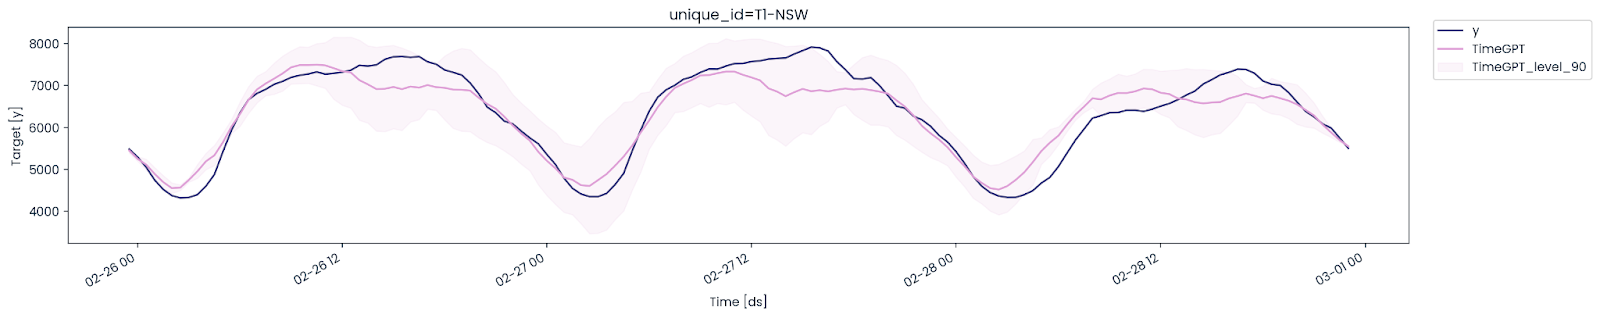
Vẽ dữ liệu thực tế, dự báo và khoảng tin cậy 90 phần trăm để đánh giá hiệu năng mô hình.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Chỉ trong vài giây, chúng ta đã có kết quả khá chính xác. Đó là sức mạnh của các mô hình tiền huấn luyện.
Bây giờ chúng ta sẽ đánh giá hiệu năng mô hình bằng thư viện UtilsForecast, một phần của dự án mã nguồn mở Nixtla. Để làm vậy, chúng ta sẽ gộp tập kiểm tra và dự báo rồi truyền vào hàm evaluate. Hàm nhận tập dữ liệu, các thước đo, mô hình, cột mục tiêu và ID duy nhất để tính toán và hiển thị các chỉ số dưới dạng dataframe pandas.
from utilsforecast.losses import mae, rmse, smape
from utilsforecast.evaluation import evaluate

predict_df["ds"] = pd.to_datetime(predict_df["ds"])
test_df = pd.merge(test_df, predict_df, "left", ["ds", "unique_id"])
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col="unique_id",
)

average_metrics = evaluation.groupby("metric")["TimeGPT"].mean()
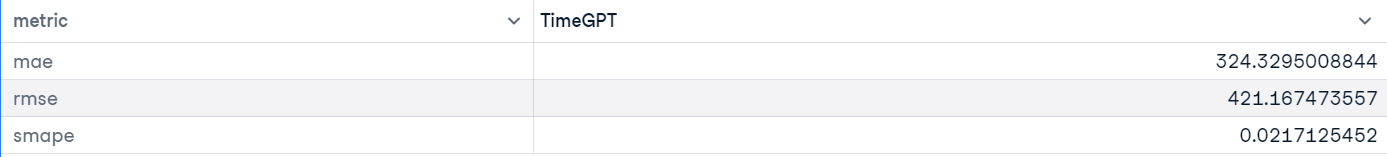
average_metrics
Chúng ta có kết quả khá tốt.
API Nixtla cũng cho phép bạn dự báo nhiều chuỗi một lúc. Chúng ta sẽ dùng toàn bộ tập dữ liệu thay vì lọc theo ID duy nhất.
Để chia tập dữ liệu thành train và test, ta dùng hàm groupby để tách 144 giá trị cho mỗi ID duy nhất. Nếu không, ta sẽ chỉ có 144 giá trị cho một ID ngẫu nhiên nào đó.
values for some randomly chosen unique ID.
test_df = demand_df.groupby("unique_id").tail(144)  # 3 days
train_df = (
    demand_df.groupby("unique_id")
    .apply(lambda group: group.iloc[-1344:-144])
    .reset_index(drop=True)
)  # 25 days
Hàm forecast giống như phần trước, chỉ khác là lần này ta thêm cả cột ID.
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],
    finetune_steps=60,
    finetune_loss='mae',
    model='timegpt-1-long-horizon',
    time_col='ds',
    target_col='y',
    id_col='unique_id'
)
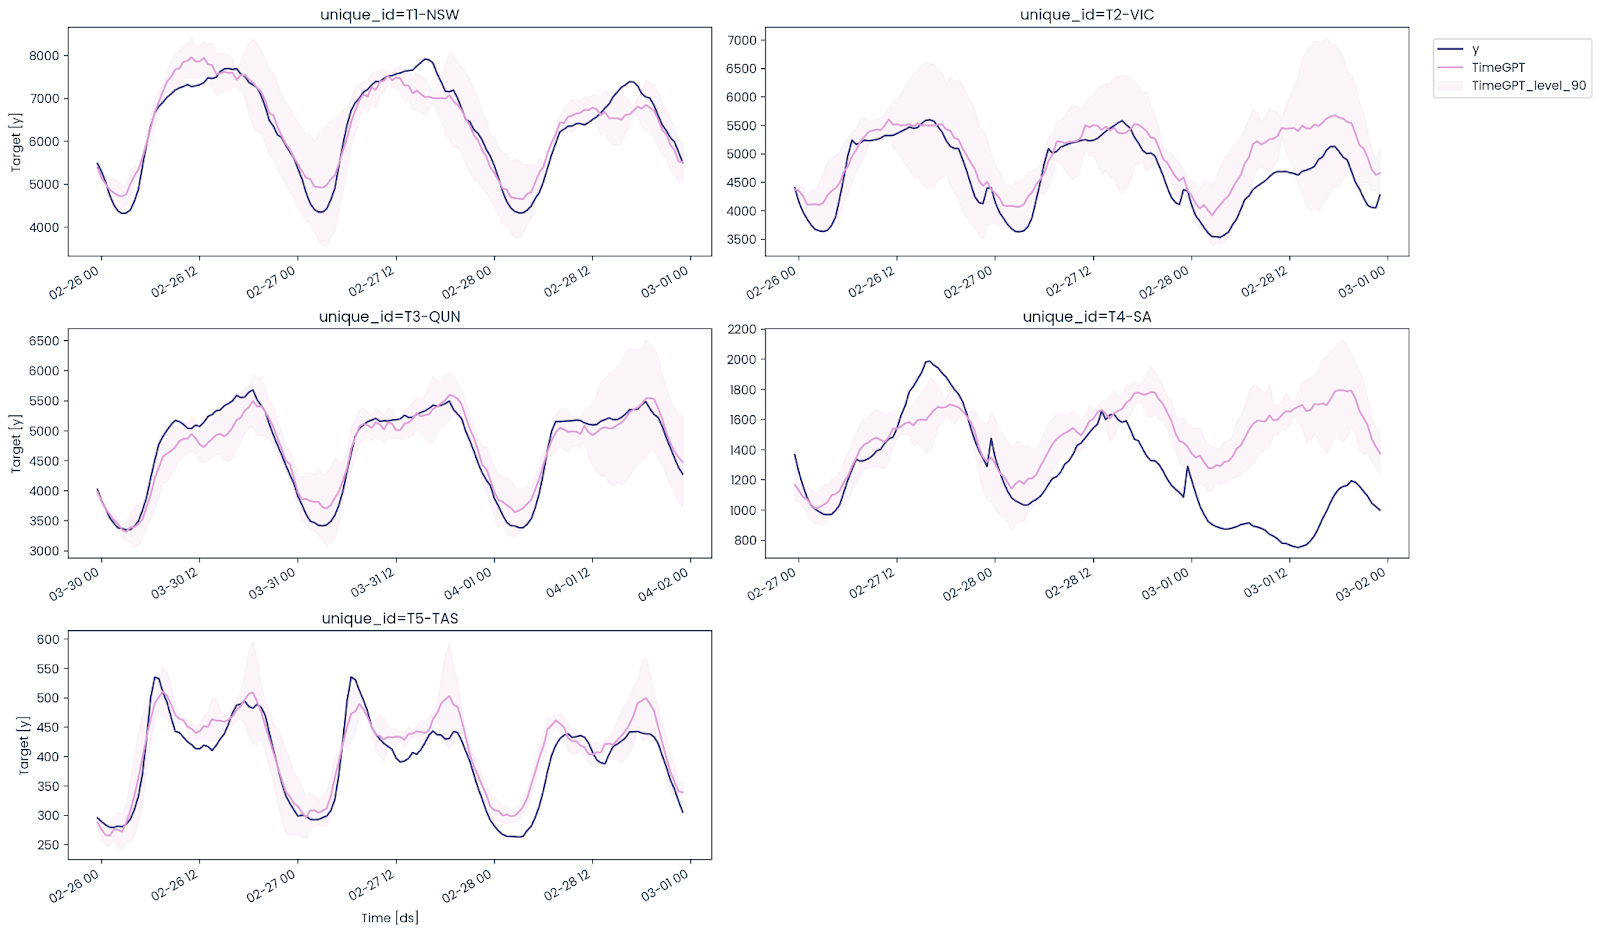
Vẽ biểu đồ chuỗi thời gian của dữ liệu thực tế, dự báo và giá trị ở mức tin cậy 90 cho cả 5 ID duy nhất.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Như ta thấy, mô hình TimeGPT hoạt động tốt ngay cả trên nhiều chuỗi thời gian, ngoại trừ Nam Úc. Mô hình không dự báo được xu hướng giảm của nhu cầu điện.
Chúng ta cần gộp hai dataframe test và dự báo để đánh giá mô hình bằng các thước đo MAE, RMSE và SMAPE.
predict_df['ds'] = pd.to_datetime(predict_df['ds'])
test_df = pd.merge(test_df, predict_df, 'left', ['ds','unique_id'])
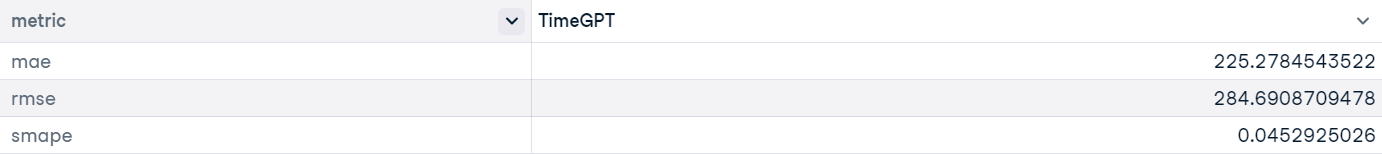
Dùng hàm evaluate để tạo báo cáo hiệu năng mô hình dưới dạng dataframe pandas. Báo cáo sẽ có chỉ số cho mỗi ID duy nhất. Để tính hiệu năng tổng thể, chúng ta cần lấy trung bình các giá trị và hiển thị kết quả cuối.
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "unique_id"
)

average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Hiệu năng tổng thể của mô hình được cải thiện khi fine-tune trên nhiều chuỗi thời gian thay vì một chuỗi đơn lẻ.
Client Nixtla cũng cho phép bạn thực hiện cross-validation để đánh giá hiệu năng mô hình trên nhiều cửa sổ của tập dữ liệu.
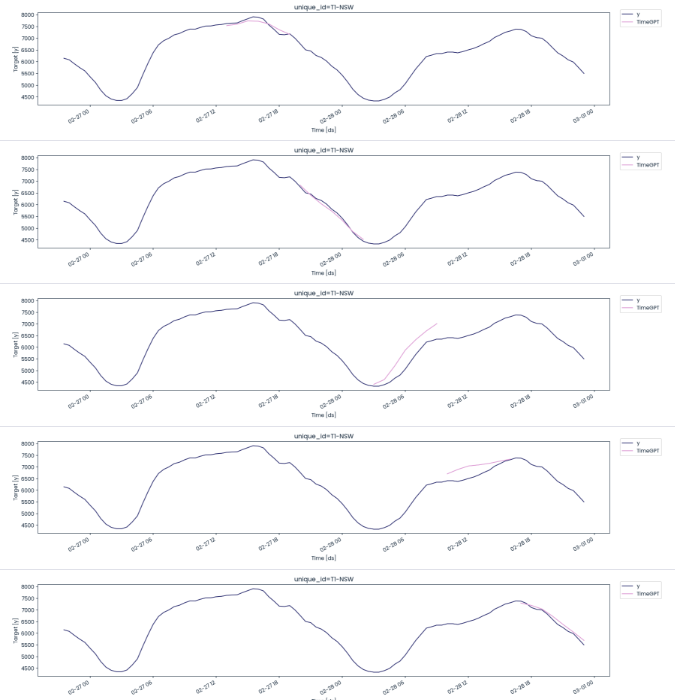
Chúng ta sẽ dùng hàm .cross_validation và truyền vào tập dữ liệu đã lọc chỉ chứa các giá trị của New South Wales. Cross-validation sẽ có 5 cửa sổ, mỗi cửa sổ dài 7 giờ.
timegpt_cv_df = nixtla_client.cross_validation(
    T1_df,
    h=7,
    n_windows=5,
    time_col='ds',
    target_col='y',
    freq='H',
)
timegpt_cv_df.head()
Như ta thấy, chúng ta có các giá trị dự báo dựa trên năm cửa sổ 7 giờ.
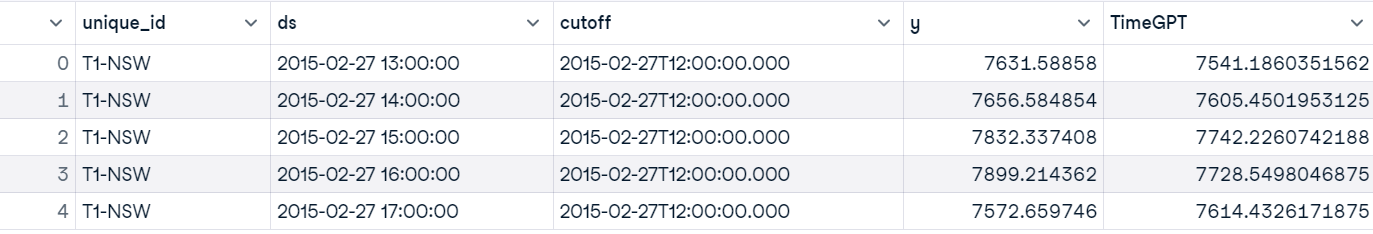
Chúng ta sẽ dùng ngày giờ cắt (cutoff) để tạo 5 cửa sổ, mỗi cửa sổ hiển thị giá trị dự đoán và thực tế.
cutoffs = timegpt_cv_df['cutoff'].unique()
for cutoff in cutoffs:
    fig = nixtla_client.plot(
        T1_df.tail(100),
        timegpt_cv_df.query('cutoff == @cutoff').drop(columns=['cutoff', 'y']),
        time_col='ds',
        target_col='y'
    )
    display(fig)
Ngoại trừ lần chia thứ 3 và thứ 4, mô hình hoạt động khá tốt.
Bây giờ hãy so sánh hiệu năng của TimeGPT và Light Gradient-Boosting Machine (LGBM) để xác định rõ mô hình nào vượt trội trên cùng tập dữ liệu. Chúng ta đã thực hiện cross-validation trên dataframe của New South Wales; bước tiếp theo là dùng hàm evaluate để tạo báo cáo đánh giá mô hình.
evaluation = evaluate(
    timegpt_cv_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "cutoff"
)
evaluation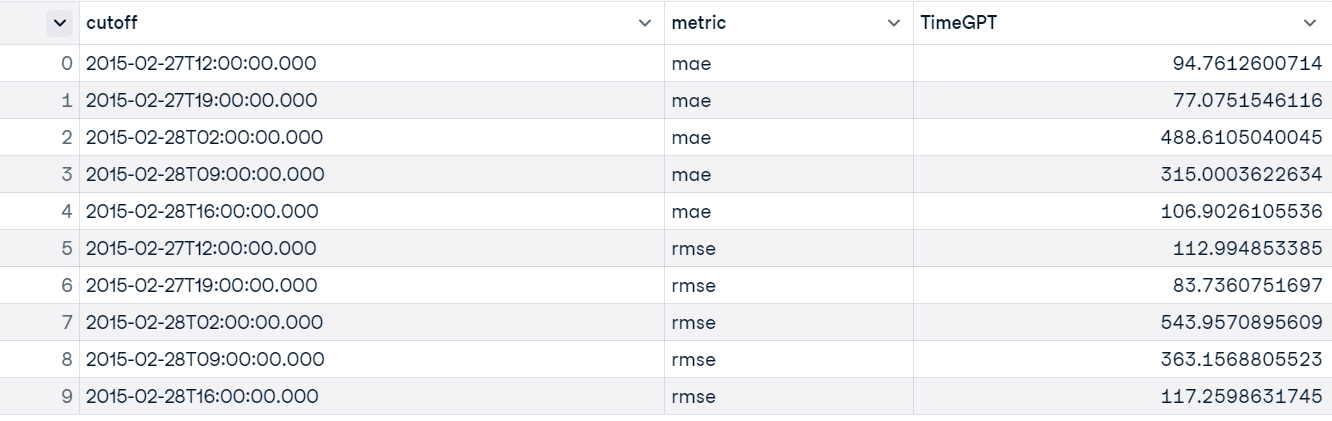
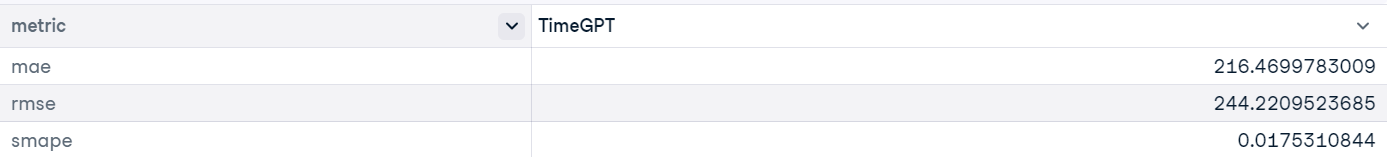
Chúng ta cần tính trung bình MAE, RMSE và SMAPE cho cả 5 cửa sổ để có kết quả tổng thể của mô hình.
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Kết quả khá tốt, ngay cả trên một tập giá trị nhỏ.
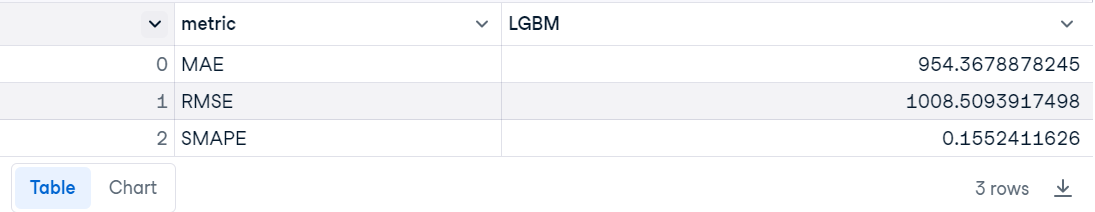
Để đánh giá mô hình LGBM, chúng ta cần thực hiện các bước sau:
Lưu ý: Để dùng các mô hình thống kê và máy học cho dự báo chuỗi thời gian, điều quan trọng là học các kỹ thuật đặc trưng cơ bản và thuật toán. Để có hướng dẫn toàn diện, hãy xem bài hướng dẫn: Hướng dẫn Dự báo Chuỗi thời gian trên DataCamp.
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import TimeSeriesSplit
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Function to calculate SMAPE
def smape(y_true, y_pred):
    return np.mean(2 * np.abs(y_pred - y_true) / (np.abs(y_true) + np.abs(y_pred)))

# Assuming 'ds' is the date/time column and 'y' is the target variable
T1_df['ds'] = pd.to_datetime(T1_df['ds'])

# Filter the DataFrame to include only the specified datetime range
start_date = '2015-02-27T13:00:00'
end_date = '2015-02-28T23:00:00'
T1_df = T1_df[(T1_df['ds'] >= start_date) & (T1_df['ds'] <= end_date)]

# Convert 'ds' to a numerical value (e.g., timestamp)
T1_df['ds_num'] = T1_df['ds'].apply(lambda x: x.timestamp())

# Create lag and window features
for lag in range(1, 4):
    T1_df[f'lag_{lag}'] = T1_df['y'].shift(lag)

T1_df['rolling_mean'] = T1_df['y'].rolling(window=3).mean()
T1_df['rolling_std'] = T1_df['y'].rolling(window=3).std()

# Drop NaN values resulting from lag and rolling operations
T1_df.dropna(inplace=True)

# Select features for the model
X = T1_df[['ds_num', 'lag_1', 'lag_2', 'lag_3', 'rolling_mean', 'rolling_std']]
y = T1_df['y']

# Time series split
tscv = TimeSeriesSplit(n_splits=5)
mae_scores = []
rmse_scores = []
smape_scores = []

for train_index, test_index in tscv.split(X):
    X_train, X_test = X.iloc[train_index], X.iloc[test_index]
    y_train, y_test = y.iloc[train_index], y.iloc[test_index]

    # Initialize and train the LGBM model
    model = lgb.LGBMRegressor(force_row_wise=True, verbosity=-1)
    model.fit(X_train, y_train)

    # Make predictions
    y_pred = model.predict(X_test)

    # Evaluate the model
    mae = mean_absolute_error(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))
    smape_value = smape(y_test, y_pred)

    mae_scores.append(mae)
    rmse_scores.append(rmse)
    smape_scores.append(smape_value)

# Convert the metrics into a DataFrame
mae_avg = np.mean(mae_scores)
rmse_avg = np.mean(rmse_scores)
smape_avg = np.mean(smape_scores)

metrics_df = pd.DataFrame({
    'metric': ['MAE', 'RMSE', 'SMAPE'],
    'LGBM': [mae_avg, rmse_avg, smape_avg]
})

# Display the DataFrame
metrics_df
TimeGPT tốt hơn LGBM gần 5 lần.
Nếu bạn gặp vấn đề khi chạy mã trên hoặc thiết lập TimeGPT, vui lòng xem workspace DataLab: Dự báo chuỗi thời gian với TimeGPT.
Hệ sinh thái TimeGPT và Nixtla lý tưởng cho các công ty mới khởi đầu, vì loại bỏ nhu cầu thuê kỹ sư máy học để huấn luyện mô hình và kỹ sư MLOps để triển khai, vận hành. Nếu bạn là startup, bạn có thể tiết kiệm chi phí đáng kể mà vẫn tiếp cận được các mô hình hiệu năng cao.
Tương tự GPT-3, TimeGPT là khởi đầu cho các mô hình tối tân dành cho chuỗi thời gian, và khi các mô hình này cải thiện theo thời gian, nhiều công ty có khả năng sẽ áp dụng API Nixtla để tích hợp dễ dàng và nâng cao hiệu năng.
Trong hướng dẫn này, chúng ta đã khám phá TimeGPT, mô hình nền tảng đầu tiên cho chuỗi thời gian. Ngoài ra, chúng ta đã học cách sử dụng Python API để truy cập TimeGPT cho các tác vụ như dự báo, trực quan hóa chuỗi thời gian, đánh giá mô hình, cross-validation và phát hiện bất thường.
Học cách dự báo tương lai bằng các mô hình họ ARIMA và tạo dự đoán cùng insight bằng mô hình máy học với Time Series with Python skill track. Nếu bạn ưa thích ngôn ngữ R, hãy cân nhắc Time Series with R để hiểu toàn diện về dự báo chuỗi thời gian.
Lộ trình
Lộ trình
Lộ trình
blog
Matt Crabtree
10 phút
