
Programma
Serie temporali in Python
20 ore
Addestrare un modello di machine learning per serie temporali non è banale; è piuttosto diverso dai classici problemi di classificazione o regressione. Devi creare finestre e lag per generare nuove feature a partire dai dati esistenti e, anche così, il modello potrebbe non funzionare bene. Non solo i modelli di regressione lineare fanno fatica, ma anche modelli di deep learning come LSTM e GRU possono avere performance scarse quando si tratta di prevedere il mercato azionario.
Ci serve un modello in stile GPT-4o per serie temporali che funzioni bene su tutti i tipi di dataset? Assolutamente sì. TimeGPT è un modello fondazionale all’avanguardia capace di fare forecast anche su dataset mai visti.
In questo tutorial esploreremo l’architettura di TimeGPT, come è stato addestrato e i suoi benchmark. Inoltre, vedremo come usare la Nixtla API per accedere al modello TimeGPT per forecasting, rilevamento di anomalie, visualizzazioni di serie temporali e valutazioni dei modelli.
Immagine dell’autore | Canva
TimeGPT-1 è un modello per serie temporali basato su Transformer con meccanismi di self-attention a cui puoi accedere tramite la Nixtla API. È il primo modello fondazionale per dataset di serie temporali che risulta piuttosto accurato su dati mai visti. Tutto ciò che devi fare è fare fine-tuning sul tuo dataset e, in pochi secondi, otterrai performance all’avanguardia.
L’architettura di TimeGPT è composta da una struttura encoder–decoder con più layer, ciascuno dotato di connessioni residuali e layer normalization. Il layer di output è lineare e mappa l’output del decoder sulla dimensione della finestra di forecast.
È stato addestrato sulla più ampia collezione di dati di serie temporali pubblicamente disponibili, il che significa che può fare forecast su dataset mai visti senza bisogno di riaddestramento. Per produrre una previsione, TimeGPT prende una finestra di valori precedenti e aggiunge un positional encoder locale per arricchire l’input.
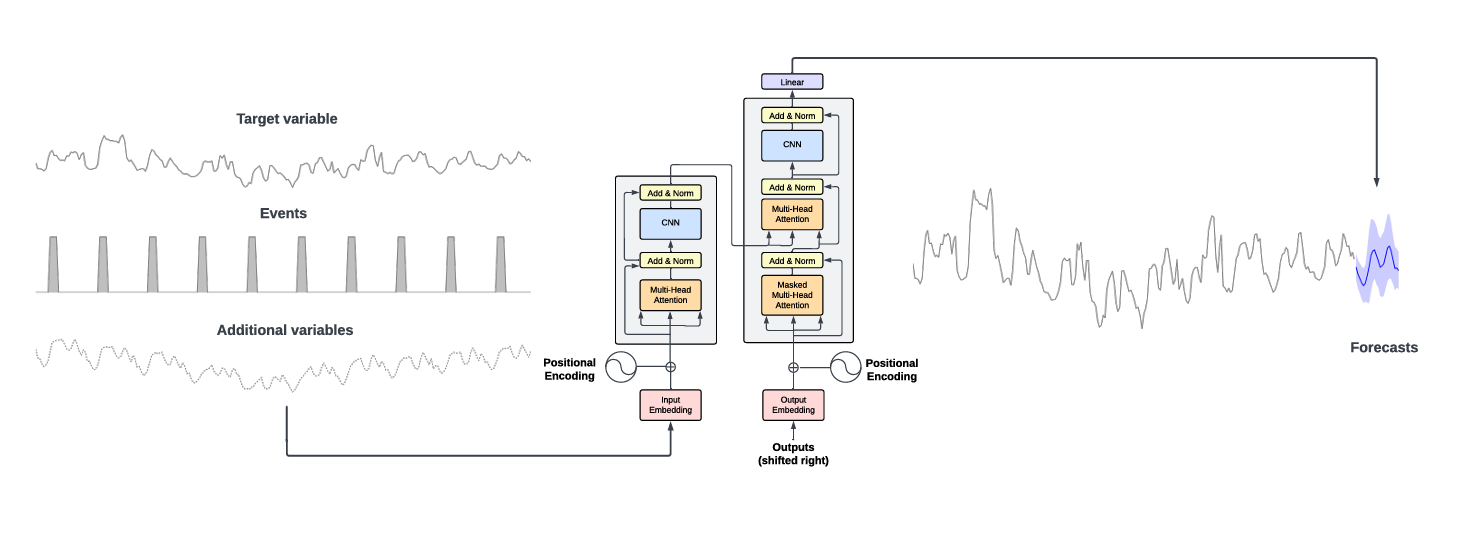
Fonte: 2310.03589 (arxiv.org) | TimeGPT prende come input i valori storici del target e variabili esogene aggiuntive per produrre i forecast.
Il modello TimeGPT supera metodi statistici, di machine learning e deep learning consolidati, mostrando una superiore performance zero-shot, efficienza e semplicità. Come dimostrato nel benchmark qui sotto, TimeGPT eccelle su varie metriche di machine learning anche senza alcuna feature engineering.
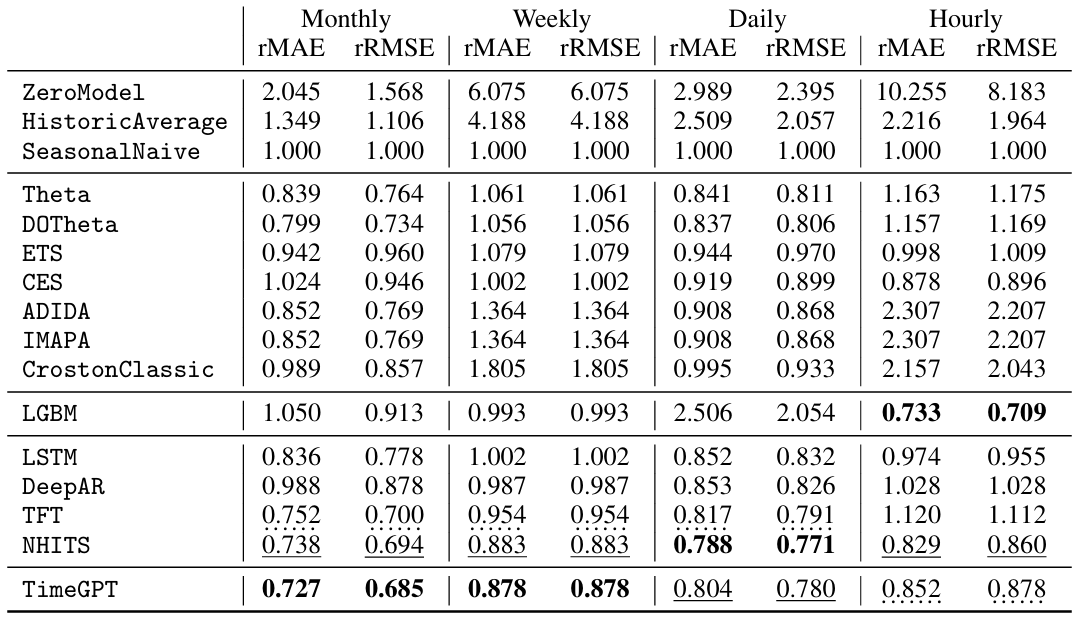
Fonte: 2310.03589 (arxiv.org) | Modelli a confronto misurati con rMAE e rRMSE, punteggi più bassi sono migliori.
Il modello TimeGPT non è open source e puoi accedervi solo tramite la Nixtla API. Questa sezione ti guiderà nella configurazione della Nixtla API per accedere al modello TimeGPT e prevedere i dati azionari di Amazon.
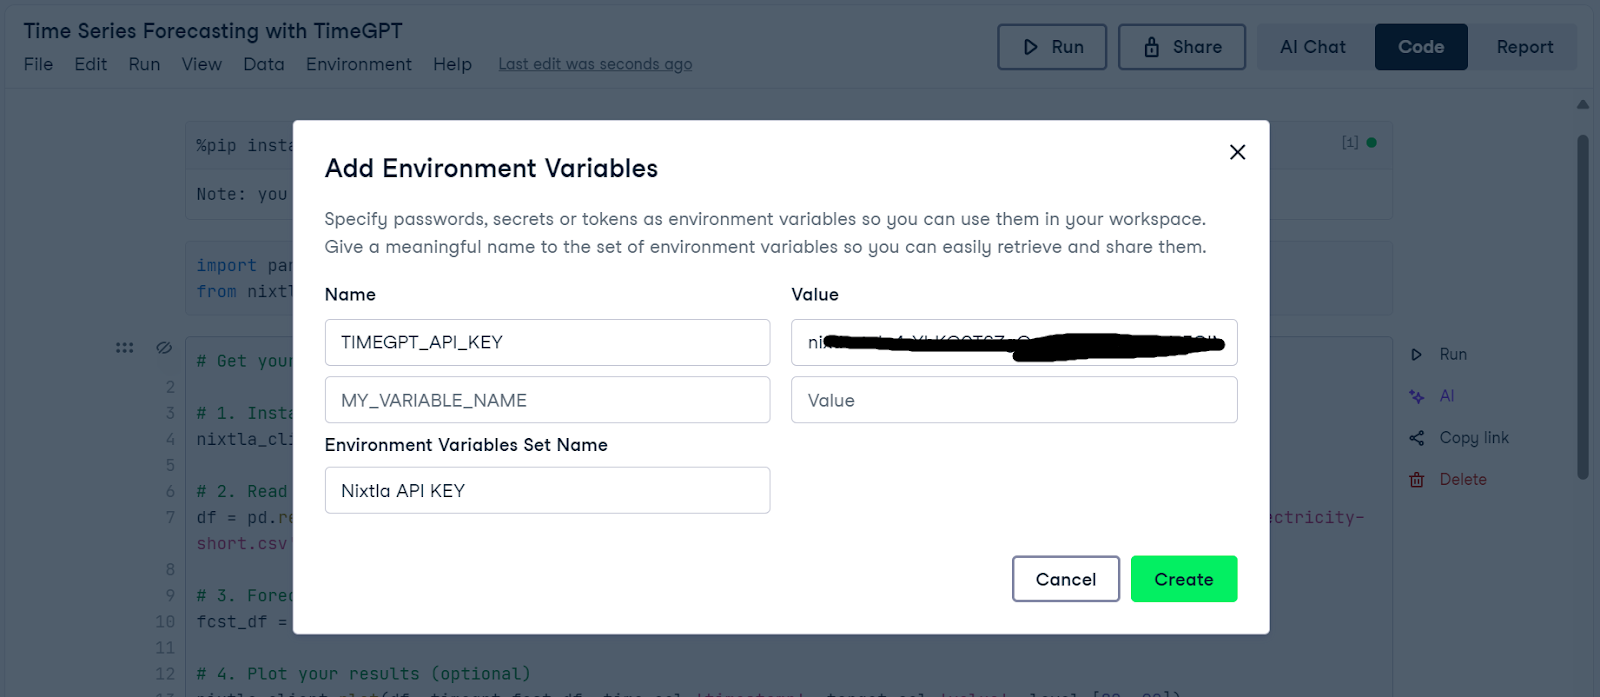
%%capture
%pip install nixtla>=0.5.1
%pip install yfinanceimport pandas as pd
import yfinance as yf
from nixtla import NixtlaClient
import os
timegpt_api_key = os.environ["TIMEGPT_API_KEY"]
# Setup NixtlaClient
nixtla_client = NixtlaClient(api_key = timegpt_api_key)
# Downloading Amazon stock price data
ticker = 'AMZN'
amazon_stock_data = yf.download(ticker)
amazon_stock_data = amazon_stock_data.reset_index()
# Displaying the dataset
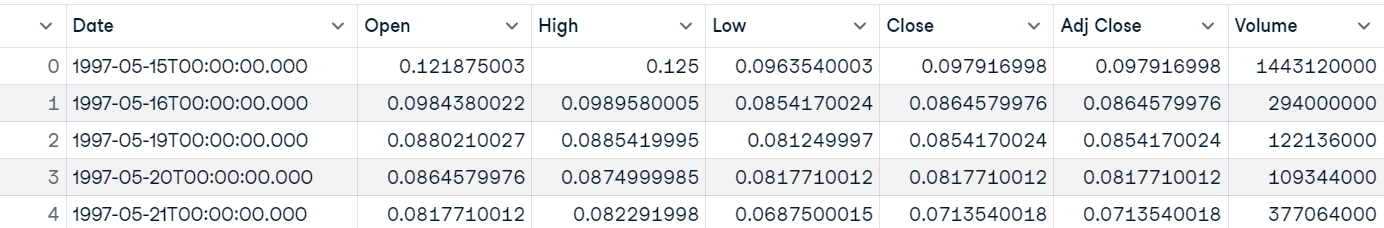
amazon_stock_data.head()Abbiamo dati sul prezzo delle azioni Amazon dal 1997 a oggi.
nixtla_client.plot(amazon_stock_data, time_col='Date', target_col='Close')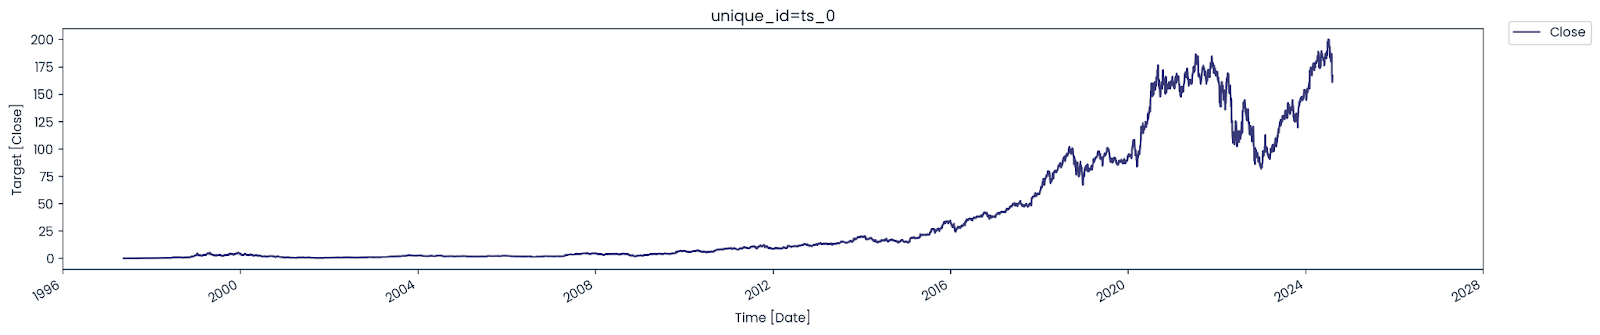
Scopri come creare line plot per serie temporali con Matplotlib seguendo questo tutorial Matplotlib Time Series Line Plot.
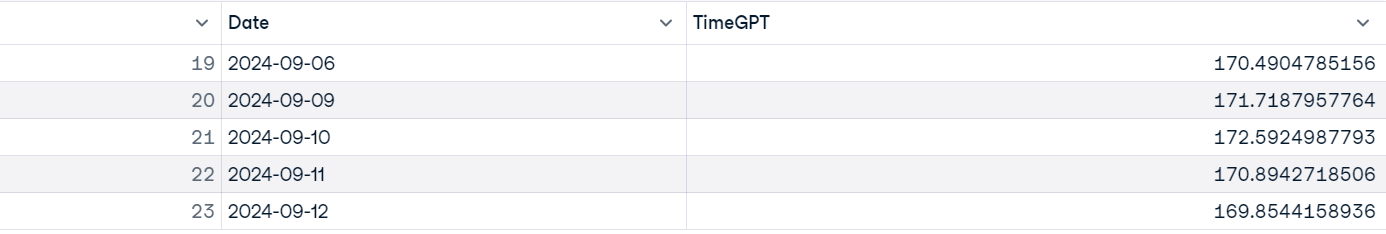
.forecast i dati azionari, il nome del modello, un orizzonte di previsione (equivalente a 24 giorni), la frequenza, la colonna temporale e quella del target. Poiché la borsa è chiusa nei weekend, selezioniamo la frequenza "business day(B)".model = nixtla_client.forecast(
df=amazon_stock_data,
model="timegpt-1",
h=24,
freq="B",
time_col="Date",
target_col="Close",
)
model.tail()
nixtla_client.plot(
    amazon_stock_data,
    model,
    time_col="Date",
    target_col="Close",
    max_insample_length=60,
)
Come si vede, in pochi secondi il modello TimeGPT ha previsto con precisione i prezzi di chiusura di Amazon nel futuro.
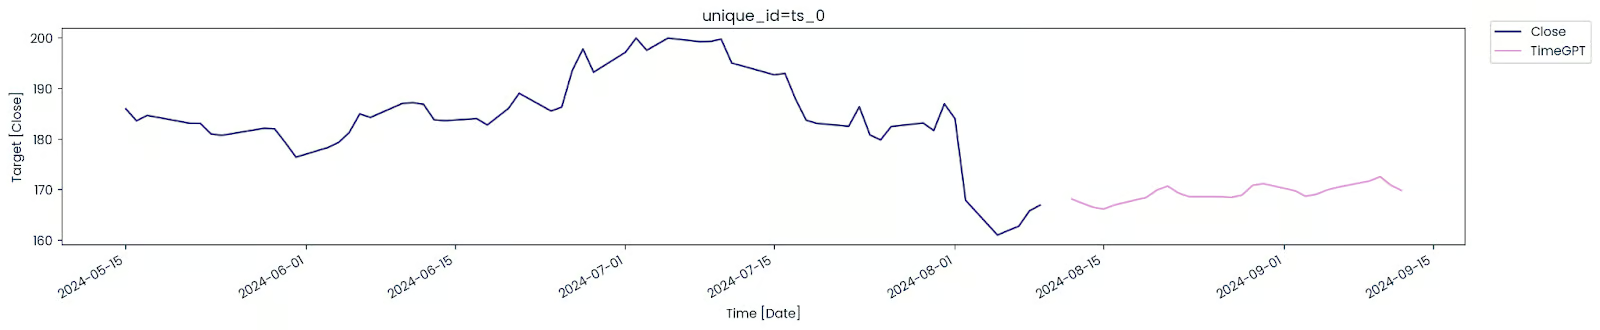
Questo era un esempio per principianti. Nella prossima sezione lavoreremo su dataset più complessi ed esploreremo varie funzionalità della Nixtla API.
In questa sezione useremo un dataset più complesso di domanda di elettricità australiana e useremo il modello TimeGPT per prevedere più valori in una volta sola.
Il dataset comprende 5 serie temporali che rappresentano la domanda di elettricità semioraria di 5 stati australiani: Victoria, Nuovo Galles del Sud, Queensland, Tasmania e Australia Meridionale.
Impareremo anche come fare fine-tuning del modello e usare vari iperparametri per migliorarne le performance. Infine, eseguiremo la cross-validation e confronteremo le performance con modelli tradizionali per una valutazione approfondita.
Non esiste un modo semplice per caricare il file .tsf con la libreria pandas. Dobbiamo creare una funzione personalizzata per caricare ed elaborare i dati e poi convertirli in un dataframe Pandas.
import pandas as pd


def read_tsf_from_file(file_path):
    data = []
    start_date = pd.to_datetime("2002-01-01 00:00:00")

    # Open and read the file from the directory

    with open(file_path, "r") as file:
        for line in file:
            if line.startswith("T"):
                parts = line.strip().split(":")
                unique_id = parts[0] + "-" + parts[1]
                values = list(map(float, parts[3].split(",")[:-1]))

                # Generate datetime index at half-hour intervals

                periods = len(values)
                date_range = pd.date_range(
                    start=start_date, periods=periods, freq="30min"
                )

                # Append to data list

                for dt, value in zip(date_range, values):
                    data.append([unique_id, dt, value])
    # Convert the list of data into a DataFrame

    return pd.DataFrame(data, columns=["unique_id", "ds", "y"])


# Example usage

file_path = "australian_electricity_demand_dataset.tsf"
demand_df = read_tsf_from_file(file_path)

# Display the dataframe

demand_df.head()
Il nostro dataset ha tre colonne:
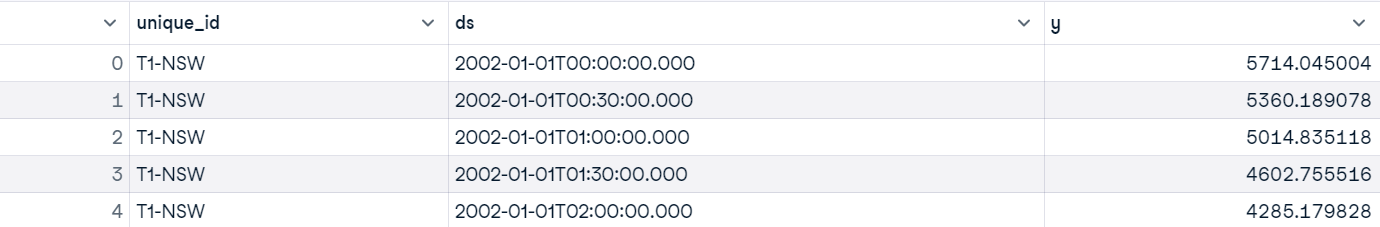
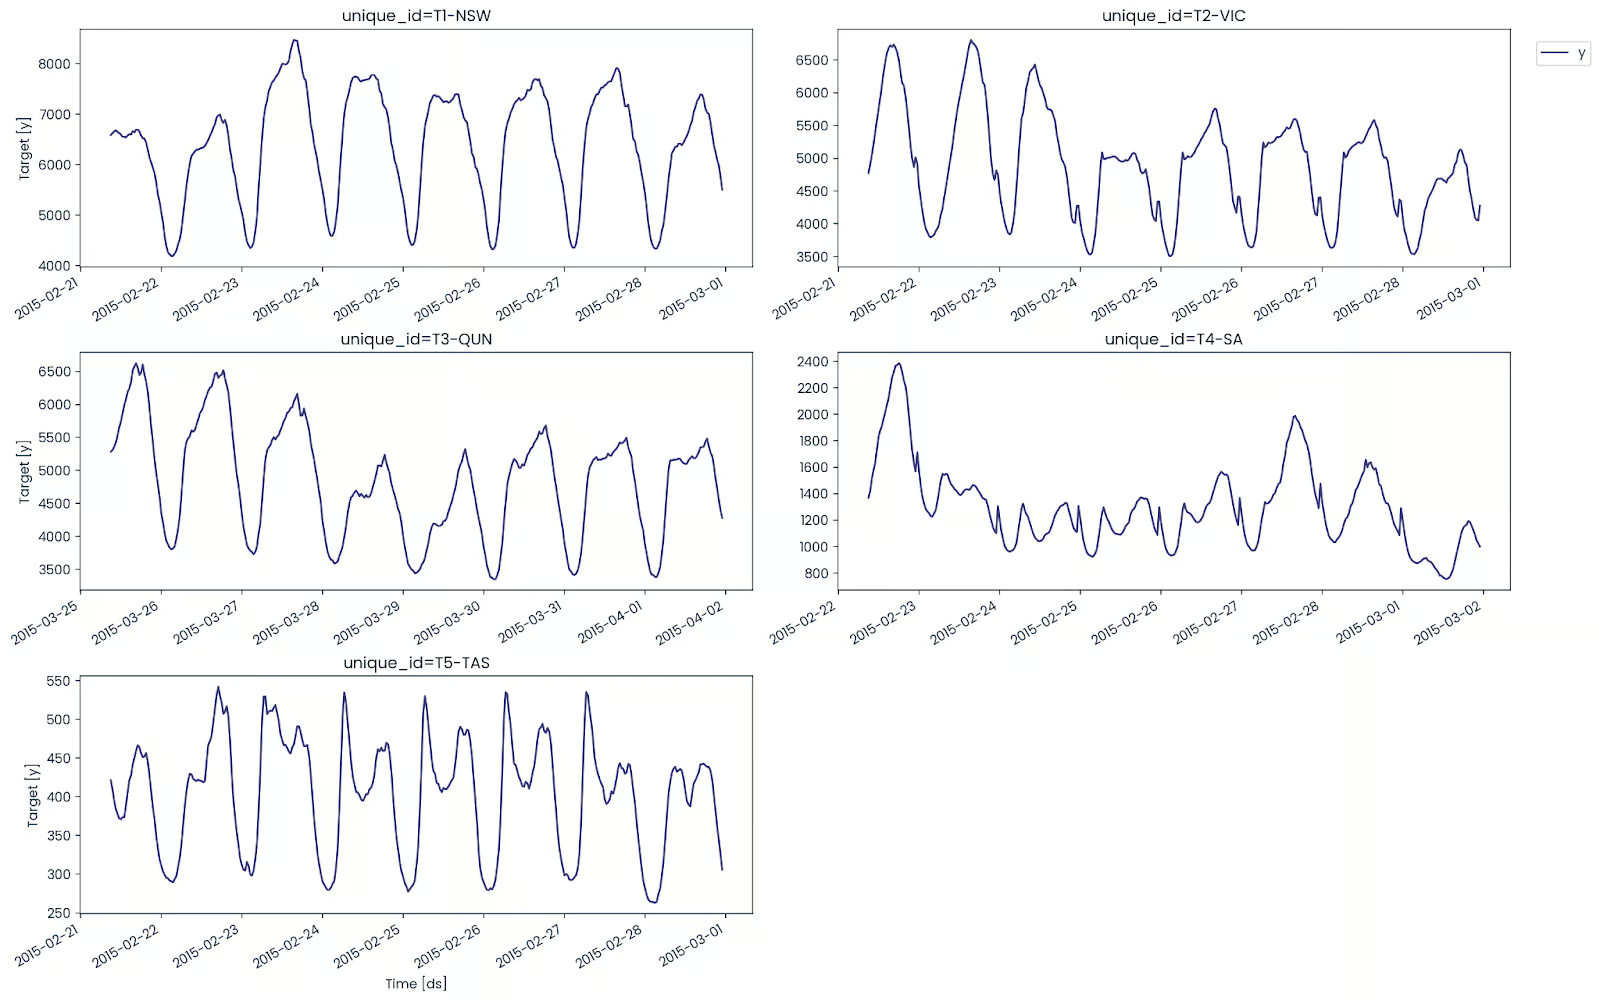
La funzione di plot è eccellente perché identifica automaticamente la colonna unique_id e crea cinque diverse visualizzazioni di serie temporali.
nixtla_client.plot(
    demand_df,
    max_insample_length=365,
)
La visualizzazione qui sotto mostra il consumo energetico dei 5 stati, e presentano tutti pattern diversi.
Impara l’analisi delle serie temporali partecipando alla sessione live di code-along su DataCamp, dove esplorerai dataset finanziari di serie temporali con Python.
In questa sessione esploreremo varie azioni, ne visualizzeremo l’andamento e faremo previsioni usando modelli diversi.
Prima di fare previsioni, identificheremo varie anomalie nel dataset per comprendere meglio il problema.
La funzione .detect_anomalies prende il dataset, le colonne temporale e target, e la frequenza.
# Detect anomalies
anomalies_df = nixtla_client.detect_anomalies(
    demand_df,
    time_col='ds',
    target_col='y',
    freq='H',
)
anomalies_df[anomalies_df["anomaly"]==1].head()
Abbiamo mostrato tutte le istanze in cui sono state rilevate anomalie.
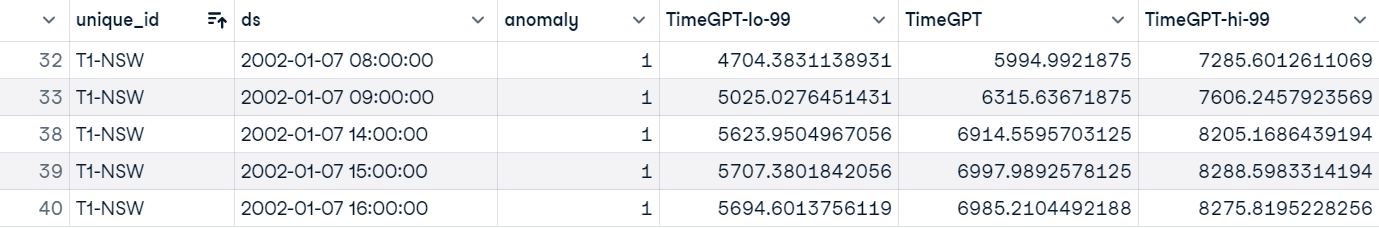
Il numero totale di anomalie in tutte e 5 le serie temporali è 17.316, che è davvero tanto.
anomalies_df.anomaly.value_counts()
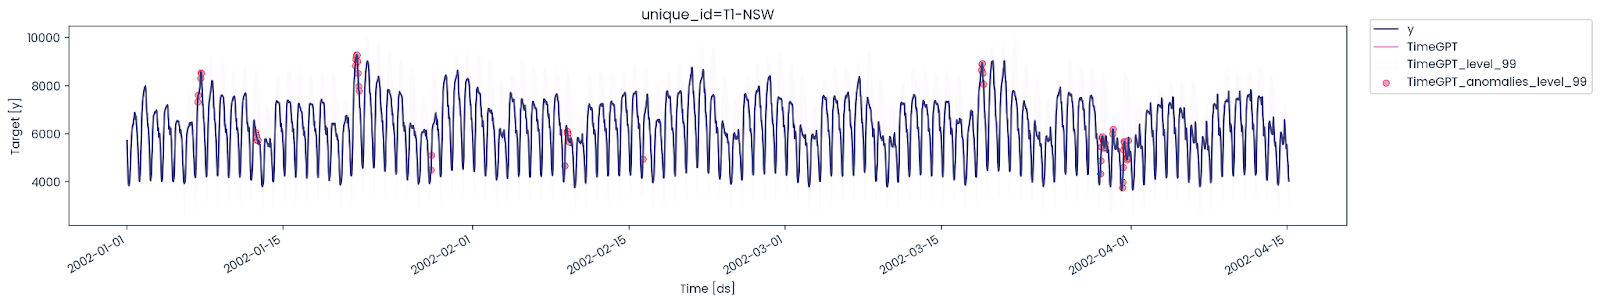
Ora tracceremo le anomalie sul dataset reale per vedere dove e quanto spesso si verificano giorno per giorno. Per semplificare la visualizzazione, mostreremo solo 5.000 campioni del Nuovo Galles del Sud.
# Plot anomalies
nixtla_client.plot(
    demand_df[demand_df["unique_id"]=="T1-NSW"][0:5000],
    anomalies_df[anomalies_df["unique_id"]=="T1-NSW"][0:5000],
    time_col='ds',
    target_col='y',

)
Le anomalie su base giornaliera non sono comuni, ma ci sono stati giorni con più anomalie nello stesso giorno.
Ora prevedremo la domanda di elettricità del Nuovo Galles del Sud. Per farlo, filtreremo solo i valori per "T1-NSW".
T1_df = demand_df[demand_df["unique_id"]=="T1-NSW"]
T1_df.head()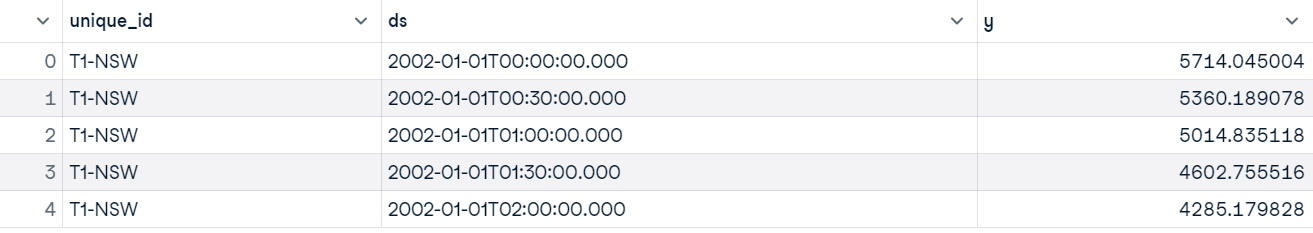
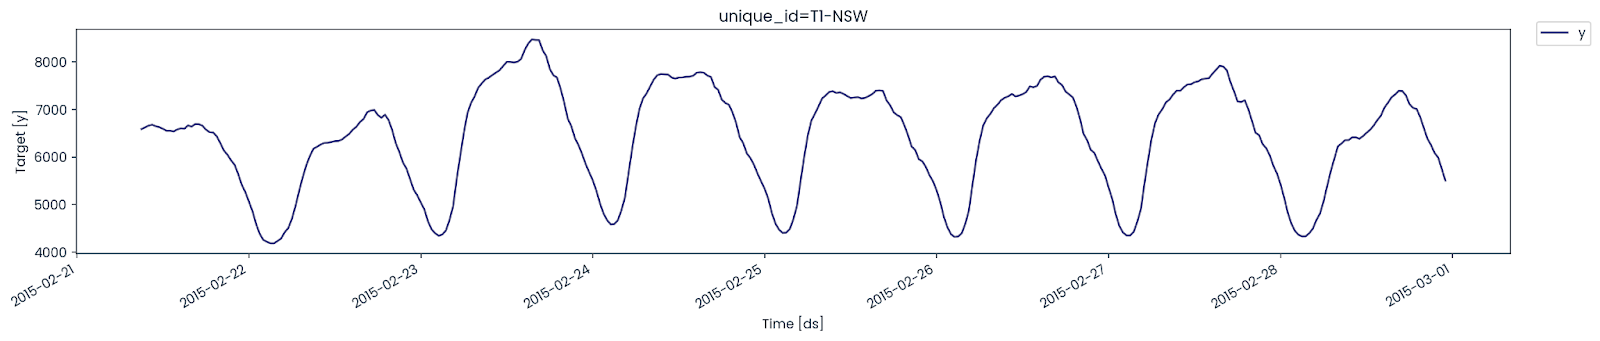
Traccia gli ultimi 365 valori per comprendere il pattern di consumo elettrico.
nixtla_client.plot(
    T1_df,
    max_insample_length=365,
)
Ora valuteremo le performance del nostro modello. Per farlo, dobbiamo dividere il dataset in training e test.
Il training set è composto da 144 valori, equivalenti a 3 giorni, e il test set da 1200 valori, equivalenti a 25 giorni.
test_df = T1_df.tail(144) # 3 days = (144 * 0.5h *  1 day/24h)
train_df = T1_df.iloc[-1344:-144] # 25 days = (1200 *0.5h * 1 day/24h)
Per il forecasting, selezioneremo un modello migliore e imposteremo vari argomenti per migliorare le performance, in particolare:
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],  # Generate a 90% confidence interval
    finetune_steps=60,  # Specify the number of steps for fine-tuning
    finetune_loss="mae",  # Use the MAE as the loss function for fine-tuning
    model="timegpt-1-long-horizon",  # Use the model for long-horizon forecasting
    time_col="ds",
    target_col="y",
)
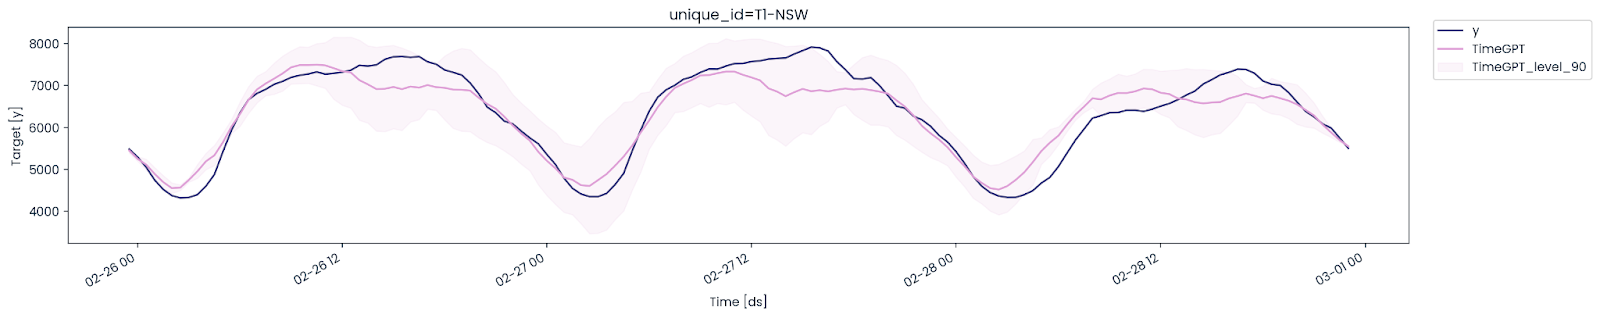
Traccia i valori reali, i forecast e l’intervallo di confidenza al 90% per valutare le performance del modello.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
In pochi secondi abbiamo ottenuto un risultato piuttosto accurato. Questo è il potere dei modelli pre-addestrati.
Ora valuteremo le performance del modello usando la libreria UtilsForecast, parte del progetto open source Nixtla. Per farlo, uniremo i dataset di test e forecast e poi li passeremo alla funzione evaluate. La funzione prende il dataset, le metriche, i modelli, la colonna target e un ID univoco per calcolare le metriche del modello e mostrarle come dataframe pandas.
from utilsforecast.losses import mae, rmse, smape
from utilsforecast.evaluation import evaluate

predict_df["ds"] = pd.to_datetime(predict_df["ds"])
test_df = pd.merge(test_df, predict_df, "left", ["ds", "unique_id"])
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col="unique_id",
)

average_metrics = evaluation.groupby("metric")["TimeGPT"].mean()
average_metrics
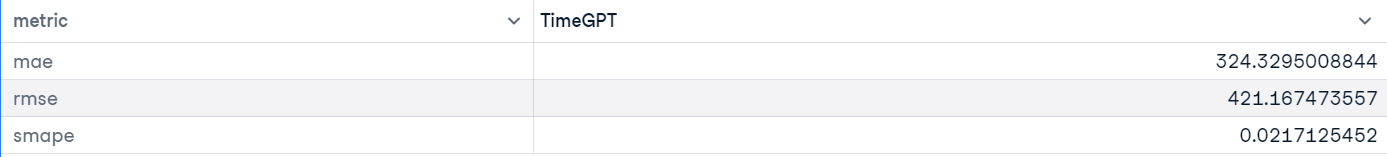
Abbiamo ottenuto risultati piuttosto buoni.
La Nixtla API ti permette anche di prevedere più serie contemporaneamente. Useremo l’intero dataset invece di filtrare in base a un ID univoco.
Per suddividere il dataset in train e test, usiamo la funzione groupby per separare i 144 valori per ogni ID univoco. Altrimenti, avremmo solo 144 valori per qualche ID scelto casualmente.
values for some randomly chosen unique ID.
test_df = demand_df.groupby("unique_id").tail(144)  # 3 days
train_df = (
    demand_df.groupby("unique_id")
    .apply(lambda group: group.iloc[-1344:-144])
    .reset_index(drop=True)
)  # 25 days
La funzione forecast è la stessa della parte precedente, tranne che questa volta includiamo anche le colonne ID.
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],
    finetune_steps=60,
    finetune_loss='mae',
    model='timegpt-1-long-horizon',
    time_col='ds',
    target_col='y',
    id_col='unique_id'
)
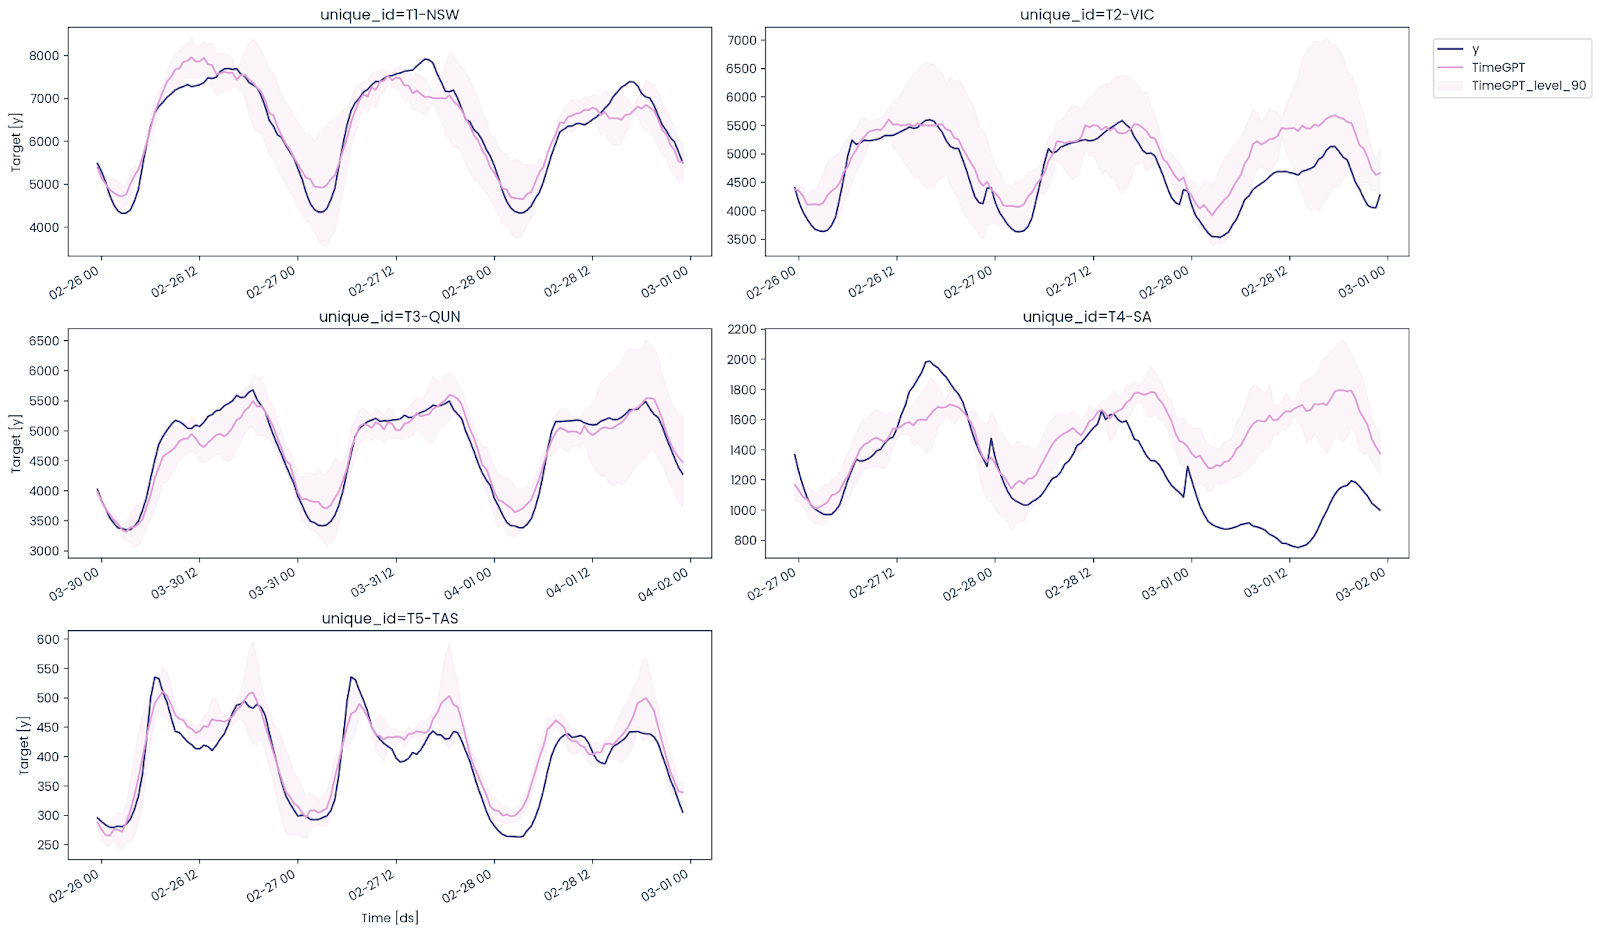
Traccia il grafico a serie temporali di valori reali, forecast e intervallo al 90% per tutti e 5 gli Unique ID.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Come si vede, il modello TimeGPT si è comportato bene anche su più serie temporali, tranne che per l’Australia Meridionale. Non è riuscito a prevedere il trend discendente della domanda di elettricità.
Dobbiamo unire i dataframe di test e forecast per valutare il modello con le metriche MAE, RMSE e SMAPE.
predict_df['ds'] = pd.to_datetime(predict_df['ds'])
test_df = pd.merge(test_df, predict_df, 'left', ['ds','unique_id'])
Usa la funzione evaluate per generare un report di performance del modello come dataframe pandas. Conterrà le metriche del modello per ciascun ID univoco. Per calcolare la performance complessiva del modello, dobbiamo fare la media dei valori e mostrare il risultato finale.
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "unique_id"
)

average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
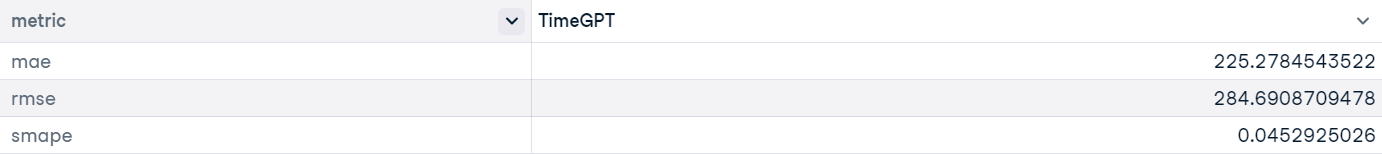
Le performance complessive del modello migliorano quando si fa fine-tuning su più serie temporali invece che su una singola.
Il client Nixtla permette anche di eseguire la cross-validation per valutare le performance del modello su varie finestre del dataset.
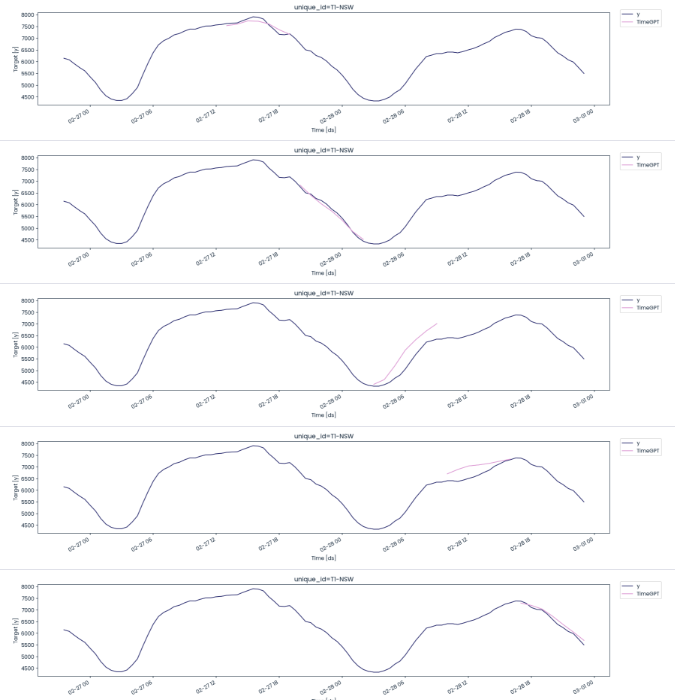
Useremo la funzione .cross_validation fornendo il dataset filtrato che contiene solo i valori del Nuovo Galles del Sud. La cross-validation avrà 5 finestre, ciascuna di 7 ore.
timegpt_cv_df = nixtla_client.cross_validation(
    T1_df,
    h=7,
    n_windows=5,
    time_col='ds',
    target_col='y',
    freq='H',
)
timegpt_cv_df.head()
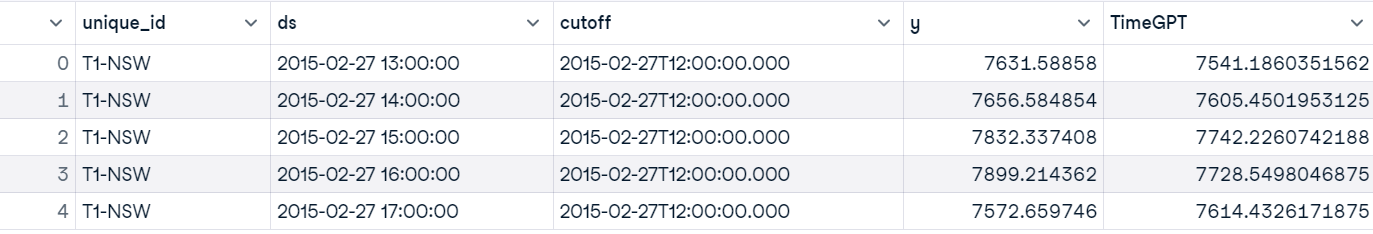
Come si vede, abbiamo ottenuto valori di forecast basati su cinque finestre da 7 ore.
Useremo una data e ora di cutoff per creare 5 finestre, ognuna con valori previsti e reali.
cutoffs = timegpt_cv_df['cutoff'].unique()
for cutoff in cutoffs:
    fig = nixtla_client.plot(
        T1_df.tail(100),
        timegpt_cv_df.query('cutoff == @cutoff').drop(columns=['cutoff', 'y']),
        time_col='ds',
        target_col='y'
    )
    display(fig)
A eccezione della 3ª e 4ª suddivisione, il modello si è comportato piuttosto bene.
Confrontiamo ora le performance dei modelli TimeGPT e Light Gradient-Boosting Machine (LGBM) per capire chiaramente quale eccelle sullo stesso dataset. Abbiamo già eseguito la cross-validation sul dataframe del Nuovo Galles del Sud; il prossimo passo è usare la funzione evaluate per generare il report di valutazione del modello.
evaluation = evaluate(
    timegpt_cv_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "cutoff"
)
evaluation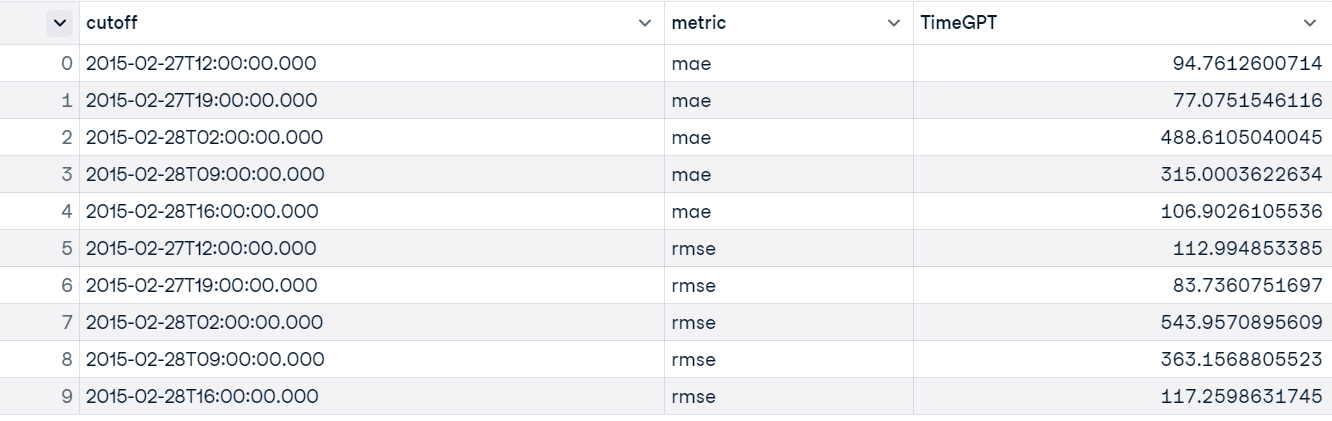
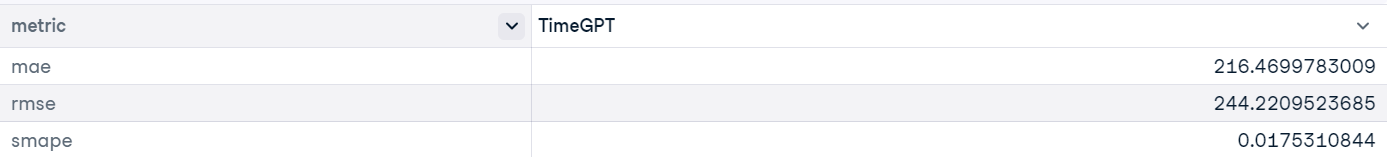
Dobbiamo calcolare la media di MAE, RMSE e SMAPE per tutte e 5 le finestre per ottenere il risultato complessivo del modello.
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
I risultati sono piuttosto buoni, anche su un set ridotto di valori.
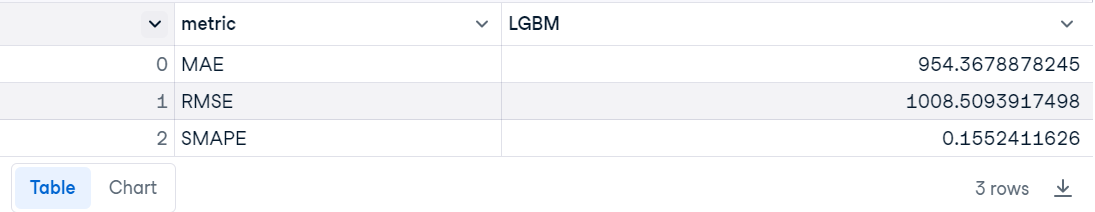
Per valutare il modello LGBM, dobbiamo seguire questi passaggi:
Nota: per usare modelli statistici e di machine learning nel forecasting di serie temporali, è fondamentale conoscere le tecniche base di feature engineering e gli algoritmi. Per una guida completa su questi argomenti, dai un’occhiata a questo tutorial: Time Series Forecasting Tutorial su DataCamp.
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import TimeSeriesSplit
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Function to calculate SMAPE
def smape(y_true, y_pred):
    return np.mean(2 * np.abs(y_pred - y_true) / (np.abs(y_true) + np.abs(y_pred)))

# Assuming 'ds' is the date/time column and 'y' is the target variable
T1_df['ds'] = pd.to_datetime(T1_df['ds'])

# Filter the DataFrame to include only the specified datetime range
start_date = '2015-02-27T13:00:00'
end_date = '2015-02-28T23:00:00'
T1_df = T1_df[(T1_df['ds'] >= start_date) & (T1_df['ds'] <= end_date)]

# Convert 'ds' to a numerical value (e.g., timestamp)
T1_df['ds_num'] = T1_df['ds'].apply(lambda x: x.timestamp())

# Create lag and window features
for lag in range(1, 4):
    T1_df[f'lag_{lag}'] = T1_df['y'].shift(lag)

T1_df['rolling_mean'] = T1_df['y'].rolling(window=3).mean()
T1_df['rolling_std'] = T1_df['y'].rolling(window=3).std()

# Drop NaN values resulting from lag and rolling operations
T1_df.dropna(inplace=True)

# Select features for the model
X = T1_df[['ds_num', 'lag_1', 'lag_2', 'lag_3', 'rolling_mean', 'rolling_std']]
y = T1_df['y']

# Time series split
tscv = TimeSeriesSplit(n_splits=5)
mae_scores = []
rmse_scores = []
smape_scores = []

for train_index, test_index in tscv.split(X):
    X_train, X_test = X.iloc[train_index], X.iloc[test_index]
    y_train, y_test = y.iloc[train_index], y.iloc[test_index]

    # Initialize and train the LGBM model
    model = lgb.LGBMRegressor(force_row_wise=True, verbosity=-1)
    model.fit(X_train, y_train)

    # Make predictions
    y_pred = model.predict(X_test)

    # Evaluate the model
    mae = mean_absolute_error(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))
    smape_value = smape(y_test, y_pred)

    mae_scores.append(mae)
    rmse_scores.append(rmse)
    smape_scores.append(smape_value)

# Convert the metrics into a DataFrame
mae_avg = np.mean(mae_scores)
rmse_avg = np.mean(rmse_scores)
smape_avg = np.mean(smape_scores)

metrics_df = pd.DataFrame({
    'metric': ['MAE', 'RMSE', 'SMAPE'],
    'LGBM': [mae_avg, rmse_avg, smape_avg]
})

# Display the DataFrame
metrics_df
TimeGPT è quasi 5 volte migliore di LGBM.
Se riscontri problemi nell’eseguire il codice sopra o nel configurare TimeGPT, dai un’occhiata allo spazio di lavoro DataLab: Time Series Forecasting with TimeGPT.
L’ecosistema TimeGPT e Nixtla è ideale per le aziende agli inizi, perché elimina la necessità di assumere machine learning engineer per addestrare i modelli e MLOps engineer per distribuirli e mantenerli. Se sei una startup, puoi risparmiare significativamente sui costi avendo comunque accesso a modelli ad alte prestazioni.
Come GPT-3, TimeGPT rappresenta l’inizio dei modelli all’avanguardia per le serie temporali e, man mano che questi modelli migliorano, molte aziende probabilmente adotteranno la Nixtla API per un’integrazione semplice e performance migliori.
In questo tutorial abbiamo esplorato TimeGPT, il primo modello fondazionale per le serie temporali. Inoltre, abbiamo imparato a usare la Python API per accedere al modello TimeGPT per attività come forecasting, visualizzazione di serie temporali, valutazione dei modelli, cross-validation e rilevamento di anomalie.
Impara a prevedere il futuro con i modelli della classe ARIMA e a generare previsioni e insight con modelli di machine learning con la Time Series with Python skill track. Se preferisci il linguaggio R, considera la Time Series with R skill track per comprendere a fondo il forecasting di serie temporali.
I migliori corsi DataCamp
Programma
Programma
Programma
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



