
programa
Series temporales en Python
20 h
Entrenar un modelo de machine learning para series temporales no es sencillo; es bastante distinto de los problemas clásicos de clasificación o regresión. Hay que crear ventanas y retardos para generar nuevas variables a partir de los datos existentes y, aun así, puede que el modelo no rinda bien. No solo los modelos de regresión lineal se resienten: incluso redes profundas como LSTM y GRU pueden ofrecer malos resultados al predecir el mercado bursátil.
¿Necesitamos un modelo tipo GPT-4o para series temporales que funcione bien en todo tipo de conjuntos de datos? Sin duda. TimeGPT es un modelo fundacional de última generación capaz de predecir incluso en datasets no vistos.
En este tutorial veremos la arquitectura de TimeGPT, cómo se entrenó y sus benchmarks. Además, aprenderás a usar la API de Nixtla para acceder al modelo TimeGPT y realizar predicciones, detección de anomalías, visualizaciones de series temporales y evaluación de modelos.
Imagen del autor | Canva
TimeGPT-1 es un modelo de series temporales basado en Transformers con mecanismos de autoatención al que puedes acceder mediante la API de Nixtla. Es el primer modelo fundacional para datasets de series temporales que resulta bastante preciso en datos no vistos. Solo tienes que ajustarlo a tu conjunto de datos y, en cuestión de segundos, ofrecerá un rendimiento de primer nivel.
La arquitectura de TimeGPT consta de una estructura codificador-decodificador con múltiples capas, cada una con conexiones residuales y normalización por capas. La capa de salida es lineal y mapea la salida del decodificador a la dimensión de la ventana de predicción.
Se entrenó con la mayor colección de datos públicos de series temporales, por lo que puede predecir en datasets no vistos sin necesidad de reentrenamiento. Para producir una predicción, TimeGPT toma una ventana de valores previos y añade un codificador posicional local para enriquecer la entrada.
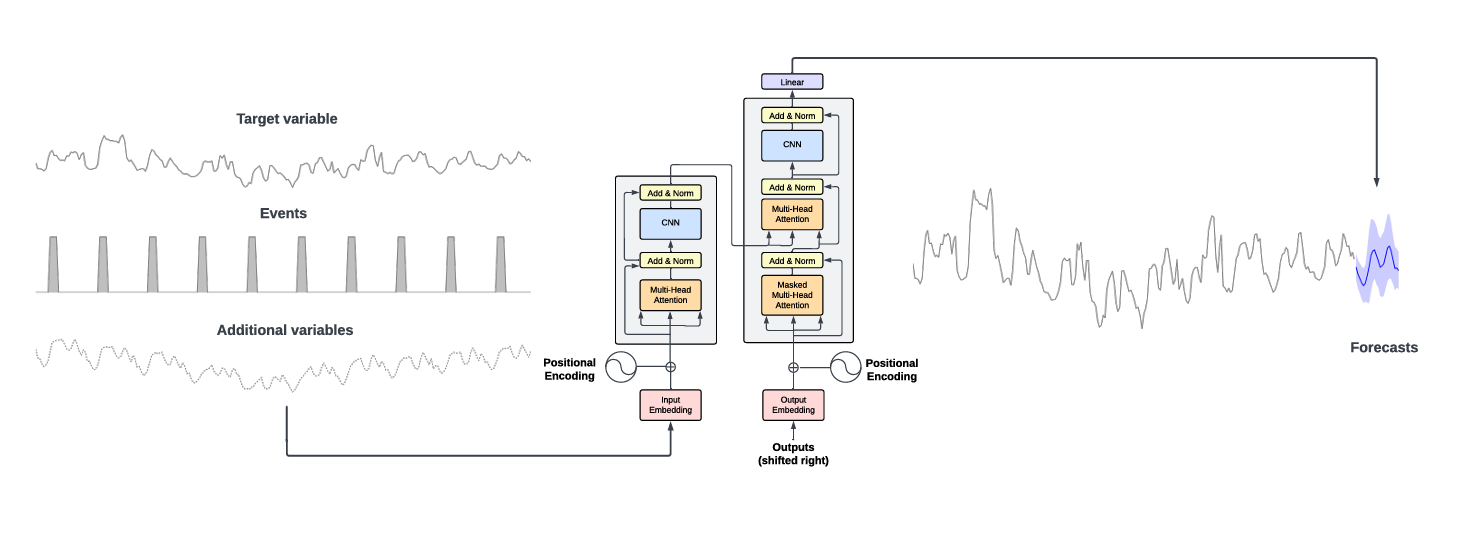
Fuente: 2310.03589 (arxiv.org) | TimeGPT toma los valores históricos del objetivo y variables exógenas adicionales como entrada para generar las predicciones.
El modelo TimeGPT supera a métodos estadísticos, de machine learning y de deep learning consolidados, mostrando un rendimiento superior en inferencia zero-shot, además de eficiencia y sencillez. Como se ve en el benchmark siguiente, TimeGPT destaca en varias métricas incluso sin ingeniería de características.
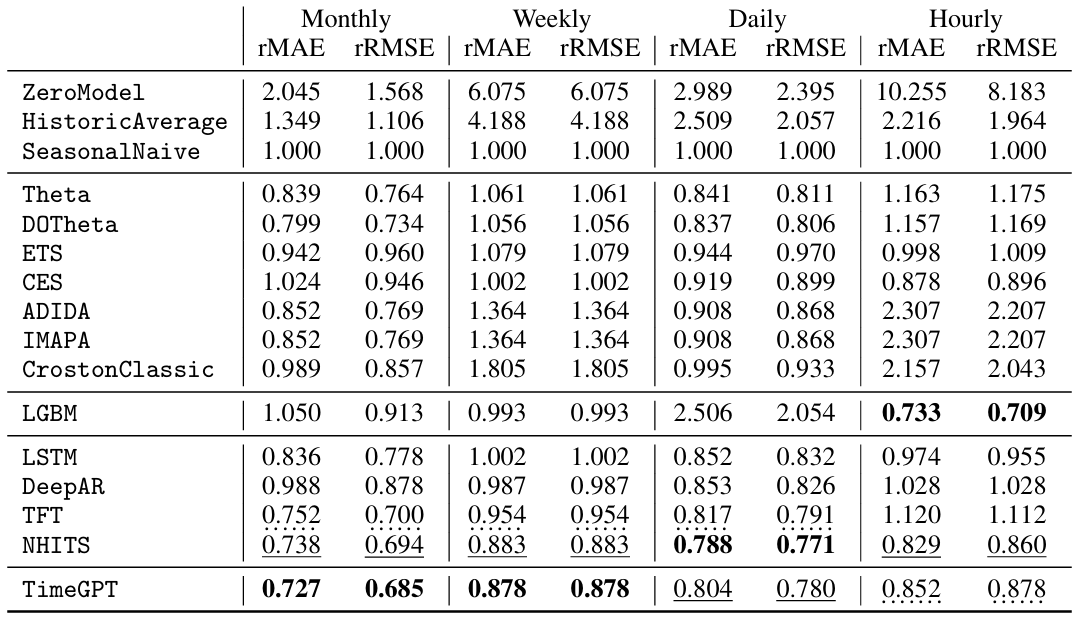
Fuente: 2310.03589 (arxiv.org) | Modelos evaluados con rMAE y rRMSE; cuanto menor, mejor.
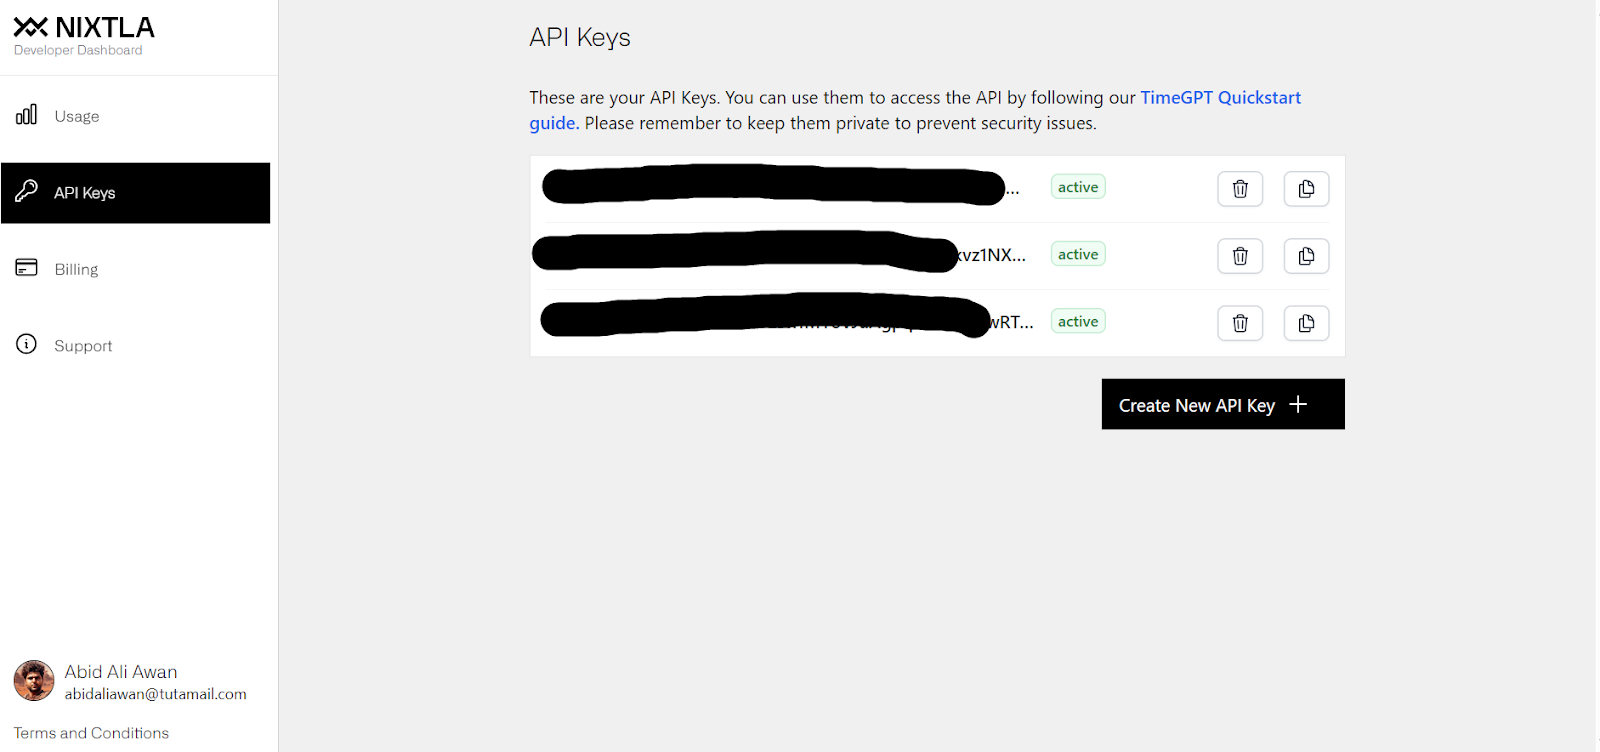
El modelo TimeGPT no es de código abierto y solo puedes acceder a él a través de la API de Nixtla. En esta sección verás cómo configurar la API de Nixtla para acceder a TimeGPT y predecir datos de las acciones de Amazon.
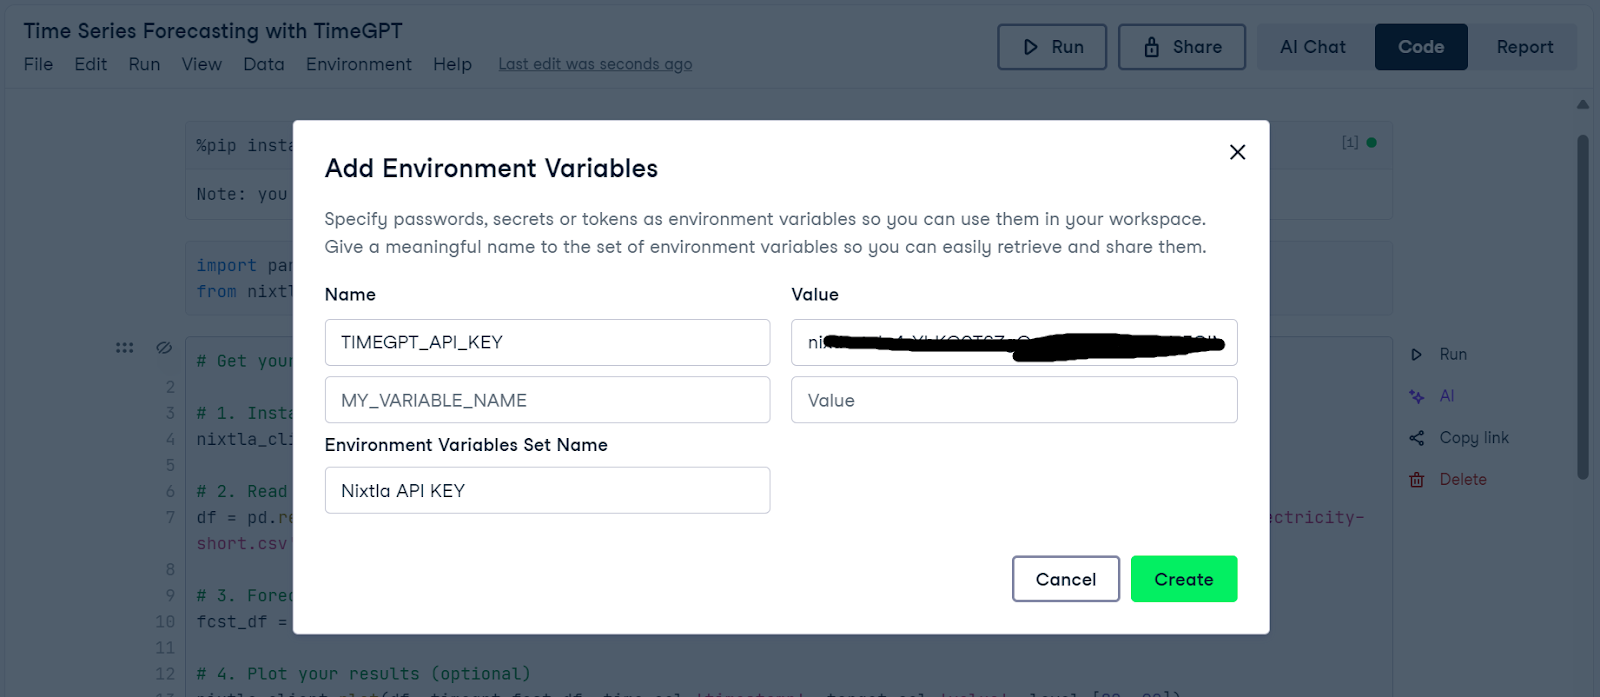
%%capture
%pip install nixtla>=0.5.1
%pip install yfinanceimport pandas as pd
import yfinance as yf
from nixtla import NixtlaClient
import os
timegpt_api_key = os.environ["TIMEGPT_API_KEY"]
# Setup NixtlaClient
nixtla_client = NixtlaClient(api_key = timegpt_api_key)
# Downloading Amazon stock price data
ticker = 'AMZN'
amazon_stock_data = yf.download(ticker)
amazon_stock_data = amazon_stock_data.reset_index()
# Displaying the dataset
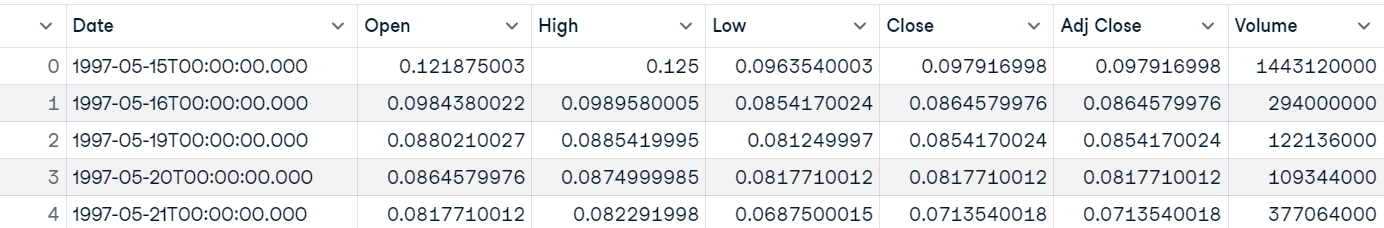
amazon_stock_data.head()Tenemos datos del precio de la acción de Amazon desde 1997 hasta la fecha.
nixtla_client.plot(amazon_stock_data, time_col='Date', target_col='Close')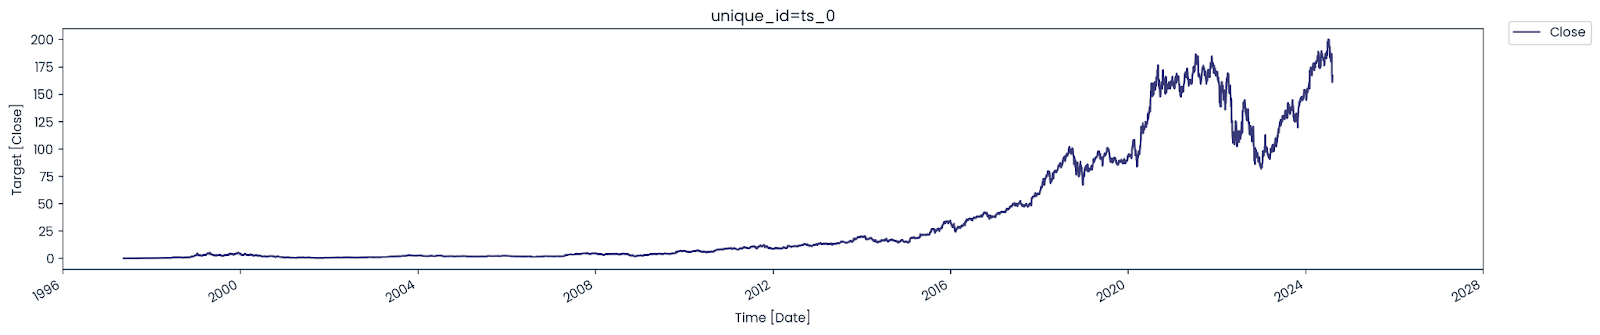
Descubre cómo crear gráficos de líneas de series temporales con Matplotlib en este tutorial de gráfico de líneas de series temporales con Matplotlib.
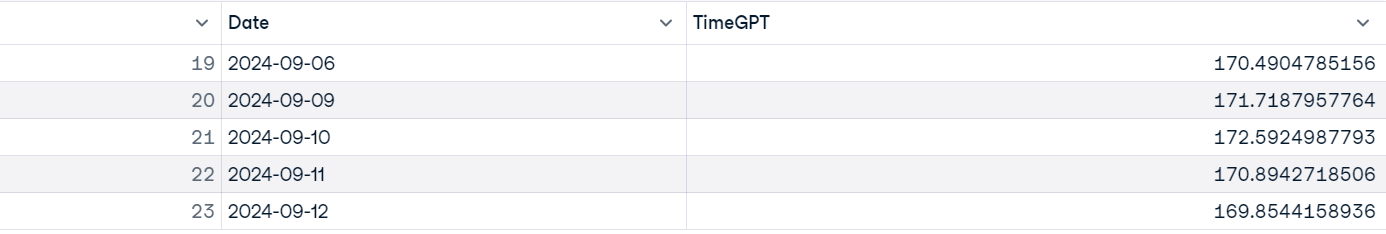
.forecast los datos bursátiles, el nombre del modelo, un horizonte de predicción (equivalente a 24 días), la frecuencia, la columna temporal y la columna objetivo. Como la bolsa cierra los fines de semana, seleccionamos la frecuencia "día laborable (B)".model = nixtla_client.forecast(
df=amazon_stock_data,
model="timegpt-1",
h=24,
freq="B",
time_col="Date",
target_col="Close",
)
model.tail()
nixtla_client.plot(
    amazon_stock_data,
    model,
    time_col="Date",
    target_col="Close",
    max_insample_length=60,
)
Como ves, en unos segundos el modelo TimeGPT predijo con precisión los precios de cierre de Amazon hacia el futuro.
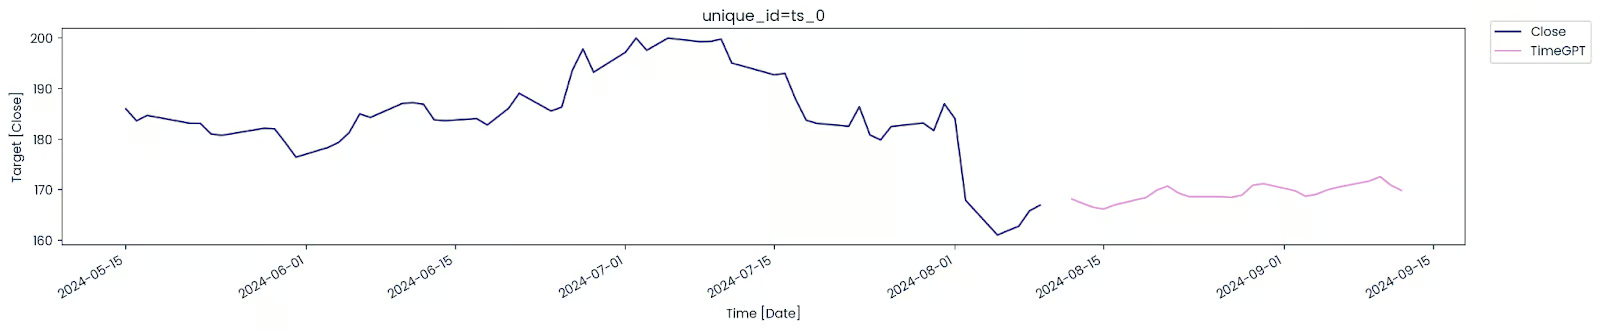
Este fue un ejemplo para principiantes. En la siguiente sección trabajaremos con datasets más complejos y exploraremos varias funciones de la API de Nixtla.
En esta sección usaremos un dataset más complejo de demanda eléctrica australiana y utilizaremos TimeGPT para predecir múltiples valores a la vez.
El dataset incluye 5 series que representan la demanda eléctrica semihoraria de cinco estados de Australia: Victoria, Nueva Gales del Sur, Queensland, Tasmania y Australia Meridional.
También veremos cómo ajustar finamente el modelo y usar varios hiperparámetros para mejorar el rendimiento. Por último, haremos validación cruzada y compararemos su rendimiento con modelos tradicionales para una evaluación completa.
No hay una forma directa de cargar el archivo .tsf con la librería pandas. Debemos crear una función personalizada para leer y procesar los datos y luego convertirlos en un DataFrame de pandas.
import pandas as pd


def read_tsf_from_file(file_path):
    data = []
    start_date = pd.to_datetime("2002-01-01 00:00:00")

    # Open and read the file from the directory

    with open(file_path, "r") as file:
        for line in file:
            if line.startswith("T"):
                parts = line.strip().split(":")
                unique_id = parts[0] + "-" + parts[1]
                values = list(map(float, parts[3].split(",")[:-1]))

                # Generate datetime index at half-hour intervals

                periods = len(values)
                date_range = pd.date_range(
                    start=start_date, periods=periods, freq="30min"
                )

                # Append to data list

                for dt, value in zip(date_range, values):
                    data.append([unique_id, dt, value])
    # Convert the list of data into a DataFrame

    return pd.DataFrame(data, columns=["unique_id", "ds", "y"])


# Example usage

file_path = "australian_electricity_demand_dataset.tsf"
demand_df = read_tsf_from_file(file_path)

# Display the dataframe

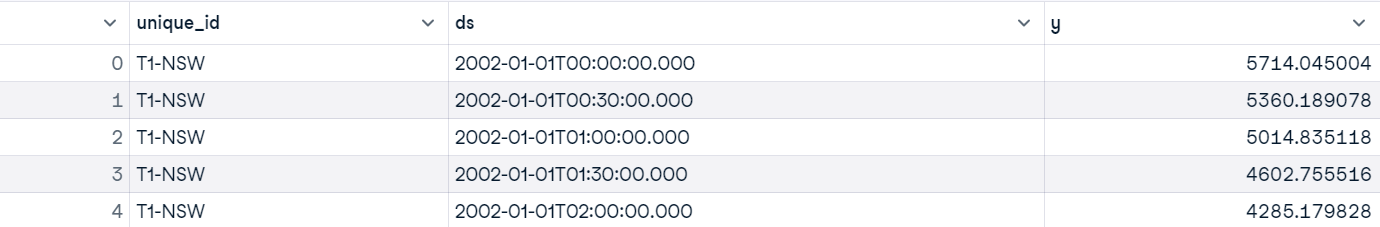
demand_df.head()
Nuestro dataset tiene tres columnas:
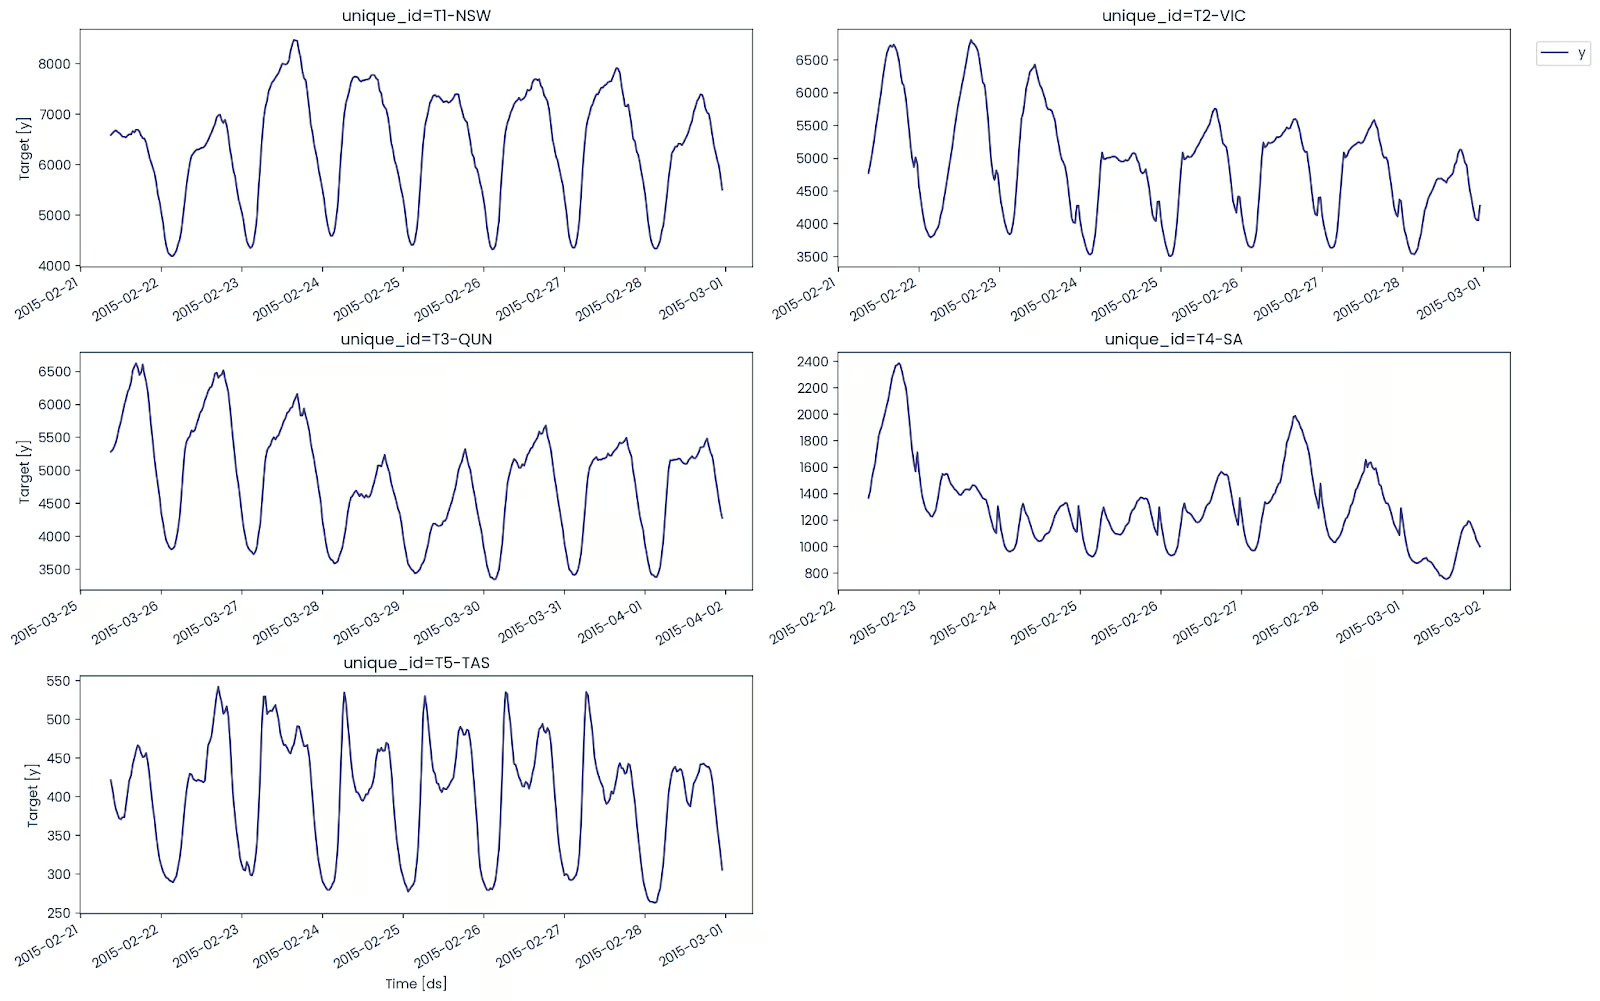
La función de trazado es excelente porque identifica automáticamente la columna unique_id y crea cinco visualizaciones distintas de series temporales.
nixtla_client.plot(
    demand_df,
    max_insample_length=365,
)
La visualización siguiente muestra el consumo eléctrico de los 5 estados, y todos presentan patrones diferentes.
Aprende análisis de series temporales participando en la sesión de code-along en vivo de DataCamp, donde profundizarás en datasets financieros con Python.
En esta sesión exploraremos varias acciones, visualizaremos su comportamiento y haremos predicciones con distintos modelos.
Antes de predecir, identificaremos diversas anomalías en el dataset para entender mejor el problema.
La función .detect_anomalies recibe el dataset, las columnas de tiempo y objetivo, y la frecuencia.
# Detect anomalies
anomalies_df = nixtla_client.detect_anomalies(
    demand_df,
    time_col='ds',
    target_col='y',
    freq='H',
)
anomalies_df[anomalies_df["anomaly"]==1].head()
Hemos mostrado todas las instancias en las que se detectaron anomalías.
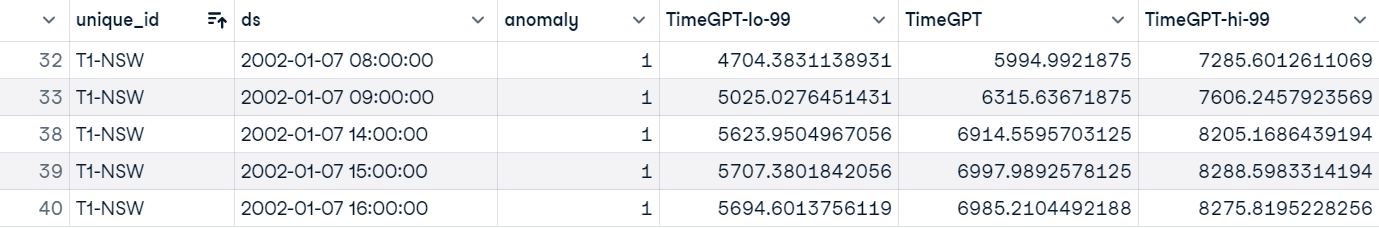
El número total de anomalías en las 5 series es 17.316, que son muchísimas.
anomalies_df.anomaly.value_counts()
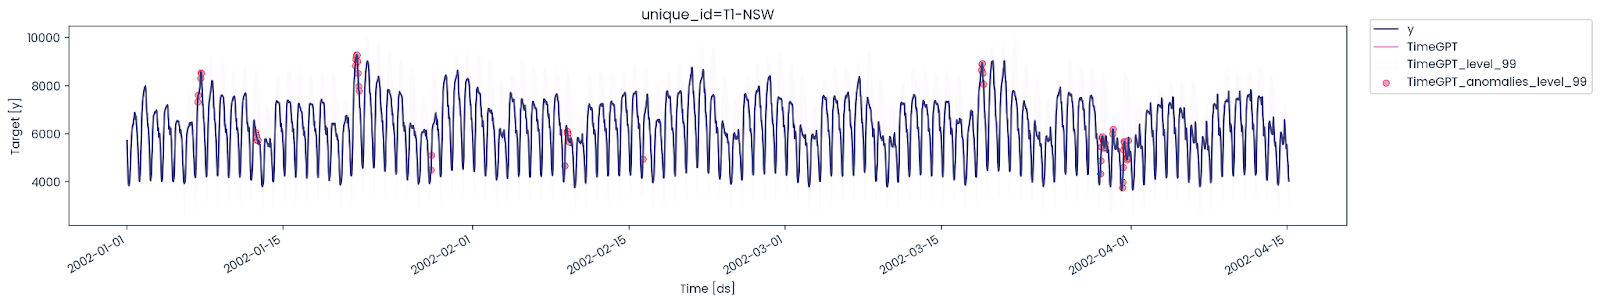
Ahora vamos a representar las anomalías sobre el conjunto real para ver dónde y con qué frecuencia se producen día a día. Para simplificar la visualización, mostraremos solo 5.000 muestras de Nueva Gales del Sur.
# Plot anomalies
nixtla_client.plot(
    demand_df[demand_df["unique_id"]=="T1-NSW"][0:5000],
    anomalies_df[anomalies_df["unique_id"]=="T1-NSW"][0:5000],
    time_col='ds',
    target_col='y',

)
Las anomalías diarias no son comunes, pero ha habido días con múltiples anomalías en una sola jornada.
Ahora vamos a predecir la demanda eléctrica de Nueva Gales del Sur. Para ello, filtraremos solo los valores de "T1-NSW".
T1_df = demand_df[demand_df["unique_id"]=="T1-NSW"]
T1_df.head()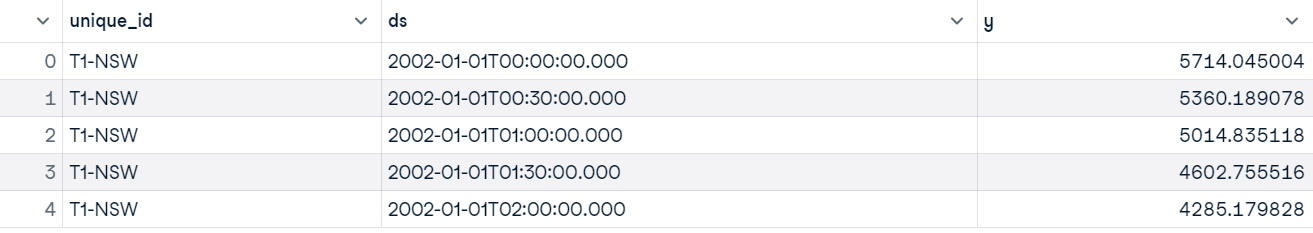
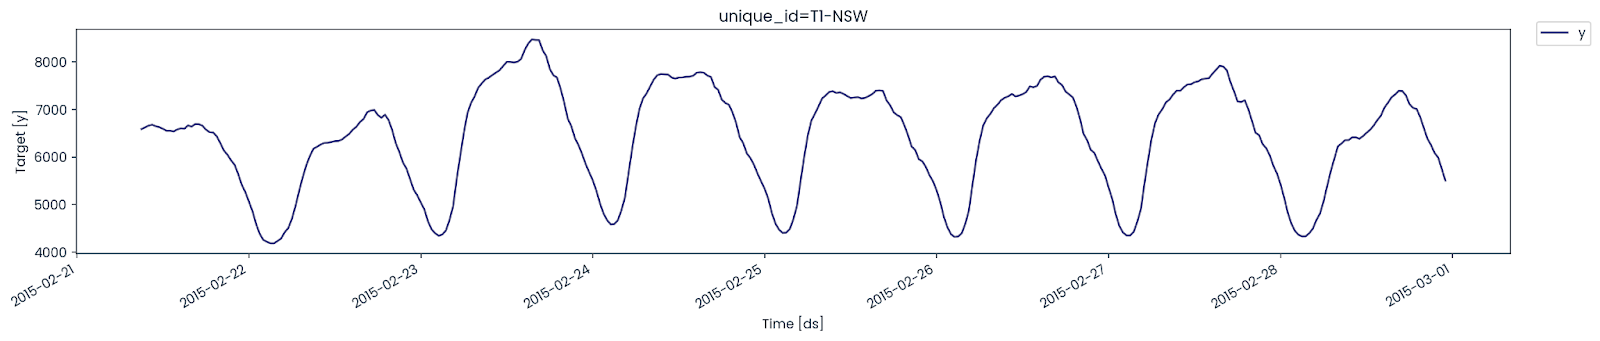
Traza los últimos 365 valores para entender el patrón de consumo eléctrico.
nixtla_client.plot(
    T1_df,
    max_insample_length=365,
)
Ahora evaluaremos el rendimiento del modelo. Para ello, debemos dividir el dataset en entrenamiento y prueba.
El conjunto de entrenamiento consta de 144 valores (3 días) y el de prueba de 1200 valores (25 días).
test_df = T1_df.tail(144) # 3 days = (144 * 0.5h *  1 day/24h)
train_df = T1_df.iloc[-1344:-144] # 25 days = (1200 *0.5h * 1 day/24h)
Para predecir, elegiremos un modelo más adecuado y definiremos varios argumentos para mejorar su rendimiento, concretamente:
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],  # Generate a 90% confidence interval
    finetune_steps=60,  # Specify the number of steps for fine-tuning
    finetune_loss="mae",  # Use the MAE as the loss function for fine-tuning
    model="timegpt-1-long-horizon",  # Use the model for long-horizon forecasting
    time_col="ds",
    target_col="y",
)
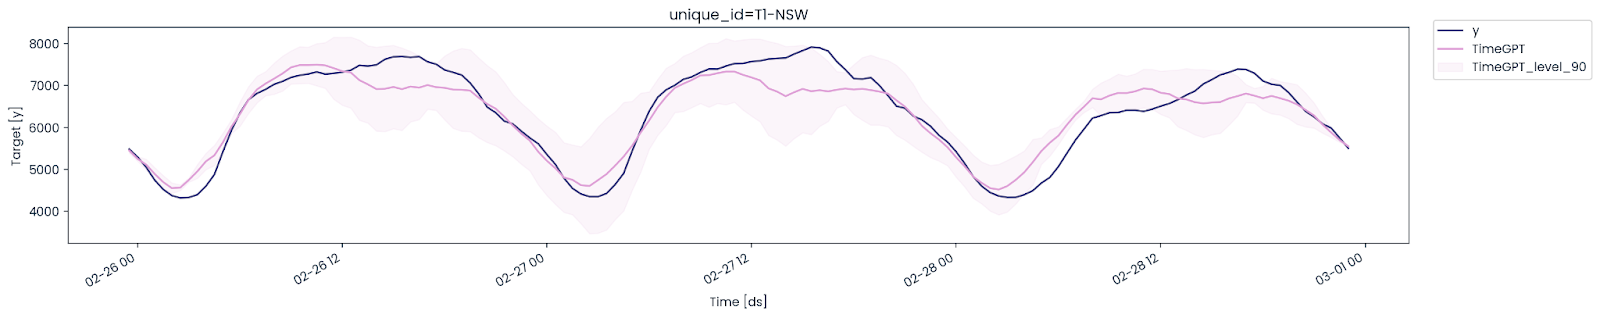
Traza los valores reales, las predicciones y el intervalo de confianza del 90% para evaluar el rendimiento del modelo.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
En pocos segundos obtuvimos un resultado bastante preciso. Esa es la ventaja de los modelos preentrenados.
Ahora evaluaremos el rendimiento con la librería UtilsForecast, parte del proyecto open source de Nixtla. Para ello uniremos los datasets de prueba y predicción y los pasaremos a la función evaluate. La función recibe el dataset, las métricas, los modelos, la columna objetivo y un identificador único para calcular y mostrar las métricas en un DataFrame de pandas.
from utilsforecast.losses import mae, rmse, smape
from utilsforecast.evaluation import evaluate

predict_df["ds"] = pd.to_datetime(predict_df["ds"])
test_df = pd.merge(test_df, predict_df, "left", ["ds", "unique_id"])
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col="unique_id",
)

average_metrics = evaluation.groupby("metric")["TimeGPT"].mean()
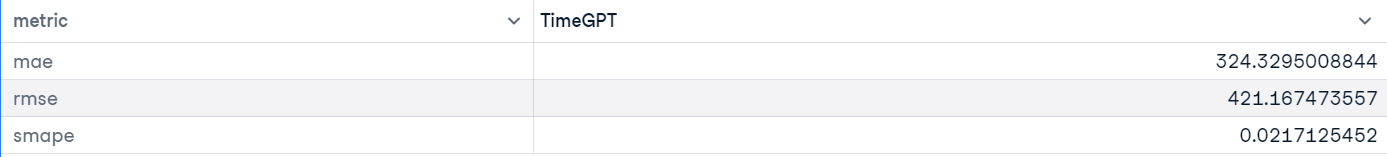
average_metrics
Los resultados son bastante buenos.
La API de Nixtla también te permite predecir varias series a la vez. Usaremos el dataset completo en lugar de filtrar por un identificador único.
Para dividir el dataset en entrenamiento y prueba, usamos groupby para separar 144 valores por cada identificador. De lo contrario, solo tendríamos 144 valores de un identificador elegido al azar.
values for some randomly chosen unique ID.
test_df = demand_df.groupby("unique_id").tail(144)  # 3 days
train_df = (
    demand_df.groupby("unique_id")
    .apply(lambda group: group.iloc[-1344:-144])
    .reset_index(drop=True)
)  # 25 days
La función forecast es la misma que antes, salvo que ahora también incluimos la columna de ID.
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],
    finetune_steps=60,
    finetune_loss='mae',
    model='timegpt-1-long-horizon',
    time_col='ds',
    target_col='y',
    id_col='unique_id'
)
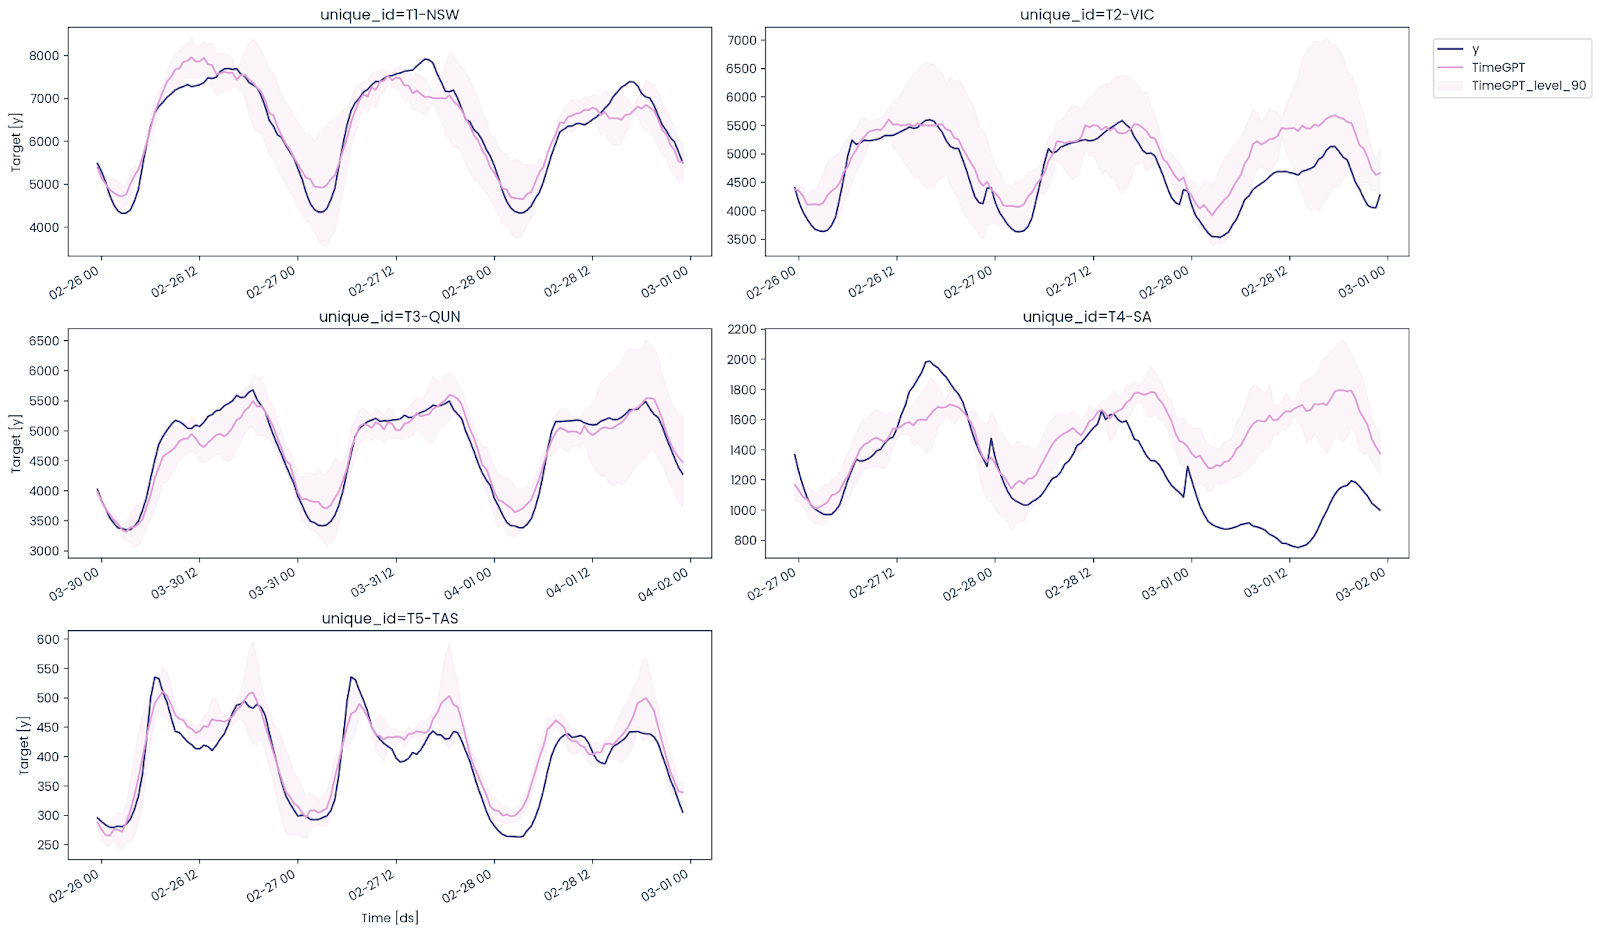
Dibuja el gráfico temporal con los valores reales, las predicciones y el intervalo de confianza del 90% de los 5 identificadores.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Como se aprecia, TimeGPT ha funcionado bien incluso con múltiples series, salvo en Australia Meridional, donde no captó la tendencia descendente de la demanda.
Para evaluar el modelo con MAE, RMSE y SMAPE, tenemos que unir los dataframes de prueba y predicción.
predict_df['ds'] = pd.to_datetime(predict_df['ds'])
test_df = pd.merge(test_df, predict_df, 'left', ['ds','unique_id'])
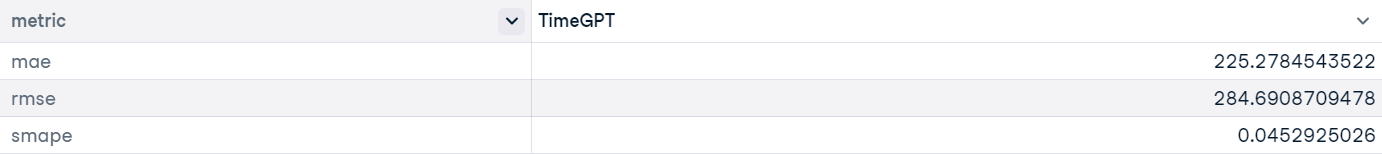
Usa la función evaluate para generar un informe de rendimiento como DataFrame de pandas. Incluirá métricas por identificador único. Para calcular el rendimiento global, promedia los valores y muestra el resultado final.
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "unique_id"
)

average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
El rendimiento global mejora cuando se ajusta el modelo con múltiples series en lugar de una sola.
El cliente de Nixtla también permite realizar validación cruzada para evaluar el rendimiento en distintas ventanas del dataset.
Usaremos la función .cross_validation con el dataset filtrado que contiene solo valores de Nueva Gales del Sur. La validación cruzada tendrá 5 ventanas, cada una de 7 horas.
timegpt_cv_df = nixtla_client.cross_validation(
    T1_df,
    h=7,
    n_windows=5,
    time_col='ds',
    target_col='y',
    freq='H',
)
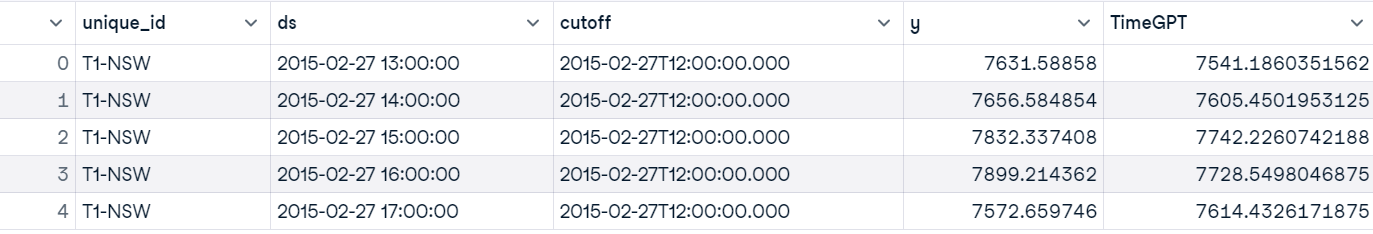
timegpt_cv_df.head()
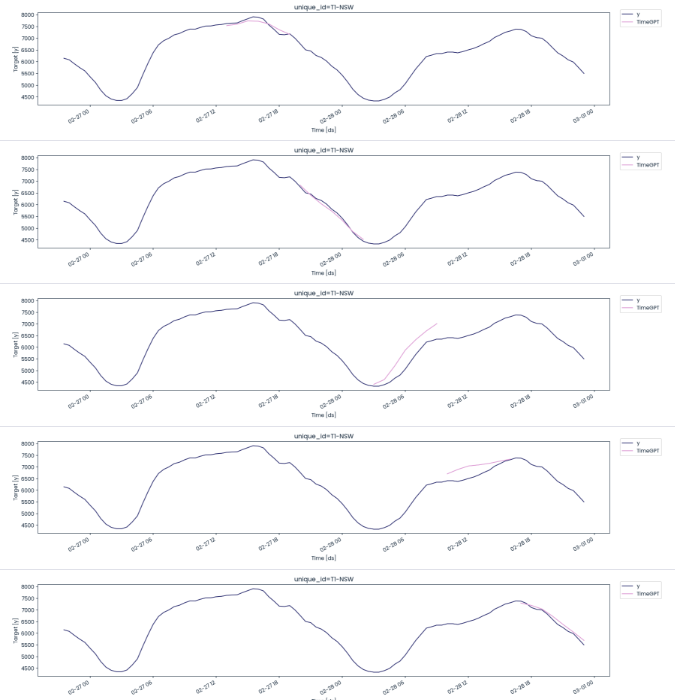
Como ves, hemos obtenido valores predichos para cinco ventanas de 7 horas.
Usaremos una fecha y hora de corte para crear 5 ventanas y mostrar para cada una los valores reales y los predichos.
cutoffs = timegpt_cv_df['cutoff'].unique()
for cutoff in cutoffs:
    fig = nixtla_client.plot(
        T1_df.tail(100),
        timegpt_cv_df.query('cutoff == @cutoff').drop(columns=['cutoff', 'y']),
        time_col='ds',
        target_col='y'
    )
    display(fig)
Salvo en las divisiones 3.ª y 4.ª, el modelo ha funcionado bastante bien.
Comparemos ahora el rendimiento de TimeGPT y Light Gradient-Boosting Machine (LGBM) para ver cuál destaca en el mismo dataset. Ya hemos realizado la validación cruzada sobre el dataframe de Nueva Gales del Sur; el siguiente paso es usar la función evaluate para generar el informe de evaluación.
evaluation = evaluate(
    timegpt_cv_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "cutoff"
)
evaluation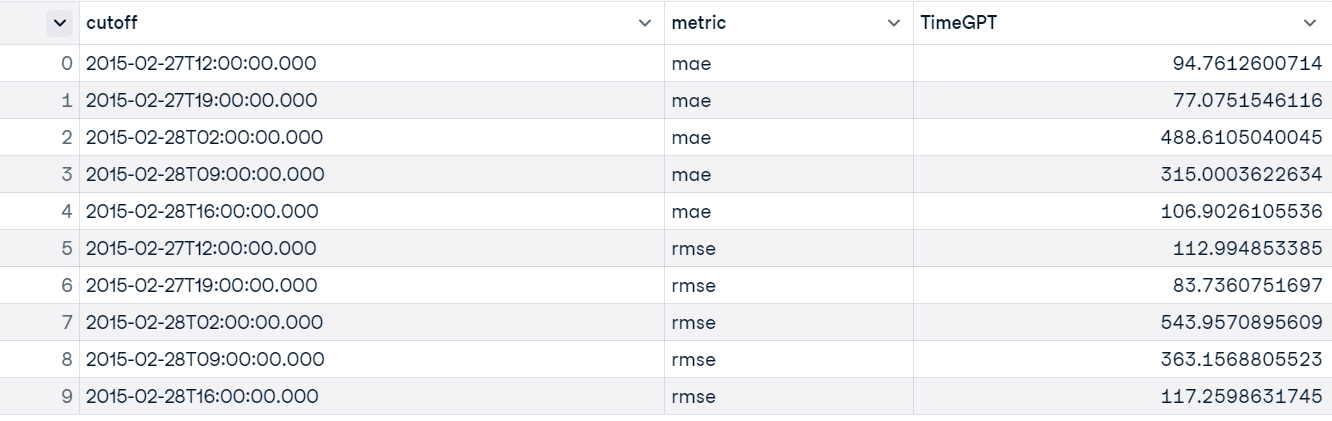
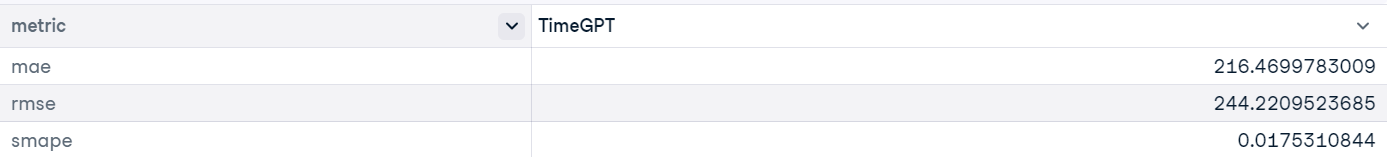
Debemos calcular la media de MAE, RMSE y SMAPE en las 5 ventanas para obtener el resultado global del modelo.
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Los resultados son muy buenos incluso con un conjunto pequeño de valores.
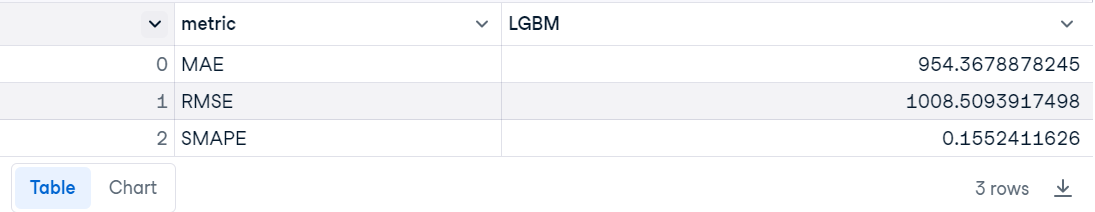
Para evaluar el modelo LGBM, sigue estos pasos:
Nota: para usar modelos estadísticos y de machine learning en predicción de series temporales, es fundamental dominar la ingeniería de características y los algoritmos básicos. Para una guía completa, consulta este tutorial: tutorial de predicción de series temporales en DataCamp.
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import TimeSeriesSplit
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Function to calculate SMAPE
def smape(y_true, y_pred):
    return np.mean(2 * np.abs(y_pred - y_true) / (np.abs(y_true) + np.abs(y_pred)))

# Assuming 'ds' is the date/time column and 'y' is the target variable
T1_df['ds'] = pd.to_datetime(T1_df['ds'])

# Filter the DataFrame to include only the specified datetime range
start_date = '2015-02-27T13:00:00'
end_date = '2015-02-28T23:00:00'
T1_df = T1_df[(T1_df['ds'] >= start_date) & (T1_df['ds'] <= end_date)]

# Convert 'ds' to a numerical value (e.g., timestamp)
T1_df['ds_num'] = T1_df['ds'].apply(lambda x: x.timestamp())

# Create lag and window features
for lag in range(1, 4):
    T1_df[f'lag_{lag}'] = T1_df['y'].shift(lag)

T1_df['rolling_mean'] = T1_df['y'].rolling(window=3).mean()
T1_df['rolling_std'] = T1_df['y'].rolling(window=3).std()

# Drop NaN values resulting from lag and rolling operations
T1_df.dropna(inplace=True)

# Select features for the model
X = T1_df[['ds_num', 'lag_1', 'lag_2', 'lag_3', 'rolling_mean', 'rolling_std']]
y = T1_df['y']

# Time series split
tscv = TimeSeriesSplit(n_splits=5)
mae_scores = []
rmse_scores = []
smape_scores = []

for train_index, test_index in tscv.split(X):
    X_train, X_test = X.iloc[train_index], X.iloc[test_index]
    y_train, y_test = y.iloc[train_index], y.iloc[test_index]

    # Initialize and train the LGBM model
    model = lgb.LGBMRegressor(force_row_wise=True, verbosity=-1)
    model.fit(X_train, y_train)

    # Make predictions
    y_pred = model.predict(X_test)

    # Evaluate the model
    mae = mean_absolute_error(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))
    smape_value = smape(y_test, y_pred)

    mae_scores.append(mae)
    rmse_scores.append(rmse)
    smape_scores.append(smape_value)

# Convert the metrics into a DataFrame
mae_avg = np.mean(mae_scores)
rmse_avg = np.mean(rmse_scores)
smape_avg = np.mean(smape_scores)

metrics_df = pd.DataFrame({
    'metric': ['MAE', 'RMSE', 'SMAPE'],
    'LGBM': [mae_avg, rmse_avg, smape_avg]
})

# Display the DataFrame
metrics_df
TimeGPT es casi 5 veces mejor que LGBM.
Si tienes problemas para ejecutar el código anterior o configurar TimeGPT, echa un vistazo al espacio de trabajo de DataLab: predicción de series temporales con TimeGPT.
El ecosistema de TimeGPT y Nixtla es ideal para empresas que están empezando, ya que elimina la necesidad de contratar ingenieros de machine learning para entrenar modelos e ingenieros de MLOps para desplegarlos y mantenerlos. Si eres una startup, puedes reducir costes significativamente y seguir accediendo a modelos de alto rendimiento.
Al igual que GPT-3, TimeGPT marca el inicio de modelos punteros para series temporales y, a medida que mejoren, muchas empresas adoptarán la API de Nixtla por su facilidad de integración y su rendimiento.
En este tutorial hemos explorado TimeGPT, el primer modelo fundacional para series temporales. Además, hemos aprendido a usar la API de Python para acceder a TimeGPT en tareas como predicción, visualización de series temporales, evaluación de modelos, validación cruzada y detección de anomalías.
Aprende a predecir el futuro con modelos de la familia ARIMA y a generar predicciones y conclusiones con modelos de machine learning en el itinerario de aprendizaje Time Series with Python. Si prefieres R, prueba el itinerario Time Series with R para comprender a fondo la predicción de series temporales.
Cursos destacados de DataCamp
programa
programa
programa
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
blog
Abid Ali Awan
9 min
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
12 min
Tutorial
Arunn Thevapalan
12 min







