

TimeGPT के साथ शुरुआत
TimeGPT मॉडल ओपन सोर्स नहीं है, और आप इसे केवल Nixtla API के माध्यम से एक्सेस कर सकते हैं। इस खंड में हम TimeGPT मॉडल तक पहुँचने और Amazon स्टॉक डेटा का पूर्वानुमान लगाने के लिए Nixtla API सेटअप करना सीखेंगे।
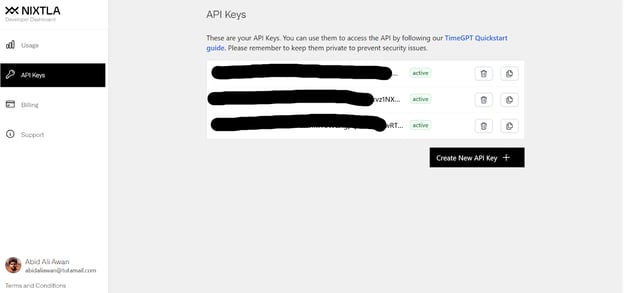
- हमें dashboard.nixtla.io पर जाकर एक API कुंजी जनरेट करनी होगी। यह API कुंजी बनाने के लिए अकाउंट क्रिएट करने का संकेत देगा। वर्तमान में, हम TimeGPT को निःशुल्क एक्सेस कर सकते हैं, लेकिन API कॉल्स पर कुछ सीमाएँ हैं।
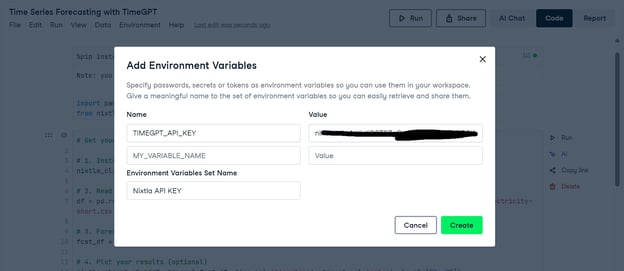
- हम अपने कोडिंग वातावरण के रूप में DataCamp का DataLab उपयोग कर रहे हैं। DataLab एक निःशुल्क क्लाउड-आधारित Jupyter Notebook है, जो किसी को भी कुछ सेकंड में कोडिंग शुरू करने में सक्षम बनाता है। DataLab में एनवायरनमेंट वेरिएबल सेट करने के लिए, "Environment" टैब पर क्लिक करें, फिर "Environment variables..." बटन, "+ Add" पर क्लिक करें, और वेरिएबल नाम और API कुंजी जोड़ें।
- मॉडल के लिए Nixtla Python क्लाइंट और स्टॉक एक्सचेंज डेटासेट के लिए Yahoo Finance लाइब्रेरी इंस्टॉल करें।
%%capture
%pip install nixtla>=0.5.1
%pip install yfinance- TimeGPT API कुंजी का उपयोग करके Nixtla क्लाइंट बनाएँ।
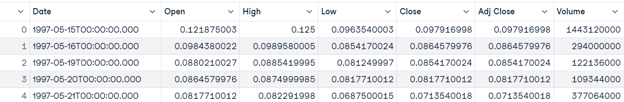
- Amazon स्टॉक प्राइस डेटा डाउनलोड करें, इंडेक्स रीसेट करें, और पहली पाँच पंक्तियाँ दिखाएँ।
import pandas as pd
import yfinance as yf
from nixtla import NixtlaClient
import os
timegpt_api_key = os.environ["TIMEGPT_API_KEY"]
# Setup NixtlaClient
nixtla_client = NixtlaClient(api_key = timegpt_api_key)
# Downloading Amazon stock price data
ticker = 'AMZN'
amazon_stock_data = yf.download(ticker)
amazon_stock_data = amazon_stock_data.reset_index()
# Displaying the dataset
amazon_stock_data.head()हमारे पास 1997 से वर्तमान तक का Amazon स्टॉक प्राइस डेटा है।
- Nixtla क्लाइंट का उपयोग करके हम स्टॉक प्राइस डेटा आसानी से प्लॉट कर सकते हैं।
nixtla_client.plot(amazon_stock_data, time_col='Date', target_col='Close')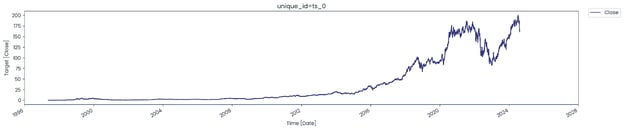
Matplotlib का उपयोग करके टाइम सीरीज़ लाइन प्लॉट बनाना सीखें: Matplotlib Time Series Line Plot ट्यूटोरियल।
- पूर्वानुमान करने के लिए, हमें
.forecastफ़ंक्शन को स्टॉक डेटा, मॉडल नाम, फोरकास्ट होराइज़न (24 दिन के बराबर), फ़्रीक्वेंसी, टाइम कॉलम, और लक्ष्य कॉलम देने होंगे। चूँकि स्टॉक एक्सचेंज वीकेंड पर बंद रहता है, हम फ़्रीक्वेंसी "बिज़नेस डे (B)" चुनते हैं।
model = nixtla_client.forecast(
df=amazon_stock_data,
model="timegpt-1",
h=24,
freq="B",
time_col="Date",
target_col="Close",
)
model.tail()
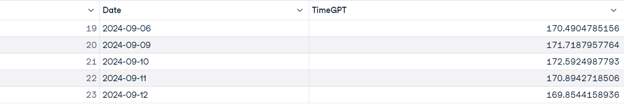
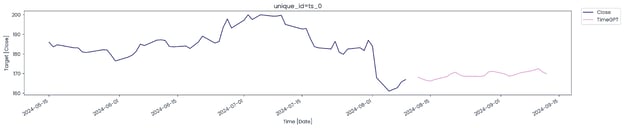
- वास्तविक और पूर्वानुमित डेटासेट्स को अधिकतम सैंपल लंबाई 60 के साथ प्लॉट करें। इसका मतलब है कि मॉडल की भविष्यवाणी को ज़्यादा ज़ूम-इन रूप में दिखाने के लिए केवल नवीनतम 60 मान प्लॉट होंगे।
nixtla_client.plot(
amazon_stock_data,
model,
time_col="Date",
target_col="Close",
max_insample_length=60,
)
जैसा कि हम देख सकते हैं, कुछ ही सेकंड में TimeGPT मॉडल ने Amazon के क्लोज़ प्राइस का भविष्य सटीक रूप से अनुमानित किया है।
यह एक शुरुआती उदाहरण था। अगले सत्र में, हम और जटिल डेटासेट्स पर काम करेंगे और Nixtla API की विभिन्न विशेषताओं का पता लगाएंगे।
TimeGPT का उपयोग करके ऑस्ट्रेलियाई बिजली मांग का पूर्वानुमान
इस खंड में, हम Australian Electricity Demand जैसे अधिक जटिल डेटासेट का उपयोग करेंगे और TimeGPT मॉडल से एक साथ कई मानों का पूर्वानुमान लगाएंगे।
डेटासेट में 5 टाइम सीरीज़ शामिल हैं जो ऑस्ट्रेलिया के 5 राज्यों—विक्टोरिया, न्यू साउथ वेल्स, क्वींसलैंड, तस्मानिया, और साउथ ऑस्ट्रेलिया—की आधे-घंटे की बिजली मांग का प्रतिनिधित्व करती हैं।
हम यह भी सीखेंगे कि मॉडल को कैसे फाइन-ट्यून करें और प्रदर्शन बढ़ाने के लिए विभिन्न हाइपरपैरामीटर्स का उपयोग कैसे करें। अंत में, हम क्रॉस-वैलिडेशन करेंगे और समग्र आकलन के लिए मॉडल के प्रदर्शन की पारंपरिक मॉडलों से तुलना करेंगे।
डेटासेट लोड करना
pandas लाइब्रेरी में .tsf फ़ाइल लोड करने का कोई सरल तरीका नहीं है। हमें डेटा लोड और प्रोसेस करने के लिए कस्टम फ़ंक्शन बनाना होगा और फिर उसे Pandas डाटा फ़्रेम में बदलना होगा।
import pandas as pd
def read_tsf_from_file(file_path):
data = []
start_date = pd.to_datetime("2002-01-01 00:00:00")
# Open and read the file from the directory
with open(file_path, "r") as file:
for line in file:
if line.startswith("T"):
parts = line.strip().split(":")
unique_id = parts[0] + "-" + parts[1]
values = list(map(float, parts[3].split(",")[:-1]))
# Generate datetime index at half-hour intervals
periods = len(values)
date_range = pd.date_range(
start=start_date, periods=periods, freq="30min"
)
# Append to data list
for dt, value in zip(date_range, values):
data.append([unique_id, dt, value])
# Convert the list of data into a DataFrame
return pd.DataFrame(data, columns=["unique_id", "ds", "y"])
# Example usage
file_path = "australian_electricity_demand_dataset.tsf"
demand_df = read_tsf_from_file(file_path)
# Display the dataframe
demand_df.head()
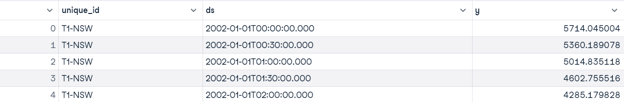
हमारे डेटासेट में तीन कॉलम हैं:
- unique_id: ऑस्ट्रेलिया के 5 राज्यों का प्रतिनिधित्व करता है।
- ds: दिनांक और समय।
- y: बिजली की मांग।
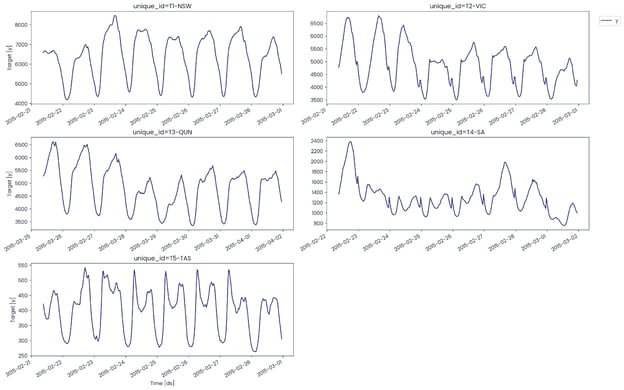
plot फ़ंक्शन बेहतरीन है क्योंकि यह अपने-आप unique_id कॉलम की पहचान कर लेता है और पाँच अलग-अलग टाइम सीरीज़ विज़ुअलाइज़ेशन बनाता है।
nixtla_client.plot(
demand_df,
max_insample_length=365,
)नीचे का विज़ुअलाइज़ेशन 5 राज्यों की बिजली खपत दिखाता है, और सभी के पैटर्न अलग-अलग हैं।
टाइम सीरीज़ विश्लेषण सीखें DataCamp के लाइव कोड-अलॉन्ग सत्र में, जहाँ आप Python का उपयोग करके वित्तीय टाइम सीरीज़ डेटासेट्स में गहराई से जाएँगे।
इस सत्र में, हम विभिन्न स्टॉक्स का अन्वेषण करेंगे, उनके प्रदर्शन का विज़ुअलाइज़ेशन करेंगे, और अलग-अलग मॉडलों से पूर्वानुमान लगाएंगे।
विसंगति (Anomaly) जाँच
पूर्वानुमान से पहले, हम समस्या को बेहतर समझने के लिए डेटासेट में विभिन्न विसंगतियों की पहचान करेंगे।
.detect_anomalies फ़ंक्शन डेटासेट, समय और लक्ष्य कॉलम, और फ़्रीक्वेंसी लेता है।
# Detect anomalies
anomalies_df = nixtla_client.detect_anomalies(
demand_df,
time_col='ds',
target_col='y',
freq='H',
)
anomalies_df[anomalies_df["anomaly"]==1].head()हमने वे सभी उदाहरण दिखाए हैं जहाँ विसंगतियाँ पाई गईं।
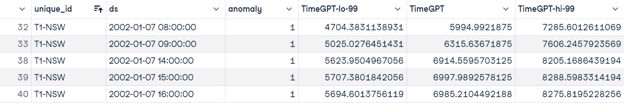
सभी 5 टाइम सीरीज़ डेटासेट्स में कुल विसंगतियों की संख्या 17,316 है, जो काफ़ी अधिक है।
anomalies_df.anomaly.value_counts()
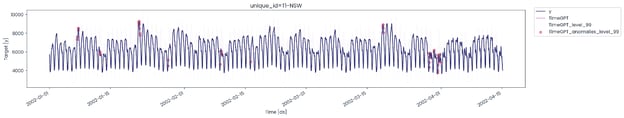
अब, हम वास्तविक डेटासेट पर विसंगतियों को प्लॉट करेंगे ताकि देखें कि वे कहाँ और कितनी बार रोज़ाना होती हैं। विज़ुअलाइज़ेशन सरल रखने के लिए, हम न्यू साउथ वेल्स के केवल 5,000 सैंपल दिखाएँगे।
# Plot anomalies
nixtla_client.plot(
demand_df[demand_df["unique_id"]=="T1-NSW"][0:5000],
anomalies_df[anomalies_df["unique_id"]=="T1-NSW"][0:5000],
time_col='ds',
target_col='y',
)दैनिक आधार पर विसंगतियाँ आम नहीं हैं, लेकिन कुछ दिन ऐसे रहे हैं जब एक ही दिन में कई विसंगतियाँ हुई हैं।
TimeGPT के साथ एकल सीरीज़ का पूर्वानुमान
अब हम न्यू साउथ वेल्स की बिजली मांग का पूर्वानुमान लगाएंगे। इसके लिए, हम केवल "T1-NSW" के मान फ़िल्टर करेंगे।
T1_df = demand_df[demand_df["unique_id"]=="T1-NSW"]
T1_df.head()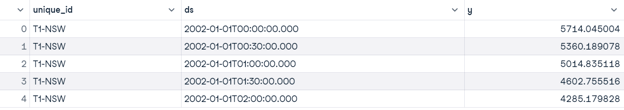
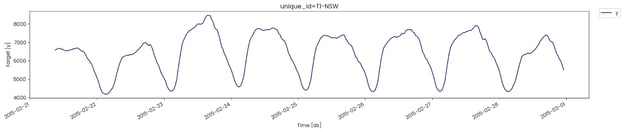
बिजली खपत का पैटर्न समझने के लिए नवीनतम 365 मानों को प्लॉट करें।
nixtla_client.plot(
T1_df,
max_insample_length=365,
)
अब हम अपने मॉडल के प्रदर्शन का मूल्यांकन करेंगे। इसके लिए, हमें डेटासेट को प्रशिक्षण और परीक्षण सेट में विभाजित करना होगा।
प्रशिक्षण सेट में 144 मान (3 दिन) और परीक्षण सेट में 1200 मान (25 दिन) होंगे।
test_df = T1_df.tail(144) # 3 days = (144 * 0.5h * 1 day/24h)
train_df = T1_df.iloc[-1344:-144] # 25 days = (1200 *0.5h * 1 day/24h)पूर्वानुमान के लिए, हम एक बेहतर मॉडल चुनेंगे और प्रदर्शन सुधारने हेतु विभिन्न आर्ग्युमेंट्स सेट करेंगे, विशेष रूप से:
- अगले 144 मान (3 दिन) का पूर्वानुमान।
- 90% कॉन्फिडेंस इंटरवल का पूर्वानुमान।
- मॉडल को 60 चरणों तक फाइन-ट्यून करें; यह अधिक है, लेकिन बेहतर परिणाम देगा।
- लॉस फ़ंक्शन MAE सेट करें।
- साधारण मॉडल की बजाय TimeGPT-1-long-horizon मॉडल का उपयोग करें।
- टाइम और टार्गेट कॉलम सेट करें।
predict_df = nixtla_client.forecast(
df=train_df,
h=144,
level=[90], # Generate a 90% confidence interval
finetune_steps=60, # Specify the number of steps for fine-tuning
finetune_loss="mae", # Use the MAE as the loss function for fine-tuning
model="timegpt-1-long-horizon", # Use the model for long-horizon forecasting
time_col="ds",
target_col="y",
)
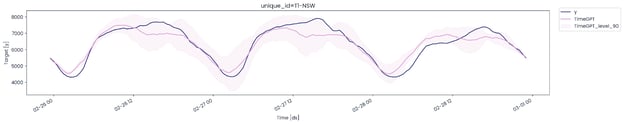
मॉडल के प्रदर्शन का आकलन करने के लिए वास्तविक मान, पूर्वानुमान, और 90% कॉन्फिडेंस इंटरवल को प्लॉट करें।
nixtla_client.plot(
test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
कुछ ही सेकंड में हमें काफ़ी सटीक परिणाम मिला। यही प्री-ट्रेंड मॉडलों की ताकत है।
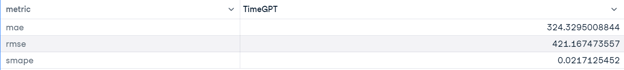
अब हम Nixtla के ओपन-सोर्स प्रोजेक्ट का हिस्सा UtilsForecast लाइब्रेरी उपयोग करके मॉडल का मूल्यांकन करेंगे। इसके लिए, हम टेस्ट और फोरकास्ट डेटासेट्स को मर्ज करेंगे और फिर उन्हें evaluate फ़ंक्शन को देंगे। यह फ़ंक्शन डेटासेट, मेट्रिक्स, मॉडल्स, लक्ष्य कॉलम, और यूनिक आईडी लेता है, मॉडल मेट्रिक्स की गणना करता है और उन्हें pandas डाटा फ़्रेम के रूप में दिखाता है।
from utilsforecast.losses import mae, rmse, smape
from utilsforecast.evaluation import evaluate
predict_df["ds"] = pd.to_datetime(predict_df["ds"])
test_df = pd.merge(test_df, predict_df, "left", ["ds", "unique_id"])
evaluation = evaluate(
test_df,
metrics=[mae, rmse, smape],
models=["TimeGPT"],
target_col="y",
id_col="unique_id",
)
average_metrics = evaluation.groupby("metric")["TimeGPT"].mean()
average_metricsहमें काफ़ी अच्छे परिणाम मिले हैं।
TimeGPT के साथ एकाधिक सीरीज़ का पूर्वानुमान
Nixtla API आपको एक साथ कई सीरीज़ का पूर्वानुमान लगाने की सुविधा भी देता है। हम यूनिक आईडी पर फ़िल्टर करने के बजाय पूरे डेटासेट का उपयोग करेंगे।
डेटासेट को ट्रेन और टेस्ट सेट में बाँटने के लिए, हम groupby का उपयोग करते हैं ताकि हर यूनिक आईडी के लिए 144 मान अलग किए जा सकें। अन्यथा, हमारे पास केवल किसी एक यादृच्छिक यूनिक आईडी के 144 मान ही रह जाते।
values for some randomly chosen unique ID.
test_df = demand_df.groupby("unique_id").tail(144) # 3 days
train_df = (
demand_df.groupby("unique_id")
.apply(lambda group: group.iloc[-1344:-144])
.reset_index(drop=True)
) # 25 daysforecast फ़ंक्शन पहले की तरह ही है, बस इस बार हम आईडी कॉलम भी शामिल कर रहे हैं।
predict_df = nixtla_client.forecast(
df=train_df,
h=144,
level=[90],
finetune_steps=60,
finetune_loss='mae',
model='timegpt-1-long-horizon',
time_col='ds',
target_col='y',
id_col='unique_id'
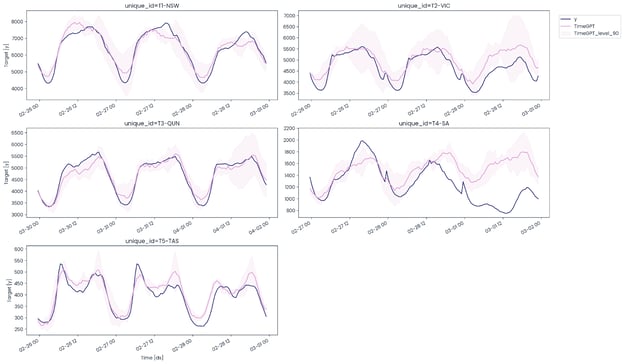
)सभी 5 यूनिक आईडी के वास्तविक, पूर्वानुमानित, और 90 कॉन्फिडेंस लेवल के मानों का टाइम सीरीज़ ग्राफ़ प्लॉट करें।
nixtla_client.plot(
test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)जैसा कि हम देख रहे हैं, TimeGPT मॉडल ने कई टाइम सीरीज़ पर भी अच्छा प्रदर्शन किया है, सिवाय साउथ ऑस्ट्रेलिया के। यह वहाँ बिजली मांग में गिरते रुझान का पूर्वानुमान नहीं कर सका।
MAE, RMSE, और SMAPE मेट्रिक्स से मॉडल का मूल्यांकन करने के लिए हमें टेस्ट और फोरकास्ट डाटा फ़्रेम्स को मर्ज करना होगा।
predict_df['ds'] = pd.to_datetime(predict_df['ds'])
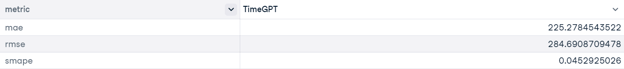
test_df = pd.merge(test_df, predict_df, 'left', ['ds','unique_id'])evaluate फ़ंक्शन का उपयोग करके मॉडल प्रदर्शन रिपोर्ट pandas डाटा फ़्रेम के रूप में बनाएँ। इसमें प्रत्येक यूनिक आईडी के लिए मॉडल मेट्रिक्स होंगे। मॉडल के समग्र प्रदर्शन की गणना करने के लिए, हमें मानों का औसत लेना होगा और अंतिम परिणाम दिखाना होगा।
evaluation = evaluate(
test_df,
metrics=[mae, rmse, smape],
models=["TimeGPT"],
target_col="y",
id_col = "unique_id"
)
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metricsएकल सीरीज़ की तुलना में कई टाइम सीरीज़ पर फाइन-ट्यून करने से समग्र प्रदर्शन बेहतर होता है।
क्रॉस-वैलिडेशन
Nixtla क्लाइंट आपको डेटासेट की विभिन्न विंडो पर मॉडल प्रदर्शन के आकलन हेतु क्रॉस-वैलिडेशन करने देता है।
हम .cross_validation फ़ंक्शन का उपयोग करेंगे और उसे केवल न्यू साउथ वेल्स के मानों वाला फ़िल्टर किया हुआ डेटासेट देंगे। क्रॉस-वैलिडेशन में 5 विंडो होंगी, प्रत्येक 7 घंटे लंबी।
timegpt_cv_df = nixtla_client.cross_validation(
T1_df,
h=7,
n_windows=5,
time_col='ds',
target_col='y',
freq='H',
)
timegpt_cv_df.head()जैसा कि हम देख सकते हैं, हमें पाँच 7-घंटे की विंडो पर आधारित पूर्वानुमान मान मिले हैं।
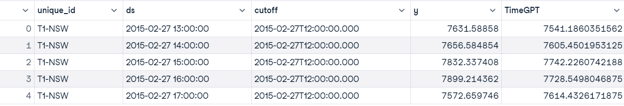
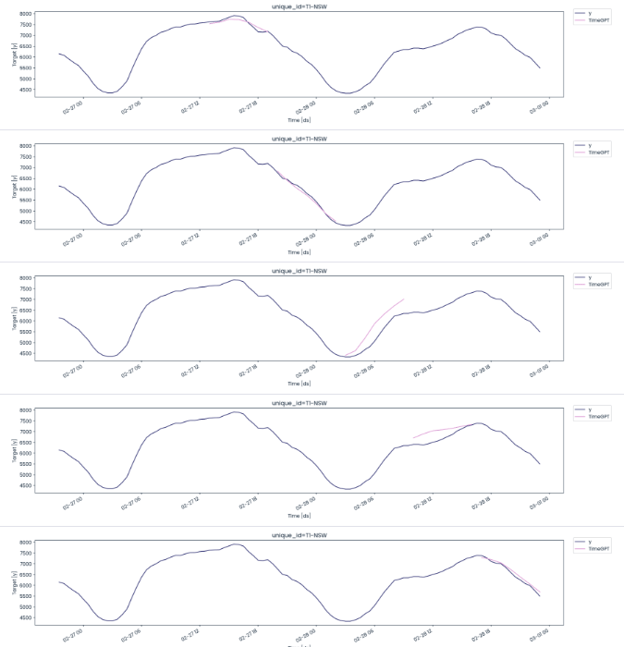
हम 5 विंडो बनाने के लिए एक कटऑफ़ दिनांक और समय उपयोग करेंगे, प्रत्येक में पूर्वानुमानित और वास्तविक मान दिखेंगे।
cutoffs = timegpt_cv_df['cutoff'].unique()
for cutoff in cutoffs:
fig = nixtla_client.plot(
T1_df.tail(100),
timegpt_cv_df.query('cutoff == @cutoff').drop(columns=['cutoff', 'y']),
time_col='ds',
target_col='y'
)
display(fig)तीसरे और चौथे स्प्लिट को छोड़कर, मॉडल ने काफ़ी अच्छा प्रदर्शन किया है।
LGBM और TimeGPT की तुलना
अब आइए TimeGPT और Light Gradient-Boosting Machine (LGBM) मॉडलों के प्रदर्शन की तुलना करें ताकि एक ही डेटासेट पर कौन बेहतर है, यह स्पष्ट हो सके। हमने पहले ही न्यू साउथ वेल्स डाटा फ़्रेम पर क्रॉस-वैलिडेशन किया है; अगला कदम evaluate फ़ंक्शन से मॉडल मूल्यांकन रिपोर्ट जनरेट करना है।
evaluation = evaluate(
timegpt_cv_df,
metrics=[mae, rmse, smape],
models=["TimeGPT"],
target_col="y",
id_col = "cutoff"
)
evaluation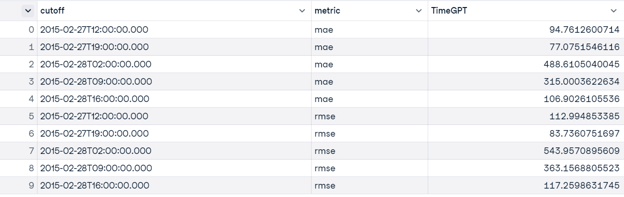
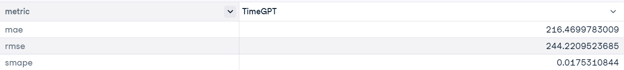
मॉडल के समग्र परिणाम प्राप्त करने के लिए हमें सभी 5 विंडो के MAE, RMSE, और SMAPE का औसत निकालना होगा।
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metricsकम मानों के छोटे सेट पर भी परिणाम काफ़ी अच्छे हैं।
LGBM मॉडल का मूल्यांकन करने के लिए हमें ये चरण अपनाने होंगे:
- डेटा फ़िल्टर करें: सुनिश्चित करें कि डेटा TimeGPT क्रॉस-वैलिडेशन में उपयोग किए गए मानों से मेल खाता हो।
- दिनांक-समय रूपांतरण: दिनांक-समय सूचना को संख्यात्मक मानों में बदलें।
- फ़ीचर इंजीनियरिंग: लैग और रोलिंग विंडो तकनीकों से अतिरिक्त फीचर्स बनाएँ।
- मिसिंग मान हैंडल करें: लैग और रोलिंग विंडो बनाने से उत्पन्न मिसिंग मानों को हटा दें।
- मॉडलिंग हेतु डेटा तैयार करें: फीचर मैट्रिक्स X और लक्ष्य वेक्टर y परिभाषित करें, फिर TimeSeriesSplit से विभाजित करें।
- ट्रेन और मूल्यांकन: मॉडल को ट्रेन करें, मूल्यांकन करें, और हर स्प्लिट के मेट्रिक्स रिकॉर्ड करें।
- परिणाम समेकित करें: प्रत्येक मॉडल मेट्रिक का औसत निकालें और परिणाम pandas डाटा फ़्रेम में दिखाएँ।
नोट: टाइम सीरीज़ पूर्वानुमान के लिए सांख्यिकीय और मशीन लर्निंग मॉडल का उपयोग करते समय बुनियादी फ़ीचर इंजीनियरिंग तकनीकें और एल्गोरिदम सीखना आवश्यक है। इन विषयों की संपूर्ण मार्गदर्शिका के लिए यह ट्यूटोरियल देखें: DataCamp पर टाइम सीरीज़ पूर्वानुमान ट्यूटोरियल।
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import TimeSeriesSplit
from sklearn.metrics import mean_absolute_error, mean_squared_error
# Function to calculate SMAPE
def smape(y_true, y_pred):
return np.mean(2 * np.abs(y_pred - y_true) / (np.abs(y_true) + np.abs(y_pred)))
# Assuming 'ds' is the date/time column and 'y' is the target variable
T1_df['ds'] = pd.to_datetime(T1_df['ds'])
# Filter the DataFrame to include only the specified datetime range
start_date = '2015-02-27T13:00:00'
end_date = '2015-02-28T23:00:00'
T1_df = T1_df[(T1_df['ds'] >= start_date) & (T1_df['ds'] <= end_date)]
# Convert 'ds' to a numerical value (e.g., timestamp)
T1_df['ds_num'] = T1_df['ds'].apply(lambda x: x.timestamp())
# Create lag and window features
for lag in range(1, 4):
T1_df[f'lag_{lag}'] = T1_df['y'].shift(lag)
T1_df['rolling_mean'] = T1_df['y'].rolling(window=3).mean()
T1_df['rolling_std'] = T1_df['y'].rolling(window=3).std()
# Drop NaN values resulting from lag and rolling operations
T1_df.dropna(inplace=True)
# Select features for the model
X = T1_df[['ds_num', 'lag_1', 'lag_2', 'lag_3', 'rolling_mean', 'rolling_std']]
y = T1_df['y']
# Time series split
tscv = TimeSeriesSplit(n_splits=5)
mae_scores = []
rmse_scores = []
smape_scores = []
for train_index, test_index in tscv.split(X):
X_train, X_test = X.iloc[train_index], X.iloc[test_index]
y_train, y_test = y.iloc[train_index], y.iloc[test_index]
# Initialize and train the LGBM model
model = lgb.LGBMRegressor(force_row_wise=True, verbosity=-1)
model.fit(X_train, y_train)
# Make predictions
y_pred = model.predict(X_test)
# Evaluate the model
mae = mean_absolute_error(y_test, y_pred)
rmse = np.sqrt(mean_squared_error(y_test, y_pred))
smape_value = smape(y_test, y_pred)
mae_scores.append(mae)
rmse_scores.append(rmse)
smape_scores.append(smape_value)
# Convert the metrics into a DataFrame
mae_avg = np.mean(mae_scores)
rmse_avg = np.mean(rmse_scores)
smape_avg = np.mean(smape_scores)
metrics_df = pd.DataFrame({
'metric': ['MAE', 'RMSE', 'SMAPE'],
'LGBM': [mae_avg, rmse_avg, smape_avg]
})
# Display the DataFrame
metrics_dfTimeGPT, LGBM से लगभग 5 गुना बेहतर है।
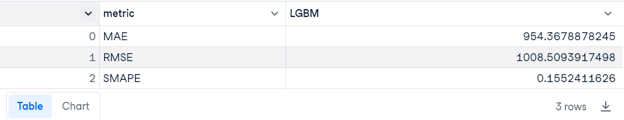
यदि आपको ऊपर दिया गया कोड चलाने या TimeGPT सेटअप में समस्या आ रही है, तो यह DataLab वर्कस्पेस देखें: Time Series Forecasting with TimeGPT.
निष्कर्ष
TimeGPT और Nixtla का इकोसिस्टम उन कंपनियों के लिए आदर्श है जो अभी शुरुआत कर रही हैं, क्योंकि यह मॉडल ट्रेन करने के लिए मशीन लर्निंग इंजीनियर और उन्हें डिप्लॉय व मेंटेन करने के लिए MLOps इंजीनियर रखने की आवश्यकता कम कर देता है। यदि आप एक स्टार्टअप हैं, तो आप लागत में काफ़ी बचत कर सकते हैं और फिर भी उच्च-प्रदर्शन वाले मॉडलों तक पहुँच प्राप्त कर सकते हैं।
GPT-3 की तरह, TimeGPT टाइम सीरीज़ के लिए अत्याधुनिक मॉडलों की शुरुआत का प्रतिनिधित्व करता है, और जैसे-जैसे ये मॉडल समय के साथ बेहतर होंगे, कई कंपनियाँ आसान इंटीग्रेशन और बेहतर प्रदर्शन के लिए Nixtla API अपनाएँगी।
इस ट्यूटोरियल में, हमने टाइम सीरीज़ के लिए पहला फ़ाउंडेशनल मॉडल TimeGPT देखा। साथ ही, हमने Python API का उपयोग करके पूर्वानुमान, टाइम सीरीज़ विज़ुअलाइज़ेशन, मॉडल मूल्यांकन, क्रॉस-वैलिडेशन, और विसंगति जाँच जैसे कार्यों के लिए TimeGPT मॉडल तक पहुँचना सीखा।
जाने कि ARIMA वर्ग के मॉडलों से भविष्य का पूर्वानुमान कैसे करें और मशीन लर्निंग मॉडलों से भविष्यवाणियाँ व इनसाइट्स कैसे जनरेट करें, इस Time Series with Python स्किल ट्रैक के साथ। यदि आप R भाषा पसंद करते हैं, तो Time Series with R स्किल ट्रैक पर विचार करें ताकि टाइम सीरीज़ पूर्वानुमान को समग्र रूप से समझ सकें।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
टाइम सीरीज़ मशीन लर्निंग मॉडल को प्रशिक्षित करना सीधा नहीं है; यह पारंपरिक वर्गीकरण या रेग्रेशन समस्याओं से काफ़ी अलग होता है। आपको विंडो और लैग बनाकर मौजूदा डेटा से नए फीचर जनरेट करने पड़ते हैं, और तब भी संभव है कि आपका मॉडल अच्छा प्रदर्शन न करे। केवल लीनियर रेग्रेशन मॉडल ही नहीं, LSTM और GRU जैसे डीप लर्निंग मॉडल भी शेयर बाज़ार का पूर्वानुमान लगाने में अक्सर संघर्ष करते हैं।
क्या हमें टाइम सीरीज़ के लिए GPT-4o जैसे किसी मॉडल की ज़रूरत है जो हर तरह के डेटासेट पर अच्छा काम करे? बिल्कुल। TimeGPT एक अत्याधुनिक फ़ाउंडेशनल मॉडल है जो अनदेखे डेटासेट पर भी पूर्वानुमान कर सकता है।
इस ट्यूटोरियल में, हम TimeGPT की आर्किटेक्चर, इसके प्रशिक्षण का तरीका, और इसके बेंचमार्क्स देखेंगे। साथ ही, हम सीखेंगे कि पूर्वानुमान, विसंगति जाँच, टाइम सीरीज़ विज़ुअलाइज़ेशन, और मॉडल मूल्यांकन के लिए TimeGPT मॉडल तक पहुँचने हेतु Nixtla API का उपयोग कैसे करें।
छवि: लेखक | Canva
TimeGPT क्या है?
TimeGPT-1 एक ट्रांसफ़ॉर्मर-आधारित टाइम सीरीज़ मॉडल है जिसमें सेल्फ-अटेंशन मैकेनिज़्म हैं, जिसे आप Nixtla API के माध्यम से एक्सेस कर सकते हैं। यह टाइम सीरीज़ डेटासेट्स के लिए पहला फ़ाउंडेशनल मॉडल है जो अनदेखे डेटा पर भी काफ़ी सटीक है। आपको बस अपने डेटासेट पर इसे फाइन-ट्यून करना है, और कुछ ही सेकंड में यह अत्याधुनिक प्रदर्शन देता है।
TimeGPT की आर्किटेक्चर एक एन्कोडर-डिकोडर संरचना पर आधारित है जिसमें कई लेयर्स हैं, प्रत्येक में रेज़िडुअल कनेक्शंस और लेयर नॉर्मलाइज़ेशन होता है। आउटपुट लेयर रैखिक है और डिकोडर के आउटपुट को फोरकास्टिंग विंडो के आयाम पर मैप करती है।
इसे सार्वजनिक रूप से उपलब्ध टाइम सीरीज़ डेटा के सबसे बड़े संग्रह पर प्रशिक्षित किया गया है, जिसका अर्थ है कि यह बिना दोबारा प्रशिक्षण के अनदेखे डेटासेट्स का भी पूर्वानुमान लगा सकता है। पूर्वानुमान उत्पन्न करने के लिए, TimeGPT पिछले मूल्यों की एक विंडो लेता है और इनपुट को बेहतर बनाने के लिए एक स्थानीय पोज़िशनल एन्कोडर जोड़ता है।
स्रोत: 2310.03589 (arxiv.org) | TimeGPT लक्षित मानों के ऐतिहासिक मान और अतिरिक्त बाह्य चरों को इनपुट के रूप में लेकर पूर्वानुमान उत्पन्न करता है।
TimeGPT मॉडल स्थापित सांख्यिकीय, मशीन लर्निंग, और डीप लर्निंग विधियों से बेहतर प्रदर्शन करता है, और श्रेष्ठ ज़ीरो-शॉट इन्फ़ेरेंस, दक्षता, और सादगी दिखाता है। नीचे दिए गए बेंचमार्क में प्रदर्शित है कि बिना किसी फ़ीचर इंजीनियरिंग के भी TimeGPT विभिन्न मशीन लर्निंग मेट्रिक्स पर उत्कृष्ट प्रदर्शन करता है।
स्रोत: 2310.03589 (arxiv.org) | rMAE और rRMSE से मापा गया बेंचमार्क; स्कोर जितना कम, उतना बेहतर।