
Program
Zaman Serisi Python'da
20 sa
Bir zaman serisi makine öğrenimi modelini eğitmek kolay değildir; geleneksel sınıflandırma veya regresyon problemlerinden oldukça farklıdır. Mevcut verilerden yeni özellikler üretmek için pencereler ve gecikmeler oluşturmanız gerekir ve yine de modeliniz iyi performans göstermeyebilir. Sadece doğrusal regresyon modelleri zorlanmakla kalmaz, LSTM ve GRU gibi derin öğrenme modelleri bile borsa tahmini söz konusu olduğunda kötü performans gösterebilir.
Tüm veri kümeleri türlerinde iyi çalışan, GPT-4o benzeri bir zaman serisi modeli gerekir mi? Kesinlikle. TimeGPT, görülmemiş veri kümelerinde bile tahmin yapabilen son teknoloji bir temel modeldir.
Bu eğitimde, TimeGPT’nin mimarisini, nasıl eğitildiğini ve karşılaştırma sonuçlarını inceleyeceğiz. Ayrıca, kestirim, anomali tespiti, zaman serisi görselleştirmeleri ve model değerlendirmeleri için TimeGPT modeline erişmek üzere Nixtla API’sini nasıl kullanacağımızı öğreneceğiz.
Görsel: Yazar | Canva
TimeGPT-1, Nixtla API’siyle erişebileceğiniz, öz-dikkat mekanizmalarına sahip, Transformer tabanlı bir zaman serisi modelidir. Görülmemiş verilerde dahi oldukça isabetli olan, zaman serileri için geliştirilen ilk temel modeldir. Tek yapmanız gereken, kendi veri kümeniz üzerinde ince ayar yapmak ve birkaç saniye içinde son teknoloji düzeyinde performans elde edeceksiniz.
TimeGPT mimarisi, artık bağlantılar ve katman normalizasyonu ile donatılmış çoklu katmanlara sahip bir kodlayıcı-çözücü yapısından oluşur. Çıkış katmanı doğrusaldır ve çözücünün çıktısını tahmin penceresinin boyutuna eşler.
En büyük, herkese açık zaman serisi veri koleksiyonu üzerinde eğitilmiştir; bu da yeniden eğitim gerektirmeden görülmemiş veri kümelerinde de tahmin üretebildiği anlamına gelir. Bir tahmin üretmek için TimeGPT geçmiş değerlerden bir pencere alır ve girdiyi zenginleştirmek için yerel bir konumsal kodlayıcı ekler.
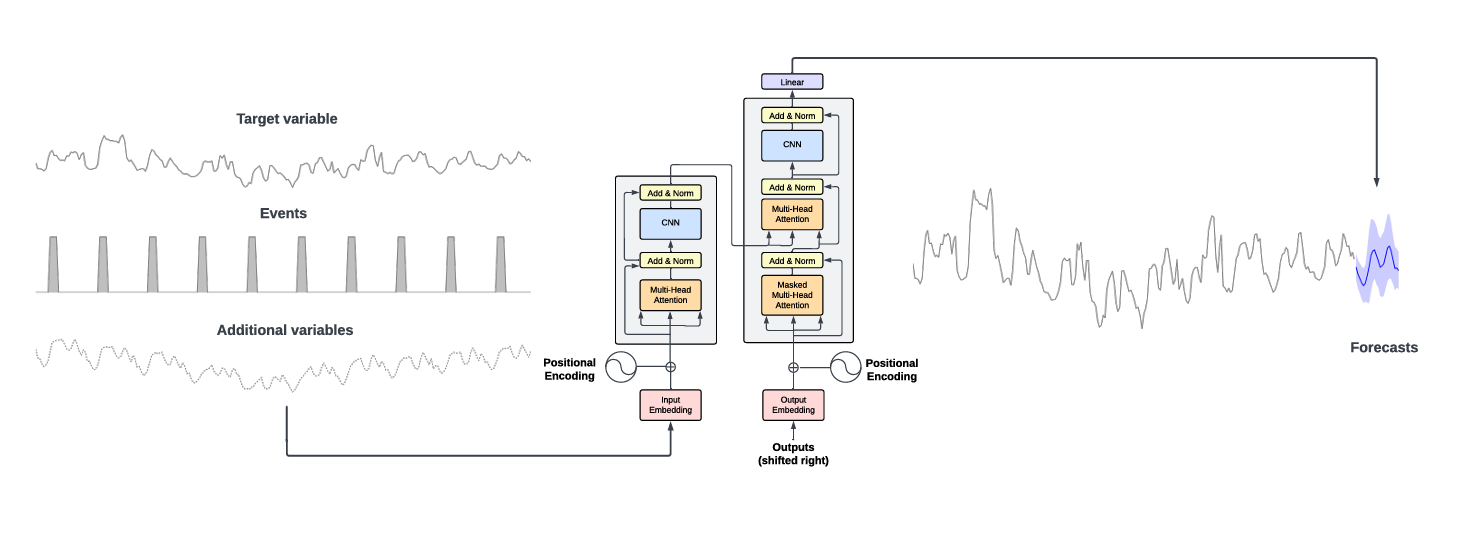
Kaynak: 2310.03589 (arxiv.org) | TimeGPT, tahmin üretmek için hedefin geçmiş değerlerini ve ek dışsal değişkenleri girdi olarak alır.
TimeGPT modeli; yerleşik istatistiksel, makine öğrenimi ve derin öğrenme yöntemlerini geride bırakarak üstün sıfır atışlı çıkarım performansı, verimlilik ve sadelik sergiler. Aşağıdaki karşılaştırmada görüldüğü gibi, herhangi bir özellik mühendisliği olmadan bile çeşitli makine öğrenimi metriklerinde öne çıkar.
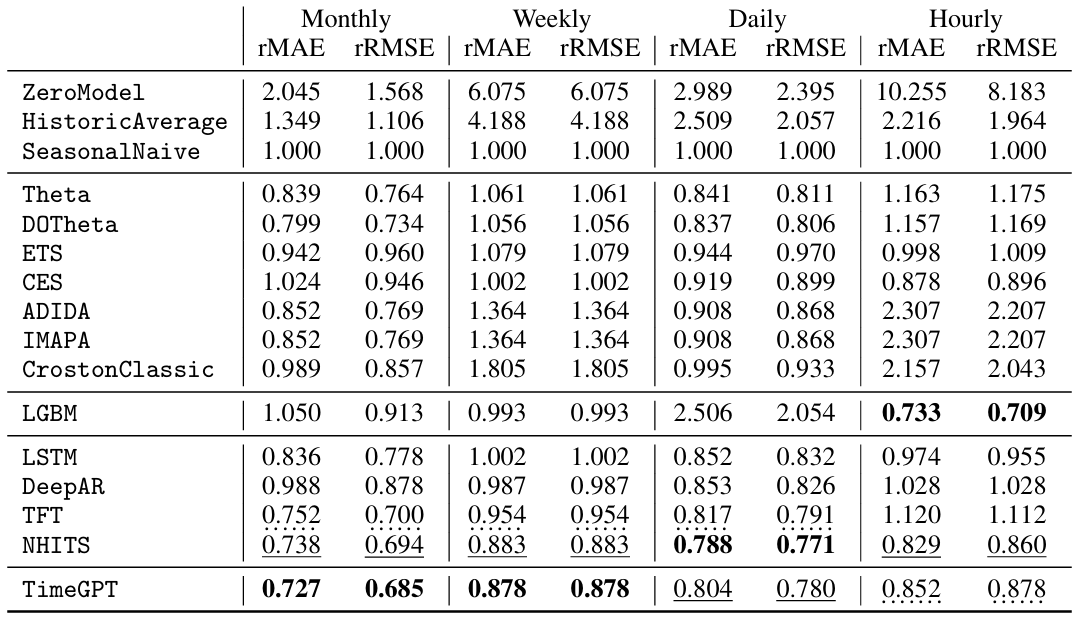
Kaynak: 2310.03589 (arxiv.org) | rMAE ve rRMSE ile ölçülen karşılaştırma modelleri; daha düşük skorlar daha iyidir.
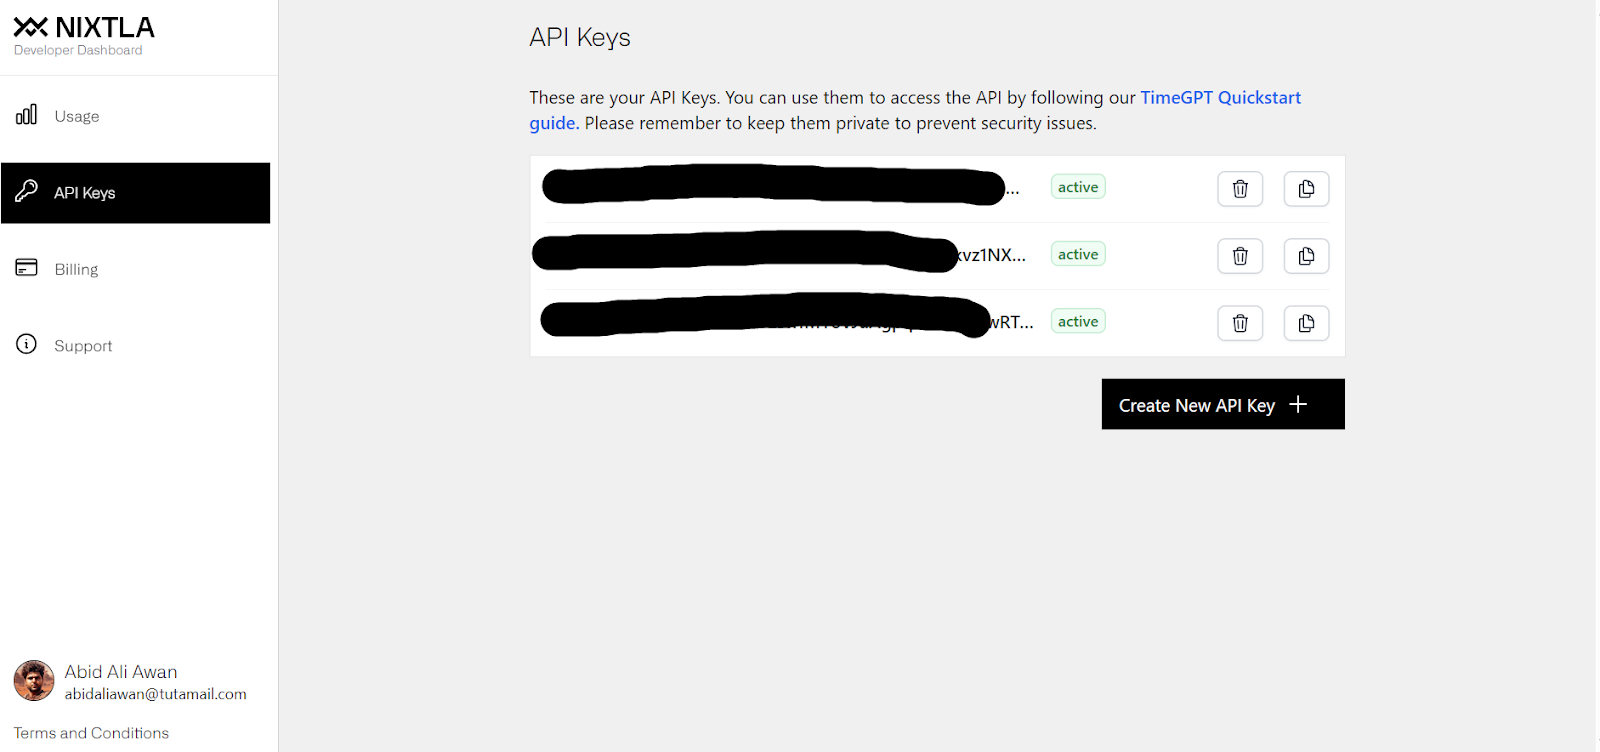
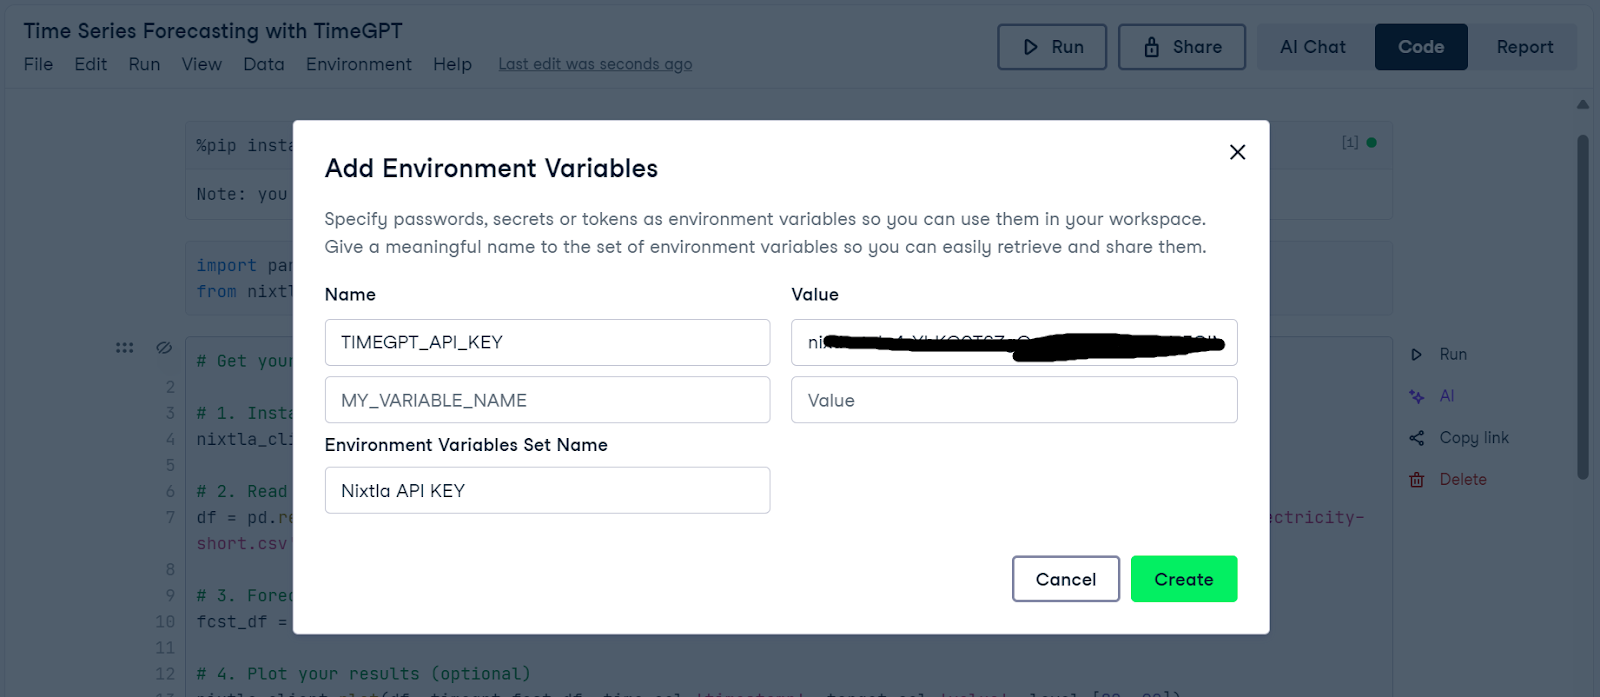
TimeGPT modeli açık kaynak değildir ve yalnızca Nixtla API’si üzerinden erişilebilir. Bu bölümde, TimeGPT modeline erişmek ve Amazon hisse senedi verileri üzerinde tahmin yapmak için Nixtla API kurulumunu adım adım göreceksiniz.
%%capture
%pip install nixtla>=0.5.1
%pip install yfinanceimport pandas as pd
import yfinance as yf
from nixtla import NixtlaClient
import os
timegpt_api_key = os.environ["TIMEGPT_API_KEY"]
# Setup NixtlaClient
nixtla_client = NixtlaClient(api_key = timegpt_api_key)
# Downloading Amazon stock price data
ticker = 'AMZN'
amazon_stock_data = yf.download(ticker)
amazon_stock_data = amazon_stock_data.reset_index()
# Displaying the dataset
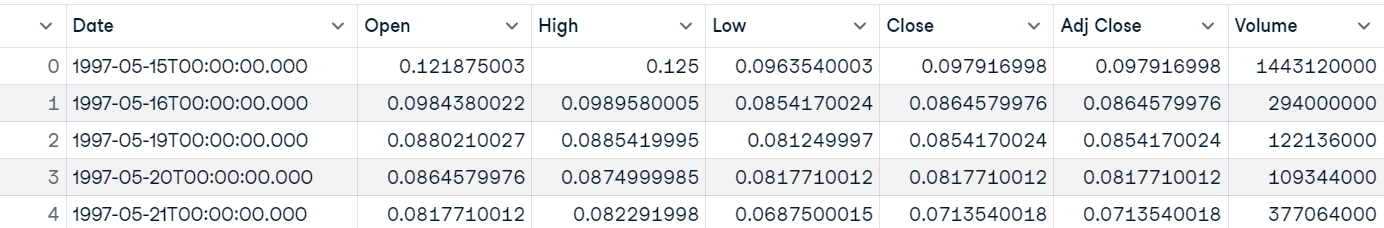
amazon_stock_data.head()1997’den günümüze Amazon hisse fiyatı verilerine sahibiz.
nixtla_client.plot(amazon_stock_data, time_col='Date', target_col='Close')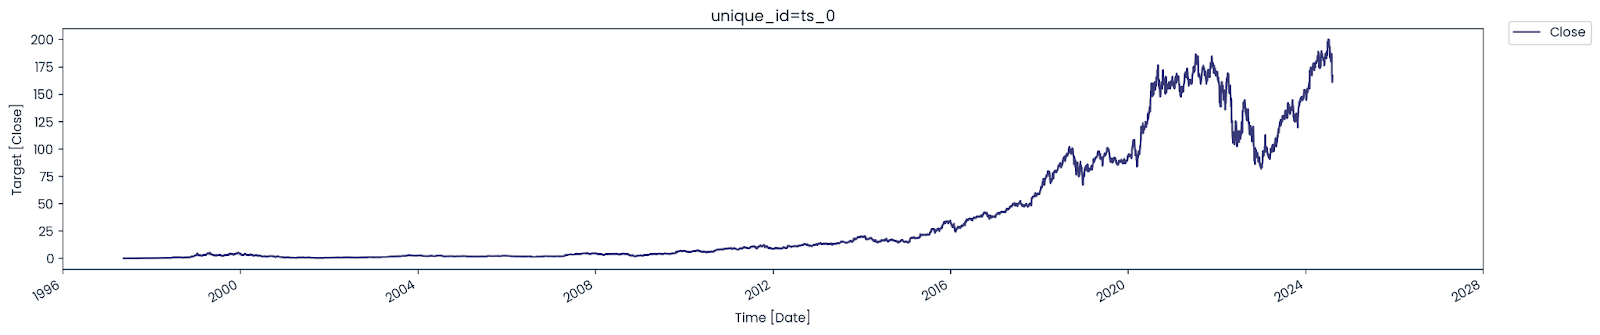
Matplotlib kullanarak zaman serisi çizgi grafiklerini nasıl oluşturacağınızı bu Matplotlib Zaman Serisi Çizgi Grafiği öğreticisini izleyerek keşfedin.
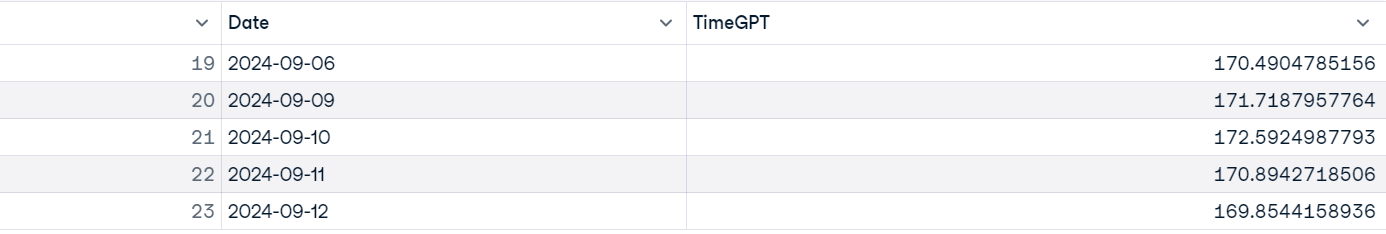
.forecast fonksiyonuna hisse verisini, model adını, öngörü ufkunu (24 güne eşdeğer), frekansı, zaman sütunlarını ve hedef sütunları sağlamamız gerekir. Borsa hafta sonları kapalı olduğundan frekansı "iş günü (B)" olarak seçiyoruz.model = nixtla_client.forecast(
df=amazon_stock_data,
model="timegpt-1",
h=24,
freq="B",
time_col="Date",
target_col="Close",
)
model.tail()
nixtla_client.plot(
    amazon_stock_data,
    model,
    time_col="Date",
    target_col="Close",
    max_insample_length=60,
)
Gördüğünüz gibi, TimeGPT modeli birkaç saniye içinde Amazon’un kapanış fiyatlarını geleceğe yönelik olarak isabetli biçimde tahmin etti.
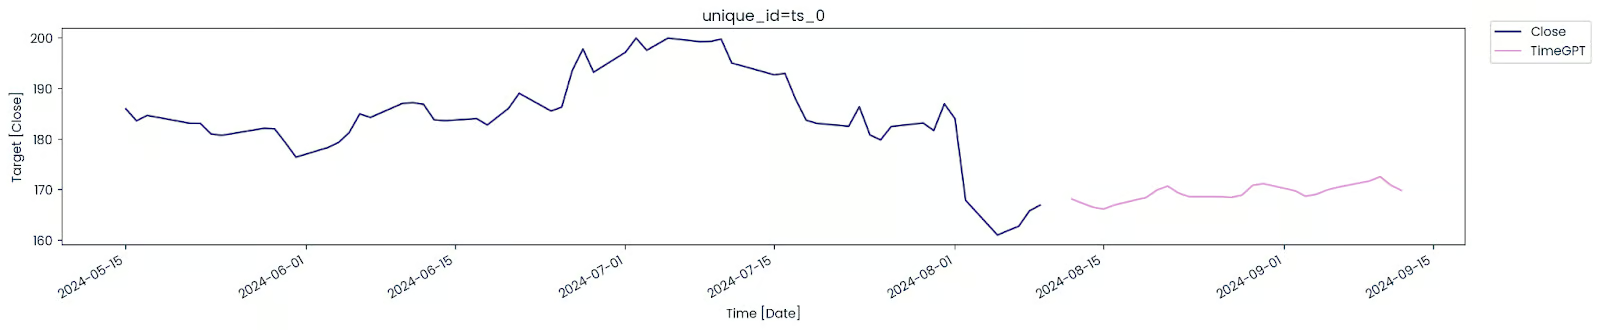
Bu bir başlangıç örneğiydi. Bir sonraki bölümde daha karmaşık veri kümeleriyle çalışacak ve Nixtla API’nin çeşitli özelliklerini keşfedeceğiz.
Bu bölümde daha karmaşık bir Avustralya Elektrik Talebi veri kümesi kullanacak ve TimeGPT modeliyle aynı anda birden fazla değeri tahmin edeceğiz.
Veri kümesi, Avustralya’daki 5 eyaletin (Victoria, New South Wales, Queensland, Tazmanya ve Güney Avustralya) yarım saatte bir elektrik talebini temsil eden 5 zaman serisinden oluşur.
Ayrıca modeli nasıl ince ayar yapacağımızı ve performansı artırmak için çeşitli model hiperparametrelerini nasıl kullanacağımızı öğreneceğiz. Son olarak çapraz doğrulama yapacak ve kapsamlı bir değerlendirme için modelin performansını geleneksel modellerle karşılaştıracağız.
pandas kütüphanesinde .tsf dosyasını yüklemenin basit bir yolu yok. Verileri yüklemek ve işlemek için kendi özel fonksiyonumuzu oluşturup ardından bir Pandas veri çerçevesine dönüştürmemiz gerekiyor.
import pandas as pd


def read_tsf_from_file(file_path):
    data = []
    start_date = pd.to_datetime("2002-01-01 00:00:00")

    # Open and read the file from the directory

    with open(file_path, "r") as file:
        for line in file:
            if line.startswith("T"):
                parts = line.strip().split(":")
                unique_id = parts[0] + "-" + parts[1]
                values = list(map(float, parts[3].split(",")[:-1]))

                # Generate datetime index at half-hour intervals

                periods = len(values)
                date_range = pd.date_range(
                    start=start_date, periods=periods, freq="30min"
                )

                # Append to data list

                for dt, value in zip(date_range, values):
                    data.append([unique_id, dt, value])
    # Convert the list of data into a DataFrame

    return pd.DataFrame(data, columns=["unique_id", "ds", "y"])


# Example usage

file_path = "australian_electricity_demand_dataset.tsf"
demand_df = read_tsf_from_file(file_path)

# Display the dataframe

demand_df.head()
Veri kümemizde üç sütun bulunuyor:
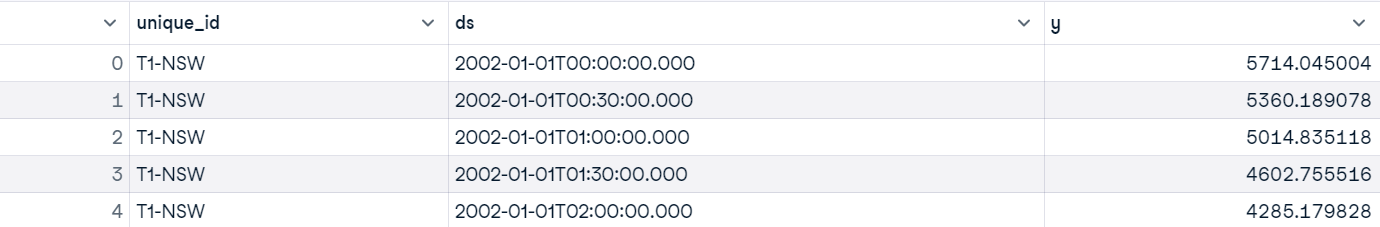
plot fonksiyonu harika; unique_id sütununu otomatik olarak algılar ve beş farklı zaman serisi görselleştirmesi oluşturur.
nixtla_client.plot(
    demand_df,
    max_insample_length=365,
)
Aşağıdaki görselleştirme 5 eyaletin güç tüketimini gösteriyor ve her birinin farklı örüntüleri var.
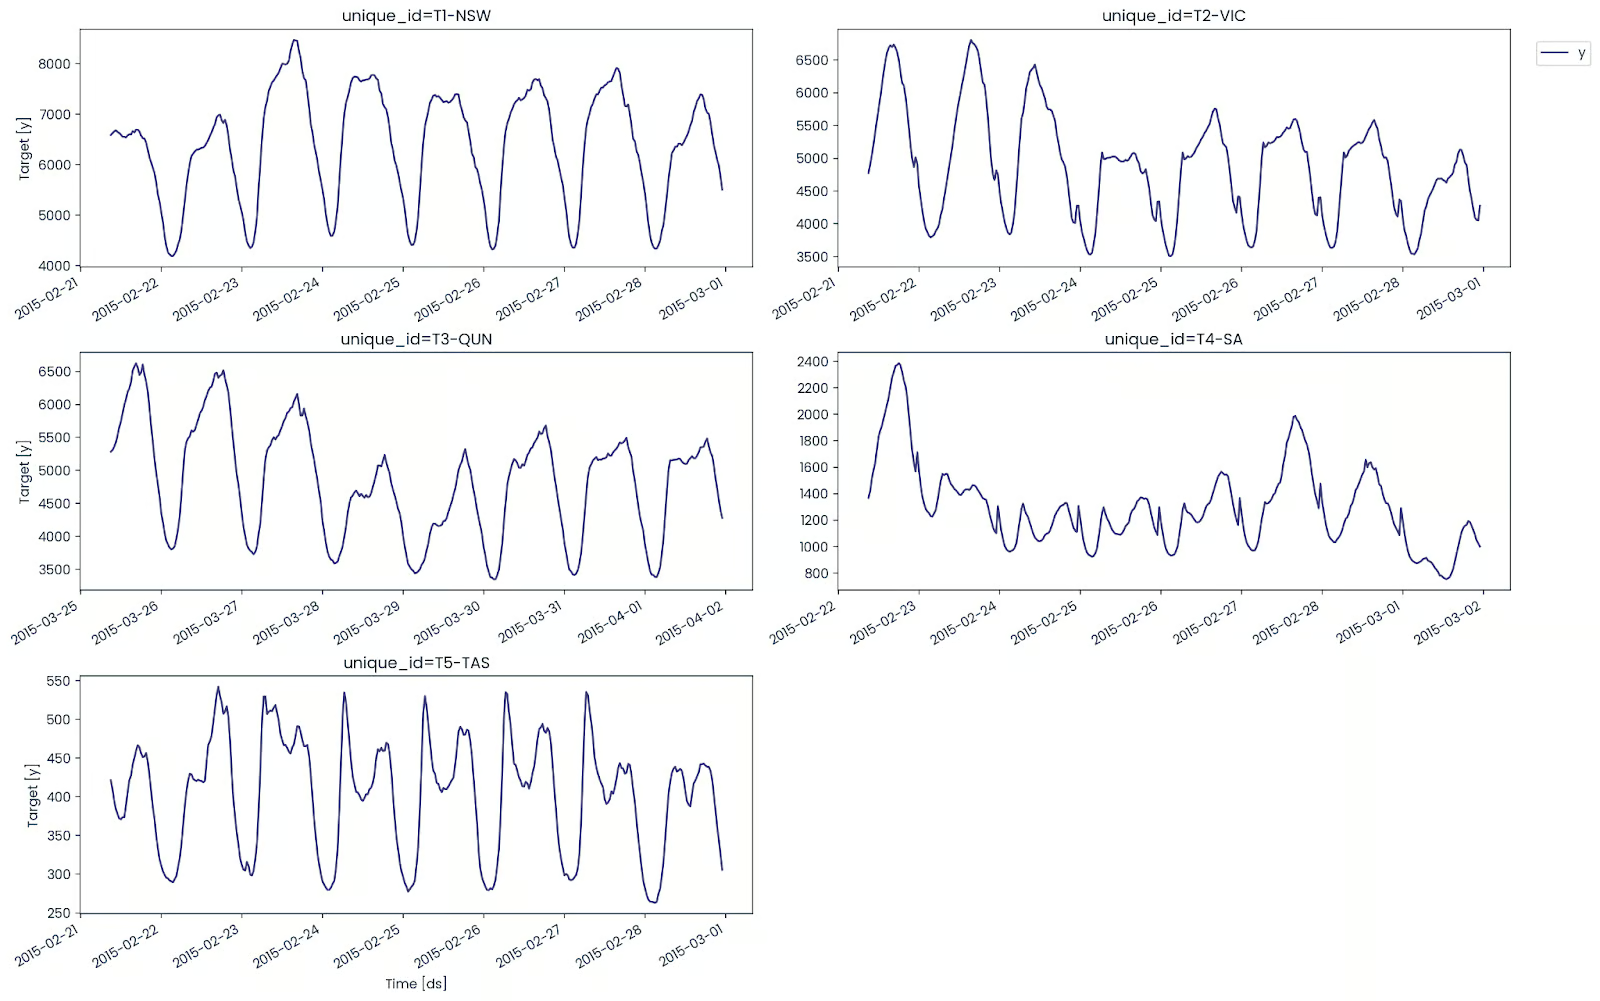
Zaman serisi analizini öğrenmek için DataCamp’teki canlı birlikte kodlama oturumuna katılın; burada Python ile finansal zaman serisi veri kümelerine dalacaksınız.
Bu oturumda çeşitli hisseleri keşfedecek, performanslarını görselleştirecek ve farklı modellerle tahminler yapacağız.
Tahmin yapmadan önce, problemi daha iyi anlamak için veri kümesindeki çeşitli anomalileri belirleyeceğiz.
.detect_anomalies fonksiyonu veri kümesini, zaman ve hedef sütunlarını ve frekansı alır.
# Detect anomalies
anomalies_df = nixtla_client.detect_anomalies(
    demand_df,
    time_col='ds',
    target_col='y',
    freq='H',
)
anomalies_df[anomalies_df["anomaly"]==1].head()
Anomali tespit edilen tüm örnekleri görüntüledik.
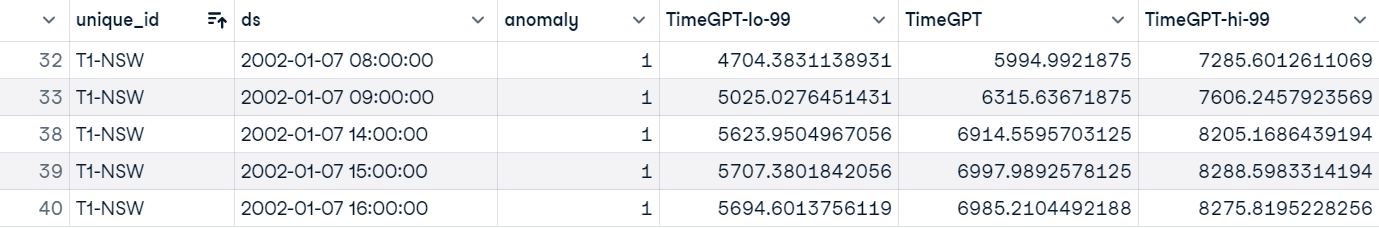
Tüm 5 zaman serisi veri kümesindeki toplam anomali sayısı 17.316, bu da oldukça fazla.
anomalies_df.anomaly.value_counts()
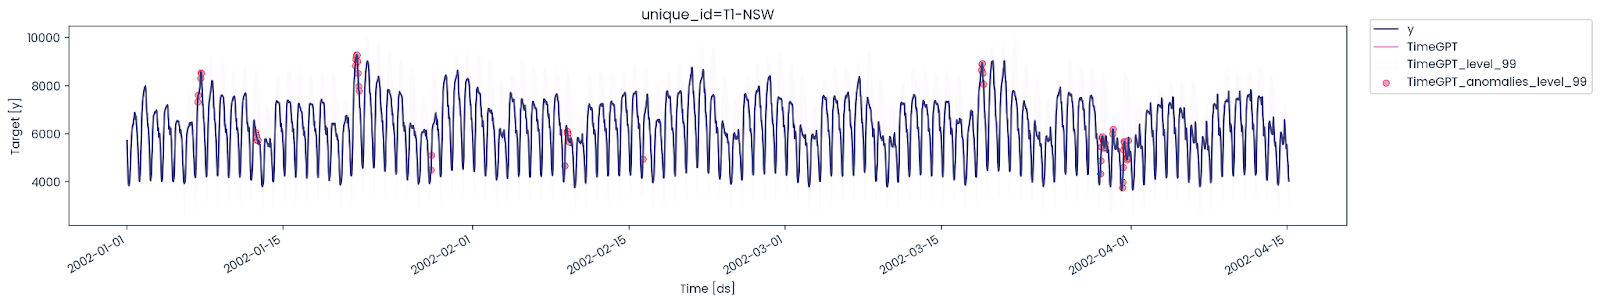
Şimdi, anomalilerin nerede ve ne sıklıkla meydana geldiğini görmek için bunları gerçek veri kümesi üzerinde çizeceğiz. Görselleştirmeyi sadeleştirmek için yalnızca New South Wales’ten 5.000 örnek göstereceğiz.
# Plot anomalies
nixtla_client.plot(
    demand_df[demand_df["unique_id"]=="T1-NSW"][0:5000],
    anomalies_df[anomalies_df["unique_id"]=="T1-NSW"][0:5000],
    time_col='ds',
    target_col='y',

)
Günlük bazda anomaliler yaygın değil, ancak tek bir günde birden fazla anomali görülen günler olmuş.
Şimdi New South Wales elektrik talebini tahmin edeceğiz. Bunun için yalnızca "T1-NSW" değerlerini filtreleyeceğiz.
T1_df = demand_df[demand_df["unique_id"]=="T1-NSW"]
T1_df.head()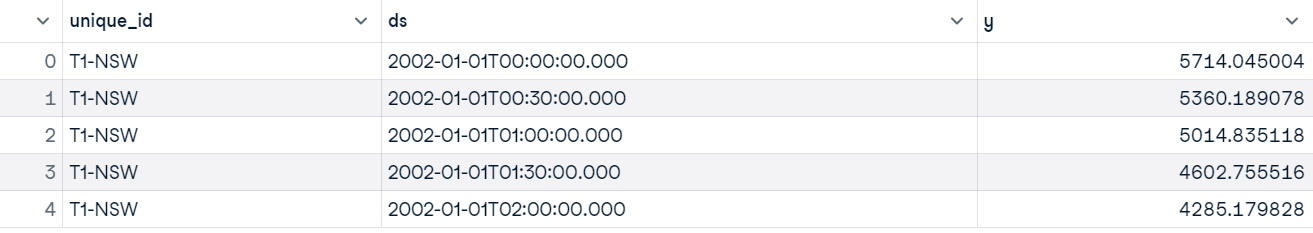
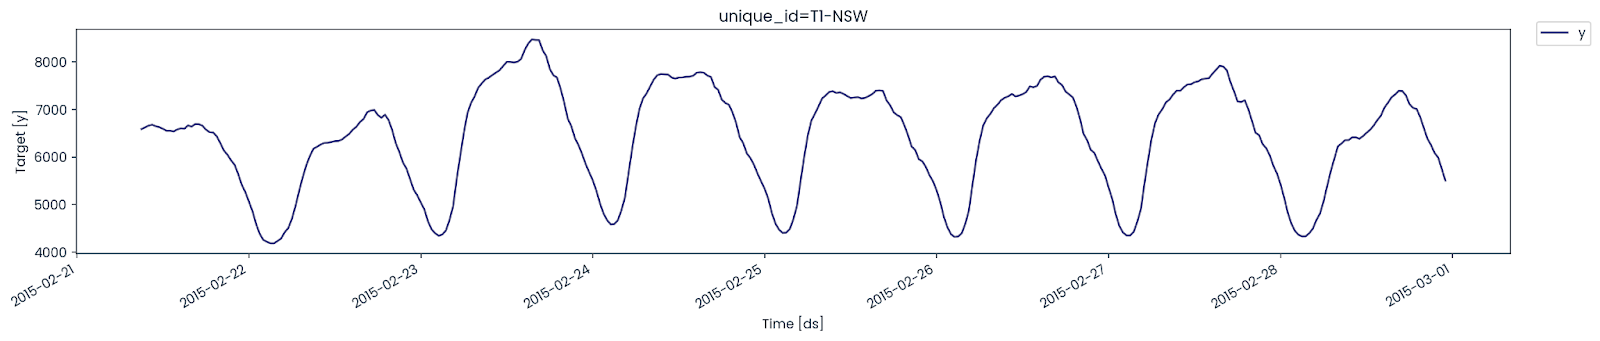
Elektrik tüketim örüntüsünü anlamak için son 365 değeri çizin.
nixtla_client.plot(
    T1_df,
    max_insample_length=365,
)
Şimdi modelimizin performansını değerlendireceğiz. Bunun için veri kümemizi eğitim ve test setlerine ayırmamız gerekiyor.
Eğitim seti 3 güne karşılık gelen 144 değerden, test seti ise 25 güne karşılık gelen 1200 değerden oluşuyor.
test_df = T1_df.tail(144) # 3 days = (144 * 0.5h *  1 day/24h)
train_df = T1_df.iloc[-1344:-144] # 25 days = (1200 *0.5h * 1 day/24h)
Tahmin için daha iyi bir model seçip çeşitli argümanları ayarlayarak model performansını artıracağız; özellikle:
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],  # Generate a 90% confidence interval
    finetune_steps=60,  # Specify the number of steps for fine-tuning
    finetune_loss="mae",  # Use the MAE as the loss function for fine-tuning
    model="timegpt-1-long-horizon",  # Use the model for long-horizon forecasting
    time_col="ds",
    target_col="y",
)
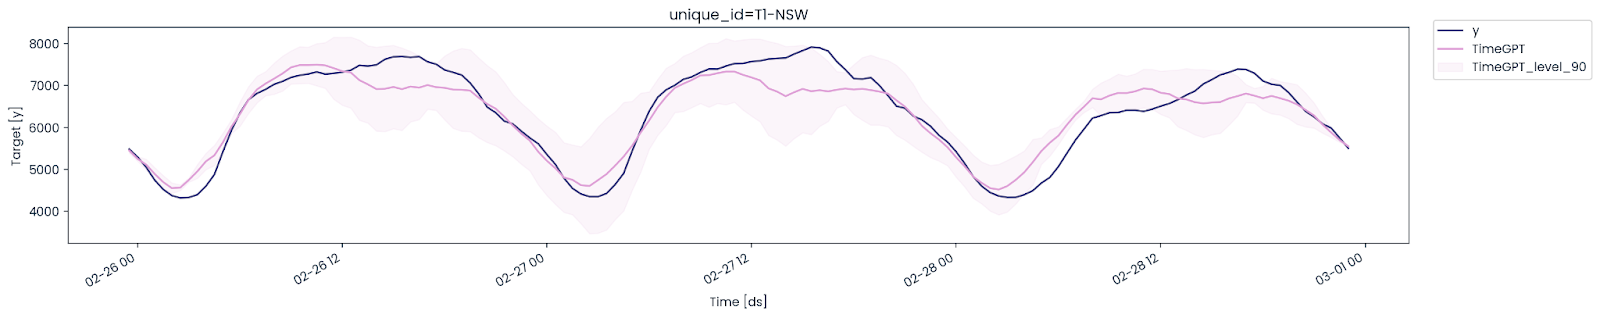
Modelin performansını değerlendirmek için gerçek, tahmin ve %90 güven aralığını çizin.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Birkaç saniye içinde oldukça isabetli bir sonuç aldık. Bu, önceden eğitilmiş modellerin gücüdür.
Model performansını, Nixtla açık kaynak projesinin bir parçası olan UtilsForecast kütüphanesiyle değerlendireceğiz. Bunun için test ve tahmin veri kümelerini birleştirip evaluate fonksiyonuna vereceğiz. Fonksiyon, veri kümesini, metrikleri, modelleri, hedef sütununu ve benzersiz kimliği alarak model metriklerini hesaplar ve bunları bir pandas veri çerçevesi olarak gösterir.
from utilsforecast.losses import mae, rmse, smape
from utilsforecast.evaluation import evaluate

predict_df["ds"] = pd.to_datetime(predict_df["ds"])
test_df = pd.merge(test_df, predict_df, "left", ["ds", "unique_id"])
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col="unique_id",
)

average_metrics = evaluation.groupby("metric")["TimeGPT"].mean()
average_metrics
Oldukça iyi sonuçlar elde ettik.
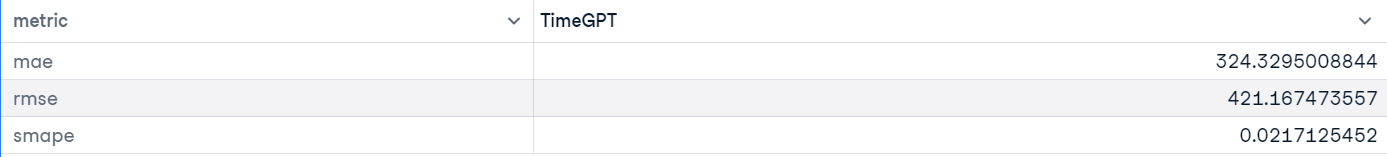
Nixtla API, aynı anda birden fazla seriyi de tahmin etmenize olanak tanır. Benzersiz kimliğe göre filtrelemek yerine tüm veri kümesini kullanacağız.
Veri kümesini eğitim ve test setlerine bölmek için, her bir benzersiz kimlik için 144 değeri ayırmak üzere groupby fonksiyonunu kullanıyoruz. Aksi halde rastgele seçilmiş bir benzersiz kimlik için yalnızca 144 değerimiz olurdu.
values for some randomly chosen unique ID.
test_df = demand_df.groupby("unique_id").tail(144)  # 3 days
train_df = (
    demand_df.groupby("unique_id")
    .apply(lambda group: group.iloc[-1344:-144])
    .reset_index(drop=True)
)  # 25 days
forecast fonksiyonu önceki bölümle aynıdır; tek fark, bu kez kimlik sütunlarını da dahil ediyoruz.
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],
    finetune_steps=60,
    finetune_loss='mae',
    model='timegpt-1-long-horizon',
    time_col='ds',
    target_col='y',
    id_col='unique_id'
)
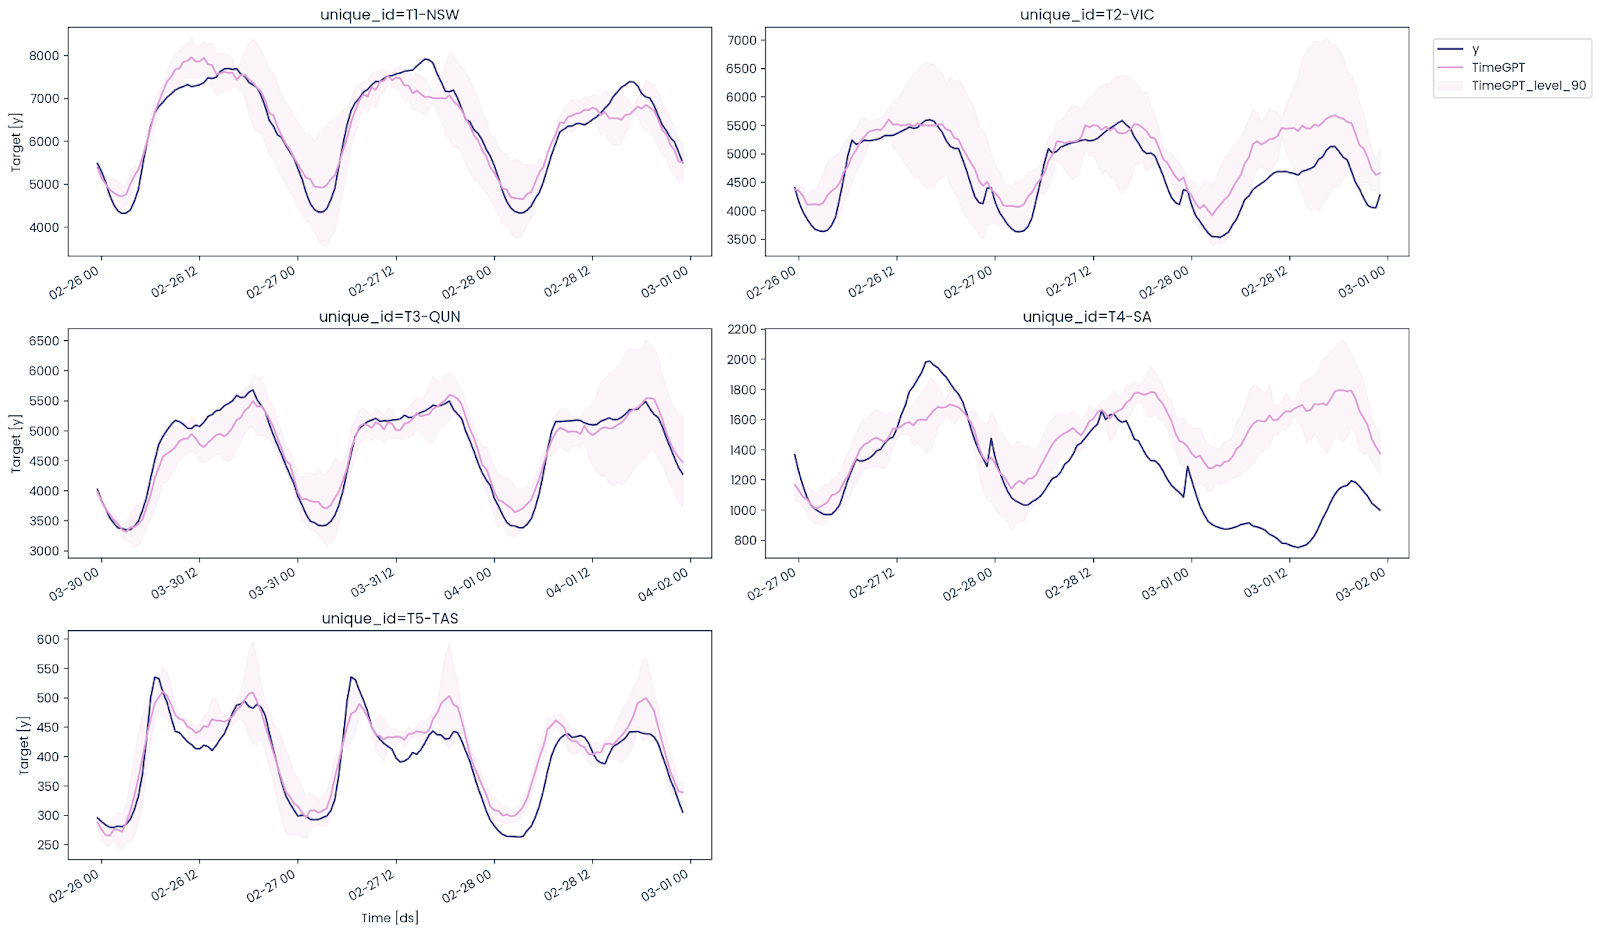
Tüm 5 benzersiz kimlik için gerçek, tahmin ve %90 güven düzeyi değerlerinin zaman serisi grafiğini çizin.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Görüldüğü gibi, TimeGPT modeli çoklu zaman serilerinde de iyi performans gösterdi; Güney Avustralya hariç. Elektrik talebindeki aşağı yönlü eğilimi tahmin edemedi.
Modeli MAE, RMSE ve SMAPE metrikleriyle değerlendirmek için test ve tahmin veri çerçevelerini birleştirmemiz gerekiyor.
predict_df['ds'] = pd.to_datetime(predict_df['ds'])
test_df = pd.merge(test_df, predict_df, 'left', ['ds','unique_id'])
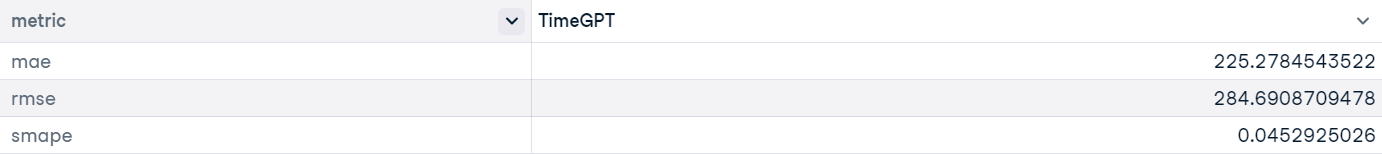
evaluate fonksiyonunu kullanarak bir model performans raporunu pandas veri çerçevesi olarak üretin. Rapor, her benzersiz kimlik için model metriklerini içerecek. Modelin genel performansını hesaplamak için değerleri ortalamamız ve nihai sonucu göstermemiz gerekir.
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "unique_id"
)

average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Genel model performansı, tek bir seri yerine birden fazla zaman serisi üzerinde ince ayar yapıldığında iyileşir.
Nixtla istemcisi, veri kümesinin çeşitli pencerelerinde model performansını değerlendirmek için çapraz doğrulama yapmanıza da olanak tanır.
.cross_validation fonksiyonunu kullanacak ve yalnızca New South Wales değerlerini içeren filtrelenmiş veri kümesini vereceğiz. Çapraz doğrulama 7 saat uzunluğunda 5 pencereye sahip olacak.
timegpt_cv_df = nixtla_client.cross_validation(
    T1_df,
    h=7,
    n_windows=5,
    time_col='ds',
    target_col='y',
    freq='H',
)
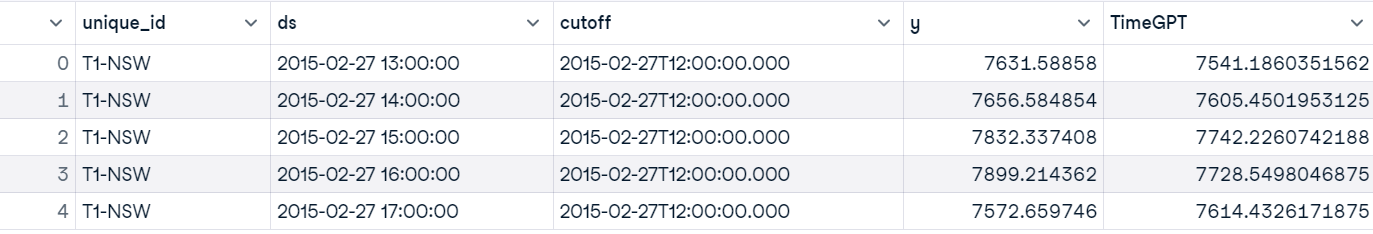
timegpt_cv_df.head()
Görüldüğü gibi, beş adet 7 saatlik pencereye dayalı tahmin değerleri elde ettik.
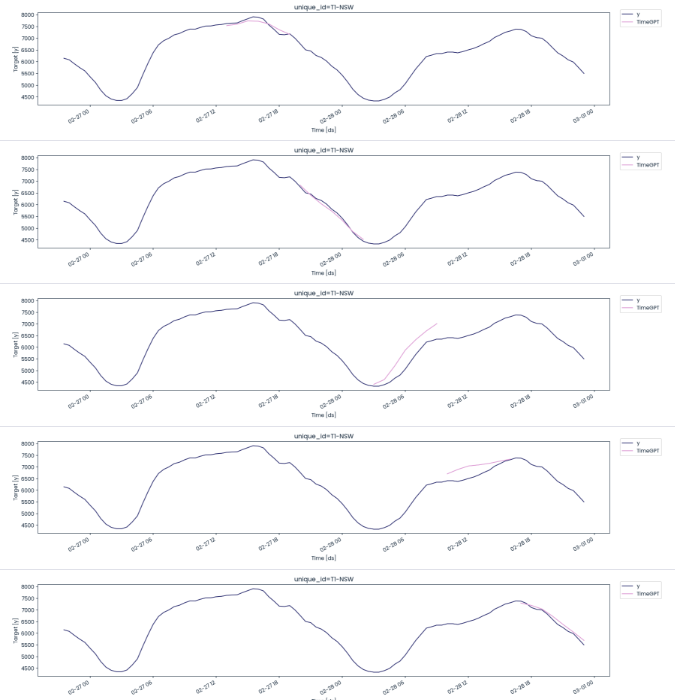
Tahmin edilen ve gerçek değerleri göstermek için 5 pencere oluşturacak bir kesim tarih ve saati kullanacağız.
cutoffs = timegpt_cv_df['cutoff'].unique()
for cutoff in cutoffs:
    fig = nixtla_client.plot(
        T1_df.tail(100),
        timegpt_cv_df.query('cutoff == @cutoff').drop(columns=['cutoff', 'y']),
        time_col='ds',
        target_col='y'
    )
    display(fig)
3. ve 4. bölmeler dışında model oldukça iyi performans gösterdi.
Şimdi TimeGPT ve Light Gradient-Boosting Machine (LGBM) modellerinin performansını aynı veri kümesinde hangisinin üstün olduğunu net biçimde görmek için karşılaştıralım. New South Wales veri çerçevesinde çapraz doğrulamayı zaten gerçekleştirdik; sıradaki adım evaluate fonksiyonunu kullanarak model değerlendirme raporu üretmek.
evaluation = evaluate(
    timegpt_cv_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "cutoff"
)
evaluation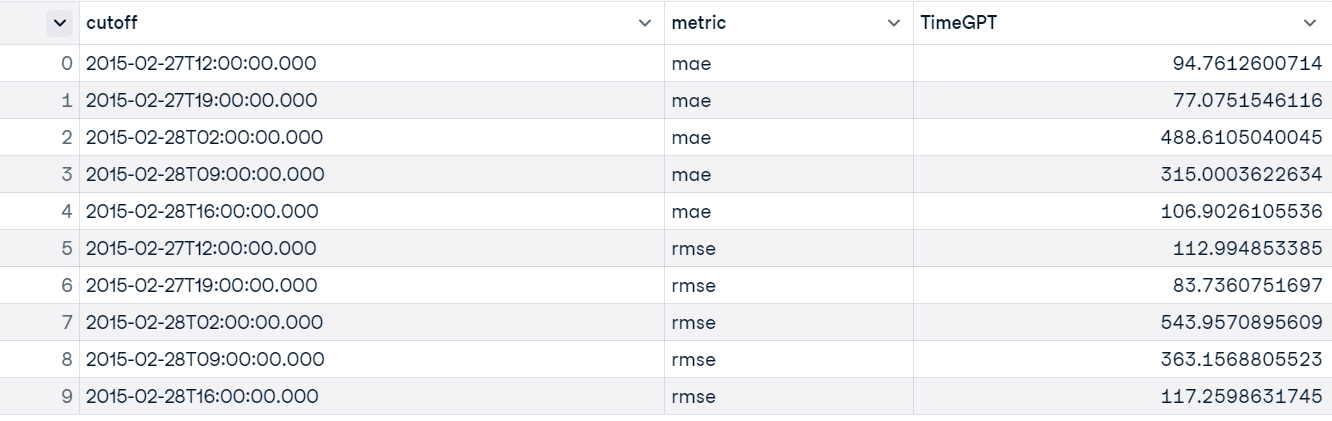
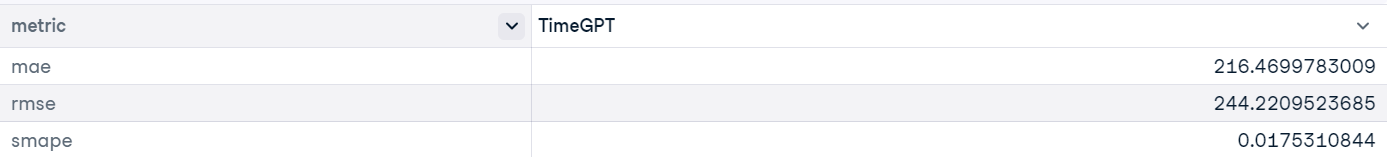
Modelin genel sonucunu elde etmek için tüm 5 pencere için MAE, RMSE ve SMAPE ortalamasını hesaplamamız gerekir.
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Sonuçlar, küçük bir değer kümesi üzerinde bile oldukça iyi.
LGBM modelini değerlendirmek için şu adımları izlememiz gerekiyor:
Not: Zaman serisi tahmini için istatistiksel ve makine öğrenimi modellerini kullanmak istiyorsanız temel özellik mühendisliği tekniklerini ve algoritmaları öğrenmek şarttır. Bu konulara kapsamlı bir giriş için şu öğreticiye göz atın: DataCamp’te Zaman Serisi Tahmini Öğreticisi.
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import TimeSeriesSplit
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Function to calculate SMAPE
def smape(y_true, y_pred):
    return np.mean(2 * np.abs(y_pred - y_true) / (np.abs(y_true) + np.abs(y_pred)))

# Assuming 'ds' is the date/time column and 'y' is the target variable
T1_df['ds'] = pd.to_datetime(T1_df['ds'])

# Filter the DataFrame to include only the specified datetime range
start_date = '2015-02-27T13:00:00'
end_date = '2015-02-28T23:00:00'
T1_df = T1_df[(T1_df['ds'] >= start_date) & (T1_df['ds'] <= end_date)]

# Convert 'ds' to a numerical value (e.g., timestamp)
T1_df['ds_num'] = T1_df['ds'].apply(lambda x: x.timestamp())

# Create lag and window features
for lag in range(1, 4):
    T1_df[f'lag_{lag}'] = T1_df['y'].shift(lag)

T1_df['rolling_mean'] = T1_df['y'].rolling(window=3).mean()
T1_df['rolling_std'] = T1_df['y'].rolling(window=3).std()

# Drop NaN values resulting from lag and rolling operations
T1_df.dropna(inplace=True)

# Select features for the model
X = T1_df[['ds_num', 'lag_1', 'lag_2', 'lag_3', 'rolling_mean', 'rolling_std']]
y = T1_df['y']

# Time series split
tscv = TimeSeriesSplit(n_splits=5)
mae_scores = []
rmse_scores = []
smape_scores = []

for train_index, test_index in tscv.split(X):
    X_train, X_test = X.iloc[train_index], X.iloc[test_index]
    y_train, y_test = y.iloc[train_index], y.iloc[test_index]

    # Initialize and train the LGBM model
    model = lgb.LGBMRegressor(force_row_wise=True, verbosity=-1)
    model.fit(X_train, y_train)

    # Make predictions
    y_pred = model.predict(X_test)

    # Evaluate the model
    mae = mean_absolute_error(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))
    smape_value = smape(y_test, y_pred)

    mae_scores.append(mae)
    rmse_scores.append(rmse)
    smape_scores.append(smape_value)

# Convert the metrics into a DataFrame
mae_avg = np.mean(mae_scores)
rmse_avg = np.mean(rmse_scores)
smape_avg = np.mean(smape_scores)

metrics_df = pd.DataFrame({
    'metric': ['MAE', 'RMSE', 'SMAPE'],
    'LGBM': [mae_avg, rmse_avg, smape_avg]
})

# Display the DataFrame
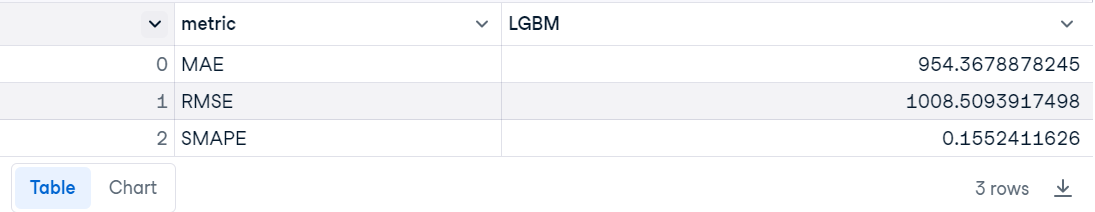
metrics_df
TimeGPT, LGBM’den neredeyse 5 kat daha iyi.
Yukarıdaki kodu çalıştırırken veya TimeGPT’yi kurarken sorun yaşıyorsanız, lütfen DataLab çalışma alanına göz atın: TimeGPT ile Zaman Serisi Tahmini.
TimeGPT ve Nixtla ekosistemi, yeni başlayan şirketler için idealdir; modelleri eğitmek için makine öğrenimi mühendisleri ve bunları devreye almak ile sürdürmek için MLOps mühendisleri tutma gereğini ortadan kaldırır. Bir girişimseniz, yüksek performanslı modellere erişirken önemli ölçüde maliyet tasarrufu sağlayabilirsiniz.
GPT-3’e benzer şekilde, TimeGPT zaman serileri için son teknoloji modellerin başlangıcını temsil eder ve bu modeller zamanla geliştikçe, pek çok şirketin kolay entegrasyon ve daha yüksek performans için Nixtla API’sini benimsemesi muhtemeldir.
Bu eğitimde, zaman serileri için ilk temel model olan TimeGPT’yi inceledik. Ayrıca, kestirim, zaman serisi görselleştirmesi, model değerlendirmesi, çapraz doğrulama ve anomali tespiti gibi görevlerde TimeGPT modeline erişmek için Python API’sinin nasıl kullanılacağını öğrendik.
ARIMA sınıfı modellerle geleceği nasıl tahmin edeceğinizi ve makine öğrenimi modelleriyle tahmin ve içgörü nasıl üreteceğinizi Python ile Zaman Serileri yetkinlik yoluyla öğrenin. R dilini tercih ediyorsanız, zaman serisi tahminini kapsamlıca anlamak için R ile Zaman Serileri yetkinlik yolunu değerlendirin.
Öne Çıkan DataCamp Kursları
Program
Program
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



