
Cursus
Séries chronologiques en Python
20 h
Entraîner un modèle d’apprentissage automatique pour séries temporelles n’est pas trivial : c’est très différent des problèmes classiques de classification ou de régression. Il faut créer des fenêtres et des retards (lags) pour générer de nouvelles caractéristiques à partir des données existantes, et malgré cela, le modèle peut rester décevant. Les régressions linéaires peinent, et même des réseaux profonds comme les LSTM et GRU peuvent se montrer peu performants pour prévoir les marchés boursiers.
Avons-nous besoin d’un modèle de type GPT-4o pour les séries temporelles, efficace sur tout type de jeu de données ? Absolument. TimeGPT est un modèle fondamental de pointe, capable de réaliser des prévisions même sur des jeux de données jamais vus.
Dans ce tutoriel, nous allons détailler l’architecture de TimeGPT, son entraînement et ses benchmarks. Nous verrons aussi comment utiliser l’API Nixtla pour accéder au modèle TimeGPT et réaliser des prévisions, détecter des anomalies, visualiser des séries temporelles et évaluer des modèles.
Image par l’auteur | Canva
TimeGPT-1 est un modèle de séries temporelles basé sur un Transformer avec des mécanismes d’auto‑attention accessible via l’API Nixtla. C’est le premier modèle fondamental pour séries temporelles qui reste fiable sur des données inédites. Il vous suffit de le peaufiner (fine-tuning) sur votre jeu de données et, en quelques secondes, vous obtenez des performances de pointe.
L’architecture de TimeGPT repose sur un schéma encodeur-décodeur à multiples couches, chacune dotée de connexions résiduelles et de normalisation de couche. La couche de sortie est linéaire et projette la sortie du décodeur sur la dimension de la fenêtre de prévision.
Il a été entraîné sur la plus vaste collection publique de séries temporelles, ce qui lui permet de prévoir des jeux de données jamais vus, sans réentraînement. Pour produire une prévision, TimeGPT prend une fenêtre de valeurs passées et ajoute un encodeur positionnel local pour enrichir l’entrée.
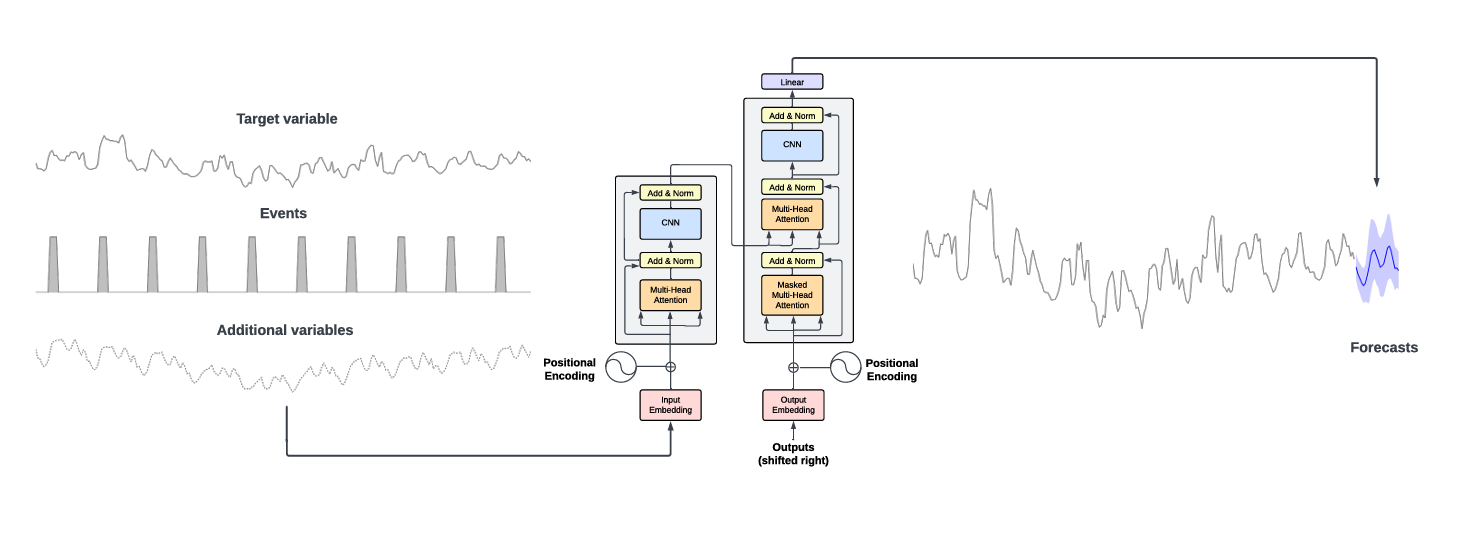
Source : 2310.03589 (arxiv.org) | TimeGPT utilise l’historique de la variable cible et des variables exogènes en entrée pour produire les prévisions.
Le modèle TimeGPT surpasse les méthodes statistiques, d’apprentissage automatique et d’apprentissage profond établies : meilleures performances en zéro-shot, efficacité et simplicité. Comme le montre le benchmark ci-dessous, TimeGPT excelle sur divers indicateurs, même sans ingénierie de caractéristiques.
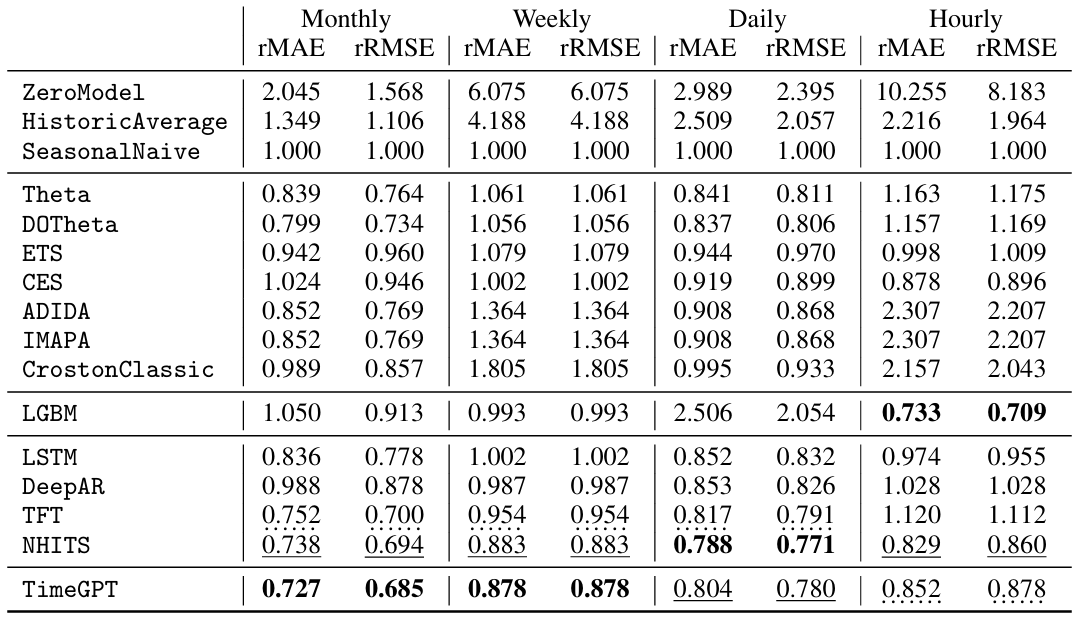
Source : 2310.03589 (arxiv.org) | Modèles évalués avec rMAE et rRMSE, plus les scores sont bas, mieux c’est.
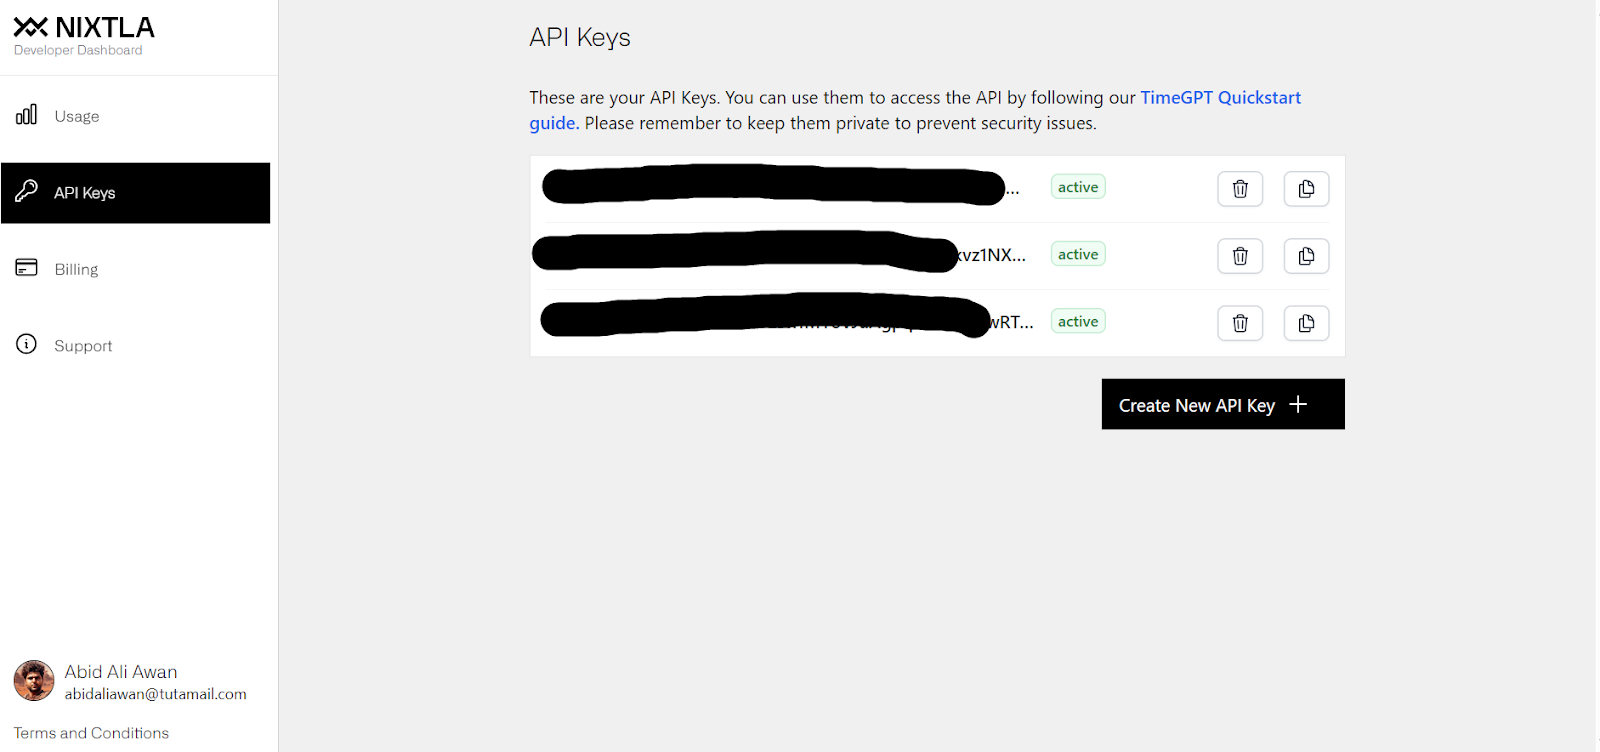
Le modèle TimeGPT n’est pas open source et n’est accessible qu’à travers l’API Nixtla. Cette section vous guide pour configurer l’API Nixtla, accéder au modèle TimeGPT et prévoir le cours de l’action Amazon.
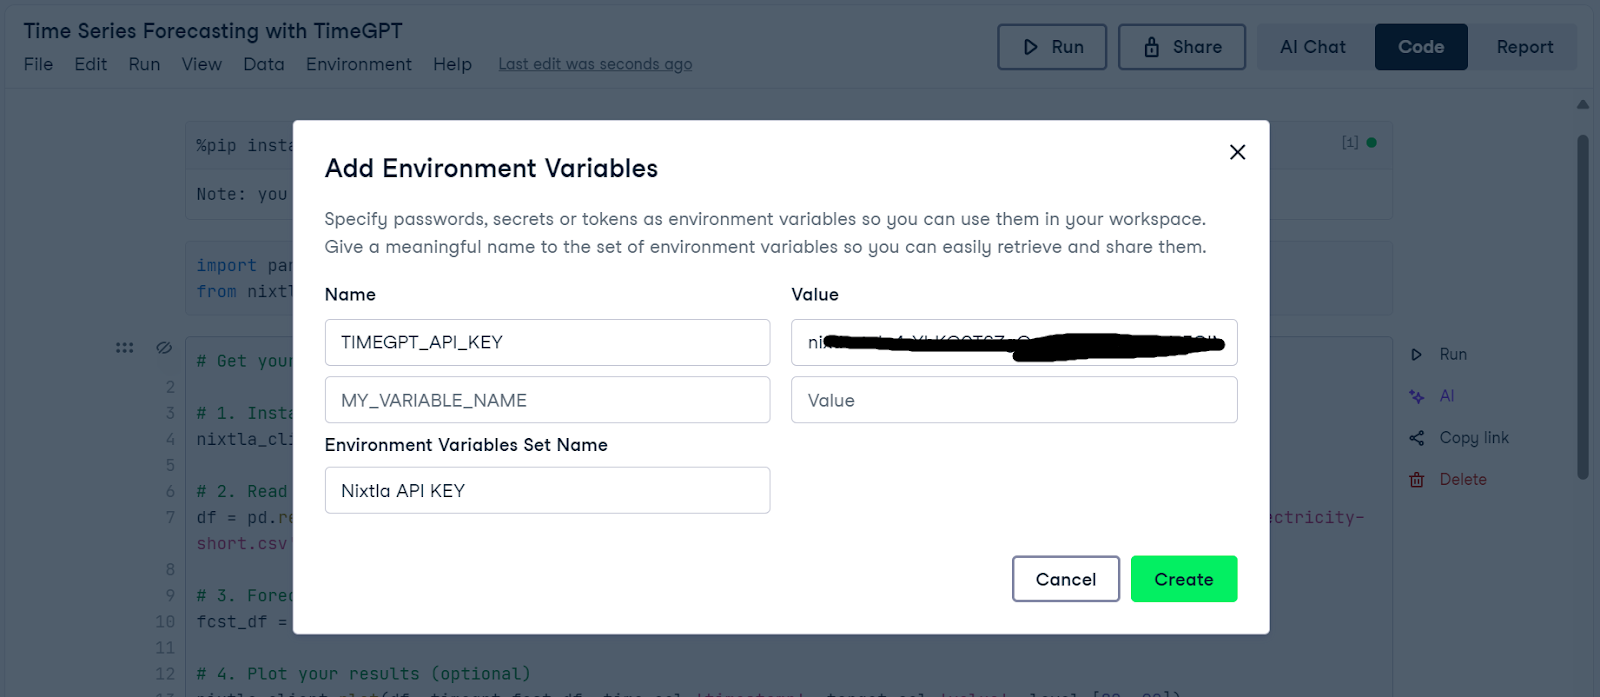
%%capture
%pip install nixtla>=0.5.1
%pip install yfinanceimport pandas as pd
import yfinance as yf
from nixtla import NixtlaClient
import os
timegpt_api_key = os.environ["TIMEGPT_API_KEY"]
# Setup NixtlaClient
nixtla_client = NixtlaClient(api_key = timegpt_api_key)
# Downloading Amazon stock price data
ticker = 'AMZN'
amazon_stock_data = yf.download(ticker)
amazon_stock_data = amazon_stock_data.reset_index()
# Displaying the dataset
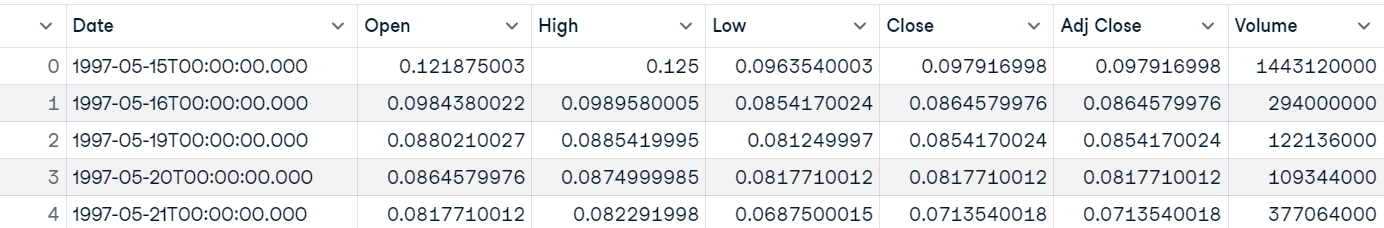
amazon_stock_data.head()Nous disposons des cours d’Amazon depuis 1997 jusqu’à aujourd’hui.
nixtla_client.plot(amazon_stock_data, time_col='Date', target_col='Close')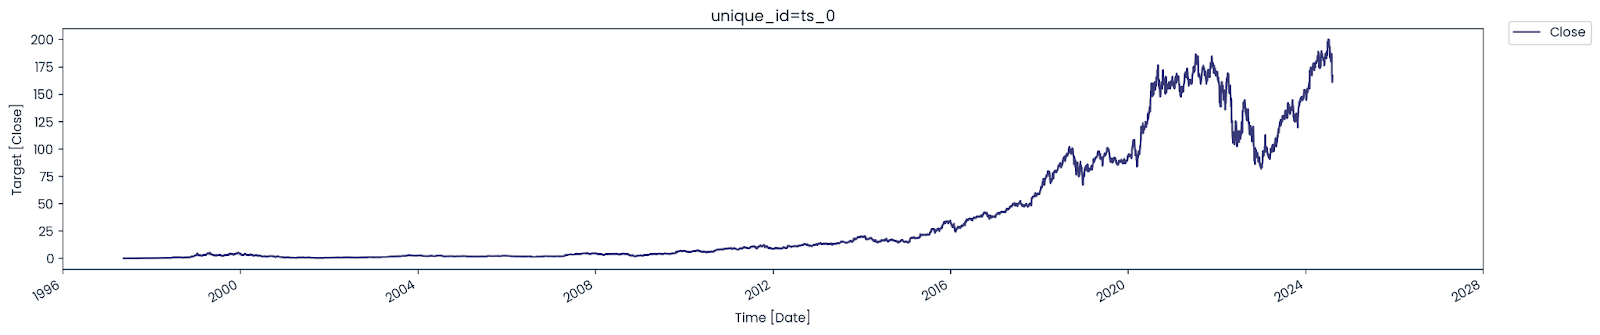
Découvrez comment créer des courbes de séries temporelles avec Matplotlib dans ce tutoriel Matplotlib : tracer des séries temporelles.
.forecast les données, le nom du modèle, l’horizon de prévision (ici 24 jours), la fréquence, ainsi que les colonnes de temps et de cible. La bourse étant fermée le week-end, nous choisissons la fréquence "business day (B)".model = nixtla_client.forecast(
df=amazon_stock_data,
model="timegpt-1",
h=24,
freq="B",
time_col="Date",
target_col="Close",
)
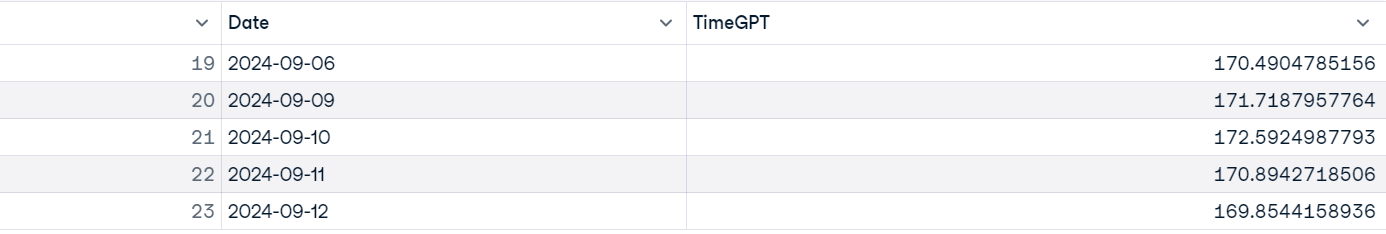
model.tail()
nixtla_client.plot(
    amazon_stock_data,
    model,
    time_col="Date",
    target_col="Close",
    max_insample_length=60,
)
Comme on le voit, en quelques secondes, TimeGPT a prévu avec précision les cours de clôture d’Amazon.
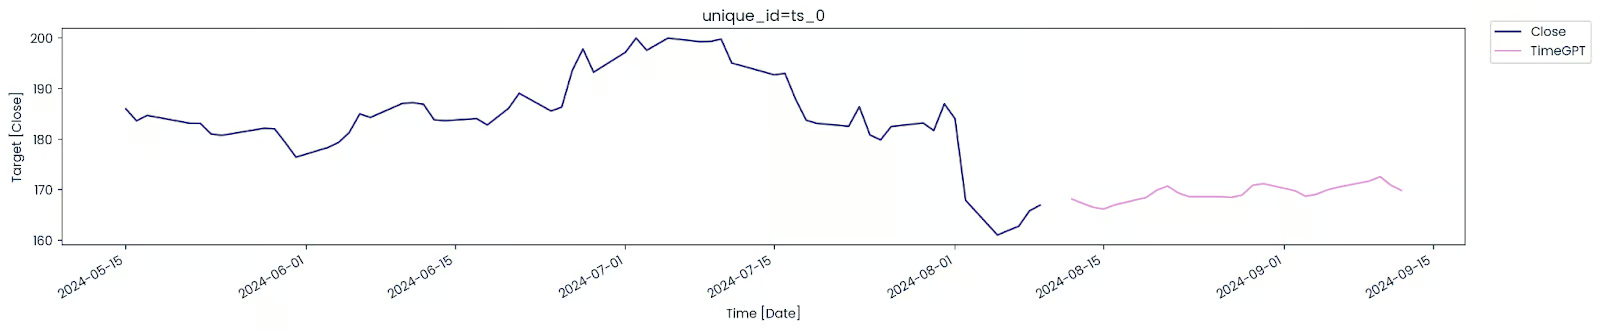
C’était un exemple pour débuter. Dans la prochaine section, nous travaillerons sur des jeux de données plus complexes et nous explorerons plusieurs fonctionnalités de l’API Nixtla.
Ici, nous allons utiliser un jeu de données plus riche, Australian Electricity Demand, et utiliser TimeGPT pour prévoir plusieurs séries en parallèle.
Le jeu de données comprend 5 séries représentant la demande d’électricité, toutes les demi-heures, pour 5 États d’Australie : Victoria, New South Wales, Queensland, Tasmanie et Australie‑Méridionale.
Nous verrons aussi comment affiner le modèle et ajuster divers hyperparamètres pour améliorer les performances. Enfin, nous réaliserons une validation croisée et comparerons les performances à des modèles traditionnels pour une évaluation complète.
Il n’existe pas de méthode simple dans pandas pour charger un fichier .tsf. Nous devons créer une fonction personnalisée pour lire, traiter les données puis les convertir en DataFrame pandas.
import pandas as pd


def read_tsf_from_file(file_path):
    data = []
    start_date = pd.to_datetime("2002-01-01 00:00:00")

    # Open and read the file from the directory

    with open(file_path, "r") as file:
        for line in file:
            if line.startswith("T"):
                parts = line.strip().split(":")
                unique_id = parts[0] + "-" + parts[1]
                values = list(map(float, parts[3].split(",")[:-1]))

                # Generate datetime index at half-hour intervals

                periods = len(values)
                date_range = pd.date_range(
                    start=start_date, periods=periods, freq="30min"
                )

                # Append to data list

                for dt, value in zip(date_range, values):
                    data.append([unique_id, dt, value])
    # Convert the list of data into a DataFrame

    return pd.DataFrame(data, columns=["unique_id", "ds", "y"])


# Example usage

file_path = "australian_electricity_demand_dataset.tsf"
demand_df = read_tsf_from_file(file_path)

# Display the dataframe

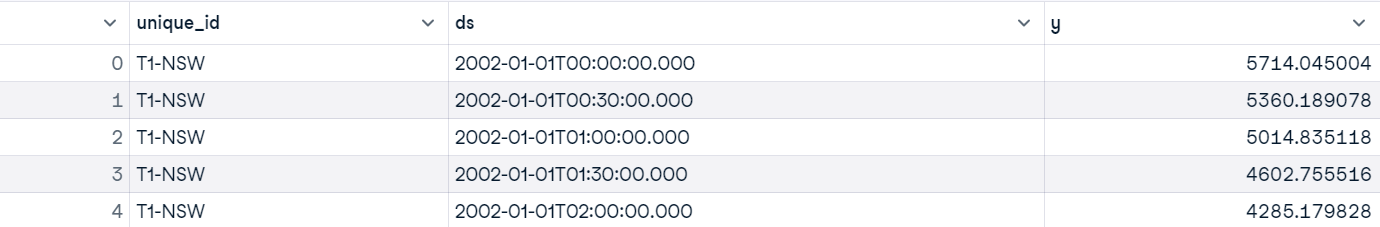
demand_df.head()
Notre jeu de données comporte trois colonnes :
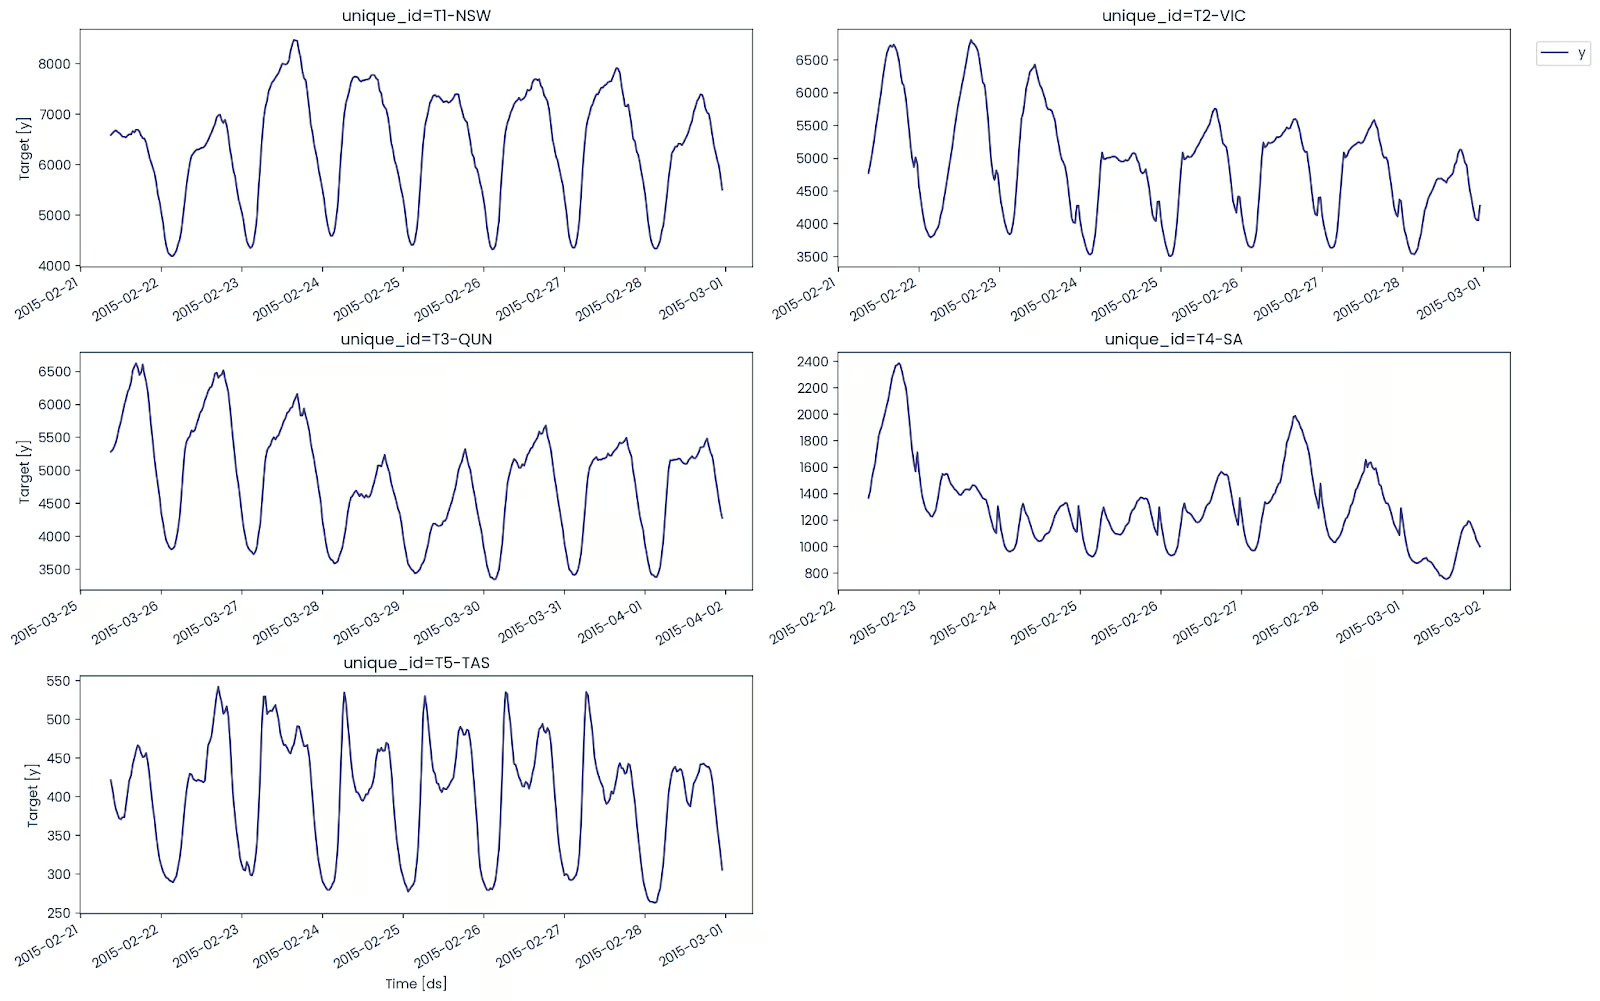
La fonction de tracé est pratique : elle détecte automatiquement la colonne unique_id et crée cinq visualisations distinctes.
nixtla_client.plot(
    demand_df,
    max_insample_length=365,
)
La visualisation ci-dessous montre la consommation d’électricité des 5 États, chacun présentant des profils différents.
Apprenez l’analyse de séries temporelles lors de la séance de code en direct sur DataCamp, où vous explorerez des séries financières avec Python.
Nous explorerons diverses actions, visualiserons leurs performances et ferons des prévisions avec différents modèles.
Avant de prévoir, identifions les anomalies du jeu de données pour mieux comprendre le problème.
La fonction .detect_anomalies prend le jeu de données, les colonnes de temps et de cible, ainsi que la fréquence.
# Detect anomalies
anomalies_df = nixtla_client.detect_anomalies(
    demand_df,
    time_col='ds',
    target_col='y',
    freq='H',
)
anomalies_df[anomalies_df["anomaly"]==1].head()
Nous affichons les occurrences où des anomalies ont été détectées.
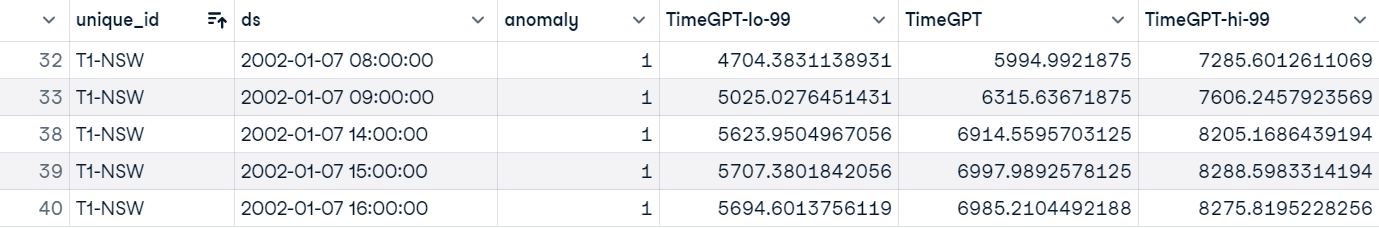
Le nombre total d’anomalies sur l’ensemble des 5 séries est de 17 316, ce qui est très élevé.
anomalies_df.anomaly.value_counts()
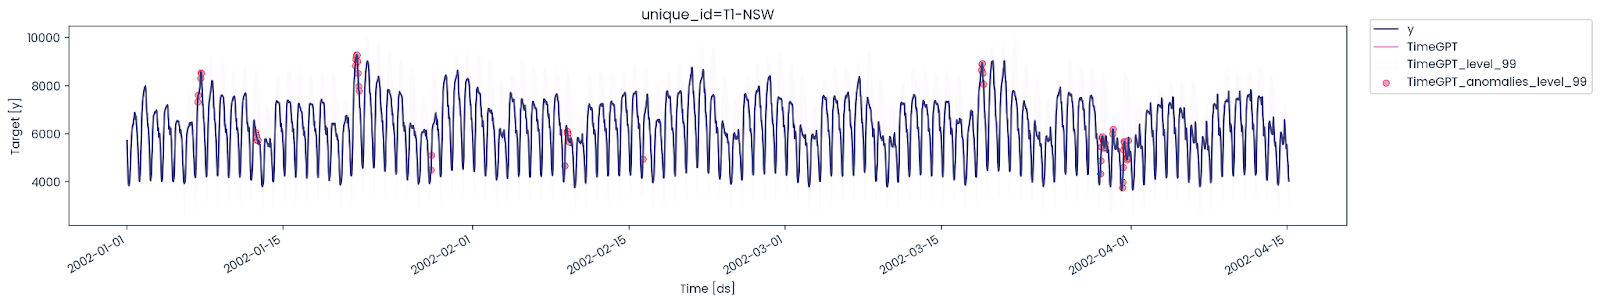
Nous allons maintenant projeter les anomalies sur la série réelle pour observer où et à quelle fréquence elles surviennent au fil des jours. Pour simplifier, nous n’afficherons que 5 000 échantillons pour New South Wales.
# Plot anomalies
nixtla_client.plot(
    demand_df[demand_df["unique_id"]=="T1-NSW"][0:5000],
    anomalies_df[anomalies_df["unique_id"]=="T1-NSW"][0:5000],
    time_col='ds',
    target_col='y',

)
Au quotidien, les anomalies restent rares, mais certains jours en concentrent plusieurs.
Nous allons maintenant prévoir la demande d’électricité du New South Wales. Pour cela, filtrons les valeurs pour "T1-NSW".
T1_df = demand_df[demand_df["unique_id"]=="T1-NSW"]
T1_df.head()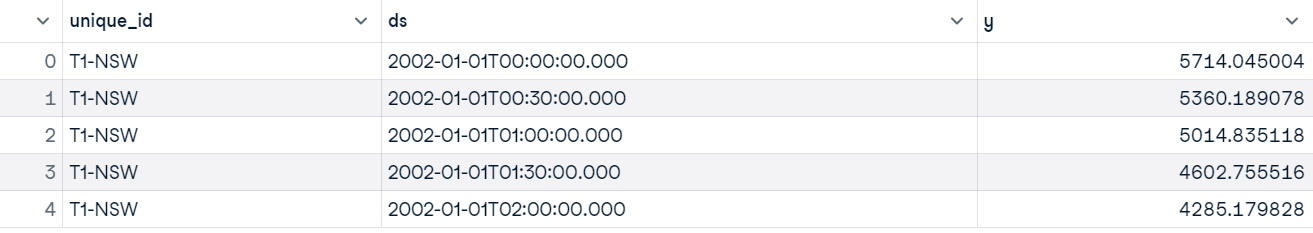
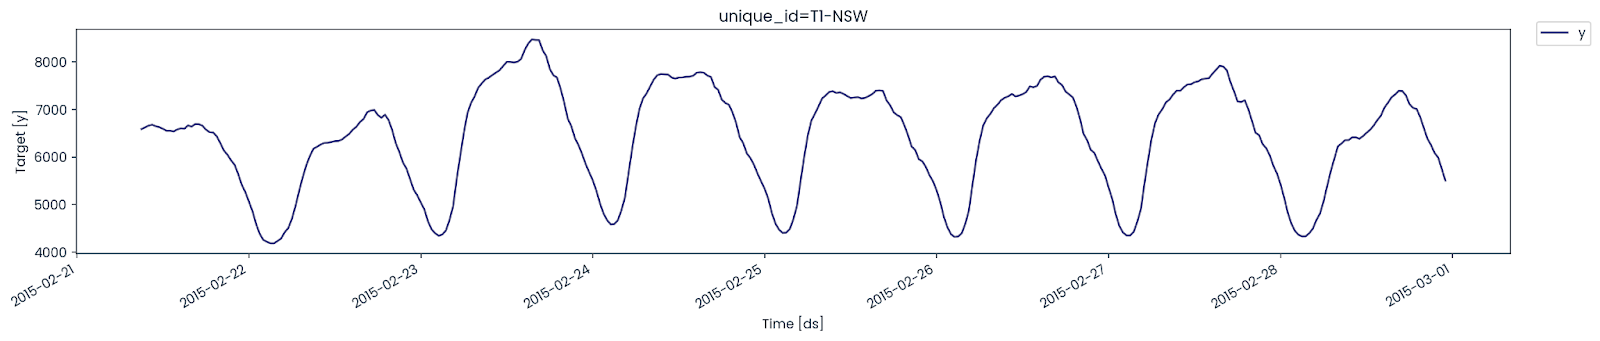
Traçons les 365 dernières valeurs pour saisir le profil de consommation.
nixtla_client.plot(
    T1_df,
    max_insample_length=365,
)
Nous allons maintenant évaluer les performances du modèle. Pour cela, nous séparons le jeu de données en apprentissage et test.
L’ensemble d’entraînement comporte 144 valeurs (3 jours) et le test 1 200 valeurs (25 jours).
test_df = T1_df.tail(144) # 3 days = (144 * 0.5h *  1 day/24h)
train_df = T1_df.iloc[-1344:-144] # 25 days = (1200 *0.5h * 1 day/24h)
Pour la prévision, nous allons choisir un modèle plus adapté et définir plusieurs paramètres pour améliorer les résultats, notamment :
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],  # Generate a 90% confidence interval
    finetune_steps=60,  # Specify the number of steps for fine-tuning
    finetune_loss="mae",  # Use the MAE as the loss function for fine-tuning
    model="timegpt-1-long-horizon",  # Use the model for long-horizon forecasting
    time_col="ds",
    target_col="y",
)
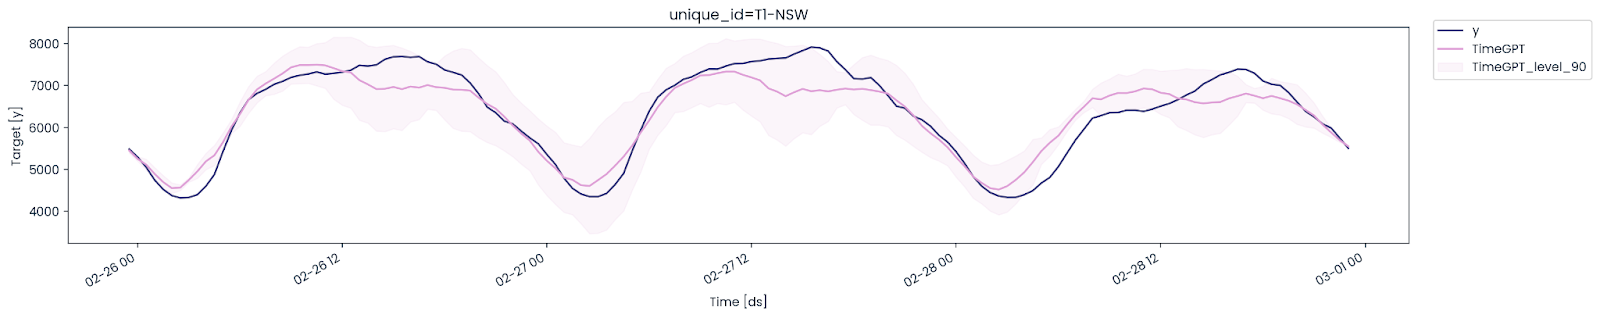
Traçons les valeurs réelles, la prévision et l’intervalle de confiance à 90 % pour juger la performance.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
En quelques secondes, nous obtenons un résultat très correct. C’est toute la force des modèles pré-entraînés.
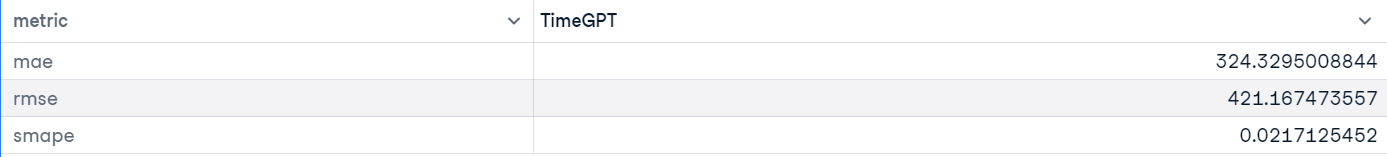
Nous allons maintenant évaluer les performances avec la bibliothèque UtilsForecast, issue du projet open source de Nixtla. Pour cela, nous fusionnons les jeux de test et de prévision et les passons à la fonction evaluate. Elle prend les données, les métriques, les modèles, la colonne cible et l’identifiant unique pour calculer et afficher les résultats dans un DataFrame pandas.
from utilsforecast.losses import mae, rmse, smape
from utilsforecast.evaluation import evaluate

predict_df["ds"] = pd.to_datetime(predict_df["ds"])
test_df = pd.merge(test_df, predict_df, "left", ["ds", "unique_id"])
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col="unique_id",
)

average_metrics = evaluation.groupby("metric")["TimeGPT"].mean()
average_metrics
Les résultats sont plutôt bons.
L’API Nixtla permet aussi de prévoir plusieurs séries d’un coup. Nous allons utiliser le jeu complet, sans filtrer par identifiant unique.
Pour séparer apprentissage et test, nous utilisons groupby afin de prendre 144 valeurs pour chaque identifiant. Sinon, nous n’aurions que 144 valeurs pour un identifiant choisi au hasard.
values for some randomly chosen unique ID.
test_df = demand_df.groupby("unique_id").tail(144)  # 3 days
train_df = (
    demand_df.groupby("unique_id")
    .apply(lambda group: group.iloc[-1344:-144])
    .reset_index(drop=True)
)  # 25 days
La fonction forecast est identique à celle utilisée plus haut, sauf que nous ajoutons la colonne d’identifiant.
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],
    finetune_steps=60,
    finetune_loss='mae',
    model='timegpt-1-long-horizon',
    time_col='ds',
    target_col='y',
    id_col='unique_id'
)
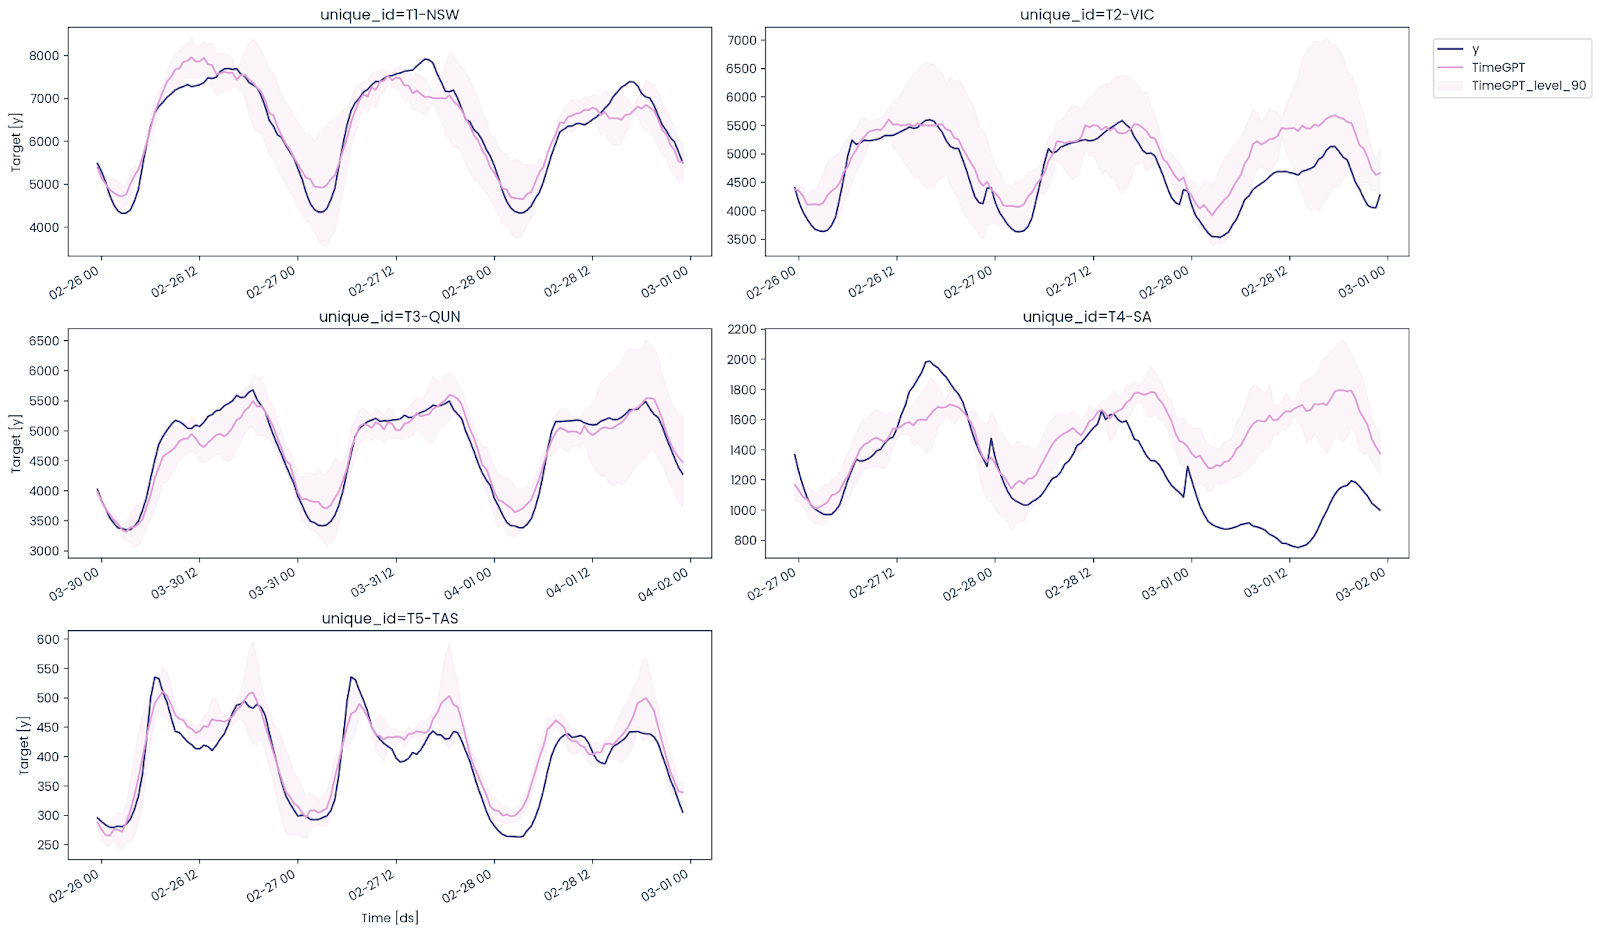
Tracez la courbe des valeurs réelles, prévues et l’intervalle de confiance à 90 % pour les 5 identifiants.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Comme on le voit, TimeGPT s’en sort bien sur plusieurs séries, à l’exception de l’Australie‑Méridionale, où il n’a pas anticipé la tendance baissière de la demande.
Nous devons fusionner les DataFrames de test et de prévision pour évaluer le modèle avec les métriques MAE, RMSE et SMAPE.
predict_df['ds'] = pd.to_datetime(predict_df['ds'])
test_df = pd.merge(test_df, predict_df, 'left', ['ds','unique_id'])
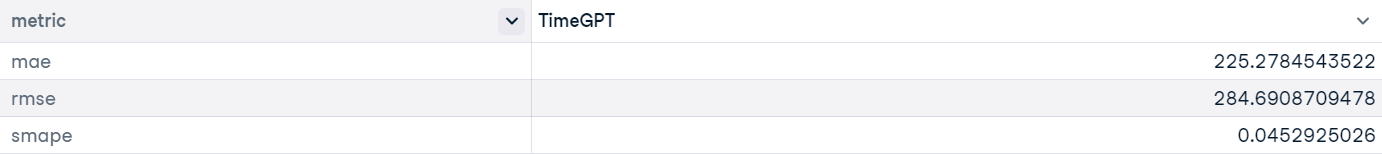
Utilisez evaluate pour générer un rapport de performance sous forme de DataFrame pandas. Il contient les métriques par identifiant. Pour obtenir la performance globale, moyennez les valeurs et affichez le résultat final.
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "unique_id"
)

average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Globalement, les performances s’améliorent quand on affine sur plusieurs séries plutôt qu’une seule.
Le client Nixtla permet aussi d’effectuer une validation croisée pour évaluer le modèle sur différentes fenêtres temporelles.
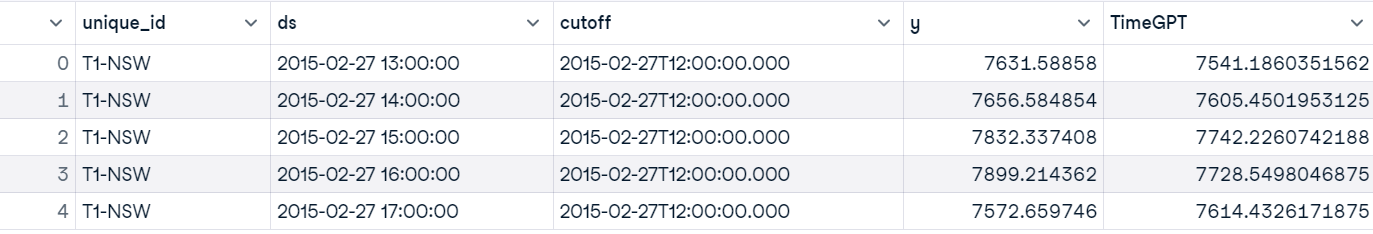
Nous allons utiliser .cross_validation avec le sous-ensemble New South Wales. La validation aura 5 fenêtres de 7 heures chacune.
timegpt_cv_df = nixtla_client.cross_validation(
    T1_df,
    h=7,
    n_windows=5,
    time_col='ds',
    target_col='y',
    freq='H',
)
timegpt_cv_df.head()
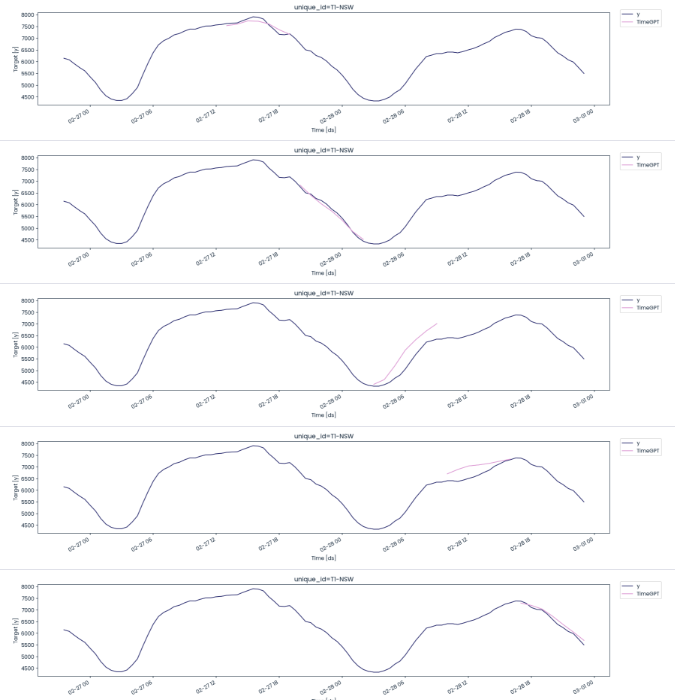
Comme on le voit, nous obtenons des prévisions pour chacune des cinq fenêtres de 7 heures.
Nous allons utiliser une date de coupure pour créer 5 fenêtres et afficher, pour chacune, les valeurs prévues et réelles.
cutoffs = timegpt_cv_df['cutoff'].unique()
for cutoff in cutoffs:
    fig = nixtla_client.plot(
        T1_df.tail(100),
        timegpt_cv_df.query('cutoff == @cutoff').drop(columns=['cutoff', 'y']),
        time_col='ds',
        target_col='y'
    )
    display(fig)
Hormis les 3e et 4e découpages, le modèle s’en sort très bien.
Comparons maintenant les performances de TimeGPT et du Light Gradient‑Boosting Machine (LGBM) pour déterminer lequel excelle sur ce jeu de données. Nous avons déjà effectué la validation croisée sur New South Wales ; utilisons la fonction evaluate pour générer le rapport d’évaluation.
evaluation = evaluate(
    timegpt_cv_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "cutoff"
)
evaluation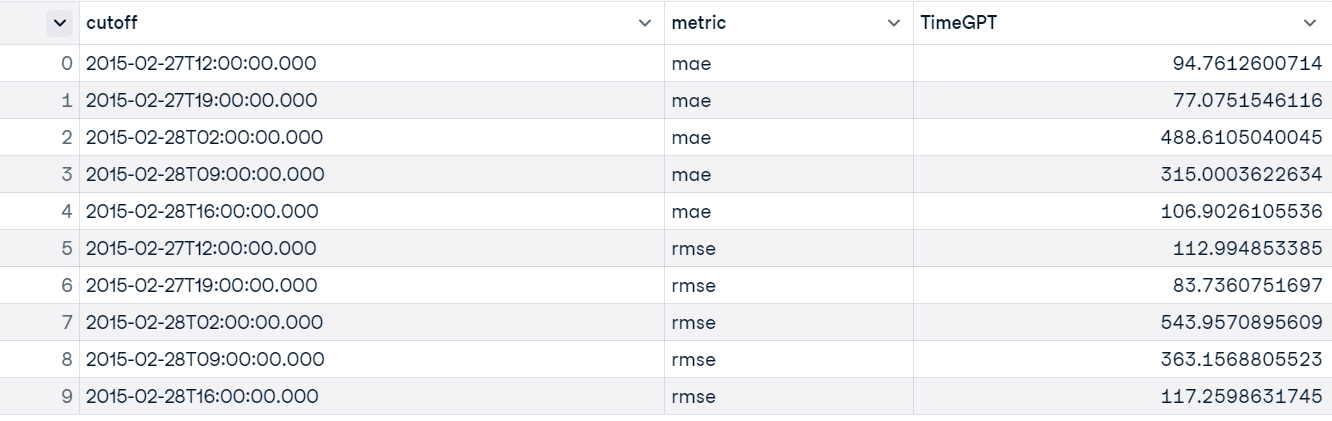
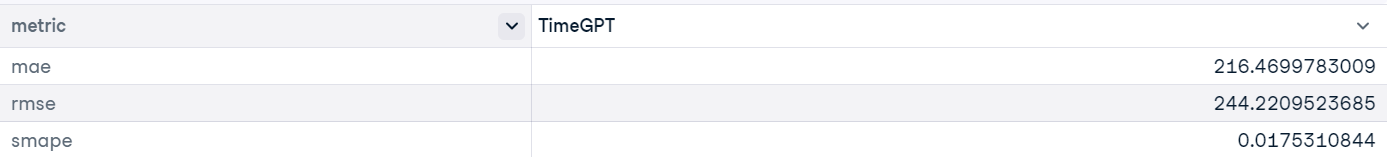
Nous devons calculer la moyenne des MAE, RMSE et SMAPE sur les 5 fenêtres pour obtenir le résultat global.
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Les résultats sont très corrects, même sur un petit échantillon.
Pour évaluer le modèle LGBM, suivez ces étapes :
Remarque : pour utiliser des modèles statistiques et de machine learning sur des séries temporelles, il est essentiel de maîtriser l’ingénierie de caractéristiques et les algorithmes de base. Pour un guide complet, consultez ce tutoriel : Tutoriel de prévision de séries temporelles sur DataCamp.
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import TimeSeriesSplit
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Function to calculate SMAPE
def smape(y_true, y_pred):
    return np.mean(2 * np.abs(y_pred - y_true) / (np.abs(y_true) + np.abs(y_pred)))

# Assuming 'ds' is the date/time column and 'y' is the target variable
T1_df['ds'] = pd.to_datetime(T1_df['ds'])

# Filter the DataFrame to include only the specified datetime range
start_date = '2015-02-27T13:00:00'
end_date = '2015-02-28T23:00:00'
T1_df = T1_df[(T1_df['ds'] >= start_date) & (T1_df['ds'] <= end_date)]

# Convert 'ds' to a numerical value (e.g., timestamp)
T1_df['ds_num'] = T1_df['ds'].apply(lambda x: x.timestamp())

# Create lag and window features
for lag in range(1, 4):
    T1_df[f'lag_{lag}'] = T1_df['y'].shift(lag)

T1_df['rolling_mean'] = T1_df['y'].rolling(window=3).mean()
T1_df['rolling_std'] = T1_df['y'].rolling(window=3).std()

# Drop NaN values resulting from lag and rolling operations
T1_df.dropna(inplace=True)

# Select features for the model
X = T1_df[['ds_num', 'lag_1', 'lag_2', 'lag_3', 'rolling_mean', 'rolling_std']]
y = T1_df['y']

# Time series split
tscv = TimeSeriesSplit(n_splits=5)
mae_scores = []
rmse_scores = []
smape_scores = []

for train_index, test_index in tscv.split(X):
    X_train, X_test = X.iloc[train_index], X.iloc[test_index]
    y_train, y_test = y.iloc[train_index], y.iloc[test_index]

    # Initialize and train the LGBM model
    model = lgb.LGBMRegressor(force_row_wise=True, verbosity=-1)
    model.fit(X_train, y_train)

    # Make predictions
    y_pred = model.predict(X_test)

    # Evaluate the model
    mae = mean_absolute_error(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))
    smape_value = smape(y_test, y_pred)

    mae_scores.append(mae)
    rmse_scores.append(rmse)
    smape_scores.append(smape_value)

# Convert the metrics into a DataFrame
mae_avg = np.mean(mae_scores)
rmse_avg = np.mean(rmse_scores)
smape_avg = np.mean(smape_scores)

metrics_df = pd.DataFrame({
    'metric': ['MAE', 'RMSE', 'SMAPE'],
    'LGBM': [mae_avg, rmse_avg, smape_avg]
})

# Display the DataFrame
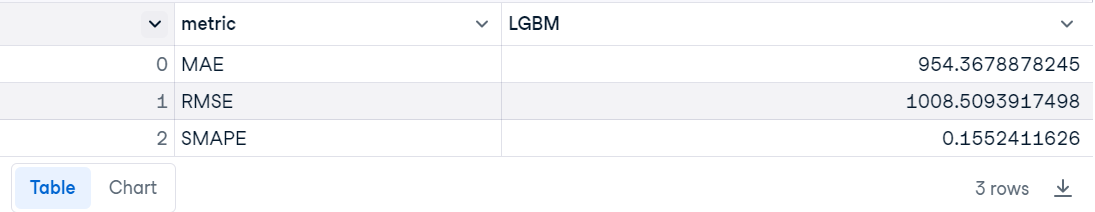
metrics_df
TimeGPT est près de 5 fois meilleur que LGBM.
Si vous rencontrez des difficultés pour exécuter le code ci-dessus ou configurer TimeGPT, consultez l’espace DataLab : Time Series Forecasting with TimeGPT.
L’écosystème TimeGPT et Nixtla est idéal pour les entreprises qui démarrent : plus besoin d’embaucher des ingénieurs en machine learning pour entraîner des modèles, ni des ingénieurs MLOps pour les déployer et les maintenir. Si vous êtes une startup, vous pouvez réduire fortement vos coûts tout en accédant à des modèles performants.
À l’instar de GPT‑3, TimeGPT marque le début des modèles de pointe pour séries temporelles. À mesure qu’ils progresseront, de nombreuses entreprises adopteront l’API Nixtla pour une intégration simple et de meilleures performances.
Dans ce tutoriel, nous avons découvert TimeGPT, le premier modèle fondamental pour séries temporelles. Nous avons aussi appris à utiliser l’API Python pour accéder à TimeGPT et réaliser des tâches telles que la prévision, la visualisation de séries temporelles, l’évaluation de modèles, la validation croisée et la détection d’anomalies.
Apprenez à prévoir l’avenir avec les modèles de la famille ARIMA et à générer des prédictions et des insights avec des modèles de machine learning grâce au parcours Time Series with Python. Si vous préférez R, découvrez le parcours Time Series with R pour maîtriser la prévision de séries temporelles.
Les meilleurs cours DataCamp
Cursus
Cursus
Cursus