Programa
Séries temporais em Python
20 h
Treinar um modelo de machine learning para séries temporais não é trivial; é bem diferente de problemas clássicos de classificação ou regressão. Você precisa criar janelas e defasagens (lags) para gerar novas features a partir dos dados existentes e, mesmo assim, o modelo pode não performar bem. Não é só a regressão linear que sofre: até modelos de deep learning como LSTM e GRU podem ter um desempenho fraco ao prever o mercado de ações.
Precisamos de um modelo no estilo GPT-4o para séries temporais que funcione bem em diferentes tipos de datasets? Com certeza. O TimeGPT é um modelo fundamental de última geração, capaz de prever até mesmo em conjuntos de dados nunca vistos.
Neste tutorial, vamos explorar a arquitetura do TimeGPT, como ele foi treinado e seus benchmarks. Além disso, você vai aprender a usar a API da Nixtla para acessar o TimeGPT e fazer previsões, detecção de anomalias, visualizações de séries temporais e avaliação de modelos.
Imagem do autor | Canva
TimeGPT-1 é um modelo de séries temporais baseado em Transformer com mecanismos de self-attention, acessível via API da Nixtla. É o primeiro modelo fundamental para séries temporais com boa acurácia em dados não vistos. Tudo o que você precisa fazer é ajustá-lo ao seu dataset e, em poucos segundos, ele entrega desempenho de ponta.
A arquitetura do TimeGPT segue um esquema encoder-decoder com múltiplas camadas, cada uma com conexões residuais e normalização de camadas. A camada de saída é linear e mapeia o output do decoder para a dimensão da janela de previsão.
Ele foi treinado na maior coleção pública de séries temporais, o que permite prever datasets inéditos sem precisar de re-treinamento. Para gerar a previsão, o TimeGPT recebe uma janela de valores anteriores e adiciona um codificador posicional local para enriquecer a entrada.
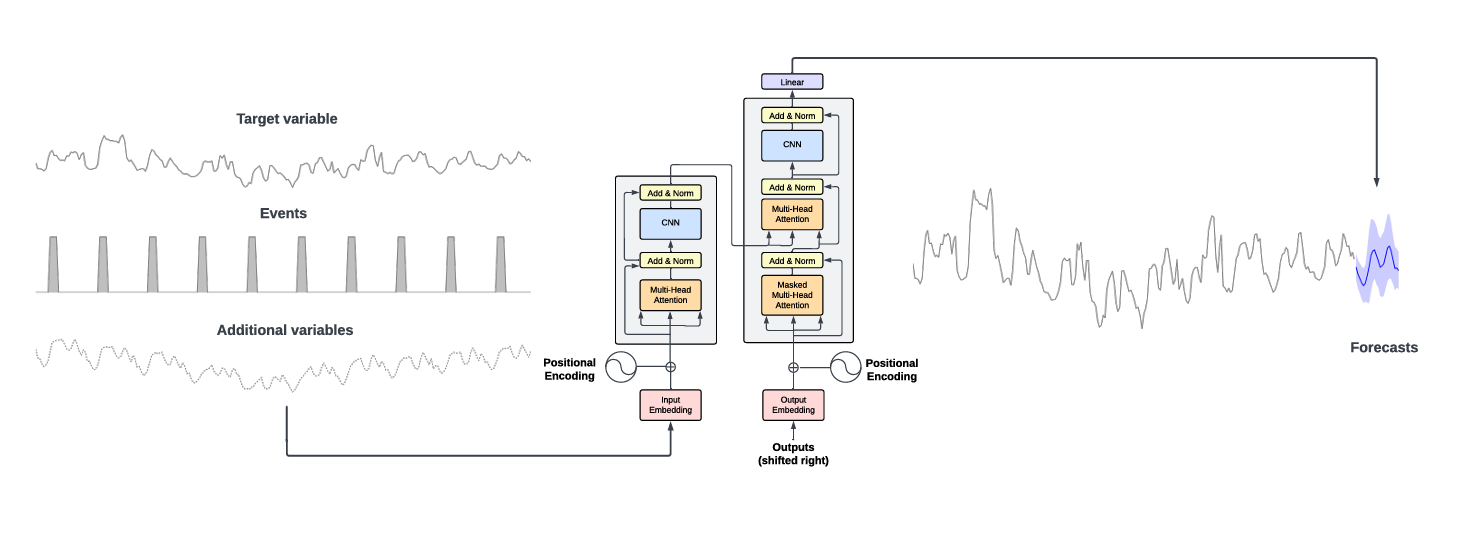
Fonte: 2310.03589 (arxiv.org) | O TimeGPT usa valores históricos da variável alvo e variáveis exógenas adicionais como entrada para produzir as previsões.
O TimeGPT supera métodos estatísticos, de machine learning e de deep learning consagrados, exibindo desempenho superior em zero-shot, além de eficiência e simplicidade. Como mostram os benchmarks abaixo, o TimeGPT se destaca em várias métricas de machine learning, mesmo sem qualquer feature engineering.
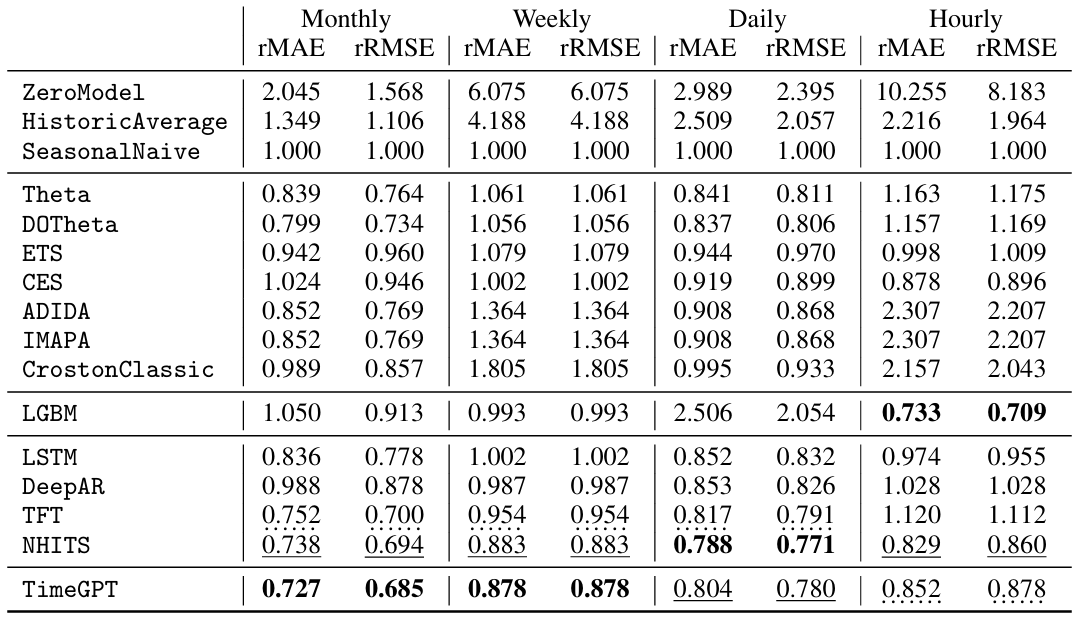
Fonte: 2310.03589 (arxiv.org) | Modelos avaliados com rMAE e rRMSE; quanto menor, melhor.
O TimeGPT não é open source e só pode ser acessado pela API da Nixtla. Esta seção mostra como configurar a API da Nixtla para acessar o TimeGPT e prever dados das ações da Amazon.
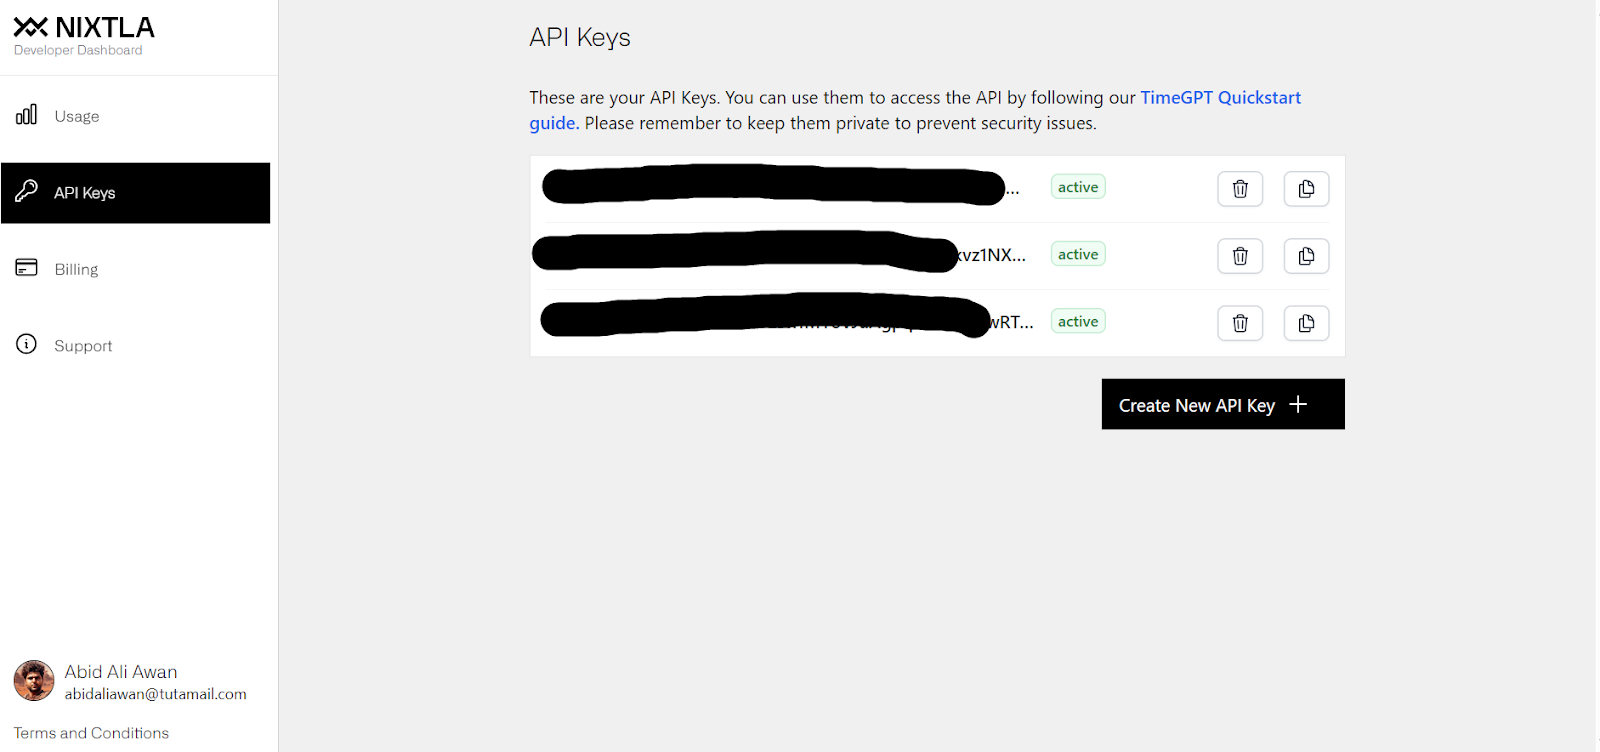
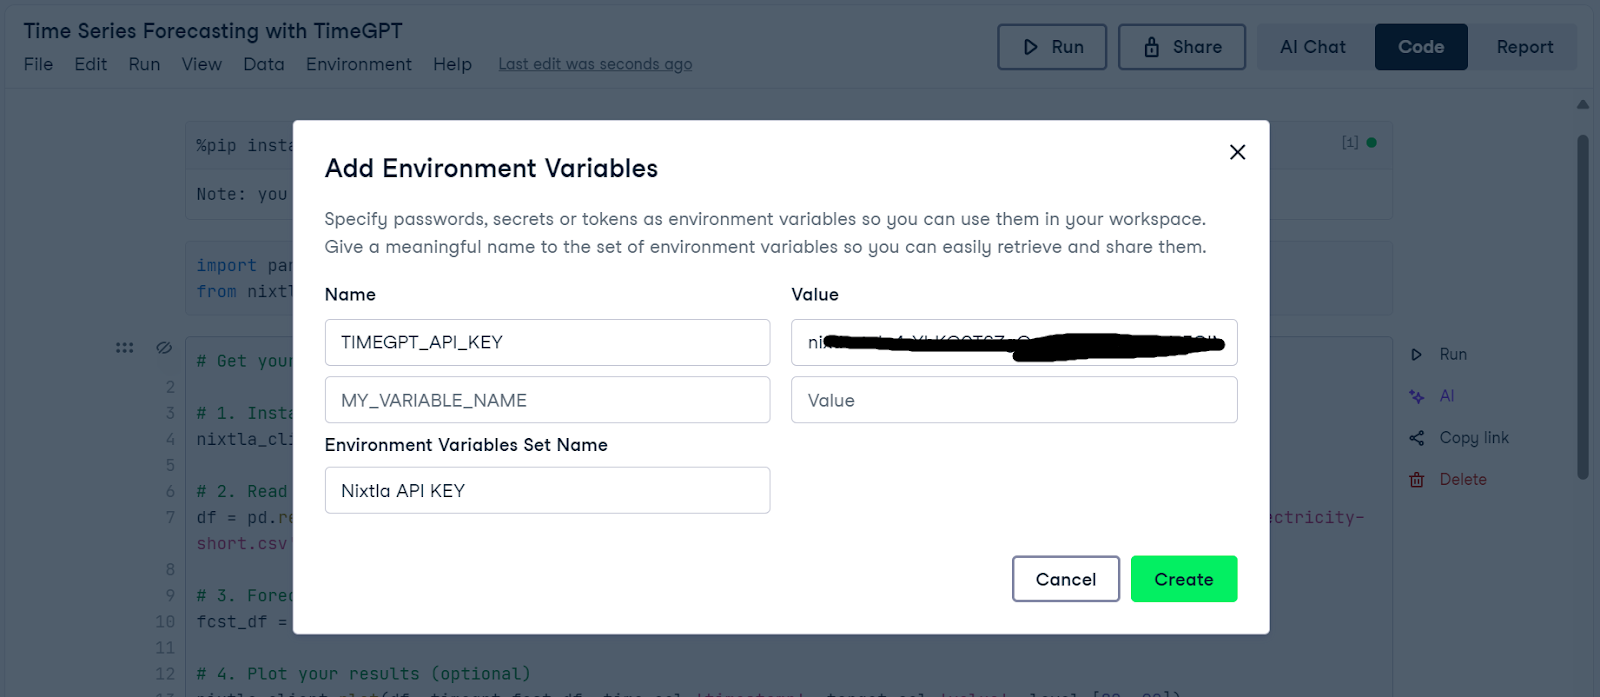
%%capture
%pip install nixtla>=0.5.1
%pip install yfinanceimport pandas as pd
import yfinance as yf
from nixtla import NixtlaClient
import os
timegpt_api_key = os.environ["TIMEGPT_API_KEY"]
# Setup NixtlaClient
nixtla_client = NixtlaClient(api_key = timegpt_api_key)
# Downloading Amazon stock price data
ticker = 'AMZN'
amazon_stock_data = yf.download(ticker)
amazon_stock_data = amazon_stock_data.reset_index()
# Displaying the dataset
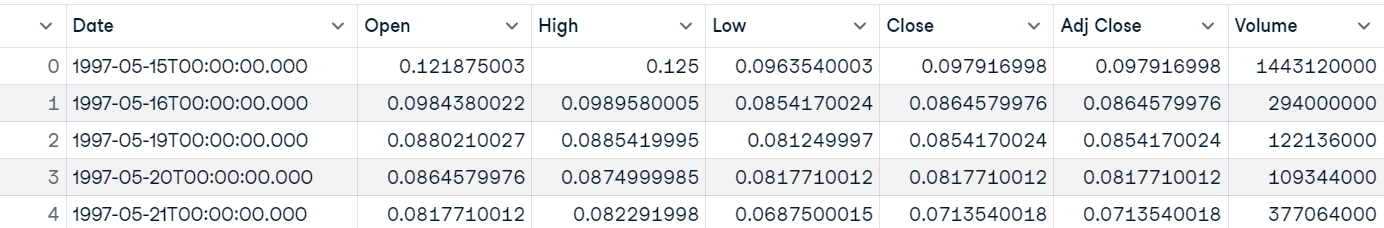
amazon_stock_data.head()Temos dados do preço da ação da Amazon desde 1997 até hoje.
nixtla_client.plot(amazon_stock_data, time_col='Date', target_col='Close')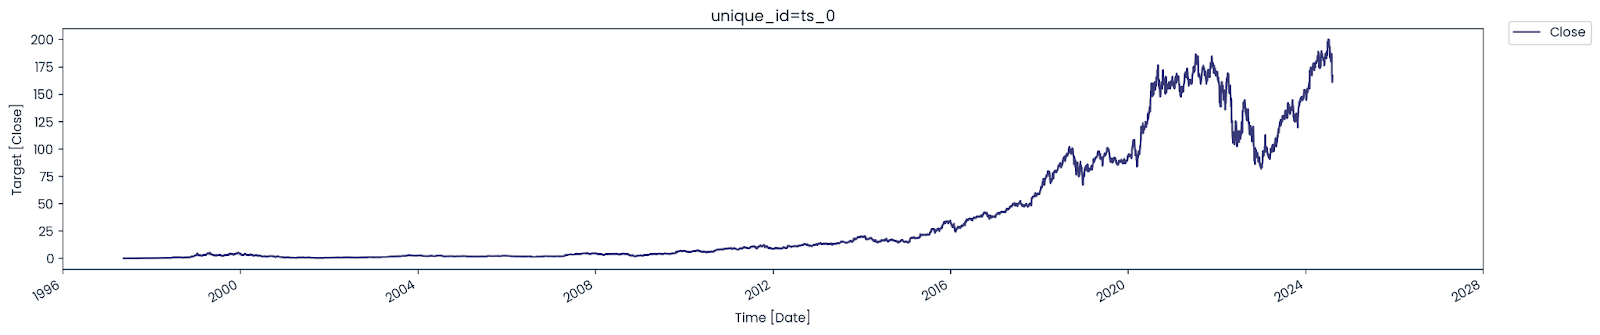
Aprenda a criar gráficos de linha para séries temporais com Matplotlib seguindo este tutorial de gráfico de linhas para séries temporais no Matplotlib.
.forecast os dados da ação, o nome do modelo, o horizonte de previsão (equivalente a 24 dias), a frequência, a coluna de tempo e a coluna alvo. Como a bolsa fecha nos fins de semana, selecionamos a frequência "business day (B)".model = nixtla_client.forecast(
df=amazon_stock_data,
model="timegpt-1",
h=24,
freq="B",
time_col="Date",
target_col="Close",
)
model.tail()
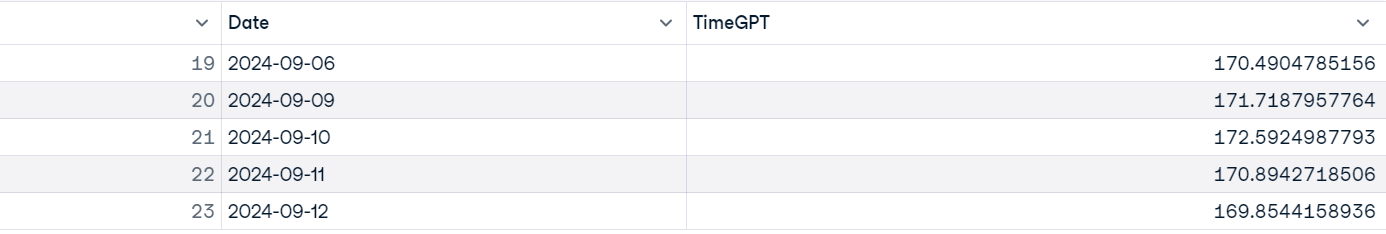
nixtla_client.plot(
    amazon_stock_data,
    model,
    time_col="Date",
    target_col="Close",
    max_insample_length=60,
)
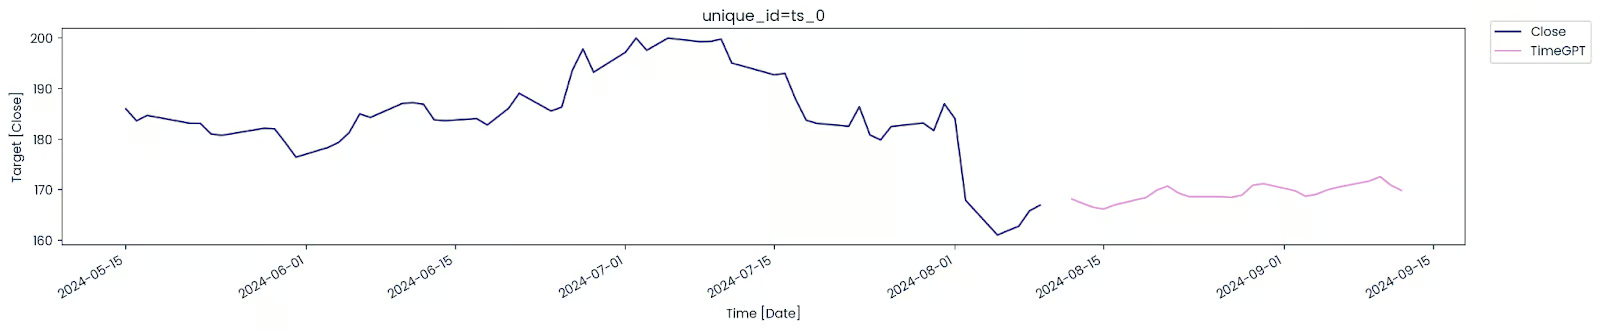
Como dá para ver, em poucos segundos o TimeGPT previu com precisão os preços de fechamento da Amazon.
Esse foi um exemplo introdutório. Na próxima seção, vamos trabalhar com um dataset mais complexo e explorar vários recursos da API da Nixtla.
Aqui vamos usar um dataset mais complexo de demanda de eletricidade na Austrália e usar o TimeGPT para prever múltiplos valores de uma vez.
O dataset traz 5 séries que representam a demanda de eletricidade, a cada meia hora, em 5 estados da Austrália: Victoria, New South Wales, Queensland, Tasmânia e Austrália do Sul.
Também vamos aprender a fazer fine-tuning do modelo e a usar diferentes hiperparâmetros para melhorar o desempenho. Por fim, vamos conduzir uma validação cruzada e comparar o desempenho com modelos tradicionais para uma avaliação completa.
Não há uma forma simples de carregar arquivos .tsf na biblioteca pandas. Precisamos criar uma função customizada para ler e processar os dados e então convertê-los em um dataframe do Pandas.
import pandas as pd


def read_tsf_from_file(file_path):
    data = []
    start_date = pd.to_datetime("2002-01-01 00:00:00")

    # Open and read the file from the directory

    with open(file_path, "r") as file:
        for line in file:
            if line.startswith("T"):
                parts = line.strip().split(":")
                unique_id = parts[0] + "-" + parts[1]
                values = list(map(float, parts[3].split(",")[:-1]))

                # Generate datetime index at half-hour intervals

                periods = len(values)
                date_range = pd.date_range(
                    start=start_date, periods=periods, freq="30min"
                )

                # Append to data list

                for dt, value in zip(date_range, values):
                    data.append([unique_id, dt, value])
    # Convert the list of data into a DataFrame

    return pd.DataFrame(data, columns=["unique_id", "ds", "y"])


# Example usage

file_path = "australian_electricity_demand_dataset.tsf"
demand_df = read_tsf_from_file(file_path)

# Display the dataframe

demand_df.head()
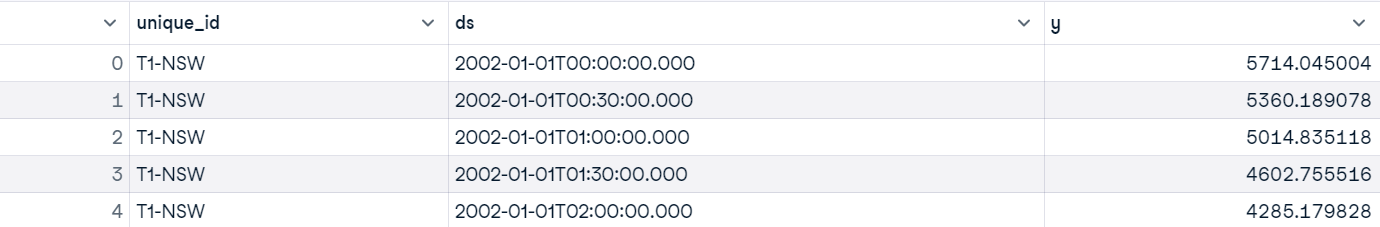
Nosso dataset tem três colunas:
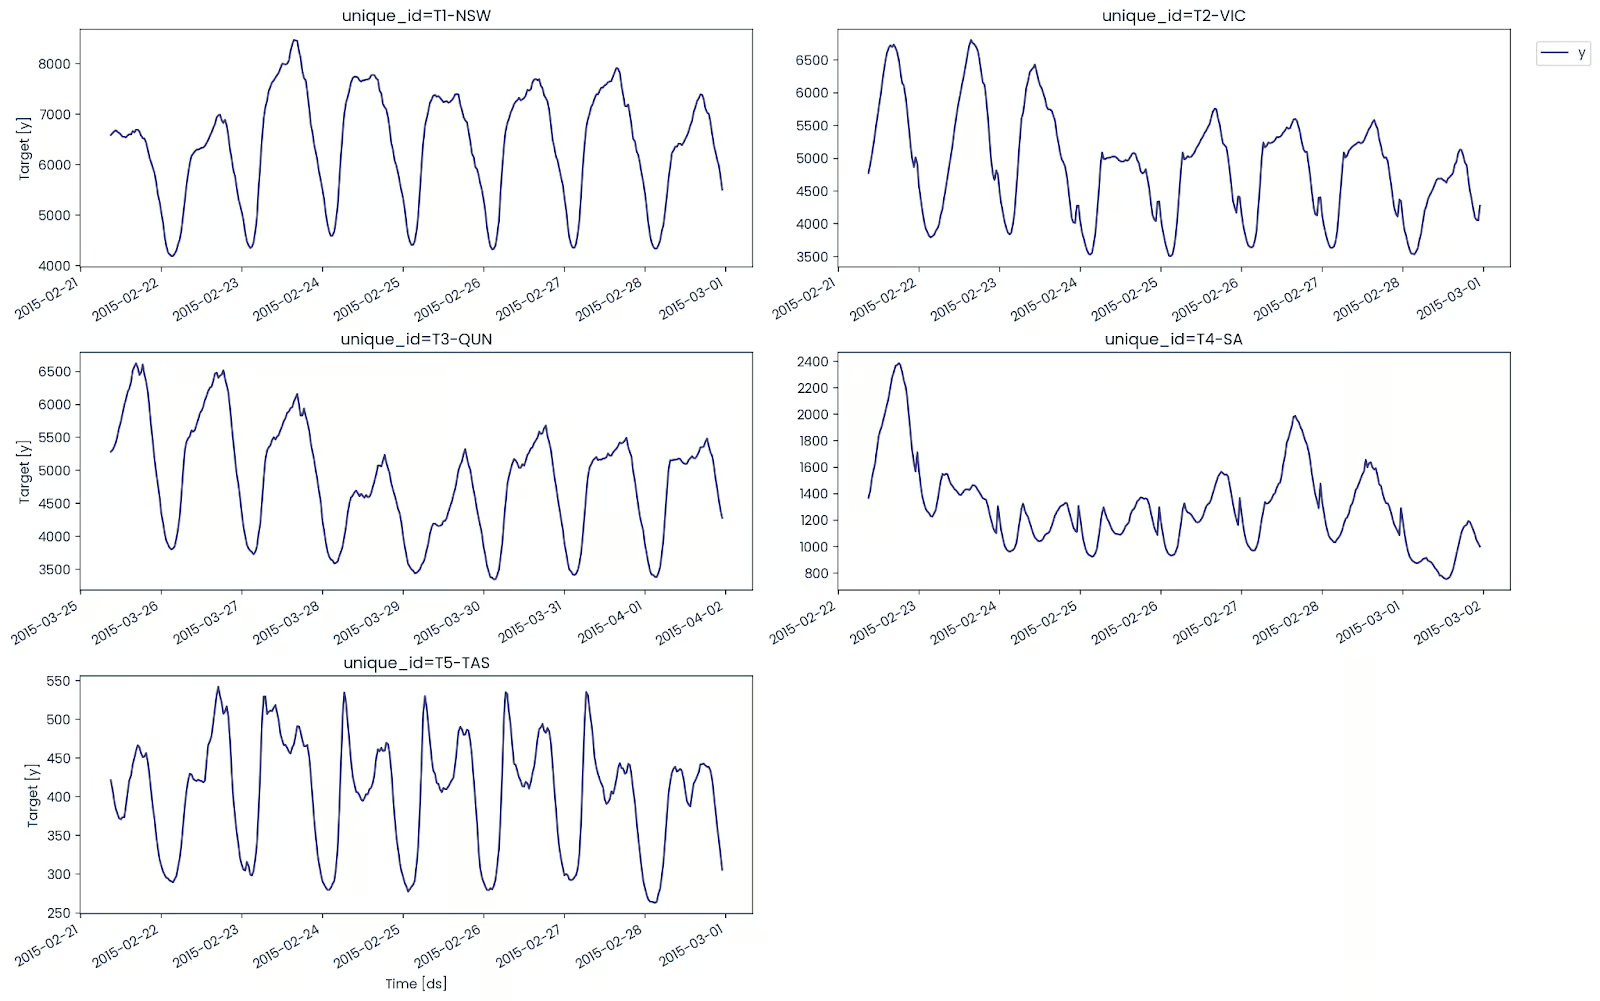
A função de plot é ótima porque identifica automaticamente a coluna unique_id e cria cinco visualizações de séries temporais diferentes.
nixtla_client.plot(
    demand_df,
    max_insample_length=365,
)
A visualização abaixo mostra o consumo de energia dos 5 estados, cada um com padrões distintos.
Aprenda análise de séries temporais participando da sessão de code-along ao vivo no DataCamp, onde você vai explorar séries financeiras em Python.
Nesta sessão, vamos explorar diferentes ações, visualizar o desempenho e fazer previsões com vários modelos.
Antes de prever, vamos identificar diferentes anomalias no dataset para entender melhor o problema.
A função .detect_anomalies recebe o dataset, as colunas de tempo e alvo, e a frequência.
# Detect anomalies
anomalies_df = nixtla_client.detect_anomalies(
    demand_df,
    time_col='ds',
    target_col='y',
    freq='H',
)
anomalies_df[anomalies_df["anomaly"]==1].head()
Exibimos todas as ocorrências em que anomalias foram detectadas.
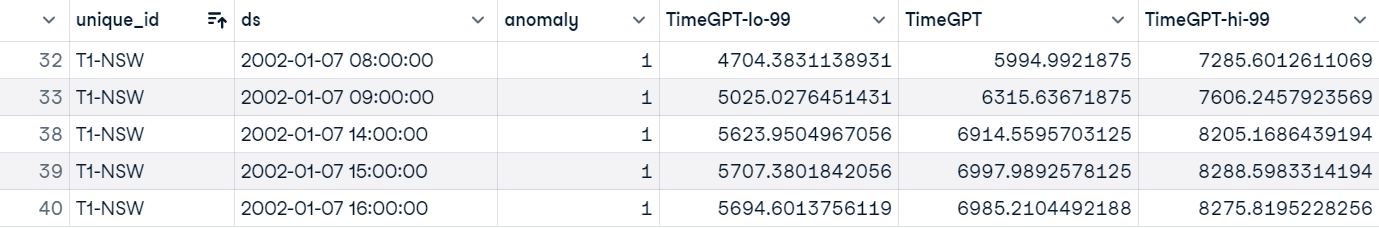
O total de anomalias nas 5 séries é 17.316 — é bastante coisa.
anomalies_df.anomaly.value_counts()
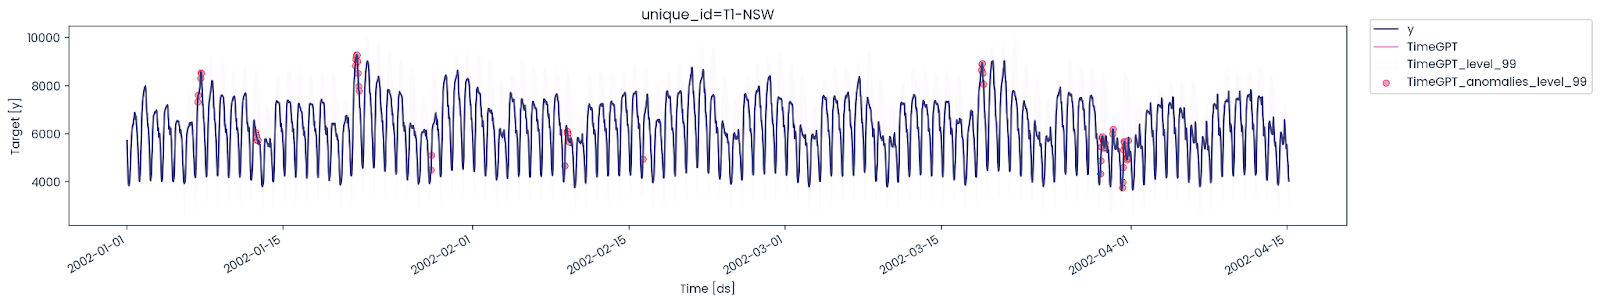
Agora vamos plotar as anomalias sobre os dados reais para ver onde e com que frequência ocorrem dia a dia. Para simplificar, vamos exibir apenas 5.000 amostras de New South Wales.
# Plot anomalies
nixtla_client.plot(
    demand_df[demand_df["unique_id"]=="T1-NSW"][0:5000],
    anomalies_df[anomalies_df["unique_id"]=="T1-NSW"][0:5000],
    time_col='ds',
    target_col='y',

)
As anomalias diárias não são comuns, mas há dias com várias ocorrências no mesmo dia.
Agora vamos prever a demanda de eletricidade de New South Wales. Para isso, filtramos apenas os valores de "T1-NSW".
T1_df = demand_df[demand_df["unique_id"]=="T1-NSW"]
T1_df.head()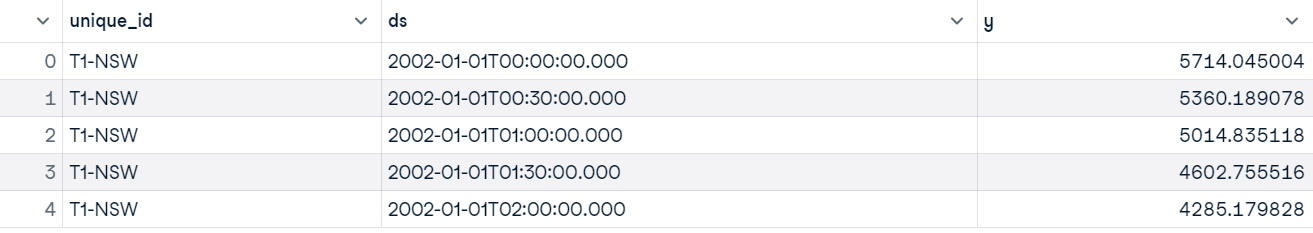
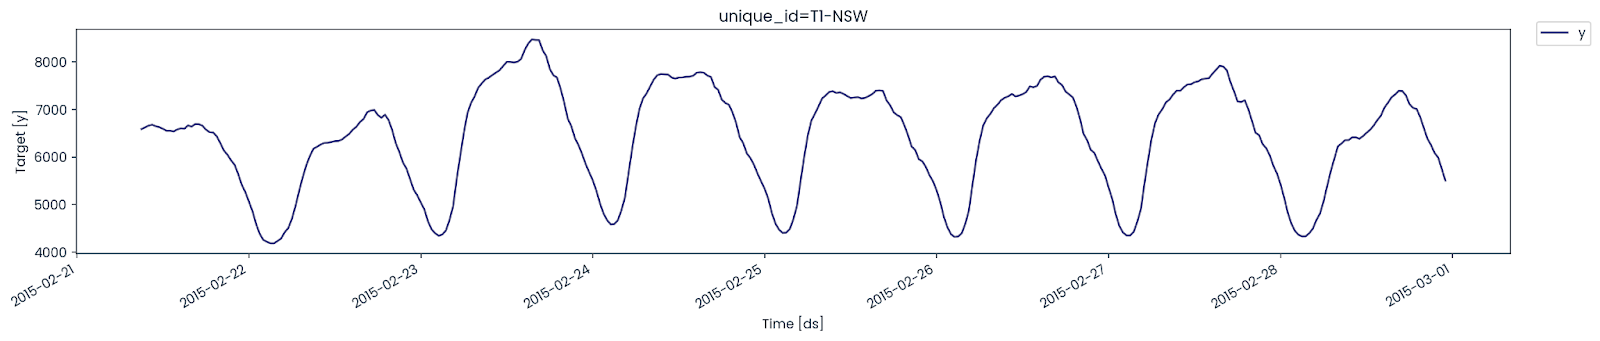
Plote os últimos 365 valores para entender o padrão de consumo elétrico.
nixtla_client.plot(
    T1_df,
    max_insample_length=365,
)
Agora vamos avaliar o desempenho do modelo. Para isso, separamos o dataset em treino e teste.
O conjunto de treino tem 144 valores (3 dias) e o de teste 1200 valores (25 dias).
test_df = T1_df.tail(144) # 3 days = (144 * 0.5h *  1 day/24h)
train_df = T1_df.iloc[-1344:-144] # 25 days = (1200 *0.5h * 1 day/24h)
Para a previsão, vamos escolher um modelo mais adequado e definir alguns argumentos para melhorar o desempenho, especificamente:
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],  # Generate a 90% confidence interval
    finetune_steps=60,  # Specify the number of steps for fine-tuning
    finetune_loss="mae",  # Use the MAE as the loss function for fine-tuning
    model="timegpt-1-long-horizon",  # Use the model for long-horizon forecasting
    time_col="ds",
    target_col="y",
)
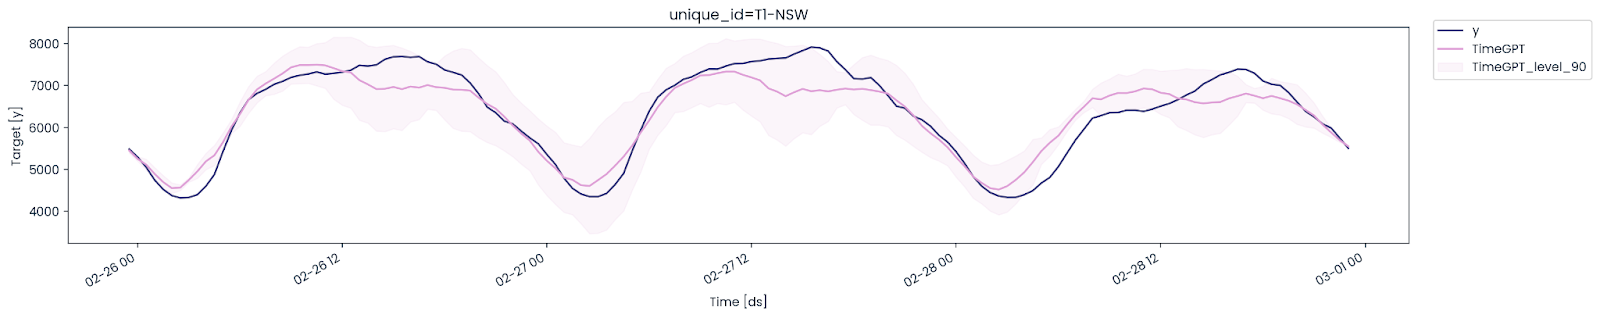
Plote os dados reais, a previsão e o intervalo de confiança de 90% para avaliar o desempenho.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Em poucos segundos, tivemos um resultado bem preciso. Esse é o poder de modelos pré-treinados.
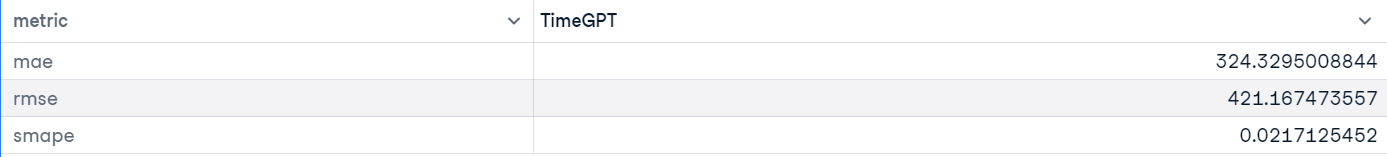
Agora vamos avaliar o desempenho com a biblioteca UtilsForecast, parte do projeto open source da Nixtla. Para isso, unimos os dataframes de teste e previsão e os passamos para a função evaluate. A função recebe o dataset, as métricas, os modelos, a coluna alvo e o identificador único para calcular e exibir as métricas em um dataframe do pandas.
from utilsforecast.losses import mae, rmse, smape
from utilsforecast.evaluation import evaluate

predict_df["ds"] = pd.to_datetime(predict_df["ds"])
test_df = pd.merge(test_df, predict_df, "left", ["ds", "unique_id"])
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col="unique_id",
)

average_metrics = evaluation.groupby("metric")["TimeGPT"].mean()
average_metrics
Os resultados ficaram bem satisfatórios.
A API da Nixtla também permite prever várias séries de uma vez. Vamos usar o dataset completo em vez de filtrar por um único ID.
Para dividir o dataset em treino e teste, usamos groupby para separar 144 valores para cada ID exclusivo. Caso contrário, teríamos apenas 144 valores de um ID aleatório.
values for some randomly chosen unique ID.
test_df = demand_df.groupby("unique_id").tail(144)  # 3 days
train_df = (
    demand_df.groupby("unique_id")
    .apply(lambda group: group.iloc[-1344:-144])
    .reset_index(drop=True)
)  # 25 days
A função forecast é a mesma da parte anterior, mas agora também informamos a coluna de ID.
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],
    finetune_steps=60,
    finetune_loss='mae',
    model='timegpt-1-long-horizon',
    time_col='ds',
    target_col='y',
    id_col='unique_id'
)
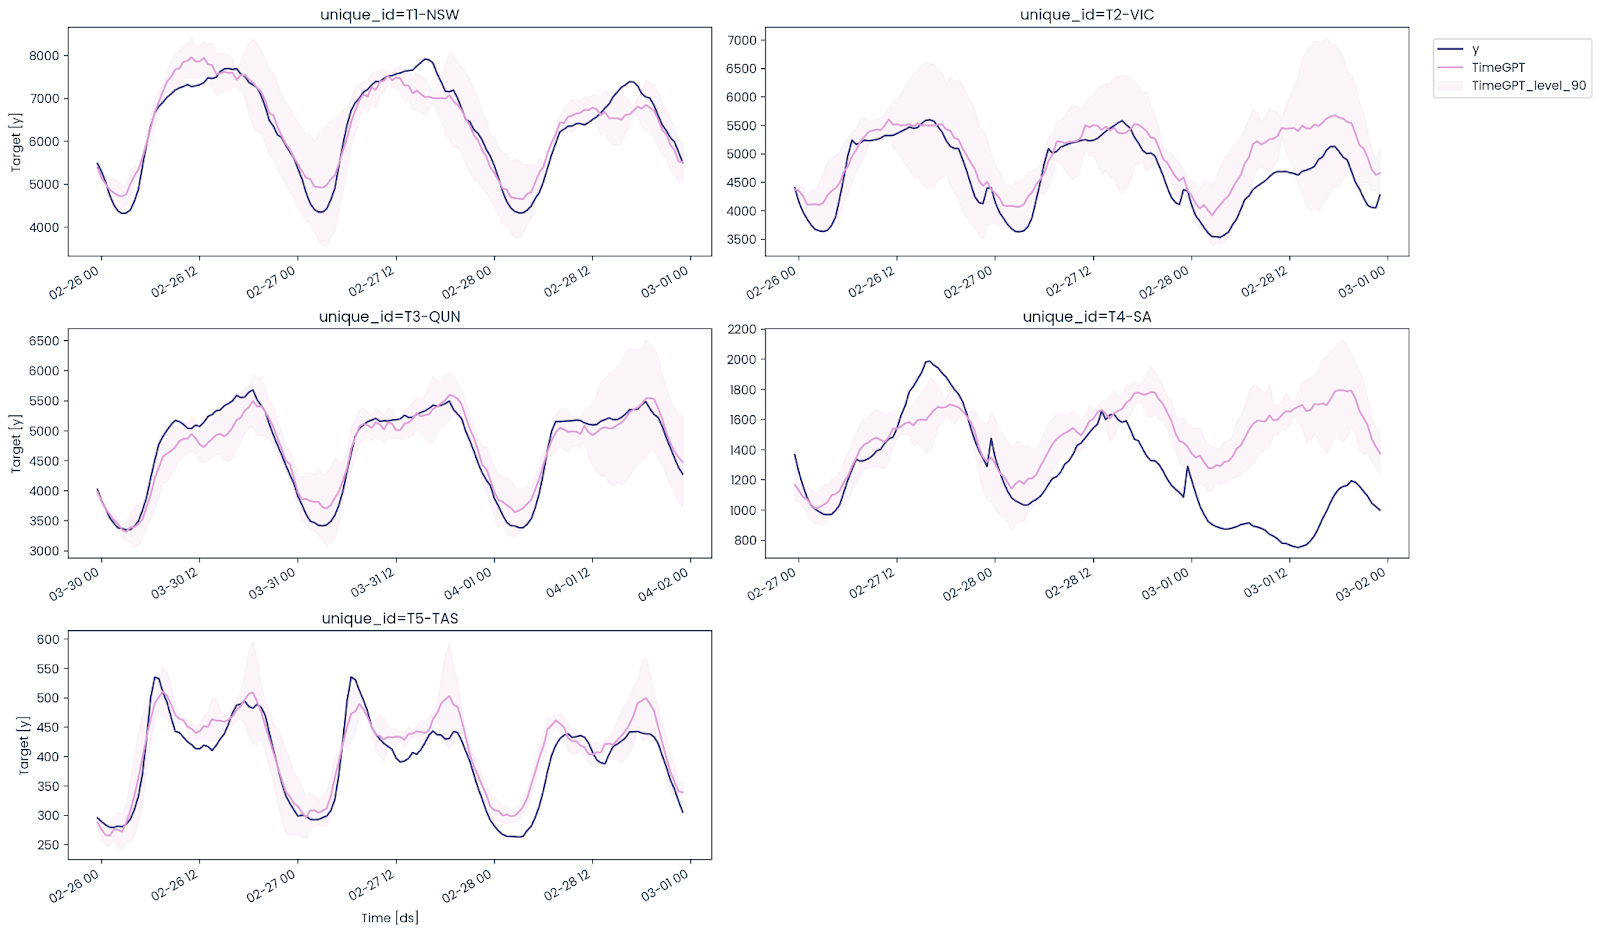
Plote os gráficos de séries temporais com valores reais, previstos e intervalo de 90% de confiança para os 5 IDs.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Como podemos ver, o TimeGPT foi bem até em múltiplas séries, com exceção da Austrália do Sul, onde ele não capturou a tendência de queda na demanda.
Precisamos unir os dataframes de teste e previsão para avaliar o modelo com as métricas MAE, RMSE e SMAPE.
predict_df['ds'] = pd.to_datetime(predict_df['ds'])
test_df = pd.merge(test_df, predict_df, 'left', ['ds','unique_id'])
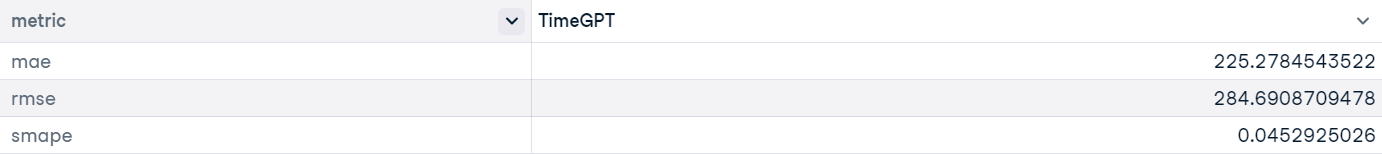
Use a função evaluate para gerar o relatório de desempenho como um dataframe do pandas. Ele traz as métricas por ID. Para o desempenho geral, calcule a média e exiba o resultado final.
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "unique_id"
)

average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
O desempenho geral melhora quando fazemos fine-tuning em múltiplas séries, e não apenas em uma.
O cliente Nixtla também permite realizar validação cruzada para avaliar o desempenho em diferentes janelas do dataset.
Vamos usar a função .cross_validation com o subconjunto de New South Wales. A validação cruzada terá 5 janelas, cada uma com duração de 7 horas.
timegpt_cv_df = nixtla_client.cross_validation(
    T1_df,
    h=7,
    n_windows=5,
    time_col='ds',
    target_col='y',
    freq='H',
)
timegpt_cv_df.head()
Como vemos, obtivemos valores de previsão com base em cinco janelas de 7 horas.
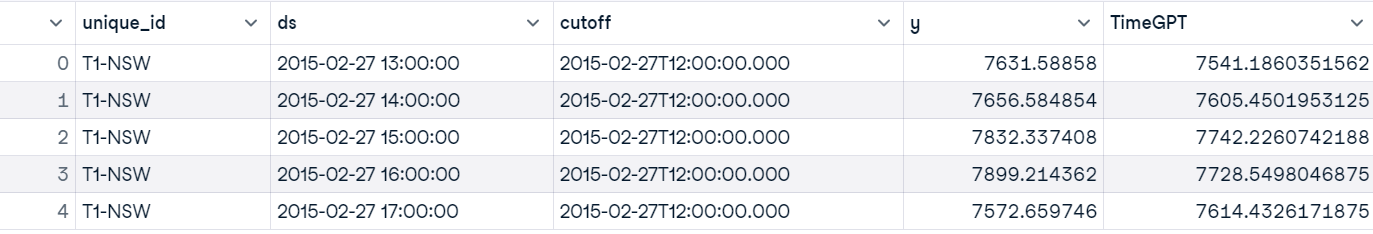
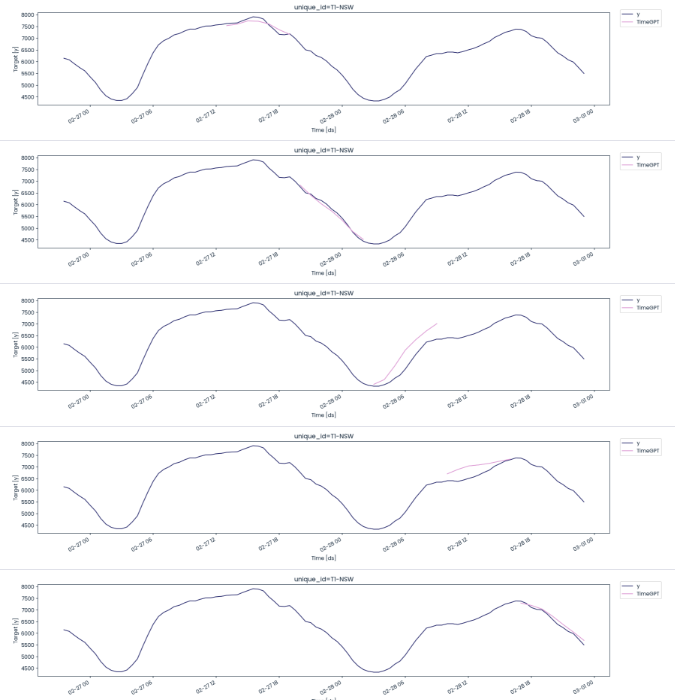
Vamos usar uma data e hora de corte para criar 5 janelas, cada uma mostrando valores previstos e reais.
cutoffs = timegpt_cv_df['cutoff'].unique()
for cutoff in cutoffs:
    fig = nixtla_client.plot(
        T1_df.tail(100),
        timegpt_cv_df.query('cutoff == @cutoff').drop(columns=['cutoff', 'y']),
        time_col='ds',
        target_col='y'
    )
    display(fig)
Com exceção do 3º e 4º blocos, o modelo foi muito bem.
Agora vamos comparar o desempenho do TimeGPT com o Light Gradient-Boosting Machine (LGBM) para ver qual se destaca no mesmo dataset. Já fizemos a validação cruzada no dataframe de New South Wales; o próximo passo é usar a função evaluate para gerar o relatório.
evaluation = evaluate(
    timegpt_cv_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "cutoff"
)
evaluation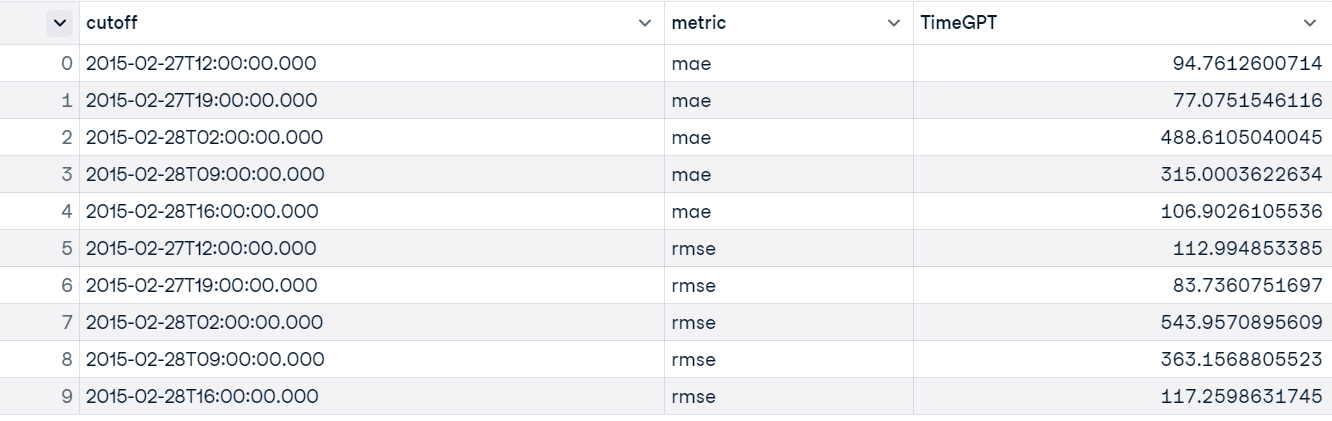
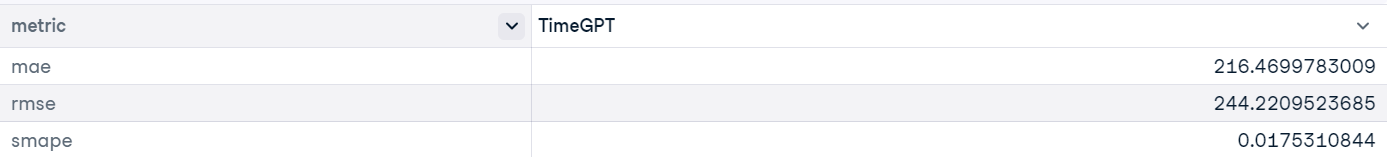
Precisamos calcular a média de MAE, RMSE e SMAPE nas 5 janelas para obter o resultado geral do modelo.
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Os resultados são muito bons, mesmo com um conjunto pequeno de valores.
Para avaliar o LGBM, siga estes passos:
Observação: Para usar modelos estatísticos e de machine learning em previsão de séries temporais, é essencial dominar técnicas básicas de feature engineering e algoritmos. Para um guia completo, confira este tutorial: Time Series Forecasting Tutorial no DataCamp.
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import TimeSeriesSplit
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Function to calculate SMAPE
def smape(y_true, y_pred):
    return np.mean(2 * np.abs(y_pred - y_true) / (np.abs(y_true) + np.abs(y_pred)))

# Assuming 'ds' is the date/time column and 'y' is the target variable
T1_df['ds'] = pd.to_datetime(T1_df['ds'])

# Filter the DataFrame to include only the specified datetime range
start_date = '2015-02-27T13:00:00'
end_date = '2015-02-28T23:00:00'
T1_df = T1_df[(T1_df['ds'] >= start_date) & (T1_df['ds'] <= end_date)]

# Convert 'ds' to a numerical value (e.g., timestamp)
T1_df['ds_num'] = T1_df['ds'].apply(lambda x: x.timestamp())

# Create lag and window features
for lag in range(1, 4):
    T1_df[f'lag_{lag}'] = T1_df['y'].shift(lag)

T1_df['rolling_mean'] = T1_df['y'].rolling(window=3).mean()
T1_df['rolling_std'] = T1_df['y'].rolling(window=3).std()

# Drop NaN values resulting from lag and rolling operations
T1_df.dropna(inplace=True)

# Select features for the model
X = T1_df[['ds_num', 'lag_1', 'lag_2', 'lag_3', 'rolling_mean', 'rolling_std']]
y = T1_df['y']

# Time series split
tscv = TimeSeriesSplit(n_splits=5)
mae_scores = []
rmse_scores = []
smape_scores = []

for train_index, test_index in tscv.split(X):
    X_train, X_test = X.iloc[train_index], X.iloc[test_index]
    y_train, y_test = y.iloc[train_index], y.iloc[test_index]

    # Initialize and train the LGBM model
    model = lgb.LGBMRegressor(force_row_wise=True, verbosity=-1)
    model.fit(X_train, y_train)

    # Make predictions
    y_pred = model.predict(X_test)

    # Evaluate the model
    mae = mean_absolute_error(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))
    smape_value = smape(y_test, y_pred)

    mae_scores.append(mae)
    rmse_scores.append(rmse)
    smape_scores.append(smape_value)

# Convert the metrics into a DataFrame
mae_avg = np.mean(mae_scores)
rmse_avg = np.mean(rmse_scores)
smape_avg = np.mean(smape_scores)

metrics_df = pd.DataFrame({
    'metric': ['MAE', 'RMSE', 'SMAPE'],
    'LGBM': [mae_avg, rmse_avg, smape_avg]
})

# Display the DataFrame
metrics_df
O TimeGPT é quase 5 vezes melhor que o LGBM.
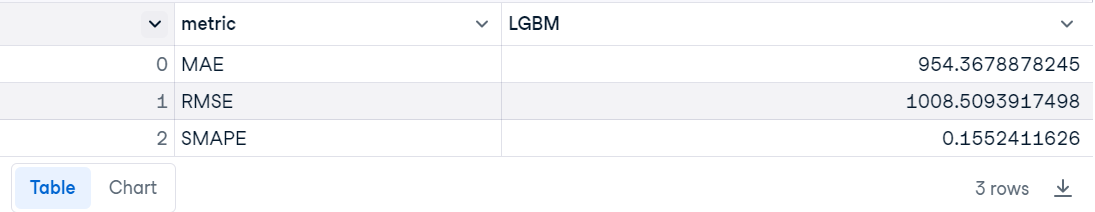
Se você teve problemas para executar o código acima ou configurar o TimeGPT, confira o workspace do DataLab: Time Series Forecasting with TimeGPT.
O ecossistema TimeGPT e Nixtla é ideal para empresas em início de jornada, pois elimina a necessidade de contratar engenheiros de ML para treinar modelos e engenheiros de MLOps para implantar e manter soluções. Se você é uma startup, pode reduzir custos significativamente e ainda acessar modelos de alta performance.
Assim como o GPT-3, o TimeGPT marca o início de modelos de ponta para séries temporais e, conforme evoluem, muitas empresas devem adotar a API da Nixtla pela facilidade de integração e ganho de desempenho.
Neste tutorial, exploramos o TimeGPT, o primeiro modelo fundamental para séries temporais. Também vimos como usar a API em Python para tarefas como previsão, visualização de séries temporais, avaliação de modelos, validação cruzada e detecção de anomalias.
Aprenda a prever o futuro com modelos da família ARIMA e a gerar previsões e insights com modelos de machine learning na trilha de habilidades Time Series with Python. Se preferir R, considere a trilha Time Series with R para entender a fundo a previsão de séries temporais.
Principais cursos do DataCamp
Programa
Programa
Programa
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
blog
Nisha Arya Ahmed
10 min
Tutorial
Moez Ali
11 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Josep Ferrer
11 min