
Last chance! 50% off DataCamp Premium
Sale ends in
Een machinelearningmodel voor tijdreeksen trainen is niet eenvoudig; het verschilt behoorlijk van traditionele classificatie- of regressieproblemen. Je moet vensters en lags maken om nieuwe features te genereren uit bestaande data, en zelfs dan kan je model ondermaats presteren. Niet alleen lineaire regressiemodellen hebben het moeilijk, ook deep-learningmodellen zoals LSTM en GRU kunnen het slecht doen bij het voorspellen van de aandelenmarkt.
Hebben we een GPT-4o-achtig model nodig voor tijdreeksen dat goed werkt op alle soorten datasets? Absoluut. TimeGPT is een state-of-the-art foundation model dat zelfs op onzichtbare datasets kan voorspellen.
In deze tutorial verkennen we de architectuur van TimeGPT, hoe het is getraind en de benchmarks. Daarnaast leer je hoe je de Nixtla API gebruikt om toegang te krijgen tot het TimeGPT-model voor forecasting, anomaliedetectie, visualisaties van tijdreeksen en model-evaluaties.
Afbeelding door auteur | Canva
TimeGPT-1 is een op Transformer gebaseerd tijdreeksmodel met self-attention-mechanismen waar je via de Nixtla API toegang toe hebt. Het is het eerste foundation model voor tijdreeksdatasets dat behoorlijk nauwkeurig is op onzichtbare data. Alles wat je hoeft te doen, is het fine-tunen op je dataset, en binnen enkele seconden levert het state-of-the-art prestaties.
De TimeGPT-architectuur bestaat uit een encoder-decoder-structuur met meerdere lagen, elk voorzien van residual connections en layer normalization. De outputlaag is lineair en projecteert de decoderoutput naar de dimensie van het forecastvenster.
Het model is getraind op de grootste verzameling publiek beschikbare tijdreeksdata, wat betekent dat het onzichtbare datasets kan voorspellen zonder hertraining. Om een voorspelling te produceren, neemt TimeGPT een venster met eerdere waarden en voegt een lokale positionele encoder toe om de input te verrijken.
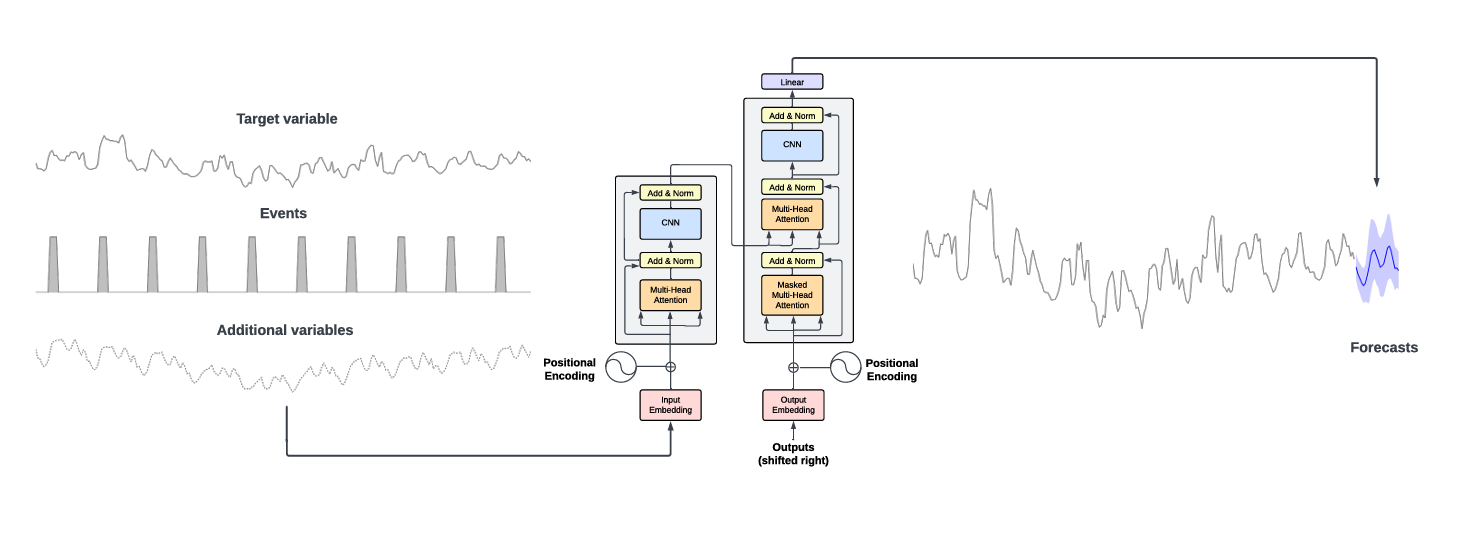
Bron: 2310.03589 (arxiv.org) | TimeGPT gebruikt de historische waarden van de doelvariabele en aanvullende exogene variabelen als input om voorspellingen te maken.
Het TimeGPT-model presteert beter dan gevestigde statistische, machinelearning- en deep-learningmethoden, met superieure zero-shot-inferentieprestaties, efficiëntie en eenvoud. Zoals getoond in de benchmark hieronder, blinkt TimeGPT uit over verschillende machinelearningmetrics, zelfs zonder enige feature engineering.
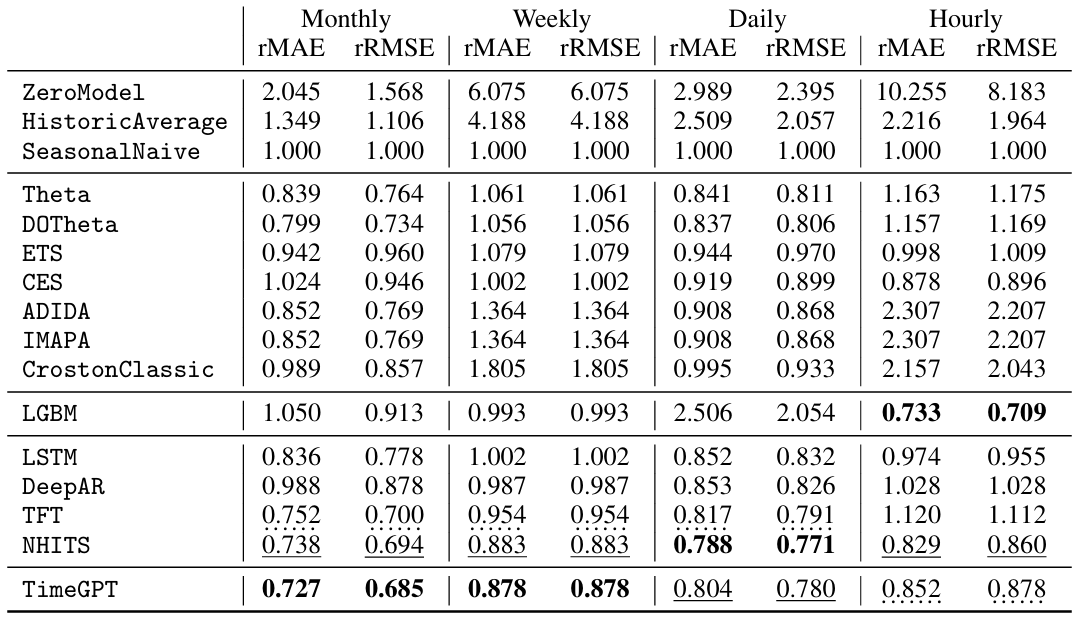
Bron: 2310.03589 (arxiv.org) | Benchmarkmodellen gemeten met rMAE en rRMSE, lagere scores zijn beter.
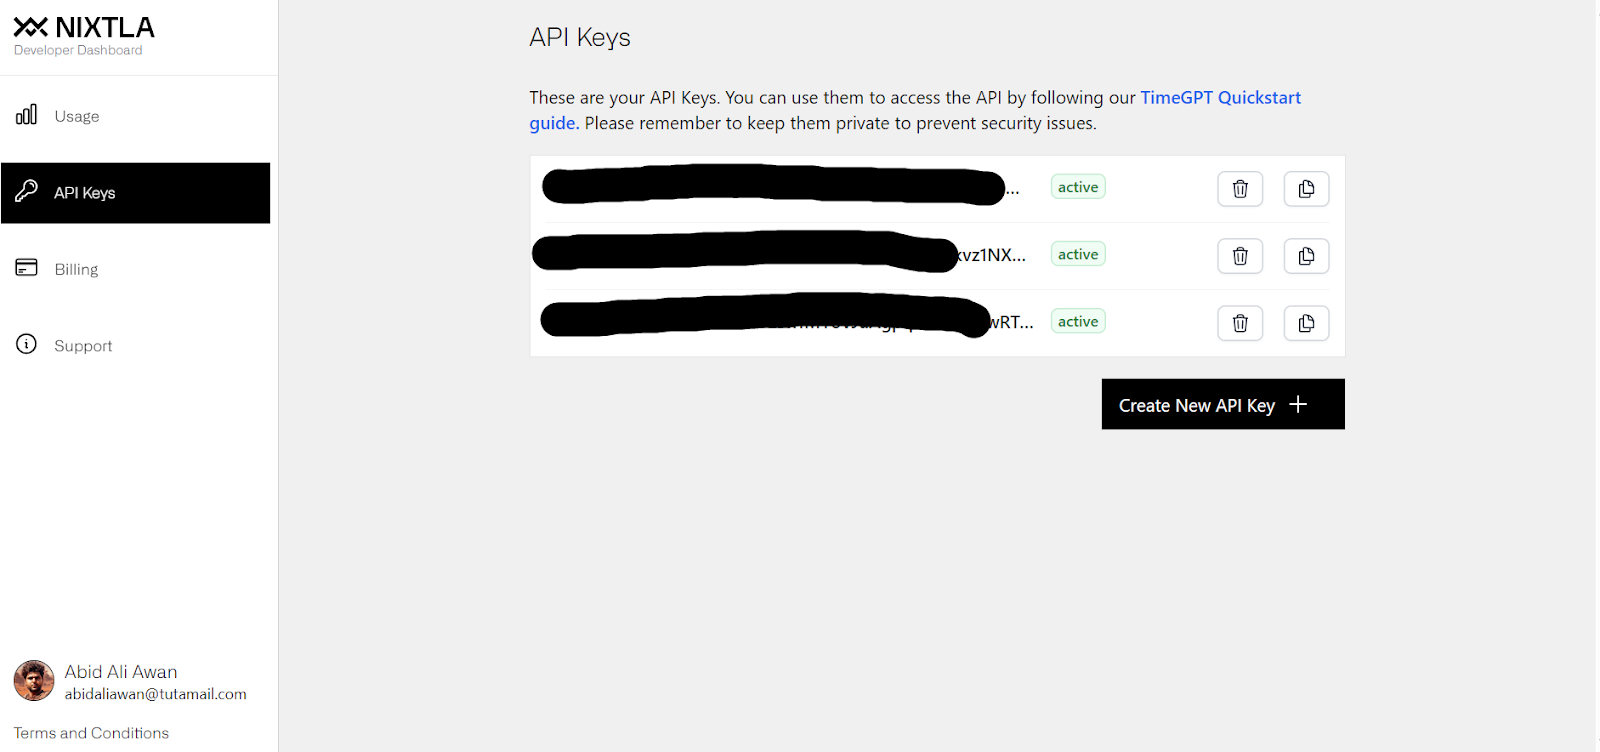
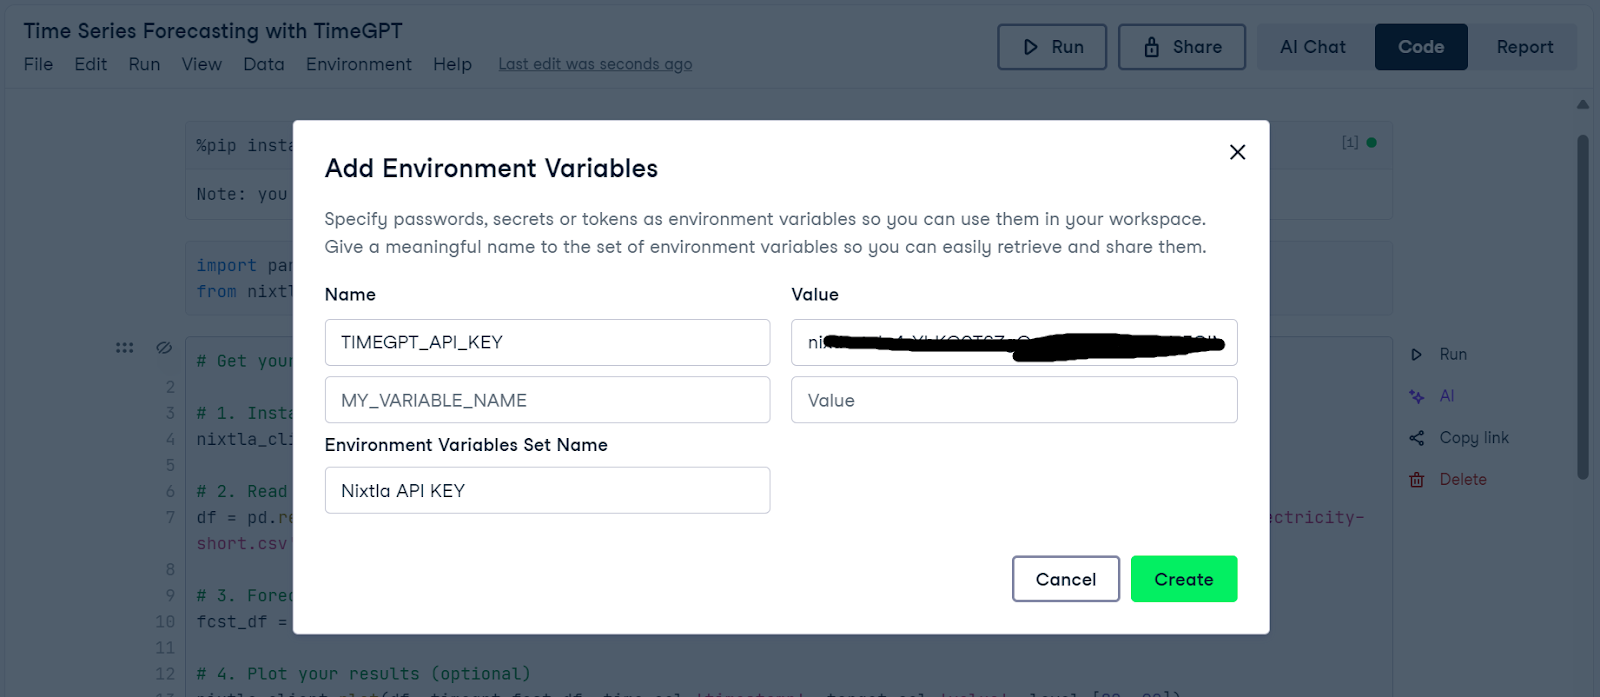
Het TimeGPT-model is niet open source en je kunt er alleen via de Nixtla API toegang toe krijgen. In deze sectie begeleiden we je bij het instellen van de Nixtla API om toegang te krijgen tot het TimeGPT-model en om Amazon-aandelen te voorspellen.
%%capture
%pip install nixtla>=0.5.1
%pip install yfinanceimport pandas as pd
import yfinance as yf
from nixtla import NixtlaClient
import os
timegpt_api_key = os.environ["TIMEGPT_API_KEY"]
# Setup NixtlaClient
nixtla_client = NixtlaClient(api_key = timegpt_api_key)
# Downloading Amazon stock price data
ticker = 'AMZN'
amazon_stock_data = yf.download(ticker)
amazon_stock_data = amazon_stock_data.reset_index()
# Displaying the dataset
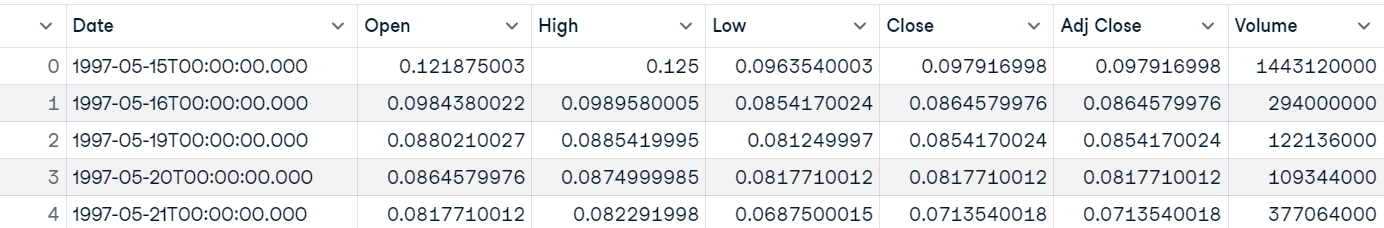
amazon_stock_data.head()We hebben Amazon-aandelenkoersdata vanaf 1997 tot nu.
nixtla_client.plot(amazon_stock_data, time_col='Date', target_col='Close')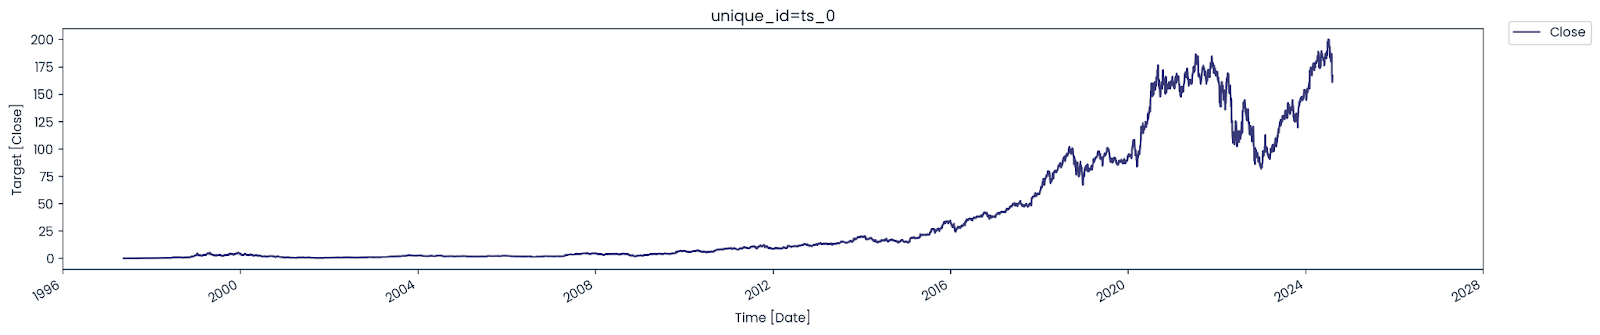
Ontdek hoe je lijngrafieken voor tijdreeksen maakt met Matplotlib in deze tutorial Matplotlib Time Series Line Plot.
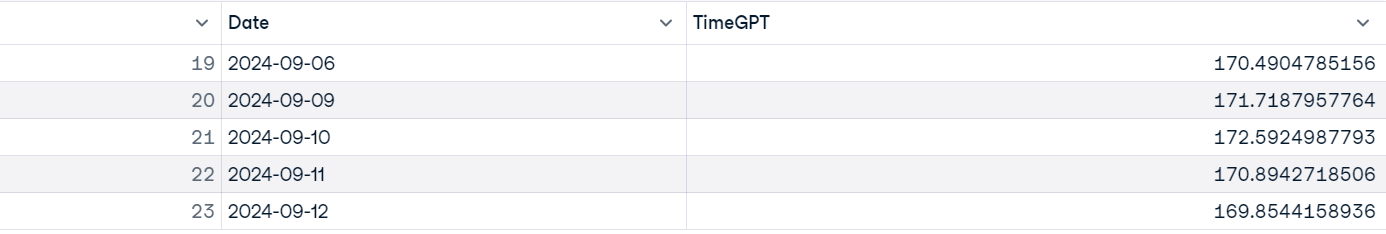
.forecast voorzien van de aandelendata, modelnaam, een voorspellingshorizon (gelijk aan 24 dagen), frequentie, tijdkolommen en doeldkolommen. Omdat de beurs in het weekend gesloten is, kiezen we de frequentie "business day(B)".model = nixtla_client.forecast(
df=amazon_stock_data,
model="timegpt-1",
h=24,
freq="B",
time_col="Date",
target_col="Close",
)
model.tail()
nixtla_client.plot(
    amazon_stock_data,
    model,
    time_col="Date",
    target_col="Close",
    max_insample_length=60,
)
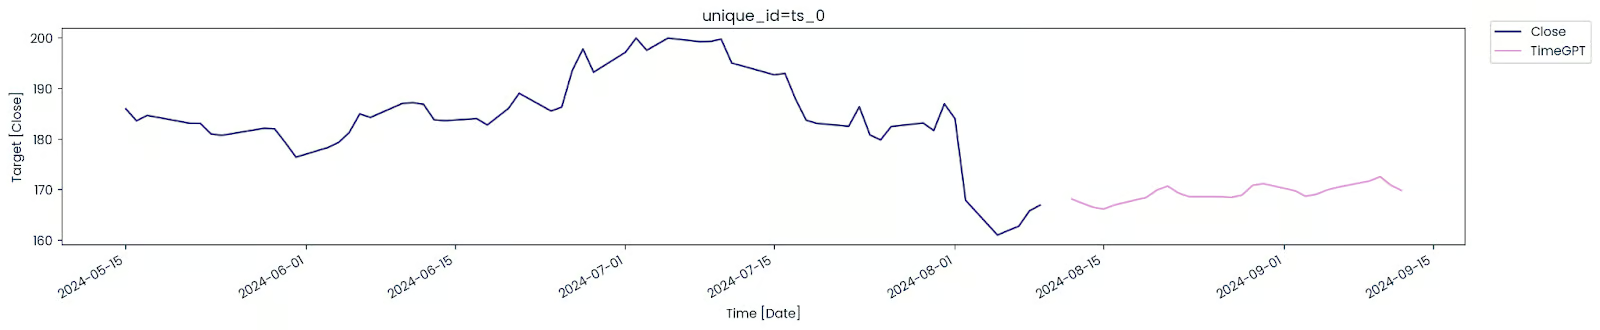
Zoals we zien, heeft het TimeGPT-model binnen enkele seconden de slotkoersen van Amazon nauwkeurig de toekomst in voorspeld.
Dit was een voorbeeld voor beginners. In de volgende sessie werken we met complexere datasets en verkennen we verschillende features van de Nixtla API.
In deze sectie gebruiken we een complexere dataset van Australische elektriciteitsvraag en gebruiken we het TimeGPT-model om meerdere waarden tegelijk te voorspellen.
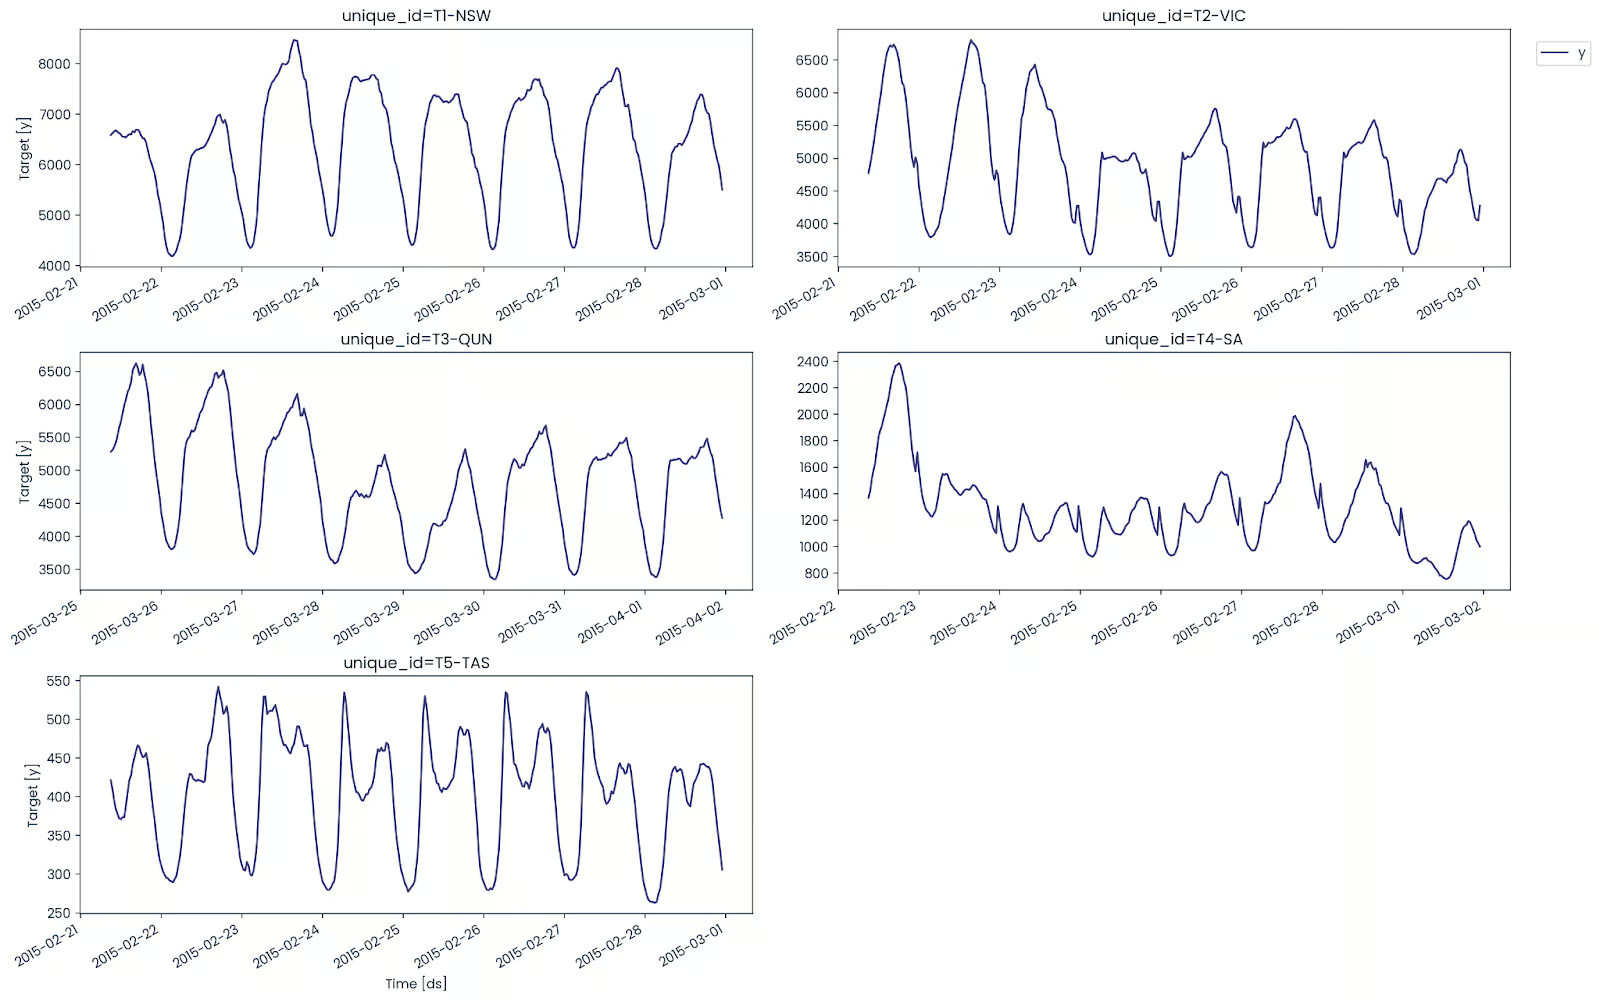
De dataset omvat 5 tijdreeksen die de halfuurlijkse elektriciteitsvraag van 5 deelstaten in Australië vertegenwoordigen: Victoria, New South Wales, Queensland, Tasmanië en Zuid-Australië.
We leren ook hoe we het model kunnen fine-tunen en verschillende modelhyperparameters kunnen gebruiken om de prestaties te verbeteren. Tot slot voeren we cross-validatie uit en vergelijken we de prestaties van het model met traditionele modellen voor een grondige beoordeling.
Er is geen eenvoudige manier om het .tsf-bestand in de pandas-bibliotheek te laden. We moeten een eigen functie maken om de data te laden en te verwerken en deze vervolgens om te zetten naar een Pandas-dataframe.
import pandas as pd


def read_tsf_from_file(file_path):
    data = []
    start_date = pd.to_datetime("2002-01-01 00:00:00")

    # Open and read the file from the directory

    with open(file_path, "r") as file:
        for line in file:
            if line.startswith("T"):
                parts = line.strip().split(":")
                unique_id = parts[0] + "-" + parts[1]
                values = list(map(float, parts[3].split(",")[:-1]))

                # Generate datetime index at half-hour intervals

                periods = len(values)
                date_range = pd.date_range(
                    start=start_date, periods=periods, freq="30min"
                )

                # Append to data list

                for dt, value in zip(date_range, values):
                    data.append([unique_id, dt, value])
    # Convert the list of data into a DataFrame

    return pd.DataFrame(data, columns=["unique_id", "ds", "y"])


# Example usage

file_path = "australian_electricity_demand_dataset.tsf"
demand_df = read_tsf_from_file(file_path)

# Display the dataframe

demand_df.head()
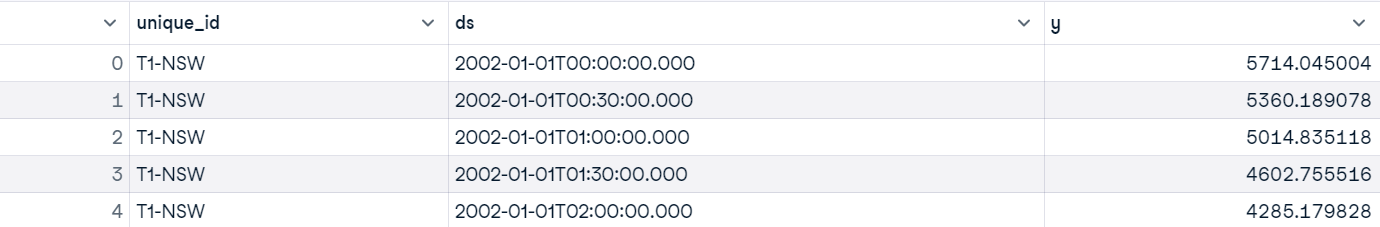
Onze dataset heeft drie kolommen:
De plotfunctie is uitstekend, omdat deze automatisch de kolom unique_id herkent en vijf verschillende visualisaties van tijdreeksen maakt.
nixtla_client.plot(
    demand_df,
    max_insample_length=365,
)
De visualisatie hieronder toont het stroomverbruik van 5 deelstaten, en ze hebben allemaal verschillende patronen.
Leer tijdreeksanalyse door mee te doen aan de live code-along-sessie op DataCamp, waar je je verdiept in financiële tijdreeksdata met Python.
In deze sessie verkennen we verschillende aandelen, visualiseren we hun prestaties en maken we voorspellingen met verschillende modellen.
Voordat we gaan voorspellen, identificeren we verschillende anomalieën in de dataset om het probleem beter te begrijpen.
De functie .detect_anomalies neemt de dataset, tijd- en doelkolommen en de frequentie.
# Detect anomalies
anomalies_df = nixtla_client.detect_anomalies(
    demand_df,
    time_col='ds',
    target_col='y',
    freq='H',
)
anomalies_df[anomalies_df["anomaly"]==1].head()
We hebben alle instanties weergegeven waarin anomalieën zijn gedetecteerd.
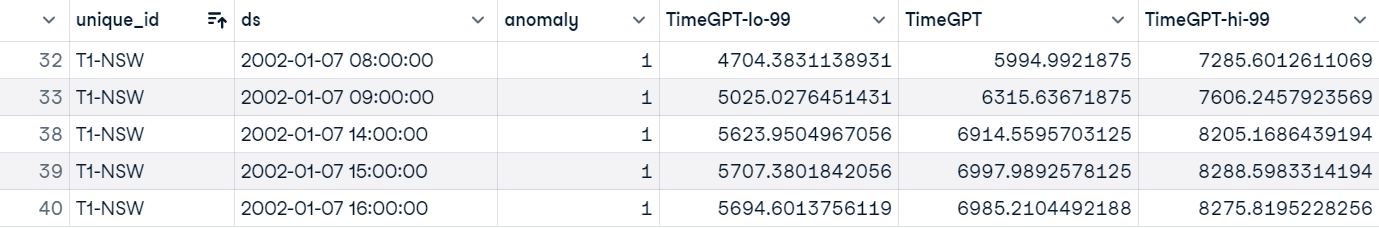
Het totale aantal anomalieën in alle 5 tijdreeksdatasets is 17.316, dat is erg veel.
anomalies_df.anomaly.value_counts()
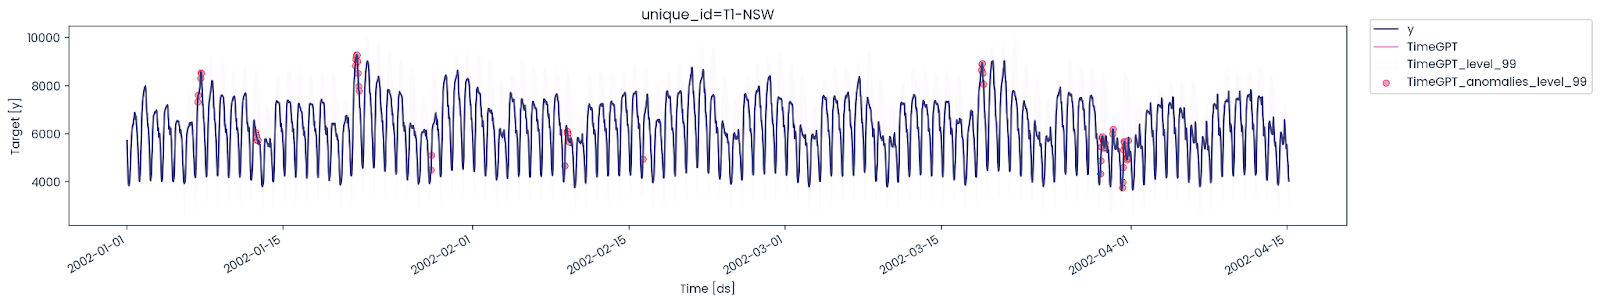
Nu plotten we de anomalieën op de werkelijke dataset om te zien waar en hoe vaak ze van dag tot dag voorkomen. Om de visualisatie te vereenvoudigen, tonen we slechts 5.000 samples uit New South Wales.
# Plot anomalies
nixtla_client.plot(
    demand_df[demand_df["unique_id"]=="T1-NSW"][0:5000],
    anomalies_df[anomalies_df["unique_id"]=="T1-NSW"][0:5000],
    time_col='ds',
    target_col='y',

)
Anomalieën op dagelijkse basis zijn niet gebruikelijk, maar er zijn dagen waarop meerdere anomalieën op één dag voorkomen.
We voorspellen nu de elektriciteitsvraag van New South Wales. Daarvoor filteren we alleen de waarden voor "T1-NSW".
T1_df = demand_df[demand_df["unique_id"]=="T1-NSW"]
T1_df.head()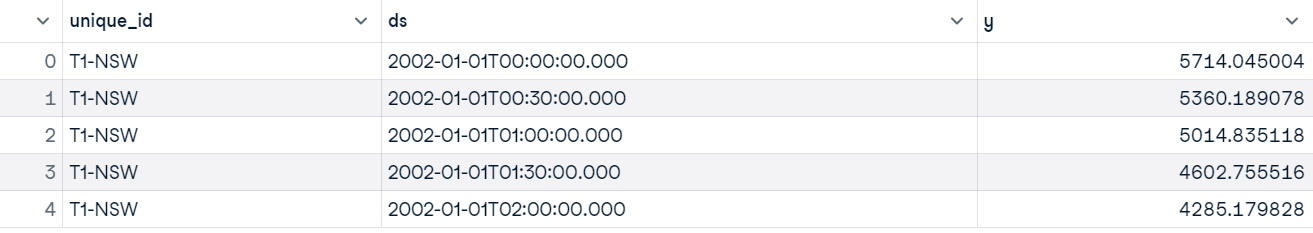
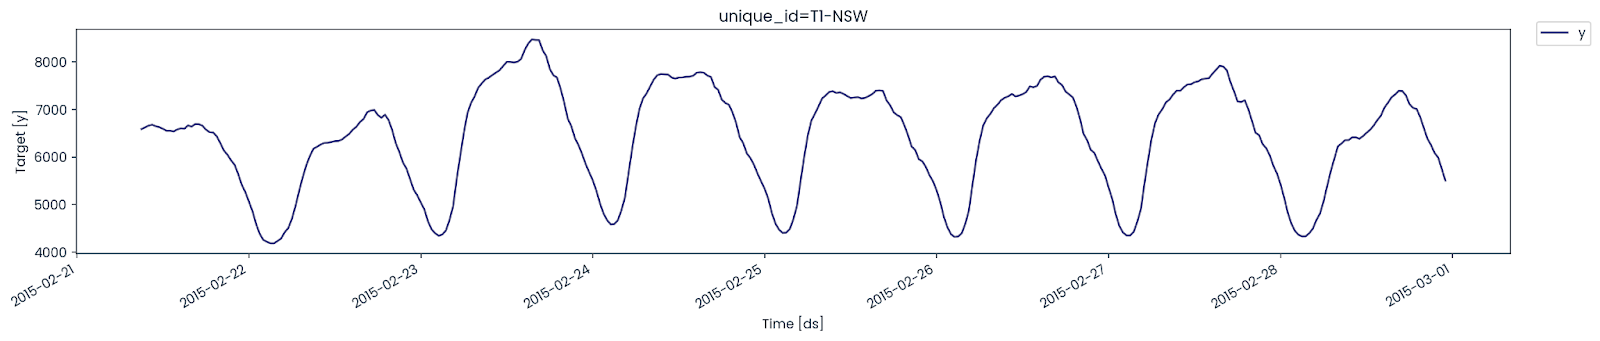
Plot de laatste 365 waarden om het patroon van het stroomverbruik te begrijpen.
nixtla_client.plot(
    T1_df,
    max_insample_length=365,
)
We evalueren nu de prestaties van ons model. Daarvoor moeten we onze dataset splitsen in een train- en testset.
De trainingset bestaat uit 144 waarden, wat neerkomt op 3 dagen, en de testset uit 1200 waarden, wat neerkomt op 25 dagen.
test_df = T1_df.tail(144) # 3 days = (144 * 0.5h *  1 day/24h)
train_df = T1_df.iloc[-1344:-144] # 25 days = (1200 *0.5h * 1 day/24h)
Voor de voorspelling kiezen we een beter model en stellen we verschillende argumenten in om de modelprestaties te verbeteren, specifiek:
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],  # Generate a 90% confidence interval
    finetune_steps=60,  # Specify the number of steps for fine-tuning
    finetune_loss="mae",  # Use the MAE as the loss function for fine-tuning
    model="timegpt-1-long-horizon",  # Use the model for long-horizon forecasting
    time_col="ds",
    target_col="y",
)
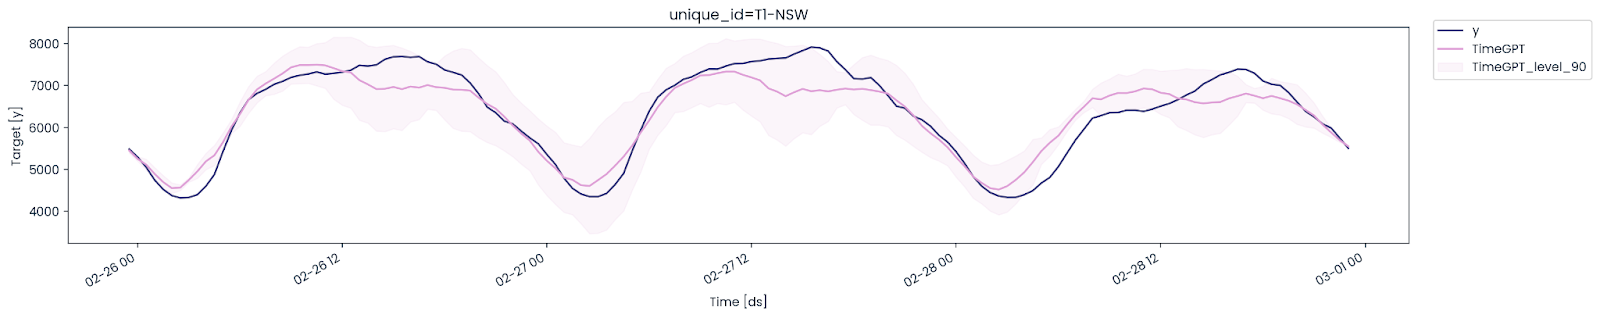
Plot de werkelijke waarden, de voorspelling en het 90 procent betrouwbaarheidsinterval om de prestaties van het model te beoordelen.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Binnen enkele seconden kregen we een behoorlijk nauwkeurig resultaat. Dat is de kracht van voorgetrainde modellen.
We evalueren nu de modelprestaties met de bibliotheek UtilsForecast, onderdeel van het open-sourceproject van Nixtla. Hiervoor voegen we de test- en forecastdatasets samen en geven ze vervolgens door aan de functie evaluate. De functie neemt de dataset, metrics, modellen, doelkolommen en een unieke ID om de modelmetrics te berekenen en deze weer te geven als een pandas-dataframe.
from utilsforecast.losses import mae, rmse, smape
from utilsforecast.evaluation import evaluate

predict_df["ds"] = pd.to_datetime(predict_df["ds"])
test_df = pd.merge(test_df, predict_df, "left", ["ds", "unique_id"])
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col="unique_id",
)

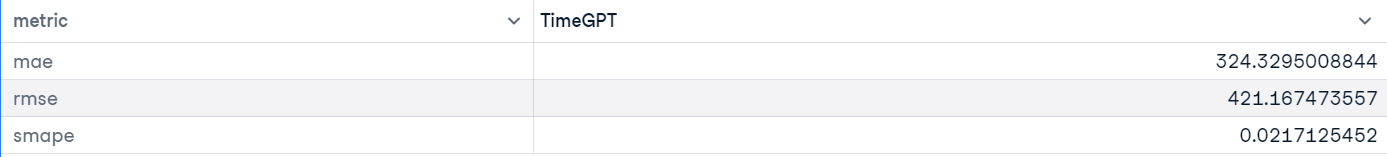
average_metrics = evaluation.groupby("metric")["TimeGPT"].mean()
average_metrics
We kregen behoorlijk goede resultaten.
De Nixtla API laat je ook meerdere reeksen tegelijk voorspellen. We gebruiken de volledige dataset in plaats van te filteren op een unieke ID.
Om de dataset te splitsen in train- en testsets, gebruiken we de functie groupby om voor elke unieke ID 144 waarden te splitsen. Anders zouden we slechts 144 waarden hebben voor een willekeurig gekozen unieke ID.
values for some randomly chosen unique ID.
test_df = demand_df.groupby("unique_id").tail(144)  # 3 days
train_df = (
    demand_df.groupby("unique_id")
    .apply(lambda group: group.iloc[-1344:-144])
    .reset_index(drop=True)
)  # 25 days
De functie forecast is hetzelfde als in het vorige deel, behalve dat we dit keer ook de ID-kolommen meenemen.
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],
    finetune_steps=60,
    finetune_loss='mae',
    model='timegpt-1-long-horizon',
    time_col='ds',
    target_col='y',
    id_col='unique_id'
)
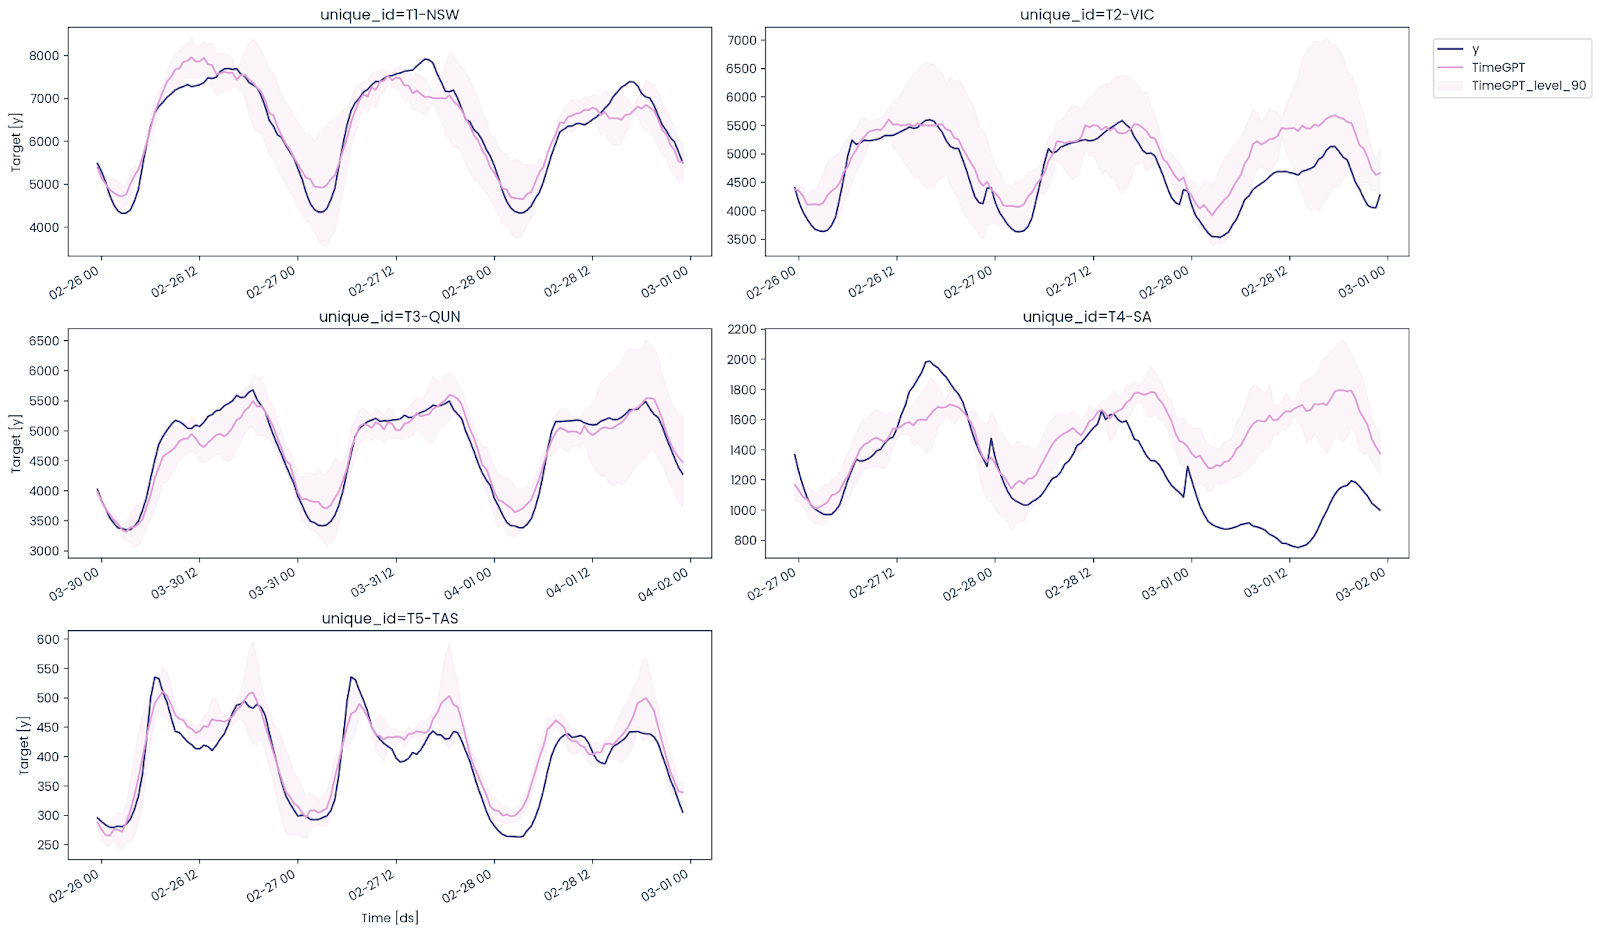
Plot tijdreeksdiagram van werkelijke, voorspelde en 90%-betrouwbaarheidswaarden van alle 5 Unique ID's.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Zoals we zien, heeft het TimeGPT-model het goed gedaan, zelfs op meerdere tijdreeksen, behalve voor Zuid-Australië. Het kon de neerwaartse trend in de elektriciteitsvraag niet voorspellen.
We moeten de test- en forecastdataframes samenvoegen om het model te evalueren met MAE-, RMSE- en SMAPE-metrics.
predict_df['ds'] = pd.to_datetime(predict_df['ds'])
test_df = pd.merge(test_df, predict_df, 'left', ['ds','unique_id'])
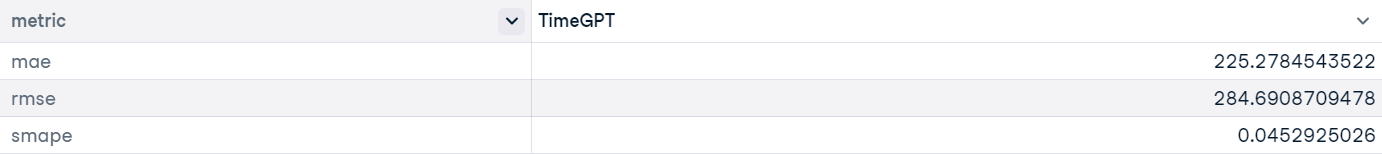
Gebruik de functie evaluate om een prestatieoverzicht van het model te genereren als pandas-dataframe. Het bevat modelmetrics voor elke unieke ID. Om de algehele prestatie van het model te berekenen, moeten we de waarden middelen en het eindresultaat tonen.
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "unique_id"
)

average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
De algehele modelprestatie verbetert wanneer je fine-tunet op meerdere tijdreeksen in plaats van één.
De Nixtla-client laat je ook cross-validatie uitvoeren om de modelprestaties op verschillende vensters van de dataset te evalueren.
We gebruiken de functie .cross_validation en geven de gefilterde dataset mee die alleen waarden voor New South Wales bevat. De cross-validatie heeft 5 vensters, elk met een lengte van 7 uur.
timegpt_cv_df = nixtla_client.cross_validation(
    T1_df,
    h=7,
    n_windows=5,
    time_col='ds',
    target_col='y',
    freq='H',
)
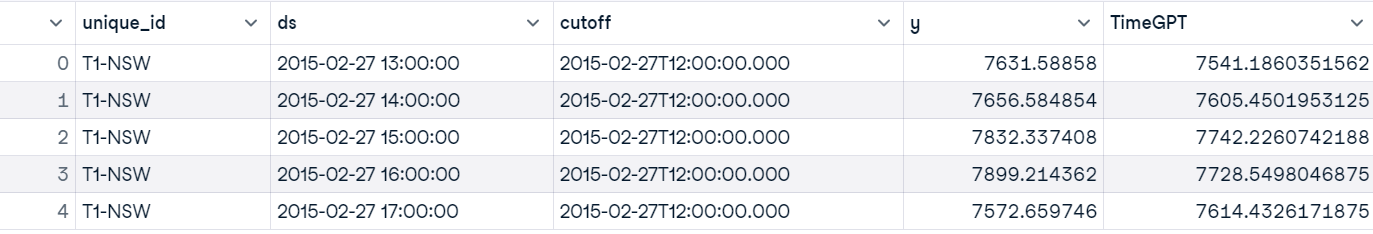
timegpt_cv_df.head()
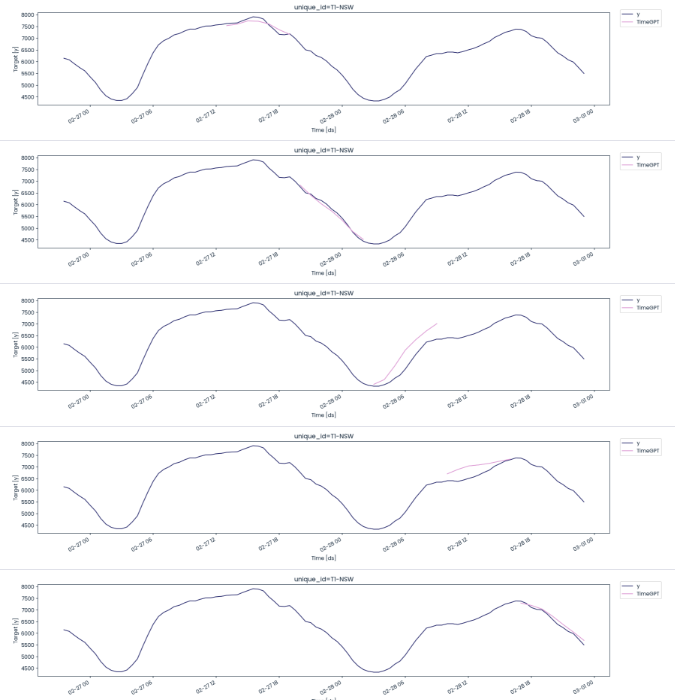
Zoals we zien, hebben we voorspelde waarden gekregen op basis van de vijf vensters van 7 uur.
We gebruiken een cutoff-datum en -tijd om 5 vensters te maken, die elk voorspelde en werkelijke waarden tonen.
cutoffs = timegpt_cv_df['cutoff'].unique()
for cutoff in cutoffs:
    fig = nixtla_client.plot(
        T1_df.tail(100),
        timegpt_cv_df.query('cutoff == @cutoff').drop(columns=['cutoff', 'y']),
        time_col='ds',
        target_col='y'
    )
    display(fig)
Afgezien van de 3e en 4e split presteerde het model behoorlijk goed.
Laten we nu de prestaties van de modellen TimeGPT en Light Gradient-Boosting Machine (LGBM) vergelijken om duidelijk te bepalen welke uitblinkt op dezelfde dataset. We hebben al cross-validatie uitgevoerd op het New South Wales-dataframe; de volgende stap is de functie evaluate gebruiken om het evaluatierapport te genereren.
evaluation = evaluate(
    timegpt_cv_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "cutoff"
)
evaluation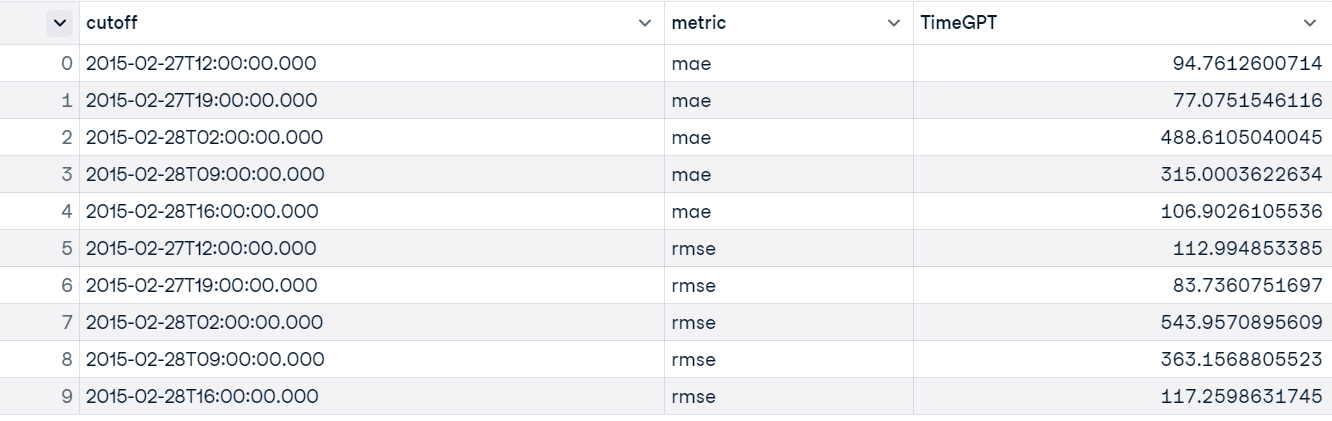
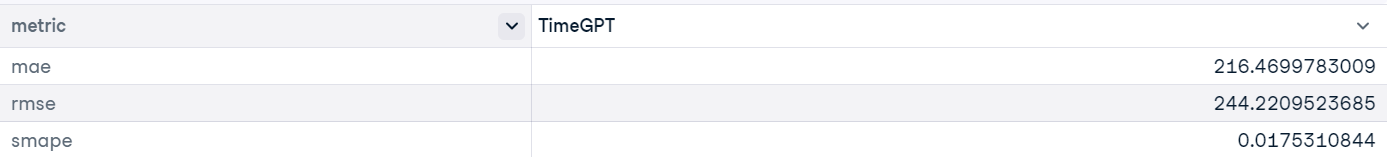
We moeten het gemiddelde van MAE, RMSE en SMAPE berekenen voor alle 5 vensters om het totale resultaat van het model te verkrijgen.
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
De resultaten zijn behoorlijk goed, zelfs op een kleine set waarden.
Opmerking: Om statistische en machinelearningmodellen voor tijdreeksvoorspelling te gebruiken, is het essentieel om de basis van feature engineering-technieken en algoritmen te leren. Voor een uitgebreide gids over deze onderwerpen, bekijk deze tutorial: Time Series Forecasting Tutorial op DataCamp.
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import TimeSeriesSplit
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Function to calculate SMAPE
def smape(y_true, y_pred):
    return np.mean(2 * np.abs(y_pred - y_true) / (np.abs(y_true) + np.abs(y_pred)))

# Assuming 'ds' is the date/time column and 'y' is the target variable
T1_df['ds'] = pd.to_datetime(T1_df['ds'])

# Filter the DataFrame to include only the specified datetime range
start_date = '2015-02-27T13:00:00'
end_date = '2015-02-28T23:00:00'
T1_df = T1_df[(T1_df['ds'] >= start_date) & (T1_df['ds'] <= end_date)]

# Convert 'ds' to a numerical value (e.g., timestamp)
T1_df['ds_num'] = T1_df['ds'].apply(lambda x: x.timestamp())

# Create lag and window features
for lag in range(1, 4):
    T1_df[f'lag_{lag}'] = T1_df['y'].shift(lag)

T1_df['rolling_mean'] = T1_df['y'].rolling(window=3).mean()
T1_df['rolling_std'] = T1_df['y'].rolling(window=3).std()

# Drop NaN values resulting from lag and rolling operations
T1_df.dropna(inplace=True)

# Select features for the model
X = T1_df[['ds_num', 'lag_1', 'lag_2', 'lag_3', 'rolling_mean', 'rolling_std']]
y = T1_df['y']

# Time series split
tscv = TimeSeriesSplit(n_splits=5)
mae_scores = []
rmse_scores = []
smape_scores = []

for train_index, test_index in tscv.split(X):
    X_train, X_test = X.iloc[train_index], X.iloc[test_index]
    y_train, y_test = y.iloc[train_index], y.iloc[test_index]

    # Initialize and train the LGBM model
    model = lgb.LGBMRegressor(force_row_wise=True, verbosity=-1)
    model.fit(X_train, y_train)

    # Make predictions
    y_pred = model.predict(X_test)

    # Evaluate the model
    mae = mean_absolute_error(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))
    smape_value = smape(y_test, y_pred)

    mae_scores.append(mae)
    rmse_scores.append(rmse)
    smape_scores.append(smape_value)

# Convert the metrics into a DataFrame
mae_avg = np.mean(mae_scores)
rmse_avg = np.mean(rmse_scores)
smape_avg = np.mean(smape_scores)

metrics_df = pd.DataFrame({
    'metric': ['MAE', 'RMSE', 'SMAPE'],
    'LGBM': [mae_avg, rmse_avg, smape_avg]
})

# Display the DataFrame
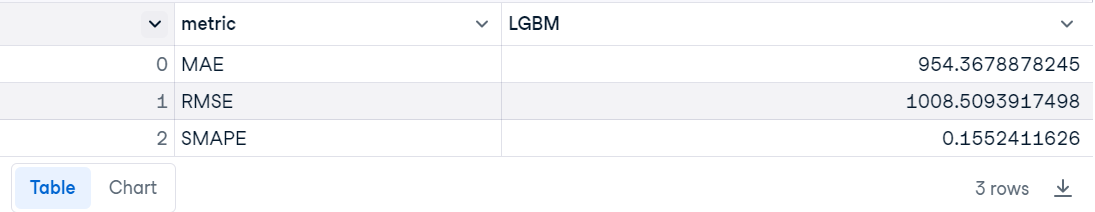
metrics_df
TimeGPT is bijna 5 keer beter dan LGBM.
Als je problemen ondervindt bij het uitvoeren van de bovenstaande code of het instellen van TimeGPT, bekijk dan de DataLab-werkruimte: Time Series Forecasting with TimeGPT.
Het TimeGPT- en Nixtla-ecosysteem is ideaal voor bedrijven die net beginnen, omdat het de noodzaak wegneemt om machinelearning-engineers in te huren om modellen te trainen en MLOps-engineers om ze te deployen en te onderhouden. Als je een startup bent, kun je aanzienlijk besparen op kosten en toch toegang krijgen tot hoog presterende modellen.
Net als GPT-3 markeert TimeGPT het begin van state-of-the-art modellen voor tijdreeksen, en naarmate deze modellen verbeteren, zullen veel bedrijven waarschijnlijk de Nixtla API gebruiken voor eenvoudige integratie en betere prestaties.
In deze tutorial hebben we TimeGPT verkend, het eerste foundation model voor tijdreeksen. Daarnaast hebben we geleerd hoe we de Python API gebruiken om toegang te krijgen tot het TimeGPT-model voor taken zoals forecasting, visualisatie van tijdreeksen, modelevaluatie, cross-validatie en anomaliedetectie.
Leer de toekomst voorspellen met ARIMA-klasse modellen en genereer voorspellingen en inzichten met machinelearningmodellen met de Time Series with Python skill track. Als je de voorkeur geeft aan R, overweeg dan de Time Series with R skill track om tijdreeksvoorspelling grondig te begrijpen.
Topcursussen op DataCamp
Leerpad
Leerpad
Leerpad
blog
Adel Nehme
15 min


