
Corso
Sviluppare sistemi di AI con l'API di OpenAI
3 ore
22.9K
Il modello o3 di OpenAI è in grado di risolvere problemi complessi in più passaggi, combinando input visivi e testuali e utilizzando strumenti come Python, la ricerca o l’ispezione di immagini per migliorare le risposte.
In questo tutorial ti spiego passo dopo passo come usare o3 via API, cosa lo rende diverso da modelli generalisti come GPT-4o e come gestire in modo efficace i costi di reasoning.
Teniamo i nostri lettori aggiornati sulle ultime novità dell’AI con The Median, la nostra newsletter gratuita del venerdì che riassume le notizie chiave della settimana. Iscriviti e resta sul pezzo in pochi minuti a settimana:
Il modello o3 di OpenAI è progettato per attività avanzate e complesse che richiedono reasoning profondo e autonomia. È particolarmente efficace nella risoluzione di problemi intricati in ambiti come sviluppo software, matematica, ricerca scientifica e interpretazione di dati visivi.
Le capacità agentiche del modello gli permettono di utilizzare in autonomia strumenti come la ricerca sul web, Python e la generazione di immagini, rendendolo ideale per compiti che richiedono analisi in più passaggi e decisioni dinamiche.
Dovresti considerare l’uso del modello o3 via API quando i tuoi progetti coinvolgono compiti di reasoning multimodale complessi che beneficiano della sua alta autonomia e delle sue avanzate capacità analitiche.
Vediamo un rapido confronto tra o3, o4-mini e GPT-4o:

Fonte: OpenAI
Anche il prezzo è un fattore importante da considerare quando usi l’API:
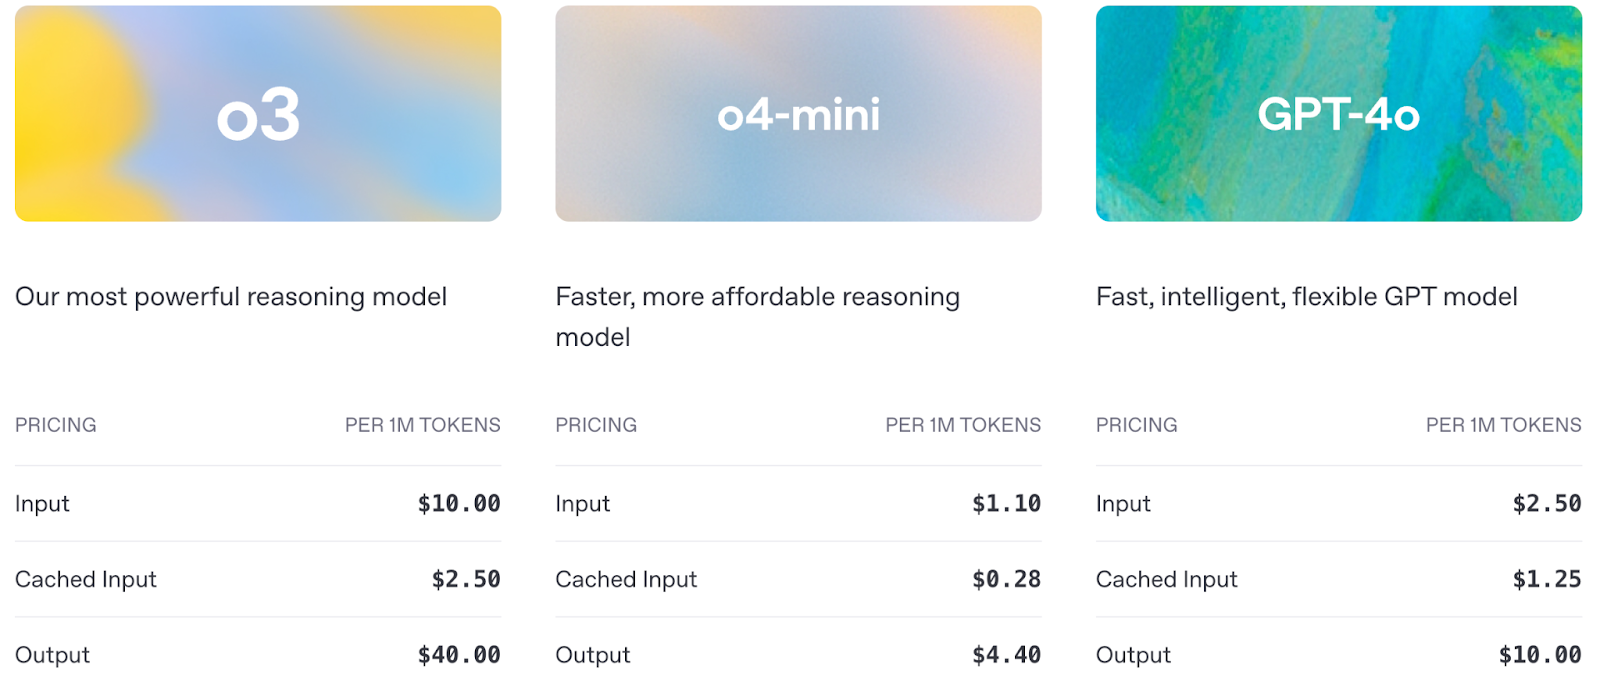
Fonte: OpenAI
Prima di poter usare le capacità avanzate di reasoning di o3, devi configurare l’accesso all’API di OpenAI. In questa sezione ti mostrerò:
Per accedere all’API di OpenAI ti serve una chiave API valida, che puoi ottenere dalla pagina delle chiavi API di OpenAI, assicurandoti che la fatturazione sia abilitata.
Nota: per usare o3 devi prima verificare la tua organizzazione OpenAI qui. L’attivazione della verifica può richiedere fino a 15 minuti.
openaiIniziamo installando e aggiornando la libreria openai per accedere al modello O3 via API. Esegui il seguente comando:
pip install --upgrade openaiUna volta installata, importiamo la classe OpenAI dalla libreria openai:
from openai import OpenAIPer interagire con l’API di OpenAI, effettuiamo l’autenticazione impostando la nostra chiave API segreta, così da poter inviare richieste autorizzate a modelli come o3.
client = OpenAI(api_key=YOUR_API_KEY)Ora che il setup è completo, facciamo la nostra prima chiamata API a o3 e vediamo come gestisce un semplice compito di reasoning in più passaggi tramite la Responses API.
Capiremo la chiamata API di o3 con un semplice esempio di prompt.
response = client.responses.create(
    model="o3",
    input=[{"role": "user", "content": "What’s the difference between inductive and deductive reasoning?"}]
)
print(response.output_text)
Questo esempio invia una domanda in linguaggio naturale direttamente al modello o3 senza usare strumenti o parametri speciali di reasoning.
model="o3" indica all’API di usare il modello di reasoning o3.input=[{"role": "user", "content": "..."}] definisce un singolo messaggio dell’utente che chiede una spiegazione concettuale.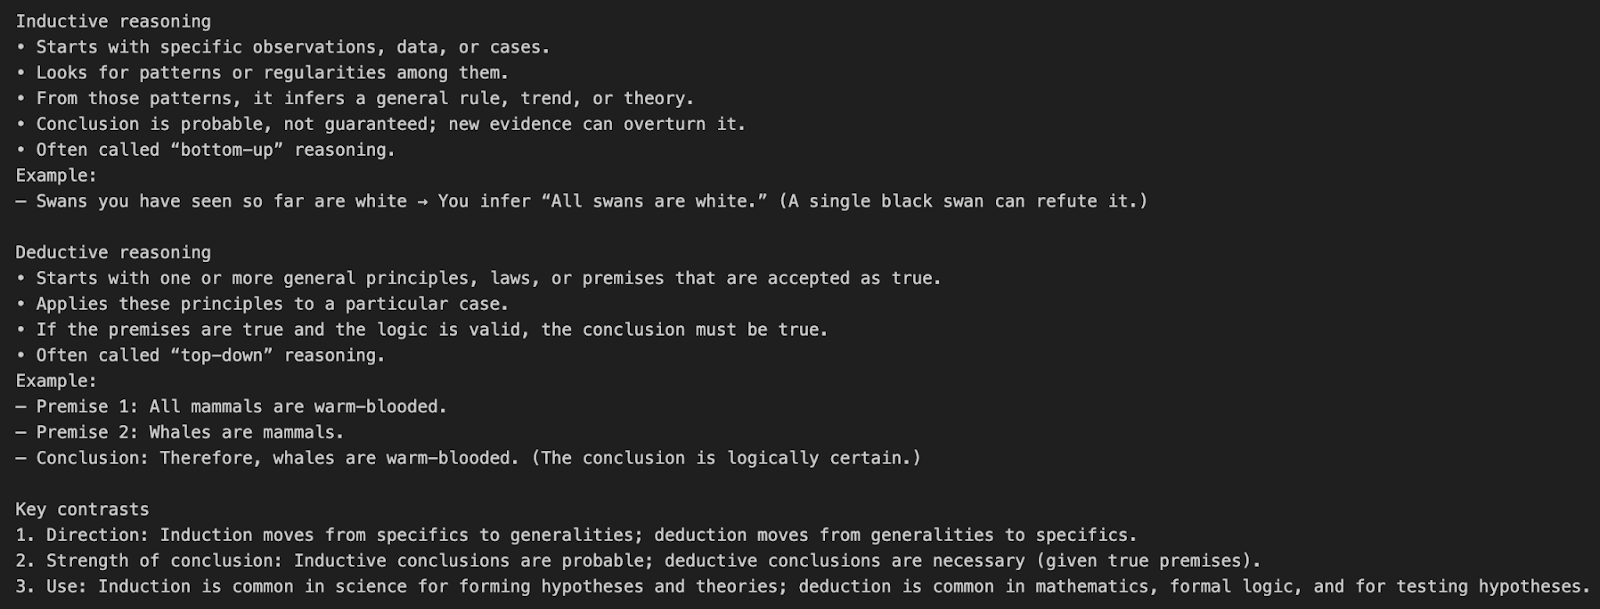
Questi sono i token che incideranno sul costo finale:
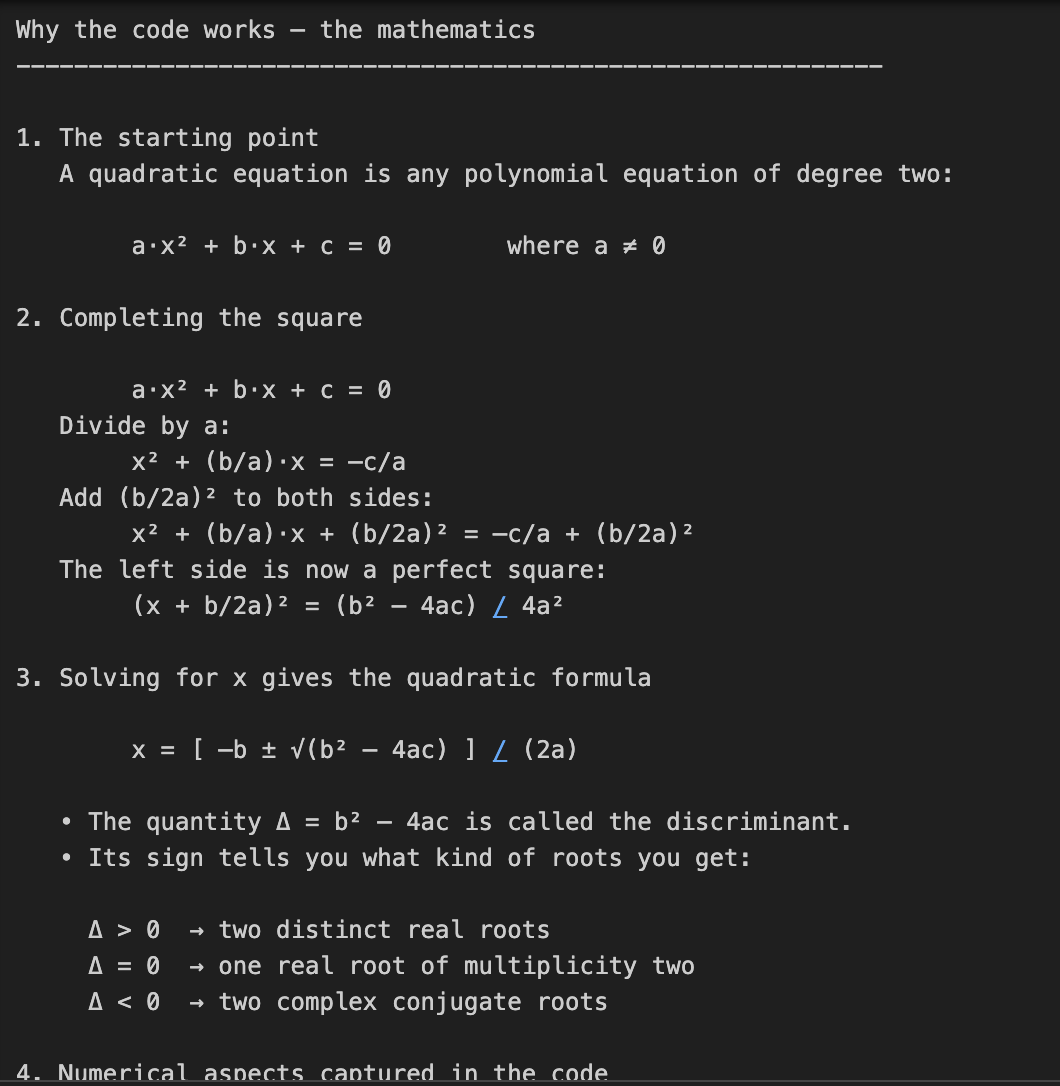
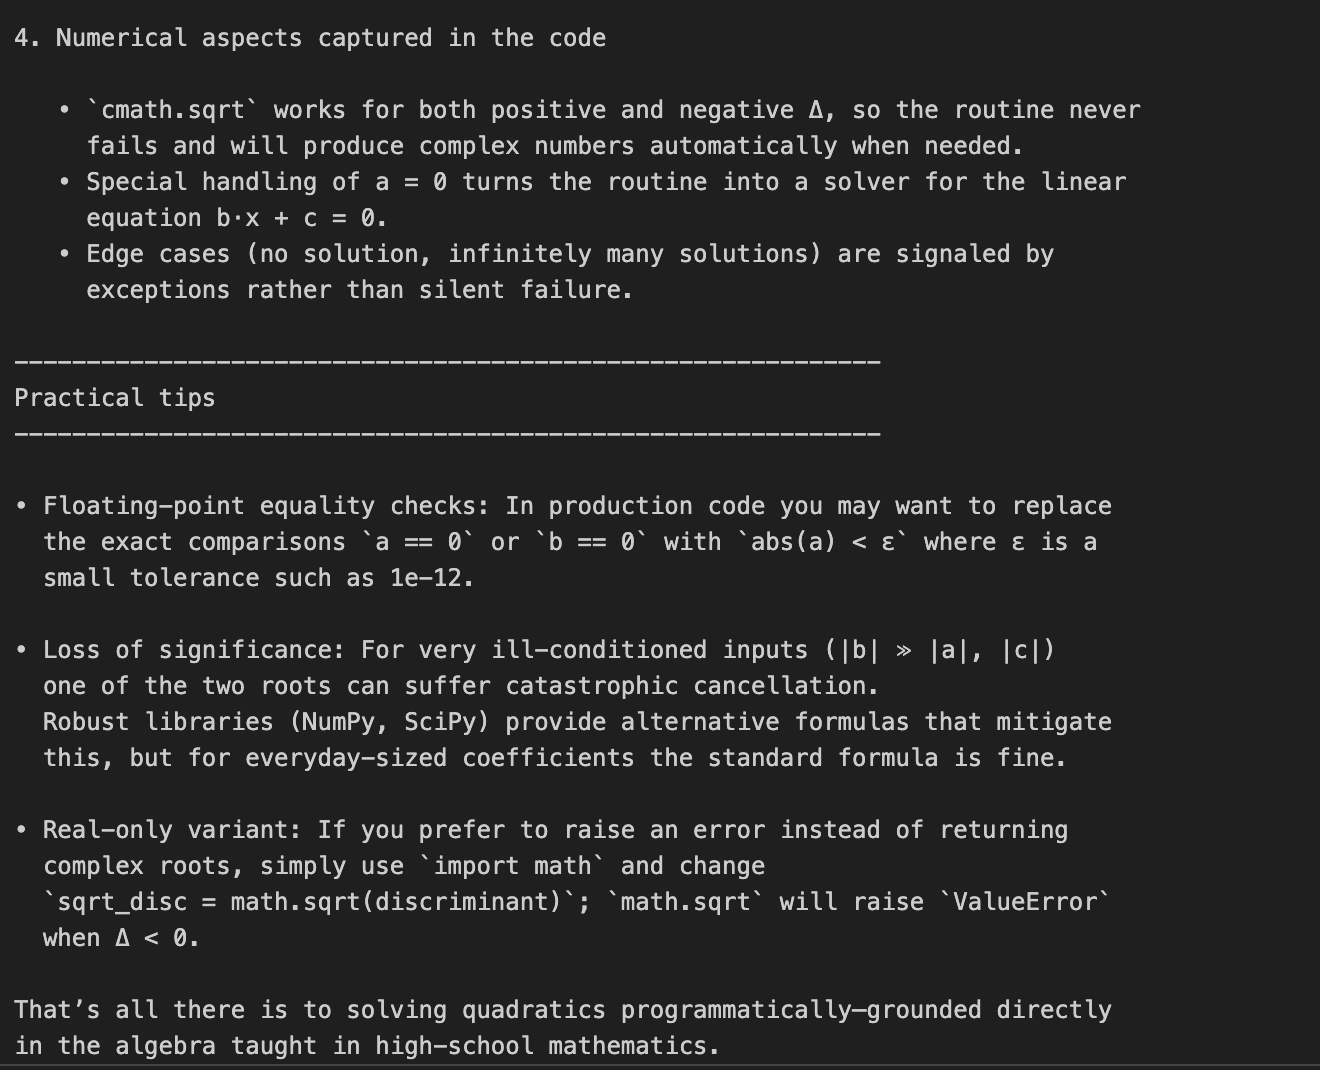
In questo esempio chiediamo a o3 sia di scrivere codice sia di spiegare la matematica dietro la risoluzione delle equazioni di secondo grado. È un compito in due parti, che richiede non solo il codice ma anche una spiegazione matematica dettagliata.
prompt = "Write a Python function that solves quadratic equations and also explain the math behind it."
response = client.responses.create(
    model="o3",
    reasoning={"effort": "high"},
    input=[{"role": "user", "content": prompt}]
)
print(response.output_text)
Questo compito richiede reasoning matematico in più passaggi: prima risolvere con la formula quadratica, poi spiegarne la derivazione. Il parametro reasoning={"effort": "high"} obbliga o3 a “pensare più a fondo”, generando una traccia di reasoning più ampia. È perfetto per attività che richiedono profondità tecnica o soluzioni a più fasi.
Nota sui costi: un maggiore sforzo di reasoning implica più token di reasoning e quindi un costo di output più alto.
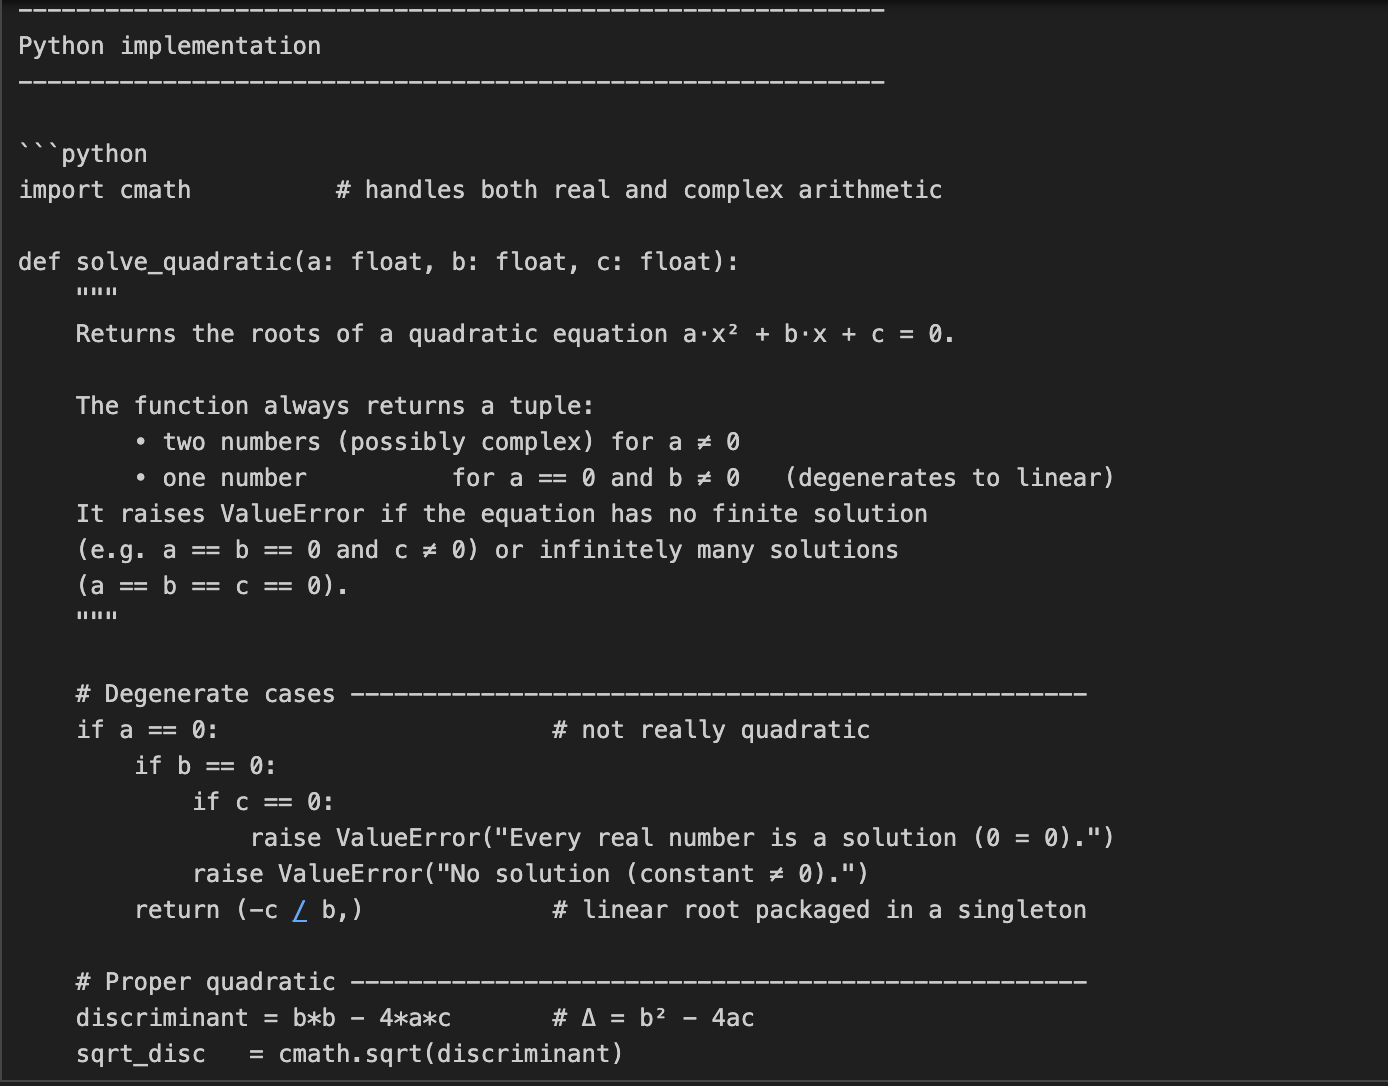
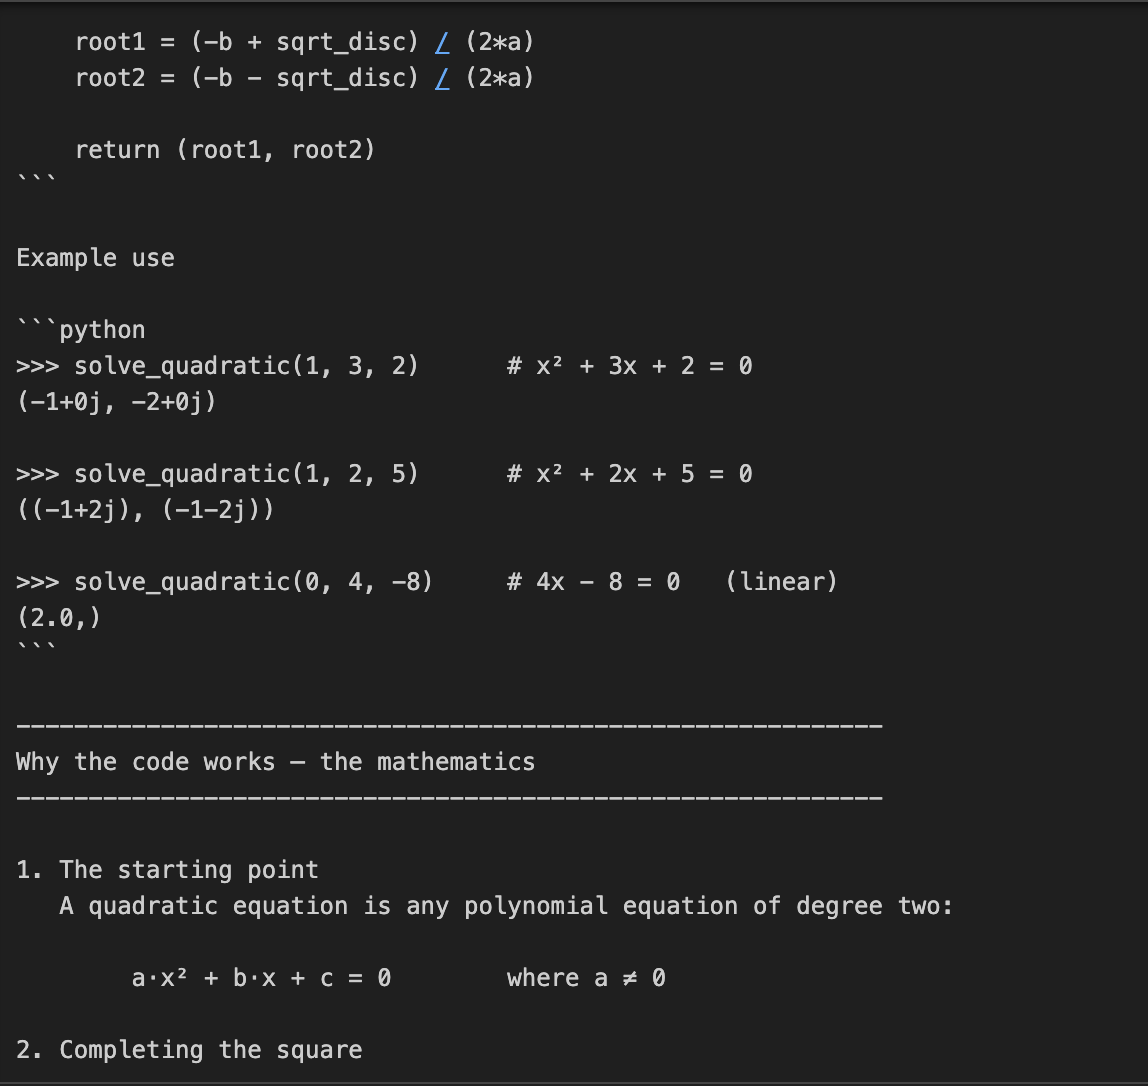
In questo esempio passiamo a O3 un compito di refactoring del codice insieme a un set di istruzioni dettagliate.
prompt = """
Instructions:
- Given the React component below, change it so that nonfiction books have red
  text.
- Return only the code in your reply
- Do not include any additional formatting, such as markdown code blocks
- For formatting, use four space tabs, and do not allow any lines of code to
  exceed 80 columns
const books = [
  { title: 'Dune', category: 'fiction', id: 1 },
  { title: 'Frankenstein', category: 'fiction', id: 2 },
  { title: 'Moneyball', category: 'nonfiction', id: 3 },
];
export default function BookList() {
  const listItems = books.map(book =>
    <li>
      {book.title}
    </li>
  );
  return (
    <ul>{listItems}</ul>
  );
}
"""
response = client.responses.create(
    model="o3",
    reasoning={"effort": "medium", "summary": "detailed"},
    input=[
        {
            "role": "user",
            "content": prompt,
        }
    ]
)
print(response.output_text)
Nel codice sopra, forniamo a O3 un compito di modifica del codice molto strutturato con regole di formattazione dettagliate.
reasoning={"effort": "medium"} gli indica di ragionare con attenzione ma in modo efficiente.summary="detailed" richiede un riassunto interno completo del processo di pensiero. O3 ragionerà internamente e, opzionalmente, restituirà una traccia riassunta se in seguito ispezioni il campo summary.Suggerimento: sono disponibili alcune impostazioni di riassunto che puoi usare, come "concise", "detailed" o "auto".

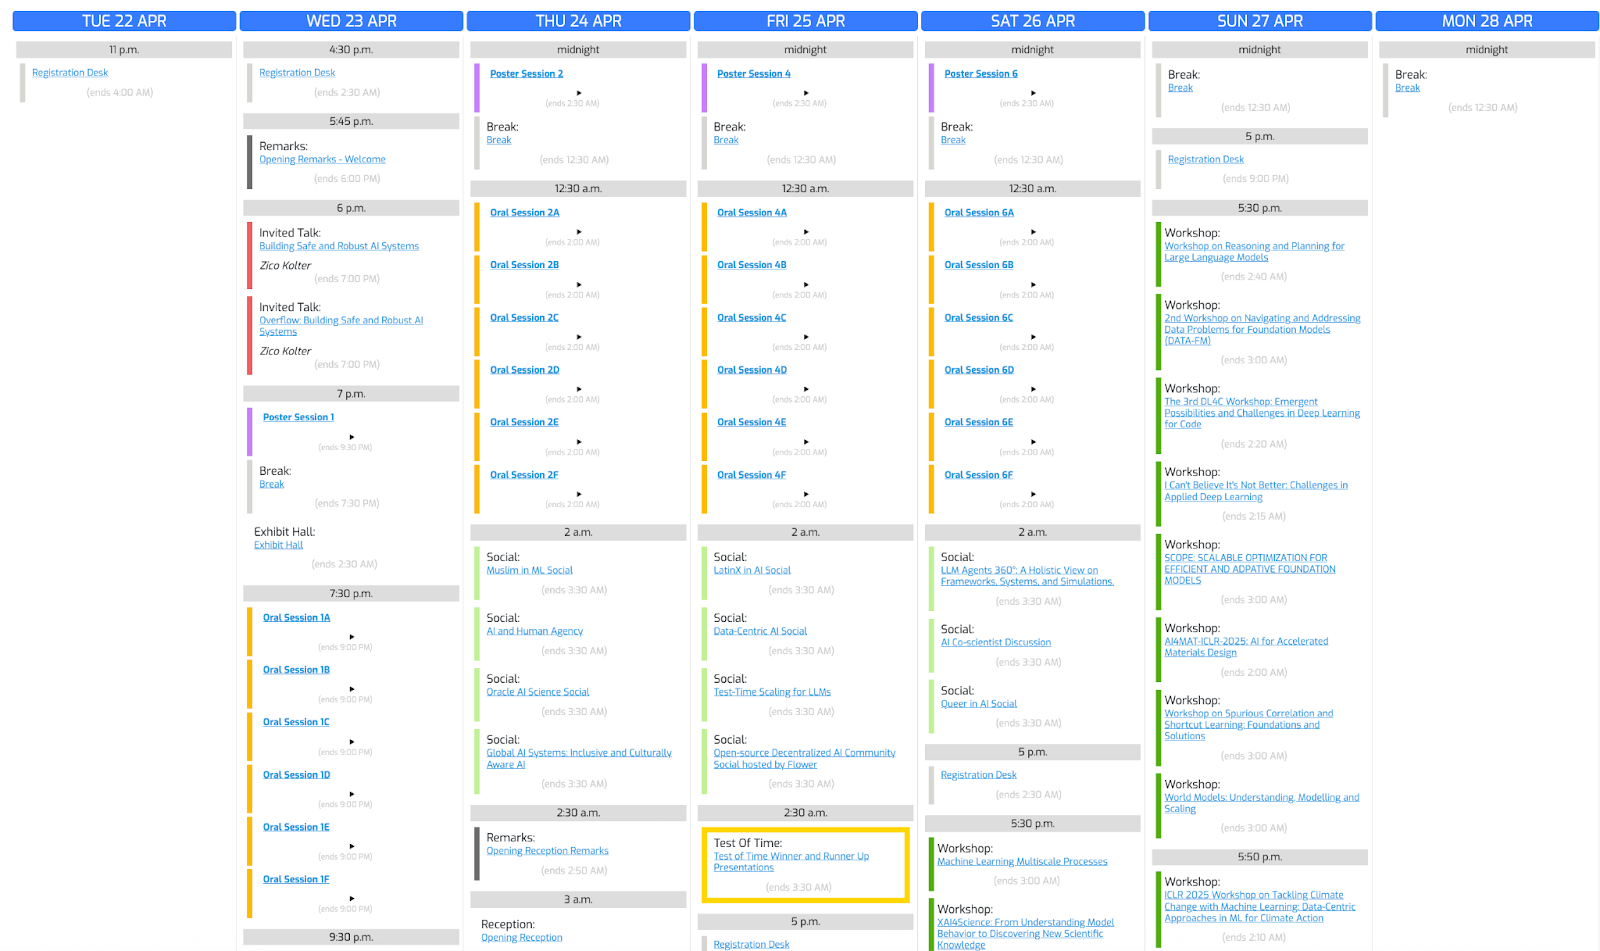
Usiamo questa foto di una conferenza e chiediamo a o3 di creare un programma in base ai nostri interessi.
Iniziamo importando le librerie necessarie e scrivendo una funzione di supporto:
import base64, mimetypes, pathlib
def to_data_url(path: str) -> str:
    mime = mimetypes.guess_type(path)[0] or "application/octet-stream"
    data = pathlib.Path(path).read_bytes()
    b64  = base64.b64encode(data).decode()
    return f"data:{mime};base64,{b64}"
La funzione to_data_url() converte il file immagine locale in un data URL codificato in base64, necessario perché l’API di OpenAI si aspetta input di immagini in formato URL e non come file grezzi.
La funzione to_data_url fa quanto segue:
Ora che abbiamo codificato l’immagine, passiamo a O3 sia il testo sia le informazioni dell’immagine codificata.
prompt = (
    "Create a schedule using this blurry conference photo. "
    "Ensure 10-minute gaps between talks and include all talks related to LLMs."
)
image_path   = "IMAGE_PATH"
image_url    = to_data_url(image_path)
response = client.chat.completions.create(
    model="o3",
    messages=[
        {
            "role": "user",
            "content": [
                { "type": "text",      "text": prompt },
                { "type": "image_url", "image_url": { "url": image_url } }
            ],
        }
    ],
)
print(response.choices[0].message.content)
Ecco come funziona:
client.chat.completions.create(), dove l’input è un elenco che contiene sia:response.choices[0].message.content, che contiene il programma generato dal modello dopo aver ragionato sulle istruzioni testuali e sui dati visivi.Considerazioni importanti sui costi:
max_completion_tokens, che tratteremo nella prossima sezione.Vediamo il risultato:
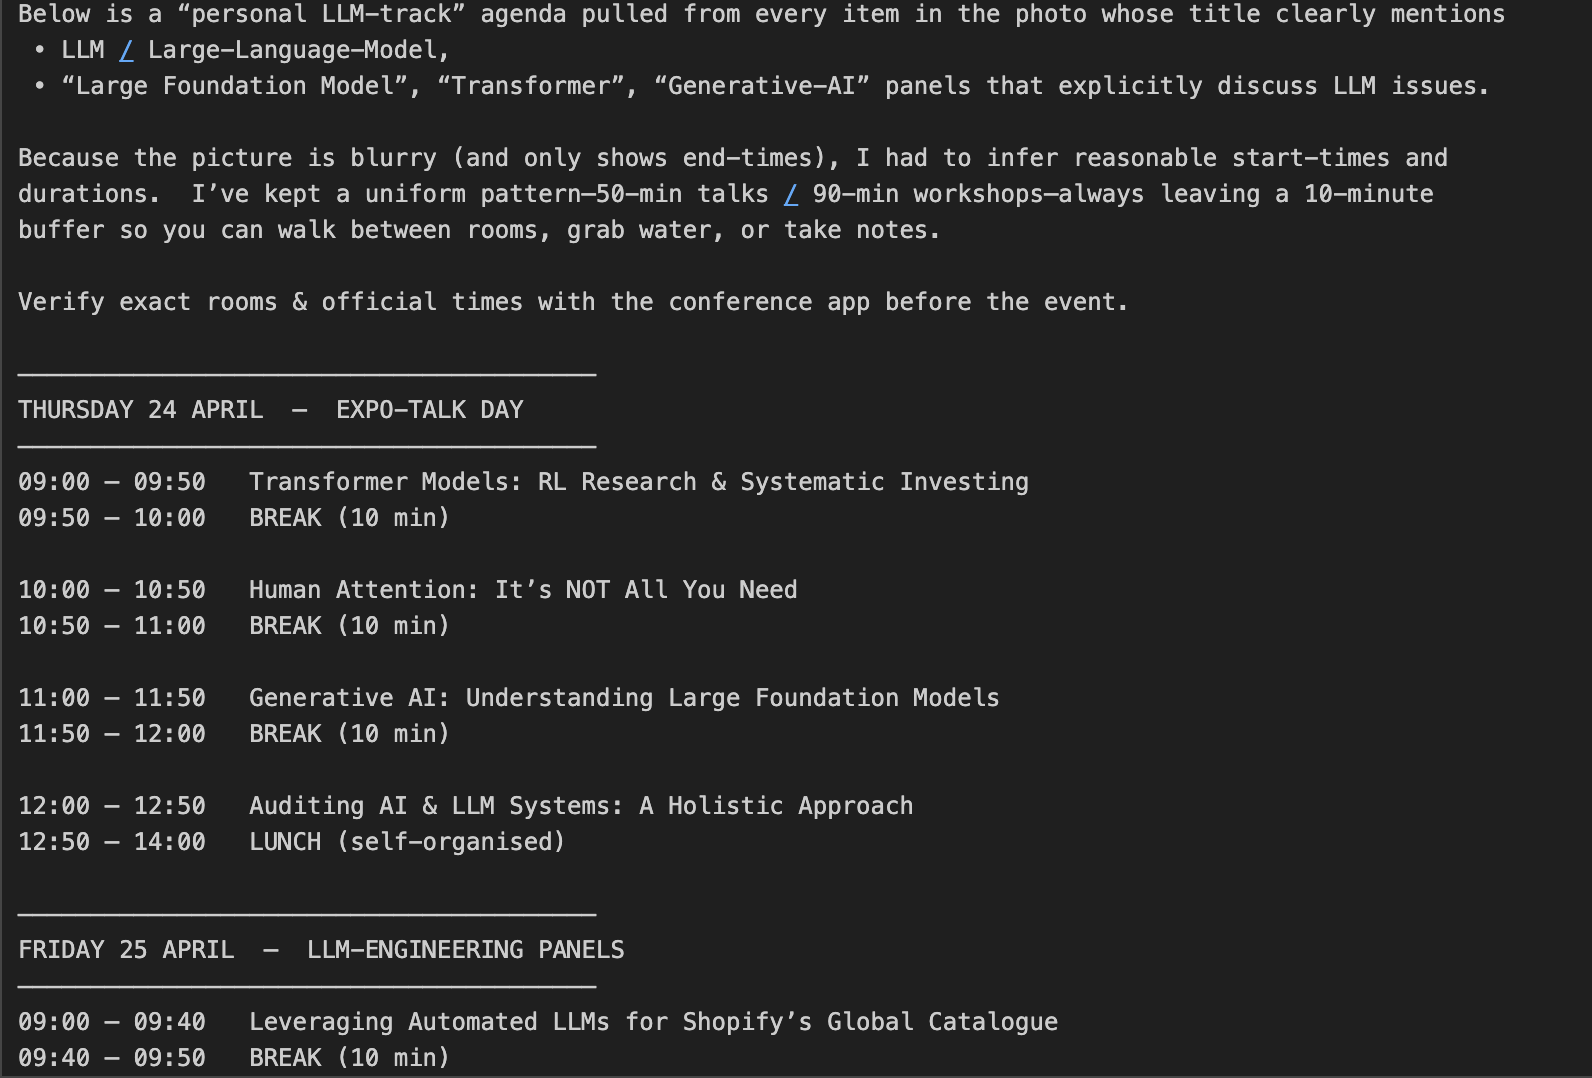
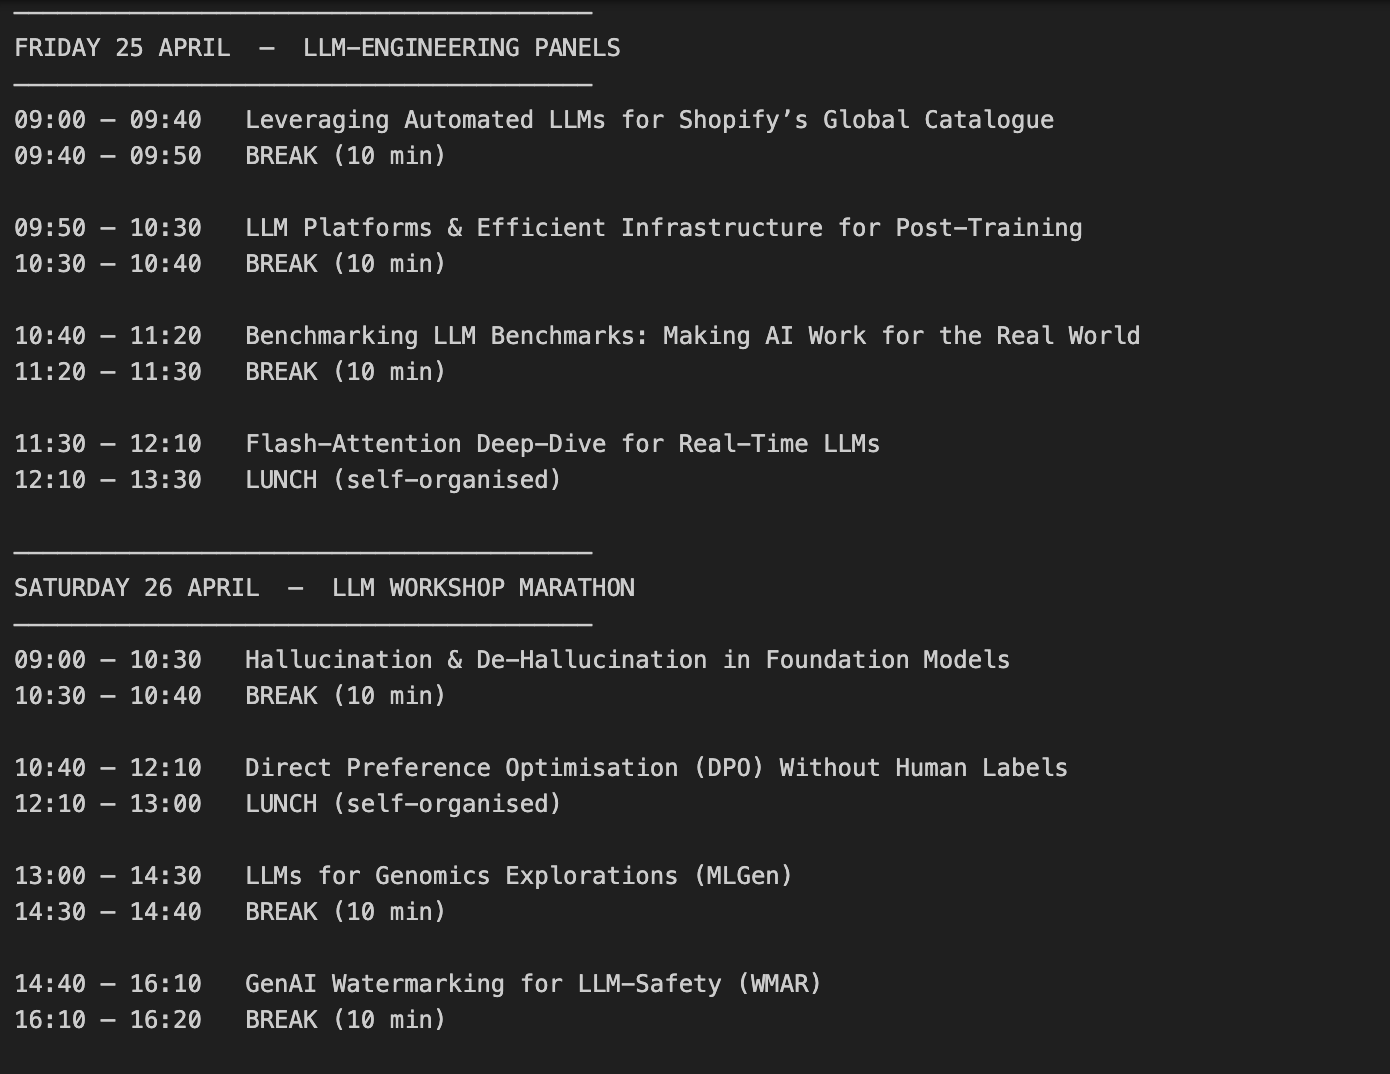
O3 usa token di reasoning oltre ai normali token di input/output, il che significa più token rispetto ai soli input/output e quindi un costo di output maggiore. Seguendo l’esempio precedente, analizziamo come i token di reasoning incidono sui costi.
print(response.usage)CompletionUsage(completion_tokens=3029,prompt_tokens=1007, total_tokens=4036, completion_tokens_details=CompletionTokensDetails(accepted_prediction_tokens=0, audio_tokens=0, reasoning_tokens=2112, rejected_prediction_tokens=0), prompt_tokens_details=PromptTokensDetails(audio_tokens=0, cached_tokens=0))Se vuoi controllare i costi, applica il parametro max_completion_tokens per porre un tetto al consumo totale:
limit_token_response = client.chat.completions.create(
    model="o3",
    messages=[
        {
            "role": "user",
            "content": [
                { "type": "text",      "text": prompt },
                { "type": "image_url", "image_url": { "url": image_url } }
            ],
        }
    ],
    max_completion_tokens=3000,
)
print(limit_token_response.usage)
CompletionUsage(completion_tokens=2746, prompt_tokens=1007, total_tokens=3753, completion_tokens_details=CompletionTokensDetails(accepted_prediction_tokens=0, audio_tokens=0, reasoning_tokens=2112, rejected_prediction_tokens=0), prompt_tokens_details=PromptTokensDetails(audio_tokens=0, cached_tokens=0))Dall’output sopra, vediamo che impostare un valore di max_completion_tokens è fondamentale per controllare il comportamento del modello. Limitando il numero massimo di token generati, impediamo a o3 di produrre output inutilmente lunghi o di consumare in eccesso token di reasoning, aiutando a ottimizzare i costi complessivi dell’API. Ciò è particolarmente importante in compiti complessi in cui il reasoning interno potrebbe altrimenti dominare l’uso dei token senza produrre un output visibile proporzionato.
Importante: quando usi o3 per compiti visivi complessi, imposta sempre max_completion_tokens su un valore prudentemente alto. Se il limite di token è troppo basso, il modello potrebbe consumare tutti i token durante il reasoning interno e non restituire alcun output visibile.
Il modello O3 si comporta in modo diverso rispetto a modelli generalisti come GPT-4o o Claude 3.5 Sonnet, perché o3 intraprende internamente un reasoning profondo a catena. Rende al meglio con prompt semplici e orientati all’obiettivo: specificare eccessivamente i passaggi può peggiorarne le prestazioni.
Ecco alcune best practice consigliate da OpenAI per il prompting di o3:
In questo blog abbiamo visto come collegarci al modello O3 di OpenAI via API, gestire i costi dei token di reasoning e creare prompt efficaci seguendo le best practice. Se il tuo progetto richiede capacità avanzate di reasoning, come matematica in più passaggi, refactoring del codice o comprensione visiva, O3 è la scelta migliore.
Per approfondire il lavoro con le API, ti consiglio questi blog:
Impara l'AI con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



