
핵심 결과는 다음과 같습니다.
- 둘 다 진짜 셰이더를 작성했습니다. 각 페이지는 GLSL 프래그먼트 셰이더에서 전체 장면을 계산하고, p5.js는 캔버스 호스팅과 마우스/시간 전달만 담당했습니다.
- Fable 5.2는 깊이를, Astra는 그림을 만들었습니다. Fable의 파도·바위·등대는 3D로 읽히며, 좋은 의미에서 약간 오래된 플레이스테이션 게임의 느낌이 납니다. Astra의 장면은 명확히 인지되지만 매우 평면적이며, 등대는 단순한 그림처럼 보입니다.
- 장면을 존중하는 빔은 Fable 5.2뿐이었습니다. Fable의 빔이 어떤 요소 뒤로 흔들릴 때 그 요소는 어둡게 유지됩니다. Astra의 빔도 마우스에 반응하지만 정밀도가 떨어집니다.
- Fable 5.2는 폭풍을 끝까지 구현했습니다. 굵은 비, 강한 파도, 배경의 번개가 있습니다. Astra도 그럴듯한 비와 전반적으로 준수한 파도가 있으나, 번개는 없고 바다는 잔잔하며 바위는 어색하고, 해안 가까운 파도는 증발하는 듯 보입니다.
두 모델을 장면 일치도, 셰이더 구현 품질, 커서 추적 성능, 프래그먼트 셰이더 진정성의 네 축으로 평가했습니다. 마지막 축은 둘 다 만점을 받았고, 차이가 난 항목은 다음과 같습니다.
| Measure | Claude Fable 5.2 (high) | GPT-6 Astra (high) |
|---|---|---|
| Cost of this run (USD) | $4.91 | $1.75 |
| Output tokens (incl. reasoning) | 95,683 | 22,934 |
| Aesthetic match (primary discriminator) | 5 | 3 |
| Shader competence | 5 | 4 |
| Cursor interactivity | 5 | 4 |
| Rubric score (mean of four axes) | 5.0 | 3.7 |
의외였던 점은 비용입니다. Fable 5.2는 토큰당 더 저렴하지만, 이 과제에서 출력 토큰을 약 네 배 더 사용해 실행 비용이 Astra보다 거의 세 배 비쌌습니다.
Claude Fable 5.2는 본 테스트에서 명확히 승리했으며, 격차도 Unity의 인용문이 지적한 대로 정확히 나타났습니다. 실제 깊이와 기하를 존중하는 빛을 구현한 장면입니다. Fable의 장면은 게임처럼 보이고, Astra의 장면은 그 단순화된 일러스트처럼 보입니다.
이는 한 노력 설정에서 하나의 과제를 한 번씩 실행한 결과로, Fable 5.1을 상대로 Astra가 승리했던 물리 시뮬레이션과는 다른 유형의 테스트입니다. 두 모델 전반에 대한 결론이라기보다 3D 장면 구축에 대한 시사점으로 보아야 합니다.
언제 Claude Fable 5.2, 언제 GPT-6 Astra를 선택할까
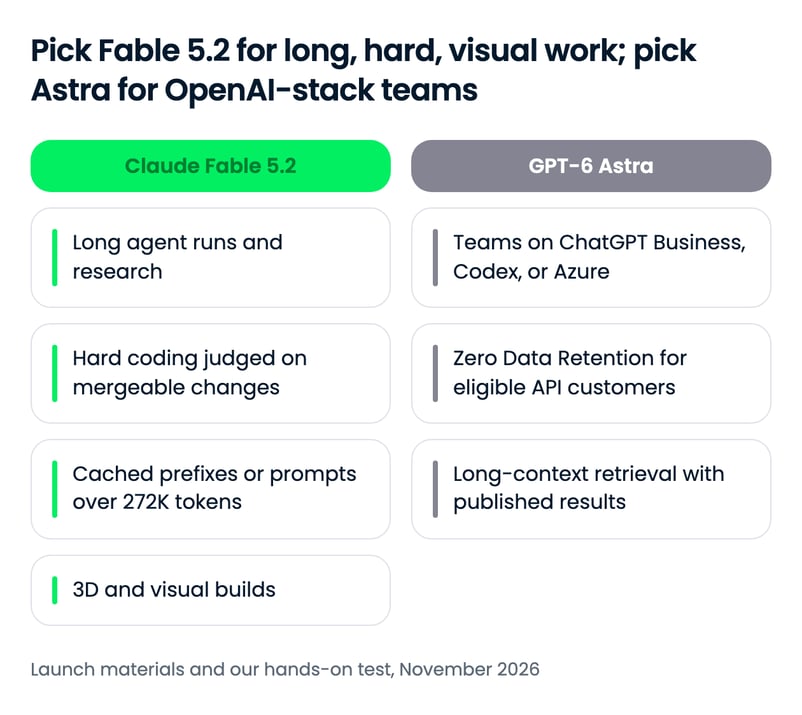
대부분의 기술 작업에서는 토큰 기준으로 Fable 5.2가 더 강력하고 저렴합니다. GPT-6 Astra의 장점은 팀의 현행 도구 생태계와, Anthropic이 아직 답하지 않은 OpenAI의 공개 결과에 기반합니다.
다음과 같다면 Claude Fable 5.2를 선택하세요…
- 에이전트가 수 시간 실행됩니다. Remote Labor Index처럼 다단계 프로젝트에서 리드가 가장 큽니다. Anthropic의 페르마의 마지막 정리 Lean 형식화 사례는 매우 긴 작업도 완주함을 보여줍니다.
- 병합되는 코드를 원합니다. 두 코딩 벤치마크 모두에서 앞서며, high effort에서도 Astra의 최고 FrontierCode 점수를 이긴다고 Anthropic는 밝힙니다.
- 프롬프트가 캐시되거나 매우 깁니다. 캐시 읽기 비용이 Astra의 1/5이고, 272K 토큰 초과 할증이 없습니다.
- 3D 장면, 게임, 비주얼 도구를 만듭니다. 셰이더 테스트에서 진짜 깊이와 기하를 존중하는 조명을 구현했습니다.
다음과 같다면 GPT-6 Astra를 선택하세요…
- 팀이 이미 ChatGPT Business/Enterprise, Codex, 또는 Azure를 사용합니다. 해당 구독에 Astra가 포함되며, Pro, Business, Enterprise 플랜은 GPT-6 Astra Pro도 제공합니다.
- Zero Data Retention이 필요합니다. Astra는 적격 API 고객에게 이를 지원하지만, Fable 5.2는 Enterprise Frontier Safeguards 설정이 없으면 30일 보존이 필요합니다.
- 백만 토큰 프롬프트 전반의 검색이 핵심입니다. OpenAI는 Astra의 롱 컨텍스트 검색 결과를 공개했지만, Anthropic는 Fable 5.2에 대해 공개하지 않았습니다.
- 짧은 빌드를 많이, 저예산으로 돌립니다. 본 테스트에서 Astra는 훨씬 적은 토큰으로 실행을 마쳐, 결과는 약하나 사용 가능한 수준에서 Fable 비용의 3분의 1로 끝냈습니다.
Claude Fable 5.2와 GPT-6 Astra 시작하기
두 모델 모두 벤더 API, 3대 클라우드, GitHub Copilot, OpenRouter에서 사용할 수 있습니다.
| Surface | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Consumer app | Claude 앱, 적격 유료 플랜(Pro 및 Team 포함) | ChatGPT Plus, Pro, Business, Enterprise(Enterprise 워크스페이스에서는 기본 비활성) |
| First-party API | Claude Platform | OpenAI API |
| Cloud platforms | AWS(Claude Platform on AWS, Amazon Bedrock), Google Cloud, Microsoft Azure | Microsoft Azure, Amazon Bedrock, Google Cloud |
| Coding agents | Claude Code, GitHub Copilot | Codex, GitHub Copilot |
| Third-party routers | OpenRouter | OpenRouter |
| API model ID | claude-fable-5-2 | gpt-6-astra |
모델 ID는 Claude Platform에서 claude-fable-5-2, OpenAI API에서 gpt-6-astra입니다.
첫 API 호출 만들기
가장 빠른 방법은 OpenRouter입니다. OpenAI 호환 클라이언트에서 모델 문자열만 바꾸면 됩니다.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)네이티브 SDK는 GPT-6 Astra API 튜토리얼에서 전체 에이전트를 구축하며, Fable 5.2 가이드에서 effort 레벨과 빠른 모드를 다룹니다.
마무리
현재 가장 까다로운 기술 작업 전반에서 Claude Fable 5.2가 더 나은 선택입니다. 두 모델이 공유하는 모든 벤치마크에서 앞서고, 토큰당 비용이 더 낮으며, 직접 테스트에서도 명확히 승리했습니다. 단, 모든 정면 비교 수치는 Anthropic가 작성했으며, OpenAI가 주장하는 수학·추상 추론·백만 토큰 검색 성과에는 아직 Fable 5.2의 답이 없습니다.
가장 흥미로웠던 대목은 테스트의 비용 항목입니다. Fable 5.2는 토큰당 저렴했지만, 생각하고 작성한 분량이 훨씬 많아 실행 비용은 더 컸습니다. 워크로드를 옮긴다면 토큰당 비용이 아니라 과제당 비용을 측정하세요.
두 모델로 빌드를 시작하려면 Introduction to Claude Models와 Working with the OpenAI API 과정을 추천합니다.
FAQs
Claude Fable 5.2가 GPT-6 Astra보다 더 좋은가요?
두 모델 모두 점수화된 벤치마크 기준으로는 그렇습니다. Anthropic의 출시 표에 따르면 Claude Fable 5.2는 코딩, 컴퓨터 사용, 장기 지식 작업을 포함한 모든 공통 항목에서 GPT-6 Astra를 앞섰고, 직접 셰이더 테스트에서도 Fable 5.2가 승리했습니다. 다만 OpenAI는 Fable 5.2와의 자체 비교를 공개하지 않았고, Astra의 수학·추상 추론·롱 컨텍스트 검색 결과에는 아직 Fable 5.2의 대응 자료가 없습니다.
Claude Fable 5.2와 GPT-6 Astra의 비용은 얼마나 되나요?
Claude Fable 5.2는 백만 입력 토큰당 $8, 백만 출력 토큰당 $40입니다. GPT-6 Astra는 각각 $10, $50입니다. 캐시 읽기는 Fable 5.2에서 백만 토큰당 $0.20, Astra에서 $1.00이며, Astra는 272K 입력 토큰을 넘는 요청에 대해 입력과 캐시에 2배, 출력에 1.5배 할증을 적용합니다. Fable 5.2는 롱 컨텍스트 할증이 없습니다.
코딩에는 Claude Fable 5.2와 GPT-6 Astra 중 어떤 모델이 더 좋나요?
Claude Fable 5.2는 두 모델에 대해 Anthropic이 보고한 코딩 벤치마크 모두에서 앞섭니다. FrontierCode 2.0에서 49.1% 대 42.8%, FrontierSWE v2에서 69.9% 대 65.5%입니다. 해당 점수는 OpenAI가 아닌 Anthropic이 산출한 것입니다. 이미 Codex나 ChatGPT를 사용하는 팀에는 여전히 GPT-6 Astra가 더 편리할 수 있습니다.
Claude Fable 5.2와 GPT-6 Astra의 API 모델 ID는 무엇인가요?
Claude Fable 5.2는 Claude Platform에서 claude-fable-5-2, GPT-6 Astra는 OpenAI API에서 gpt-6-astra입니다. OpenRouter에서는 각각 anthropic/claude-fable-5.2와 openai/gpt-6-astra입니다.
Claude Fable 5.2와 GPT-6 Astra는 어디에서 사용할 수 있나요?
Claude Fable 5.2는 적격 유료 플랜의 Claude 앱과 Claude Code, 그리고 Claude Platform에서 이용할 수 있습니다. GPT-6 Astra는 ChatGPT Plus, Pro, Business, Enterprise, OpenAI API, Codex에서 이용 가능합니다. 두 모델 모두 Microsoft Azure, Amazon Bedrock, GitHub Copilot, Google Cloud에서 사용할 수 있습니다.

Tom은 DataCamp의 데이터 사이언스 에디터입니다. 그는 AI 튜토리얼을 집필·편집하고, 새로운 LLM 출시 버전을 비교하며, AI 기반 워크플로를 구축합니다. 이전에는 도이치 텔레콤에서 데이터 사이언티스트로 근무했습니다. 업무 외에는 머신러닝으로 축구 경기를 예측합니다.
Anthropic는 2026년 11월 9일 Claude Fable 5.2를 출시했습니다. 이는 OpenAI가 GPT-6 Astra를 “세계에서 가장 지능적이고 정렬된 모델”로 선보인 지 두 달 후입니다. Fable 5.2는 Fable 5.1 대비 가격 인하와 함께 출시됐고, Anthropic의 출시 표에서는 두 모델이 모두 등장하는 모든 항목에서 Fable 5.2가 Astra를 앞섭니다. OpenAI가 Fable 5.2와의 비교 자료를 공개하지 않았기 때문에, 선도 모델을 선택하려는 사람들에게는 이 수치가 실제로도 유효한지 확인하는 것이 핵심 질문입니다.
이 글에서는 Claude Fable 5.2와 GPT-6 Astra를 장기 지식 작업, 코딩, 컴퓨터 사용, 세이프가드, 가격 측면에서 비교한 뒤, 두 모델을 대상으로 동일한 실전 빌드 과제를 수행합니다.
AI와 데이터 분야 소식을 따라가고 싶다면 주간 뉴스레터 The Median을 구독하세요.
요약
Claude Fable 5.2란?
Claude Fable 5.2는 Anthropic의 고난도 기술 작업을 위한 모델로, 2026년 11월 모든 사용자에게 출시되었습니다. Claude Mythos 5.2와 동일한 기반 모델 위에 구축되며, Mythos는 검증된 조직을 대상으로 Fable의 사이버보안 및 생물학 세이프가드를 해제한 변형입니다.
Anthropic는 이를 가장 야심적인 장기 기술 작업에 적합하다고 포지셔닝하면서, 일상적인 코딩과 지식 작업에는 여전히 Claude Opus 5.5를 기본으로 권장합니다.
출시 전반은 Claude Fable 5.2 및 Mythos 5.2 가이드에서 다룹니다.
GPT-6 Astra란?
GPT-6 Astra는 OpenAI의 플래그십 프런티어 모델로, 2026년 9월 GPT-5.6 Sol의 후속작으로 출시되었습니다.
OpenAI는 컴퓨터 사용과 전문 업무, 그리고 AI 모델이 따라잡기 어렵도록 설계된 ARC-AGI-3와 FrontierMath Tier 4 같은 벤치마크에서의 포화에 초점을 맞춰 소개했습니다.
GPT-6 Astra 가이드에서 출시 내용을 확인할 수 있으며, GPT-6 Astra API 튜토리얼에서는 릴리스 체크 에이전트 구축 과정을 안내합니다.
Claude Fable 5.2 vs GPT-6 Astra: 정면 비교
Fable 5.2는 코딩부터 컴퓨터 사용까지, 두 모델 모두가 점수화된 모든 벤치마크에서 앞섭니다. 차트 해석만이 비슷한 수준에 가깝습니다. 다만 모든 수치는 OpenAI의 표가 Fable 5.2 이전이라 Anthropic의 출시 표에서 온 것이라는 점이 변수입니다.
장기 지식 작업과 리서치
Fable 5.2는 개방형 다단계 작업에서 격차가 가장 큽니다. 실제 프리랜서형 프로젝트를 점수화하는 Remote Labor Index에서 Fable 5.2는 41.3%로 Astra의 20.8% 대비 약 두 배에 가깝습니다.
테이블 전반의 패턴은 동일합니다. 단일 정답형 과제보다 장기 프로젝트에 가까울수록 Fable 5.2의 리드가 더 커집니다. Humanity's Last Exam 결과도 놀랍지 않습니다. OpenAI의 자체 출시 표에서도 이미 Astra가 Claude Fable 5.1에 뒤처진 바 있습니다.
Anthropic의 사례 소개도 같은 방향을 가리킵니다. Fable 5.2는 약 1,000개의 에이전트를 사용해 30시간 만에 Lean으로 페르마의 마지막 정리를 형식화했으며, 이전 내부 연구 모델은 같은 작업에 11일이 걸렸습니다.
이를 기정사실로 보기 전 유의할 점 두 가지:
장기적이고 모호한 리서치·분석 프로젝트에서는 Fable 5.2가 더 강력하며, 단순한 하니스 차이만으로는 이 격차를 메우기 어려워 보입니다.
코딩과 에이전틱 워크플로
Fable 5.2는 Anthropic이 보고한 두 코딩 벤치마크 모두에서 앞서지만, 지식 작업만큼 큰 격차는 아닙니다. 오픈소스 메인테이너가 모델의 변경 사항을 병합할지 평가하는 FrontierCode 2.0에서 Fable 5.2는 xhigh effort 기준 49.1%로, Astra의 42.8%를 앞섭니다.
Anthropic는 Fable 5.2가 high effort에서도 Astra의 최고 FrontierCode 점수를 유사 비용으로 이긴다고 덧붙입니다. OpenAI의 코딩 표는 구버전 벤치마크를 사용하고 Fable 5.1과 비교하기 때문에 아직 OpenAI 쪽의 교차 검증은 없습니다. 현재 공개된 증거로는 Fable 5.2가 더 나은 코딩 모델입니다.
컴퓨터 사용, 비전, 로보틱스
Fable 5.2는 컴퓨터 사용과 로보틱스에서 앞서며, 차트 해석은 박빙입니다. 로보틱스는 특히 두드러집니다. 시뮬레이션 양팔 로봇 벤치마크인 RoboDojo Sim에서 Fable 5.2는 64.9%, Astra는 29.8%입니다.
OpenAI는 Astra를 “세계 최고의 컴퓨터 사용 모델”이라 했지만, 이는 OSWorld 2.0에서 Claude Fable 5.1과 Claude Opus 5를 상대로 한 주장입니다. Anthropic의 더 최신 버전에서는 Fable 5.2가 앞섭니다.
수학, 추상적 추론, 롱 컨텍스트: Astra의 미답 주장
Astra의 가장 강력한 출시 결과는 Anthropic이 Fable 5.2에 대해 보고하지 않은 벤치마크에 있습니다. 따라서 정면 비교는 없고 한쪽의 주장만 존재합니다. 가장 분명한 것은 롱 컨텍스트 검색으로, Astra는 512K~1M 토큰 구간의 OpenAI MRCR v2 8-needle 테스트에서 96.3%를 기록했습니다.
OpenAI는 FrontierMath Tier 4와 ARC-AGI-3에서도 포화에 가까운 점수를 보고하지만, GPT-6 Astra 가이드에서 언급했듯 ARC-AGI-3 수치는 일반 API 호출에서는 제공되지 않는 상태 하니스에 의존합니다. 작업이 백만 토큰 프롬프트 전반의 검색 성능에 달려 있다면, 현재로서는 Astra만이 공개 증거를 제시했습니다.
세이프가드와 데이터 보존
두 모델 모두 기본적으로 공격적 사이버보안 작업을 차단하지만, 거부보다는 데이터 보존 정책에서 차이가 큽니다. Fable 5.2는 분류기로 침투 테스트, 익스플로잇 생성, 다수의 연구 수준 생물학 작업을 차단하며, Fable 5.1 대비 불필요한 차단은 줄었다고 합니다. 검증된 조직은 Claude Mythos 5.2를 신청할 수 있습니다.
OpenAI는 Astra를 Preparedness Framework의 Critical 사이버보안 임계치로 평가하고, 익스플로잇 생성은 Daybreak 프로그램으로 제한합니다. Astra는 적격 API 고객에게 Zero Data Retention을 지원하는 반면, Fable 5.2는 엔터프라이즈가 Anthropic의 Enterprise Frontier Safeguards를 사용하지 않는 한 안전 모니터링을 위해 30일 보존을 요구합니다. 이미 제로 보존에 의존하는 규제 환경의 팀에는 Astra가 더 수월합니다.
가격: 실제로 지불하는 비용
Fable 5.2는 두 벤더가 모두 공개한 모든 요율에서 GPT-6 Astra보다 저렴하지만, 격차는 균일하지 않습니다. Astra는 입력, 출력, 캐시 쓰기에서 1.25배 비싸고, 캐시 읽기에서는 5배 비싸며, 롱 컨텍스트 할증은 Astra에만 있습니다.
일반적인 균형 잡힌 워크로드에서는 차이가 크지 않습니다. 다만 프롬프트를 캐시하거나 272K 토큰을 넘기면 결정적 요인이 됩니다.
토큰 요율 나란히 보기
두 벤더 모두 백만 토큰당 표준 요율과 캐시, 배치, 빠른 모드 가격을 공개합니다.
대부분의 팀이 체감할 항목은 캐시 읽기 요율입니다. 에이전트 루프는 매 스텝마다 같은 긴 접두어를 재전송하기 때문입니다.
실제 워크로드 비용
아래 각 행은 월간 볼륨이며, (볼륨 ÷ 1M) × 요율로 산출해 입력과 출력을 합산했습니다.
두 벤더 모두 공유 워크로드의 실제 토큰 사용량을 공개하지 않았으므로, 위 합계는 청구서가 아니라 요율 비교로 보세요. 아래의 직접 테스트가 왜 그런지 보여줍니다. 그 테스트에서는 토큰당 더 저렴한 모델이 실행 비용은 더 비쌌습니다.
Claude Fable 5.2와 GPT-6 Astra의 성능
한 벤더의 출시 포스트에서 나온 벤치마크만으로는 한계가 있어, 동일한 프롬프트와 동일한 도구로 두 모델을 대상으로 하나의 빌드 과제를 실행했습니다.
과제: 전체 창 크기의 애니메이티드 GLSL 프래그먼트 셰이더가 들어간 단일 HTML 페이지를 만들 것. 장면은 밤 폭풍 속 바위 해안의 등대로, 바위에 부딪히며 굴러오는 파도, 비스듬히 내리는 빗줄기, 아래에서 빛이 비치는 낮은 구름을 포함합니다. 등대의 빔은 마우스를 따라 움직이며, 스쳐 지나가는 파도·비·구름을 밝힙니다. p5.js는 캔버스 호스팅, 루프 실행, 마우스 위치와 시간을 셰이더로 전달하는 역할만 할 수 있습니다.
전체 프롬프트:
어려운 점:
Anthropic 출시 포스트는 Unity의 Sam Zhang 인용을 통해 Fable 5.2의 가장 뚜렷한 향상이 “제로부터 더 고품질의 3D 장면을 구축하는 것”이라고 밝힙니다. 본 테스트는 그 주장에 대한 직접 검증입니다. 또한 GPT-6 Astra vs Claude Fable 5.1 비교에서 이전 Fable을 상대로 물리 시뮬레이션 테스트를 Astra가 이겼던 바 있어 일종의 재대결이기도 합니다.
두 모델 모두 OpenCode에서 고정된 도구 표면(파일 읽기/편집만)으로,
high추론 노력, 각 1회 시도, 신규 세션, 동일 프롬프트(바이트 단위 동일)로 실행했습니다.아래는 마우스를 장면 위로 움직이며 녹화한 화면입니다. Fable이 먼저입니다: