
I principali risultati:
- Entrambi hanno scritto un vero shader. Ogni pagina calcola l’intera scena in uno shader di frammenti GLSL, con p5.js che ospita solo il canvas e passa mouse e tempo.
- Fable 5.2 ha costruito profondità; Astra ha costruito un’immagine. Le onde, le rocce e il faro di Fable leggono come 3D, con l’aspetto di un gioco PlayStation un po’ datato, in senso positivo. La scena di Astra è chiaramente riconoscibile, ma molto piatta, e il suo faro sembra un disegno semplificato con vernice.
- Solo il fascio di Fable 5.2 rispetta la scena. Quando il fascio di Fable passa dietro a un elemento, quell’elemento resta scuro. Il fascio di Astra risponde al mouse, ma in modo meno preciso.
- Fable 5.2 si è impegnato nella tempesta. Ha pioggia intensa, onde forti e fulmini sullo sfondo. Astra ha pioggia convincente e onde generalmente buone, ma niente fulmini, mare calmo, rocce dall’aspetto strano e onde vicino alla riva che sembrano evaporare.
Ho valutato entrambi su quanto la pagina assomiglia alla scena descritta, la qualità del lavoro di shader, quanto bene il fascio segue il cursore e se l’effetto è un vero shader di frammenti. Entrambi hanno preso il massimo sull’ultimo asse; le righe dove differiscono:
| Misura | Claude Fable 5.2 (high) | GPT-6 Astra (high) |
|---|---|---|
| Costo di questa run (USD) | $4,91 | $1,75 |
| Token di output (incl. ragionamento) | 95.683 | 22.934 |
| Corrispondenza estetica (discriminante principale) | 5 | 3 |
| Competenza shader | 5 | 4 |
| Interattività con il cursore | 5 | 4 |
| Punteggio rubric (media di quattro assi) | 5,0 | 3,7 |
La riga sul costo è la sorpresa. Fable 5.2 è più economico per token, ma ha speso circa quattro volte i token di output in questo compito, quindi la sua esecuzione è costata quasi tre volte quella di Astra.
Claude Fable 5.2 vince chiaramente questo test, e il divario cade esattamente dove la citazione di Unity diceva: una scena con vera profondità e una luce che si comporta come luce. La scena di Fable sembra un gioco; quella di Astra sembra un’illustrazione semplificata di un gioco.
Questa è una sola run di un solo compito a un solo livello di sforzo, ed è un test diverso dalla simulazione fisica che Astra ha vinto contro Fable 5.1, quindi dice più sulla costruzione di scene 3D che sui due modelli in generale.
Quando scegliere Claude Fable 5.2 vs GPT-6 Astra
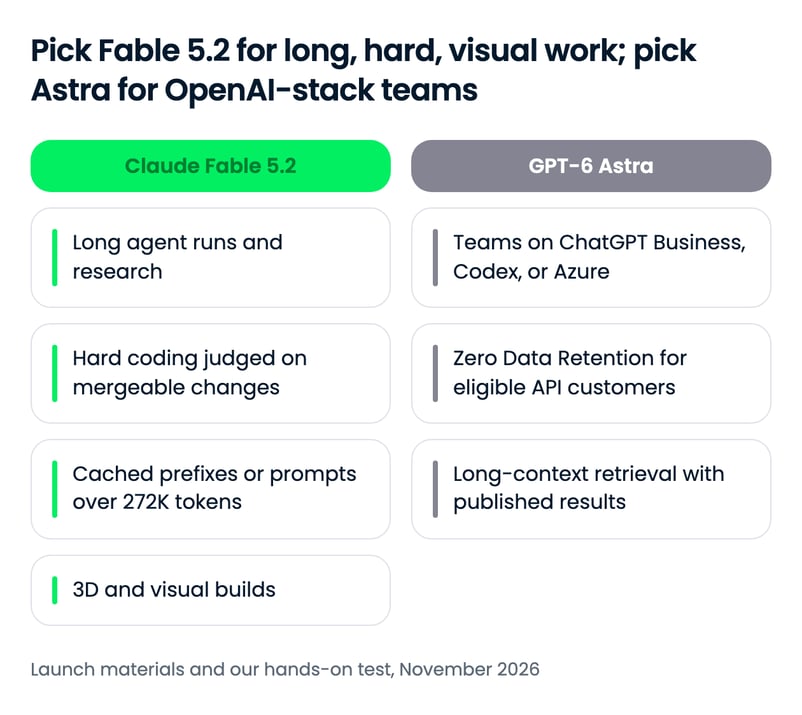
Per la maggior parte del lavoro tecnico, Fable 5.2 è la scelta più forte e più economica per token. Il caso per GPT-6 Astra poggia su dove lavora già il tuo team e sulle affermazioni pubblicate da OpenAI a cui Anthropic non ha ancora risposto.
Scegli Claude Fable 5.2 se…
- I tuoi agenti girano per ore. I vantaggi di Fable 5.2 sono massimi sui progetti multi-step come il Remote Labor Index, e la formalizzazione in Lean dell’Ultimo Teorema di Fermat di Anthropic mostra che porta a termine lavori molto lunghi.
- Ti serve codice che venga mergiato. È avanti in entrambi i benchmark di coding di Anthropic, e Anthropic afferma che batte il miglior punteggio di Astra su FrontierCode anche a sforzo high.
- I tuoi prompt sono in cache o molto lunghi. Le letture in cache costano un quinto della tariffa di Astra, e non c’è sovrapprezzo oltre i 272K token.
- Stai costruendo scene 3D, giochi o strumenti visivi. Nel mio test shader, ha prodotto l’unica scena con vera profondità e illuminazione che rispetta la geometria.
Scegli GPT-6 Astra se…
- Il tuo team lavora già in ChatGPT Business o Enterprise, Codex o Azure. Astra è incluso in quegli abbonamenti, e i piani Pro, Business ed Enterprise includono anche GPT-6 Astra Pro.
- Ti serve Zero Data Retention. Astra la supporta per i clienti API idonei, mentre Fable 5.2 richiede 30 giorni di retention a meno di configurare gli Enterprise Frontier Safeguards.
- Il tuo lavoro dipende dal retrieval su un prompt da un milione di token. OpenAI ha pubblicato risultati di retrieval su contesto lungo per Astra; Anthropic non l’ha fatto per Fable 5.2.
- Esegui molti build brevi con budget limitato. Nel mio test, Astra ha speso molti meno token e ha concluso a circa un terzo del costo di Fable, con un risultato più debole ma utilizzabile.
Come iniziare con Claude Fable 5.2 e GPT-6 Astra
Entrambi i modelli sono disponibili sulle API dei rispettivi vendor, sui tre grandi cloud, su GitHub Copilot e su OpenRouter.
| Superficie | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| App consumer | App Claude, piani a pagamento idonei (inclusi Pro e Team) | ChatGPT Plus, Pro, Business, Enterprise (disattivato di default per i workspace Enterprise) |
| API first-party | Claude Platform | OpenAI API |
| Piattaforme cloud | AWS (Claude Platform su AWS, Amazon Bedrock), Google Cloud, Microsoft Azure | Microsoft Azure, Amazon Bedrock, Google Cloud |
| Agenti di coding | Claude Code, GitHub Copilot | Codex, GitHub Copilot |
| Router di terze parti | OpenRouter | OpenRouter |
| ID del modello API | claude-fable-5-2 | gpt-6-astra |
Gli ID dei modelli sono claude-fable-5-2 sulla Claude Platform e gpt-6-astra sull’API di OpenAI.
La tua prima chiamata API
Il modo più rapido per provarli entrambi è OpenRouter, dove cambiare modello è una modifica di una stringa in un client compatibile con OpenAI.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)Per gli SDK nativi, il nostro tutorial sull’API di GPT-6 Astra costruisce un agente completo, e la nostra guida a Fable 5.2 copre livelli di sforzo e fast mode.
Pensieri finali
Claude Fable 5.2 è, al momento, il modello migliore per la maggior parte dei lavori tecnici impegnativi: è avanti a GPT-6 Astra in ogni benchmark condiviso, costa meno per token e ha vinto chiaramente il mio test pratico. L’avvertenza è che ogni numero head-to-head è stato scritto da Anthropic, e le affermazioni più forti di OpenAI su matematica, ragionamento astratto e retrieval su un milione di token non hanno ancora una risposta di Fable 5.2.
La cosa più interessante per me è la riga dei costi nel mio test. Fable 5.2 è più economico per token e comunque è costato molto di più, perché ha pensato e scritto molto di più. Se sposti i carichi di lavoro, misura il costo per task, non per token.
Se vuoi costruire con uno dei due modelli, ti consiglio il nostro corso Introduction to Claude Models e il nostro corso Working with the OpenAI API.
FAQ
Claude Fable 5.2 è migliore di GPT-6 Astra?
Sui benchmark che valutano entrambi i modelli, sì. La tabella di lancio di Anthropic pone Claude Fable 5.2 davanti a GPT-6 Astra in ogni riga condivisa, incluso coding, uso del computer e lavoro di conoscenza a lungo orizzonte, e Fable 5.2 ha anche vinto il nostro test pratico sullo shader. OpenAI non ha pubblicato un proprio confronto contro Fable 5.2, e i risultati di Astra su matematica, ragionamento astratto e retrieval su contesto lungo non hanno ancora un corrispettivo per Fable 5.2.
Quanto costano Claude Fable 5.2 e GPT-6 Astra?
Claude Fable 5.2 costa $8 per milione di token in input e $40 per milione di token in output. GPT-6 Astra costa $10 e $50. Le letture dalla cache costano $0,20 per milione di token su Fable 5.2 e $1,00 su Astra, e Astra applica 2x sull’input e 1,5x sull’output per richieste oltre i 272K token di input, mentre Fable 5.2 non indica sovrapprezzi per contesto lungo.
Qual è migliore per il coding, Claude Fable 5.2 o GPT-6 Astra?
Claude Fable 5.2 è in testa in entrambi i benchmark di coding che Anthropic riporta per i due modelli: 49,1% vs 42,8% su FrontierCode 2.0 e 69,9% vs 65,5% su FrontierSWE v2. Questi punteggi provengono da Anthropic, non da OpenAI. Per i team che già lavorano in Codex o ChatGPT, GPT-6 Astra resta la scelta più comoda.
Quali sono gli ID dei modelli API per Claude Fable 5.2 e GPT-6 Astra?
Claude Fable 5.2 è claude-fable-5-2 sulla Claude Platform, e GPT-6 Astra è gpt-6-astra sull’API di OpenAI. Su OpenRouter, sono anthropic/claude-fable-5.2 e openai/gpt-6-astra.
Dove posso usare Claude Fable 5.2 e GPT-6 Astra?
Claude Fable 5.2 è disponibile nelle app Claude e in Claude Code su piani a pagamento idonei, e sulla Claude Platform. GPT-6 Astra è disponibile in ChatGPT Plus, Pro, Business ed Enterprise, sull’API di OpenAI e in Codex. Entrambi sono disponibili su Microsoft Azure, Amazon Bedrock, GitHub Copilot e Google Cloud.

Tom è un Editor di Data Science in DataCamp. Scrive e modifica tutorial sull’IA, confronta le nuove release di LLM e crea flussi di lavoro potenziati dall’IA. In precedenza ha lavorato nella data science presso Deutsche Telekom. Fuori dal lavoro, prevede le partite di calcio con il machine learning.





Anthropic ha rilasciato Claude Fable 5.2 il 9 novembre 2026, due mesi dopo che OpenAI ha lanciato GPT-6 Astra come "il modello più intelligente e allineato al mondo". Fable 5.2 arriva con un taglio di prezzo rispetto a Fable 5.1, e la tabella di lancio di Anthropic lo pone davanti ad Astra in ogni riga in cui compaiono entrambi i modelli. OpenAI non ha pubblicato un confronto contro Fable 5.2 che siamo riusciti a trovare, quindi la domanda ovvia per chi sceglie un modello di frontiera è se quei numeri reggono.
In questo articolo, confronterò Claude Fable 5.2 e GPT-6 Astra su lavoro di conoscenza a lungo orizzonte, coding, uso del computer, salvaguardie e prezzi, per poi eseguire un compito pratico di build con entrambi.
Per restare aggiornato sul mondo dell’AI e dei dati, ti consiglio di iscriverti alla nostra newsletter settimanale, The Median.
TL;DR
Che cos’è Claude Fable 5.2?
Claude Fable 5.2 è il modello di Anthropic per i lavori tecnici più impegnativi, rilasciato a tutti gli utenti a novembre 2026 e basato sullo stesso modello sottostante di Claude Mythos 5.2, che rimuove le salvaguardie di Fable su cybersecurity e biologia per le organizzazioni verificate.
Anthropic lo posiziona per il lavoro tecnico più ambizioso a lungo orizzonte, e continua a raccomandare Claude Opus 5.5 come predefinito per il coding quotidiano e i compiti di conoscenza.
La nostra guida a Claude Fable 5.2 e Mythos 5.2 copre il lancio nel dettaglio.
Che cos’è GPT-6 Astra?
GPT-6 Astra è il modello di punta di frontiera di OpenAI, lanciato a settembre 2026 come successore di GPT-5.6 Sol.
OpenAI ha incentrato il suo pitch su uso del computer e lavoro professionale, e sul saturare benchmark come ARC-AGI-3 e FrontierMath Tier 4 progettati per restare avanti ai modelli di AI.
La nostra guida a GPT-6 Astra copre il lancio; il nostro tutorial sull’API di GPT-6 Astra illustra la costruzione di un agente per i check di release.
Claude Fable 5.2 vs GPT-6 Astra: confronto diretto
Fable 5.2 è in testa in ogni benchmark che valuta entrambi i modelli, dal coding all’uso del computer, e solo la lettura di grafici è vicina a un pareggio. Il punto è la fonte: tutte queste cifre provengono dalla tabella di lancio di Anthropic, perché la tabella di OpenAI è precedente a Fable 5.2.
Lavoro di conoscenza a lungo orizzonte e ricerca
Il vantaggio maggiore di Fable 5.2 è sul lavoro aperto e multi-step. Sul Remote Labor Index, che valuta progetti reali in stile freelance, Fable 5.2 completa il 41,3% contro il 20,8% di Astra, circa il doppio.
Il pattern regge in tutta la tabella: più un compito somiglia a un progetto lungo piuttosto che a una singola risposta, più ampio è il vantaggio di Fable 5.2. Humanity's Last Exam non sorprende: la tabella di lancio di OpenAI mostrava già Astra dietro a Claude Fable 5.1.
Anche la vetrina di Anthropic va nella stessa direzione. Fable 5.2 ha formalizzato in Lean la dimostrazione dell’Ultimo Teorema di Fermat in 30 ore con circa 1.000 agenti, un progetto per cui un precedente modello interno di ricerca aveva impiegato 11 giorni.
Due avvertenze prima di considerare la questione chiusa:
Fable 5.2 è il modello più forte per progetti di ricerca e analisi lunghi e ambigui, e i margini sono abbastanza ampi che una differenza di harness difficilmente li colmerebbe da sola.
Coding e workflow agentici
Fable 5.2 è avanti in entrambi i benchmark di coding riportati da Anthropic, anche se con margini inferiori rispetto al lavoro di conoscenza. Su FrontierCode 2.0, che chiede se i maintainer open-source farebbero il merge delle modifiche del modello, Fable 5.2 arriva al 49,1% a sforzo xhigh contro il 42,8% di Astra.
Anthropic aggiunge che Fable 5.2 a sforzo high batte il miglior punteggio di Astra su FrontierCode a circa lo stesso costo per task. La tabella di coding di OpenAI usa versioni di benchmark più vecchie e confronta Astra con Fable 5.1, quindi non c’è ancora un riscontro lato OpenAI. In base alle evidenze disponibili, Fable 5.2 è il modello migliore per il coding.
Uso del computer, visione e robotica
Fable 5.2 è avanti su uso del computer e robotica, mentre la lettura di grafici è vicina al pareggio. La robotica è l’outlier: su RoboDojo Sim, un robot simulato a due bracci, Fable 5.2 segna il 64,9% contro il 29,8% di Astra.
OpenAI ha definito Astra "il miglior modello al mondo per l’uso del computer", ma ha fatto questa affermazione contro Claude Fable 5.1 e Claude Opus 5 su OSWorld 2.0. Sulla versione più recente di Anthropic, Fable 5.2 passa in testa.
Matematica, ragionamento astratto e contesto lungo: le affermazioni non risposte di Astra
I risultati di lancio più forti di Astra si trovano su benchmark che Anthropic non ha riportato per Fable 5.2, quindi qui non c’è un head-to-head, solo affermazioni da un lato. Il più chiaro è il retrieval su contesto lungo: Astra segna il 96,3% sul test 8-needle MRCR v2 di OpenAI nella fascia 512K–1M token.
OpenAI riporta anche punteggi quasi saturi su FrontierMath Tier 4 e ARC-AGI-3, anche se la nostra guida a GPT-6 Astra nota che la cifra su ARC-AGI-3 dipende da un harness stateful che le semplici chiamate API non hanno. Se il tuo lavoro si basa sul retrieval su un prompt da un milione di token, tra i due solo Astra ha evidenze pubblicate.
Salvaguardie e retention dei dati
Entrambi i modelli bloccano di default il lavoro offensivo di cybersecurity, e differiscono più sulla retention dei dati che sulle refusal. I classificatori di Fable 5.2 bloccano penetration testing, generazione di exploit e la maggior parte della biologia a livello di ricerca, anche se Anthropic afferma che produce meno blocchi inutili rispetto a Fable 5.1; le organizzazioni verificate possono richiedere Claude Mythos 5.2.
OpenAI classifica Astra alla soglia Critical di cybersecurity del suo Preparedness Framework e limita la creazione di exploit al programma Daybreak. Astra supporta la Zero Data Retention per i clienti API idonei, mentre Fable 5.2 richiede una retention di 30 giorni per il monitoraggio della sicurezza, a meno che un’azienda non utilizzi gli Enterprise Frontier Safeguards di Anthropic. Per i team regolamentati che già si affidano a retention zero, Astra è l’opzione più semplice.
Prezzi: quanto paghi davvero
Fable 5.2 è più economico di GPT-6 Astra su ogni tariffa pubblicata da entrambi i vendor, e il divario non è uniforme. Astra costa 1,25x in più per input, output e scritture in cache, ma 5x in più per le letture dalla cache, e solo Astra applica un sovrapprezzo per contesto lungo.
Su un carico di lavoro bilanciato la differenza è modesta. Diventa decisiva quando i prompt sono in cache o superano i 272K token.
Tariffe per token affiancate
Entrambi i vendor elencano tariffe standard per milione di token, oltre a prezzi per cache, batch e fast mode.
La tariffa per le letture dalla cache è la voce che la maggior parte dei team sentirà, perché i loop degli agenti reinviano lo stesso prefisso lungo a ogni step.
Quanto costa un carico di lavoro reale
Ogni riga sotto è un volume mensile, prezzato come (volume ÷ 1M) × tariffa, sommato tra input e output.
Nessun vendor ha pubblicato i conteggi dei token per un carico di lavoro condiviso, quindi tratta questi totali come un confronto di tariffe, non come una fattura. La mia esecuzione pratica qui sotto ricorda il perché: lì, il modello più economico per token è stato l’esecuzione più costosa.
Come si sono comportati Claude Fable 5.2 e GPT-6 Astra
I benchmark dal post di lancio di un singolo vendor arrivano fino a un certo punto, quindi ho eseguito un compito di build con entrambi i modelli con prompt e strumenti identici.
Il compito: una singola pagina HTML con uno shader di frammenti GLSL a finestra intera animato di un faro su una costa rocciosa durante una tempesta notturna, con onde che si infrangono sugli scogli, pioggia obliqua e nubi basse illuminate dal basso. Il fascio del faro doveva seguire il mouse e illuminare le onde, la pioggia e le nuvole che attraversa. p5.js poteva solo ospitare il canvas, eseguire il loop e passare la posizione del mouse e il tempo allo shader.
Il prompt completo:
Cosa lo rende difficile:
Il post di lancio di Anthropic cita Sam Zhang di Unity secondo cui i guadagni più chiari di Fable 5.2 sono nel "costruire da zero scene 3D di qualità superiore", quindi questo è un test diretto di quell’affermazione. È anche una sorta di rivincita: nel nostro confronto GPT-6 Astra vs Claude Fable 5.1, Astra ha vinto un test di simulazione fisica contro il precedente Fable.
Entrambi i modelli sono stati eseguiti in OpenCode con una superficie di tool bloccata (solo lettura e modifica file), a sforzo di ragionamento
high, un tentativo ciascuno, in una sessione nuova, con il prompt consegnato byte per byte.Ecco le mie registrazioni schermo di entrambe le pagine, muovendo il mouse sulla scena. Fable per primo: