
Temuan utama:
- Keduanya menulis shader yang autentik. Setiap halaman menghitung seluruh adegan dalam GLSL fragment shader, dengan p5.js hanya meng-host kanvas dan memasukkan mouse serta waktu.
- Fable 5.2 membangun kedalaman; Astra membangun gambar. Gelombang, bebatuan, dan mercusuar Fable terbaca sebagai 3D, dengan tampilan seperti gim PlayStation yang agak lama—dalam arti positif. Adegan Astra jelas dikenali, tetapi sangat datar, dan mercusuarnya terlihat seperti gambar cat yang terlalu disederhanakan.
- Hanya sinar Fable 5.2 yang menghormati adegan. Saat sinar Fable mengayun di belakang sebuah elemen, elemen itu tetap gelap. Sinar Astra merespons mouse, tetapi kurang presisi.
- Fable 5.2 berkomitmen pada badai. Ada hujan lebat, gelombang kuat, dan kilat di latar. Astra memiliki hujan yang meyakinkan dan gelombang yang umumnya bagus, tetapi tanpa kilat, laut yang tenang, bebatuan yang aneh, dan gelombang dekat pantai yang tampak seperti menguap.
Saya memberi skor keduanya berdasarkan apakah halaman terlihat seperti adegan yang dideskripsikan, kualitas kerja shader, seberapa baik sinar mengikuti kursor, dan apakah efeknya benar-benar fragment shader. Keduanya mendapat nilai penuh pada sumbu terakhir; baris-baris yang berbeda:
| Ukuran | Claude Fable 5.2 (high) | GPT-6 Astra (high) |
|---|---|---|
| Biaya run ini (USD) | $4,91 | $1,75 |
| Token output (termasuk reasoning) | 95.683 | 22.934 |
| Kecocokan estetika (pembeda utama) | 5 | 3 |
| Kompetensi shader | 5 | 4 |
| Interaktivitas kursor | 5 | 4 |
| Skor rubrik (rata-rata empat sumbu) | 5,0 | 3,7 |
Baris biaya adalah kejutan. Fable 5.2 lebih murah per token, tetapi menghabiskan sekitar empat kali lebih banyak token output pada tugas ini, sehingga run-nya hampir tiga kali lebih mahal dari Astra.
Claude Fable 5.2 dengan jelas memenangkan uji ini, dan kesenjangannya tepat seperti yang dikatakan kutipan Unity: adegan dengan kedalaman nyata dan cahaya yang berperilaku seperti cahaya. Adegan Fable terlihat seperti gim; Astra terlihat seperti ilustrasi yang disederhanakan dari sebuah gim.
Ini adalah satu run dari satu tugas pada satu pengaturan effort, dan uji yang berbeda dari simulasi fisika yang dimenangkan Astra melawan Fable 5.1, jadi ini lebih menggambarkan pembangunan adegan 3D daripada kedua model secara keseluruhan.
Kapan Memilih Claude Fable 5.2 vs GPT-6 Astra
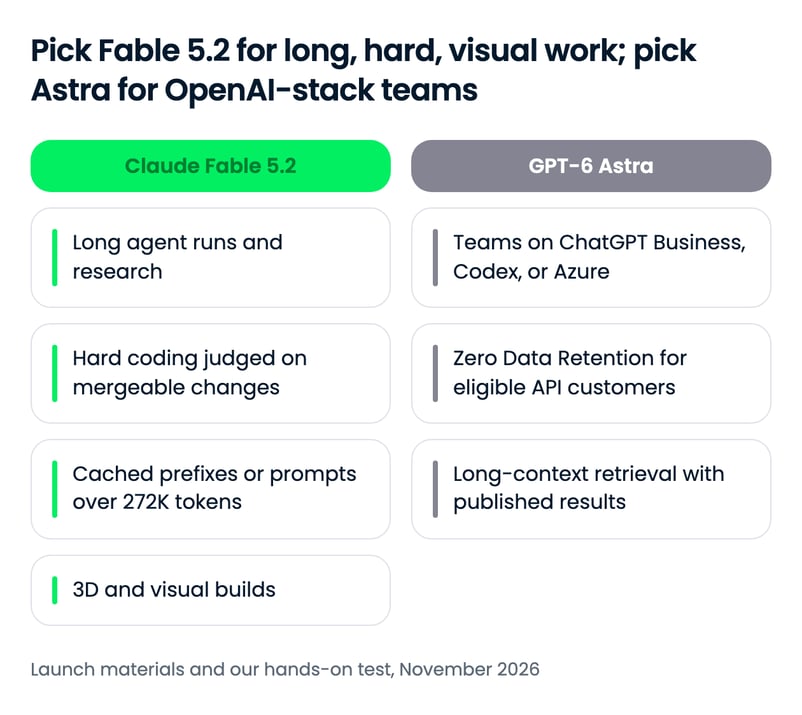
Untuk sebagian besar pekerjaan teknis, Fable 5.2 adalah pilihan yang lebih kuat dan lebih murah per token. Kasus untuk GPT-6 Astra bergantung pada tempat tim Anda sudah bekerja dan pada klaim yang telah dipublikasikan OpenAI yang belum dijawab Anthropic.
Pilih Claude Fable 5.2 jika...
- Agen Anda berjalan berjam-jam. Keunggulan Fable 5.2 paling lebar pada proyek multilangkah seperti Remote Labor Index, dan formalisasi Lean atas Teorema Terakhir Fermat oleh Anthropic menunjukkan model ini mampu menyelesaikan pekerjaan yang sangat panjang hingga tuntas.
- Anda butuh kode yang di-merge. Model ini memimpin pada kedua tolok ukur coding milik Anthropic, dan Anthropic mengatakan model ini mengalahkan skor FrontierCode terbaik Astra bahkan pada effort high.
- Prompt Anda di-cache atau sangat panjang. Pembacaan cache berbiaya seperlima dari tarif Astra, dan tidak ada biaya tambahan di atas 272K token.
- Anda membangun adegan 3D, gim, atau alat visual. Dalam uji shader saya, model ini menghasilkan satu-satunya adegan dengan kedalaman nyata dan pencahayaan yang menghormati geometri.
Pilih GPT-6 Astra jika...
- Tim Anda sudah bekerja di ChatGPT Business atau Enterprise, Codex, atau Azure. Astra termasuk dalam langganan tersebut, dan paket Pro, Business, dan Enterprise juga mendapatkan GPT-6 Astra Pro.
- Anda membutuhkan Zero Data Retention. Astra mendukungnya untuk pelanggan API yang memenuhi syarat, sementara Fable 5.2 mewajibkan retensi 30 hari kecuali Anda menyiapkan Enterprise Frontier Safeguards.
- Pekerjaan Anda bergantung pada pengambilan di dalam prompt sejuta token. OpenAI telah menerbitkan hasil pengambilan konteks panjang untuk Astra; Anthropic belum untuk Fable 5.2.
- Anda menjalankan banyak build pendek dengan anggaran terbatas. Dalam uji saya, Astra menghabiskan jauh lebih sedikit token dan selesai sekitar sepertiga biaya Fable, dengan hasil yang lebih lemah tetapi tetap dapat digunakan.
Cara Memulai dengan Claude Fable 5.2 dan GPT-6 Astra
Kedua model tersedia di API vendor masing-masing, tiga cloud besar, GitHub Copilot, dan OpenRouter.
| Surface | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Aplikasi konsumen | Aplikasi Claude, paket berbayar yang memenuhi syarat (termasuk Pro dan Team) | ChatGPT Plus, Pro, Business, Enterprise (nonaktif secara default untuk workspace Enterprise) |
| API pihak pertama | Claude Platform | OpenAI API |
| Platform cloud | AWS (Claude Platform on AWS, Amazon Bedrock), Google Cloud, Microsoft Azure | Microsoft Azure, Amazon Bedrock, Google Cloud |
| Agen coding | Claude Code, GitHub Copilot | Codex, GitHub Copilot |
| Router pihak ketiga | OpenRouter | OpenRouter |
| ID model API | claude-fable-5-2 | gpt-6-astra |
ID modelnya adalah claude-fable-5-2 pada Claude Platform dan gpt-6-astra pada OpenAI API.
Membuat panggilan API pertama Anda
Cara tercepat untuk mencoba keduanya adalah OpenRouter, di mana mengganti model hanya perubahan satu string pada klien yang kompatibel dengan OpenAI.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)Untuk SDK native, tutorial API GPT-6 Astra kami membangun agen lengkap, dan panduan Fable 5.2 kami membahas tingkat effort dan mode cepat.
Pikiran Terakhir
Claude Fable 5.2 adalah model yang lebih baik untuk sebagian besar pekerjaan teknis yang menuntut saat ini: model ini memimpin GPT-6 Astra pada setiap tolok ukur yang sama-sama diuji, biayanya lebih rendah per token, dan dengan jelas memenangkan uji praktik saya. Catatannya adalah bahwa Anthropic menyusun setiap angka head-to-head tersebut, dan klaim terkuat OpenAI pada matematika, penalaran abstrak, dan pengambilan sejuta token masih belum ada jawabannya dari Fable 5.2.
Yang paling menarik bagi saya adalah baris biaya dari uji saya. Fable 5.2 lebih murah per token namun tetap jauh lebih mahal dijalankan, karena ia berpikir dan menulis jauh lebih banyak. Jika Anda memindahkan beban kerja, ukur biaya per tugas, bukan per token.
Jika Anda ingin membangun dengan salah satu model, saya rekomendasikan kursus Introduction to Claude Models dan kursus Working with the OpenAI API kami.
FAQ
Apakah Claude Fable 5.2 lebih baik daripada GPT-6 Astra?
Pada tolok ukur yang menilai kedua model, ya. Tabel peluncuran Anthropic menempatkan Claude Fable 5.2 di depan GPT-6 Astra pada setiap baris yang sama, termasuk coding, penggunaan komputer, dan kerja pengetahuan berjangka panjang, dan Fable 5.2 juga memenangkan uji shader praktik kami. OpenAI belum menerbitkan perbandingan sendiri terhadap Fable 5.2, dan hasil Astra pada matematika, penalaran abstrak, serta pengambilan konteks panjang belum memiliki padanan Fable 5.2.
Berapa biaya Claude Fable 5.2 dan GPT-6 Astra?
Claude Fable 5.2 berharga $8 per sejuta token input dan $40 per sejuta token output. GPT-6 Astra berharga $10 dan $50. Pembacaan cache berharga $0,20 per sejuta token pada Fable 5.2 dan $1,00 pada Astra, dan Astra mengenakan 2x input dan 1,5x output untuk permintaan di atas 272K token input, sementara Fable 5.2 tidak mencantumkan biaya tambahan konteks panjang.
Mana yang lebih baik untuk coding, Claude Fable 5.2 atau GPT-6 Astra?
Claude Fable 5.2 memimpin pada kedua tolok ukur coding yang dilaporkan Anthropic untuk kedua model: 49,1% vs 42,8% pada FrontierCode 2.0 dan 69,9% vs 65,5% pada FrontierSWE v2. Skor tersebut berasal dari Anthropic, bukan OpenAI. Untuk tim yang sudah bekerja di Codex atau ChatGPT, GPT-6 Astra tetap menjadi pilihan yang lebih praktis.
Apa ID model API untuk Claude Fable 5.2 dan GPT-6 Astra?
Claude Fable 5.2 adalah claude-fable-5-2 pada Claude Platform, dan GPT-6 Astra adalah gpt-6-astra pada OpenAI API. Di OpenRouter, keduanya adalah anthropic/claude-fable-5.2 dan openai/gpt-6-astra.
Di mana saya bisa menggunakan Claude Fable 5.2 dan GPT-6 Astra?
Claude Fable 5.2 tersedia di aplikasi Claude dan Claude Code pada paket berbayar yang memenuhi syarat, serta di Claude Platform. GPT-6 Astra tersedia di ChatGPT Plus, Pro, Business, dan Enterprise, di OpenAI API, dan di Codex. Keduanya tersedia di Microsoft Azure, Amazon Bedrock, GitHub Copilot, dan Google Cloud.

Tom adalah Editor Data Science di DataCamp. Ia menulis dan menyunting tutorial AI, membandingkan rilis LLM terbaru, dan membangun alur kerja berbasis AI. Sebelumnya, ia bekerja di bidang data science di Deutsche Telekom. Di luar pekerjaan, ia membuat prediksi pertandingan sepak bola dengan pembelajaran mesin.


Anthropic merilis Claude Fable 5.2 pada 9 November 2026, dua bulan setelah OpenAI meluncurkan GPT-6 Astra sebagai "model paling cerdas dan paling selaras di dunia." Fable 5.2 hadir dengan penurunan harga dibanding Fable 5.1, dan tabel peluncuran Anthropic menempatkannya di depan Astra pada setiap baris yang mencantumkan keduanya. OpenAI belum menerbitkan perbandingan terhadap Fable 5.2 yang bisa kami temukan, sehingga pertanyaan jelas bagi siapa pun yang memilih model frontier adalah apakah angka-angka tersebut bertahan.
Dalam artikel ini, saya akan membandingkan Claude Fable 5.2 dan GPT-6 Astra dalam kerja pengetahuan berjangka panjang, coding, penggunaan komputer, pengaman, dan harga, lalu menjalankan satu tugas build praktik terhadap keduanya.
Untuk mengikuti perkembangan AI dan data, saya sarankan berlangganan buletin mingguan kami, The Median.
Ringkasnya
Apa itu Claude Fable 5.2?
Claude Fable 5.2 adalah model Anthropic untuk pekerjaan teknis yang paling menuntut, dirilis untuk semua pengguna pada November 2026 dan dibangun di atas model dasar yang sama dengan Claude Mythos 5.2, yang menghapus pengaman keamanan siber dan biologi Fable untuk organisasi terverifikasi.
Anthropic memposisikannya untuk pekerjaan teknis berjangka panjang yang paling ambisius, dan tetap merekomendasikan Claude Opus 5.5 sebagai default untuk tugas coding dan pengetahuan sehari-hari.
Panduan Claude Fable 5.2 dan Mythos 5.2 kami membahas peluncuran secara lengkap.
Apa itu GPT-6 Astra?
GPT-6 Astra adalah andalan frontier OpenAI, diluncurkan pada September 2026 sebagai penerus GPT-5.6 Sol.
OpenAI membangun pesannya di sekitar penggunaan komputer dan pekerjaan profesional, serta di sekitar tolok ukur seperti ARC-AGI-3 dan FrontierMath Tier 4 yang dirancang untuk selalu berada selangkah di depan model AI.
Panduan GPT-6 Astra kami membahas peluncurannya; tutorial API GPT-6 Astra kami memandu pembuatan agen pemeriksa rilis.
Claude Fable 5.2 vs GPT-6 Astra: Perbandingan Head-to-Head
Fable 5.2 memimpin pada setiap tolok ukur yang menilai keduanya, dari coding hingga penggunaan komputer, dan hanya pembacaan grafik yang mendekati seri. Kekurangannya adalah sumber: semua angka ini berasal dari tabel peluncuran Anthropic, karena tabel OpenAI sendiri lebih awal dari Fable 5.2.
Pekerjaan pengetahuan berjangka panjang dan riset
Keunggulan terbesar Fable 5.2 ada pada pekerjaan terbuka multilangkah. Pada Remote Labor Index, yang menilai proyek bergaya freelance nyata, Fable 5.2 menyelesaikan 41,3% dibanding 20,8% milik Astra, kira-kira dua kali lipat.
Pola ini bertahan di seluruh tabel: semakin sebuah tugas tampak seperti proyek panjang alih-alih satu jawaban, semakin lebar keunggulan Fable 5.2. Humanity's Last Exam tidak mengejutkan: tabel peluncuran OpenAI sendiri sudah menunjukkan Astra tertinggal dari Claude Fable 5.1 di sana.
Demo Anthropic sendiri mengarah ke hal yang sama. Fable 5.2 memformalkan pembuktian Teorema Terakhir Fermat di Lean dalam 30 jam dengan sekitar 1.000 agen, sebuah proyek yang membutuhkan 11 hari pada model riset internal sebelumnya.
Dua catatan sebelum Anda menganggap ini tuntas:
Fable 5.2 adalah model yang lebih kuat untuk proyek riset dan analisis yang panjang dan ambigu, dan margin yang besar membuat perbedaan harness saja kecil kemungkinannya menutup celah tersebut.
Coding dan alur kerja agentic
Fable 5.2 memimpin pada kedua tolok ukur coding yang dilaporkan Anthropic, meski tidak sebesar pada pekerjaan pengetahuan. Pada FrontierCode 2.0, yang menilai apakah maintainer open-source akan menggabungkan perubahan model, Fable 5.2 mencapai 49,1% pada effort xhigh dibanding 42,8% milik Astra.
Anthropic menambahkan bahwa Fable 5.2 pada effort high mengalahkan skor FrontierCode terbaik Astra dengan biaya per tugas yang kira-kira sama. Tabel coding OpenAI sendiri menggunakan versi tolok ukur yang lebih lama dan membandingkan Astra dengan Fable 5.1, sehingga belum ada cek dari sisi OpenAI. Berdasarkan bukti yang tersedia, Fable 5.2 adalah model coding yang lebih baik.
Penggunaan komputer, visi, dan robotika
Fable 5.2 memimpin pada penggunaan komputer dan robotika, sementara pembacaan grafik nyaris seri. Robotika menjadi pengecualian: pada RoboDojo Sim, robot dua lengan simulasi, Fable 5.2 mencetak 64,9% dibanding 29,8% milik Astra.
OpenAI menyebut Astra "model penggunaan komputer terbaik di dunia," tetapi klaim itu dibuat melawan Claude Fable 5.1 dan Claude Opus 5 pada OSWorld 2.0. Pada versi yang lebih baru dari Anthropic, Fable 5.2 memimpin.
Matematika, penalaran abstrak, dan konteks panjang: klaim Astra yang belum terjawab
Hasil peluncuran terkuat Astra berada pada tolok ukur yang tidak dilaporkan Anthropic untuk Fable 5.2, jadi tidak ada head-to-head di sini, hanya klaim dari satu sisi. Yang paling jelas adalah pengambilan konteks panjang: Astra mencetak 96,3% pada uji MRCR v2 8-needle OpenAI di rentang 512K hingga 1M token.
OpenAI juga melaporkan skor nyaris jenuh pada FrontierMath Tier 4 dan ARC-AGI-3, meski panduan GPT-6 Astra kami mencatat bahwa angka ARC-AGI-3 bergantung pada harness stateful yang tidak didapatkan panggilan API biasa. Jika pekerjaan Anda bergantung pada pengambilan kembali di dalam prompt sejuta token, Astra adalah satu-satunya dari keduanya yang memiliki bukti terbitan.
Pengaman dan retensi data
Kedua model memblokir pekerjaan keamanan siber ofensif secara default, dan mereka lebih berbeda pada retensi data daripada pada penolakan. Klasifier Fable 5.2 memblokir pengujian penetrasi, pembuatan eksploit, dan sebagian besar biologi tingkat riset, meski Anthropic mengatakan model ini menghasilkan lebih sedikit blokir yang tidak perlu daripada Fable 5.1; organisasi yang terverifikasi dapat mendaftar Claude Mythos 5.2 sebagai gantinya.
OpenAI menilai Astra pada ambang keamanan siber Critical dari Preparedness Framework dan membatasi pembuatan eksploit di balik program Daybreak. Astra mendukung Zero Data Retention untuk pelanggan API yang memenuhi syarat, sementara Fable 5.2 mewajibkan retensi 30 hari untuk pemantauan keselamatan kecuali perusahaan menggunakan Enterprise Frontier Safeguards milik Anthropic. Bagi tim teregulasi yang sudah bergantung pada tanpa retensi, Astra lebih mudah diadopsi.
Harga: yang benar-benar Anda bayar
Fable 5.2 lebih murah daripada GPT-6 Astra pada setiap tarif yang dipublikasikan kedua vendor, dan selisihnya tidak seragam. Astra berbiaya 1,25x untuk input, output, dan penulisan cache, tetapi 5x untuk pembacaan cache, dan hanya Astra yang menambahkan biaya tambahan konteks panjang.
Pada beban kerja seimbang biasa, perbedaannya moderat. Ini menjadi faktor penentu ketika prompt di-cache atau berjalan melewati 272K token.
Tarif token berdampingan
Kedua vendor mencantumkan tarif standar per sejuta token, plus harga cache, batch, dan mode cepat.
Tarif pembacaan cache adalah baris yang paling terasa oleh banyak tim, karena loop agen mengirim ulang prefiks panjang yang sama pada setiap langkah.
Biaya beban kerja nyata
Setiap baris di bawah ini adalah volume bulanan, dihitung sebagai (volume ÷ 1M) × tarif, dijumlahkan antara input dan output.
Tidak ada vendor yang telah menerbitkan jumlah token untuk beban kerja bersama, jadi perlakukan total ini sebagai perbandingan tarif, bukan tagihan. Run praktik saya di bawah ini mengingatkan alasannya: di sana, model yang lebih murah per token justru run-nya lebih mahal.
Performa Claude Fable 5.2 dan GPT-6 Astra
Tolok ukur dari posting peluncuran satu vendor hanya sejauh itu nilainya, jadi saya menjalankan satu tugas build terhadap kedua model dengan prompt dan tooling yang identik.
Tugasnya: satu halaman HTML dengan GLSL fragment shader animasi layar penuh tentang mercusuar di pantai berbatu saat badai malam, dengan gelombang bergulung yang pecah di bebatuan, hujan miring, dan awan rendah yang diterangi dari bawah. Sinar mercusuar harus mengikuti mouse dan menerangi gelombang, hujan, dan awan yang dilaluinya. p5.js hanya boleh menjadi host kanvas, menjalankan loop, dan memasukkan posisi mouse serta waktu ke shader.
Prompt lengkap:
Yang membuatnya sulit:
Posting peluncuran Anthropic mengutip Sam Zhang dari Unity yang mengatakan peningkatan paling jelas Fable 5.2 ada pada "membangun adegan 3D berkualitas lebih tinggi dari nol," jadi ini adalah uji langsung atas klaim itu. Ini juga semacam pertandingan ulang: dalam perbandingan GPT-6 Astra vs Claude Fable 5.1 kami, Astra memenangkan uji simulasi fisika melawan Fable sebelumnya.
Kedua model dijalankan di OpenCode dengan permukaan tool yang dipaku (hanya baca dan edit file), pada reasoning effort
high, satu percobaan masing-masing, di sesi baru, dengan prompt dikirim byte-per-byte.Berikut rekaman layar halaman keduanya, menggerakkan mouse melintasi adegan. Fable lebih dulu: