
De viktigaste resultaten:
- Båda skrev en genuin shader. Varje sida beräknar hela scenen i en GLSL-fragmentshader, med p5.js som endast värdar canvasen och skickar in mus och tid.
- Fable 5.2 byggde djup; Astra byggde en bild. Fables vågor, klippor och fyr läses som 3D, med känslan av ett något äldre PlayStation-spel – på ett bra sätt. Astras scen är tydligt igenkännbar, men mycket platt, och fyren ser ut som en förenklad målning.
- Endast Fable 5.2:s stråle respekterar scenen. När Fables stråle sveper bakom ett element förblir det mörkt. Astras stråle svarar på musen, men mindre exakt.
- Fable 5.2 tog stormen på allvar. Den har kraftigt regn, starka vågor och blixtar i bakgrunden. Astra har övertygande regn och generellt bra vågor, men inga blixtar, ett lugnt hav, märkligt utseende på klipporna och vågor nära stranden som ser ut att avdunsta.
Jag betygsatte båda på om sidan liknar den beskrivna scenen, kvaliteten på shaderarbetet, hur väl strålen följer markören, och om effekten är en riktig fragmentshader. Båda fick full pott på den sista axeln; raderna där de skiljer sig:
| Mått | Claude Fable 5.2 (high) | GPT-6 Astra (high) |
|---|---|---|
| Kostnad för denna körning (USD) | $4.91 | $1.75 |
| Utdataton (inkl. resonemang) | 95 683 | 22 934 |
| Estetisk träffsäkerhet (primär skiljelinje) | 5 | 3 |
| Shaderkompetens | 5 | 4 |
| Interaktivitet med markör | 5 | 4 |
| Rubricpoäng (medel av fyra axlar) | 5,0 | 3,7 |
Kostnadsraden är överraskningen. Fable 5.2 är billigare per token, men spenderade cirka fyra gånger så många utdataton på denna uppgift, så körningen kostade nästan tre gånger så mycket som Astras.
Claude Fable 5.2 vinner detta test tydligt, och gapet hamnar precis där Unity-citatet sa att det skulle: en scen med verkligt djup och ett ljus som beter sig som ljus. Fables scen ser ut som ett spel; Astras ser ut som en förenklad illustration av ett.
Detta är en körning av en uppgift vid en ansträngningsnivå, och ett annat test än fysiksimuleringen som Astra vann mot Fable 5.1, så det säger mer om 3D-scenskapande än om de två modellerna generellt.
När du ska välja Claude Fable 5.2 vs GPT-6 Astra
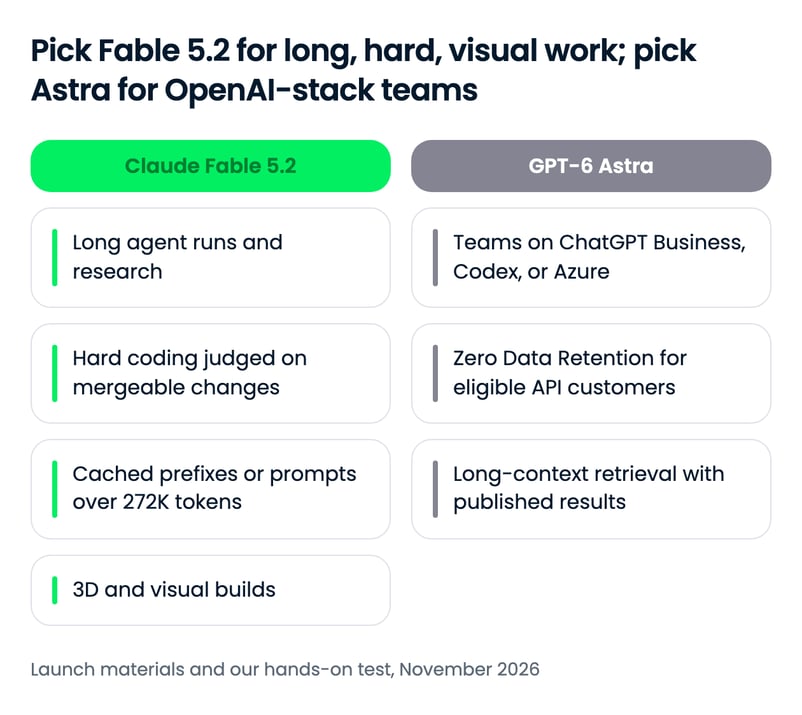
För de flesta tekniska arbeten är Fable 5.2 det starkare och billigare valet per token. Fallet för GPT-6 Astra vilar på var ditt team redan arbetar och på de påståenden OpenAI har publicerat som Anthropic ännu inte har besvarat.
Välj Claude Fable 5.2 om…
- Dina agenter kör i timmar. Fable 5.2:s ledningar är störst på flerstegsprojekt som Remote Labor Index, och Anthropics Lean-formalisering av Fermats sista sats visar att den orkar hela vägen i ett mycket långt jobb.
- Du behöver kod som blir ihopslagen. Den leder båda Anthropics kodningsbenchmarks, och Anthropic säger att den slår Astras bästa FrontierCode-poäng även på high-effort.
- Dina promptar är cache:ade eller mycket långa. Cache-läsningar kostar en femtedel av Astras taxa, och det finns inget påslag över 272K token.
- Du bygger 3D-scener, spel eller visuella verktyg. I mitt shadertest producerade den den enda scenen med verkligt djup och belysning som respekterar geometrin.
Välj GPT-6 Astra om…
- Ditt team arbetar redan i ChatGPT Business eller Enterprise, Codex eller Azure. Astra ingår i dessa abonnemang, och Pro-, Business- och Enterprise-planer får också GPT-6 Astra Pro.
- Du behöver Zero Data Retention. Astra stöder det för berättigade API-kunder, medan Fable 5.2 kräver 30 dagars lagring om du inte sätter upp Enterprise Frontier Safeguards.
- Ditt arbete beror på återhämtning över en prompt med en miljon token. OpenAI har publicerat resultat för långkontextåterhämtning för Astra; Anthropic har inte gjort det för Fable 5.2.
- Du kör många korta byggen med begränsad budget. I mitt test förbrukade Astra betydligt färre token och blev klar för ungefär en tredjedel av Fables kostnad, med ett svagare men användbart resultat.
Så kommer du igång med Claude Fable 5.2 och GPT-6 Astra
Båda modellerna finns på sina leverantörers API, de tre stora molnen, GitHub Copilot och OpenRouter.
| Yta | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Konsumentapp | Claude-appar, berättigade betalda planer (inklusive Pro och Team) | ChatGPT Plus, Pro, Business, Enterprise (av som standard för Enterprise-arbetsytor) |
| Förstapart-API | Claude Platform | OpenAI API |
| Molnplattformar | AWS (Claude Platform på AWS, Amazon Bedrock), Google Cloud, Microsoft Azure | Microsoft Azure, Amazon Bedrock, Google Cloud |
| Kodningsagenter | Claude Code, GitHub Copilot | Codex, GitHub Copilot |
| Tredjepartsroutrar | OpenRouter | OpenRouter |
| API-modell-ID | claude-fable-5-2 | gpt-6-astra |
Modell-ID:na är claude-fable-5-2 på Claude Platform och gpt-6-astra på OpenAI API.
Göra ditt första API-anrop
Det snabbaste sättet att prova båda är OpenRouter, där byte av modell är en strängändring i en OpenAI-kompatibel klient.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)För de inhemska SDK:erna bygger vår API-handledning för GPT-6 Astra en fullständig agent, och vår Fable 5.2-guide täcker ansträngningsnivåer och snabbläge.
Avslutande tankar
Claude Fable 5.2 är den bättre modellen för de flesta krävande tekniska arbeten just nu: den leder GPT-6 Astra på varje benchmark de två delar, kostar mindre per token och vann mitt praktiska test tydligt. Förbehållet är att Anthropic ligger bakom varenda en av dessa head-to-head-siffror, och OpenAIs starkaste påståenden inom matte, abstrakt resonemang och återhämtning över en miljon token saknar fortfarande ett svar från Fable 5.2.
Det jag tycker är mest intressant är kostnadsraden från mitt test. Fable 5.2 är billigare per token och blev ändå betydligt dyrare i drift, eftersom den tänkte och skrev så mycket mer. Om du flyttar arbetsbelastningar, mät kostnad per uppgift, inte per token.
Om du är sugen på att bygga med någon av modellerna rekommenderar jag vår kurs Introduction to Claude Models och vår kurs Working with the OpenAI API.
Vanliga frågor
Är Claude Fable 5.2 bättre än GPT-6 Astra?
På de benchmarktester som betygsätter båda modellerna, ja. Anthropics lanseringstabell placerar Claude Fable 5.2 före GPT-6 Astra på varje delad rad, inklusive kodning, datoranvändning och långsiktigt kunskapsarbete, och Fable 5.2 vann också vårt praktiska shadertest. OpenAI har inte publicerat sin egen jämförelse mot Fable 5.2, och Astras resultat för matte, abstrakt resonemang och långkontextåterhämtning har ännu ingen motsvarighet för Fable 5.2.
Hur mycket kostar Claude Fable 5.2 och GPT-6 Astra?
Claude Fable 5.2 kostar $8 per miljon indatatoken och $40 per miljon utdataton. GPT-6 Astra kostar $10 respektive $50. Cache-läsningar kostar $0,20 per miljon token på Fable 5.2 och $1,00 på Astra, och Astra tar 2x indata och 1,5x utdata för förfrågningar över 272K indatatoken, medan Fable 5.2 inte listar något påslag för lång kontext.
Vilken är bäst för kodning, Claude Fable 5.2 eller GPT-6 Astra?
Claude Fable 5.2 leder på båda kodningsbenchmarks som Anthropic rapporterar för de två modellerna: 49,1% vs 42,8% på FrontierCode 2.0 och 69,9% vs 65,5% på FrontierSWE v2. Dessa poäng kommer från Anthropic, inte OpenAI. För team som redan arbetar i Codex eller ChatGPT förblir GPT-6 Astra det bekvämare valet.
Vad är API-modell-ID:na för Claude Fable 5.2 och GPT-6 Astra?
Claude Fable 5.2 är claude-fable-5-2 på Claude Platform, och GPT-6 Astra är gpt-6-astra på OpenAI API. På OpenRouter är de anthropic/claude-fable-5.2 och openai/gpt-6-astra.
Var kan jag använda Claude Fable 5.2 och GPT-6 Astra?
Claude Fable 5.2 finns i Claude-apparna och Claude Code på berättigade betalda planer, och på Claude Platform. GPT-6 Astra finns i ChatGPT Plus, Pro, Business och Enterprise, på OpenAI API och i Codex. Båda finns på Microsoft Azure, Amazon Bedrock, GitHub Copilot och Google Cloud.

Tom är redaktör inom data science på DataCamp. Han skriver och redigerar AI-handledningar, jämför nya LLM-släpp och bygger AI-drivna arbetsflöden. Tidigare arbetade han med data science på Deutsche Telekom. Utanför jobbet förutspår han fotbollsmatcher med maskininlärning.
Anthropic släppte Claude Fable 5.2 den 9 november 2026, två månader efter att OpenAI lanserade GPT-6 Astra som ”världens mest intelligenta och alignade modell”. Fable 5.2 kommer med en prissänkning jämfört med Fable 5.1, och Anthropics lanseringstabell placerar den före Astra på varje rad där båda modellerna finns med. OpenAI har inte publicerat en jämförelse mot Fable 5.2 som vi kunnat hitta, så den självklara frågan för alla som väljer en toppmodell är om siffrorna håller.
I den här artikeln jämför jag Claude Fable 5.2 och GPT-6 Astra inom långsiktigt kunskapsarbete, kodning, datoranvändning, skyddsmekanismer och prissättning, och kör sedan ett praktiskt byg guppdrag mot båda.
För att hänga med i AI- och datautvecklingen rekommenderar jag att du prenumererar på vårt veckobrev, The Median.
TL;DR
Vad är Claude Fable 5.2?
Claude Fable 5.2 är Anthropics modell för dess mest krävande tekniska arbete, släppt till alla användare i november 2026 och byggd på samma underliggande modell som Claude Mythos 5.2, som tar bort Fables skydd för cybersäkerhet och biologi för granskade organisationer.
Anthropic positionerar den för de mest ambitiösa tekniska arbetena med lång horisont, och rekommenderar fortfarande Claude Opus 5.5 som standard för vardagliga kod- och kunskapsuppgifter.
Vår guide till Claude Fable 5.2 och Mythos 5.2 täcker lanseringen i sin helhet.
Vad är GPT-6 Astra?
GPT-6 Astra är OpenAIs toppmodell, lanserad i september 2026 som efterföljare till GPT-5.6 Sol.
OpenAI byggde sitt erbjudande kring datoranvändning och professionellt arbete, samt kring att mätta benchmarktester som ARC-AGI-3 och FrontierMath Tier 4 som var designade för att ligga före AI-modeller.
Vår guide till GPT-6 Astra täcker lanseringen; vår API-handledning för GPT-6 Astra går igenom hur du bygger en releasekontroll-agent.
Claude Fable 5.2 vs GPT-6 Astra: Jämförelse head-to-head
Fable 5.2 leder på varje benchmark som betygsätter båda modellerna, från kodning till datoranvändning, och endast diagramläsning ligger nära oavgjort. Haken är källan: alla siffror kommer från Anthropics lanseringstabell, eftersom OpenAIs egen tabell är äldre än Fable 5.2.
Långsiktigt kunskapsarbete och forskning
Fable 5.2:s största ledning finns i öppna, flerstegsuppgifter. På Remote Labor Index, som bedömer verkliga uppdrag i frilansstil, slutför Fable 5.2 41,3% mot Astras 20,8%, ungefär dubbelt.
Mönstret håller över hela tabellen: ju mer en uppgift liknar ett långt projekt snarare än ett enskilt svar, desto större blir Fable 5.2:s ledning. Humanity's Last Exam är ingen överraskning: OpenAIs egen lanseringstabell visade redan att Astra låg efter Claude Fable 5.1 där.
Anthropics egen showcase pekar åt samma håll. Fable 5.2 formaliserade beviset för Fermats sista sats i Lean på 30 timmar med cirka 1 000 agenter, ett projekt som en tidigare intern forskningsmodell behövde 11 dagar för.
Två förbehåll innan du betraktar detta som avgjort:
Fable 5.2 är den starkare modellen för långa, otydliga forsknings- och analysprojekt, och marginalerna är så stora att enbart skillnader i testharnesk sannolikt inte stänger gapet.
Kodning och agentiska arbetsflöden
Fable 5.2 leder båda kodningsbenchmarks som Anthropic rapporterar, om än med mindre marginaler än inom kunskapsarbete. På FrontierCode 2.0, som bedömer om open-source-maintainers skulle slå ihop en modells ändringar, når Fable 5.2 49,1% på xhigh-effort mot Astras 42,8%.
Anthropic tillägger att Fable 5.2 på high-effort slår Astras bästa FrontierCode-resultat till ungefär samma kostnad per uppgift. OpenAIs egen kodningstabell använder äldre benchmarkversioner och jämför Astra mot Fable 5.1, så det finns ännu ingen OpenAI-kontroll mot 5.2. Fable 5.2 är den bättre kodningsmodellen utifrån tillgängliga bevis.
Datoranvändning, vision och robotik
Fable 5.2 leder inom datoranvändning och robotik, medan diagramläsning ligger nära oavgjort. Robotik är avvikelsen: på RoboDojo Sim, en simulerad tvåarmad robot, får Fable 5.2 64,9% mot Astras 29,8%.
OpenAI kallade Astra ”världens bästa modell för datoranvändning”, men det påståendet gjordes mot Claude Fable 5.1 och Claude Opus 5 på OSWorld 2.0. På Anthropics nyare version tar Fable 5.2 ledningen.
Matematik, abstrakt resonemang och lång kontext: Astras obesvarade anspråk
Astras starkaste lanseringsresultat ligger på benchmarks som Anthropic inte rapporterade för Fable 5.2, så här finns ingen head-to-head, bara ensidiga påståenden. Det tydligaste är långkontextåterhämtning: Astra får 96,3% på OpenAIs MRCR v2 8-needle-test i intervallet 512K till 1M token.
OpenAI rapporterar också nästintill mättade resultat på FrontierMath Tier 4 och ARC-AGI-3, även om vår guide till GPT-6 Astra noterar att ARC-AGI-3-siffran beror på ett stateful harnesk som rena API-anrop inte får. Om ditt arbete hänger på återhämtning över en prompt på en miljon token är Astra den enda av de två med publicerade bevis.
Skyddsmekanismer och datalagring
Båda modellerna blockerar stötande cybersäkerhetsarbete som standard, och de skiljer sig mer i datalagring än i vägranden. Fable 5.2:s klassificerare blockerar penetrationstester, exploatsgenerering och de flesta forskningsnivåer inom biologi, men Anthropic säger att den gör färre onödiga blockeringar än Fable 5.1; granskade organisationer kan i stället ansöka om Claude Mythos 5.2.
OpenAI klassar Astra på den Kritiska cybersäkerhetsnivån i sitt Preparedness Framework och låser exploatskapande bakom Daybreak-programmet. Astra stöder Zero Data Retention för berättigade API-kunder, medan Fable 5.2 kräver 30 dagars lagring för säkerhetsövervakning om inte ett företag använder Anthropics Enterprise Frontier Safeguards. För reglerade team som redan förlitar sig på noll lagring är Astra lättare att passa in.
Priser: vad du faktiskt betalar
Fable 5.2 är billigare än GPT-6 Astra på varje taxa som båda leverantörerna publicerar, och gapet är inte jämnt. Astra kostar 1,25x så mycket för indata, utdata och cache-skrivningar, men 5x så mycket för cache-läsningar, och bara Astra lägger till ett påslag för lång kontext.
Vid en enkel balanserad arbetsbelastning är skillnaden måttlig. Den blir avgörande när promptar cache:as eller körs över 272K token.
Tokenpriser sida vid sida
Båda leverantörerna listar standardtaxor per miljon token, plus cache-, batch- och snabb-läge-priser.
Taxan för cache-läsning är raden som de flesta team kommer att märka, eftersom agentloopar skickar om samma långa prefix vid varje steg.
Vad en verklig arbetsbelastning kostar
Varje rad nedan är en månatlig volym, prissatt som (volym ÷ 1M) × taxa, summerat över in- och utdata.
Ingen av leverantörerna har publicerat tokenantal för en delad arbetsbelastning, så betrakta dessa totalsummor som en ratajämförelse snarare än en faktura. Min praktiska körning nedan påminner om varför: där blev den billigare modellen per token det dyrare körningen.
Hur Claude Fable 5.2 och GPT-6 Astra presterade
Benchmarktester från en leverantörs lanseringsinlägg räcker bara så långt, så jag körde ett bygguppdrag mot båda modellerna med identisk prompt och identiska verktyg.
Uppgiften: en enda HTML-sida med en helfönsteranimerad GLSL-fragmentshader av en fyr på en klippig kust under en nattstorm, med rullande vågor som bryter mot klipporna, snedställt regn och låga moln upplysta underifrån. Fyrens ljusstråle skulle följa musen och lysa upp de vågor, regndroppar och moln den sveper över. p5.js fick endast vara värd för canvasen, köra loopen och föra in musposition och tid i shadern.
Hela prompten:
Vad som gör det svårt:
Anthropics lanseringsinlägg citerar Unitys Sam Zhang som säger att Fable 5.2:s tydligaste förbättringar finns i ”att bygga 3D-scener av högre kvalitet från grunden”, så detta är ett direkt test av det påståendet. Det är också en sorts returmatch: i vår jämförelse mellan GPT-6 Astra och Claude Fable 5.1 vann Astra ett fysiksimulationstest mot föregående Fable.
Båda modellerna kördes i OpenCode med en låst verktygsyta (endast fil-läs och -redigera), på
highreasoning effort, ett försök var, i en ny session, med prompten levererad byte för byte.Här är mina skärminspelningar av båda sidorna, när jag rör musen över scenen. Fable först: