
主な所見:
- どちらも本物のシェーダーを書いた。 それぞれのページは、p5.js がキャンバスのホストとマウス・時刻の受け渡しのみを担い、シーン全体を GLSL フラグメントシェーダーで計算している。
- Fable 5.2 は奥行きを作り、Astra は絵を作った。 Fable の波・岩・灯台は 3D として読め、良い意味で少し古い PlayStation のゲームのような雰囲気。Astra のシーンは分かりやすいが平板で、灯台は簡略化しすぎたペイント画のよう。
- 光がシーンを尊重しているのは Fable 5.2 だけ。 Fable のビームが要素の背後を通ると、その要素は暗いまま。Astra のビームもマウスには反応するが精度が劣る。
- Fable 5.2 は嵐をやり切った。 激しい雨、強い波、背景の稲光。Astra は雨は説得力があり波も概ね良いが、稲光はなく海は穏やかで、岩は不自然、岸辺の波は蒸発しているように見える。
評価は、描画が要件のシーンに見えるか、シェーダーの出来、ビームのカーソル追従性、フラグメントシェーダーとしての実装の 4 軸で採点。最後の軸は両者満点。差が出た行は以下:
| 指標 | Claude Fable 5.2(high) | GPT-6 Astra(high) |
|---|---|---|
| 今回実行のコスト(USD) | $4.91 | $1.75 |
| 出力トークン(推論含む) | 95,683 | 22,934 |
| 審美的一致度(主判定軸) | 5 | 3 |
| シェーダーの習熟度 | 5 | 4 |
| カーソルとのインタラクション | 5 | 4 |
| ルーブリックスコア(4 軸平均) | 5.0 | 3.7 |
コストが意外でした。Fable 5.2 はトークン単価が安いのに、今回のタスクでは出力トークンが約 4 倍で、実行コストは Astra のほぼ 3 倍になりました。
このテストでは Claude Fable 5.2 の明確な勝利です。差が出たのは Unity の引用どおり、実在感のある奥行きと、光が幾何に従う振る舞い。Fable のシーンはゲームらしく、Astra のシーンはその簡略イラストという印象。
もっとも、これは effort 設定を揃えた単一タスクの単回実行で、Fable 5.1 相手に Astra が勝った物理シミュレーションとは別種の試験です。主に 3D シーン構築の適性を示す結果と捉えるべきでしょう。
Claude Fable 5.2 と GPT-6 Astra の選び方
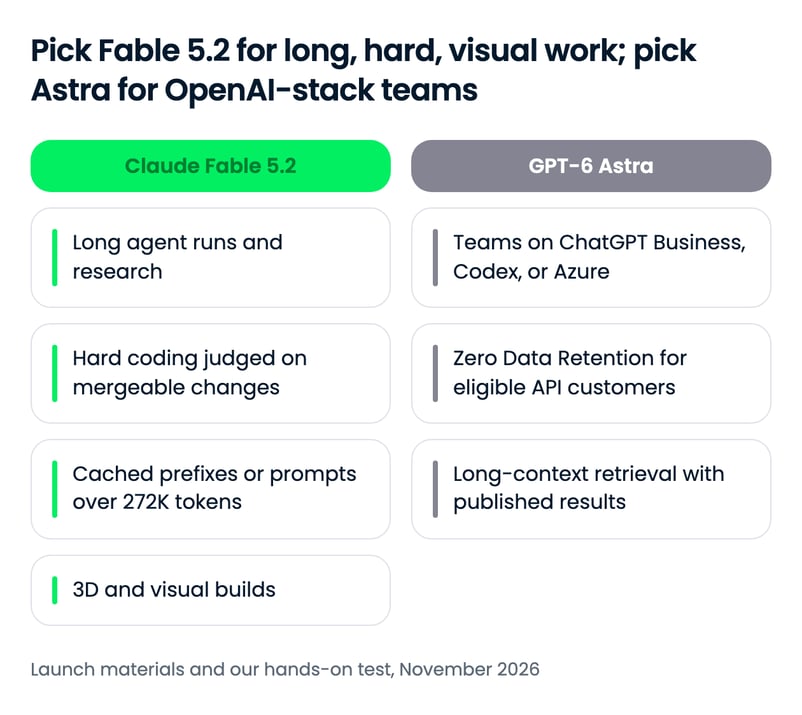
大半の技術作業では、Fable 5.2 がより強力でトークン単価も安価です。GPT-6 Astra を選ぶ根拠は、チームの既存環境と、Anthropic が未回答の OpenAI の主張にあります。
Claude Fable 5.2 を選ぶなら...
- エージェントが数時間走る。 Fable 5.2 は Remote Labor Index のような多段プロジェクトで差が最も大きく、Fermat の最終定理の Lean 形式化でも非常に長いジョブを完走しています。
- マージされるコードが必要。 Anthropic の 2 つのコーディング系ベンチマークでリードし、high でも Astra の FrontierCode のベストを上回るとされます。
- プロンプトをキャッシュする、または非常に長い。 キャッシュ読み出しは Astra の 5 分の 1、27.2 万トークン超でもサーチャージなし。
- 3D シーン、ゲーム、ビジュアルツールを作る。 シェーダーテストでは、奥行きがあり、幾何を尊重するライティングを唯一実現しました。
GPT-6 Astra を選ぶなら...
- ChatGPT Business/Enterprise、Codex、Azure を既に使っている。 それらのサブスクリプションに Astra が含まれ、Pro、Business、Enterprise は GPT-6 Astra Pro も利用可能。
- Zero Data Retention が必要。 Astra は適格な API 顧客に提供。Fable 5.2 は Enterprise Frontier Safeguards を構成しない限り 30 日保持が必要。
- 100 万トークン級プロンプトでのリトリーバルが業務の要。 OpenAI は Astra の長文リトリーバル結果を公開、Anthropic は Fable 5.2 では未公表。
- 短いビルドを多数、低予算で回す。 今回のテストでは、Astra は消費トークンが大幅に少なく、Fable の 3 分の 1 程度の費用で完了(品質はやや劣るが実用的)。
Claude Fable 5.2 と GPT-6 Astra の始め方
両モデルとも、各社 API、主要 3 クラウド、GitHub Copilot、OpenRouter で利用可能です。
| 提供面 | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| コンシューマーアプリ | Claude アプリ(対象の有料プラン:Pro、Team 含む) | ChatGPT Plus、Pro、Business、Enterprise(Enterprise ワークスペースではデフォルト無効) |
| ファーストパーティ API | Claude Platform | OpenAI API |
| クラウドプラットフォーム | AWS(Claude Platform on AWS、Amazon Bedrock)、Google Cloud、Microsoft Azure | Microsoft Azure、Amazon Bedrock、Google Cloud |
| コーディングエージェント | Claude Code、GitHub Copilot | Codex、GitHub Copilot |
| サードパーティルーター | OpenRouter | OpenRouter |
| API モデル ID | claude-fable-5-2 | gpt-6-astra |
モデル ID は、Claude Platform では claude-fable-5-2、OpenAI API では gpt-6-astra です。
最初の API コール
最も手早いのは OpenRouter。OpenAI 互換クライアントでモデル名の文字列を 1 箇所差し替えるだけで切り替えられます。
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)各社のネイティブ SDK については、GPT-6 Astra API チュートリアルでフルのエージェントを、Fable 5.2 ガイドで Effort レベルとファストモードを解説しています。
まとめ
現時点で、要求の厳しい技術作業には Claude Fable 5.2 が有利です。共有ベンチマークのすべてで GPT-6 Astra を上回り、トークン単価も安く、ハンズオンテストでも明確に勝ちました。ただし、これらの対決スコアはすべて Anthropic が提示したもので、OpenAI の数学・抽象推論・100 万トークン級リトリーバルに関する強い主張には、Fable 5.2 側の回答がまだありません。
個人的に興味深いのは、テストの「コスト」の行です。Fable 5.2 はトークン単価が安いのに、思考と出力が多く、結果として実行コストが高くなりました。ワークロードを移す場合は、トークン単価ではなくタスクあたりのコストで計測してください。
どちらのモデルでも開発を進めたい方には、Introduction to Claude Models と Working with the OpenAI API の各コースをおすすめします。
FAQs
Claude Fable 5.2 は GPT-6 Astra より優れていますか?
両モデルにスコアがあるベンチマークでは、はい。Anthropic の発表表では、Claude Fable 5.2 はコーディング、コンピュータ操作、長期的な知的労働など、共有されるすべての行で GPT-6 Astra を上回り、ハンズオンのシェーダーテストでも Fable 5.2 が勝ちました。OpenAI は Fable 5.2 との比較を公開しておらず、Astra の数学・抽象推論・長文リトリーバルの結果には、Fable 5.2 側の対抗データがまだありません。
Claude Fable 5.2 と GPT-6 Astra の価格は?
Claude Fable 5.2 は入力 100 万トークンあたり $8、出力 100 万トークンあたり $40。GPT-6 Astra はそれぞれ $10 と $50。キャッシュ読み出しは Fable 5.2 が 100 万トークンあたり $0.20、Astra は $1.00。さらに Astra は入力 27.2 万トークン超のリクエストで、入力とキャッシュが 2 倍、出力が 1.5 倍のサーチャージがかかります。Fable 5.2 は長文サーチャージの記載がありません。
コーディングには Claude Fable 5.2 と GPT-6 Astra のどちらが適していますか?
Anthropic が両モデルに対して報告している 2 つのコーディング系ベンチマークでは、いずれも Claude Fable 5.2 がリードしています。FrontierCode 2.0 は 49.1% 対 42.8%、FrontierSWE v2 は 69.9% 対 65.5%。これらのスコアは Anthropic 側の実行によるもので、OpenAI 側の検証は未提示です。既に Codex や ChatGPT を使っているチームにとっては、利便性の観点で GPT-6 Astra が引き続き有力です。
Claude Fable 5.2 と GPT-6 Astra の API モデル ID は?
Claude Fable 5.2 の API モデル ID は Claude Platform で claude-fable-5-2、GPT-6 Astra は OpenAI API で gpt-6-astra。OpenRouter ではそれぞれ anthropic/claude-fable-5.2 と openai/gpt-6-astra です。
Claude Fable 5.2 と GPT-6 Astra はどこで使えますか?
Claude Fable 5.2 は、対象の有料プランの Claude アプリおよび Claude Code、ならびに Claude Platform で利用可能です。GPT-6 Astra は ChatGPT Plus、Pro、Business、Enterprise、OpenAI API、Codex で利用可能。両者とも Microsoft Azure、Amazon Bedrock、GitHub Copilot、Google Cloud で利用できます。

TomはDataCampのデータサイエンス編集者です。AIチュートリアルの執筆・編集、新しいLLMリリースの比較、AIを活用したワークフローの構築を担当しています。以前はDeutsche Telekomでデータサイエンスに携わっていました。仕事以外では、機械学習を使ってサッカーの試合結果を予測しています。
Anthropic は 2026 年 11 月 9 日に Claude Fable 5.2 をリリースしました。これは、OpenAI が GPT-6 Astra を「世界で最も高性能でアラインしたモデル」として発表してから 2 か月後のことです。Fable 5.2 は Fable 5.1 から値下げされており、Anthropic の発表資料では、両モデルが並ぶすべての行で Astra を上回っています。OpenAI は(少なくとも確認できる限りでは)Fable 5.2 との比較を公開していないため、最前線モデルを選ぶうえで当然浮かぶ疑問は、その数値が実際に妥当かどうかです。
本記事では、長期的な知的労働、コーディング、コンピュータ操作、セーフガード、価格という観点で Claude Fable 5.2 と GPT-6 Astra を比較し、最後に両モデルで同じビルド課題を実施します。
AI とデータ分野の最新情報を追うなら、週刊ニュースレター The Median の購読をおすすめします。
要点
Claude Fable 5.2 とは?
Claude Fable 5.2 は、Anthropic が最も高度な技術作業向けに提供するモデルで、2026 年 11 月に全ユーザーへ公開されました。Claude Mythos 5.2 と同じ基盤モデル上に構築されています。Mythos は審査済み組織向けに、Fable のサイバーセキュリティおよび生物学に関するセーフガードを外しています。
Anthropic は、もっとも野心的な長期技術作業に向けたモデルとして位置づけつつ、日常的なコーディングや知識タスクには引き続き Claude Opus 5.5 を推奨しています。
詳細は Claude Fable 5.2 と Mythos 5.2 のガイドで総覧しています。
GPT-6 Astra とは?
GPT-6 Astra は OpenAI の最前線フラッグシップで、2026 年 9 月に GPT-5.6 Sol の後継として登場しました。
OpenAI は、コンピュータ操作とプロフェッショナル作業に的を絞り、AI モデルの先を行くことを目指して設計された ARC-AGI-3 や FrontierMath Tier 4 といったベンチマークの到達度を前面に打ち出しました。
GPT-6 Astra ガイドではローンチ全体を、GPT-6 Astra API チュートリアルではリリースチェック用エージェントの構築を解説しています。
Claude Fable 5.2 と GPT-6 Astra の比較
Fable 5.2 は、コーディングからコンピュータ操作まで、両モデルがスコアを持つすべてのベンチマークでリードしています。唯一、チャート読解はほぼ互角。ただし発表元に注意が必要です。これらの数値はすべて Anthropic のローンチ資料に基づき、OpenAI 側の資料は Fable 5.2 より前のものです。
長期的な知的労働とリサーチ
Fable 5.2 の最大のリードは、オープンエンドかつ多段の作業にあります。実際のフリーランス案件風タスクを評価する Remote Labor Index では、Fable 5.2 が 41.3%、Astra は 20.8% と、およそ 2 倍の差です。
表全体に同じ傾向が見られます。単発の解答というより長期プロジェクトに近いほど、Fable 5.2 のリードが広がります。Humanity's Last Exam については驚きではありません。OpenAI 自身のローンチ表でも、Astra はすでに Claude Fable 5.1 に遅れを取っていました。
Anthropic のショーケースも同じ方向性です。Fable 5.2 は、約 1000 のエージェントを用い、30 時間で Fermat の最終定理の証明を Lean で形式化しました。これは、以前の社内研究モデルが 11 日かかったプロジェクトです。
結論めいた扱いにする前に 2 点の注意:
長期で曖昧さのあるリサーチや分析では Fable 5.2 がより強力で、ハーネスの違いだけでこの差が埋まる可能性は低いと見ます。
コーディングとエージェントワークフロー
Fable 5.2 は、Anthropic が報告する 2 つのコーディング系ベンチマークでいずれもリード。ただし知的労働より差は小さめです。オープンソースのメンテナがモデルの変更をマージするかを問う FrontierCode 2.0 では、Fable 5.2(xhigh)が 49.1%、Astra は 42.8% です。
Anthropic は、Fable 5.2(high)が Astra の FrontierCode のベストスコアを、タスクあたりのコストがほぼ同等で上回ると補足しています。OpenAI 側のコーディング表は古いベンチマーク版を使い、比較相手も Fable 5.1 なので、OpenAI 側の照合はまだありません。現時点の証拠では Fable 5.2 がコーディングに優位です。
コンピュータ操作、ビジョン、ロボティクス
Fable 5.2 はコンピュータ操作とロボティクスでリードし、チャート読解はほぼ互角。特にロボティクスが目立ち、二腕ロボットのシミュレーションである RoboDojo Sim では、Fable 5.2 が 64.9%、Astra は 29.8% です。
OpenAI は Astra を「世界最高のコンピュータ操作モデル」と称しましたが、その主張は OSWorld 2.0 上での Claude Fable 5.1 と Claude Opus 5 との比較に基づくものです。Anthropic の新バージョンでは Fable 5.2 がリードしています。
数学、抽象推論、長文文脈:Astra の未検証主張
Astra の強力なローンチ結果の多くは、Anthropic が Fable 5.2 で未報告のベンチマークにあります。したがって、ここは片側の主張のみ。最も明確なのは長文コンテキスト検索で、Astra は OpenAI の MRCR v2 8-needle テストの 512K〜100 万トークン帯で 96.3% を記録しています。
OpenAI は FrontierMath Tier 4 と ARC-AGI-3 でもほぼ飽和に近いスコアを報告していますが、GPT-6 Astra ガイドでも触れたとおり、ARC-AGI-3 の数値は、素の API 呼び出しでは使えないステートフルなハーネスに依存しています。100 万トークン規模のプロンプトでのリトリーバルが業務の要なら、公開実績があるのは Astra のみです。
セーフガードとデータ保持
両モデルとも、攻撃的なサイバーセキュリティ用途はデフォルトでブロックします。違いが大きいのは拒否よりデータ保持の方です。Fable 5.2 の分類器は、ペネトレーションテストやエクスプロイト生成、多くの研究レベルの生物学をブロックしますが、不要なブロックは Fable 5.1 より減ったとされます。審査済み組織は代わりに Claude Mythos 5.2 を申請できます。
OpenAI は、Astra を Preparedness Framework のサイバーセキュリティ「Critical」しきい値に位置づけ、エクスプロイト生成は Daybreak プログラムの背後で制御しています。Astra は適格な API 顧客に対して Zero Data Retention を提供する一方、Fable 5.2 は Enterprise Frontier Safeguards を導入しない限り、安全性モニタリングのため 30 日間の保持を要します。すでにゼロ保持を前提とする規制業種のチームには、Astra の方が適合しやすいでしょう。
価格:実際に支払う金額
公表されているすべての単価で、Fable 5.2 は GPT-6 Astra より安価です。ただし差は一様ではありません。Astra は入力・出力・キャッシュ書き込みが 1.25 倍、キャッシュ読み出しは 5 倍、さらに Astra のみ長文サーチャージがあります。
標準的なバランス型ワークロードでは差は小さめ。しかし、プロンプトをキャッシュする、または 27.2 万トークン超で走らせる場合は決定要因になります。
トークン単価の比較
両社とも、100 万トークンあたりの標準単価に加え、キャッシュ、バッチ、ファストモードの価格を掲載しています。
キャッシュ読み出しの単価差は多くのチームが体感します。エージェントループでは、長いプレフィックスを各ステップで再送するためです。
実際のワークロード費用
下表の各行は月間ボリュームを、(ボリューム ÷ 100 万)× 単価として、入力と出力を合算して試算しています。
両社とも共有ワークロードのトークン消費は公開していないため、ここでの合計は請求額そのものではなく単価比較と捉えてください。後述のハンズオンが示すとおり、トークン単価が安くても実行コストが高くなる場合があります。
Claude Fable 5.2 と GPT-6 Astra の実力
片方のベンダーのローンチ投稿に基づくベンチマークだけでは十分でないため、同一プロンプト・同一ツールで 1 つのビルド課題を両モデルに実行させました。
課題:1 枚の HTML ページに全画面 GLSL フラグメントシェーダーで、夜の嵐の中の岩礁と灯台のシーンを描く。波が岩に砕け、斜めに降る雨、下から照らされた低い雲。灯台の光はマウスに追従し、当たった波・雨・雲が明るくなる。p5.js はキャンバスのホスト、ループ実行、マウス座標と時刻のシェーダーへの受け渡しのみ許可。
フルプロンプト:
難しいポイント:
Anthropic のローンチ投稿では、Unity の Sam Zhang 氏が Fable 5.2 の明確な進歩は「ゼロから高品質な 3D シーンを構築する力」にあると述べています。今回の課題はその主張を直接検証するもの。また、過去のGPT-6 Astra 対 Claude Fable 5.1 比較で、前世代 Fable に対し Astra が物理シミュレーションで勝ったリマッチの側面もあります。
両モデルとも OpenCode 上で、固定ツール面(ファイルの読み書きのみ)を使い、
highの reasoning effort、各 1 回の試行、新規セッション、完全同一のプロンプトで実行しました。以下は両ページのスクリーン録画で、マウスをシーン内で動かした様子です。Fable から: