
Principales conclusions :
- Les deux ont écrit un vrai shader. Chaque page calcule toute la scène dans un shader de fragment GLSL, p5.js ne servant qu’à héberger le canvas et à transmettre souris et temps.
- Fable 5.2 a bâti de la profondeur ; Astra a bâti une image. Les vagues, rochers et le phare de Fable se lisent en 3D, avec l’allure d’un jeu PlayStation un peu ancien, dans le bon sens du terme. La scène d’Astra est reconnaissable, mais très plate, et son phare rappelle un dessin trop simplifié.
- Seul le faisceau de Fable 5.2 respecte la scène. Quand le faisceau passe derrière un élément, celui-ci reste sombre. Le faisceau d’Astra suit la souris, mais moins précisément.
- Fable 5.2 assume l’orage. Pluie battante, houle marquée et éclairs en arrière-plan. Astra propose une pluie convaincante et des vagues globalement correctes, mais pas d’éclairs, une mer calme, des rochers étranges, et des vagues proches du rivage qui semblent s’évaporer.
J’ai noté les deux selon : ressemblance avec la scène décrite, qualité du travail de shader, suivi du curseur par le faisceau, et caractère « vrai fragment shader » de l’effet. Les deux obtiennent la note maximale sur ce dernier axe ; voici les lignes différenciantes :
| Mesure | Claude Fable 5.2 (high) | GPT-6 Astra (high) |
|---|---|---|
| Coût de cette exécution (USD) | $4,91 | $1,75 |
| Jetons de sortie (raisonnement inclus) | 95 683 | 22 934 |
| Correspondance esthétique (critère principal) | 5 | 3 |
| Compétence shader | 5 | 4 |
| Interactivité au curseur | 5 | 4 |
| Score barème (moyenne des quatre axes) | 5,0 | 3,7 |
La ligne de coût est la surprise. Fable 5.2 est moins cher au jeton, mais a généré environ quatre fois plus de jetons de sortie sur cette tâche, si bien que son exécution revient presque trois fois plus cher que celle d’Astra.
Claude Fable 5.2 remporte clairement ce test, et l’écart se situe exactement là où la citation d’Unity l’annonçait : une scène avec une vraie profondeur et une lumière qui se comporte comme telle. La scène de Fable ressemble à un jeu ; celle d’Astra à une illustration simplifiée.
Ceci n’est qu’une exécution, sur une tâche et un niveau d’effort donnés : cela renseigne davantage sur la création de scènes 3D que sur les deux modèles dans leur ensemble.
Quand choisir Claude Fable 5.2 ou GPT-6 Astra
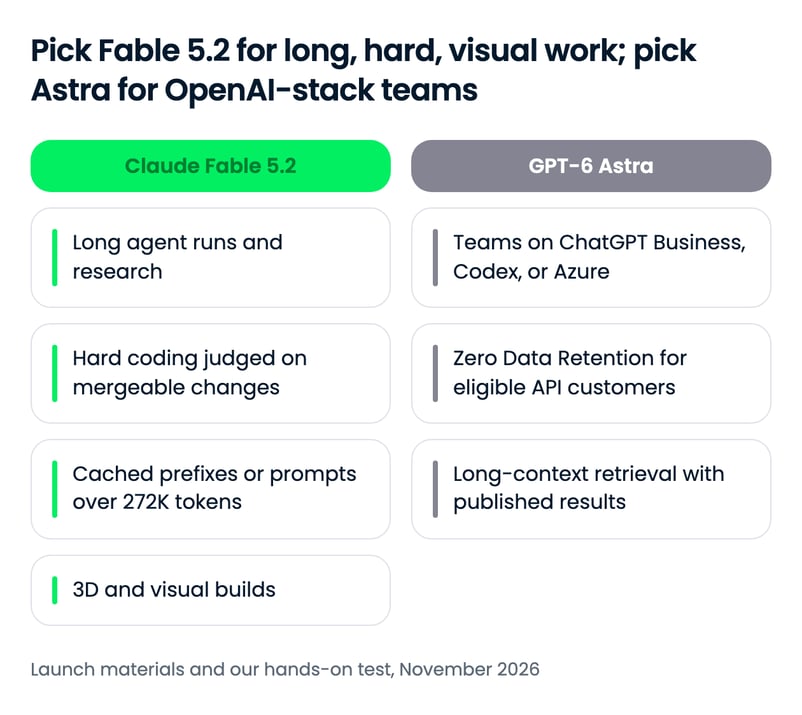
Pour la plupart des travaux techniques, Fable 5.2 est le choix le plus performant et le moins cher au jeton. L’argument en faveur de GPT-6 Astra dépend surtout des outils déjà adoptés par votre équipe et des résultats publiés par OpenAI auxquels Anthropic n’a pas encore répondu.
Choisissez Claude Fable 5.2 si…
- Vos agents tournent des heures. Les avances de Fable 5.2 sont les plus marquées sur les projets multi-étapes comme le Remote Labor Index, et la formalisation en Lean du théorème de Fermat montre sa capacité à mener une tâche très longue jusqu’au bout.
- Vous avez besoin d’un code qui est fusionné. Il mène sur les deux benchmarks de code d’Anthropic, et Anthropic affirme qu’il bat le meilleur score FrontierCode d’Astra même en effort high.
- Vos invites sont mises en cache ou très longues. Les lectures en cache coûtent un cinquième du tarif d’Astra, et aucune surtaxe n’est appliquée au-delà de 272 K jetons.
- Vous créez des scènes 3D, des jeux ou des outils visuels. Dans mon test shader, c’est le seul à produire une scène avec une vraie profondeur et un éclairage qui respecte la géométrie.
Choisissez GPT-6 Astra si…
- Votre équipe travaille déjà dans ChatGPT Business ou Enterprise, Codex, ou Azure. Astra est inclus dans ces abonnements, et les formules Pro, Business et Enterprise accèdent également à GPT-6 Astra Pro.
- Vous avez besoin de Zero Data Retention. Astra la propose aux clients API éligibles, tandis que Fable 5.2 impose 30 jours sauf mise en place d’Enterprise Frontier Safeguards.
- Votre travail repose sur la recherche dans une invite d’un million de jetons. OpenAI a publié des résultats de recherche long contexte pour Astra ; Anthropic non pour Fable 5.2.
- Vous lancez beaucoup de petites créations avec un budget serré. Dans mon test, Astra a consommé bien moins de jetons et terminé pour environ un tiers du coût de Fable, avec un résultat moins bon mais exploitable.
Premiers pas avec Claude Fable 5.2 et GPT-6 Astra
Les deux modèles sont disponibles sur l’API de leur éditeur, les trois grands clouds, GitHub Copilot et OpenRouter.
| Surface | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Application grand public | Applications Claude, formules payantes éligibles (dont Pro et Team) | ChatGPT Plus, Pro, Business, Enterprise (désactivé par défaut pour les espaces Enterprise) |
| API éditeur | Claude Platform | OpenAI API |
| Plateformes cloud | AWS (Claude Platform sur AWS, Amazon Bedrock), Google Cloud, Microsoft Azure | Microsoft Azure, Amazon Bedrock, Google Cloud |
| Agents de développement | Claude Code, GitHub Copilot | Codex, GitHub Copilot |
| Routeurs tiers | OpenRouter | OpenRouter |
| ID du modèle API | claude-fable-5-2 | gpt-6-astra |
Les IDs sont claude-fable-5-2 sur la Claude Platform et gpt-6-astra sur l’OpenAI API.
Passer votre premier appel API
Le moyen le plus rapide de tester les deux est OpenRouter, où changer de modèle revient à modifier une chaîne dans un client compatible OpenAI.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)Pour les SDK natifs, notre tutoriel API GPT-6 Astra bâtit un agent complet, et notre guide Fable 5.2 détaille les niveaux d’effort et le mode rapide.
En conclusion
Claude Fable 5.2 est aujourd’hui le meilleur modèle pour la plupart des travaux techniques exigeants : il devance GPT-6 Astra sur tous les benchmarks communs, coûte moins cher au jeton et remporte clairement mon test pratique. Le bémol : Anthropic est à l’origine de toutes ces confrontations, et les affirmations les plus fortes d’OpenAI en maths, raisonnement abstrait et recherche sur un million de jetons n’ont pas encore de réplique côté Fable 5.2.
Le point le plus marquant est la ligne coût de mon test. Fable 5.2 est moins cher au jeton et a pourtant coûté bien plus cher, parce qu’il a davantage réfléchi et écrit. Si vous migrez des charges, mesurez le coût par tâche, pas par jeton.
Si vous avez envie de construire avec l’un ou l’autre, je vous recommande nos cours Introduction to Claude Models et Working with the OpenAI API.
FAQ
Claude Fable 5.2 est-il meilleur que GPT-6 Astra ?
Sur les benchmarks qui notent les deux modèles, oui. Le tableau de lancement d’Anthropic place Claude Fable 5.2 devant GPT-6 Astra sur toutes les lignes communes, y compris le code, l’usage de l’ordinateur et le travail de longue haleine, et Fable 5.2 a également gagné notre test shader pratique. OpenAI n’a pas publié sa propre comparaison contre Fable 5.2, et les résultats d’Astra en mathématiques, raisonnement abstrait et recherche long contexte n’ont pas encore d’équivalent publié pour Fable 5.2.
Combien coûtent Claude Fable 5.2 et GPT-6 Astra ?
Claude Fable 5.2 coûte $8 par million de jetons d’entrée et $40 par million de jetons de sortie. GPT-6 Astra coûte $10 et $50. Les lectures en cache coûtent $0,20 par million de jetons sur Fable 5.2 et $1,00 sur Astra, et Astra facture 2 x l’entrée et 1,5 x la sortie pour les requêtes au-delà de 272 K jetons d’entrée, tandis que Fable 5.2 n’indique aucune surtaxe long contexte.
Quel est le meilleur pour coder, Claude Fable 5.2 ou GPT-6 Astra ?
Claude Fable 5.2 mène sur les deux benchmarks de code qu’Anthropic rapporte pour les deux modèles : 49,1 % vs 42,8 % sur FrontierCode 2.0 et 69,9 % vs 65,5 % sur FrontierSWE v2. Ces scores proviennent d’Anthropic, pas d’OpenAI. Pour les équipes déjà sur Codex ou ChatGPT, GPT-6 Astra reste le choix le plus pratique.
Quels sont les IDs modèle API de Claude Fable 5.2 et GPT-6 Astra ?
Claude Fable 5.2 est claude-fable-5-2 sur la Claude Platform, et GPT-6 Astra est gpt-6-astra sur l’OpenAI API. Sur OpenRouter, ce sont anthropic/claude-fable-5.2 et openai/gpt-6-astra.
Où puis-je utiliser Claude Fable 5.2 et GPT-6 Astra ?
Claude Fable 5.2 est disponible dans les applications Claude et Claude Code sur des formules payantes éligibles, et sur la Claude Platform. GPT-6 Astra est disponible dans ChatGPT Plus, Pro, Business et Enterprise, sur l’OpenAI API, et dans Codex. Les deux sont disponibles sur Microsoft Azure, Amazon Bedrock, GitHub Copilot et Google Cloud.

Tom est rédacteur en data science chez DataCamp. Il rédige et édite des tutoriels sur l'IA, compare les nouvelles versions de LLM et conçoit des workflows propulsés par l'IA. Auparavant, il a travaillé en data science chez Deutsche Telekom. En dehors du travail, il prévoit les résultats de matchs de football grâce à l'apprentissage automatique.
Anthropic a lancé Claude Fable 5.2 le 9 novembre 2026, deux mois après qu’OpenAI a présenté GPT-6 Astra comme « le modèle le plus intelligent et le mieux aligné au monde ». Fable 5.2 arrive avec une baisse de prix par rapport à Fable 5.1, et le tableau de lancement d’Anthropic le place devant Astra sur toutes les lignes où les deux modèles figurent. Nous n’avons pas trouvé de comparaison publiée par OpenAI contre Fable 5.2, d’où la question évidente pour quiconque choisit un modèle de pointe : ces chiffres tiennent-ils la route ?
Dans cet article, je compare Claude Fable 5.2 et GPT-6 Astra sur le travail cognitif de longue haleine, le code, l’usage de l’ordinateur, les garde-fous et les tarifs, puis j’exécute un test pratique de création avec les deux.
Pour suivre l’actualité de l’IA et des données, je vous recommande de vous abonner à notre newsletter hebdomadaire, The Median.
En bref
Qu’est-ce que Claude Fable 5.2 ?
Claude Fable 5.2 est le modèle d’Anthropic destiné à ses travaux techniques les plus exigeants, disponible pour tous les utilisateurs depuis novembre 2026 et bâti sur le même socle que Claude Mythos 5.2, qui lève les garde-fous cybersécurité et biologie de Fable pour des organisations validées.
Anthropic le positionne sur les travaux techniques ambitieux et de longue haleine, tout en recommandant encore Claude Opus 5.5 comme valeur par défaut pour le code et les tâches de connaissance au quotidien.
Notre guide Claude Fable 5.2 et Mythos 5.2 couvre le lancement en détail.
Qu’est-ce que GPT-6 Astra ?
GPT-6 Astra est le fleuron de pointe d’OpenAI, lancé en septembre 2026 en successeur de GPT-5.6 Sol.
OpenAI a articulé sa proposition autour de l’usage de l’ordinateur et du travail professionnel, et sur des benchmarks à haut plafond comme ARC-AGI-3 et FrontierMath Tier 4 conçus pour rester en avance sur les modèles d’IA.
Notre guide GPT-6 Astra couvre le lancement ; notre tutoriel API GPT-6 Astra explique comment bâtir un agent de vérification de release.
Claude Fable 5.2 vs GPT-6 Astra : comparaison directe
Fable 5.2 mène sur chaque benchmark où les deux modèles sont notés, du code à l’usage de l’ordinateur, et seule la lecture de graphiques frôle l’égalité. Le bémol, c’est la source : toutes ces valeurs proviennent du tableau de lancement d’Anthropic, car celui d’OpenAI est antérieur à Fable 5.2.
Travail cognitif de longue haleine et recherche
L’avance la plus nette de Fable 5.2 se situe sur les travaux ouverts et multi-étapes. Sur le Remote Labor Index, qui évalue de vrais projets de type freelance, Fable 5.2 en réussit 41,3 % contre 20,8 % pour Astra, soit environ le double.
Le constat se vérifie partout : plus une tâche ressemble à un projet long plutôt qu’à une réponse unique, plus l’avance de Fable 5.2 grandit. Humanity’s Last Exam n’est pas une surprise : le tableau de lancement d’OpenAI montrait déjà Astra derrière Claude Fable 5.1.
Les démonstrations d’Anthropic vont dans le même sens. Fable 5.2 a formalisé la démonstration du dernier théorème de Fermat en Lean en 30 heures avec environ 1 000 agents, là où un modèle de recherche interne antérieur avait besoin de 11 jours.
Deux précautions avant d’en tirer une conclusion définitive :
Fable 5.2 est le modèle le plus solide pour les projets de recherche et d’analyse longs et ambigus, et les marges sont trop importantes pour être comblées par le seul choix du harnais d’évaluation.
Code et workflows agentiques
Fable 5.2 mène sur les deux benchmarks de code rapportés par Anthropic, mais avec un écart plus modeste que sur le travail de connaissance. Sur FrontierCode 2.0, qui évalue si des mainteneurs open source accepteraient une proposition du modèle, Fable 5.2 atteint 49,1 % en effort xhigh contre 42,8 % pour Astra.
Anthropic ajoute que Fable 5.2 en high dépasse le meilleur score FrontierCode d’Astra pour un coût par tâche comparable. Le tableau de code d’OpenAI s’appuie sur des versions plus anciennes des benchmarks et compare Astra à Fable 5.1, donc pas encore de contre-expertise côté OpenAI. Sur la base des éléments disponibles, Fable 5.2 est le meilleur modèle de code.
Usage de l’ordinateur, vision et robotique
Fable 5.2 mène sur l’usage de l’ordinateur et la robotique, tandis que la lecture de graphiques est presque à égalité. La robotique se distingue : sur RoboDojo Sim, un robot à deux bras simulé, Fable 5.2 atteint 64,9 % contre 29,8 % pour Astra.
OpenAI présentait Astra comme « le meilleur modèle d’usage de l’ordinateur au monde », mais cette affirmation était faite face à Claude Fable 5.1 et Claude Opus 5 sur OSWorld 2.0. Sur la version plus récente d’Anthropic, Fable 5.2 prend l’avantage.
Maths, raisonnement abstrait et long contexte : des promesses d’Astra sans réponse
Les résultats les plus forts d’Astra au lancement reposent sur des benchmarks qu’Anthropic n’a pas rapportés pour Fable 5.2 : pas de face-à-face ici, seulement des chiffres d’un seul côté. Le plus net concerne la recherche en long contexte : Astra obtient 96,3 % sur le test MRCR v2 « 8 aiguilles » d’OpenAI dans la plage 512K à 1M de jetons.
OpenAI rapporte aussi des scores presque saturés sur FrontierMath Tier 4 et ARC-AGI-3, même si notre guide GPT-6 Astra précise que le score ARC-AGI-3 dépend d’un harnais à état que les appels API simples n’utilisent pas. Si votre travail dépend d’une recherche dans une invite d’un million de jetons, Astra est le seul des deux à avoir publié des preuves.
Garde-fous et rétention des données
Les deux modèles bloquent par défaut les usages cybersécurité offensifs, et ils diffèrent davantage sur la rétention que sur les refus. Les classifieurs de Fable 5.2 bloquent le pentest, la génération d’exploits et la plupart des travaux de biologie de niveau recherche, tout en produisant selon Anthropic moins de blocages injustifiés que Fable 5.1 ; les organisations validées peuvent demander Claude Mythos 5.2.
OpenAI classe Astra au seuil Critical de son Preparedness Framework pour la cybersécurité et restreint la création d’exploits via son programme Daybreak. Astra prend en charge la Zero Data Retention pour les clients API éligibles, tandis que Fable 5.2 impose 30 jours de rétention à des fins de sécurité, sauf si l’entreprise utilise Enterprise Frontier Safeguards d’Anthropic. Pour les équipes régulées déjà organisées en zéro rétention, Astra est plus simple à intégrer.
Tarifs : ce que vous paierez vraiment
Fable 5.2 est moins cher que GPT-6 Astra sur toutes les lignes tarifaires communes, et l’écart n’est pas uniforme. Astra coûte 1,25 x plus cher en entrée, sortie et écriture de cache, mais 5 x plus cher pour les lectures de cache, et seul Astra ajoute une surtaxe long contexte.
Sur une charge équilibrée, la différence reste modeste. Elle devient déterminante dès que les invites sont mises en cache ou dépassent 272 K jetons.
Tarifs au million de jetons, côte à côte
Les deux fournisseurs affichent des tarifs standards par million de jetons, plus des prix pour le cache, le batch et le mode rapide.
La ligne sur la lecture en cache est celle que la plupart des équipes ressentiront, car les boucles d’agents renvoient le même préfixe long à chaque étape.
Ce que coûte une charge réelle
Chaque ligne ci-dessous est un volume mensuel, chiffré comme (volume ÷ 1 M) × tarif, sommé entre entrée et sortie.
Aucun des deux fournisseurs n’a publié de comptages de jetons sur une charge partagée : considérez donc ces totaux comme une comparaison de tarifs, pas une facture. Mon test pratique ci-dessous en rappelle la raison : là, le modèle le moins cher au jeton a coûté plus cher à l’exécution.
Performance de Claude Fable 5.2 et GPT-6 Astra
Les benchmarks d’un seul éditeur ne suffisent pas : j’ai donc exécuté une même tâche de création sur les deux modèles, avec une invite et des outils strictement identiques.
La tâche : une page HTML unique avec un shader de fragment GLSL plein écran animé d’un phare sur une côte rocheuse par nuit d’orage, avec houle déferlante sur les rochers, pluie oblique et nuages bas éclairés par dessous. Le faisceau du phare devait suivre la souris et illuminer les vagues, la pluie et les nuages sur son passage. p5.js ne pouvait que fournir le canvas, faire tourner la boucle et passer la position de la souris et le temps au shader.
L’invite complète :
Pourquoi c’est difficile :
Le billet de lancement d’Anthropic cite Sam Zhang (Unity) expliquant que les gains les plus nets de Fable 5.2 sont « la création à partir de zéro de scènes 3D de plus haute qualité » : c’est donc un test direct de cette affirmation. C’est aussi une revanche : dans notre comparatif GPT-6 Astra vs Claude Fable 5.1, Astra avait remporté un test de simulation physique contre l’ancien Fable.
Les deux modèles ont tourné dans OpenCode avec une surface d’outils figée (lecture et édition de fichiers uniquement), en niveau de raisonnement
high, une tentative chacun, en session neuve, avec l’invite transmise à l’octet près.Voici mes enregistrements écran des deux pages, en déplaçant la souris dans la scène. Fable en premier :