
主要结论:
- 两者都写了真正的着色器。 每个页面都用 GLSL 片段着色器计算整幅场景,p5.js 仅用于挂载画布并传入鼠标与时间。
- Fable 5.2 构建了“深度”;Astra 构建了“画面”。 Fable 的海浪、岩石与灯塔具有 3D 质感,颇有一代老款 PlayStation 游戏的味道(褒义)。Astra 的场景虽清晰可辨,但非常扁平,灯塔像是简化的涂鸦。
- 只有 Fable 5.2 的光束尊重场景几何。 当 Fable 的光束扫到某元素背后时,该元素保持黑暗。Astra 的光束虽响应鼠标,但精度较差。
- Fable 5.2 更“投入”风暴氛围。 它有密集的雨、强烈的浪,以及背景中的闪电。Astra 的雨很像真,海浪也总体不错,但没有闪电,海面偏平静,岩石形态奇怪,近岸的浪像是在蒸发。
我从页面是否符合描述、着色器质量、光束跟随鼠标的表现、以及是否为真正的片段着色器四条轴线打分。最后一条两者都满分;其余差异如下:
| 指标 | Claude Fable 5.2(high) | GPT-6 Astra(high) |
|---|---|---|
| 本次运行成本(美元) | $4.91 | $1.75 |
| 输出 tokens(含推理) | 95,683 | 22,934 |
| 美学匹配度(主判定项) | 5 | 3 |
| 着色器能力 | 5 | 4 |
| 光标交互性 | 5 | 4 |
| 评分量表(四轴均值) | 5.0 | 3.7 |
成本一行出人意料。Fable 5.2 的单 token 更便宜,但它在该任务上产出了约四倍的输出 token,因此整体运行成本几乎是 Astra 的三倍。
Claude Fable 5.2 在这次测试中胜出明显,差距正如 Unity 的引述所说:一个具有真实深度的场景,以及像真正“光”般行为的光束。Fable 的场景像游戏;Astra 的场景像其简化插画。
这只是一次、单一任务、单一强度设置下的结果,与 Astra 曾在对 Fable 5.1 的物理模拟测试中获胜的项目不同,因此它更多反映 3D 场景构建能力,而非两者的全面对比。
何时选择 Claude Fable 5.2,何时选择 GPT-6 Astra
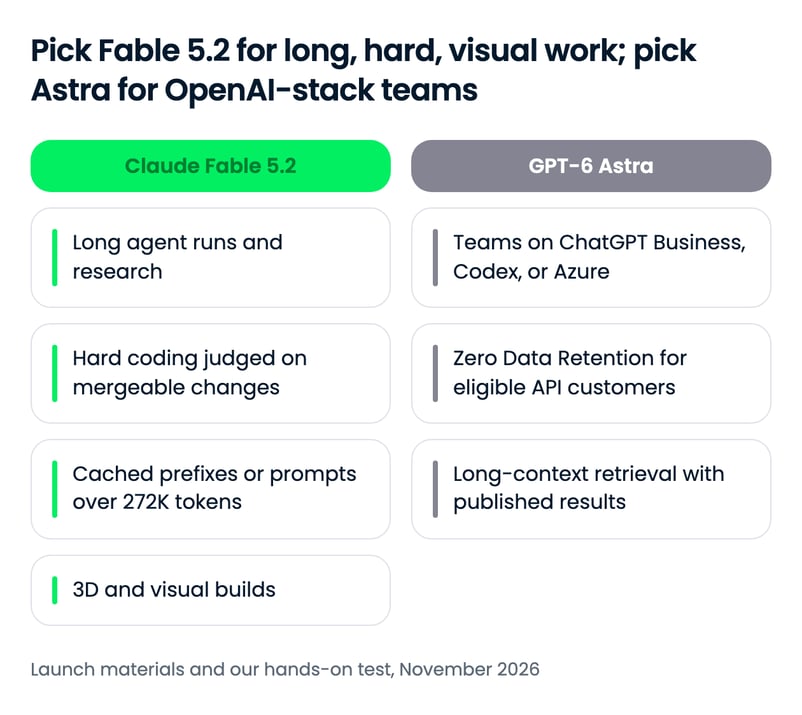
对多数技术工作而言,Fable 5.2 在单 token 上更强也更便宜。选择 GPT-6 Astra 的理由在于您的团队所处生态,以及 OpenAI 已发布而 Anthropic 尚未回应的主张。
如果以下情况,请选 Claude Fable 5.2:
- 您的代理要运行数小时。 Fable 5.2 在远程劳动指数等多步骤项目上优势最明显,Anthropic 用 Lean 形式化费马大定理也显示它能把超长任务完成到底。
- 您需要能被合并的代码。 它在 Anthropic 报告的两项编码基准上领先,且 Anthropic 称其在 high 强度时也能打败 Astra 的最佳 FrontierCode 分数。
- 您的提示会被缓存或非常长。 缓存读取费用仅为 Astra 的五分之一,且超过 27.2 万 tokens 不加收附加费。
- 您在构建 3D 场景、游戏或视觉工具。 在我的着色器测试中,它是唯一生成了真实深度与遵循几何光照的场景。
如果以下情况,请选 GPT-6 Astra:
- 您的团队已在 ChatGPT Business 或 Enterprise、Codex 或 Azure 上工作。 Astra 包含在这些订阅中,且 Pro、Business 与 Enterprise 也可使用 GPT-6 Astra Pro。
- 您需要零数据留存。 Astra 对符合条件的 API 客户支持 Zero Data Retention,而 Fable 5.2 除非配置 Enterprise Frontier Safeguards,否则需 30 天留存。
- 您的工作依赖跨百万 token 提示的检索。 OpenAI 已发布 Astra 的长上下文检索结果;Anthropic 尚未发布 Fable 5.2 的对应数据。
- 您要以有限预算运行大量短构建。 在我的测试中,Astra 消耗的 token 少得多,成本约为 Fable 的三分之一,虽然效果较弱但可用。
如何开始使用 Claude Fable 5.2 与 GPT-6 Astra
两者均上线自家 API、三大云、GitHub Copilot 与 OpenRouter。
| 接入面 | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| 消费者应用 | Claude 应用,符合条件的付费方案(含 Pro 与 Team) | ChatGPT Plus、Pro、Business、Enterprise(企业工作区默认关闭) |
| 第一方 API | Claude Platform | OpenAI API |
| 云平台 | AWS(Claude Platform on AWS、Amazon Bedrock)、Google Cloud、Microsoft Azure | Microsoft Azure、Amazon Bedrock、Google Cloud |
| 编码代理 | Claude Code、GitHub Copilot | Codex、GitHub Copilot |
| 第三方路由 | OpenRouter | OpenRouter |
| API 模型 ID | claude-fable-5-2 | gpt-6-astra |
在 Claude Platform 上的模型 ID 是 claude-fable-5-2,在 OpenAI API 上是 gpt-6-astra。
发出第一条 API 调用
最快的尝试方式是 OpenRouter,在 OpenAI 兼容的客户端里只需改一个字符串即可切换模型。
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)对于各自的原生 SDK,我们的 GPT-6 Astra API 教程构建了完整代理;我们的 Fable 5.2 指南介绍了推理强度与快速模式。
结语
在当下的大多数高难度技术工作上,Claude Fable 5.2 更胜一筹:它在两者共有的每个基准上领先,单 token 更便宜,并在我的上手测试中明显取胜。需要注意的是,所有正面对比数字都由 Anthropic 提供;而 OpenAI 在数学、抽象推理与百万 token 检索上的最强主张,Fable 5.2 仍未给出回应。
我觉得最有意思的是测试中的“成本”一行。Fable 5.2 的单 token 更便宜,但因为“想与写得更多”,它的总成本反而高出许多。若您要迁移工作负载,请按“单任务成本”而非“单 token 成本”来衡量。
如果您希望用任一模型动手实践,推荐我们的 Introduction to Claude Models 课程与 Working with the OpenAI API 课程。
常见问题
Claude Fable 5.2 比 GPT-6 Astra 更好吗?
就能同时评测两者的基准而言,是的。Anthropic 的发布对比表显示,Claude Fable 5.2 在两者共享的每一项(包括编码、电脑使用与长期知识型工作)上均领先,且 Fable 5.2 也赢下了我们的着色器上手测试。OpenAI 尚未发布其与 Fable 5.2 的对比;而 Astra 在数学、抽象推理与长上下文检索上的结果,目前没有 Fable 5.2 的对应数据。
Claude Fable 5.2 和 GPT-6 Astra 的价格是多少?
Claude Fable 5.2 的价格为每百万输入 tokens $8、每百万输出 tokens $40。GPT-6 Astra 分别为 $10 与 $50。Fable 5.2 的缓存读取为每百万 tokens $0.20,Astra 为 $1.00;且 Astra 对超过 27.2 万输入 tokens 的请求,输入按 2 倍、输出按 1.5 倍计费;Fable 5.2 未列出长上下文附加费。
哪一个更适合编码,Claude Fable 5.2 还是 GPT-6 Astra?
在 Anthropic 报告的两项编码基准上,Claude Fable 5.2 均领先:FrontierCode 2.0 为 49.1% 对 42.8%,FrontierSWE v2 为 69.9% 对 65.5%。这些分数来自 Anthropic,而非 OpenAI。对已在 Codex 或 ChatGPT 工作的团队而言,GPT-6 Astra 仍是更便利的选择。
Claude Fable 5.2 与 GPT-6 Astra 的 API 模型 ID 是什么?
Claude Fable 5.2 在 Claude Platform 上的 ID 是 claude-fable-5-2,GPT-6 Astra 在 OpenAI API 上的 ID 是 gpt-6-astra。在 OpenRouter 上,它们分别为 anthropic/claude-fable-5.2 与 openai/gpt-6-astra。
我可以在哪些平台使用 Claude Fable 5.2 和 GPT-6 Astra?
Claude Fable 5.2 可在 Claude 应用与 Claude Code(符合条件的付费方案)以及 Claude Platform 上使用。GPT-6 Astra 可在 ChatGPT Plus、Pro、Business 与 Enterprise、OpenAI API 以及 Codex 中使用。两者均可在 Microsoft Azure、Amazon Bedrock、GitHub Copilot 与 Google Cloud 上使用。

Tom 是 DataCamp 的数据科学编辑,负责撰写与编辑 AI 教程、比较最新的 LLM 版本,并构建 AI 驱动的工作流程。在此之前,他曾在德国电信从事数据科学工作。工作之余,他利用机器学习预测足球比赛结果。
Anthropic 于 2026 年 11 月 9 日发布了 Claude Fable 5.2,比 OpenAI 推出 GPT-6 Astra(称其为“全球最智能且最对齐的模型”)晚两个月。Fable 5.2 相比 Fable 5.1 降价,Anthropic 的发布对比表显示它在两者同时出现的每一项上都领先于 Astra。我们没找到 OpenAI 针对 Fable 5.2 的对比数据,因此对任何在前沿模型间做选择的人来说,显而易见的问题是这些数字是否经得起检验。
本文将从长期知识型工作、编码、电脑使用、安全防护和定价等方面,比较 Claude Fable 5.2 和 GPT-6 Astra,并用一次上手构建任务做对比测试。
想持续跟进 AI 与数据领域动态,推荐订阅我们的每周通讯 The Median。
要点速览
什么是 Claude Fable 5.2?
Claude Fable 5.2 是 Anthropic 面向最高难度技术工作的模型,于 2026 年 11 月向所有用户发布,底层与 Claude Mythos 5.2 相同。后者为通过审查的机构放开了 Fable 的网络安全与生物学安全防护。
Anthropic 将其定位为应对最具雄心的长期技术任务,同时仍建议将 Claude Opus 5.5 作为日常编码与知识任务的默认选择。
我们的 Claude Fable 5.2 与 Mythos 5.2 指南完整覆盖了此次发布。
什么是 GPT-6 Astra?
GPT-6 Astra 是 OpenAI 的前沿旗舰,于 2026 年 9 月作为 GPT-5.6 Sol 的继任者发布。
OpenAI 的主打卖点是电脑使用与专业工作,以及诸如 ARC-AGI-3 和 FrontierMath 第 4 档这类旨在“领先于 AI 模型”的饱和型基准。
我们的 GPT-6 Astra 指南覆盖了发布内容;我们的 GPT-6 Astra API 教程带您构建一个发布检查代理。
Claude Fable 5.2 vs GPT-6 Astra:正面对比
在对两者均有评分的每个基准上,从编码到电脑使用,Fable 5.2 都领先,只有图表解读接近打平。问题在于来源:这些数据均来自 Anthropic 的发布对比表,因为 OpenAI 自己的表格早于 Fable 5.2。
长期知识型工作与研究
Fable 5.2 在开放式、多步骤的工作上优势最大。在评分真实自由职业型项目的远程劳动指数上,Fable 5.2 完成率为 41.3%,而 Astra 为 20.8%,约为其两倍。
整体模式一致:任务越像一个长期项目而非单次回答,Fable 5.2 的领先幅度越大。“人类最后一考”并不意外:OpenAI 自己的发布表格已经显示 Astra 在此落后于 Claude Fable 5.1。
Anthropic 的示例也指向同一结论。Fable 5.2 用约 1000 个代理在 30 小时内,用 Lean 形式化了费马大定理的证明,而更早期的内部研究模型花了 11 天。
在将此视为定论前有两点注意:
对于长期、含糊的研究与分析项目,Fable 5.2 更强,而且优势足够大,仅凭评测框架差异很难抹平。
编码与代理式工作流
在 Anthropic 报告的两项编码基准上,Fable 5.2 均领先,虽不及知识型工作的优势那么大。在 FrontierCode 2.0 上(检验开源维护者是否会合并模型的修改),Fable 5.2 在 xhigh 强度下达到 49.1%,而 Astra 为 42.8%。
Anthropic 补充称,Fable 5.2 在 high 强度时也能以大致相同的单任务成本,战胜 Astra 的最佳 FrontierCode 分数。OpenAI 自己的编码表使用了更早的基准版本,并将 Astra 与 Fable 5.1 对比,因此尚无 OpenAI 侧的直接校验。就现有证据看,Fable 5.2 是更好的编码模型。
电脑使用、视觉与机器人
在电脑使用与机器人上,Fable 5.2 领先,而图表解读接近打平。机器人是异类:在 RoboDojo Sim(一个双臂机器人模拟)上,Fable 5.2 得分 64.9%,Astra 为 29.8%。
OpenAI 称 Astra 是“全球最佳电脑使用模型”,但该说法是相对 OSWorld 2.0 上的 Claude Fable 5.1 与 Claude Opus 5 而言。在 Anthropic 的新版本上,Fable 5.2 领先。
数学、抽象推理与长上下文:Astra 尚未被回应的主张
Astra 最强的发布结果集中在 Anthropic 未报告 Fable 5.2 成绩的基准上,因此没有正面对比,只有单方主张。最明确的是长上下文检索:在 51.2 万至 100 万 token 区间的 OpenAI MRCR v2 8-needle 测试中,Astra 得分 96.3%。
OpenAI 还报告了在 FrontierMath 第 4 档与 ARC-AGI-3 上接近饱和的分数,但我们在 GPT-6 Astra 指南中提到,ARC-AGI-3 的数据依赖有状态的评测框架,普通 API 调用并不具备。如果您的工作高度依赖跨百万 token 提示词的检索,在两者之间,只有 Astra 有公布的证据。
安全防护与数据留存
两者默认都会拦截攻击性的网络安全工作,它们在数据留存方面的差异大于在拒答上的差异。Fable 5.2 的分类器会拦截渗透测试、漏洞利用生成以及大多数研究级生物学内容,但 Anthropic 表示其误拦截少于 Fable 5.1;通过审查的机构可申请使用 Claude Mythos 5.2。
OpenAI 将 Astra 评为其 Preparedness Framework 中网络安全的 Critical 阈值,并将漏洞利用创建置于 Daybreak 计划之下。Astra 为符合条件的 API 客户提供零数据留存(Zero Data Retention),而 Fable 5.2 出于安全监控要求 30 天留存,除非企业使用 Anthropic 的 Enterprise Frontier Safeguards。对已依赖零留存的受监管团队而言,Astra 更易于接入。
定价:您实际会付多少钱
在两家厂商都公布费率的每一项上,Fable 5.2 都比 GPT-6 Astra 更便宜,且差距并不均匀。Astra 的输入、输出与缓存写入价格是 Fable 的 1.25 倍,但缓存读取是 5 倍,且只有 Astra 额外收取长上下文附加费。
在普通的均衡负载下,差距不大。但一旦提示被缓存或超过 27.2 万 tokens,就成为决定性因素。
Token 费率并排对比
两家都按百万 token 列出标准费率,另含缓存、批量与快速模式定价。
缓存读取这一行最能影响团队成本,因为代理循环会在每一步重复发送同样的长前缀。
真实工作负载要花多少钱
下表各行代表月度用量,按(用量 ÷ 100 万)× 费率计价,并在输入与输出间相加。
两家都没有公布某个共享工作负载的 token 消耗量,所以这些总计更像费率对比而非真实账单。下面的上手测试也提醒了这一点:在那次测试中,单 token 更便宜的模型反而花费更高。
Claude Fable 5.2 和 GPT-6 Astra 的实际表现
仅凭一方的发布博文里的基准并不足够,因此我用相同的提示词与工具,对两者各跑了一次构建任务。
任务:用一个 HTML 单页呈现全窗口的 GLSL 片段着色器动画,场景是“夜晚暴风雨中的岩石海岸与灯塔”,有滚动的海浪拍击岩石、倾斜的雨丝、从下方被照亮的低云。灯塔光束需跟随鼠标,并点亮光束扫过的海浪、雨和云。p5.js 只能用于挂载画布、运行循环,并将鼠标位置与时间传入着色器。
完整提示词:
难点在于:
Anthropic 的发布中引用了 Unity 的 Sam Zhang 的话,称 Fable 5.2 在“从零构建更高质量的 3D 场景”上提升最为明显,所以这正是对其主张的直接测试。这也是一次“重赛”:在我们的 GPT-6 Astra vs Claude Fable 5.1 对比中,Astra 在上一版 Fable 面前赢下了一个物理模拟测试。
两者均在 OpenCode 上运行,固定的工具面板(仅文件读取与编辑),
high推理强度,各一次尝试,独立新会话,提示词逐字节一致。以下是我移动鼠标穿过场景时,两页的屏幕录制。先看 Fable: