
Principais conclusões:
- Ambos escreveram um shader de verdade. Cada página computa a cena inteira em um shader de fragmento GLSL, com p5.js apenas hospedando o canvas e passando mouse e tempo.
- O Fable 5.2 construiu profundidade; o Astra construiu uma figura. As ondas, rochas e o farol do Fable parecem 3D, com a cara de um jogo de PlayStation mais antigo — no bom sentido. A cena do Astra é reconhecível, mas muito plana, e seu farol lembra um desenho simplificado.
- Só o feixe do Fable 5.2 respeita a cena. Quando o feixe do Fable passa por trás de um elemento, esse elemento permanece escuro. O feixe do Astra responde ao mouse, mas com menos precisão.
- O Fable 5.2 abraçou a tempestade. Ele tem chuva pesada, ondas fortes e relâmpagos ao fundo. O Astra tem chuva convincente e ondas geralmente boas, mas sem relâmpagos, mar calmo, rochas estranhas e ondas perto da costa que parecem evaporar.
Avaliei ambos por: parecer com a cena descrita, qualidade do trabalho de shader, quão bem o feixe segue o cursor e se o efeito é um shader de fragmento real. Ambos receberam nota máxima nesse último critério; onde diferem:
| Métrica | Claude Fable 5.2 (high) | GPT-6 Astra (high) |
|---|---|---|
| Custo desta execução (USD) | US$ 4,91 | US$ 1,75 |
| Tokens de saída (incl. raciocínio) | 95.683 | 22.934 |
| Correspondência estética (discriminador principal) | 5 | 3 |
| Competência em shader | 5 | 4 |
| Interatividade do cursor | 5 | 4 |
| Pontuação da rubrica (média dos quatro eixos) | 5,0 | 3,7 |
O custo é a surpresa. O Fable 5.2 é mais barato por token, mas gastou cerca de quatro vezes mais tokens de saída nesta tarefa, então sua execução saiu quase três vezes mais cara do que a do Astra.
O Claude Fable 5.2 vence este teste com clareza, e a diferença aparece exatamente onde a citação da Unity indicou: uma cena com profundidade real e luz que se comporta como luz. A cena do Fable parece um jogo; a do Astra parece uma ilustração simplificada de um.
Este é um único teste, de uma tarefa, em um nível de esforço — e diferente da simulação de física que o Astra venceu contra o Fable 5.1 —, então diz mais sobre construção de cenas 3D do que sobre os dois modelos como um todo.
Quando escolher Claude Fable 5.2 vs GPT-6 Astra
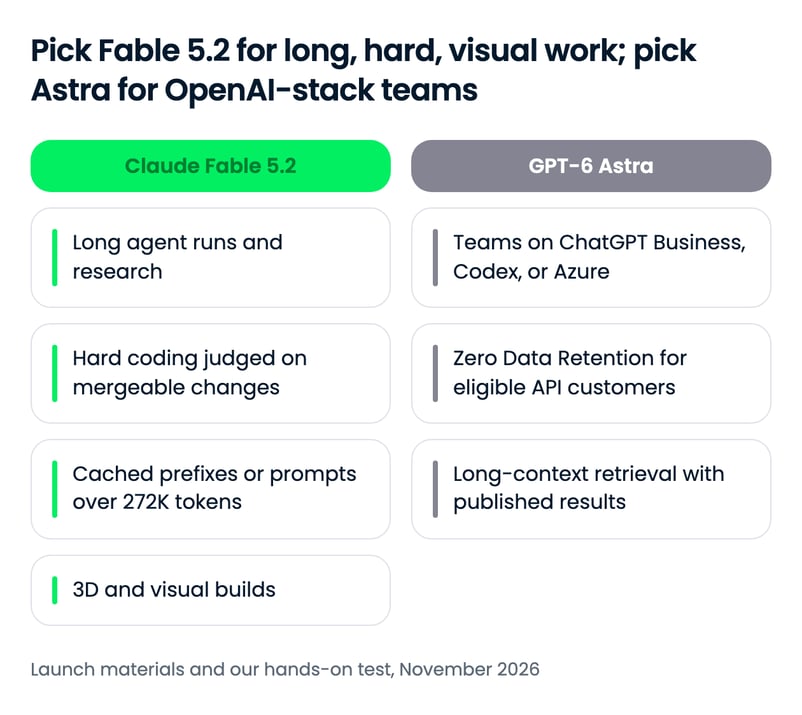
Para a maior parte do trabalho técnico, o Fable 5.2 é a opção mais forte e mais barata por token. O caso do GPT-6 Astra se apoia em onde seu time já trabalha e nas alegações publicadas pela OpenAI que a Anthropic ainda não respondeu.
Escolha o Claude Fable 5.2 se...
- Seus agentes rodam por horas. As maiores vantagens do Fable 5.2 estão em projetos de múltiplas etapas como o Remote Labor Index, e a formalização em Lean do Último Teorema de Fermat mostra que ele leva um trabalho muito longo até o fim.
- Você precisa de código que é aceito. Ele lidera os dois benchmarks de código da Anthropic, e a Anthropic diz que supera a melhor pontuação do Astra no FrontierCode mesmo em high effort.
- Seus prompts são cacheados ou muito longos. Leituras em cache custam um quinto da tarifa do Astra e não há sobretaxa acima de 272K tokens.
- Você cria cenas 3D, jogos ou ferramentas visuais. No meu teste de shader, ele foi o único a produzir cena com profundidade real e iluminação que respeita a geometria.
Escolha o GPT-6 Astra se...
- Seu time já trabalha no ChatGPT Business ou Enterprise, Codex ou Azure. O Astra está incluído nessas assinaturas, e os planos Pro, Business e Enterprise também contam com GPT-6 Astra Pro.
- Você precisa de Zero Data Retention. O Astra oferece isso para clientes elegíveis da API, enquanto o Fable 5.2 exige 30 dias de retenção, a menos que você implemente o Enterprise Frontier Safeguards.
- Seu trabalho depende de recuperação em um prompt de um milhão de tokens. A OpenAI publicou resultados de contexto longo para o Astra; a Anthropic ainda não fez isso para o Fable 5.2.
- Você roda muitos builds curtos com orçamento apertado. No meu teste, o Astra gastou bem menos tokens e terminou por cerca de um terço do custo do Fable, com um resultado mais fraco, porém utilizável.
Como começar com Claude Fable 5.2 e GPT-6 Astra
Ambos estão na API do fornecedor, nas três grandes clouds, no GitHub Copilot e no OpenRouter.
| Superfície | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| App para consumidor | Apps do Claude, planos pagos elegíveis (incluindo Pro e Team) | ChatGPT Plus, Pro, Business, Enterprise (desativado por padrão em workspaces Enterprise) |
| API de primeira parte | Claude Platform | OpenAI API |
| Plataformas de cloud | AWS (Claude Platform na AWS, Amazon Bedrock), Google Cloud, Microsoft Azure | Microsoft Azure, Amazon Bedrock, Google Cloud |
| Agentes de código | Claude Code, GitHub Copilot | Codex, GitHub Copilot |
| Roteadores de terceiros | OpenRouter | OpenRouter |
| ID do modelo na API | claude-fable-5-2 | gpt-6-astra |
Os IDs são claude-fable-5-2 na Claude Platform e gpt-6-astra na OpenAI API.
Fazendo sua primeira chamada de API
O jeito mais rápido de testar os dois é pelo OpenRouter, onde trocar de modelo é mudar uma string em um cliente compatível com a OpenAI.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)Para os SDKs nativos, nosso tutorial da API do GPT-6 Astra constrói um agente completo, e nosso guia do Fable 5.2 cobre níveis de esforço e modo rápido.
Considerações finais
O Claude Fable 5.2 é hoje o melhor modelo para a maior parte do trabalho técnico exigente: lidera o GPT-6 Astra em todos os benchmarks que os dois compartilham, custa menos por token e venceu claramente meu teste prático. A ressalva é que a Anthropic produziu todos esses números diretos, e as alegações mais fortes da OpenAI em matemática, raciocínio abstrato e recuperação em um milhão de tokens ainda não têm resposta do Fable 5.2.
O que acho mais interessante é a linha de custo do meu teste. O Fable 5.2 é mais barato por token e ainda assim rodou muito mais caro, porque pensou e escreveu muito mais. Se você migrar cargas de trabalho, meça custo por tarefa, não por token.
Se você quer começar a construir com qualquer um dos modelos, recomendo nosso curso Introduction to Claude Models e nosso curso Working with the OpenAI API.
FAQs
O Claude Fable 5.2 é melhor que o GPT-6 Astra?
Nos benchmarks que avaliam ambos os modelos, sim. A tabela de lançamento da Anthropic coloca o Claude Fable 5.2 à frente do GPT-6 Astra em todas as linhas compartilhadas, incluindo código, uso de computador e trabalho de conhecimento de longo prazo, e o Fable 5.2 também venceu nosso teste prático de shader. A OpenAI ainda não publicou sua própria comparação com o Fable 5.2, e os resultados do Astra em matemática, raciocínio abstrato e recuperação em contexto longo ainda não têm contraparte do Fable 5.2.
Quanto custam o Claude Fable 5.2 e o GPT-6 Astra?
O Claude Fable 5.2 custa US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída. O GPT-6 Astra custa US$ 10 e US$ 50. Leituras em cache custam US$ 0,20 por milhão de tokens no Fable 5.2 e US$ 1,00 no Astra, e o Astra cobra 2x na entrada e 1,5x na saída para requisições acima de 272K tokens de entrada, enquanto o Fable 5.2 não lista sobretaxa de contexto longo.
Qual é melhor para programar, Claude Fable 5.2 ou GPT-6 Astra?
O Claude Fable 5.2 lidera nos dois benchmarks de código que a Anthropic reporta para os dois modelos: 49,1% vs 42,8% no FrontierCode 2.0 e 69,9% vs 65,5% no FrontierSWE v2. Essas pontuações vêm da Anthropic, não da OpenAI. Para times que já trabalham no Codex ou no ChatGPT, o GPT-6 Astra continua sendo a opção mais conveniente.
Quais são os IDs dos modelos na API para Claude Fable 5.2 e GPT-6 Astra?
O Claude Fable 5.2 é claude-fable-5-2 na Claude Platform, e o GPT-6 Astra é gpt-6-astra na OpenAI API. No OpenRouter, são anthropic/claude-fable-5.2 e openai/gpt-6-astra.
Onde posso usar o Claude Fable 5.2 e o GPT-6 Astra?
O Claude Fable 5.2 está disponível nos apps do Claude e no Claude Code em planos pagos elegíveis, e na Claude Platform. O GPT-6 Astra está disponível no ChatGPT Plus, Pro, Business e Enterprise, na OpenAI API e no Codex. Ambos estão disponíveis no Microsoft Azure, Amazon Bedrock, GitHub Copilot e Google Cloud.

Tom é editor de ciência de dados na DataCamp. Ele escreve e revisa tutoriais de IA, compara novos lançamentos de LLM e cria fluxos de trabalho com IA. Antes, atuou em ciência de dados na Deutsche Telekom. Fora do trabalho, ele faz previsões de partidas de futebol com aprendizado de máquina.





A Anthropic lançou o Claude Fable 5.2 em 9 de novembro de 2026, dois meses depois de a OpenAI apresentar o GPT-6 Astra como "o modelo mais inteligente e alinhado do mundo". O Fable 5.2 chegou com redução de preço em relação ao Fable 5.1, e a tabela de lançamento da Anthropic o coloca à frente do Astra em todas as linhas em que ambos aparecem. A OpenAI não publicou uma comparação com o Fable 5.2 que pudéssemos encontrar, então a pergunta óbvia para quem precisa escolher um modelo de fronteira é: esses números se sustentam?
Neste artigo, comparo o Claude Fable 5.2 e o GPT-6 Astra em trabalho de conhecimento de longo prazo, programação, uso de computador, salvaguardas e preços — e depois executo uma tarefa prática com ambos.
Para acompanhar o mundo de IA e dados, recomendo assinar nossa newsletter semanal, The Median.
Resumo
O que é o Claude Fable 5.2?
O Claude Fable 5.2 é o modelo da Anthropic para seus trabalhos técnicos mais exigentes, lançado para todos os usuários em novembro de 2026 e construído sobre o mesmo modelo base do Claude Mythos 5.2, que remove as salvaguardas de cibersegurança e biologia do Fable para organizações aprovadas.
A Anthropic posiciona o Fable para os trabalhos técnicos mais ambiciosos e de longo horizonte, e ainda recomenda o Claude Opus 5.5 como padrão para tarefas diárias de código e conhecimento.
Nosso guia do Claude Fable 5.2 e Mythos 5.2 traz a cobertura completa do lançamento.
O que é o GPT-6 Astra?
O GPT-6 Astra é o flagship de fronteira da OpenAI, lançado em setembro de 2026 como sucessor do GPT-5.6 Sol.
A OpenAI baseou seu posicionamento em uso de computador e trabalho profissional, além de benchmarks como ARC-AGI-3 e FrontierMath Tier 4, pensados para se manterem à frente dos modelos de IA.
Nosso guia do GPT-6 Astra cobre o lançamento; nosso tutorial da API do GPT-6 Astra mostra como construir um agente de verificação de releases.
Claude Fable 5.2 vs GPT-6 Astra: comparação direta
O Fable 5.2 lidera em todos os benchmarks que avaliam ambos os modelos, de programação a uso de computador, e só a leitura de gráficos chega perto de um empate. O porém é a fonte: todos esses números vêm da tabela de lançamento da Anthropic, porque a própria tabela da OpenAI é anterior ao Fable 5.2.
Trabalho de conhecimento de longo prazo e pesquisa
A maior vantagem do Fable 5.2 está em trabalhos abertos e de múltiplas etapas. No Remote Labor Index, que avalia projetos reais no estilo de freelas, o Fable 5.2 conclui 41,3% contra 20,8% do Astra — cerca do dobro.
O padrão se mantém: quanto mais uma tarefa se parece com um projeto longo e menos com uma resposta única, maior a liderança do Fable 5.2. O Humanity's Last Exam não surpreende: a própria tabela de lançamento da OpenAI já mostrava o Astra atrás do Claude Fable 5.1 nele.
Os destaques da Anthropic apontam na mesma direção. O Fable 5.2 formalizou a prova do Último Teorema de Fermat em Lean em 30 horas com cerca de 1.000 agentes — um projeto que um modelo interno anterior precisou de 11 dias para concluir.
Duas ressalvas antes de tratar isso como definido:
O Fable 5.2 é o modelo mais forte para projetos longos, ambíguos, de pesquisa e análise — e as margens são grandes o suficiente para que uma diferença de harness provavelmente não as elimine.
Programação e workflows com agentes
O Fable 5.2 lidera os dois benchmarks de código que a Anthropic reporta, embora por menos do que em trabalho de conhecimento. No FrontierCode 2.0, que avalia se mantenedores de open source aceitariam as mudanças do modelo, o Fable 5.2 atinge 49,1% em xhigh effort contra 42,8% do Astra.
A Anthropic acrescenta que o Fable 5.2 em high effort supera a melhor pontuação do Astra no FrontierCode a um custo por tarefa semelhante. A tabela de código da OpenAI usa versões mais antigas de benchmarks e compara o Astra com o Fable 5.1, então ainda não há um contracheque do lado da OpenAI. Pelo que há, o Fable 5.2 é melhor para código.
Uso de computador, visão e robótica
O Fable 5.2 lidera em uso de computador e robótica, enquanto a leitura de gráficos fica quase empatada. Robótica é o ponto fora da curva: no RoboDojo Sim, um robô simulado de dois braços, o Fable 5.2 marca 64,9% contra 29,8% do Astra.
A OpenAI chamou o Astra de "o melhor modelo de uso de computador do mundo", mas fez essa afirmação contra o Claude Fable 5.1 e o Claude Opus 5 no OSWorld 2.0. Na versão mais nova da Anthropic, o Fable 5.2 assume a liderança.
Matemática, raciocínio abstrato e contexto longo: os pontos sem resposta do Astra
Os resultados mais fortes do lançamento do Astra estão em benchmarks que a Anthropic não reportou para o Fable 5.2, então não há confronto direto aqui — apenas alegações de um dos lados. O mais claro é a recuperação em contexto longo: o Astra marca 96,3% no teste 8-needle do MRCR v2 da OpenAI, na faixa de 512K a 1M tokens.
A OpenAI também reporta pontuações quase saturadas no FrontierMath Tier 4 e no ARC-AGI-3, embora nosso guia do GPT-6 Astra observe que o resultado do ARC-AGI-3 depende de um harness stateful que chamadas simples de API não têm. Se seu trabalho depende de recuperação em um prompt de um milhão de tokens, o Astra é o único dos dois com evidência publicada.
Salvaguardas e retenção de dados
Ambos os modelos bloqueiam trabalhos ofensivos de cibersegurança por padrão, e diferem mais na retenção de dados do que em recusas. Os classificadores do Fable 5.2 bloqueiam testes de penetração, geração de exploits e a maior parte da biologia em nível de pesquisa, embora a Anthropic diga que ele gera menos bloqueios indevidos do que o Fable 5.1; organizações aprovadas podem solicitar o Claude Mythos 5.2.
A OpenAI classifica o Astra no nível Critical de cibersegurança do seu Preparedness Framework e coloca a criação de exploits atrás do programa Daybreak. O Astra oferece Zero Data Retention para clientes elegíveis da API, enquanto o Fable 5.2 exige retenção de 30 dias para monitoramento de segurança, a menos que a empresa use o Enterprise Frontier Safeguards da Anthropic. Para times regulados que já dependem de zero retenção, o Astra se encaixa mais facilmente.
Preços: o que você realmente paga
O Fable 5.2 é mais barato que o GPT-6 Astra em todas as tarifas que ambos publicam, e a diferença não é uniforme. O Astra custa 1,25x mais para entrada, saída e gravação em cache, mas 5x mais para leituras em cache, e só o Astra adiciona sobretaxa para contexto longo.
Em uma carga de trabalho equilibrada, a diferença é modesta. Ela se torna decisiva quando os prompts são cacheados ou passam de 272K tokens.
Tarifas por token, lado a lado
Ambos listam tarifas padrão por milhão de tokens, além de preços para cache, batch e modo rápido.
A tarifa de leitura em cache é a linha que a maioria dos times vai sentir, porque loops de agentes reencaminham o mesmo prefixo longo a cada passo.
Quanto custa uma carga de trabalho real
Cada linha abaixo é um volume mensal, precificado como (volume ÷ 1M) × tarifa, somado entre entrada e saída.
Nenhum dos fornecedores publicou contagem de tokens para uma carga de trabalho compartilhada, então trate esses totais como comparação de tarifas, não como fatura. Minha execução prática abaixo lembra o porquê: lá, o modelo mais barato por token foi a execução mais cara.
Como o Claude Fable 5.2 e o GPT-6 Astra se saíram
Benchmarks do post de lançamento de um fornecedor têm alcance limitado, então rodei uma tarefa de construção com ambos os modelos, com prompt e ferramental idênticos.
A tarefa: uma página HTML única com um shader de fragmento GLSL animado em tela cheia de um farol em uma costa rochosa durante uma tempestade à noite, com ondas batendo nas rochas, chuva inclinada e nuvens baixas iluminadas por baixo. O feixe do farol tinha que seguir o mouse e iluminar as ondas, a chuva e as nuvens por onde passasse. O p5.js só podia hospedar o canvas, rodar o loop e passar a posição do mouse e o tempo para o shader.
O prompt completo:
O que torna isso difícil:
O post da Anthropic cita Sam Zhang, da Unity, dizendo que os ganhos mais claros do Fable 5.2 estão em "construir cenas 3D de maior qualidade do zero", então este é um teste direto dessa afirmação. Também é uma revanche de certa forma: no nosso comparativo GPT-6 Astra vs Claude Fable 5.1, o Astra venceu um teste de simulação de física contra o Fable anterior.
Ambos os modelos rodaram no OpenCode com uma superfície de ferramentas fixa (apenas ler e editar arquivo), em
higheffort, uma tentativa cada, em sessão nova, com o prompt entregue byte a byte.Aqui estão minhas gravações de tela de ambas as páginas, movendo o mouse pela cena. O Fable primeiro: