
Главные выводы:
- Обе написали настоящий шейдер. Каждая страница вычисляет всю сцену в фрагментном шейдере GLSL, а p5.js лишь размещает канвас и передаёт мышь и время.
- Fable 5.2 построил глубину; Astra — картинку. У Fable волны, скалы и маяк читаются как 3D, с эстетикой чуть «олдскульной» PlayStation — в хорошем смысле. У Astra сцена узнаваема, но очень плоская, а маяк выглядит как чрезмерно упрощённый рисунок красками.
- Лишь луч Fable 5.2 уважает сцену. Когда луч Fable уходит за элемент, тот остаётся тёмным. Луч Astra реагирует на мышь, но менее точно.
- Fable 5.2 выдержал шторм. Здесь сильный дождь, мощные волны и молнии на заднем плане. У Astra — убедительный дождь и в целом неплохие волны, но без молний, с спокойным морем, странными скалами и волнами у берега, которые будто испаряются.
Я оценивал, насколько страница соответствует описанной сцене, качество шейдерной работы, насколько хорошо луч следует за курсором и является ли эффект настоящим фрагментным шейдером. По последнему пункту обе получили максимальные баллы; строки, где они различаются:
| Метрика | Claude Fable 5.2 (high) | GPT-6 Astra (high) |
|---|---|---|
| Стоимость этого прогона (USD) | $4,91 | $1,75 |
| Выходные токены (вкл. рассуждения) | 95 683 | 22 934 |
| Эстетическое соответствие (главный критерий) | 5 | 3 |
| Компетентность в шейдерах | 5 | 4 |
| Интерактивность с курсором | 5 | 4 |
| Оценка по рубрике (среднее по 4 осям) | 5,0 | 3,7 |
Строка со стоимостью — сюрприз. Fable 5.2 дешевле за токен, но израсходовал примерно в четыре раза больше выходных токенов на эту задачу, поэтому запуск стоил почти втрое дороже, чем у Astra.
Claude Fable 5.2 уверенно выигрывает этот тест, и разрыв точно ложится в область, о которой говорилось в цитате из Unity: сцена с реальной глубиной и светом, ведущим себя как свет. Сцена Fable похожа на игру; у Astra — на упрощённую иллюстрацию игры.
Это один прогон одной задачи на одном уровне усилий, и это другой тест, чем физическая симуляция, которую Astra выиграла у Fable 5.1, так что он больше говорит о построении 3D-сцен, чем о моделях в целом.
Когда выбирать Claude Fable 5.2, а когда GPT-6 Astra
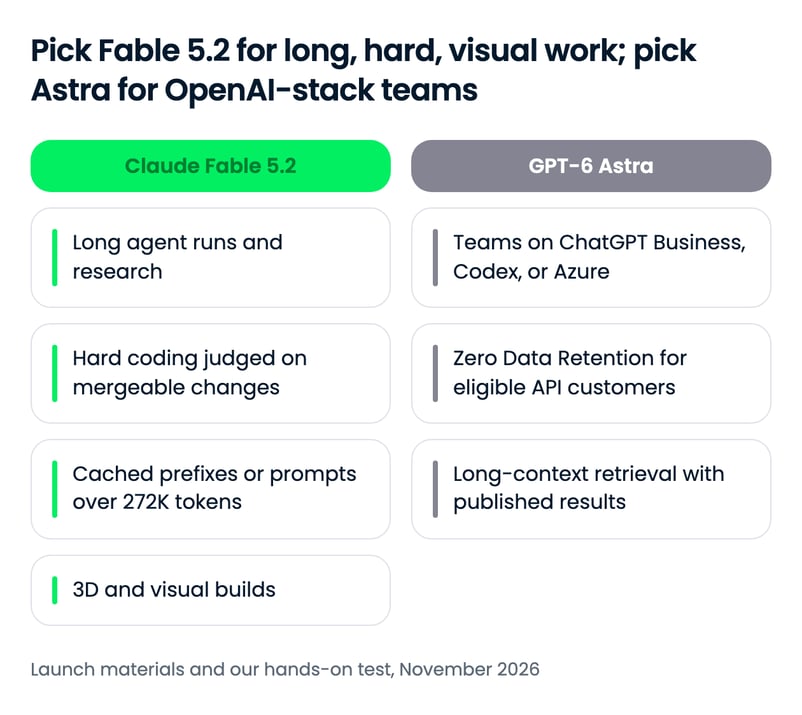
Для большинства технических задач Fable 5.2 — более сильный и более дешёвый выбор за токен. Аргументы в пользу GPT-6 Astra зависят от того, где уже работает ваша команда, и от заявлений OpenAI по математике, абстрактному мышлению и миллионному контексту, на которые Anthropic пока не ответила.
Выберите Claude Fable 5.2, если…
- Ваши агенты работают часами. Преимущество Fable 5.2 максимально в многошаговых проектах вроде Remote Labor Index, а формализация теоремы Ферма в Lean от Anthropic показывает, что модель тянет очень длинную задачу до конца.
- Вам нужен код, который принимают в мейнстрим. Модель лидирует в обоих кодинговых бенчмарках Anthropic, и Anthropic утверждает, что она обходит лучший результат Astra в FrontierCode даже на уровне high.
- Ваши промпты кешируются или очень длинные. Кешированные чтения стоят пятую часть ставки Astra, и нет надбавки свыше 272K токенов.
- Вы строите 3D-сцены, игры или визуальные инструменты. В моём шейдерном тесте это была единственная сцена с настоящей глубиной и освещением, учитывающим геометрию.
Выберите GPT-6 Astra, если…
- Ваша команда уже работает в ChatGPT Business или Enterprise, Codex или Azure. Astra входит в эти подписки, а тарифы Pro, Business и Enterprise также получают GPT-6 Astra Pro.
- Вам нужно нулевое хранение данных. Astra поддерживает его для соответствующих клиентов API, тогда как Fable 5.2 требует 30-дневного хранения, если не настроены Enterprise Frontier Safeguards.
- Ваша работа зависит от извлечения на миллионном промпте. OpenAI опубликовала результаты для Astra по длинному контексту; Anthropic — нет для Fable 5.2.
- Вы запускаете много коротких сборок с ограниченным бюджетом. В моём тесте Astra потратила гораздо меньше токенов и завершила примерно за треть стоимости Fable, с более слабым, но рабочим результатом.
С чего начать с Claude Fable 5.2 и GPT-6 Astra
Обе модели доступны через API вендора, три крупных облака, GitHub Copilot и OpenRouter.
| Площадка | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Пользовательское приложение | Приложения Claude, подходящие платные тарифы (включая Pro и Team) | ChatGPT Plus, Pro, Business, Enterprise (по умолчанию выключено для рабочих пространств Enterprise) |
| Собственный API | Claude Platform | OpenAI API |
| Облачные платформы | AWS (Claude Platform на AWS, Amazon Bedrock), Google Cloud, Microsoft Azure | Microsoft Azure, Amazon Bedrock, Google Cloud |
| Кодинговые агенты | Claude Code, GitHub Copilot | Codex, GitHub Copilot |
| Сторонние роутеры | OpenRouter | OpenRouter |
| ID модели в API | claude-fable-5-2 | gpt-6-astra |
ID моделей — claude-fable-5-2 на Claude Platform и gpt-6-astra в OpenAI API.
Первый вызов API
Самый быстрый способ попробовать обе — OpenRouter, где переключение моделей — это замена одной строки в клиенте, совместимом с OpenAI.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)Для нативных SDK см. наш туториал по API GPT-6 Astra с полноценным агентом и наш гид по Fable 5.2 с уровнями усилий и быстрым режимом.
Итоги
Claude Fable 5.2 сейчас — лучшая модель для большинства сложных технических задач: она опережает GPT-6 Astra во всех общих бенчмарках, стоит меньше за токен и уверенно выиграла мой практический тест. Оговорка: все очные цифры привёл Anthropic, а сильнейшие заявления OpenAI по математике, абстрактному мышлению и миллионному контексту пока не получили ответа от Fable 5.2.
Самым интересным оказался пункт со стоимостью в моём тесте. Fable 5.2 дешевле за токен, но запуск вышел значительно дороже, потому что модель думала и писала намного больше. При переносе нагрузок измеряйте стоимость за задачу, а не за токен.
Если хотите строить решения с любой из моделей, рекомендуем наш курс Introduction to Claude Models и курс Working with the OpenAI API.
Частые вопросы
Claude Fable 5.2 лучше, чем GPT-6 Astra?
В бенчмарках, где оцениваются обе модели, — да. В таблице запуска Anthropic Claude Fable 5.2 опережает GPT-6 Astra по всем общим строкам, включая кодинг, использование компьютера и долгосрочную знаниевую работу, и Fable 5.2 также выиграл наш практический шейдерный тест. OpenAI не публиковала собственного сравнения с Fable 5.2, а у заявлений Astra по математике, абстрактному мышлению и поиску в длинном контексте пока нет аналога для Fable 5.2.
Сколько стоят Claude Fable 5.2 и GPT-6 Astra?
Claude Fable 5.2 стоит $8 за миллион входных токенов и $40 за миллион выходных. GPT-6 Astra стоит $10 и $50. Кешированные чтения стоят $0,20 за миллион токенов у Fable 5.2 и $1,00 у Astra, а Astra берёт 2x за ввод и 1,5x за вывод для запросов свыше 272K входных токенов, тогда как у Fable 5.2 надбавка за длинный контекст не заявлена.
Какая модель лучше для кодинга: Claude Fable 5.2 или GPT-6 Astra?
Claude Fable 5.2 лидирует в обоих кодинговых бенчмарках, которые Anthropic приводит для двух моделей: 49,1% против 42,8% на FrontierCode 2.0 и 69,9% против 65,5% на FrontierSWE v2. Эти оценки получены Anthropic, а не OpenAI. Для команд, уже работающих в Codex или ChatGPT, GPT-6 Astra остаётся более удобным выбором.
Какие ID моделей в API у Claude Fable 5.2 и GPT-6 Astra?
В Claude Platform у Claude Fable 5.2 ID — claude-fable-5-2, а у GPT-6 Astra в OpenAI API — gpt-6-astra. В OpenRouter они указаны как anthropic/claude-fable-5.2 и openai/gpt-6-astra.
Где я могу использовать Claude Fable 5.2 и GPT-6 Astra?
Claude Fable 5.2 доступен в приложениях Claude и Claude Code на подходящих платных тарифах и на Claude Platform. GPT-6 Astra доступен в ChatGPT Plus, Pro, Business и Enterprise, в OpenAI API и в Codex. Обе модели доступны в Microsoft Azure, Amazon Bedrock, GitHub Copilot и Google Cloud.

Том — редактор по Data Science в DataCamp. Он пишет и редактирует обучающие материалы по ИИ, сравнивает новые релизы LLM и создаёт рабочие процессы на основе ИИ. Ранее работал в области науки о данных в Deutsche Telekom. Вне работы занимается прогнозированием футбольных матчей с помощью машинного обучения.
Anthropic выпустила Claude Fable 5.2 9 ноября 2026 года, через два месяца после того, как OpenAI представила GPT-6 Astra как «самую интеллектуальную и выверенную модель в мире». Fable 5.2 также подешевел по сравнению с Fable 5.1, и в сводной таблице запуска Anthropic он опережает Astra по всем строкам, где присутствуют обе модели. Мы не нашли у OpenAI сравнения с Fable 5.2, поэтому закономерный вопрос для тех, кто выбирает передовую модель, — подтверждаются ли эти цифры.
В этой статье мы сравним Claude Fable 5.2 и GPT-6 Astra по длинным циклам знаний, программированию, использованию компьютера, механизмам безопасности и ценам, а затем проведём практическое испытание на сборке.
Чтобы оставаться в курсе событий в сфере ИИ и данных, рекомендуем подписаться на нашу еженедельную рассылку The Median.
Кратко
Что такое Claude Fable 5.2?
Claude Fable 5.2 — модель Anthropic для самых требовательных технических задач; она стала доступна всем пользователям в ноябре 2026 года и построена на той же базе, что и Claude Mythos 5.2, который снимает ограничения Fable на кибербезопасность и биологию для проверенных организаций.
Anthropic позиционирует её для самых амбициозных задач с длинным горизонтом, при этом рекомендует Claude Opus 5.5 как модель по умолчанию для повседневного кодинга и задач на знания.
Наш гид по Claude Fable 5.2 и Mythos 5.2 подробно разбирает запуск.
Что такое GPT-6 Astra?
GPT-6 Astra — флагманская передовая модель OpenAI, выпущенная в сентябре 2026 года как преемник GPT-5.6 Sol.
OpenAI делала упор на использование компьютера и профессиональную работу, а также на «насыщенные» бенчмарки, такие как ARC-AGI-3 и FrontierMath Tier 4, которые изначально были задуманы с запасом относительно возможностей ИИ.
Наш гид по GPT-6 Astra описывает запуск, а в руководстве по API GPT-6 Astra показано, как собрать агента для проверки релизов.
Claude Fable 5.2 vs GPT-6 Astra: сравнение лоб в лоб
Fable 5.2 лидирует во всех бенчмарках, где оценены обе модели — от кодинга до использования компьютера; лишь чтение графиков близко к ничьей. Но есть нюанс: все эти цифры взяты из таблицы запуска Anthropic, потому что собственная таблица OpenAI предшествует Fable 5.2.
Длинные циклы знаний и исследования
Самый большой отрыв у Fable 5.2 — в открытых многошаговых задачах. В Remote Labor Index, который оценивает реальные проекты в стиле фриланса, Fable 5.2 выполняет 41,3% против 20,8% у Astra — почти вдвое больше.
Шаблон сохраняется по всей таблице: чем больше задача похожа на длинный проект, а не на единичный ответ, тем шире отрыв Fable 5.2. Humanity's Last Exam неудивителен: в таблице запуска OpenAI Astra уже уступала Claude Fable 5.1.
Витрина Anthropic указывает в ту же сторону. Fable 5.2 формализовал доказательство Последней теоремы Ферма в Lean за 30 часов примерно с 1000 агентами — проект, на который более ранняя внутренняя исследовательская модель потратила 11 дней.
Два оговорки, прежде чем считать вопрос закрытым:
Fable 5.2 — более сильная модель для длинных, неоднозначных исследовательских и аналитических проектов, и отрыв достаточно велик, чтобы одна лишь разница в окружении вряд ли его закроет.
Кодинг и агентные пайплайны
Fable 5.2 лидирует в обоих кодинговых бенчмарках, о которых сообщает Anthropic, хотя и с меньшим отрывом, чем в знаниевых задачах. В FrontierCode 2.0, где оценивается, примут ли сопровождающие open-source изменения модели, Fable 5.2 набирает 49,1% на уровне xhigh против 42,8% у Astra.
Anthropic добавляет, что Fable 5.2 на уровне high обходит лучший результат Astra в FrontierCode при сопоставимой стоимости за задачу. Собственная таблица OpenAI по кодингу использует более старые версии бенчмарков и сравнивает Astra с Fable 5.1, так что проверки со стороны OpenAI пока нет. По имеющимся данным Fable 5.2 — лучшая модель для кодинга.
Использование компьютера, зрение и робототехника
Fable 5.2 лидирует в задачах использования компьютера и в робототехнике, тогда как по чтению графиков результат близок к ничьей. Робототехника — явный аутсайдер для Astra: в RoboDojo Sim, симуляции двухрукого робота, Fable 5.2 набирает 64,9% против 29,8% у Astra.
OpenAI называла Astra «лучшей в мире моделью для использования компьютера», но это заявление относилось к сравнению с Claude Fable 5.1 и Claude Opus 5 на OSWorld 2.0. В более новой версии у Anthropic Fable 5.2 выходит вперед.
Математика, абстрактное мышление и длинный контекст: необратимые заявления Astra
Сильнейшие результаты запуска Astra приходятся на бенчмарки, по которым Anthropic не приводила данных для Fable 5.2, поэтому прямого сравнения нет — есть лишь односторонние заявления. Самое наглядное — поиск в длинном контексте: Astra набирает 96,3% в 8-игольном тесте MRCR v2 от OpenAI в диапазоне 512K–1M токенов.
OpenAI также сообщает почти насыщенные баллы на FrontierMath Tier 4 и ARC-AGI-3, хотя в нашем руководстве по GPT-6 Astra отмечено, что результат ARC-AGI-3 зависит от «состоящего» стенда, недоступного через обычные API-вызовы. Если ваша работа критично зависит от извлечения на миллионном промпте, опубликованные подтверждения есть только у Astra.
Безопасность и хранение данных
Обе модели по умолчанию блокируют оскорбительные сценарии по кибербезопасности, а сильнее они различаются в политике хранения данных, чем в отказах. Классификаторы Fable 5.2 блокируют пентесты, генерацию эксплойтов и большую часть биологии на исследовательском уровне, хотя Anthropic отмечает меньшее число ложных блокировок по сравнению с Fable 5.1; проверенные организации могут подать заявку на Claude Mythos 5.2.
OpenAI оценивает Astra на критическом пороге кибербезопасности в своей Preparedness Framework и ограничивает создание эксплойтов программой Daybreak. Astra поддерживает нулевое хранение данных (Zero Data Retention) для соответствующих клиентов API, тогда как Fable 5.2 требует 30-дневного хранения для мониторинга безопасности, если только предприятие не использует Enterprise Frontier Safeguards от Anthropic. Для регулируемых команд, полагающихся на нулевое хранение, Astra будет проще.
Цены: сколько вы платите на деле
Fable 5.2 дешевле GPT-6 Astra по всем публикуемым обеими компаниями ставкам, и разрыв неоднороден. У Astra цена выше в 1,25 раза за ввод, вывод и запись в кеш, но в 5 раз выше за чтение из кеша, и только у Astra есть надбавка за длинный контекст.
При сбалансированной нагрузке разница невелика. Она становится решающей, когда промпты кешируются или превышают 272K токенов.
Ставки за токены бок о бок
Обе компании указывают стандартные расценки за миллион токенов, а также цены на кеш, батчи и быстрый режим.
Ставка на кешированное чтение — это строка, которую сильнее всего почувствуют команды, потому что в петлях агентов один и тот же длинный префикс пересылается на каждом шаге.
Сколько стоит реальная нагрузка
Каждая строка ниже — ежемесячный объём, оцененный как (объём ÷ 1M) × ставка, с суммированием по вводу и выводу.
Ни один из вендоров не публиковал токенизацию общей нагрузки, поэтому воспринимайте эти суммы как сравнение ставок, а не счёта. Мой практический прогон ниже напоминает почему: там более дешёвая по токену модель оказалась дороже по запуску.
Как показали себя Claude Fable 5.2 и GPT-6 Astra
Бенчмарков из лонч-поста одного вендора недостаточно, поэтому я запустил одну сборочную задачу на обеих моделях с идентичным промптом и одинаковыми инструментами.
Задача: одна HTML-страница с полноэкранным анимированным шейдером-фрагментом GLSL — маяк на скалистом берегу во время ночного шторма, с набегающими волнами, скошенным дождём и низкими облаками, подсвеченными снизу. Луч маяка должен следовать за мышью и подсвечивать волны, дождь и облака, по которым он проходит. p5.js может только размещать канвас, запускать цикл и передавать позицию мыши и время в шейдер.
Полный промпт:
Что делает задачу сложной:
В посте запуска Anthropic цитирует Сэма Чжана из Unity, который говорит, что самые явные улучшения Fable 5.2 — «построение 3D-сцен более высокого качества с нуля», так что это прямой тест этого тезиса. Это ещё и реванш: в нашем сравнении GPT-6 Astra и Claude Fable 5.1 Astra выиграла тест по физической симуляции у предыдущей версии Fable.
Обе модели запускались в OpenCode с закреплённой поверхностью инструментов (только чтение и редактирование файлов), на уровне рассуждений
high, по одной попытке, в чистой сессии, с промптом, переданным побайтно идентично.Вот записи экрана обеих страниц при движении мыши по сцене. Сначала Fable: