
Główne wnioski:
- Oba napisały prawdziwy shader. Każda strona liczy całą scenę w shaderze fragmentów GLSL, a p5.js tylko hostuje canvas i przekazuje mysz oraz czas.
- Fable 5.2 zbudował głębię; Astra zbudowała obrazek. Fale, skały i latarnia w Fable czytają się jak 3D, z wyglądem nieco starszej gry na PlayStation, w dobrym sensie. Scena Astry jest wyraźnie rozpoznawalna, ale bardzo płaska, a latarnia wygląda jak zbyt uproszczony rysunek farbami.
- Tylko snop Fable 5.2 respektuje scenę. Gdy snop Fable przechodzi za element, ten element pozostaje ciemny. Snop Astry reaguje na mysz, ale mniej precyzyjnie.
- Fable 5.2 postawił na sztorm. Ma ulewny deszcz, silne fale i błyskawice w tle. Astra ma przekonujący deszcz i ogólnie dobre fale, ale bez błyskawic, z spokojnym morzem, dziwnie wyglądającymi skałami i falami przy brzegu, które wyglądają jakby wyparowywały.
Oceniłem oba pod kątem: czy strona wygląda jak opisana scena, jakości pracy shadera, tego, jak dobrze snop podąża za kursorem, oraz czy efekt to prawdziwy shader fragmentów. Ostatnia oś to pełne punkty dla obu; wiersze, w których się różnią:
| Miara | Claude Fable 5.2 (high) | GPT-6 Astra (high) |
|---|---|---|
| Koszt tego przebiegu (USD) | $4.91 | $1.75 |
| Tokeny wyjścia (w tym rozumowanie) | 95 683 | 22 934 |
| Dopasowanie estetyczne (główny rozstrzygacz) | 5 | 3 |
| Kompetencje shaderowe | 5 | 4 |
| Interaktywność kursora | 5 | 4 |
| Wynik wg rubryki (średnia z czterech osi) | 5,0 | 3,7 |
Koszt to zaskoczenie. Fable 5.2 jest tańszy za token, ale zużył ok. cztery razy więcej tokenów wyjścia w tym zadaniu, więc koszt przebiegu był prawie trzykrotnie wyższy niż Astry.
Claude Fable 5.2 wygrywa ten test wyraźnie, a różnica jest dokładnie tam, gdzie wskazywał cytat z Unity: scena z prawdziwą głębią i światłem, które zachowuje się jak światło. Scena Fable wygląda jak gra; scena Astry wygląda jak uproszczona ilustracja gry.
To jeden przebieg jednego zadania przy jednym ustawieniu wysiłku i inny test niż symulacja fizyki, którą Astra wygrała z Fable 5.1, więc mówi to więcej o budowaniu scen 3D niż o obu modelach ogólnie.
Kiedy wybrać Claude Fable 5.2 vs GPT-6 Astra
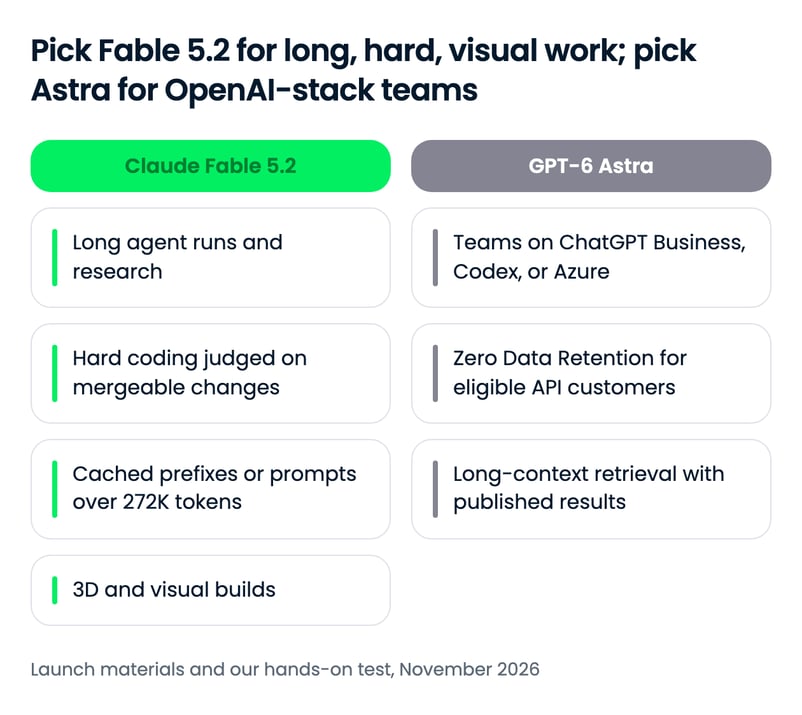
Dla większości zadań technicznych Fable 5.2 to mocniejszy i tańszy wybór w przeliczeniu na token. Przewaga GPT-6 Astra opiera się na tym, gdzie twój zespół już pracuje, oraz na twierdzeniach opublikowanych przez OpenAI, na które Anthropic jeszcze nie odpowiedział.
Wybierz Claude Fable 5.2, jeśli...
- Twoje agenty działają godzinami. Przewagi Fable 5.2 są największe w projektach wieloetapowych jak Remote Labor Index, a formalizacja Twierdzenia Fermata w Lean przez Anthropic pokazuje, że dowozi bardzo długą pracę do końca.
- Potrzebujesz kodu, który trafia do maina. Prowadzi w obu benchmarkach kodowania Anthropic, a Anthropic mówi, że przebija najlepszy wynik Astry na FrontierCode nawet przy wysokim wysiłku.
- Twoje prompty są cache’owane lub bardzo długie. Odczyty z cache kosztują jedną piątą stawki Astry i nie ma dopłaty powyżej 272K tokenów.
- Budujesz sceny 3D, gry lub narzędzia wizualne. W moim teście shadera tylko on stworzył scenę z prawdziwą głębią i światłem respektującym geometrię.
Wybierz GPT-6 Astra, jeśli...
- Twój zespół już pracuje w ChatGPT Business lub Enterprise, Codex albo Azure. Astra jest w tych subskrypcjach, a plany Pro, Business i Enterprise dostają też GPT-6 Astra Pro.
- Potrzebujesz Zero Data Retention. Astra wspiera to dla uprawnionych klientów API, podczas gdy Fable 5.2 wymaga 30 dni retencji, chyba że skonfigurujesz Enterprise Frontier Safeguards.
- Twoja praca zależy od wyszukiwania w promptach rzędu miliona tokenów. OpenAI opublikował wyniki długiego kontekstu dla Astry; Anthropic nie dla Fable 5.2.
- Uruchamiasz wiele krótkich buildów z ograniczonym budżetem. W moim teście Astra zużyła znacznie mniej tokenów i zakończyła za ok. jedną trzecią kosztu Fable, z wynikiem słabszym, ale użytecznym.
Jak zacząć z Claude Fable 5.2 i GPT-6 Astra
Oba modele są dostępne w API dostawców, na trzech głównych chmurach, w GitHub Copilot i na OpenRouter.
| Powierzchnia | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Aplikacja konsumencka | Aplikacje Claude, uprawnione płatne plany (w tym Pro i Team) | ChatGPT Plus, Pro, Business, Enterprise (domyślnie wyłączone dla przestrzeni Enterprise) |
| API pierwszej strony | Claude Platform | OpenAI API |
| Platformy chmurowe | AWS (Claude Platform na AWS, Amazon Bedrock), Google Cloud, Microsoft Azure | Microsoft Azure, Amazon Bedrock, Google Cloud |
| Agenci do kodu | Claude Code, GitHub Copilot | Codex, GitHub Copilot |
| Routery zewnętrzne | OpenRouter | OpenRouter |
| ID modelu w API | claude-fable-5-2 | gpt-6-astra |
ID modeli to claude-fable-5-2 na Claude Platform i gpt-6-astra w OpenAI API.
Pierwsze wywołanie API
Najszybciej sprawdzisz oba przez OpenRouter, gdzie przełączanie modeli to zmiana jednego stringa w kliencie kompatybilnym z OpenAI.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)Dla natywnych SDK nasz samouczek API GPT-6 Astra buduje pełnego agenta, a nasz przewodnik po Fable 5.2 omawia poziomy wysiłku i tryb szybki.
Na zakończenie
Claude Fable 5.2 to obecnie lepszy model do większości wymagających zadań technicznych: prowadzi nad GPT-6 Astra we wszystkich wspólnych benchmarkach, kosztuje mniej za token i wyraźnie wygrał mój test praktyczny. Zastrzeżenie: każdy z tych wyników bezpośredniego starcia pochodzi od Anthropic, a najmocniejsze twierdzenia OpenAI w matematyce, rozumowaniu abstrakcyjnym i wyszukiwaniu w miliontokenowych promptach wciąż nie mają odpowiedzi Fable 5.2.
Najciekawszy jest dla mnie wiersz o koszcie z mojego testu. Fable 5.2 jest tańszy za token, a mimo to kosztował znacznie więcej, bo więcej myślał i więcej pisał. Jeśli przenosisz obciążenia, mierz koszt na zadanie, nie na token.
Jeśli chcesz budować z którymkolwiek modelem, polecam nasz kurs Introduction to Claude Models i kurs Working with the OpenAI API.
FAQ
Czy Claude Fable 5.2 jest lepszy niż GPT-6 Astra?
W benchmarkach, które oceniają oba modele — tak. Tabela premierowa Anthropic stawia Claude Fable 5.2 przed GPT-6 Astra w każdym wspólnym wierszu, w tym w kodowaniu, obsłudze komputera i długohoryzontalnej pracy wiedzoznawczej, a Fable 5.2 wygrał też nasz praktyczny test shadera. OpenAI nie opublikował własnego porównania z Fable 5.2, a wyniki Astry w matematyce, rozumowaniu abstrakcyjnym i długim kontekście nie mają jeszcze odpowiednika dla Fable 5.2.
Ile kosztują Claude Fable 5.2 i GPT-6 Astra?
Claude Fable 5.2 kosztuje $8 za milion tokenów wejścia i $40 za milion tokenów wyjścia. GPT-6 Astra kosztuje odpowiednio $10 i $50. Odczyty z cache kosztują $0,20 za milion tokenów w Fable 5.2 i $1,00 w Astrze, a Astra dolicza 2x stawki wejścia i 1,5x wyjścia dla żądań powyżej 272K tokenów wejścia, podczas gdy Fable 5.2 nie podaje dopłaty za długi kontekst.
Który model jest lepszy do kodowania, Claude Fable 5.2 czy GPT-6 Astra?
Claude Fable 5.2 prowadzi w obu benchmarkach kodowania raportowanych przez Anthropic dla tych modeli: 49,1% vs 42,8% na FrontierCode 2.0 oraz 69,9% vs 65,5% na FrontierSWE v2. Te wyniki pochodzą od Anthropic, nie od OpenAI. Dla zespołów już pracujących w Codex lub ChatGPT, GPT-6 Astra pozostaje wygodniejszym wyborem.
Jakie są ID modeli w API dla Claude Fable 5.2 i GPT-6 Astra?
Claude Fable 5.2 to claude-fable-5-2 na Claude Platform, a GPT-6 Astra to gpt-6-astra w OpenAI API. W OpenRouter to odpowiednio anthropic/claude-fable-5.2 i openai/gpt-6-astra.
Gdzie mogę używać Claude Fable 5.2 i GPT-6 Astra?
Claude Fable 5.2 jest dostępny w aplikacjach Claude i w Claude Code na uprawnionych płatnych planach oraz na Claude Platform. GPT-6 Astra jest dostępna w ChatGPT Plus, Pro, Business i Enterprise, w OpenAI API oraz w Codex. Oba modele są dostępne w Microsoft Azure, Amazon Bedrock, GitHub Copilot i Google Cloud.

Tom jest redaktorem ds. data science w DataCamp. Pisze i redaguje tutoriale o AI, porównuje nowe wydania LLM i tworzy przepływy pracy zasilane przez AI. Wcześniej pracował w obszarze data science w Deutsche Telekom. Po pracy prognozuje wyniki meczów piłkarskich z wykorzystaniem uczenia maszynowego.
Anthropic wypuścił Claude Fable 5.2 9 listopada 2026 r., dwa miesiące po tym, jak OpenAI ogłosił GPT-6 Astra jako „najinteligentniejszy i najlepiej zestrojony model na świecie”. Fable 5.2 wchodzi na rynek z obniżką cen względem Fable 5.1, a tabela premierowa Anthropic stawia go przed Astrą w każdym wierszu, w którym oba modele występują. OpenAI nie opublikował porównania z Fable 5.2, które udało nam się znaleźć, więc naturalne pytanie dla każdego wybierającego model z czołówki brzmi: czy te liczby się potwierdzają?
W tym artykule porównam Claude Fable 5.2 i GPT-6 Astra pod kątem długohoryzontalnej pracy wiedzoznawczej, kodowania, obsługi komputera, zabezpieczeń i cen, a następnie przeprowadzę praktyczne zadanie dla obu.
Żeby być na bieżąco z AI i danymi, polecam subskrypcję naszego cotygodniowego newslettera The Median.
Skrót
Czym jest Claude Fable 5.2?
Claude Fable 5.2 to model Anthropic do najbardziej wymagających zadań technicznych, udostępniony wszystkim użytkownikom w listopadzie 2026 r. i zbudowany na tym samym modelu bazowym co Claude Mythos 5.2, który usuwa zabezpieczenia Fable w zakresie cyberbezpieczeństwa i biologii dla zweryfikowanych organizacji.
Anthropic pozycjonuje go do najbardziej ambitnych, długohoryzontalnych prac technicznych, a jako domyślny model do codziennego kodowania i zadań wiedzoznawczych nadal poleca Claude Opus 5.5.
Nasz przewodnik po Claude Fable 5.2 i Mythos 5.2 opisuje premierę w całości.
Czym jest GPT-6 Astra?
GPT-6 Astra to flagowy model z czołówki OpenAI, wprowadzony we wrześniu 2026 r. jako następca GPT-5.6 Sol.
OpenAI oparł przekaz o obsługę komputera i pracę profesjonalną oraz o saturację benchmarków takich jak ARC-AGI-3 i FrontierMath Tier 4, zaprojektowanych tak, by wyprzedzać modele AI.
Nasz przewodnik po GPT-6 Astra omawia premierę; nasz samouczek API GPT-6 Astra przeprowadza przez budowę agenta do sprawdzania wydań.
Claude Fable 5.2 vs GPT-6 Astra: bezpośrednie porównanie
Fable 5.2 prowadzi we wszystkich benchmarkach, które oceniają oba modele, od kodowania po obsługę komputera, a jedynie odczyt wykresów jest blisko remisu. Haczyk tkwi w źródle: wszystkie te liczby pochodzą z tabeli premierowej Anthropic, bo tabela OpenAI powstała przed Fable 5.2.
Długohoryzontalna praca wiedzoznawcza i badania
Największa przewaga Fable 5.2 dotyczy otwartej, wieloetapowej pracy. W Remote Labor Index, który ocenia prawdziwe projekty w stylu freelancerskim, Fable 5.2 kończy 41,3% wobec 20,8% Astry, czyli mniej więcej dwa razy więcej.
Wzorzec utrzymuje się w całej tabeli: im bardziej zadanie przypomina długi projekt niż pojedynczą odpowiedź, tym większa przewaga Fable 5.2. Humanity's Last Exam nie zaskakuje: własna tabela premierowa OpenAI pokazała już, że Astra ustępuje Claude Fable 5.1.
Prezentacje Anthropic wskazują to samo. Fable 5.2 sformalizował dowód Wielkiego Twierdzenia Fermata w Lean w 30 godzin przy użyciu ok. 1000 agentów, podczas gdy wcześniejszy wewnętrzny model badawczy potrzebował na to 11 dni.
Dwa zastrzeżenia, zanim uznasz to za przesądzone:
Fable 5.2 jest silniejszym modelem do długich, niejednoznacznych projektów badawczych i analitycznych, a różnice są na tyle duże, że sam sposób uruchomienia raczej ich nie zniweluje.
Kodowanie i przepływy agentowe
Fable 5.2 prowadzi w obu benchmarkach kodowania raportowanych przez Anthropic, choć różnica jest mniejsza niż w pracy wiedzoznawczej. W FrontierCode 2.0, który sprawdza, czy maintainerzy open source zmergowaliby zmiany modelu, Fable 5.2 osiąga 49,1% przy wysiłku xhigh wobec 42,8% Astry.
Anthropic dodaje, że Fable 5.2 przy wysokim wysiłku przebija najlepszy wynik Astry na FrontierCode przy zbliżonym koszcie na zadanie. Własna tabela OpenAI dla kodowania używa starszych wersji benchmarków i porównuje Astrę z Fable 5.1, więc po stronie OpenAI nie ma jeszcze weryfikacji. Na dostępnych danych Fable 5.2 jest lepszym modelem do kodowania.
Obsługa komputera, wizja i robotyka
Fable 5.2 prowadzi w obsłudze komputera i robotyce, a odczyt wykresów jest blisko remisu. Robotyka to wyjątek: w RoboDojo Sim, symulowanym robocie z dwiema ramionami, Fable 5.2 zdobywa 64,9% wobec 29,8% Astry.
OpenAI nazwał Astrę „najlepszym na świecie modelem do obsługi komputera”, ale twierdzenie to dotyczyło Claude Fable 5.1 i Claude Opus 5 na OSWorld 2.0. W nowszej wersji Anthropic, Fable 5.2 przejmuje prowadzenie.
Matematyka, rozumowanie abstrakcyjne i długi kontekst: nieodpowiedziane twierdzenia Astry
Najmocniejsze wyniki Astry z premiery dotyczą benchmarków, których Anthropic nie raportował dla Fable 5.2, więc nie ma tu bezpośredniego starcia, tylko twierdzenia jednej strony. Najbardziej klarowny jest długi kontekst: Astra uzyskuje 96,3% w teście MRCR v2 8-needle OpenAI w paśmie 512K–1M tokenów.
OpenAI raportuje też wyniki bliskie nasyceniu na FrontierMath Tier 4 i ARC-AGI-3, choć nasz przewodnik po GPT-6 Astra zauważa, że wynik ARC-AGI-3 zależy od stanowego harnessa, którego nie ma w zwykłych wywołaniach API. Jeśli twoja praca opiera się na wyszukiwaniu w promptach rzędu miliona tokenów, tylko Astra ma na to opublikowane dowody.
Zabezpieczenia i retencja danych
Oba modele domyślnie blokują ofensywne prace z zakresu cyberbezpieczeństwa, a bardziej różnią się retencją danych niż odmowami. Klasyfikatory Fable 5.2 blokują testy penetracyjne, generowanie exploitów i większość badań na poziomie biologii, choć Anthropic twierdzi, że generuje mniej niepotrzebnych blokad niż Fable 5.1; zweryfikowane organizacje mogą zamiast tego wnioskować o Claude Mythos 5.2.
OpenAI ocenia Astrę na krytycznym progu cyberbezpieczeństwa w swoim Preparedness Framework i ogranicza tworzenie exploitów w programie Daybreak. Astra wspiera Zero Data Retention dla uprawnionych klientów API, podczas gdy Fable 5.2 wymaga 30-dniowej retencji na potrzeby monitorowania bezpieczeństwa, chyba że przedsiębiorstwo korzysta z Enterprise Frontier Safeguards Anthropic. Dla zespołów regulowanych, które już polegają na zerowej retencji, Astra będzie łatwiejsza.
Ceny: ile faktycznie zapłacisz
Fable 5.2 jest tańszy niż GPT-6 Astra we wszystkich stawkach publikowanych przez obu dostawców, ale różnica nie jest równomierna. Astra kosztuje 1,25x więcej za wejście, wyjście i zapisy do cache, ale aż 5x więcej za odczyty z cache i tylko Astra dolicza dopłatę za długi kontekst.
Przy zwykłym zbalansowanym obciążeniu różnica jest umiarkowana. Staje się czynnikiem decydującym, gdy prompty są cache’owane lub przekraczają 272K tokenów.
Stawki za token obok siebie
Obaj dostawcy podają standardowe stawki za milion tokenów oraz ceny dla cache, batch i trybu szybkiego.
Stawka za odczyt z cache to pozycja, którą większość zespołów odczuje, bo pętle agentów wysyłają ten sam długi prefiks przy każdym kroku.
Ile kosztuje realne obciążenie
Każdy wiersz poniżej to miesięczna wielkość, wyceniona jako (wolumen ÷ 1M) × stawka, zsumowana dla wejścia i wyjścia.
Żaden z dostawców nie opublikował liczby tokenów dla wspólnego obciążenia, więc traktuj te sumy jako porównanie stawek, a nie rachunek. Mój praktyczny przebieg poniżej przypomina dlaczego: tam tańszy model za token okazał się droższym uruchomieniem.
Jak wypadły Claude Fable 5.2 i GPT-6 Astra
Benchmarki z wpisu jednego dostawcy mówią tylko tyle, więc uruchomiłem jedno zadanie budowy dla obu modeli z identycznym promptem i identycznymi narzędziami.
Zadanie: pojedyncza strona HTML z pełnoekranowym animowanym shaderem fragmentów GLSL latarni morskiej na skalistym wybrzeżu podczas nocnej burzy, z toczącymi się falami rozbijającymi się o skały, ukośnym deszczem i niskimi chmurami podświetlonymi od dołu. Snop latarni miał podążać za myszą i rozświetlać fale, deszcz i chmury, po których przechodzi. p5.js mógł jedynie hostować canvas, uruchomić pętlę i przekazać pozycję myszy oraz czas do shadera.
Pełny prompt:
Co czyni to trudnym:
W poście premierowym Anthropic cytuje Sama Zhanga z Unity, który mówi, że najczytelniejsze zyski Fable 5.2 to „budowanie wyższej jakości scen 3D od zera”, więc to bezpośredni test tego twierdzenia. To też pewien rewanż: w naszym porównaniu GPT-6 Astra vs Claude Fable 5.1 Astra wygrała test symulacji fizyki z poprzednim Fable.
Oba modele uruchomiłem w OpenCode z przypiętą powierzchnią narzędzia (tylko odczyt i edycja plików), przy wysiłku
high, po jednej próbie, w świeżej sesji, z promptem dostarczonym bajt w bajt.Oto moje nagrania ekranu obu stron, z ruchem myszy po scenie. Najpierw Fable: