
Die wichtigsten Erkenntnisse:
- Beide haben einen echten Shader geschrieben. Jede Seite berechnet die gesamte Szene in einem GLSL-Fragment-Shader; p5.js hostet nur die Canvas und übergibt Maus und Zeit.
- Fable 5.2 hat Tiefe gebaut; Astra hat ein Bild gebaut. Fables Wellen, Felsen und Leuchtturm lesen sich als 3D – mit dem Look eines etwas älteren PlayStation-Spiels, im positiven Sinn. Astras Szene ist klar erkennbar, aber sehr flach, und der Leuchtturm wirkt wie eine zu einfache Malvorlage.
- Nur Fable 5.2s Lichtstrahl respektiert die Szene. Schwenkt Fables Strahl hinter ein Element, bleibt dieses dunkel. Astras Strahl reagiert auf die Maus, aber weniger präzise.
- Fable 5.2 hat den Sturm ernst genommen. Es gibt starken Regen, kräftige Wellen und Blitze im Hintergrund. Astra hat überzeugenden Regen und generell gute Wellen, aber keine Blitze, ein ruhiges Meer, seltsam wirkende Felsen und Uferwellen, die aussehen, als würden sie verdampfen.
Ich habe beide danach bewertet, ob die Seite wie die beschriebene Szene aussieht, nach der Qualität der Shader-Arbeit, wie gut der Strahl dem Cursor folgt und ob der Effekt ein echter Fragment-Shader ist. Beim letzten Punkt gab es für beide volle Punktzahl. Die Zeilen mit Unterschieden:
| Messgröße | Claude Fable 5.2 (high) | GPT-6 Astra (high) |
|---|---|---|
| Kosten dieses Laufs (USD) | $4,91 | $1,75 |
| Output-Tokens (inkl. Reasoning) | 95.683 | 22.934 |
| Ästhetische Übereinstimmung (Hauptkriterium) | 5 | 3 |
| Shader-Kompetenz | 5 | 4 |
| Cursor-Interaktivität | 5 | 4 |
| Rubrik-Score (Mittel der vier Achsen) | 5,0 | 3,7 |
Die Kostenzeile ist die Überraschung. Fable 5.2 ist pro Token günstiger, hat hier aber rund viermal so viele Output-Tokens verbraucht. Deshalb war der Lauf fast dreimal so teuer wie bei Astra.
Claude Fable 5.2 gewinnt diesen Test klar – und genau an der Stelle, die das Unity-Zitat genannt hat: eine Szene mit echter Tiefe und einem Licht, das sich wie Licht verhält. Fables Szene wirkt wie ein Spiel; Astras wie eine vereinfachte Illustration davon.
Das ist ein einzelner Lauf einer einzelnen Aufgabe bei einer Aufwandsstufe – und ein anderer Test als die Physik-Simulation, die Astra gegen Fable 5.1 gewann. Es sagt also mehr über 3D-Szenenbau aus als über die Modelle insgesamt.
Wann du Claude Fable 5.2 vs GPT-6 Astra wählen solltest
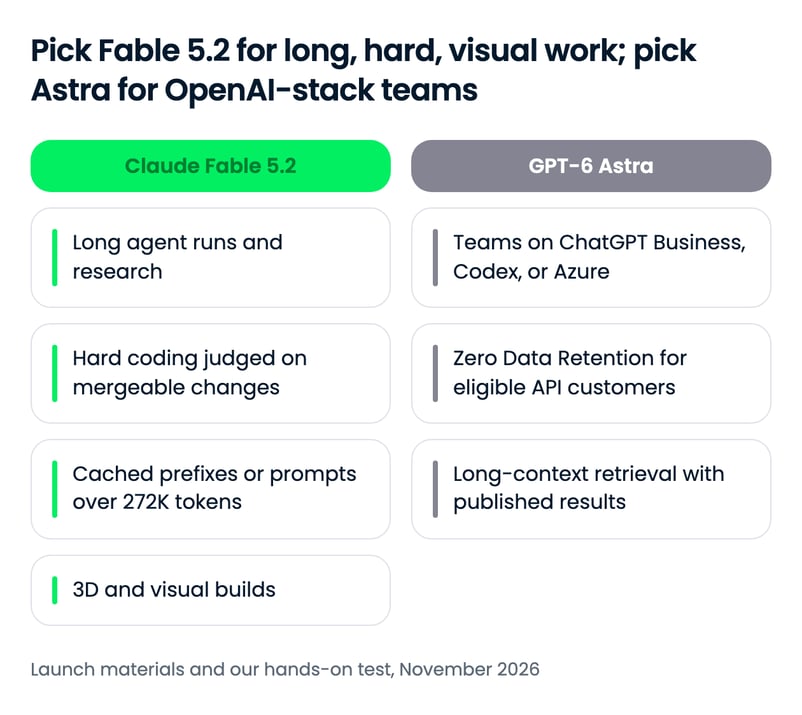
Für die meisten technischen Aufgaben ist Fable 5.2 die stärkere und pro Token günstigere Wahl. Der Case für GPT-6 Astra hängt davon ab, wo dein Team bereits arbeitet und auf welchen Claims OpenAI veröffentlicht hat, die Anthropic noch nicht beantwortet hat.
Wähle Claude Fable 5.2, wenn ...
- Deine Agenten stundenlang laufen. Fable 5.2s Vorsprung ist am größten bei mehrstufigen Projekten wie dem Remote Labor Index, und Anthropics Lean-Formalisation von Fermats letztem Satz zeigt, dass es sehr lange Jobs bis zum Ende tragen kann.
- Du Code brauchst, der gemergt wird. Es führt beide von Anthropic gemeldeten Coding-Benchmarks, und Anthropic sagt, dass es Astras beste FrontierCode-Leistung sogar bei hohem Aufwand schlägt.
- Deine Prompts gecacht oder sehr lang sind. Gecachte Reads kosten ein Fünftel von Astras Tarif, und es gibt keinen Zuschlag über 272K Tokens.
- Du 3D-Szenen, Spiele oder visuelle Tools baust. Im Shader-Test war es das einzige Modell mit echter Tiefe und Geometrie-respektierendem Licht.
Wähle GPT-6 Astra, wenn ...
- Dein Team bereits in ChatGPT Business oder Enterprise, Codex oder Azure arbeitet. Astra ist in diesen Abos enthalten, und Pro-, Business- und Enterprise-Pläne bekommen auch GPT-6 Astra Pro.
- Du Zero Data Retention brauchst. Astra unterstützt das für berechtigte API-Kunden, während Fable 5.2 30 Tage Aufbewahrung verlangt, sofern du nicht Enterprise Frontier Safeguards einrichtest.
- Deine Arbeit Retrieval über eine Million Tokens braucht. OpenAI hat Langkontext-Retrieval-Ergebnisse für Astra veröffentlicht; Anthropic nicht für Fable 5.2.
- Du viele kurze Builds mit knappem Budget fährst. In meinem Test verbrauchte Astra deutlich weniger Tokens und kam mit etwa einem Drittel der Kosten von Fable ins Ziel – schwächer, aber brauchbar.
So startest du mit Claude Fable 5.2 und GPT-6 Astra
Beide Modelle sind über die API des jeweiligen Anbieters, die drei großen Clouds, GitHub Copilot und OpenRouter verfügbar.
| Surface | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Consumer-App | Claude-Apps, berechtigte kostenpflichtige Pläne (inklusive Pro und Team) | ChatGPT Plus, Pro, Business, Enterprise (für Enterprise-Workspaces standardmäßig aus) |
| First-Party-API | Claude Platform | OpenAI API |
| Cloud-Plattformen | AWS (Claude Platform auf AWS, Amazon Bedrock), Google Cloud, Microsoft Azure | Microsoft Azure, Amazon Bedrock, Google Cloud |
| Coding-Agenten | Claude Code, GitHub Copilot | Codex, GitHub Copilot |
| Drittanbieter-Router | OpenRouter | OpenRouter |
| API-Model-ID | claude-fable-5-2 | gpt-6-astra |
Die Model-IDs sind claude-fable-5-2 auf der Claude Platform und gpt-6-astra auf der OpenAI API.
Deinen ersten API-Call machen
Am schnellsten probierst du beide über OpenRouter aus. Dort ist der Modellwechsel nur eine Zeichenkette in einem OpenAI-kompatiblen Client.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)Für die nativen SDKs baut unser GPT-6 Astra API-Tutorial einen vollständigen Agenten, und unsere Fable-5.2-Übersicht erklärt Aufwandsstufen und Schnellmodus.
Fazit
Claude Fable 5.2 ist derzeit für die meisten anspruchsvollen technischen Aufgaben das bessere Modell: Es liegt bei allen gemeinsamen Benchmarks vor GPT-6 Astra, kostet weniger pro Token und hat meinen Praxistest klar gewonnen. Die Einschränkung: Jede dieser direkten Vergleichszahlen stammt von Anthropic, und OpenAIs stärkste Claims zu Mathe, abstraktem Denken und Retrieval über eine Million Tokens sind noch unbeantwortet.
Am interessantesten finde ich die Kostenzeile aus meinem Test. Fable 5.2 ist pro Token günstiger und lief trotzdem deutlich teurer, weil es so viel mehr gedacht und geschrieben hat. Wenn du Workloads umziehst, miss Kosten pro Aufgabe, nicht pro Token.
Wenn du mit einem der beiden Modelle loslegen willst, empfehle ich unseren Kurs Introduction to Claude Models und unseren Kurs Working with the OpenAI API.
FAQs
Ist Claude Fable 5.2 besser als GPT-6 Astra?
Bei den Benchmarks, die beide Modelle bewerten, ja. Anthropics Launch-Tabelle sieht Claude Fable 5.2 vor GPT-6 Astra in jeder gemeinsamen Zeile, darunter Coding, Computerbedienung und langlaufende Wissensarbeit. Fable 5.2 hat auch unseren praktischen Shader-Test gewonnen. OpenAI hat noch keinen eigenen Vergleich mit Fable 5.2 veröffentlicht, und Astras Ergebnisse zu Mathe, abstraktem Denken und Langkontext-Retrieval haben noch kein Gegenstück von Fable 5.2.
Was kosten Claude Fable 5.2 und GPT-6 Astra?
Claude Fable 5.2 kostet $8 pro Million Input-Tokens und $40 pro Million Output-Tokens. GPT-6 Astra kostet $10 bzw. $50. Gecachte Reads kosten bei Fable 5.2 $0,20 pro Million Tokens und bei Astra $1,00. Astra berechnet für Anfragen über 272K Input-Tokens 2x Input und 1,5x Output, während Fable 5.2 keinen Langkontext-Zuschlag ausweist.
Welches ist besser für Coding, Claude Fable 5.2 oder GPT-6 Astra?
Claude Fable 5.2 führt bei beiden Coding-Benchmarks, die Anthropic für die beiden Modelle meldet: 49,1% vs. 42,8% bei FrontierCode 2.0 und 69,9% vs. 65,5% bei FrontierSWE v2. Diese Werte stammen von Anthropic, nicht von OpenAI. Für Teams, die bereits mit Codex oder ChatGPT arbeiten, bleibt GPT-6 Astra die bequemere Wahl.
Wie lauten die API-Model-IDs für Claude Fable 5.2 und GPT-6 Astra?
Claude Fable 5.2 ist claude-fable-5-2 auf der Claude Platform, und GPT-6 Astra ist gpt-6-astra auf der OpenAI API. Auf OpenRouter heißen sie anthropic/claude-fable-5.2 und openai/gpt-6-astra.
Wo kann ich Claude Fable 5.2 und GPT-6 Astra nutzen?
Claude Fable 5.2 ist in den Claude-Apps und in Claude Code auf berechtigten, kostenpflichtigen Plänen sowie auf der Claude Platform verfügbar. GPT-6 Astra ist in ChatGPT Plus, Pro, Business und Enterprise, über die OpenAI API und in Codex verfügbar. Beide gibt es auf Microsoft Azure, Amazon Bedrock, GitHub Copilot und Google Cloud.

Tom ist Redakteur für Data Science bei DataCamp. Er schreibt und redigiert KI-Tutorials, vergleicht neue LLM-Releases und entwickelt KI-gestützte Workflows. Zuvor arbeitete er im Data-Science-Bereich bei der Deutschen Telekom. Abseits der Arbeit sagt er Fußballspiele mit Machine Learning voraus.



Anthropic hat Claude Fable 5.2 am 9. November 2026 veröffentlicht, zwei Monate nachdem OpenAI GPT-6 Astra als "das weltweit intelligenteste und am besten ausgerichtete Modell" vorgestellt hatte. Fable 5.2 kommt mit einer Preissenkung gegenüber Fable 5.1, und in Anthropics Launch-Tabelle liegt es in jeder Zeile vorne, in der beide Modelle auftauchen. OpenAI hat bislang keinen Vergleich mit Fable 5.2 veröffentlicht, den wir finden konnten. Für alle, die ein Spitzenmodell auswählen, stellt sich also die Frage, ob diese Zahlen standhalten.
In diesem Artikel vergleiche ich Claude Fable 5.2 und GPT-6 Astra bei langlaufender Wissensarbeit, Coding, Computerbedienung, Sicherheitsmechanismen und Preisen und lasse anschließend beide ein praktisches Build bewerkstelligen.
Wenn du in der KI- und Datenwelt am Ball bleiben willst, abonniere unseren wöchentlichen Newsletter The Median.
TL;DR
Was ist Claude Fable 5.2?
Claude Fable 5.2 ist Anthropics Modell für die anspruchsvollste technische Arbeit. Es wurde im November 2026 für alle Nutzer freigegeben und basiert auf demselben Grundmodell wie Claude Mythos 5.2, das Fables Sicherheitsmechanismen für Cybersecurity und Biologie für geprüfte Organisationen aufhebt.
Anthropic positioniert es für besonders ambitionierte, langlaufende technische Projekte und empfiehlt weiterhin Claude Opus 5.5 als Standard für alltägliche Coding- und Wissensaufgaben.
Unsere Übersicht zu Claude Fable 5.2 und Mythos 5.2 deckt den Launch vollständig ab.
Was ist GPT-6 Astra?
GPT-6 Astra ist OpenAIs Spitzenmodell an der vordersten Front, im September 2026 als Nachfolger von GPT-5.6 Sol gestartet.
OpenAI hat den Schwerpunkt auf Computerbedienung und professionelle Arbeit gelegt – und auf das Erreichen von Benchmarks wie ARC-AGI-3 und FrontierMath Tier 4, die eigentlich dazu gedacht waren, KI-Modelle auf Abstand zu halten.
Unsere GPT-6 Astra-Übersicht begleitet den Launch, unser GPT-6 Astra API-Tutorial führt Schritt für Schritt durch den Bau eines Release-Check-Agenten.
Claude Fable 5.2 vs GPT-6 Astra: Direktvergleich
Fable 5.2 führt bei jedem Benchmark, der beide Modelle bewertet – von Coding bis Computerbedienung, nur das Lesen von Charts ist nahezu ein Unentschieden. Der Haken: Die Quelle. Alle Zahlen stammen aus Anthropics Launch-Tabelle, weil OpenAIs eigene Tabelle älter ist als Fable 5.2.
Langlaufende Wissensarbeit und Research
Fable 5.2s größter Vorsprung liegt bei offenen, mehrstufigen Aufgaben. Beim Remote Labor Index, der echte freiberufliche Projekte bewertet, schließt Fable 5.2 41,3% ab gegenüber 20,8% bei Astra – in etwa doppelt so viel.
Das Muster zieht sich durch: Je mehr eine Aufgabe wie ein langes Projekt statt wie eine einzelne Antwort aussieht, desto größer ist Fable 5.2s Vorsprung. Humanity's Last Exam überrascht nicht: OpenAIs eigene Launch-Tabelle zeigte bereits Astra hinter Claude Fable 5.1.
Auch Anthropics Showcase weist in dieselbe Richtung. Fable 5.2 hat den Beweis von Fermats letztem Satz in Lean in 30 Stunden mit rund 1.000 Agenten formalisiert – ein Projekt, für das ein früheres internes Forschungsmodell 11 Tage brauchte.
Zwei Vorbehalte, bevor du das als entschieden verbuchst:
Fable 5.2 ist das stärkere Modell für lange, unklare Research- und Analyseprojekte, und die Abstände sind so groß, dass allein ein anderer Harness sie kaum schließen dürfte.
Coding und agentische Workflows
Fable 5.2 führt beide Coding-Benchmarks, die Anthropic meldet – wenn auch mit geringeren Abständen als bei Wissensarbeit. Bei FrontierCode 2.0, wo bewertet wird, ob Open-Source-Maintainer die Änderungen eines Modells mergen würden, erreicht Fable 5.2 bei xhigh 49,1% gegenüber 42,8% bei Astra.
Anthropic ergänzt, dass Fable 5.2 bei hohem Aufwand Astras beste FrontierCode-Leistung zum ähnlich hohen Task-Preis schlägt. OpenAIs eigene Coding-Tabelle nutzt ältere Benchmark-Versionen und vergleicht Astra mit Fable 5.1, daher gibt es noch keinen OpenAI-Check. Nach aktuellem Stand ist Fable 5.2 das bessere Coding-Modell.
Computerbedienung, Vision und Robotik
Fable 5.2 führt bei Computerbedienung und Robotik, während das Lesen von Charts nahezu gleichauf ist. Robotik ist der Ausreißer: Auf RoboDojo Sim, einem simulierten Zweiarm-Roboter, erzielt Fable 5.2 64,9% gegenüber 29,8% bei Astra.
OpenAI nannte Astra "das weltweit beste Modell für Computerbedienung", bezog sich damit aber auf Claude Fable 5.1 und Claude Opus 5 auf OSWorld 2.0. Auf Anthropics neuerer Version liegt Fable 5.2 vorne.
Mathe, abstraktes Denken und langer Kontext: Offene Astra-Ansprüche
Astras stärkste Launch-Ergebnisse liegen auf Benchmarks, die Anthropic für Fable 5.2 nicht gemeldet hat. Es gibt also keinen direkten Vergleich, nur Aussagen einer Seite. Am klarsten ist das Langkontext-Retrieval: Astra erreicht 96,3% auf OpenAIs MRCR v2 8-Needle-Test im Bereich 512K bis 1 Mio. Tokens.
OpenAI meldet außerdem nahezu gesättigte Werte auf FrontierMath Tier 4 und ARC-AGI-3. Unsere GPT-6-Astra-Übersicht weist jedoch darauf hin, dass der ARC-AGI-3-Wert von einem zustandsbehafteten Harness abhängt, der bei einfachen API-Calls nicht zur Verfügung steht. Wenn deine Arbeit von Retrieval über eine Million Tokens abhängt, ist Astra das einzige der beiden Modelle mit veröffentlichten Ergebnissen.
Safeguards und Datenaufbewahrung
Beide Modelle blockieren offensive Cybersecurity-Arbeit standardmäßig. Sie unterscheiden sich stärker bei der Datenaufbewahrung als bei Verweigerungen. Fable 5.2 blockiert per Klassifikatoren Penetrationstests, Exploit-Generierung und die meiste biologiebezogene Forschung auf Forschungsniveau. Anthropic sagt, es gebe weniger unnötige Blocks als bei Fable 5.1. Geprüfte Organisationen können stattdessen Claude Mythos 5.2 beantragen.
OpenAI stuft Astra auf der Kritisch-Schwelle seines Preparedness Frameworks für Cybersecurity ein und schützt Exploit-Erstellung hinter dem Daybreak-Programm. Astra unterstützt Zero Data Retention für berechtigte API-Kunden, während Fable 5.2 eine 30-tägige Aufbewahrung für Sicherheitsmonitoring verlangt – es sei denn, ein Unternehmen nutzt Anthropics Enterprise Frontier Safeguards. Für regulierte Teams, die bereits auf Nullaufbewahrung setzen, passt Astra einfacher.
Preise: Was du tatsächlich zahlst
Fable 5.2 ist bei allen von beiden Anbietern veröffentlichten Tarifen günstiger als GPT-6 Astra – und die Lücke ist nicht überall gleich. Astra kostet für Input, Output und Cache-Writes das 1,25-Fache, für gecachte Reads jedoch das 5-Fache, und nur Astra erhebt einen Langkontext-Zuschlag.
Bei einer ausgewogenen Last ist der Unterschied moderat. Entscheidend wird er, sobald Prompts gecacht werden oder über 272K Tokens hinausgehen.
Token-Tarife im direkten Vergleich
Beide Anbieter listen Standardpreise pro Million Tokens sowie Preise für Cache, Batch und Schnellmodus.
Die Rate für gecachte Reads werden die meisten Teams spüren, weil Agenten in jeder Schleife denselben langen Prefix erneut senden.
Was eine echte Last kostet
Jede Zeile unten ist ein Monatsvolumen, berechnet als (Volumen ÷ 1 Mio.) × Tarif, summiert über Input und Output.
Keiner der Anbieter hat Tokenzahlen für eine gemeinsame Last veröffentlicht. Behandle diese Summen daher als Tarifvergleich, nicht als Rechnung. Mein Praxislauf unten erinnert daran, warum: Dort war das günstigere Modell pro Token der teurere Lauf.
Wie sich Claude Fable 5.2 und GPT-6 Astra geschlagen haben
Benchmarks aus einem Launch-Post eines Anbieters reichen nur begrenzt. Deshalb habe ich einen Build-Task gegen beide Modelle laufen lassen – mit identischem Prompt und identischen Tools.
Die Aufgabe: Eine einzelne HTML-Seite mit einem Vollbild-GLSL-Fragment-Shader für einen Leuchtturm an einer felsigen Küste während eines Nachtsturms – mit rollenden Wellen, die an den Felsen brechen, schrägem Regen und tiefen Wolken, die von unten beleuchtet sind. Der Leuchtturmstrahl sollte der Maus folgen und Wellen, Regen und Wolken erhellen, wo er entlangfährt. p5.js durfte nur die Canvas hosten, die Schleife laufen lassen und Mausposition sowie Zeit in den Shader geben.
Der vollständige Prompt:
Warum das schwer ist:
Anthropics Launch-Post zitiert Unitys Sam Zhang, wonach Fable 5.2s deutlichste Fortschritte beim "Bauen hochwertiger 3D-Szenen von Grund auf" liegen. Genau das testet diese Aufgabe direkt. Es ist auch ein kleines Rematch: In unserem Vergleich GPT-6 Astra vs Claude Fable 5.1 gewann Astra einen Physik-Simulationstest gegen den vorherigen Fable.
Beide Modelle liefen in OpenCode mit festgelegter Tool-Oberfläche (nur Datei lesen und bearbeiten), bei
highReasoning-Aufwand, je ein Versuch, frische Session, Prompt bytegenau identisch.Hier sind meine Bildschirmaufnahmen beider Seiten, während ich die Maus über die Szene bewege. Fable zuerst: