
De belangrijkste bevindingen:
- Beiden schreven een echte shader. Elke pagina berekent de hele scène in een GLSL-fragmentshader, met p5.js alleen om het canvas te hosten en muis en tijd door te geven.
- Fable 5.2 bouwde diepte; Astra bouwde een plaatje. Fable’s golven, rotsen en vuurtoren lezen als 3D, met de look van een wat ouder PlayStation-spel — in positieve zin. Astra’s scène is duidelijk herkenbaar, maar erg vlak, en de vuurtoren lijkt op een te simpele verftekening.
- Alleen Fable 5.2’s bundel respecteert de scène. Als Fable’s bundel achter een element zwaait, blijft dat element donker. Astra’s bundel reageert op de muis, maar minder precies.
- Fable 5.2 committeerde aan de storm. Het heeft zware regen, sterke golven en bliksem op de achtergrond. Astra heeft overtuigende regen en over het algemeen goede golven, maar geen bliksem, een kalme zee, vreemd ogende rotsen en golven bij de kust die lijken te verdampen.
Ik scoorde beide op of de pagina lijkt op de beschreven scène, de kwaliteit van het shaderwerk, hoe goed de bundel de cursor volgt, en of het effect een echte fragmentshader is. Beiden kregen volle punten op die laatste as; de rijen waar ze verschillen:
| Maatstaf | Claude Fable 5.2 (high) | GPT-6 Astra (high) |
|---|---|---|
| Kosten van deze run (USD) | $4,91 | $1,75 |
| Outputtokens (incl. redeneren) | 95.683 | 22.934 |
| Esthetische match (primaire discriminator) | 5 | 3 |
| Shadercompetentie | 5 | 4 |
| Cursorinteractiviteit | 5 | 4 |
| Rubriekscore (gemiddelde van vier assen) | 5,0 | 3,7 |
De kostenrij is de verrassing. Fable 5.2 is goedkoper per token, maar verstookte ongeveer vier keer zoveel outputtokens op deze taak, dus de run kostte bijna drie keer zoveel als Astra’s.
Claude Fable 5.2 wint deze test duidelijk, en de kloof valt precies waar Unity’s quote het voorspelde: een scène met echte diepte en licht dat zich gedraagt als licht. Fable’s scène oogt als een game; Astra’s als een vereenvoudigde illustratie ervan.
Dit is één run van één taak op één inspanningsniveau, en een andere test dan de natuurkundesimulatie die Astra won tegen Fable 5.1, dus het zegt meer over 3D-scènebouw dan over de twee modellen in het algemeen.
Wanneer kies je Claude Fable 5.2 vs GPT-6 Astra
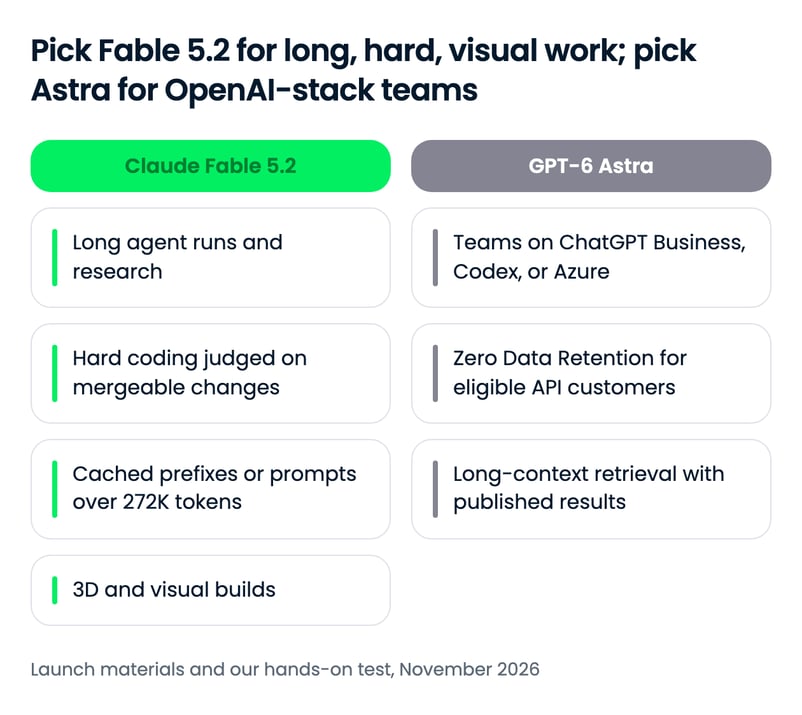
Voor het meeste technische werk is Fable 5.2 de sterkere en per token goedkopere keuze. De case voor GPT-6 Astra rust op waar je team al werkt en op de claims die OpenAI heeft gepubliceerd en waarop Anthropic nog niet heeft geantwoord.
Kies Claude Fable 5.2 als...
- Je agents urenlang draaien. Fable 5.2’s voorsprongen zijn het grootst op meerstapsprojecten zoals de Remote Labor Index, en Anthropic’s Lean-formalisatie van Fermat’s Laatste Stelling laat zien dat het een heel lange klus tot het einde draagt.
- Je code nodig hebt die wordt gemerged. Het leidt op beide codeerbenchmarks van Anthropic, en Anthropic zegt dat het Astra’s beste FrontierCode-score verslaat zelfs op high effort.
- Je prompts gecachet of heel lang zijn. Gecachete reads kosten een vijfde van Astra’s tarief, en er is geen toeslag boven 272K tokens.
- Je 3D-scènes, games of visuele tools bouwt. In mijn shadertest leverde het de enige scène met echte diepte en belichting die de geometrie respecteert.
Kies GPT-6 Astra als...
- Je team al werkt in ChatGPT Business of Enterprise, Codex of Azure. Astra is inbegrepen in die abonnementen, en Pro-, Business- en Enterprise-plannen krijgen ook GPT-6 Astra Pro.
- Je Zero Data Retention nodig hebt. Astra ondersteunt dit voor in aanmerking komende API-klanten, terwijl Fable 5.2 30 dagen retentie vereist tenzij je Enterprise Frontier Safeguards instelt.
- Je werk afhankelijk is van retrieval over een prompt van een miljoen tokens. OpenAI heeft long-context retrievalresultaten voor Astra gepubliceerd; Anthropic niet voor Fable 5.2.
- Je veel korte builds draait met een strak budget. In mijn test gebruikte Astra veel minder tokens en rondde af voor ongeveer een derde van Fable’s kosten, met een zwakker maar bruikbaar resultaat.
Hoe je start met Claude Fable 5.2 en GPT-6 Astra
Beide modellen zijn beschikbaar op de API van hun leverancier, de drie grote clouds, GitHub Copilot en OpenRouter.
| Surface | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Consumentenapp | Claude-apps, in aanmerking komende betaalde plannen (inclusief Pro en Team) | ChatGPT Plus, Pro, Business, Enterprise (standaard uitgeschakeld voor Enterprise-workspaces) |
| Eerste-partij API | Claude Platform | OpenAI API |
| Cloudplatforms | AWS (Claude Platform op AWS, Amazon Bedrock), Google Cloud, Microsoft Azure | Microsoft Azure, Amazon Bedrock, Google Cloud |
| Codeeragents | Claude Code, GitHub Copilot | Codex, GitHub Copilot |
| Routers van derden | OpenRouter | OpenRouter |
| API-model-ID | claude-fable-5-2 | gpt-6-astra |
De model-ID’s zijn claude-fable-5-2 op het Claude Platform en gpt-6-astra op de OpenAI API.
Je eerste API-call maken
De snelste manier om beide te proberen is OpenRouter, waar je in een OpenAI-compatibele client met één string van model wisselt.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="anthropic/claude-fable-5.2", # swap for "openai/gpt-6-astra"
messages=[{"role": "user", "content": "Review this migration plan for risks..."}],
)
print(response.choices[0].message.content)Voor de native SDK’s bouwt onze GPT-6 Astra API-tutorial een volledige agent, en onze Fable 5.2-gids behandelt inspanningsniveaus en de snelle modus.
Laatste gedachten
Claude Fable 5.2 is op dit moment het betere model voor de meeste veeleisende technische taken: het leidt GPT-6 Astra op elk benchmark dat ze delen, kost minder per token en won mijn hands-on test duidelijk. De kanttekening is dat Anthropic elk van die head-to-headcijfers schreef, en OpenAI’s sterkste claims over wiskunde, abstract redeneren en retrieval over een miljoen tokens hebben nog geen Fable 5.2-antwoord.
Wat ik het meest interessant vind is de kostenrij uit mijn test. Fable 5.2 is goedkoper per token en liep toch veel duurder, omdat het zoveel meer dacht en schreef. Als je workloads verplaatst, meet dan kosten per taak, niet per token.
Als je graag met een van beide modellen wil bouwen, raad ik onze cursus Introduction to Claude Models en onze cursus Working with the OpenAI API aan.
FAQs
Is Claude Fable 5.2 beter dan GPT-6 Astra?
Op de benchmarks die beide modellen scoren: ja. In Anthropic’s lanceertabel staat Claude Fable 5.2 vóór GPT-6 Astra op elke gedeelde rij, inclusief coderen, computergebruik en langetermijn kenniswerk, en Fable 5.2 won ook onze hands-on shadertest. OpenAI heeft nog geen eigen vergelijking tegen Fable 5.2 gepubliceerd, en Astra’s resultaten op wiskunde, abstract redeneren en long-context retrieval hebben nog geen Fable 5.2-tegenhanger.
Hoeveel kosten Claude Fable 5.2 en GPT-6 Astra?
Claude Fable 5.2 kost $8 per miljoen inputtokens en $40 per miljoen outputtokens. GPT-6 Astra kost $10 en $50. Gecachete reads kosten $0,20 per miljoen tokens op Fable 5.2 en $1,00 op Astra, en Astra rekent 2x input en 1,5x output voor verzoeken boven 272K inputtokens, terwijl Fable 5.2 geen long-contexttoeslag vermeldt.
Welke is beter voor coderen, Claude Fable 5.2 of GPT-6 Astra?
Claude Fable 5.2 leidt op beide codeerbenchmarks die Anthropic voor de twee modellen rapporteert: 49,1% vs 42,8% op FrontierCode 2.0 en 69,9% vs 65,5% op FrontierSWE v2. Die scores komen van Anthropic, niet van OpenAI. Voor teams die al met Codex of ChatGPT werken, blijft GPT-6 Astra de handigere keuze.
Wat zijn de API-model-ID’s voor Claude Fable 5.2 en GPT-6 Astra?
Claude Fable 5.2 is claude-fable-5-2 op het Claude Platform, en GPT-6 Astra is gpt-6-astra op de OpenAI API. Op OpenRouter zijn ze anthropic/claude-fable-5.2 en openai/gpt-6-astra.
Waar kan ik Claude Fable 5.2 en GPT-6 Astra gebruiken?
Claude Fable 5.2 is beschikbaar in de Claude-apps en Claude Code op in aanmerking komende betaalde plannen, en op het Claude Platform. GPT-6 Astra is beschikbaar in ChatGPT Plus, Pro, Business en Enterprise, op de OpenAI API en in Codex. Beide zijn beschikbaar op Microsoft Azure, Amazon Bedrock, GitHub Copilot en Google Cloud.

Tom is Data Science Editor bij DataCamp. Hij schrijft en redigeert AI-tutorials, vergelijkt nieuwe LLM-releases en bouwt AI-gestuurde workflows. Eerder werkte hij in data science bij Deutsche Telekom. Buiten het werk voorspelt hij voetbalwedstrijden met machine learning.


Anthropic bracht Claude Fable 5.2 uit op 9 november 2026, twee maanden nadat OpenAI GPT-6 Astra lanceerde als “het intelligentste en best uitgelijnde model ter wereld.” Fable 5.2 komt met een prijsverlaging ten opzichte van Fable 5.1, en in Anthropic’s lanceertabel staat het op elke rij waar beide modellen voorkomen boven Astra. OpenAI heeft geen vergelijking tegen Fable 5.2 gepubliceerd die wij konden vinden, dus de voor de hand liggende vraag voor iedereen die een frontier-model kiest is of die cijfers standhouden.
In dit artikel vergelijk ik Claude Fable 5.2 en GPT-6 Astra op langetermijn kenniswerk, coderen, computergebruik, safeguards en prijzen, en voer ik daarna een hands-on buildtaak op beide uit.
Wil je op de hoogte blijven van AI en data? Abonneer je dan op onze wekelijkse nieuwsbrief, The Median.
TL;DR
Wat is Claude Fable 5.2?
Claude Fable 5.2 is Anthropic’s model voor het meest veeleisende technische werk, in november 2026 uitgebracht voor alle gebruikers en gebouwd op hetzelfde onderliggende model als Claude Mythos 5.2, dat Fable’s cybersecurity- en biologiesafeguards laat vallen voor gescreende organisaties.
Anthropic positioneert het voor het meest ambitieuze langetermijn technische werk, en raadt Claude Opus 5.5 nog steeds aan als standaard voor dagelijks coderen en kennistaken.
Onze Claude Fable 5.2- en Mythos 5.2-gids behandelt de lancering volledig.
Wat is GPT-6 Astra?
GPT-6 Astra is OpenAI’s frontier-vlaggenschip, gelanceerd in september 2026 als opvolger van GPT-5.6 Sol.
OpenAI bouwde de pitch rond computergebruik en professioneel werk, en rond verzadigde benchmarks zoals ARC-AGI-3 en FrontierMath Tier 4 die bedoeld waren om AI-modellen voor te blijven.
Onze GPT-6 Astra-gids behandelt de lancering; onze GPT-6 Astra API-tutorial laat zien hoe je een release-checkagent bouwt.
Claude Fable 5.2 vs GPT-6 Astra: Head-to-head vergelijking
Fable 5.2 leidt op elke benchmark die beide modellen scoort, van coderen tot computergebruik, en alleen grafieklezen komt in de buurt van gelijkspel. De adder onder het gras is de bron: al deze cijfers komen uit Anthropic’s lanceertabel, omdat OpenAI’s eigen tabel ouder is dan Fable 5.2.
Langetermijn kenniswerk en onderzoek
Fable 5.2’s grootste voorsprong ligt bij open-ended werk met meerdere stappen. Op de Remote Labor Index, die echte freelance-achtige projecten beoordeelt, voltooit Fable 5.2 41,3% tegenover Astra’s 20,8%, ruwweg het dubbele.
Het patroon houdt stand: hoe meer een taak op een lang project lijkt in plaats van één enkel antwoord, hoe groter Fable 5.2’s voorsprong. Humanity’s Last Exam is geen verrassing: OpenAI’s eigen lanceertabel liet al zien dat Astra achterliep op Claude Fable 5.1.
Anthropic’s eigen showcase wijst dezelfde kant op. Fable 5.2 formaliseerde het bewijs van de Laatste Stelling van Fermat in Lean in 30 uur met zo’n 1.000 agents, een project waarvoor een eerder intern onderzoeksmodel 11 dagen nodig had.
Twee kanttekeningen voordat je dit als afgedaan beschouwt:
Fable 5.2 is het sterkere model voor lange, onduidelijke onderzoeks- en analysetrajecten, en de marges zijn groot genoeg dat een verschil in testharnas die niet waarschijnlijk dichtloopt.
Coderen en agentische workflows
Fable 5.2 leidt op beide codeerbenchmarks die Anthropic rapporteert, zij het met kleinere marges dan bij kenniswerk. Op FrontierCode 2.0, dat vraagt of open-sourcemaintainers de wijzigingen van een model zouden mergen, haalt Fable 5.2 49,1% op xhigh effort tegenover Astra’s 42,8%.
Anthropic voegt toe dat Fable 5.2 op high effort Astra’s beste FrontierCode-score verslaat tegen ongeveer dezelfde kosten per taak. OpenAI’s eigen codetabel gebruikt oudere benchmarkversies en vergelijkt Astra met Fable 5.1, dus er is nog geen OpenAI-check. Op basis van het beschikbare bewijs is Fable 5.2 het betere codeermodel.
Computergebruik, visie en robotica
Fable 5.2 leidt op computergebruik en robotica, terwijl grafieklezen dicht bij een gelijkspel zit. Robotica is de uitschieter: op RoboDojo Sim, een gesimuleerde twee-armige robot, scoort Fable 5.2 64,9% tegenover Astra’s 29,8%.
OpenAI noemde Astra “het beste model voor computergebruik ter wereld”, maar deed die claim tegen Claude Fable 5.1 en Claude Opus 5 op OSWorld 2.0. Op Anthropic’s nieuwere versie neemt Fable 5.2 de leiding.
Wiskunde, abstract redeneren en long context: Astra’s onbeantwoorde claims
Astra’s sterkste lanceringsresultaten staan op benchmarks die Anthropic niet voor Fable 5.2 rapporteerde, dus er is hier geen head-to-head, alleen claims aan één kant. De duidelijkste is long-context retrieval: Astra scoort 96,3% op OpenAI’s MRCR v2 8-needle test in de band van 512K tot 1M tokens.
OpenAI rapporteert ook bijna verzadigde scores op FrontierMath Tier 4 en ARC-AGI-3, al merkt onze GPT-6 Astra-gids op dat de ARC-AGI-3-figuur afhangt van een stateful harnas dat gewone API-calls niet krijgen. Als je werk draait op retrieval over een prompt van een miljoen tokens, is Astra de enige van de twee met gepubliceerd bewijs.
Safeguards en gegevensretentie
Beide modellen blokkeren standaard offensief cybersecuritywerk, en ze verschillen meer in gegevensretentie dan in weigeringen. Fable 5.2’s classifiers blokkeren penetratietesten, exploitgeneratie en de meeste biologie op onderzoeksniveau, al zegt Anthropic dat het minder onnodige blokkades geeft dan Fable 5.1; gescreende organisaties kunnen in plaats daarvan Claude Mythos 5.2 aanvragen.
OpenAI classificeert Astra op de Critical-cybersecuritydrempel van zijn Preparedness Framework en zet exploitcreatie achter het Daybreak-programma. Astra ondersteunt Zero Data Retention voor in aanmerking komende API-klanten, terwijl Fable 5.2 30 dagen retentie vereist voor veiligheidsmonitoring, tenzij een enterprise Anthropic’s Enterprise Frontier Safeguards gebruikt. Voor gereguleerde teams die al op nulretentie vertrouwen, past Astra makkelijker.
Prijzen: wat je echt betaalt
Fable 5.2 is goedkoper dan GPT-6 Astra op elk tarief dat beide aanbieders publiceren, en de kloof is niet uniform. Astra kost 1,25x zoveel voor input, output en cachewrites, maar 5x zoveel voor gecachete reads, en alleen Astra voegt een toeslag toe voor long context.
Bij een gewone gebalanceerde workload is het verschil bescheiden. Het wordt doorslaggevend zodra prompts worden gecachet of voorbij 272K tokens gaan.
Tokenprijzen naast elkaar
Beide aanbieders vermelden standaardtarieven per miljoen tokens, plus cache-, batch- en fast-modetarieven.
Het tarief voor gecachete reads is de regel die de meeste teams zullen voelen, omdat agentloops bij elke stap dezelfde lange prefix opnieuw versturen.
Wat een echte workload kost
Elke rij hieronder is een maandelijks volume, geprijsd als (volume ÷ 1M) × tarief, opgeteld over input en output.
Geen van beide aanbieders heeft tokenaantallen voor een gedeelde workload gepubliceerd, dus beschouw deze totalen als een tariefvergelijking in plaats van een rekening. Mijn hands-on run hieronder herinnert eraan waarom: daar was het goedkopere model per token de duurdere run.
Hoe Claude Fable 5.2 en GPT-6 Astra presteerden
Benchmarks uit de launchpost van één leverancier gaan maar zo ver, dus ik draaide één buildtaak tegen beide modellen met een identieke prompt en identieke tooling.
De taak: een enkele HTML-pagina met een full-window geanimeerde GLSL-fragmentshader van een vuurtoren op een rotsige kust tijdens een nachtstorm, met rollende golven die op de rotsen breken, schuine regen en lage wolken die van onderen worden verlicht. De vuurtorenbundel moest de muis volgen en de golven, regen en wolken oplichten waar hij overheen veegt. p5.js mocht alleen het canvas hosten, de loop draaien en de muispositie en tijd in de shader voeren.
De volledige prompt:
Waarom dit lastig is:
Anthropic’s launchpost citeert Sam Zhang van Unity die zegt dat Fable 5.2’s duidelijkste winst ligt in “het vanaf nul bouwen van 3D-scènes van hogere kwaliteit”, dus dit test die claim direct. Het is ook een soort rematch: in onze GPT-6 Astra vs Claude Fable 5.1-vergelijking won Astra een natuurkundesimulatie van de vorige Fable.
Beide modellen draaiden in OpenCode met een vast tooloppervlak (alleen lezen en bewerken van bestanden), op
highreasoning effort, één poging elk, in een verse sessie, met de prompt byte-for-byte afgeleverd.Hier zijn mijn schermopnames van beide pagina’s, terwijl ik de muis over de scène beweeg. Fable eerst: