이전 Gemini 4 Argon API 튜토리얼에서 에이전트의 역할은 명확했습니다. 느린 코드를 찾고, 수정하며, 숨겨진 테스트를 통과하는 것이었죠. 이번 동반 실험은 통제된 도구와 외부 검증이라는 동일한 패턴을 유지하되, 결정을 바꿉니다. Gemini 4 Carbon은 원래 규칙을 아예 만족시킬 수 있는지부터 판단해야 합니다.
가상의 온라인 상점 PayGuard에는 주문의 사기 가능성을 점수화하는 머신러닝(ML) 모델이 있습니다. 배포 정책은 전체와 각 판매 채널에서 충분한 사기 가치를 포착하는 동시에 심사 팀의 과부하를 막아야 한다고 요구합니다. 에이전트는 유효한 임곗값이 존재하는지 알려주지 않은 상태에서 이 규칙들을 조사해야 합니다.
Gemini 4 Carbon은 Google의 추론 모델로, Python에서 Interactions API를 통해 호출합니다. 여기서는 AI 에이전트로 동작합니다. 어떤 점검을 요청할지 모델이 선택하고, Python은 함수 호출을 통해 세 가지 읽기 전용 도구로 이를 실행합니다. 모델이 충돌을 식별하고, 근거를 설명하며, 변경안을 승인된 것으로 취급하지 않은 채 허용 가능한 수정 사항을 권고할 수 있는지가 제 질문입니다.
필요한 것은 기본적인 Python 지식과 API 요청 경험 정도입니다. 숫자를 사용하기 전에 각 사기 지표를 정의합니다. 아래를 다룹니다.
Gemini 4 Carbon API는 gemini-4-carbon에 대한 유료 애플리케이션 프로그래밍 인터페이스(API)입니다. 모델 페이지는 이를 길고 다단계인 에이전트 작업을 위한 추론 모델로 설명합니다. 입력, 사고, 출력이 1,048,576 토큰의 컨텍스트 윈도를 공유하며, 동기 응답은 기본적으로 사고+출력 합산 65,536 토큰에서 중지됩니다.
ML 모델 감사가 Gemini 4 Carbon 테스트에 적합한 이유
이 작업은 여러 점검, 허용된 변경안 탐색, 그리고 규칙상 답이 없을 때의 명확한 중단을 요구합니다. Python이 기준 정답을 계산할 수 있기 때문에 선택했습니다. 모델 카드에는 환각(hallucination)이 Gemini 4 Carbon의 알려진 한계로 명시되어 있어, 모델이 조사하고 Python이 권고안의 타당성을 판정하도록 했습니다.
프로젝트: PayGuard의 사기 탐지 모델을 배포할 수 있는지 결정하기
PayGuard는 서두에 등장한 가상의 상점이며, 전체 프로젝트는 GitHub 저장소에 있습니다. 분류기는 이미 학습된 상태입니다.
PayGuard가 거래를 점수화하는 방식
각 거래에는 UTC 타임스탬프, 금액, 채널(Website 또는 Mobile App), 위험 점수, 사기 라벨이 있습니다. scikit-learn의 HistGradientBoostingClassifier가 점수를 생성하며, 소수 셋째 자리(0.001)까지 반올림합니다. PayGuard는 risk_score >= threshold일 때 거래를 플래그합니다. 임곗값 이동이 플래그에 어떤 영향을 주는지는 정밀도-재현율 곡선 튜토리얼에서 다루며, 모델링 측면은 Fraud Detection in Python 강의에서 다룹니다.
합성 데이터는 시간으로 분할됩니다.
학습: 처음 9주, 분류기 학습에만 사용
검증: 다음 4주, 도구들이 읽을 수 있는 유일한 구간
홀드아웃: 그 다음 4주, 권고안이 고정될 때까지 봉인
현재 임곗값은 0.5이며, 실험 동안 데이터와 정책은 바뀌지 않습니다. Website 사기는 이 데이터에서 뚜렷한 신호를 보이는 반면, 대부분의 Mobile App 사기는 일반 주문과 유사합니다.
Gemini 4 Carbon이 묻고, Python이 결정합니다. 이미지: 작성자
PayGuard의 세 가지 배포 규칙
서두의 세 가지 규칙을 정책 원문 표현대로 정리하면 다음과 같습니다. 모두 이 실험을 위해 임의로 정한 목표입니다.
R1: 플래그된 거래는 전체 라벨링된 사기 가치의 최소 85%를 포착해야 함
R2: 각 채널 내에서 라벨링된 사기 가치의 최소 70%를 포착해야 함
R3: 단일 UTC 일자에 플래그되는 거래 수가 200건을 넘지 않아야 함
사기-가치 재현율은 플래그된 사기 가치 ÷ 전체 사기 가치입니다. 정밀도 대 재현율 가이드에서의 거래 단위 재현율과 달리, 2,000달러짜리 사기를 놓치는 것은 15달러짜리를 놓치는 것보다 훨씬 크게 반영됩니다. 또한 플래그가 돈을 구했다는 의미는 아닙니다. R3은 가장 바빴던 단 하루를 상한으로 제한하며, 이 문구가 결국 감사를 좌우합니다.
에이전트는 두 가지 변경안을 조사할 수 있습니다. 하나의 임곗값으로 일일 처리 용량을 최대 260까지 늘리는 것, 또는 원래 상한을 유지한 채 채널별 임곗값을 두는 것. 두 가지 모두 사람의 승인이 필요하며, 병행 적용은 불가하고, 추가 심사 인력이 없는 옵션을 정책이 우선합니다.
올바른 감사의 기준
올바른 감사는 네 가지를 정확히 파악해야 하며, 첫 요청 전에 이를 확정해야 합니다.
판정: 단일 임곗값이 검증 구간에서 R1, R2, R3을 모두 충족하는지 여부
충돌: 원래 정책을 불가능하게 만드는 요구사항은 무엇인지
대안: Python이 재계산했을 때 모든 규칙을 통과하는 허용 가능한 변경안
우선순위: 권고안이 정책의 우선순위를 따르는지
에이전트가 호출할 수 없는 평가자가 정답을 계산합니다.
Python에서 Gemini 4 Carbon API 설정하기
Gemini 4 Carbon API 설정에는 Python 3.11 이상과 과금이 활성화된 Google AI Studio 프로젝트의 API 키가 필요합니다. 요금 페이지에는 무료 등급이 없다고 명시되어 있습니다.
Google Gen AI SDK 설치 및 프로젝트 준비
이 프로젝트는 출시일의 google-genai==3.1.0으로 고정된 Google Gen AI 소프트웨어 개발 키트(SDK)로 테스트했습니다. 해당 버전은 Interactions 모델 목록에 PyPI 릴리스로 gemini-4-carbon을 추가했습니다. 프로젝트를 클론하고 가상환경에 설치하세요.
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS or Linux: source .venv/bin/activate
pip install-r requirements.txt제공
그다음, 저장소 페이지의 두 명령을 실행해 고정 시드로 데이터를 생성하고 분류기를 학습하세요. 새 클론에서의 출력은 다음과 같습니다.
고정 시드로 동일한 데이터셋을 재현합니다. 이미지: 작성자
그다음 GEMINI_API_KEY=your-key를 .env 파일에 추가하세요. 저장소는 키를 출력하지 않고 로드합니다.
첫 Gemini 4 Carbon API 요청 보내기
프로젝트 폴더에서 아래 완전한 예제를 실행하세요. 정책과 분류기 요약을 제공하고, 충돌을 암시하지 않은 채 측정에 필요한 항목을 물어봅니다.
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")제공
thinking_level은 generation_config에 설정하며, output_text에 답변이 담깁니다. 일부 응답은 다음과 같습니다.
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412제공
R3을 일일 최대치로 해석했고, 숫자를 보기도 전에 정책의 우선순위를 계획했습니다. 다만 동점 처리나 점수 반올림 방식은 묻지 않았는데, 뒤에서 보여줄 전수 검사는 정확히 그 부분에 의존합니다. 호출에는 약 40초가 걸렸고 비용은 약 2센트였습니다.
Gemini 4 Carbon 감사 에이전트는 루프 구조입니다. 모델이 평가를 요청하면, Python이 검증 및 실행하고, 결과를 다시 전달하며 모델이 더 이상 요청하지 않을 때까지 반복합니다.
모델 평가를 위한 읽기 전용 도구 정의
에이전트는 세 가지 도구를 받습니다. 모두 검증 구간으로 제한됩니다.
get_audit_context: 분류기 요약, 현재 구성, 정책, 허용 변경안
evaluate_global_threshold: 단일 임곗값에 대한 전체 및 채널별 사기-가치 재현율, 일자별 플래그 수, 진단
evaluate_policy_change: 용량 증가 또는 채널별 임곗값 쌍에 대한 동일한 측정치
전체 스키마는 저장소에 있습니다. 아래 단순화된 발췌는 임곗값과 용량 필드를 생략하므로 그대로 복사해 사용할 완전한 선언이 아닙니다. 여기서 중요한 경계만 보여줍니다. 즉, 도구는 PayGuard가 허용한 두 가지 정책 변경을 입력으로 받고, 검증 데이터를 읽으며, 어떤 것도 승인하지 않습니다.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}제공
Python은 생략된 임곗값과 용량 필드를 검증하고, 정책 밖의 변경은 거부하며, 합격/불합격 플래그 대신 측정치를 반환합니다. 에이전트는 홀드아웃에 접근하거나, 평가자를 호출하거나, 정책을 바꿀 수 없습니다. Gemini 4 Carbon의 내장 코드 실행을 사용하지 않은 이유는 FAQ에서 설명합니다.
에이전트에 명확한 목표와 중단 규칙 제공
시스템 지시문은 방법을 설정합니다. 첫 요청과 마찬가지로, 충돌의 위치를 암시하지 않습니다.
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.제공
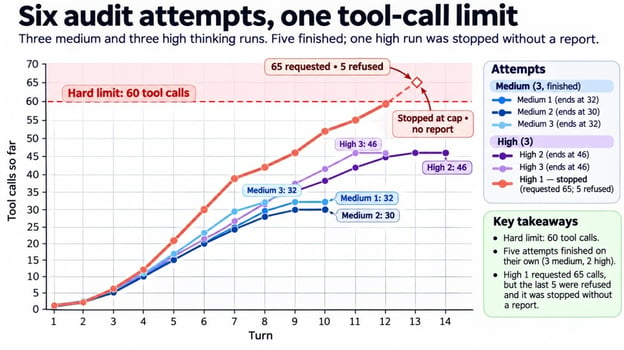
프롬프트는 요구만 할 수 있으므로, 한계는 모델 주변의 Python 코드인 에이전트 하니스에 둡니다. API에는 예산 설정이 없으므로 애플리케이션이 시도 단위로 제한을 둡니다. 25턴, 도구 호출 60회, 30분, 3달러이며, 턴 사이에 지출을 점검합니다.
Interactions API로 함수 호출 루프 구현
각 턴은 하나의 client.interactions.create() 호출입니다. Gemini 4 Carbon은 한 번에 여러 도구를 요청하는 경우가 많아, 루프는 각 function_call 단계마다 실행됩니다. 다음은 핵심 루프이며, 저장소 버전에는 로깅과 제한 점검이 추가되어 있습니다.
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)제공
request 딕셔너리에 설정을 모아두고, 후속 호출마다 재전송합니다. previous_interaction_id가 히스토리를 이어주지만, tools, system_instruction, generation_config는 각 인터랙션에만 적용됩니다. 턴이 incomplete로 끝났다면 max_output_tokens에 걸린 것입니다. 이 경우 사고 토큰 비용은 그대로 청구됩니다.
JSON 스키마로 구조화된 감사 보고서 반환
Google의 구조화 출력 가이드는 도구와 JSON 스키마를 하나의 요청으로 보내는 프리뷰 기능을 Gemini 4 Carbon에 대해 안내합니다. 저는 분리했습니다. 조사 턴은 측정만 하고, 동일한 히스토리와 구성에서 마지막 턴이 도구 없이 스키마를 적용해 보고서를 작성합니다.
AuditReport는 판정, 충돌, 근거, 권고, 승인 사항을 담는 Pydantic 모델입니다. 시간과 비용은 Gemini 4 Carbon에 보고를 맡기지 않고 Python이 측정합니다.
사기 탐지 모델에 대해 Gemini 4 Carbon 감사 실행하기
Gemini 4 Carbon은 주니어 분석가에게 기대하는 방식으로, 결론에 앞서 측정부터 진행했습니다. 첫 medium 시도에서 감사 컨텍스트를 읽고, 약 20여 개의 단일 임곗값을 점검했으며, 8개의 정책 변경을 시험했습니다.
총 32회의 도구 호출 순서. 이미지: 작성자
PayGuard의 현재 임곗값 평가
에이전트는 현재 임곗값 0.5를 평가해 Website 재현율 91%, Mobile App 재현율 20%, 전체 재현율 64%, 가장 바쁜 날 플래그 85건을 확인했습니다. 이는 R1과 R2의 Mobile App 측면에서 실패하며 R3에는 여유가 있어, 명백한 다음 단계는 임곗값을 낮추는 것입니다.
일일 검토 용량 대비 사기-가치 재현율 점검
임곗값을 낮추면 더 많은 사기 가치를 포착하지만, 검토로 보내는 주문도 늘어납니다. PayGuard는 전자를 충분히 확보하면서도 후자를 일일 상한 아래로 유지해야 합니다.
에이전트는 먼저 몇 개의 거친 임곗값을 한 번에 시도한 다음, 단일 그리드 포인트로 좁혔습니다. 추적의 호출 11, 12, 17, 18이 결론을 냈습니다.
이 검증 구간에서 Mobile App의 하한은 0.108 이하가 필요합니다. 한 단계만 높여도 70% 바로 아래로 떨어집니다. 상한(R3)은 0.118 이상이 필요합니다. 둘 다 만족하는 임곗값은 없습니다.
전체 재현율은 0.137까지 유지되어, R1은 충돌 밖에 있습니다. 0.108에서 평균 일일 플래그는 약 169건이고, 토요일 하루만 상한을 넘습니다. 그래서 정책이 일일 평균이 아니라 가장 바쁜 하루의 업무량을 기준으로 삼는 것입니다.
Mobile 재현율과 용량은 겹치지 않습니다. 이미지: 작성자
두 결제 채널 전반의 성능 점검
신호가 약한 Mobile App 사기는 점수 범위의 하단에 위치합니다. Mobile App을 위해 임곗값을 0.108까지 내리면 Website의 정상 주문까지 더 많이 끌어들이게 되며, 토요일에는 총합이 상한을 넘기게 됩니다.
전체 수치는 이를 가립니다. 0.118에서 전체 재현율은 약 87%인데, Mobile App은 여전히 하한 아래에 있습니다. 정책이 세그먼트를 명시한다면 각 세그먼트를 별도로 측정하세요. 전체는 통과해도 한 세그먼트가 실패할 수 있습니다.
Gemini 4 Carbon은 상충하는 배포 요구사항을 감지할 수 있나요?
네, 이번 감사에서는 그렇습니다. 동결된 보고서는 not deployable이라고 명시하고, 단일 임곗값이 없음을 지적하며, 충돌로 Mobile App의 R2와 R3을 지목합니다.
Gemini 4 Carbon의 배포 판정을 근거와 대조하기
보고서에 인용된 모든 수치는 도구 결과와 일치하지만, 문장 하나가 측정 범위를 넘어서는 주장을 합니다. "모든 0.001 위험 점수 그리드 포인트에서" 작동하는 임곗값이 없다고 했지만, 실제로는 가능한 1,002개 중 위의 추적처럼 20여 개만 테스트했습니다.
해당 주장은 임곗값이 올라갈수록 재현율과 일일 플래그 수가 모두 감소한다는 성질 때문에 성립하며, 보고서는 이를 명시하진 않았습니다. 에이전트 보고서의 각 주장을 그가 측정한 것과 대조하세요. 이와 같은 점검에 대해서는 AI 에이전트 평가 가이드에서 더 자세히 다룹니다.
전수 Python 평가자로 충돌을 검증하기
Gemini 4 Carbon은 임곗값을 샘플링하고 어떤 것도 작동하지 않음을 추론했습니다. 평가자는 도구와 코드를 공유하지 않고, 가능한 모든 플래그 집합을 점검해 이 검증 구간에서 해당 결과를 증명합니다.
점수는 0.001 그리드에 놓여 있으므로, 1,002개의 후보 컷오프가 가능한 모든 플래그 집합을 포괄합니다. 평가자는 전부를 점검하고, 채널 임곗값 쌍도 모두 확인하며, 퍼센트 계산은 정수 센트 단위로 처리해 85%와 70%가 정확히 떨어지도록 합니다.
전수 점검과 4개의 거부된 구성. 이미지: 작성자
모든 규칙을 통과하는 전역 임곗값은 없으므로, 이제 Gemini 4 Carbon의 주장은 증거를 갖춥니다. 평가자는 에이전트의 탐색에서 얻은 0.108과 0.118 경계를 일치시켰고, 일일 200건 상한에서 통과하는 수천 개의 채널 쌍을 찾았습니다.
평가자는 잘못된 답을 걸러낼 때 의미가 있습니다. 그래서 명백히 틀린 4개 구성을 넣어보았고 모두 거부했습니다.
Gemini 4 Carbon으로 배포 대안 시험하기
Gemini 4 Carbon은 허용된 두 변경안을 모두 시험하고, 추가 심사 인력 없이 원래 상한을 유지하는 채널별 임곗값을 더 높게 평가했습니다. 해당 선택을 사람 승인 필요 예외로 표시했습니다.
수동 검토 용량 증가 시험
일일 상한을 200에서 205로 올리면 단일 전역 임곗값이 동작하며, 평가자는 205가 최소 증가분임을 확인했습니다. 앞서 설명한 우선순위 규칙 때문에 Gemini 4 Carbon은 이 옵션을 2순위로 두었습니다.
각 결제 채널에 대한 별도 임곗값 시험
채널 분할 측면에서, 에이전트는 Mobile App 임곗값을 하한 근처에 유지했고(0.109가 하한을 깨는 것을 이미 확인), Website 임곗값을 올려 정상 Website 주문의 플래그를 줄였습니다. 7쌍을 시험했으며, 한 쌍은 가장 바쁜 날 단 1건 차이로 실패했습니다. Website 0.3, Mobile App 0.1을 권고한 이유는 모든 규칙을 여유 있게 통과하기 때문이며, 평가는 원래 상한에서 이를 확인했습니다.
검증된 대안 비교
아래 수치는 앞서 등장했으며, 평가자가 각 항목을 재계산했습니다.
옵션
임곗값
전체
Website
Mobile App
가장 바쁜 날
승인
원래 정책
전역 0.108
87.5%
98.2%
70.1%
205, 상한 200
실패
용량 증가
전역 0.108
87.5%
98.2%
70.1%
205, 상한 205
승인 필요
채널 분할
Website 0.3, Mobile App 0.1
86.2%
94.5%
72.8%
191, 상한 200
승인 필요
채널 분할은 용량 증가 옵션보다 플래그 수를 약 6% 줄여줍니다. 다만 플래그 중 절반도 사기가 아니어서, 보고서는 이를 미해결 이슈로 기재했습니다.
보지 못한 데이터로 Gemini 4 Carbon의 권고안 검증하기
권고안을 봉인(freeze)한 뒤 봉인된 홀드아웃에 적용해 검증합니다. 평가자와의 차이는 데이터입니다. 평가자는 에이전트가 볼 수 있었던 주를 채점했고, 홀드아웃은 도구가 읽을 수 없었던 이후 4주를 채점합니다. 이 점검은 봉인된 권고안당 한 번 실행되며, 보고서가 봉인 후 변경되었다면 시작하지 않습니다.
동결된 권고안이 홀드아웃에서 통과. 이미지: 작성자
세 가지 규칙 모두 통과했고, 가장 바쁜 날도 상한 아래였습니다. 다만 과도한 해석은 피하세요. 이 결과를 절제해야 하는 이유는 세 가지입니다.
홀드아웃은 동일한 생성기에서 나왔기 때문에, 새로운 유형의 사기나 데이터 드리프트에 대해 말해주지 못합니다
전체 재현율은 85%를 2포인트 미만의 여유로 넘겼습니다
검증하지는 않았지만, Mobile App 트래픽이 Website보다 더 빠르게 증가하면 Mobile App 임곗값이 매우 낮기 때문에 상한을 넘길 수 있다고 추정합니다
앞의 두 항목은 숫자에서 바로 도출됩니다.
Streamlit에서 전체 감사를 살펴보기
저장소에는 Streamlit 앱과 6번의 기록된 시도가 포함되어 있어, API 호출 없이도 감사를 열람할 수 있습니다. 영상에서는 이를 로드해 탭별로 살펴봅니다.
Streamlit 앱에서 하나의 감사를 보여줍니다. 영상: 작성자
Gemini 4 Carbon의 Medium vs. High 사고 수준: 정확도, 시간, 비용
여기서의 성공이란 애플리케이션 한도 내에서 완료하고, 평가자가 수용하는 보고서를 반환하는 것입니다. 중단된 시도는 채점할 판정이 없습니다. 이 정의에 따르면, medium은 모든 시도를 완료했고, 올바른 감사당 비용이 절반 미만이었습니다.
다음은 요약 뒤에 있는 전체 비교입니다. 각 수준당 3회 시도를, 동일한 데이터·프롬프트·도구·한도·평가자 조건에서 서로의 기억 없이 독립적으로 시작했습니다.
수준별
medium
high
보고서로 끝난 시도 수
3/3
2/3
그중 올바른 감사
3/3
2/2
시도당 사고 토큰
약 7,700
약 17,500
시도당 소요 시간
약 5분
약 6분
도입 요금 기준 올바른 감사당 비용
약 $0.25
약 $0.62
표준 요금 기준 올바른 감사당 비용
약 $0.51
약 $1.24
비용 행은 중단된 1회 포함 전체 시도의 지출을 합산합니다. 완료된 모든 시도는 동일한 판정과 충돌을 도출했고, 평가자가 수용한 채널 쌍을 선택했으므로, 추가 사고는 더 많은 점검에 쓰였습니다.
유사한 패턴을 Gemini 4 Argon 코딩 실험에서도 보았습니다. high가 더 많은 비용을 들여 더 많은 작업을 했지만, 검증된 결과의 차이는 작았습니다. 작업이 다르므로 비용과 성공률은 직접 비교할 수 없습니다. 두 경우 모두, 사고 토큰 총량보다 독립 검증이 더 많은 정보를 줍니다.
high 사고 수준의 한 시도가 끝나지 못한 이유
중단된 시도는 high의 첫 시도로, 잘못된 판정을 내리진 않았습니다. 0.101부터 0.119까지 모든 그리드 포인트를 탐색한 뒤, 아무도 의존하지 않는 Website의 70% 경계를 찾느라 계속 추가 점검을 요청했고, 제가 설정한 도구 호출 60회 한도에 도달해 애플리케이션이 보고서 작성 전에 중단시켰습니다.
한 번만 한도에 도달했습니다. 이미지: 작성자
이 중단이 유익한 지점입니다. 도구 호출을 줄이라는 프롬프트로는 끝나지 않았겠지만, 코드의 한도는 약 22센트 지점에서 중단시켰습니다.
완료된 5개 보고서는 Python의 다른 점검도 통과했습니다. 현재 구성을 잘못 읽거나, 충돌 밖의 요구사항을 지목하거나, 존재하지 않는 도구 호출을 인용하거나, 시험하지 않은 구성을 권고한 사례는 없었습니다.
감사별 토큰, 시간, 비용 측정
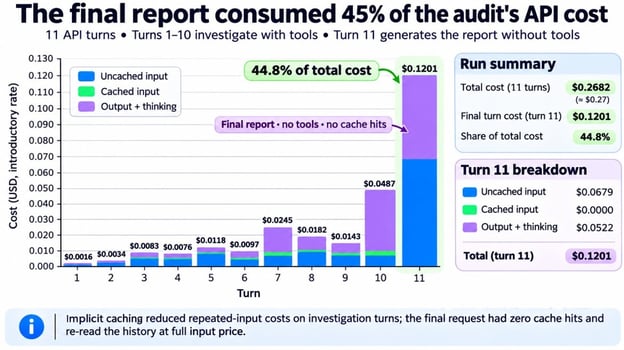
감사 비용은 각 턴의 usage 합으로 계산합니다. 가격은 입력 토큰 백만 개당 $2.00, 캐시된 입력 $0.10, 출력(사고 포함) $10.00이며, 2026년 12월 1일에 두 배가 됩니다. total_input_tokens에는 캐시 토큰이 포함되므로, 코드는 두 부분의 가격을 분리해 계산합니다.
보고서 턴이 가장 비용이 큽니다. 이미지: 작성자
의외였던 점은 보고서, 더 정확히는 그 청구서였습니다. 조사 턴의 입력 토큰 약 4분의 3은 암묵적 캐싱이 적용되었지만, 도구 없는 보고서 요청은 캐시 적중이 전혀 없었습니다.
원인은 아마도 tools를 제외하면서 요청의 시작부가 달라진 탓일 것입니다. 어쨌든 그 턴은 전체 히스토리를 정가로 다시 읽었고, 완료된 시도당 비용의 약 40%를 차지했습니다. 지출 한도를 정할 때 이 턴을 반드시 포함하세요.
ML 모델 감사를 위한 Gemini 4 Carbon 활용의 한계
이 테스트는 제가 설계하고 데이터를 생성했으므로, 결과에는 다음과 같은 한계가 있습니다.
데이터는 합성이며 한 개의 분류기에서 생성되었습니다. API 호출 전, 충돌이 존재하도록 생성기를 조정했습니다.
판정은 이 분류기에만 해당합니다. 더 나은 분류기는 단일 임곗값으로 세 규칙을 모두 만족할 수 있습니다.
임곗값 평가는 가능하지만, 채널 분할 승인은 비즈니스와 공정성 판단입니다.
유료 등급에서는 상호작용이 기본 55일간 저장되며, store=false는 previous_interaction_id 사용을 막기 때문에, 거래 행을 전송하는 에이전트는 데이터 검토가 필요합니다.
평가자는 모델 없이도 임곗값 문제를 스스로 해결합니다. 필요한 것이 임곗값뿐이라면 최적화 솔버를 사용하세요. Gemini 4 Carbon이 더한 가치는 그 주변의 감사입니다.
여기서 다룬 내용은 사기에만 한정되지 않습니다. Python으로 규칙을 측정할 수 있는 어떤 모델에도 적용할 수 있습니다.
맺음말
핵심 결과는 Gemini 4 Carbon이 원래 정책에 유효한 전역 임곗값이 없음을 알아냈다는 점입니다. 완료된 5회 시도는 모두 충돌을 지목하고, 평가자가 수용한 채널 분할을 제안했습니다. high 1회는 보고서 작성 전에 중단되었습니다.
Gemini 4 Argon과 Gemini 4 Carbon 실험은 에이전트 신뢰성의 양면을 시험했습니다. Gemini 4 Argon 에이전트는 코드를 변경하면서 동작을 보존해야 했고, Gemini 4 Carbon 에이전트는 원래 답을 불가능하게 만드는 규칙 아래에서 결론에 도달해야 했습니다. 둘 모두 좁은 도구 세트, 자원 한도, 모델 외부의 검증이 필요했습니다.
제가 에이전트에 요구할 표준은 이렇습니다. 도구가 입증할 수 있는 것을 정의하고, 결과를 독립적으로 검증하며, 근거가 부족할 때는 inconclusive답변을 허용하는 것입니다. 다음 단계로, 두세 개의 후보 분류기를 동일한 정책 아래 두고, 그중 어떤 것이 배포 가능한지 묻겠습니다.
FAQs
Gemini 4 Carbon API에 어떻게 액세스하나요?⌄
유료 Google AI Studio 프로젝트 또는 Google Cloud의 Gemini for business를 통해 이용할 수 있습니다. Gemini 앱, Antigravity, AI Mode도 Google AI Ultra 가입자에게 제공되지만, 이러한 소비자용 앱에서는 API 키를 발급받을 수 없습니다.
Gemini 4 Carbon API 비용은 얼마인가요?⌄
여기 소개된 6건의 감사 총비용은 도입 요금 기준 $2.00였습니다. 입력 토큰이 4,096을 넘는 요청부터는 암묵적 캐싱이 적용되므로, 각 요청의 시작부를 동일하게 유지하세요. Interactions 요청이 지원하는 Flex 추론은 응답이 더 느리고 덜 안정적인 대신 토큰 요금을 절반으로 낮춥니다.
Gemini 4 Carbon API의 요청 속도 제한은 어떻게 되나요?⌄
유료 프로젝트에는 분당 한도와 지출 한도가 있으며, 티어 1에서는 10분 롤링 윈도당 $10입니다. 이를 초과하면 429 RESOURCE_EXHAUSTED가 반환됩니다. 본문 기준 한 번의 감사 비용은 $1 미만이므로, 많은 병렬 시도에서만 한도에 도달할 수 있습니다. 한도는 티어에 따라 상승하므로, Google의 요청 속도 제한 페이지에서 프로젝트의 한도를 확인하세요.
Gemini 4 Carbon의 medium과 high 사고 수준 차이는 무엇인가요?⌄
Gemini 4 Carbon의 사고 수준은 low, medium(기본값), high의 세 단계가 있으며, 여기서는 상위 두 단계만 비교했습니다. 추가 사고가 어떻게 보이는지 확인하려면 thinking_summaries를 "auto"로 설정하세요. 각 답변 옆에 요약이 표시됩니다. 기본은 꺼져 있으며, 모델이 거의 추론하지 않으면 비어 있을 수 있습니다.
Gemini 4 Carbon이 Python 코드를 실행할 수 있나요?⌄
가능합니다. {"type": "code_execution"}를 tools에 추가하면 Gemini 4 Carbon이 Google 측에서 Python을 작성 및 실행할 수 있으며, 토큰 요금은 정상 요율이 적용됩니다. 저는 통제를 제 쪽에 두기 위해 제외했습니다. 세 도구가 측정 범위를 결정하고, 원시 거래 데이터와 홀드아웃은 제 머신을 떠나지 않습니다.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.


이전 Gemini 4 Argon API 튜토리얼에서 에이전트의 역할은 명확했습니다. 느린 코드를 찾고, 수정하며, 숨겨진 테스트를 통과하는 것이었죠. 이번 동반 실험은 통제된 도구와 외부 검증이라는 동일한 패턴을 유지하되, 결정을 바꿉니다. Gemini 4 Carbon은 원래 규칙을 아예 만족시킬 수 있는지부터 판단해야 합니다.
가상의 온라인 상점 PayGuard에는 주문의 사기 가능성을 점수화하는 머신러닝(ML) 모델이 있습니다. 배포 정책은 전체와 각 판매 채널에서 충분한 사기 가치를 포착하는 동시에 심사 팀의 과부하를 막아야 한다고 요구합니다. 에이전트는 유효한 임곗값이 존재하는지 알려주지 않은 상태에서 이 규칙들을 조사해야 합니다.
Gemini 4 Carbon은 Google의 추론 모델로, Python에서 Interactions API를 통해 호출합니다. 여기서는 AI 에이전트로 동작합니다. 어떤 점검을 요청할지 모델이 선택하고, Python은 함수 호출을 통해 세 가지 읽기 전용 도구로 이를 실행합니다. 모델이 충돌을 식별하고, 근거를 설명하며, 변경안을 승인된 것으로 취급하지 않은 채 허용 가능한 수정 사항을 권고할 수 있는지가 제 질문입니다.
필요한 것은 기본적인 Python 지식과 API 요청 경험 정도입니다. 숫자를 사용하기 전에 각 사기 지표를 정의합니다. 아래를 다룹니다.
출시 스토리와 벤치마크 점수는 Gemini 4 Carbon 개요에서 확인할 수 있고, Claude Fable 5.2 vs. Gemini 4 Carbon 비교 글에서는 두 모델을 나란히 다룹니다. 이 실험은 Google이 유료 개발자에게 API를 공개한 다음 날 진행했습니다.
Gemini 4 Carbon API란 무엇인가요?
Gemini 4 Carbon API는
gemini-4-carbon에 대한 유료 애플리케이션 프로그래밍 인터페이스(API)입니다. 모델 페이지는 이를 길고 다단계인 에이전트 작업을 위한 추론 모델로 설명합니다. 입력, 사고, 출력이 1,048,576 토큰의 컨텍스트 윈도를 공유하며, 동기 응답은 기본적으로 사고+출력 합산 65,536 토큰에서 중지됩니다.ML 모델 감사가 Gemini 4 Carbon 테스트에 적합한 이유
이 작업은 여러 점검, 허용된 변경안 탐색, 그리고 규칙상 답이 없을 때의 명확한 중단을 요구합니다. Python이 기준 정답을 계산할 수 있기 때문에 선택했습니다. 모델 카드에는 환각(hallucination)이 Gemini 4 Carbon의 알려진 한계로 명시되어 있어, 모델이 조사하고 Python이 권고안의 타당성을 판정하도록 했습니다.
프로젝트: PayGuard의 사기 탐지 모델을 배포할 수 있는지 결정하기
PayGuard는 서두에 등장한 가상의 상점이며, 전체 프로젝트는 GitHub 저장소에 있습니다. 분류기는 이미 학습된 상태입니다.
PayGuard가 거래를 점수화하는 방식
각 거래에는 UTC 타임스탬프, 금액, 채널(Website 또는 Mobile App), 위험 점수, 사기 라벨이 있습니다. scikit-learn의
HistGradientBoostingClassifier가 점수를 생성하며, 소수 셋째 자리(0.001)까지 반올림합니다. PayGuard는risk_score >= threshold일 때 거래를 플래그합니다. 임곗값 이동이 플래그에 어떤 영향을 주는지는 정밀도-재현율 곡선 튜토리얼에서 다루며, 모델링 측면은 Fraud Detection in Python 강의에서 다룹니다.합성 데이터는 시간으로 분할됩니다.
현재 임곗값은 0.5이며, 실험 동안 데이터와 정책은 바뀌지 않습니다. Website 사기는 이 데이터에서 뚜렷한 신호를 보이는 반면, 대부분의 Mobile App 사기는 일반 주문과 유사합니다.
Gemini 4 Carbon이 묻고, Python이 결정합니다. 이미지: 작성자
PayGuard의 세 가지 배포 규칙
서두의 세 가지 규칙을 정책 원문 표현대로 정리하면 다음과 같습니다. 모두 이 실험을 위해 임의로 정한 목표입니다.
사기-가치 재현율은 플래그된 사기 가치 ÷ 전체 사기 가치입니다. 정밀도 대 재현율 가이드에서의 거래 단위 재현율과 달리, 2,000달러짜리 사기를 놓치는 것은 15달러짜리를 놓치는 것보다 훨씬 크게 반영됩니다. 또한 플래그가 돈을 구했다는 의미는 아닙니다. R3은 가장 바빴던 단 하루를 상한으로 제한하며, 이 문구가 결국 감사를 좌우합니다.
에이전트는 두 가지 변경안을 조사할 수 있습니다. 하나의 임곗값으로 일일 처리 용량을 최대 260까지 늘리는 것, 또는 원래 상한을 유지한 채 채널별 임곗값을 두는 것. 두 가지 모두 사람의 승인이 필요하며, 병행 적용은 불가하고, 추가 심사 인력이 없는 옵션을 정책이 우선합니다.
올바른 감사의 기준
올바른 감사는 네 가지를 정확히 파악해야 하며, 첫 요청 전에 이를 확정해야 합니다.
에이전트가 호출할 수 없는 평가자가 정답을 계산합니다.
Python에서 Gemini 4 Carbon API 설정하기
Gemini 4 Carbon API 설정에는 Python 3.11 이상과 과금이 활성화된 Google AI Studio 프로젝트의 API 키가 필요합니다. 요금 페이지에는 무료 등급이 없다고 명시되어 있습니다.
Google Gen AI SDK 설치 및 프로젝트 준비
이 프로젝트는 출시일의
google-genai==3.1.0으로 고정된 Google Gen AI 소프트웨어 개발 키트(SDK)로 테스트했습니다. 해당 버전은 Interactions 모델 목록에 PyPI 릴리스로gemini-4-carbon을 추가했습니다. 프로젝트를 클론하고 가상환경에 설치하세요.그다음, 저장소 페이지의 두 명령을 실행해 고정 시드로 데이터를 생성하고 분류기를 학습하세요. 새 클론에서의 출력은 다음과 같습니다.
고정 시드로 동일한 데이터셋을 재현합니다. 이미지: 작성자
그다음
GEMINI_API_KEY=your-key를.env파일에 추가하세요. 저장소는 키를 출력하지 않고 로드합니다.첫 Gemini 4 Carbon API 요청 보내기
프로젝트 폴더에서 아래 완전한 예제를 실행하세요. 정책과 분류기 요약을 제공하고, 충돌을 암시하지 않은 채 측정에 필요한 항목을 물어봅니다.
thinking_level은generation_config에 설정하며,output_text에 답변이 담깁니다. 일부 응답은 다음과 같습니다.R3을 일일 최대치로 해석했고, 숫자를 보기도 전에 정책의 우선순위를 계획했습니다. 다만 동점 처리나 점수 반올림 방식은 묻지 않았는데, 뒤에서 보여줄 전수 검사는 정확히 그 부분에 의존합니다. 호출에는 약 40초가 걸렸고 비용은 약 2센트였습니다.
temperature,top_p,top_k와thinking_budget은 설정하지 마세요. Gemini 4 Carbon은 이를 무시합니다.Gemini 4 Carbon 함수 호출로 ML 감사 에이전트 만들기
Gemini 4 Carbon 감사 에이전트는 루프 구조입니다. 모델이 평가를 요청하면, Python이 검증 및 실행하고, 결과를 다시 전달하며 모델이 더 이상 요청하지 않을 때까지 반복합니다.
모델 평가를 위한 읽기 전용 도구 정의
에이전트는 세 가지 도구를 받습니다. 모두 검증 구간으로 제한됩니다.
get_audit_context: 분류기 요약, 현재 구성, 정책, 허용 변경안evaluate_global_threshold: 단일 임곗값에 대한 전체 및 채널별 사기-가치 재현율, 일자별 플래그 수, 진단evaluate_policy_change: 용량 증가 또는 채널별 임곗값 쌍에 대한 동일한 측정치전체 스키마는 저장소에 있습니다. 아래 단순화된 발췌는 임곗값과 용량 필드를 생략하므로 그대로 복사해 사용할 완전한 선언이 아닙니다. 여기서 중요한 경계만 보여줍니다. 즉, 도구는 PayGuard가 허용한 두 가지 정책 변경을 입력으로 받고, 검증 데이터를 읽으며, 어떤 것도 승인하지 않습니다.
Python은 생략된 임곗값과 용량 필드를 검증하고, 정책 밖의 변경은 거부하며, 합격/불합격 플래그 대신 측정치를 반환합니다. 에이전트는 홀드아웃에 접근하거나, 평가자를 호출하거나, 정책을 바꿀 수 없습니다. Gemini 4 Carbon의 내장 코드 실행을 사용하지 않은 이유는 FAQ에서 설명합니다.
에이전트에 명확한 목표와 중단 규칙 제공
시스템 지시문은 방법을 설정합니다. 첫 요청과 마찬가지로, 충돌의 위치를 암시하지 않습니다.
프롬프트는 요구만 할 수 있으므로, 한계는 모델 주변의 Python 코드인 에이전트 하니스에 둡니다. API에는 예산 설정이 없으므로 애플리케이션이 시도 단위로 제한을 둡니다. 25턴, 도구 호출 60회, 30분, 3달러이며, 턴 사이에 지출을 점검합니다.
Interactions API로 함수 호출 루프 구현
각 턴은 하나의
client.interactions.create()호출입니다. Gemini 4 Carbon은 한 번에 여러 도구를 요청하는 경우가 많아, 루프는 각function_call단계마다 실행됩니다. 다음은 핵심 루프이며, 저장소 버전에는 로깅과 제한 점검이 추가되어 있습니다.request딕셔너리에 설정을 모아두고, 후속 호출마다 재전송합니다.previous_interaction_id가 히스토리를 이어주지만,tools,system_instruction,generation_config는 각 인터랙션에만 적용됩니다. 턴이incomplete로 끝났다면max_output_tokens에 걸린 것입니다. 이 경우 사고 토큰 비용은 그대로 청구됩니다.JSON 스키마로 구조화된 감사 보고서 반환
Google의 구조화 출력 가이드는 도구와 JSON 스키마를 하나의 요청으로 보내는 프리뷰 기능을 Gemini 4 Carbon에 대해 안내합니다. 저는 분리했습니다. 조사 턴은 측정만 하고, 동일한 히스토리와 구성에서 마지막 턴이 도구 없이 스키마를 적용해 보고서를 작성합니다.
AuditReport는 판정, 충돌, 근거, 권고, 승인 사항을 담는 Pydantic 모델입니다. 시간과 비용은 Gemini 4 Carbon에 보고를 맡기지 않고 Python이 측정합니다.사기 탐지 모델에 대해 Gemini 4 Carbon 감사 실행하기
Gemini 4 Carbon은 주니어 분석가에게 기대하는 방식으로, 결론에 앞서 측정부터 진행했습니다. 첫
medium시도에서 감사 컨텍스트를 읽고, 약 20여 개의 단일 임곗값을 점검했으며, 8개의 정책 변경을 시험했습니다.총 32회의 도구 호출 순서. 이미지: 작성자
PayGuard의 현재 임곗값 평가
에이전트는 현재 임곗값 0.5를 평가해 Website 재현율 91%, Mobile App 재현율 20%, 전체 재현율 64%, 가장 바쁜 날 플래그 85건을 확인했습니다. 이는 R1과 R2의 Mobile App 측면에서 실패하며 R3에는 여유가 있어, 명백한 다음 단계는 임곗값을 낮추는 것입니다.
일일 검토 용량 대비 사기-가치 재현율 점검
임곗값을 낮추면 더 많은 사기 가치를 포착하지만, 검토로 보내는 주문도 늘어납니다. PayGuard는 전자를 충분히 확보하면서도 후자를 일일 상한 아래로 유지해야 합니다.
에이전트는 먼저 몇 개의 거친 임곗값을 한 번에 시도한 다음, 단일 그리드 포인트로 좁혔습니다. 추적의 호출 11, 12, 17, 18이 결론을 냈습니다.
이 검증 구간에서 Mobile App의 하한은 0.108 이하가 필요합니다. 한 단계만 높여도 70% 바로 아래로 떨어집니다. 상한(R3)은 0.118 이상이 필요합니다. 둘 다 만족하는 임곗값은 없습니다.
전체 재현율은 0.137까지 유지되어, R1은 충돌 밖에 있습니다. 0.108에서 평균 일일 플래그는 약 169건이고, 토요일 하루만 상한을 넘습니다. 그래서 정책이 일일 평균이 아니라 가장 바쁜 하루의 업무량을 기준으로 삼는 것입니다.
Mobile 재현율과 용량은 겹치지 않습니다. 이미지: 작성자
두 결제 채널 전반의 성능 점검
신호가 약한 Mobile App 사기는 점수 범위의 하단에 위치합니다. Mobile App을 위해 임곗값을 0.108까지 내리면 Website의 정상 주문까지 더 많이 끌어들이게 되며, 토요일에는 총합이 상한을 넘기게 됩니다.
전체 수치는 이를 가립니다. 0.118에서 전체 재현율은 약 87%인데, Mobile App은 여전히 하한 아래에 있습니다. 정책이 세그먼트를 명시한다면 각 세그먼트를 별도로 측정하세요. 전체는 통과해도 한 세그먼트가 실패할 수 있습니다.
Gemini 4 Carbon은 상충하는 배포 요구사항을 감지할 수 있나요?
네, 이번 감사에서는 그렇습니다. 동결된 보고서는
not deployable이라고 명시하고, 단일 임곗값이 없음을 지적하며, 충돌로 Mobile App의 R2와 R3을 지목합니다.Gemini 4 Carbon의 배포 판정을 근거와 대조하기
보고서에 인용된 모든 수치는 도구 결과와 일치하지만, 문장 하나가 측정 범위를 넘어서는 주장을 합니다. "모든 0.001 위험 점수 그리드 포인트에서" 작동하는 임곗값이 없다고 했지만, 실제로는 가능한 1,002개 중 위의 추적처럼 20여 개만 테스트했습니다.
해당 주장은 임곗값이 올라갈수록 재현율과 일일 플래그 수가 모두 감소한다는 성질 때문에 성립하며, 보고서는 이를 명시하진 않았습니다. 에이전트 보고서의 각 주장을 그가 측정한 것과 대조하세요. 이와 같은 점검에 대해서는 AI 에이전트 평가 가이드에서 더 자세히 다룹니다.
전수 Python 평가자로 충돌을 검증하기
Gemini 4 Carbon은 임곗값을 샘플링하고 어떤 것도 작동하지 않음을 추론했습니다. 평가자는 도구와 코드를 공유하지 않고, 가능한 모든 플래그 집합을 점검해 이 검증 구간에서 해당 결과를 증명합니다.
점수는 0.001 그리드에 놓여 있으므로, 1,002개의 후보 컷오프가 가능한 모든 플래그 집합을 포괄합니다. 평가자는 전부를 점검하고, 채널 임곗값 쌍도 모두 확인하며, 퍼센트 계산은 정수 센트 단위로 처리해 85%와 70%가 정확히 떨어지도록 합니다.
전수 점검과 4개의 거부된 구성. 이미지: 작성자
모든 규칙을 통과하는 전역 임곗값은 없으므로, 이제 Gemini 4 Carbon의 주장은 증거를 갖춥니다. 평가자는 에이전트의 탐색에서 얻은 0.108과 0.118 경계를 일치시켰고, 일일 200건 상한에서 통과하는 수천 개의 채널 쌍을 찾았습니다.
평가자는 잘못된 답을 걸러낼 때 의미가 있습니다. 그래서 명백히 틀린 4개 구성을 넣어보았고 모두 거부했습니다.
Gemini 4 Carbon으로 배포 대안 시험하기
Gemini 4 Carbon은 허용된 두 변경안을 모두 시험하고, 추가 심사 인력 없이 원래 상한을 유지하는 채널별 임곗값을 더 높게 평가했습니다. 해당 선택을 사람 승인 필요 예외로 표시했습니다.
수동 검토 용량 증가 시험
일일 상한을 200에서 205로 올리면 단일 전역 임곗값이 동작하며, 평가자는 205가 최소 증가분임을 확인했습니다. 앞서 설명한 우선순위 규칙 때문에 Gemini 4 Carbon은 이 옵션을 2순위로 두었습니다.
각 결제 채널에 대한 별도 임곗값 시험
채널 분할 측면에서, 에이전트는 Mobile App 임곗값을 하한 근처에 유지했고(0.109가 하한을 깨는 것을 이미 확인), Website 임곗값을 올려 정상 Website 주문의 플래그를 줄였습니다. 7쌍을 시험했으며, 한 쌍은 가장 바쁜 날 단 1건 차이로 실패했습니다. Website 0.3, Mobile App 0.1을 권고한 이유는 모든 규칙을 여유 있게 통과하기 때문이며, 평가는 원래 상한에서 이를 확인했습니다.
검증된 대안 비교
아래 수치는 앞서 등장했으며, 평가자가 각 항목을 재계산했습니다.
옵션
임곗값
전체
Website
Mobile App
가장 바쁜 날
승인
원래 정책
전역 0.108
87.5%
98.2%
70.1%
205, 상한 200
실패
용량 증가
전역 0.108
87.5%
98.2%
70.1%
205, 상한 205
승인 필요
채널 분할
Website 0.3, Mobile App 0.1
86.2%
94.5%
72.8%
191, 상한 200
승인 필요
채널 분할은 용량 증가 옵션보다 플래그 수를 약 6% 줄여줍니다. 다만 플래그 중 절반도 사기가 아니어서, 보고서는 이를 미해결 이슈로 기재했습니다.
보지 못한 데이터로 Gemini 4 Carbon의 권고안 검증하기
권고안을 봉인(freeze)한 뒤 봉인된 홀드아웃에 적용해 검증합니다. 평가자와의 차이는 데이터입니다. 평가자는 에이전트가 볼 수 있었던 주를 채점했고, 홀드아웃은 도구가 읽을 수 없었던 이후 4주를 채점합니다. 이 점검은 봉인된 권고안당 한 번 실행되며, 보고서가 봉인 후 변경되었다면 시작하지 않습니다.
동결된 권고안이 홀드아웃에서 통과. 이미지: 작성자
세 가지 규칙 모두 통과했고, 가장 바쁜 날도 상한 아래였습니다. 다만 과도한 해석은 피하세요. 이 결과를 절제해야 하는 이유는 세 가지입니다.
앞의 두 항목은 숫자에서 바로 도출됩니다.
Streamlit에서 전체 감사를 살펴보기
저장소에는 Streamlit 앱과 6번의 기록된 시도가 포함되어 있어, API 호출 없이도 감사를 열람할 수 있습니다. 영상에서는 이를 로드해 탭별로 살펴봅니다.