Tutorial API Gemini 4 Carbon: crea un agente che esegue l'audit di un modello antifrode
Impara l'API Gemini 4 Carbon in Python: crea un agente con function calling che esegue l'audit di un modello antifrode, trova regole in conflitto e testa una modifica alla policy.
Nel nostro Tutorial sull'API Gemini 4 Argon, l'agente aveva un compito chiaro: trovare il codice lento, modificarlo e superare i test nascosti. Questo esperimento complementare mantiene lo stesso schema di strumenti controllati e verifica esterna, ma cambia la decisione. Gemini 4 Carbon deve capire se le regole originali possono essere soddisfatte o meno.
PayGuard, un negozio online fittizio, ha un modello di machine learning (ML) addestrato che attribuisce un punteggio di rischio di frode agli ordini. La sua policy di messa in produzione richiede che il modello intercetti abbastanza valore frode in totale e su ciascun canale di vendita, senza sovraccaricare il team di revisione. L'agente deve esaminare queste regole senza che gli venga detto se esiste una soglia valida.
Gemini 4 Carbon è un modello di ragionamento di Google che chiami da Python tramite la Interactions API. Qui agisce come un agente AI: sceglie quali controlli richiedere e Python li esegue tramite tre strumenti in sola lettura usando il function calling. La mia domanda è se riesca a identificare il conflitto, spiegare le evidenze e raccomandare una modifica consentita senza considerarla approvata.
Ti serviranno le basi di Python e un po' di esperienza con le richieste API. Definisco ogni metrica antifrode prima che i numeri la usino. Vedremo come:
Inviare una prima richiesta a Gemini 4 Carbon da Python
Dare al modello strumenti in sola lettura ed eseguirli in loop con limiti
Ricevere il verdetto come JSON che il tuo codice può controllare
Verificare quel verdetto con codice e dati che il modello non vede mai
Confrontare due livelli di ragionamento, che controllano quanto il modello pensa prima di rispondere
Se vuoi la storia del lancio e i punteggi ai benchmark, il nostro overview di Gemini 4 Carbon li contiene, e il nostro confronto Claude Fable 5.2 vs. Gemini 4 Carbon mette a confronto i due modelli. Ho eseguito questo esperimento il giorno dopo l'apertura dell'API agli sviluppatori paganti da parte di Google.
Che cos'è l'API Gemini 4 Carbon?
L'API Gemini 4 Carbon è l'interfaccia di programmazione (API) a pagamento per gemini-4-carbon, che la pagina del modello descrive come un modello di ragionamento per compiti lunghi e multi-step degli agenti. Input, ragionamento e output condividono una finestra di contesto da 1.048.576 token, e una risposta sincrona si ferma di default a 65.536 token tra pensiero e output.
Perché un audit di un modello ML è un buon test per Gemini 4 Carbon
Il compito richiede diversi controlli, una ricerca tra le modifiche consentite e uno stop chiaro quando le regole non lasciano risposta. L'ho scelto perché Python può calcolare il risultato di riferimento. La scheda del modello elenca le allucinazioni tra i limiti noti di Gemini 4 Carbon, quindi il modello indaga mentre Python decide se la sua raccomandazione regge.
Il progetto: decidere se il modello antifrode di PayGuard può andare in produzione
PayGuard è il negozio fittizio dell'introduzione e il progetto completo è nel repository GitHub. Il suo classificatore è già addestrato.
Come PayGuard assegna i punteggi alle transazioni
Ogni transazione ha un timestamp in Tempo coordinato universale (UTC), un importo, un canale (Sito web o App mobile), un punteggio di rischio e un'etichetta di frode. Uno HistGradientBoostingClassifier di scikit-learn produce il punteggio, arrotondato a 0,001, e PayGuard contrassegna una transazione quando risk_score >= threshold. Il nostro tutorial sulla curva precisione-richiamo mostra come lo spostamento di una soglia cambi ciò che viene contrassegnato, e il nostro corso Fraud Detection in Python copre il lato modellistico.
I dati sintetici sono suddivisi per tempo:
Training: le prime nove settimane, usate solo per addestrare il classificatore
Validazione: le quattro settimane successive, l'unica finestra che gli strumenti possono leggere
Holdout: le quattro settimane successive, sigillate finché la raccomandazione non è congelata
La soglia attuale è 0,5 e dati e policy non cambiano mai durante l'esperimento. La frode sul Sito web lascia segnali chiari in questi dati, mentre gran parte della frode sull'App mobile sembra un ordine normale.
Ecco le tre regole dell'introduzione, scritte come da policy. Sono tutti obiettivi fittizi che ho scelto per questo esperimento:
R1: le transazioni contrassegnate coprono almeno l'85% del valore di frode etichettato complessivo
R2: coprono almeno il 70% del valore di frode etichettato all'interno di ciascun canale
R3: non più di 200 transazioni vengono contrassegnate in un singolo giorno UTC
Il richiamo per valore di frode è il valore della frode contrassegnata diviso per il valore totale della frode. Diversamente dal richiamo a livello di transazione nella nostra guida precisione vs richiamo, una frode da 2.000 $ mancata conta molto più di una da 15 $, e il contrassegno non significa che i soldi siano stati salvati. R3 pone un tetto al giorno più impegnativo, e quella formulazione finisce per decidere l'audit.
L'agente può indagare su due modifiche: una capacità giornaliera fino a 260 con una sola soglia, oppure soglie distinte per canale con il limite originale. Entrambe richiedono approvazione umana, non possono essere combinate e la policy preferisce l'opzione senza revisori extra.
Cosa conta come audit corretto
Un audit corretto azzecca quattro cose, e dovresti deciderle prima della prima richiesta:
Il verdetto: se una singola soglia soddisfi R1, R2 e R3 sulla validazione
Il conflitto: quali requisiti rendono impossibile la policy originale
L'alternativa: una modifica consentita che superi ogni regola quando Python la ricalcola
La preferenza: la raccomandazione segue l'ordine di preferenza della policy
Un valutatore che l'agente non può chiamare calcola la risposta.
Come configurare l'API Gemini 4 Carbon in Python
Configurare l'API Gemini 4 Carbon richiede Python 3.11 o successivo e una chiave API da un progetto Google AI Studio con billing attivo, dato che la pagina prezzi non prevede un livello gratuito.
Installa il Google Gen AI SDK e prepara il progetto
Ho testato questo progetto con il software development kit (SDK) Google Gen AI bloccato a google-genai==3.1.0, la release su PyPI del giorno del lancio che ha aggiunto gemini-4-carbon alla lista dei modelli Interactions. Clona il progetto e installalo in un ambiente virtuale:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS o Linux: source .venv/bin/activate
pip install-r requirements.txtOfferto da
Dopo, esegui i due comandi nella pagina del repository che generano i dati e adattano il classificatore con seed fissi. Su una nuova clonazione, stampano questo:
Seed fissi ricreano lo stesso dataset. Immagine dell'autore.
Poi metti GEMINI_API_KEY=your-key in un file .env. Il repository lo carica senza stamparlo.
Fai la tua prima richiesta all'API Gemini 4 Carbon
Esegui questo esempio completo dalla cartella del progetto. Fornisce a Gemini 4 Carbon la policy e il riepilogo del classificatore e chiede cosa avrebbe bisogno di misurare, senza suggerire un conflitto:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Offerto da
Il livello di ragionamento va in generation_config e output_text contiene la risposta. Ecco parte di ciò che è tornato:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Offerto da
Ha letto R3 come un picco e ha pianificato l'ordine di preferenza della policy prima ancora di vedere un numero. Non ha mai chiesto però come funzionano i pareggi o l'arrotondamento del punteggio, e il controllo esaustivo che mostrerò dopo dipende proprio da questo. La chiamata ha richiesto circa 40 secondi e costato circa 2 centesimi.
Ometti temperature, top_p e top_k, che Gemini 4 Carbon ignora, e thinking_budget.
Come costruire un agente di audit ML con il function calling di Gemini 4 Carbon
Un agente di audit Gemini 4 Carbon è un loop: il modello richiede una valutazione, Python la valida ed esegue, e il risultato torna finché il modello non smette di chiedere.
Definisci strumenti in sola lettura per la valutazione del modello
L'agente ha tre strumenti. Tutti sono limitati alla finestra di validazione:
get_audit_context: il riepilogo del classificatore, la configurazione attuale, la policy e le modifiche consentite
evaluate_global_threshold: richiamo per valore di frode complessivo e per canale, flag al giorno e diagnostica per una soglia
evaluate_policy_change: le stesse misure per un aumento di capacità o una coppia di soglie per canale
Gli schemi completi sono nel repository. Questo estratto semplificato omette i campi soglia e capacità, quindi non è una dichiarazione completa da copiare. Mostra solo il confine che qui conta: lo strumento accetta le due modifiche di policy consentite da PayGuard, legge i dati di validazione e non approva nulla.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Offerto da
Python valida i campi soglia e capacità omessi, rifiuta le modifiche fuori policy e restituisce misure invece di flag di pass o fail. L'agente non può raggiungere l'holdout, chiamare il valutatore o cambiare la policy. Spiego nelle FAQ perché ho saltato l'esecuzione di codice integrata in Gemini 4 Carbon.
Dai all'agente un obiettivo chiaro e regole di stop
L'istruzione di sistema imposta il metodo. Come la prima richiesta, non suggerisce dove sia il conflitto:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.Offerto da
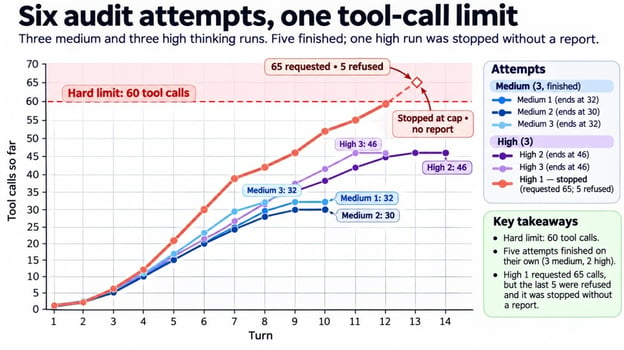
Il prompt può solo chiedere, quindi i limiti vivono nell'harness dell'agente, il codice Python attorno al modello. Poiché l'API non ha un'impostazione di budget, l'applicazione li imposta per tentativo: 25 turni, 60 chiamate a strumenti, 30 minuti e 3 $, con spesa controllata tra i turni.
Implementa il loop di function calling con la Interactions API
Ogni turno è una chiamata a client.interactions.create(). Spesso Gemini 4 Carbon richiede più strumenti insieme, quindi il loop esegue ogni step di function_call. Questo è il loop principale; la versione nel repository aggiunge logging e controlli dei limiti:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Offerto da
Tengo queste impostazioni in un unico dict request così che ogni chiamata successiva le rinvii. previous_interaction_id porta con sé la cronologia, ma tools, system_instruction e generation_config valgono per una sola interaction. Se un turno finisce incomplete, max_output_tokens lo ha troncato, e paghi comunque i token di ragionamento.
Restituisci un report di audit strutturato con uno schema JSON
La guida all'output strutturato di Google elenca strumenti più uno schema JSON in un'unica richiesta come funzionalità Preview che include Gemini 4 Carbon. Io li ho tenuti separati: i turni d'indagine misurano e un turno finale sulla stessa cronologia e configurazione scrive il report con uno schema e senza strumenti:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Offerto da
AuditReport è un modello Pydantic con verdetto, conflitto, evidenze, raccomandazione e approvazioni. Python misura tempo e costo invece di chiedere a Gemini 4 Carbon di riportarli.
Esegui l'audit Gemini 4 Carbon sul modello di rilevazione della frode
Gemini 4 Carbon ha eseguito l'audit del modello come vorrei facesse un analista junior, con misurazioni prima di qualunque conclusione. Al primo tentativo medium ha letto il contesto dell'audit, controllato circa due dozzine di soglie singole e testato otto modifiche di policy.
Tutte le 32 chiamate agli strumenti, in ordine. Immagine dell'autore.
Valuta la soglia attuale di PayGuard
L'agente ha valutato la soglia attuale di 0,5 e ha trovato 91% di richiamo sul Sito web, 20% sull'App mobile, 64% complessivo e 85 flag nel giorno più impegnativo. Questo non soddisfa R1 e la metà Mobile App di R2 con margine sotto R3, quindi la mossa ovvia è abbassare la soglia.
Metti alla prova il richiamo per valore di frode contro la capacità di revisione giornaliera
Abbassare una soglia cattura più valore di frode e manda più ordini in revisione. PayGuard ha bisogno di abbastanza del primo mantenendo il secondo sotto un tetto giornaliero.
L'agente ha provato alcune soglie grossolane in un unico batch, poi ha ristretto a singoli punti griglia. Le chiamate 11, 12, 17 e 18 nel tracciato lo hanno risolto.
Su questa finestra di validazione, il limite minimo per l'App mobile richiede 0,108 o meno, perché un passo più alto la porta appena sotto il 70%. Il tetto richiede 0,118 o più. Nessuna soglia fa entrambe le cose.
Il richiamo complessivo regge fino a 0,137, quindi R1 resta fuori dal conflitto. A 0,108 la giornata media ha circa 169 flag e solo un sabato sfora. Ecco perché la policy usa il carico del giorno più impegnativo invece della media giornaliera.
Il richiamo Mobile e la capacità non si sovrappongono mai. Immagine dell'autore.
Controlla le prestazioni su entrambi i canali di pagamento
La frode sull'App mobile, con segnali più deboli, sta bassa nella gamma di punteggi. Trascinare una soglia a 0,108 per l'App mobile tira dentro anche più ordini legittimi del Sito web e in quel sabato spingono il totale oltre il tetto.
Il numero complessivo lo nasconde: a 0,118 il richiamo complessivo è circa 87% mentre l'App mobile resta sotto il suo minimo. Se la tua policy nomina dei segmenti, misura ciascuno di essi, perché il totale può passare mentre un segmento fallisce.
Gemini 4 Carbon può rilevare requisiti di deploy in conflitto?
Sì, in questo audit. Il report congelato dice not deployable, afferma che nessuna singola soglia funziona e indica R2 per l'App mobile e R3 come conflitto.
Controlla il verdetto di deploy di Gemini 4 Carbon rispetto alle evidenze
Ogni numero citato dal report corrisponde a un risultato degli strumenti, ma una frase afferma più di quanto l'agente abbia misurato. Dice che nessuna soglia funziona "su tutti i punti della griglia di punteggio di rischio a 0,001", eppure l'agente ha testato solo le due dozzine nel tracciato sopra, su 1.002 soglie possibili.
L'affermazione regge perché sia il richiamo sia i conteggi giornalieri calano man mano che la soglia sale, cosa che il report non dice mai. Verifica ogni affermazione nel report di un agente rispetto a ciò che ha misurato, e la nostra guida alla valutazione degli agenti AI copre altri controlli di questo tipo.
Verifica il conflitto con un valutatore Python esaustivo
Gemini 4 Carbon ha campionato soglie e dedotto che nessuna poteva funzionare. Il valutatore dimostra quel risultato per questo set di validazione controllando ogni insieme di flag distinto, senza condividere codice con gli strumenti.
I punteggi stanno su una griglia di 0,001, quindi i 1.002 cutoff candidati coprono ogni possibile insieme di flag. Il valutatore li controlla tutti, più ogni coppia di soglie per canale, usando centesimi interi così che 85% e 70% siano esatti.
Controllo esaustivo e quattro configurazioni rifiutate. Immagine dell'autore.
Nessuna soglia globale supera tutte e tre le regole, quindi l'affermazione di Gemini 4 Carbon ora ha una prova dietro. Il valutatore ha coinciso con i confini 0,108 e 0,118 emersi dalla sondatura dell'agente e ha trovato migliaia di coppie di canale che passano a 200 al giorno.
Un valutatore è utile solo se rifiuta le risposte sbagliate, quindi gli ho dato quattro configurazioni errate e le ha rifiutate tutte.
Metti alla prova le alternative di deploy con Gemini 4 Carbon
Gemini 4 Carbon ha testato entrambe le modifiche consentite e ha scelto soglie separate al tetto originale rispetto a revisori extra. Ha segnalato quella scelta come eccezione che una persona deve approvare.
Testa un aumento della capacità di revisione manuale
Una soglia globale funziona se il tetto sale da 200 a 205, e il valutatore ha confermato 205 come l'aumento minimo. Gemini 4 Carbon ha comunque classificato questa opzione al secondo posto, per via della regola di preferenza descritta prima.
Testa soglie separate per ciascun canale di pagamento
Sul lato canali, l'agente ha mantenuto la soglia dell'App mobile vicino al suo limite (aveva già visto 0,109 far cadere sotto il minimo) e alzato la soglia del Sito web, riducendo i flag sugli ordini legittimi del Sito. Ha testato sette coppie e una è fallita per un solo flag nel giorno più impegnativo. Ha raccomandato Sito web 0,3 e App mobile 0,1 perché quella coppia supera ogni regola con margine, e il valutatore l'ha confermata al tetto originale.
Confronta le alternative verificate
Questi numeri sono già emersi sopra, e il valutatore ha ricalcolato ciascuno:
Opzione
Soglie
Complessivo
Sito web
App mobile
Giorno più impegnativo
Approvazione
Policy originale
Globale 0,108
87,5%
98,2%
70,1%
205, tetto 200
Fallisce
Più capacità
Globale 0,108
87,5%
98,2%
70,1%
205, tetto 205
Necessaria
Split per canale
Sito web 0,3, App mobile 0,1
86,2%
94,5%
72,8%
191, tetto 200
Necessaria
Lo split per canale contrassegna anche circa il 6% di transazioni in meno rispetto all'opzione capacità. Tuttavia, meno della metà dei suoi flag sono frodi, cosa che il report ha elencato come questione aperta.
Come verificare la raccomandazione di Gemini 4 Carbon su dati non visti
Verifichi la raccomandazione applicandola, congelata, all'holdout sigillato. La differenza rispetto al valutatore sono i dati: il valutatore ha valutato settimane che l'agente poteva vedere, e l'holdout valuta quattro settimane successive che nessuno strumento poteva leggere. Il controllo viene eseguito una volta per raccomandazione congelata e non parte se il report è cambiato dopo il congelamento.
La raccomandazione congelata supera l'holdout. Immagine dell'autore.
Ha superato tutte e tre le regole e il giorno più impegnativo è rimasto sotto il tetto. Non trarne troppe conclusioni, però. Tre cose mantengono questo risultato modesto:
L'holdout proviene dallo stesso generatore, quindi non dice nulla su nuovi tipi di frode o data drift
Il richiamo complessivo ha superato l'85% di meno di due punti
La mia ipotesi non testata: lo split potrebbe superare il tetto se il traffico dell'App mobile cresce più velocemente di quello del Sito web, perché la soglia dell'App mobile è molto bassa
Le prime due vengono dai numeri.
Guarda l'audit completo in Streamlit
Il repository include anche un'app Streamlit e i sei tentativi registrati, così puoi aprire questo audit senza una chiamata API. Nel video, la carico e passo in rassegna ciascuna scheda.
L'app Streamlit mostra un audit. Video dell'autore.
Gemini 4 Carbon, ragionamento Medium vs High: accuratezza, tempo e costo
Qui successo significa finire entro i limiti dell'applicazione e restituire un report che il valutatore accetta. Un tentativo interrotto non ha un verdetto da valutare. Per quella definizione, medium ha concluso ogni tentativo e costato meno della metà per audit corretto.
Sei tentativi sono troppo pochi per farne una regola generale. Se i livelli di ragionamento sono nuovi per te, il nostro tutorial sull'API Gemini 3.8 Flash tratta thinking_level in maggior dettaglio.
Confronta medium e high sullo stesso audit
Questo è il confronto completo dietro il TL;DR. Ho eseguito 3 tentativi per livello, ciascuno da uno stato pulito senza memoria degli altri, con dati, prompt, strumenti, limiti e valutatore identici:
Per livello
medium
high
Tentativi conclusi con un report
3 su 3
2 su 3
Audit corretti tra questi
3 su 3
2 su 2
Token di ragionamento per tentativo
Circa 7.700
Circa 17.500
Tempo per tentativo
Circa 5 minuti
Circa 6 minuti
Costo per audit corretto, tariffa introduttiva
Circa 0,25 $
Circa 0,62 $
Costo per audit corretto, tariffa standard
Circa 0,51 $
Circa 1,24 $
Le righe di costo conteggiano la spesa di ogni tentativo, incluso quello che si è fermato. Ogni tentativo concluso è arrivato allo stesso verdetto e conflitto e ha scelto una coppia di canali che il valutatore ha accettato, quindi il ragionamento extra è andato in più controlli.
Ho visto un pattern simile nell'esperimento di coding con Gemini 4 Argon: highha speso di più e fatto più lavoro per un cambiamento minore nel risultato verificato. I compiti sono diversi, quindi costi e tassi di successo non sono direttamente comparabili. In entrambi i casi, il controllo indipendente dice più del totale di ragionamento.
Perché un tentativo con high non è mai finito
Il tentativo che si è fermato era il primo di high, e non ha mai dato un verdetto sbagliato. Ha sondato ogni punto griglia da 0,101 a 0,119 e poi è andato a caccia del limite del 70% per il Sito web, da cui non dipendeva nulla, e ha continuato a chiedere più controlli fino a quando ha raggiunto il limite di 60 chiamate che avevo impostato e l'applicazione lo ha fermato prima che scrivesse un report.
Solo un tentativo ha toccato il limite. Immagine dell'autore.
Quello stop è la parte utile. Un prompt che chiedesse meno chiamate non l'avrebbe concluso, e il limite nel codice sì, dopo circa 22 centesimi.
I cinque report conclusi hanno superato anche gli altri controlli di Python. Nessuno ha letto male la configurazione corrente, nominato un requisito fuori dal conflitto, citato una chiamata a strumenti inesistente o raccomandato una configurazione che non avesse testato.
Misura token, tempo e costo per audit
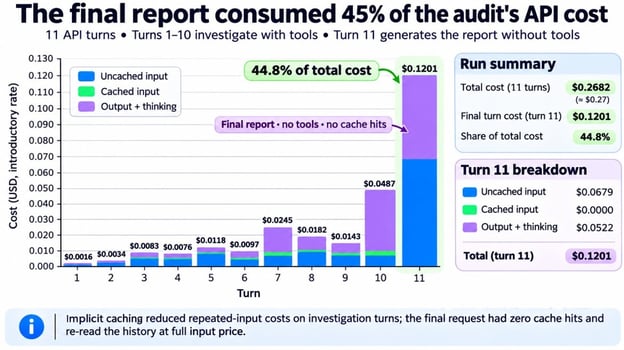
Un audit costa la somma dell'usage di ogni turno, al prezzo di 2,00 $ per milione di token in input, 0,10 $ in cache e 10,00 $ in output inclusi i token di ragionamento, tutto raddoppia il 1° dicembre 2026. total_input_tokens include i token in cache, quindi il codice prezza separatamente le due parti.
Il turno del report costa di più. Immagine dell'autore.
La sorpresa è stato il report, o meglio, il suo conto. La cache implicita ha coperto circa tre quarti dei token in input nei turni di indagine, ma la richiesta del report senza strumenti non ha mai ottenuto un hit di cache.
La causa probabile è che rimuovere tools cambia l'inizio della richiesta. In ogni caso, quel turno ha riletto tutta la cronologia a prezzo pieno e ha rappresentato circa il 40% del costo di ogni tentativo concluso. Considera quel turno quando definisci il limite di spesa.
Limitazioni dell'uso di Gemini 4 Carbon per l'audit di modelli ML
Ho progettato questo test e generato i suoi dati da solo, quindi i risultati hanno questi limiti:
I dati sono sintetici e provengono da un classificatore, e ho regolato il generatore finché non esistesse un conflitto, prima di qualunque chiamata API
Il verdetto copre solo questo classificatore e uno migliore potrebbe soddisfare tutte e tre le regole con una sola soglia
Una soglia può essere verificata, ma approvare uno split per canale è una valutazione di business e fairness
Le interazioni sono archiviate per 55 giorni sul tier a pagamento di default, e store=false esclude previous_interaction_id, quindi un agente che invia righe di transazioni richiede una revisione dei dati
Il valutatore risolve il problema della soglia da solo, senza il modello. Se tutto ciò che ti serve è una soglia, usa un risolutore di ottimizzazione. Ciò che Gemini 4 Carbon ha aggiunto è stato l'audit attorno ad essa.
Qui nulla è legato alla frode. L'impostazione si adatta a qualsiasi modello le cui regole Python può misurare.
Considerazioni finali
Il risultato principale è che Gemini 4 Carbon ha riconosciuto che la policy originale non aveva una soglia globale valida. Tutti e 5 i tentativi completati hanno indicato il conflitto e proposto uno split per canale che il valutatore ha accettato; un tentativo high si è fermato prima di produrre un report.
Gli esperimenti con Gemini 4 Argon e Gemini 4 Carbon testano due lati dell'affidabilità degli agenti. L'agente Gemini 4 Argon ha modificato codice e doveva preservarne il comportamento, mentre l'agente Gemini 4 Carbon è arrivato a una decisione sotto regole che rendevano impossibile la risposta originale. Entrambi hanno avuto bisogno di strumenti ristretti, limiti di risorse e un controllo esterno al modello.
Questo è lo standard che userei per un agente: definire cosa possono stabilire i suoi strumenti, verificare il risultato in modo indipendente e consentire una risposta inconclusivequando le evidenze finiscono. Poi metterei due o tre classificatori candidati sotto la stessa policy e chiederei quale, se qualcuno, può essere rilasciato.
Sono un data engineer e community builder: lavoro su pipeline dati, cloud e strumenti di AI, e scrivo tutorial pratici e ad alto impatto per DataCamp e per sviluppatori alle prime armi.
FAQs
Come ottengo l'accesso all'API Gemini 4 Carbon?⌄
Attraverso un progetto a pagamento su Google AI Studio o tramite Gemini for business su Google Cloud. L'app Gemini, Antigravity e AI Mode lo offrono anche agli abbonati Google AI Ultra, ma quelle app consumer non forniscono una chiave API.
Quanto costa l'API Gemini 4 Carbon?⌄
Tutti e 6 gli audit qui sono costati 2,00 $ alla tariffa introduttiva. Le richieste standard come queste ottengono caching implicito una volta che una richiesta supera 4.096 token in input, quindi mantieni identico l'inizio di ogni richiesta. Il Flex inference, supportato anche dalle richieste Interactions, dimezza le tariffe per token in cambio di risposte più lente e meno affidabili.
Quali sono i rate limit dell'API Gemini 4 Carbon?⌄
I progetti a pagamento hanno limiti per minuto più un limite di spesa, che è di 10 $ per finestre di 10 minuti scorrevoli nel Tier 1, e superarlo restituisce 429 RESOURCE_EXHAUSTED. Un audit qui è costato meno di 1 $, quindi solo molti tentativi in parallelo lo colpirebbero. I limiti aumentano con il tuo tier, quindi controlla la pagina dei rate limit di Google per il tuo progetto.
Qual è la differenza tra medium e high in Gemini 4 Carbon?⌄
Gemini 4 Carbon ha tre livelli, low, medium (predefinito) e high, e qui ho confrontato solo i due superiori. Per vedere com'è il ragionamento extra, imposta thinking_summariessu "auto" e otterrai riassunti condensati accanto a ogni risposta. Sono disattivati per impostazione predefinita e possono risultare vuoti quando il modello ragiona appena.
Gemini 4 Carbon può eseguire codice Python?⌄
Sì. Aggiungi {"type": "code_execution"} a toolse Gemini 4 Carbon può scrivere ed eseguire Python lato Google, fatturato alle sue normali tariffe per token. L'ho lasciato fuori per mantenere il controllo dal mio lato: i tre strumenti decidono cosa può misurare e le transazioni grezze e l'holdout non lasciano mai la mia macchina.
Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.








Nel nostro Tutorial sull'API Gemini 4 Argon, l'agente aveva un compito chiaro: trovare il codice lento, modificarlo e superare i test nascosti. Questo esperimento complementare mantiene lo stesso schema di strumenti controllati e verifica esterna, ma cambia la decisione. Gemini 4 Carbon deve capire se le regole originali possono essere soddisfatte o meno.
PayGuard, un negozio online fittizio, ha un modello di machine learning (ML) addestrato che attribuisce un punteggio di rischio di frode agli ordini. La sua policy di messa in produzione richiede che il modello intercetti abbastanza valore frode in totale e su ciascun canale di vendita, senza sovraccaricare il team di revisione. L'agente deve esaminare queste regole senza che gli venga detto se esiste una soglia valida.
Gemini 4 Carbon è un modello di ragionamento di Google che chiami da Python tramite la Interactions API. Qui agisce come un agente AI: sceglie quali controlli richiedere e Python li esegue tramite tre strumenti in sola lettura usando il function calling. La mia domanda è se riesca a identificare il conflitto, spiegare le evidenze e raccomandare una modifica consentita senza considerarla approvata.
Ti serviranno le basi di Python e un po' di esperienza con le richieste API. Definisco ogni metrica antifrode prima che i numeri la usino. Vedremo come:
Se vuoi la storia del lancio e i punteggi ai benchmark, il nostro overview di Gemini 4 Carbon li contiene, e il nostro confronto Claude Fable 5.2 vs. Gemini 4 Carbon mette a confronto i due modelli. Ho eseguito questo esperimento il giorno dopo l'apertura dell'API agli sviluppatori paganti da parte di Google.
Che cos'è l'API Gemini 4 Carbon?
L'API Gemini 4 Carbon è l'interfaccia di programmazione (API) a pagamento per
gemini-4-carbon, che la pagina del modello descrive come un modello di ragionamento per compiti lunghi e multi-step degli agenti. Input, ragionamento e output condividono una finestra di contesto da 1.048.576 token, e una risposta sincrona si ferma di default a 65.536 token tra pensiero e output.Perché un audit di un modello ML è un buon test per Gemini 4 Carbon
Il compito richiede diversi controlli, una ricerca tra le modifiche consentite e uno stop chiaro quando le regole non lasciano risposta. L'ho scelto perché Python può calcolare il risultato di riferimento. La scheda del modello elenca le allucinazioni tra i limiti noti di Gemini 4 Carbon, quindi il modello indaga mentre Python decide se la sua raccomandazione regge.
Il progetto: decidere se il modello antifrode di PayGuard può andare in produzione
PayGuard è il negozio fittizio dell'introduzione e il progetto completo è nel repository GitHub. Il suo classificatore è già addestrato.
Come PayGuard assegna i punteggi alle transazioni
Ogni transazione ha un timestamp in Tempo coordinato universale (UTC), un importo, un canale (Sito web o App mobile), un punteggio di rischio e un'etichetta di frode. Uno
HistGradientBoostingClassifierdi scikit-learn produce il punteggio, arrotondato a 0,001, e PayGuard contrassegna una transazione quandorisk_score >= threshold. Il nostro tutorial sulla curva precisione-richiamo mostra come lo spostamento di una soglia cambi ciò che viene contrassegnato, e il nostro corso Fraud Detection in Python copre il lato modellistico.I dati sintetici sono suddivisi per tempo:
La soglia attuale è 0,5 e dati e policy non cambiano mai durante l'esperimento. La frode sul Sito web lascia segnali chiari in questi dati, mentre gran parte della frode sull'App mobile sembra un ordine normale.
Gemini 4 Carbon chiede, Python decide. Immagine dell'autore.
Le tre regole di deploy di PayGuard
Ecco le tre regole dell'introduzione, scritte come da policy. Sono tutti obiettivi fittizi che ho scelto per questo esperimento:
Il richiamo per valore di frode è il valore della frode contrassegnata diviso per il valore totale della frode. Diversamente dal richiamo a livello di transazione nella nostra guida precisione vs richiamo, una frode da 2.000 $ mancata conta molto più di una da 15 $, e il contrassegno non significa che i soldi siano stati salvati. R3 pone un tetto al giorno più impegnativo, e quella formulazione finisce per decidere l'audit.
L'agente può indagare su due modifiche: una capacità giornaliera fino a 260 con una sola soglia, oppure soglie distinte per canale con il limite originale. Entrambe richiedono approvazione umana, non possono essere combinate e la policy preferisce l'opzione senza revisori extra.
Cosa conta come audit corretto
Un audit corretto azzecca quattro cose, e dovresti deciderle prima della prima richiesta:
Un valutatore che l'agente non può chiamare calcola la risposta.
Come configurare l'API Gemini 4 Carbon in Python
Configurare l'API Gemini 4 Carbon richiede Python 3.11 o successivo e una chiave API da un progetto Google AI Studio con billing attivo, dato che la pagina prezzi non prevede un livello gratuito.
Installa il Google Gen AI SDK e prepara il progetto
Ho testato questo progetto con il software development kit (SDK) Google Gen AI bloccato a
google-genai==3.1.0, la release su PyPI del giorno del lancio che ha aggiuntogemini-4-carbonalla lista dei modelli Interactions. Clona il progetto e installalo in un ambiente virtuale:Dopo, esegui i due comandi nella pagina del repository che generano i dati e adattano il classificatore con seed fissi. Su una nuova clonazione, stampano questo:
Seed fissi ricreano lo stesso dataset. Immagine dell'autore.
Poi metti
GEMINI_API_KEY=your-keyin un file.env. Il repository lo carica senza stamparlo.Fai la tua prima richiesta all'API Gemini 4 Carbon
Esegui questo esempio completo dalla cartella del progetto. Fornisce a Gemini 4 Carbon la policy e il riepilogo del classificatore e chiede cosa avrebbe bisogno di misurare, senza suggerire un conflitto:
Il livello di ragionamento va in
generation_configeoutput_textcontiene la risposta. Ecco parte di ciò che è tornato:Ha letto R3 come un picco e ha pianificato l'ordine di preferenza della policy prima ancora di vedere un numero. Non ha mai chiesto però come funzionano i pareggi o l'arrotondamento del punteggio, e il controllo esaustivo che mostrerò dopo dipende proprio da questo. La chiamata ha richiesto circa 40 secondi e costato circa 2 centesimi.
Ometti
temperature,top_petop_k, che Gemini 4 Carbon ignora, ethinking_budget.Come costruire un agente di audit ML con il function calling di Gemini 4 Carbon
Un agente di audit Gemini 4 Carbon è un loop: il modello richiede una valutazione, Python la valida ed esegue, e il risultato torna finché il modello non smette di chiedere.
Definisci strumenti in sola lettura per la valutazione del modello
L'agente ha tre strumenti. Tutti sono limitati alla finestra di validazione:
get_audit_context: il riepilogo del classificatore, la configurazione attuale, la policy e le modifiche consentiteevaluate_global_threshold: richiamo per valore di frode complessivo e per canale, flag al giorno e diagnostica per una sogliaevaluate_policy_change: le stesse misure per un aumento di capacità o una coppia di soglie per canaleGli schemi completi sono nel repository. Questo estratto semplificato omette i campi soglia e capacità, quindi non è una dichiarazione completa da copiare. Mostra solo il confine che qui conta: lo strumento accetta le due modifiche di policy consentite da PayGuard, legge i dati di validazione e non approva nulla.
Python valida i campi soglia e capacità omessi, rifiuta le modifiche fuori policy e restituisce misure invece di flag di pass o fail. L'agente non può raggiungere l'holdout, chiamare il valutatore o cambiare la policy. Spiego nelle FAQ perché ho saltato l'esecuzione di codice integrata in Gemini 4 Carbon.
Dai all'agente un obiettivo chiaro e regole di stop
L'istruzione di sistema imposta il metodo. Come la prima richiesta, non suggerisce dove sia il conflitto:
Il prompt può solo chiedere, quindi i limiti vivono nell'harness dell'agente, il codice Python attorno al modello. Poiché l'API non ha un'impostazione di budget, l'applicazione li imposta per tentativo: 25 turni, 60 chiamate a strumenti, 30 minuti e 3 $, con spesa controllata tra i turni.
Implementa il loop di function calling con la Interactions API
Ogni turno è una chiamata a
client.interactions.create(). Spesso Gemini 4 Carbon richiede più strumenti insieme, quindi il loop esegue ogni step difunction_call. Questo è il loop principale; la versione nel repository aggiunge logging e controlli dei limiti:Tengo queste impostazioni in un unico dict
requestcosì che ogni chiamata successiva le rinvii.previous_interaction_idporta con sé la cronologia, matools,system_instructionegeneration_configvalgono per una sola interaction. Se un turno finisceincomplete,max_output_tokenslo ha troncato, e paghi comunque i token di ragionamento.Restituisci un report di audit strutturato con uno schema JSON
La guida all'output strutturato di Google elenca strumenti più uno schema JSON in un'unica richiesta come funzionalità Preview che include Gemini 4 Carbon. Io li ho tenuti separati: i turni d'indagine misurano e un turno finale sulla stessa cronologia e configurazione scrive il report con uno schema e senza strumenti:
AuditReportè un modello Pydantic con verdetto, conflitto, evidenze, raccomandazione e approvazioni. Python misura tempo e costo invece di chiedere a Gemini 4 Carbon di riportarli.Esegui l'audit Gemini 4 Carbon sul modello di rilevazione della frode
Gemini 4 Carbon ha eseguito l'audit del modello come vorrei facesse un analista junior, con misurazioni prima di qualunque conclusione. Al primo tentativo
mediumha letto il contesto dell'audit, controllato circa due dozzine di soglie singole e testato otto modifiche di policy.Tutte le 32 chiamate agli strumenti, in ordine. Immagine dell'autore.
Valuta la soglia attuale di PayGuard
L'agente ha valutato la soglia attuale di 0,5 e ha trovato 91% di richiamo sul Sito web, 20% sull'App mobile, 64% complessivo e 85 flag nel giorno più impegnativo. Questo non soddisfa R1 e la metà Mobile App di R2 con margine sotto R3, quindi la mossa ovvia è abbassare la soglia.
Metti alla prova il richiamo per valore di frode contro la capacità di revisione giornaliera
Abbassare una soglia cattura più valore di frode e manda più ordini in revisione. PayGuard ha bisogno di abbastanza del primo mantenendo il secondo sotto un tetto giornaliero.
L'agente ha provato alcune soglie grossolane in un unico batch, poi ha ristretto a singoli punti griglia. Le chiamate 11, 12, 17 e 18 nel tracciato lo hanno risolto.
Su questa finestra di validazione, il limite minimo per l'App mobile richiede 0,108 o meno, perché un passo più alto la porta appena sotto il 70%. Il tetto richiede 0,118 o più. Nessuna soglia fa entrambe le cose.
Il richiamo complessivo regge fino a 0,137, quindi R1 resta fuori dal conflitto. A 0,108 la giornata media ha circa 169 flag e solo un sabato sfora. Ecco perché la policy usa il carico del giorno più impegnativo invece della media giornaliera.
Il richiamo Mobile e la capacità non si sovrappongono mai. Immagine dell'autore.
Controlla le prestazioni su entrambi i canali di pagamento
La frode sull'App mobile, con segnali più deboli, sta bassa nella gamma di punteggi. Trascinare una soglia a 0,108 per l'App mobile tira dentro anche più ordini legittimi del Sito web e in quel sabato spingono il totale oltre il tetto.
Il numero complessivo lo nasconde: a 0,118 il richiamo complessivo è circa 87% mentre l'App mobile resta sotto il suo minimo. Se la tua policy nomina dei segmenti, misura ciascuno di essi, perché il totale può passare mentre un segmento fallisce.
Gemini 4 Carbon può rilevare requisiti di deploy in conflitto?
Sì, in questo audit. Il report congelato dice
not deployable, afferma che nessuna singola soglia funziona e indica R2 per l'App mobile e R3 come conflitto.Controlla il verdetto di deploy di Gemini 4 Carbon rispetto alle evidenze
Ogni numero citato dal report corrisponde a un risultato degli strumenti, ma una frase afferma più di quanto l'agente abbia misurato. Dice che nessuna soglia funziona "su tutti i punti della griglia di punteggio di rischio a 0,001", eppure l'agente ha testato solo le due dozzine nel tracciato sopra, su 1.002 soglie possibili.
L'affermazione regge perché sia il richiamo sia i conteggi giornalieri calano man mano che la soglia sale, cosa che il report non dice mai. Verifica ogni affermazione nel report di un agente rispetto a ciò che ha misurato, e la nostra guida alla valutazione degli agenti AI copre altri controlli di questo tipo.
Verifica il conflitto con un valutatore Python esaustivo
Gemini 4 Carbon ha campionato soglie e dedotto che nessuna poteva funzionare. Il valutatore dimostra quel risultato per questo set di validazione controllando ogni insieme di flag distinto, senza condividere codice con gli strumenti.
I punteggi stanno su una griglia di 0,001, quindi i 1.002 cutoff candidati coprono ogni possibile insieme di flag. Il valutatore li controlla tutti, più ogni coppia di soglie per canale, usando centesimi interi così che 85% e 70% siano esatti.
Controllo esaustivo e quattro configurazioni rifiutate. Immagine dell'autore.
Nessuna soglia globale supera tutte e tre le regole, quindi l'affermazione di Gemini 4 Carbon ora ha una prova dietro. Il valutatore ha coinciso con i confini 0,108 e 0,118 emersi dalla sondatura dell'agente e ha trovato migliaia di coppie di canale che passano a 200 al giorno.
Un valutatore è utile solo se rifiuta le risposte sbagliate, quindi gli ho dato quattro configurazioni errate e le ha rifiutate tutte.
Metti alla prova le alternative di deploy con Gemini 4 Carbon
Gemini 4 Carbon ha testato entrambe le modifiche consentite e ha scelto soglie separate al tetto originale rispetto a revisori extra. Ha segnalato quella scelta come eccezione che una persona deve approvare.
Testa un aumento della capacità di revisione manuale
Una soglia globale funziona se il tetto sale da 200 a 205, e il valutatore ha confermato 205 come l'aumento minimo. Gemini 4 Carbon ha comunque classificato questa opzione al secondo posto, per via della regola di preferenza descritta prima.
Testa soglie separate per ciascun canale di pagamento
Sul lato canali, l'agente ha mantenuto la soglia dell'App mobile vicino al suo limite (aveva già visto 0,109 far cadere sotto il minimo) e alzato la soglia del Sito web, riducendo i flag sugli ordini legittimi del Sito. Ha testato sette coppie e una è fallita per un solo flag nel giorno più impegnativo. Ha raccomandato Sito web 0,3 e App mobile 0,1 perché quella coppia supera ogni regola con margine, e il valutatore l'ha confermata al tetto originale.
Confronta le alternative verificate
Questi numeri sono già emersi sopra, e il valutatore ha ricalcolato ciascuno:
Opzione
Soglie
Complessivo
Sito web
App mobile
Giorno più impegnativo
Approvazione
Policy originale
Globale 0,108
87,5%
98,2%
70,1%
205, tetto 200
Fallisce
Più capacità
Globale 0,108
87,5%
98,2%
70,1%
205, tetto 205
Necessaria
Split per canale
Sito web 0,3, App mobile 0,1
86,2%
94,5%
72,8%
191, tetto 200
Necessaria
Lo split per canale contrassegna anche circa il 6% di transazioni in meno rispetto all'opzione capacità. Tuttavia, meno della metà dei suoi flag sono frodi, cosa che il report ha elencato come questione aperta.
Come verificare la raccomandazione di Gemini 4 Carbon su dati non visti
Verifichi la raccomandazione applicandola, congelata, all'holdout sigillato. La differenza rispetto al valutatore sono i dati: il valutatore ha valutato settimane che l'agente poteva vedere, e l'holdout valuta quattro settimane successive che nessuno strumento poteva leggere. Il controllo viene eseguito una volta per raccomandazione congelata e non parte se il report è cambiato dopo il congelamento.
La raccomandazione congelata supera l'holdout. Immagine dell'autore.
Ha superato tutte e tre le regole e il giorno più impegnativo è rimasto sotto il tetto. Non trarne troppe conclusioni, però. Tre cose mantengono questo risultato modesto:
Le prime due vengono dai numeri.
Guarda l'audit completo in Streamlit
Il repository include anche un'app Streamlit e i sei tentativi registrati, così puoi aprire questo audit senza una chiamata API. Nel video, la carico e passo in rassegna ciascuna scheda.