Gemini 4 Carbon API ट्यूटोरियल: एक एजेंट बनाएँ जो फ्रॉड मॉडल का ऑडिट करे
Python में Gemini 4 Carbon API सीखें: एक फंक्शन-कॉलिंग एजेंट बनाएँ जो फ्रॉड मॉडल का ऑडिट करे, परस्पर-विरोधी नियम ढूँढे, और किसी नीति बदलाव का परीक्षण करे।
हमारे Gemini 4 Argon API ट्यूटोरियल में एजेंट का काम साफ था: धीमा कोड ढूँढना, उसे बदलना, और हिडन टेस्ट पास करना। यह साथी प्रयोग नियंत्रित टूल्स और बाहरी जाँच के उसी ढाँचे को रखता है, पर निर्णय बदल देता है। Gemini 4 Carbon को यह समझना है कि क्या मूल नियमों को किसी भी तरह पूरा किया जा सकता है।
PayGuard, एक काल्पनिक ऑनलाइन स्टोर, के पास एक प्रशिक्षित मशीन लर्निंग (ML) मॉडल है जो ऑर्डरों का फ्रॉड स्कोर निकालता है। इसकी डिप्लॉयमेंट नीति चाहती है कि मॉडल कुल मिलाकर और हर सेल्स चैनल पर पर्याप्त फ्रॉड वैल्यू पकड़े, वह भी रिव्यू टीम पर बोझ डाले बिना। एजेंट को इन नियमों की जाँच करनी है, बिना यह बताए कि कोई वैध थ्रेशहोल्ड मौजूद है या नहीं।
Gemini 4 Carbon एक Google रीजनिंग मॉडल है जिसे आप Python से Interactions API के ज़रिए कॉल करते हैं। यहाँ यह एक AI एजेंट की तरह काम करता है: यह तय करता है किन जाँचों का अनुरोध करना है, और Python उन्हें function calling के माध्यम से तीन केवल-पढ़ने योग्य टूल्स से चलाता है। मेरा प्रश्न है कि क्या यह टकराव की पहचान कर सकता है, साक्ष्य समझा सकता है, और किसी अनुमत बदलाव की सिफारिश कर सकता है, बिना उसे मंज़ूर किए मानने के।
आपको बेसिक Python और API रिक्वेस्ट्स का थोड़ा अनुभव चाहिए। मैं हर फ्रॉड मेट्रिक को उसके इस्तेमाल से पहले परिभाषित करता हूँ। हम यह कवर करेंगे कि कैसे:
Python से Gemini 4 Carbon को पहला अनुरोध भेजें
मॉडल को केवल-पढ़ने योग्य टूल्स दें और सीमाओं के साथ उन्हें लूप में चलाएँ
वर्डिक्ट को ऐसे JSON में पाएँ जिसे आपका कोड जाँच सके
उस वर्डिक्ट को उस कोड और डाटा से वेरिफ़ाई करें जो मॉडल ने कभी नहीं देखा
दो थिंकिंग लेवल्स की तुलना करें, जो तय करते हैं कि मॉडल जवाब देने से पहले कितना तर्क करेगा
यदि आप लॉन्च स्टोरी और बेंचमार्क स्कोर चाहते हैं, तो हमारा Gemini 4 Carbon ओवरव्यू इन्हें कवर करता है, और हमारा Claude Fable 5.2 बनाम Gemini 4 Carbon विश्लेषण दोनों मॉडलों की तुलना करता है। मैंने यह प्रयोग उस अगले दिन चलाया जब Google ने API भुगतान करने वाले डेवलपर्स के लिए खोली।
Gemini 4 Carbon API क्या है?
Gemini 4 Carbon API, gemini-4-carbon के लिए भुगतान-योग्य एप्लिकेशन प्रोग्रामिंग इंटरफ़ेस (API) है, जिसे मॉडल पेज लम्बे, मल्टी-स्टेप एजेंट टास्क्स के लिए एक रीजनिंग मॉडल के रूप में वर्णित करता है। इनपुट, थिंकिंग और आउटपुट एक 1,048,576-टोकन कॉन्टेक्स्ट विंडो साझा करते हैं, और एक सिंक्रोनस रिस्पॉन्स डिफ़ॉल्ट रूप से 65,536 टोकन की थिंकिंग प्लस आउटपुट पर रुक जाता है।
क्यों एक ML मॉडल ऑडिट Gemini 4 Carbon के लिए अच्छा टेस्ट है
इस कार्य में कई जाँचें, अनुमत बदलावों में खोज, और तब साफ़ स्टॉप शामिल है जब नियम कोई उत्तर नहीं छोड़ते। मैंने इसे इसलिए चुना क्योंकि Python संदर्भ परिणाम की गणना कर सकता है। मॉडल कार्ड Gemini 4 Carbon की ज्ञात सीमाओं में भ्रम-जनित उत्तरों का उल्लेख करता है, इसलिए मॉडल जाँच-पड़ताल करता है जबकि Python यह तय करता है कि उसकी सिफारिश ठहरती है या नहीं।
प्रोजेक्ट: तय करना कि PayGuard का फ्रॉड मॉडल लाइव जा सकता है या नहीं
PayGuard वही काल्पनिक स्टोर है जिसका ज़िक्र भूमिका में था, और पूरा प्रोजेक्ट GitHub रिपोजिटरी में है। इसका क्लासिफ़ायर पहले से प्रशिक्षित है।
PayGuard ट्रांज़ैक्शनों को कैसे स्कोर करता है
हर ट्रांज़ैक्शन में Coordinated Universal Time (UTC) टाइमस्टैम्प, अमाउंट, चैनल (Website या Mobile App), एक रिस्क स्कोर, और फ्रॉड लेबल होता है। एक scikit-learn HistGradientBoostingClassifier स्कोर बनाता है, जिसे 0.001 पर राउंड किया जाता है, और PayGuard किसी ट्रांज़ैक्शन को तब फ़्लैग करता है जब risk_score >= threshold। हमारा प्रिसीज़न-रिकॉल कर्व ट्यूटोरियल दिखाता है कि थ्रेशहोल्ड बदलने से क्या फ़्लैग होता है में कैसे बदलाव आता है, और हमारा Fraud Detection in Python कोर्स मॉडलिंग पक्ष को कवर करता है।
सिंथेटिक डाटा समय के आधार पर विभाजित है:
Training: पहली नौ हफ्ते, केवल क्लासिफ़ायर को फ़िट करने के लिए
Validation: अगले चार हफ्ते, वही विंडो जिसे टूल्स पढ़ सकते हैं
Holdout: उसके बाद के चार हफ्ते, सिफारिश फ्रीज़ होने तक सीलबंद
वर्तमान थ्रेशहोल्ड 0.5 है, और प्रयोग के दौरान डाटा और नीति नहीं बदलते। Website फ्रॉड इस डाटा में स्पष्ट संकेत छोड़ता है, जबकि अधिकतर Mobile App फ्रॉड एक सामान्य ऑर्डर जैसा दिखता है।
Gemini 4 Carbon पूछता है, Python निर्णय लेता है। चित्र: लेखक।
PayGuard के तीन डिप्लॉयमेंट नियम
यहाँ भूमिका में दिए गए तीन नियम हैं, नीति की भाषा में लिखे हुए। ये सभी इस प्रयोग के लिए चुने गए काल्पनिक लक्ष्य हैं:
R1: फ़्लैग की गई ट्रांज़ैक्शन कुल लेबल्ड फ्रॉड वैल्यू का कम से कम 85% कवर करें
R2: वे प्रत्येक चैनल के भीतर लेबल्ड फ्रॉड वैल्यू का कम से कम 70% कवर करें
R3: किसी भी एकल UTC दिन पर 200 से अधिक ट्रांज़ैक्शन फ़्लैग न हों
फ्रॉड-वैल्यू रिकॉल का मतलब है फ़्लैग की गई फ्रॉड वैल्यू को कुल फ्रॉड वैल्यू से भाग देना। हमारी प्रिसीज़न बनाम रिकॉल गाइड के ट्रांज़ैक्शन-स्तरीय रिकॉल के विपरीत, छूटा हुआ $2,000 का फ्रॉड $15 वाले से कहीं ज़्यादा मायने रखता है, और फ़्लैग होने का मतलब यह नहीं कि पैसा बच गया। R3 सबसे व्यस्त एक दिन पर सीमा लगाता है, और यही शब्दावली अंततः ऑडिट का फ़ैसला करती है।
एजेंट दो बदलावों की जाँच कर सकता है: एक थ्रेशहोल्ड के साथ दैनिक क्षमता अधिकतम 260 तक, या मूल कैप पर अलग-अलग चैनल थ्रेशहोल्ड। दोनों के लिए मानव स्वीकृति चाहिए, वे जोड़े नहीं जा सकते, और नीति बिना अतिरिक्त रिव्यूअर्स वाले विकल्प को प्राथमिकता देती है।
सही ऑडिट किसे मानें
एक सही ऑडिट चार बातों को ठीक-ठीक पकड़े, और आपको पहली रिक्वेस्ट से पहले इन्हें तय कर लेना चाहिए:
वर्डिक्ट: क्या कोई एकल थ्रेशहोल्ड वैलिडेशन पर R1, R2, और R3 पूरी करता है
संघर्ष: कौन-सी आवश्यकताएँ मूल नीति को असंभव बनाती हैं
विकल्प: कोई अनुमत बदलाव जो Python द्वारा दोबारा गिनने पर हर नियम पार कर ले
प्राथमिकता: सिफारिश नीति के प्रेफरेंस क्रम का पालन करे
एजेंट जिस इवैल्युएटर को कॉल नहीं कर सकता, वही उत्तर की गणना करता है।
Python में Gemini 4 Carbon API कैसे सेटअप करें
Gemini 4 Carbon API सेटअप के लिए Python 3.11 या नया संस्करण और API कुंजी चाहिए, जो बिलिंग चालू वाले Google AI Studio प्रोजेक्ट से मिलेगी, क्योंकि प्राइसिंग पेज कोई फ्री टियर सूचीबद्ध नहीं करता।
Google Gen AI SDK इंस्टॉल करें और प्रोजेक्ट तैयार करें
मैंने इस प्रोजेक्ट को Google Gen AI सॉफ़्टवेयर डेवलपमेंट किट (SDK) पर टेस्ट किया, जिसे google-genai==3.1.0 पर पिन किया गया था, जो लॉन्च-डे की PyPI रिलीज़ है जिसने Interactions मॉडल सूची में gemini-4-carbon जोड़ा। प्रोजेक्ट क्लोन करें और वर्चुअल एनवायरनमेंट में इंस्टॉल करें:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS or Linux: source .venv/bin/activate
pip install-r requirements.txtसंचालित द्वारा
इसके बाद, रिपोजिटरी पेज पर दिए गए दो कमांड चलाएँ जो डाटा बनाते हैं और फिक्स्ड सीड्स के साथ क्लासिफ़ायर फ़िट करते हैं। नई क्लोन पर वे यह प्रिंट करते हैं:
फिक्स्ड सीड्स वही डेटासेट रीबिल्ड करते हैं। चित्र: लेखक।
फिर GEMINI_API_KEY=your-key को एक .env फ़ाइल में रखें। रिपोजिटरी इसे बिना प्रिंट किए लोड करती है।
अपना पहला Gemini 4 Carbon API अनुरोध बनाएँ
यह पूरा उदाहरण प्रोजेक्ट फ़ोल्डर से चलाएँ। यह Gemini 4 Carbon को नीति और क्लासिफ़ायर सारांश देता है और पूछता है कि उसे क्या नापना होगा, बिना किसी टकराव का संकेत दिए:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")संचालित द्वारा
थिंकिंग लेवल generation_config में जाता है, और output_text में उत्तर होता है। यहाँ उसके उत्तर का एक हिस्सा है:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412संचालित द्वारा
इसने R3 को पीक के रूप में पढ़ा और बिना किसी संख्या देखे नीति की प्रेफरेंस ऑर्डर की योजना बना ली। हालाँकि, इसने कभी नहीं पूछा कि टाई या स्कोर राउंडिंग कैसे काम करते हैं, और बाद में दिखाऊँगा कि थकाऊ जाँच ठीक उसी पर निर्भर करती है। कॉल में लगभग 40 सेकंड लगे और लगभग 2 सेंट खर्च आए।
temperature, top_p, और top_k को छोड़ दें, जिन्हें Gemini 4 Carbon इग्नोर करता है, और thinking_budget को भी।
Gemini 4 Carbon फंक्शन कॉलिंग से ML ऑडिट एजेंट कैसे बनाएँ
एक Gemini 4 Carbon ऑडिट एजेंट एक लूप है: मॉडल एक इवैल्युएशन का अनुरोध करता है, Python उसे वेलिडेट कर चलाता है, और परिणाम तब तक वापस जाता है जब तक मॉडल पूछना बंद न कर दे।
मॉडल इवैल्युएशन के लिए केवल-पढ़ने योग्य टूल्स परिभाषित करें
एजेंट को तीन टूल मिलते हैं। सभी वैलिडेशन विंडो तक सीमित हैं:
get_audit_context: क्लासिफ़ायर सारांश, वर्तमान कॉन्फ़िगरेशन, नीति, और अनुमत बदलाव
evaluate_global_threshold: एक थ्रेशहोल्ड के लिए कुल और चैनल-वार फ्रॉड-वैल्यू रिकॉल, प्रति दिन फ़्लैग, और डायग्नॉस्टिक्स
evaluate_policy_change: क्षमता वृद्धि या चैनल-थ्रेशहोल्ड जोड़ी के लिए वही माप
पूरी स्कीमाएँ रिपोजिटरी में हैं। यह सरलीकृत अंश थ्रेशहोल्ड और क्षमता फ़ील्ड छोड़ देता है, इसलिए यह कॉपी करने लायक पूरी डिक्लेरेशन नहीं है। यह केवल वह सीमा दिखाता है जो यहाँ मायने रखती है: टूल PayGuard द्वारा अनुमत दो नीति बदलावों को स्वीकार करता है, वैलिडेशन डाटा पढ़ता है, और कुछ अप्रूव नहीं करता।
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}संचालित द्वारा
Python छोड़े गए थ्रेशहोल्ड और क्षमता फ़ील्ड्स को वेलिडेट करता है, नीति से बाहर के बदलावों को अस्वीकार करता है, और पास/फेल के फ़्लैग्स के बजाय माप लौटाता है। एजेंट होल्डआउट तक नहीं पहुँच सकता, इवैल्युएटर को कॉल नहीं कर सकता, या नीति नहीं बदल सकता। मैं FAQs में बताता हूँ कि मैंने Gemini 4 Carbon के बिल्ट-इन कोड एग्जीक्यूशन को क्यों छोड़ा।
एजेंट को स्पष्ट उद्देश्य और स्टॉपिंग नियम दें
सिस्टम इंस्ट्रक्शन विधि तय करता है। पहली रिक्वेस्ट की तरह, यह नहीं बताता कि टकराव कहाँ है:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.संचालित द्वारा
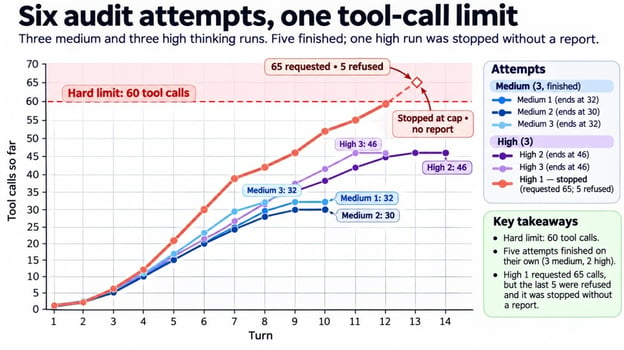
प्रॉम्प्ट केवल मांग सकता है, इसलिए सीमाएँ एजेंट हार्नेस, यानी मॉडल के चारों ओर के Python कोड में रहती हैं। चूँकि API में कोई बजट सेटिंग नहीं, एप्लिकेशन प्रत्येक प्रयास पर सीमाएँ सेट करता है: 25 टर्न, 60 टूल कॉल, 30 मिनट, और $3, जहाँ खर्च टर्न्स के बीच जाँचा जाता है।
Interactions API के साथ फंक्शन कॉलिंग लूप लागू करें
हर टर्न एक client.interactions.create() कॉल है। Gemini 4 Carbon अक्सर एक साथ कई टूल्स का अनुरोध करता है, इसलिए लूप हर function_call स्टेप चलाता है। यह कोर लूप है, और रिपोजिटरी संस्करण लॉगिंग और लिमिट चेक्स जोड़ता है:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)संचालित द्वारा
मैं ये सेटिंग्स एक ही request डिक्ट में रखता हूँ ताकि हर फॉलो-अप कॉल इन्हें फिर से भेजे। previous_interaction_id हिस्ट्री को साथ ले जाता है, पर tools, system_instruction, और generation_config केवल एक इंटरैक्शन पर लागू होते हैं। यदि कोई टर्न incomplete पर खत्म होता है, तो max_output_tokens ने उसे काट दिया, और फिर भी आप उसके थिंकिंग टोकन्स का भुगतान करते हैं।
JSON स्कीमा के साथ संरचित ऑडिट रिपोर्ट लौटाएँ
Google की structured output गाइड, Gemini 4 Carbon सहित, एक प्रीव्यू फ़ीचर के रूप में एक ही रिक्वेस्ट में टूल्स और JSON स्कीमा सूचीबद्ध करती है। फिर भी मैंने इन्हें अलग रखा: जाँच वाले टर्न केवल मापते हैं, और उसी हिस्ट्री और कॉन्फ़िग पर एक अंतिम टर्न बिना टूल्स के स्कीमा सहित रिपोर्ट लिखता है:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)संचालित द्वारा
AuditReport एक Pydantic मॉडल है, जिसमें वर्डिक्ट, संघर्ष, साक्ष्य, सिफारिश, और अनुमोदन शामिल हैं। Python समय और लागत को स्वयं मापता है, बजाय इसके कि Gemini 4 Carbon को उन्हें रिपोर्ट करने को कहे।
फ्रॉड डिटेक्शन मॉडल पर Gemini 4 Carbon ऑडिट चलाएँ
Gemini 4 Carbon ने मॉडल का ऑडिट उसी तरह किया जैसा मैं किसी जूनियर एनालिस्ट से चाहता, यानी किसी निष्कर्ष से पहले माप। पहली medium कोशिश में, इसने ऑडिट संदर्भ पढ़ा, लगभग दो दर्जन एकल थ्रेशहोल्ड जाँचे, और आठ नीति बदलावों को टेस्ट किया।
सभी 32 टूल कॉल, क्रम में। चित्र: लेखक।
PayGuard के वर्तमान थ्रेशहोल्ड का मूल्यांकन करें
एजेंट ने 0.5 के मौजूदा थ्रेशहोल्ड का आकलन किया और 91% Website रिकॉल, 20% Mobile App रिकॉल, 64% कुल रिकॉल, और सबसे व्यस्त दिन पर 85 फ़्लैग पाए। यह R1 और R2 के Mobile App हिस्से में फेल होता है, जबकि R3 के नीचे जगह बचती है, तो साफ़ कदम होगा थ्रेशहोल्ड घटाना।
दैनिक रिव्यू क्षमता के विरुद्ध फ्रॉड-वैल्यू रिकॉल टेस्ट करें
थ्रेशहोल्ड घटाने से अधिक फ्रॉड वैल्यू पकड़ेगी और अधिक ऑर्डर रिव्यू में जाएँगे। PayGuard को पहले में पर्याप्त चाहिए और दूसरे को दैनिक कैप के नीचे रखना है।
एजेंट ने एक बैच में कुछ मोटे थ्रेशहोल्ड आज़माए, फिर एकल ग्रिड पॉइंट्स तक सीमित हुआ। ट्रेस में कॉल 11, 12, 17, और 18 ने बात साफ़ कर दी।
इस वैलिडेशन विंडो पर, Mobile App की न्यूनतम जरूरत 0.108 या नीचे है, क्योंकि एक स्टेप ऊपर यह 70% से थोड़ा नीचे गिरता है। कैप के लिए 0.118 या ऊपर चाहिए। कोई थ्रेशहोल्ड दोनों नहीं करता।
कुल रिकॉल 0.137 तक बना रहता है, इसलिए R1 टकराव से बाहर है। 0.108 पर औसत दिन में लगभग 169 फ़्लैग होते हैं, और सिर्फ एक शनिवार ऊपर जाता है। यही वजह है कि नीति दैनिक औसत की बजाय सबसे व्यस्त दिन के वर्कलोड का उपयोग करती है।
मोबाइल रिकॉल और क्षमता कभी ओवरलैप नहीं करते। चित्र: लेखक।
दोनों भुगतान चैनलों पर प्रदर्शन जाँचें
कमज़ोर संकेतों वाला Mobile App फ्रॉड स्कोर रेंज के निचले हिस्से में बैठता है। Mobile App के लिए एक ही थ्रेशहोल्ड को 0.108 तक नीचे खींचना वैध Website ऑर्डर भी अधिक खींच लाता है, और उसी शनिवार को वे कुल को कैप से ऊपर धकेलते हैं।
कुल संख्या इसे छुपा देती है: 0.118 पर, कुल रिकॉल लगभग 87% है जबकि Mobile App अपना फ़्लोर से नीचे बैठा है। यदि आपकी नीति सेगमेंट्स का नाम लेती है, तो हर सेगमेंट को मापें, क्योंकि कुल पास हो सकता है जबकि कोई एक सेगमेंट फेल हो।
क्या Gemini 4 Carbon परस्पर-विरोधी डिप्लॉयमेंट आवश्यकताएँ पहचान सकता है?
हाँ, इस ऑडिट पर। फ्रीज़ की गई रिपोर्ट not deployable कहती है, कहती है कि कोई एकल थ्रेशहोल्ड काम नहीं करता, और Mobile App के लिए R2 तथा R3 को टकराव के रूप में नाम देती है।
Gemini 4 Carbon के डिप्लॉयमेंट वर्डिक्ट को उसके साक्ष्य से मिलाएँ
रिपोर्ट में दिए गए हर नंबर किसी टूल परिणाम से मेल खाते हैं, पर एक वाक्य एजेंट द्वारा मापे से अधिक दावा करता है। यह कहता है कि कोई भी थ्रेशहोल्ड "सभी 0.001 रिस्क-स्कोर ग्रिड पॉइंट्स" पर काम नहीं करता, जबकि एजेंट ने ऊपर ट्रेस में सिर्फ दो दर्जन टेस्ट किए, 1,002 संभावित थ्रेशहोल्ड्स में से।
दावा इसलिए ठहरता है क्योंकि थ्रेशहोल्ड बढ़ने पर रिकॉल और दैनिक काउंट दोनों गिरते हैं, जिसे रिपोर्ट कभी कहती नहीं। किसी एजेंट की रिपोर्ट में दिए हर दावे को इस आधार पर जाँचें कि उसने क्या मापा, और हमारी AI एजेंट्स के मूल्यांकन की गाइड इस तरह की और जाँचें कवर करती है।
थकाऊ Python इवैल्युएटर से टकराव वेरिफ़ाई करें
Gemini 4 Carbon ने थ्रेशहोल्ड सैंपल किए और निष्कर्ष निकाला कि कोई काम नहीं कर सकता। इवैल्युएटर इस वैलिडेशन सेट के लिए हर भिन्न फ़्लैग सेट जाँचकर, टूल्स के साथ कोड साझा किए बिना, परिणाम साबित करता है।
स्कोर 0.001 ग्रिड पर बैठते हैं, इसलिए 1,002 कैंडिडेट कटऑफ़ हर संभावित फ़्लैग सेट कवर करते हैं। इवैल्युएटर उन सबको, साथ ही हर चैनल-थ्रेशहोल्ड जोड़ी को जाँचता है, और 85% तथा 70% को सटीक रखने के लिए इंटीजर सेंट्स का उपयोग करता है।
थकाऊ जाँच और चार अस्वीकार की गई कॉन्फ़िगरेशन। चित्र: लेखक।
कोई ग्लोबल थ्रेशहोल्ड तीनों नियम पास नहीं करता, तो अब Gemini 4 Carbon का दावा प्रमाणित है। इवैल्युएटर ने एजेंट की प्रोबिंग से 0.108 और 0.118 सीमाएँ मैच कीं और 200 प्रति दिन पर पास होने वाली हज़ारों चैनल जोड़ियाँ पाईं।
इवैल्युएटर तभी काम का है जब वह खराब उत्तरों को खारिज कर दे, इसलिए मैंने उसे चार गलत कॉन्फ़िगरेशन दीं, और उसने चारों को अस्वीकार किया।
Gemini 4 Carbon के साथ डिप्लॉयमेंट विकल्पों का परीक्षण करें
Gemini 4 Carbon ने दोनों अनुमत बदलावों को टेस्ट किया और अतिरिक्त रिव्यूअर्स की बजाय मूल कैप पर अलग-अलग थ्रेशहोल्ड चुने। इसने उस चयन को व्यक्ति द्वारा स्वीकृत किए जाने वाली अपवाद के रूप में फ़्लैग किया।
मैनुअल रिव्यू क्षमता में वृद्धि का परीक्षण करें
यदि कैप 200 से 205 तक बढ़े तो एक ग्लोबल थ्रेशहोल्ड काम करता है, और इवैल्युएटर ने 205 को सबसे छोटी वृद्धि के रूप में कन्फ़र्म किया। Gemini 4 Carbon ने फिर भी इस विकल्प को दूसरा स्थान दिया, उस प्राथमिकता नियम की वजह से जिसका मैंने पहले वर्णन किया।
प्रत्येक भुगतान चैनल के लिए अलग थ्रेशहोल्ड का परीक्षण करें
चैनल पक्ष पर, एजेंट ने Mobile App थ्रेशहोल्ड को उसकी सीमा के पास रखा (इसने पहले ही देखा था कि 0.109 फ़्लोर तोड़ता है) और Website थ्रेशहोल्ड बढ़ाया, वैध Website ऑर्डरों पर फ़्लैग घटाते हुए। इसने सात जोड़ियाँ टेस्ट कीं, और एक सबसे व्यस्त दिन पर एक फ़्लैग से फेल हुई। इसने Website 0.3 और Mobile App 0.1 की सिफारिश की क्योंकि यह जोड़ी हर नियम आराम से पार करती है, और इवैल्युएटर ने इसे मूल कैप पर कन्फ़र्म किया।
वेरिफ़ाई किए गए विकल्पों की तुलना करें
ये संख्याएँ ऊपर आई थीं, और इवैल्युएटर ने हर एक को फिर से गिना:
विकल्प
थ्रेशहोल्ड्स
कुल
Website
Mobile App
सबसे व्यस्त दिन
अनुमोदन
मूल नीति
ग्लोबल 0.108
87.5%
98.2%
70.1%
205, कैप 200
असफ़ल
अधिक क्षमता
ग्लोबल 0.108
87.5%
98.2%
70.1%
205, कैप 205
आवश्यक
चैनल स्प्लिट
Website 0.3, Mobile App 0.1
86.2%
94.5%
72.8%
191, कैप 200
आवश्यक
चैनल स्प्लिट क्षमता विकल्प की तुलना में लगभग 6% कम ट्रांज़ैक्शन भी फ़्लैग करता है। हालाँकि, इसके आधे से कम फ़्लैग फ्रॉड हैं, जिसे रिपोर्ट ने खुले मुद्दे के रूप में सूचीबद्ध किया।
अनदेखे डाटा पर Gemini 4 Carbon की सिफारिश कैसे वेरिफ़ाई करें
आप सिफारिश को फ्रीज़ करके सीलबंद होल्डआउट पर लागू कर वेरिफ़ाई करते हैं। इवैल्युएटर से फर्क डाटा का है: इवैल्युएटर ने वे हफ्ते स्कोर किए जिन्हें एजेंट देख सकता था, और होल्डआउट चार बाद के हफ्ते स्कोर करता है जिन्हें कोई टूल नहीं पढ़ सका। यह जाँच प्रति फ्रीज़ की गई सिफारिश एक बार चलती है और अगर फ्रीज़ के बाद रिपोर्ट बदली हो तो शुरू नहीं होगी।
फ्रीज़ की गई सिफारिश होल्डआउट पर पास होती है। चित्र: लेखक।
यह तीनों नियम पास कर गई, और सबसे व्यस्त दिन कैप के नीचे रहा। पर इसे ज़्यादा न पढ़ें। तीन बातें इस परिणाम को संयत रखती हैं:
होल्डआउट उसी जेनरेटर से आता है, इसलिए यह नए तरह के फ्रॉड या डेटा ड्रिफ्ट के बारे में कुछ नहीं कहता
कुल रिकॉल 85% से दो पॉइंट से कम ऊपर था
मेरा अपरीक्षित अनुमान: यदि Mobile App ट्रैफ़िक Website ट्रैफ़िक से तेज़ी से बढ़ता है, तो स्प्लिट कैप तोड़ सकता है, क्योंकि Mobile App थ्रेशहोल्ड बहुत कम बैठा है
पहले दो तो संख्याओं से आते हैं।
Streamlit में पूरा ऑडिट देखें
रिपोजिटरी में एक Streamlit ऐप और छह रिकॉर्ड किए हुए प्रयास भी शामिल हैं, ताकि आप यह ऑडिट बिना API कॉल के खोल सकें। वीडियो में, मैं इसे लोड करता हूँ और हर टैब से होकर गुजरता हूँ।
Streamlit ऐप एक ऑडिट दिखाता है। वीडियो: लेखक।
Gemini 4 Carbon Medium बनाम High थिंकिंग: सटीकता, समय, और लागत
यहाँ सफलता का मतलब है एप्लिकेशन सीमाओं के भीतर खत्म करना और ऐसी रिपोर्ट लौटाना जिसे इवैल्युएटर स्वीकार करे। रुका हुआ प्रयास स्कोर करने लायक वर्डिक्ट नहीं रखता। इस परिभाषा से, medium हर प्रयास में खत्म हुआ और प्रति सही ऑडिट आधे से भी कम लागत आई।
छह प्रयास किसी सामान्य नियम के लिए बहुत कम हैं। यदि थिंकिंग लेवल आपके लिए नए हैं, तो हमारा Gemini 3.8 Flash API ट्यूटोरियलthinking_level को और विस्तार से कवर करता है।
उसी ऑडिट पर medium और high थिंकिंग की तुलना करें
यह TL;DR के पीछे की पूरी तुलना है। मैंने प्रति लेवल 3 प्रयास चलाए, हर बार एक साफ़ स्टेट से, बिना दूसरे की कोई मेमोरी, और समान डाटा, प्रॉम्प्ट, टूल्स, सीमाएँ, और इवैल्युएटर के साथ:
प्रति लेवल
medium
high
रिपोर्ट के साथ खत्म हुए प्रयास
3 में 3
3 में 2
उनमें सही ऑडिट
3 में 3
2 में 2
प्रति प्रयास थिंकिंग टोकन्स
लगभग 7,700
लगभग 17,500
प्रति प्रयास समय
लगभग 5 मिनट
लगभग 6 मिनट
प्रति सही ऑडिट लागत, प्रारंभिक दर
लगभग $0.25
लगभग $0.62
प्रति सही ऑडिट लागत, मानक दर
लगभग $0.51
लगभग $1.24
कास्ट पंक्तियाँ हर प्रयास के खर्च को गिनती हैं, उस एक सहित जो रुका। हर पूर्ण प्रयास एक ही वर्डिक्ट और टकराव तक पहुँचा और ऐसी चैनल जोड़ी चुनी जिसे इवैल्युएटर ने स्वीकार किया, इसलिए अतिरिक्त थिंकिंग और जाँचों में गई।
मैंने Gemini 4 Argon कोडिंग प्रयोग में भी यही पैटर्न देखा: highने ज़्यादा खर्च किया और ज़्यादा काम किया, जबकि वेरिफ़ाई हुए परिणाम में छोटा बदलाव आया। कार्य अलग हैं, इसलिए उनकी लागतें और सफलता दरें सीधे तुलनीय नहीं। दोनों ही मामलों में, स्वतंत्र जाँच हमें थिंकिंग टोटल से अधिक बताती है।
क्यों एक high-थिंकिंग प्रयास कभी खत्म नहीं हुआ
जो प्रयास रुका वह high का पहला था, और इसने कभी गलत वर्डिक्ट नहीं दिया। इसने 0.101 से 0.119 तक हर ग्रिड पॉइंट की पड़ताल की और फिर Website के 70% की सीमा ढूँढने निकल पड़ा, जिस पर कुछ निर्भर नहीं था, और यह और जाँचें माँगता रहा जब तक कि यह मेरे सेट किए 60-कॉल लिमिट तक नहीं पहुँचा, और एप्लिकेशन ने इसे रिपोर्ट लिखने से पहले ही रोक दिया।
सिर्फ एक प्रयास सीमा तक पहुँचा। चित्र: लेखक।
वह रुकवाना ही उपयोगी हिस्सा है। कम कॉल्स माँगने वाला प्रॉम्प्ट इसे नहीं रोकता, और कोड में सीमा ने रोका, लगभग 22 सेंट के बाद।
बाकी पाँच पूरी हुई रिपोर्टें भी Python की दूसरी जाँचों से पास हुईं। किसी ने भी वर्तमान कॉन्फ़िगरेशन को गलत नहीं पढ़ा, टकराव के बाहर कोई आवश्यकता नहीं बताई, ऐसा टूल कॉल उद्धृत नहीं किया जो अस्तित्व में न हो, या ऐसी कॉन्फ़िगरेशन की सिफारिश नहीं की जिसे उसने टेस्ट न किया हो।
प्रति ऑडिट टोकन्स, समय, और लागत मापें
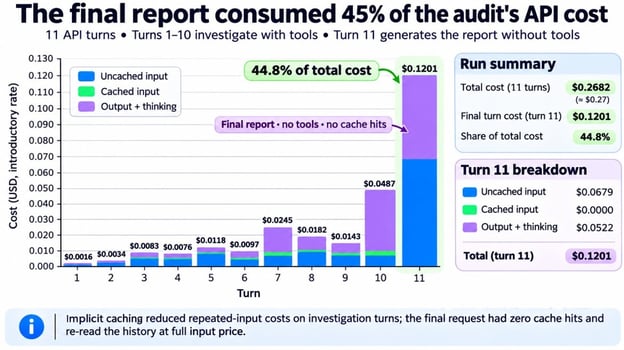
किसी ऑडिट की लागत हर टर्न के usage का योग है, जिसकी कीमत $2.00 प्रति मिलियन इनपुट टोकन, $0.10 कैश्ड, और $10.00 आउटपुट (थिंकिंग सहित) है, जो 1 दिसंबर, 2026 को दोगुनी हो जाएगी। total_input_tokens में कैश्ड टोकन शामिल होते हैं, इसलिए कोड दोनों भागों की कीमत अलग से लगाता है।
रिपोर्ट वाला टर्न सबसे महँगा है। चित्र: लेखक।
आश्चर्य रिपोर्ट, या सटीक कहें तो उसका बिल था। इम्प्लिसिट कैशिंग ने जाँच वाले टर्न्स में इनपुट टोकन के लगभग तीन-चौथाई कवर किए, पर बिना-टूल्स रिपोर्ट रिक्वेस्ट को कभी कैश हिट नहीं मिला।
संभावित कारण यह है कि tools हटाने से रिक्वेस्ट की शुरुआत बदल जाती है। किसी भी तरह, उस टर्न ने पूरी हिस्ट्री को फुल कीमत पर फिर से पढ़ा और हर पूर्ण प्रयास की लागत का करीब 40% लिया। अपना स्पेंड लिमिट सेट करते समय उस टर्न को गिनें।
ML मॉडल ऑडिटिंग के लिए Gemini 4 Carbon उपयोग करने की सीमाएँ
मैंने यह टेस्ट स्वयं डिज़ाइन किया और इसका डाटा स्वयं जेनरेट किया, इसलिए परिणामों पर ये सीमाएँ लागू होती हैं:
डाटा सिंथेटिक है और एक क्लासिफ़ायर से आता है, और मैंने जेनरेटर को तब तक ट्यून किया जब तक टकराव बन न गया, किसी भी API कॉल से पहले
वर्डिक्ट सिर्फ इस क्लासिफ़ायर को कवर करता है, और कोई बेहतर क्लासिफ़ायर एक थ्रेशहोल्ड से तीनों नियम पूरा कर सकता है
थ्रेशहोल्ड जाँचा जा सकता है, पर चैनल स्प्लिट को मंज़ूरी देना व्यापार और फ़ेयरनेस का निर्णय है
पेड टियर पर इंटरैक्शन डिफ़ॉल्ट रूप से 55 दिनों तक संग्रहीत होते हैं, और store=falseprevious_interaction_id को बाहर कर देता है, इसलिए कोई एजेंट जो ट्रांज़ैक्शन रो भेजता है, उसे डाटा रिव्यू चाहिए
इवैल्युएटर थ्रेशहोल्ड समस्या को स्वयं हल कर देता है, बिना किसी मॉडल के। यदि आपको सिर्फ थ्रेशहोल्ड चाहिए, तो ऑप्टिमाइज़ेशन सॉल्वर का उपयोग करें। Gemini 4 Carbon ने जो जोड़ा, वह उसके चारों ओर का ऑडिट था।
यहाँ कुछ भी फ्रॉड से बँधा नहीं है। यह सेटअप किसी भी मॉडल पर फिट बैठता है जिसके नियमों को Python नाप सकता है।
अंतिम विचार
मुख्य परिणाम यह है कि Gemini 4 Carbon ने पहचाना कि मूल नीति का कोई वैध ग्लोबल थ्रेशहोल्ड नहीं था। पूरी हुई 5 कोशिशों ने टकराव का नाम लिया और ऐसा चैनल स्प्लिट प्रस्तावित किया जिसे इवैल्युएटर ने स्वीकार किया; एक high प्रयास रिपोर्ट बनाने से पहले ही रुक गया।
Gemini 4 Argon और Gemini 4 Carbon प्रयोग एजेंट विश्वसनीयता के दो पहलू जाँचते हैं। Gemini 4 Argon एजेंट कोड बदलता था और व्यवहार बनाए रखना था, जबकि Gemini 4 Carbon एजेंट ने उन नियमों के तहत निर्णय लिया जिनसे मूल उत्तर असंभव हो गया था। दोनों को संकरे टूल्स, संसाधन सीमाएँ, और मॉडल से बाहर की जाँच चाहिए थी।
यही मानक मैं किसी एजेंट के लिए उपयोग करूँगा: परिभाषित करें कि उसके टूल क्या स्थापित कर सकते हैं, परिणाम को स्वतंत्र रूप से वेरिफ़ाई करें, और जब साक्ष्य खत्म हो जाए तो inconclusive उत्तर की अनुमति दें। अगला कदम, मैं इसी नीति के तहत दो या तीन कैंडिडेट क्लासिफ़ायर्स रखूँगा और पूछूँगा कि इनमें से कौन, यदि कोई, शिप हो सकता है।
मैं एक डेटा इंजीनियर और कम्युनिटी बिल्डर हूँ, जो डेटा पाइपलाइनों, क्लाउड, और AI टूलिंग के साथ काम करता/करती हूँ, साथ ही DataCamp और उभरते डेवलपर्स के लिए व्यावहारिक, असरदार ट्यूटोरियल लिखता/लिखती हूँ।
FAQs
मैं Gemini 4 Carbon API की पहुँच कैसे पाऊँ?⌄
किसी भुगतान-योग्य Google AI Studio प्रोजेक्ट के माध्यम से या Google Cloud पर Gemini for business के ज़रिए। Gemini ऐप, Antigravity, और AI Mode भी इसे Google AI Ultra सब्सक्राइबर्स को देते हैं, पर वे कंज़्यूमर ऐप्स आपको API कुंजी नहीं देते।
Gemini 4 Carbon API की लागत कितनी है?⌄
यहाँ सभी 6 ऑडिट प्रारंभिक दर पर $2.00 में आए। ऐसी मानक रिक्वेस्ट्स को 4,096 इनपुट टोकन पार होने के बाद इम्प्लिसिट कैशिंग मिलती है, इसलिए हर रिक्वेस्ट की शुरुआत एक जैसी रखें। फ्लेक्स इन्फ़रेंस, जिसे Interactions रिक्वेस्ट्स भी सपोर्ट करती हैं, धीमे, कम विश्वसनीय उत्तरों के बदले टोकन दरें आधी कर देती है।
Gemini 4 Carbon API के लिए रेट लिमिट्स क्या हैं?⌄
पेड प्रोजेक्ट्स में प्रति-मिनट सीमाएँ और एक स्पेंड लिमिट होती है, जो Tier 1 पर हर 10-मिनट की रोलिंग विंडो में $10 है, और उससे ऊपर जाने पर 429 RESOURCE_EXHAUSTED आता है। यहाँ एक ऑडिट की लागत $1 से कम रही, इसलिए सिर्फ़ बहुत सारे समानांतर प्रयास ही इसे छूएँगे। सीमाएँ आपके टियर के साथ बढ़ती हैं, इसलिए Google के रेट लिमिट्स पेज पर अपना प्रोजेक्ट जाँचें।
Gemini 4 Carbon में medium और high थिंकिंग में क्या अंतर है?⌄
Gemini 4 Carbon में तीन लेवल होते हैं, low, medium (डिफ़ॉल्ट), और high, और मैंने यहाँ सिर्फ़ ऊपर के दो की तुलना की। अतिरिक्त थिंकिंग कैसा दिखता है, यह देखने के लिए thinking_summariesको "auto" पर सेट करें और आपको हर उत्तर के पास संक्षिप्त सार मिलेंगे। वे डिफ़ॉल्ट रूप से बंद हैं और तब खाली आ सकते हैं जब मॉडल मुश्किल से तर्क करता है।
क्या Gemini 4 Carbon Python कोड चला सकता है?⌄
हाँ। {"type": "code_execution"} को tools में जोड़ें और Gemini 4 Carbon Google की ओर से Python लिख और चला सकता है, जिसकी बिलिंग इसकी सामान्य टोकन दरों पर होगी। मैंने इसे नियंत्रण अपनी ओर रखने के लिए छोड़ा: तीन टूल तय करते हैं कि वह क्या माप सकता है, और रॉ ट्रांज़ैक्शन तथा होल्डआउट मेरी मशीन से बाहर नहीं जाते।
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.



हमारे Gemini 4 Argon API ट्यूटोरियल में एजेंट का काम साफ था: धीमा कोड ढूँढना, उसे बदलना, और हिडन टेस्ट पास करना। यह साथी प्रयोग नियंत्रित टूल्स और बाहरी जाँच के उसी ढाँचे को रखता है, पर निर्णय बदल देता है। Gemini 4 Carbon को यह समझना है कि क्या मूल नियमों को किसी भी तरह पूरा किया जा सकता है।
PayGuard, एक काल्पनिक ऑनलाइन स्टोर, के पास एक प्रशिक्षित मशीन लर्निंग (ML) मॉडल है जो ऑर्डरों का फ्रॉड स्कोर निकालता है। इसकी डिप्लॉयमेंट नीति चाहती है कि मॉडल कुल मिलाकर और हर सेल्स चैनल पर पर्याप्त फ्रॉड वैल्यू पकड़े, वह भी रिव्यू टीम पर बोझ डाले बिना। एजेंट को इन नियमों की जाँच करनी है, बिना यह बताए कि कोई वैध थ्रेशहोल्ड मौजूद है या नहीं।
Gemini 4 Carbon एक Google रीजनिंग मॉडल है जिसे आप Python से Interactions API के ज़रिए कॉल करते हैं। यहाँ यह एक AI एजेंट की तरह काम करता है: यह तय करता है किन जाँचों का अनुरोध करना है, और Python उन्हें function calling के माध्यम से तीन केवल-पढ़ने योग्य टूल्स से चलाता है। मेरा प्रश्न है कि क्या यह टकराव की पहचान कर सकता है, साक्ष्य समझा सकता है, और किसी अनुमत बदलाव की सिफारिश कर सकता है, बिना उसे मंज़ूर किए मानने के।
आपको बेसिक Python और API रिक्वेस्ट्स का थोड़ा अनुभव चाहिए। मैं हर फ्रॉड मेट्रिक को उसके इस्तेमाल से पहले परिभाषित करता हूँ। हम यह कवर करेंगे कि कैसे:
यदि आप लॉन्च स्टोरी और बेंचमार्क स्कोर चाहते हैं, तो हमारा Gemini 4 Carbon ओवरव्यू इन्हें कवर करता है, और हमारा Claude Fable 5.2 बनाम Gemini 4 Carbon विश्लेषण दोनों मॉडलों की तुलना करता है। मैंने यह प्रयोग उस अगले दिन चलाया जब Google ने API भुगतान करने वाले डेवलपर्स के लिए खोली।
Gemini 4 Carbon API क्या है?
Gemini 4 Carbon API,
gemini-4-carbonके लिए भुगतान-योग्य एप्लिकेशन प्रोग्रामिंग इंटरफ़ेस (API) है, जिसे मॉडल पेज लम्बे, मल्टी-स्टेप एजेंट टास्क्स के लिए एक रीजनिंग मॉडल के रूप में वर्णित करता है। इनपुट, थिंकिंग और आउटपुट एक 1,048,576-टोकन कॉन्टेक्स्ट विंडो साझा करते हैं, और एक सिंक्रोनस रिस्पॉन्स डिफ़ॉल्ट रूप से 65,536 टोकन की थिंकिंग प्लस आउटपुट पर रुक जाता है।क्यों एक ML मॉडल ऑडिट Gemini 4 Carbon के लिए अच्छा टेस्ट है
इस कार्य में कई जाँचें, अनुमत बदलावों में खोज, और तब साफ़ स्टॉप शामिल है जब नियम कोई उत्तर नहीं छोड़ते। मैंने इसे इसलिए चुना क्योंकि Python संदर्भ परिणाम की गणना कर सकता है। मॉडल कार्ड Gemini 4 Carbon की ज्ञात सीमाओं में भ्रम-जनित उत्तरों का उल्लेख करता है, इसलिए मॉडल जाँच-पड़ताल करता है जबकि Python यह तय करता है कि उसकी सिफारिश ठहरती है या नहीं।
प्रोजेक्ट: तय करना कि PayGuard का फ्रॉड मॉडल लाइव जा सकता है या नहीं
PayGuard वही काल्पनिक स्टोर है जिसका ज़िक्र भूमिका में था, और पूरा प्रोजेक्ट GitHub रिपोजिटरी में है। इसका क्लासिफ़ायर पहले से प्रशिक्षित है।
PayGuard ट्रांज़ैक्शनों को कैसे स्कोर करता है
हर ट्रांज़ैक्शन में Coordinated Universal Time (UTC) टाइमस्टैम्प, अमाउंट, चैनल (Website या Mobile App), एक रिस्क स्कोर, और फ्रॉड लेबल होता है। एक scikit-learn
HistGradientBoostingClassifierस्कोर बनाता है, जिसे 0.001 पर राउंड किया जाता है, और PayGuard किसी ट्रांज़ैक्शन को तब फ़्लैग करता है जबrisk_score >= threshold। हमारा प्रिसीज़न-रिकॉल कर्व ट्यूटोरियल दिखाता है कि थ्रेशहोल्ड बदलने से क्या फ़्लैग होता है में कैसे बदलाव आता है, और हमारा Fraud Detection in Python कोर्स मॉडलिंग पक्ष को कवर करता है।सिंथेटिक डाटा समय के आधार पर विभाजित है:
वर्तमान थ्रेशहोल्ड 0.5 है, और प्रयोग के दौरान डाटा और नीति नहीं बदलते। Website फ्रॉड इस डाटा में स्पष्ट संकेत छोड़ता है, जबकि अधिकतर Mobile App फ्रॉड एक सामान्य ऑर्डर जैसा दिखता है।
Gemini 4 Carbon पूछता है, Python निर्णय लेता है। चित्र: लेखक।
PayGuard के तीन डिप्लॉयमेंट नियम
यहाँ भूमिका में दिए गए तीन नियम हैं, नीति की भाषा में लिखे हुए। ये सभी इस प्रयोग के लिए चुने गए काल्पनिक लक्ष्य हैं:
फ्रॉड-वैल्यू रिकॉल का मतलब है फ़्लैग की गई फ्रॉड वैल्यू को कुल फ्रॉड वैल्यू से भाग देना। हमारी प्रिसीज़न बनाम रिकॉल गाइड के ट्रांज़ैक्शन-स्तरीय रिकॉल के विपरीत, छूटा हुआ $2,000 का फ्रॉड $15 वाले से कहीं ज़्यादा मायने रखता है, और फ़्लैग होने का मतलब यह नहीं कि पैसा बच गया। R3 सबसे व्यस्त एक दिन पर सीमा लगाता है, और यही शब्दावली अंततः ऑडिट का फ़ैसला करती है।
एजेंट दो बदलावों की जाँच कर सकता है: एक थ्रेशहोल्ड के साथ दैनिक क्षमता अधिकतम 260 तक, या मूल कैप पर अलग-अलग चैनल थ्रेशहोल्ड। दोनों के लिए मानव स्वीकृति चाहिए, वे जोड़े नहीं जा सकते, और नीति बिना अतिरिक्त रिव्यूअर्स वाले विकल्प को प्राथमिकता देती है।
सही ऑडिट किसे मानें
एक सही ऑडिट चार बातों को ठीक-ठीक पकड़े, और आपको पहली रिक्वेस्ट से पहले इन्हें तय कर लेना चाहिए:
एजेंट जिस इवैल्युएटर को कॉल नहीं कर सकता, वही उत्तर की गणना करता है।
Python में Gemini 4 Carbon API कैसे सेटअप करें
Gemini 4 Carbon API सेटअप के लिए Python 3.11 या नया संस्करण और API कुंजी चाहिए, जो बिलिंग चालू वाले Google AI Studio प्रोजेक्ट से मिलेगी, क्योंकि प्राइसिंग पेज कोई फ्री टियर सूचीबद्ध नहीं करता।
Google Gen AI SDK इंस्टॉल करें और प्रोजेक्ट तैयार करें
मैंने इस प्रोजेक्ट को Google Gen AI सॉफ़्टवेयर डेवलपमेंट किट (SDK) पर टेस्ट किया, जिसे
google-genai==3.1.0पर पिन किया गया था, जो लॉन्च-डे की PyPI रिलीज़ है जिसने Interactions मॉडल सूची मेंgemini-4-carbonजोड़ा। प्रोजेक्ट क्लोन करें और वर्चुअल एनवायरनमेंट में इंस्टॉल करें:इसके बाद, रिपोजिटरी पेज पर दिए गए दो कमांड चलाएँ जो डाटा बनाते हैं और फिक्स्ड सीड्स के साथ क्लासिफ़ायर फ़िट करते हैं। नई क्लोन पर वे यह प्रिंट करते हैं:
फिक्स्ड सीड्स वही डेटासेट रीबिल्ड करते हैं। चित्र: लेखक।
फिर
GEMINI_API_KEY=your-keyको एक.envफ़ाइल में रखें। रिपोजिटरी इसे बिना प्रिंट किए लोड करती है।अपना पहला Gemini 4 Carbon API अनुरोध बनाएँ
यह पूरा उदाहरण प्रोजेक्ट फ़ोल्डर से चलाएँ। यह Gemini 4 Carbon को नीति और क्लासिफ़ायर सारांश देता है और पूछता है कि उसे क्या नापना होगा, बिना किसी टकराव का संकेत दिए:
थिंकिंग लेवल
generation_configमें जाता है, औरoutput_textमें उत्तर होता है। यहाँ उसके उत्तर का एक हिस्सा है:इसने R3 को पीक के रूप में पढ़ा और बिना किसी संख्या देखे नीति की प्रेफरेंस ऑर्डर की योजना बना ली। हालाँकि, इसने कभी नहीं पूछा कि टाई या स्कोर राउंडिंग कैसे काम करते हैं, और बाद में दिखाऊँगा कि थकाऊ जाँच ठीक उसी पर निर्भर करती है। कॉल में लगभग 40 सेकंड लगे और लगभग 2 सेंट खर्च आए।
temperature,top_p, औरtop_kको छोड़ दें, जिन्हें Gemini 4 Carbon इग्नोर करता है, औरthinking_budgetको भी।Gemini 4 Carbon फंक्शन कॉलिंग से ML ऑडिट एजेंट कैसे बनाएँ
एक Gemini 4 Carbon ऑडिट एजेंट एक लूप है: मॉडल एक इवैल्युएशन का अनुरोध करता है, Python उसे वेलिडेट कर चलाता है, और परिणाम तब तक वापस जाता है जब तक मॉडल पूछना बंद न कर दे।
मॉडल इवैल्युएशन के लिए केवल-पढ़ने योग्य टूल्स परिभाषित करें
एजेंट को तीन टूल मिलते हैं। सभी वैलिडेशन विंडो तक सीमित हैं:
get_audit_context: क्लासिफ़ायर सारांश, वर्तमान कॉन्फ़िगरेशन, नीति, और अनुमत बदलावevaluate_global_threshold: एक थ्रेशहोल्ड के लिए कुल और चैनल-वार फ्रॉड-वैल्यू रिकॉल, प्रति दिन फ़्लैग, और डायग्नॉस्टिक्सevaluate_policy_change: क्षमता वृद्धि या चैनल-थ्रेशहोल्ड जोड़ी के लिए वही मापपूरी स्कीमाएँ रिपोजिटरी में हैं। यह सरलीकृत अंश थ्रेशहोल्ड और क्षमता फ़ील्ड छोड़ देता है, इसलिए यह कॉपी करने लायक पूरी डिक्लेरेशन नहीं है। यह केवल वह सीमा दिखाता है जो यहाँ मायने रखती है: टूल PayGuard द्वारा अनुमत दो नीति बदलावों को स्वीकार करता है, वैलिडेशन डाटा पढ़ता है, और कुछ अप्रूव नहीं करता।
Python छोड़े गए थ्रेशहोल्ड और क्षमता फ़ील्ड्स को वेलिडेट करता है, नीति से बाहर के बदलावों को अस्वीकार करता है, और पास/फेल के फ़्लैग्स के बजाय माप लौटाता है। एजेंट होल्डआउट तक नहीं पहुँच सकता, इवैल्युएटर को कॉल नहीं कर सकता, या नीति नहीं बदल सकता। मैं FAQs में बताता हूँ कि मैंने Gemini 4 Carbon के बिल्ट-इन कोड एग्जीक्यूशन को क्यों छोड़ा।
एजेंट को स्पष्ट उद्देश्य और स्टॉपिंग नियम दें
सिस्टम इंस्ट्रक्शन विधि तय करता है। पहली रिक्वेस्ट की तरह, यह नहीं बताता कि टकराव कहाँ है:
प्रॉम्प्ट केवल मांग सकता है, इसलिए सीमाएँ एजेंट हार्नेस, यानी मॉडल के चारों ओर के Python कोड में रहती हैं। चूँकि API में कोई बजट सेटिंग नहीं, एप्लिकेशन प्रत्येक प्रयास पर सीमाएँ सेट करता है: 25 टर्न, 60 टूल कॉल, 30 मिनट, और $3, जहाँ खर्च टर्न्स के बीच जाँचा जाता है।
Interactions API के साथ फंक्शन कॉलिंग लूप लागू करें
हर टर्न एक
client.interactions.create()कॉल है। Gemini 4 Carbon अक्सर एक साथ कई टूल्स का अनुरोध करता है, इसलिए लूप हरfunction_callस्टेप चलाता है। यह कोर लूप है, और रिपोजिटरी संस्करण लॉगिंग और लिमिट चेक्स जोड़ता है:मैं ये सेटिंग्स एक ही
requestडिक्ट में रखता हूँ ताकि हर फॉलो-अप कॉल इन्हें फिर से भेजे।previous_interaction_idहिस्ट्री को साथ ले जाता है, परtools,system_instruction, औरgeneration_configकेवल एक इंटरैक्शन पर लागू होते हैं। यदि कोई टर्नincompleteपर खत्म होता है, तोmax_output_tokensने उसे काट दिया, और फिर भी आप उसके थिंकिंग टोकन्स का भुगतान करते हैं।JSON स्कीमा के साथ संरचित ऑडिट रिपोर्ट लौटाएँ
Google की structured output गाइड, Gemini 4 Carbon सहित, एक प्रीव्यू फ़ीचर के रूप में एक ही रिक्वेस्ट में टूल्स और JSON स्कीमा सूचीबद्ध करती है। फिर भी मैंने इन्हें अलग रखा: जाँच वाले टर्न केवल मापते हैं, और उसी हिस्ट्री और कॉन्फ़िग पर एक अंतिम टर्न बिना टूल्स के स्कीमा सहित रिपोर्ट लिखता है:
AuditReportएक Pydantic मॉडल है, जिसमें वर्डिक्ट, संघर्ष, साक्ष्य, सिफारिश, और अनुमोदन शामिल हैं। Python समय और लागत को स्वयं मापता है, बजाय इसके कि Gemini 4 Carbon को उन्हें रिपोर्ट करने को कहे।फ्रॉड डिटेक्शन मॉडल पर Gemini 4 Carbon ऑडिट चलाएँ
Gemini 4 Carbon ने मॉडल का ऑडिट उसी तरह किया जैसा मैं किसी जूनियर एनालिस्ट से चाहता, यानी किसी निष्कर्ष से पहले माप। पहली
mediumकोशिश में, इसने ऑडिट संदर्भ पढ़ा, लगभग दो दर्जन एकल थ्रेशहोल्ड जाँचे, और आठ नीति बदलावों को टेस्ट किया।सभी 32 टूल कॉल, क्रम में। चित्र: लेखक।
PayGuard के वर्तमान थ्रेशहोल्ड का मूल्यांकन करें
एजेंट ने 0.5 के मौजूदा थ्रेशहोल्ड का आकलन किया और 91% Website रिकॉल, 20% Mobile App रिकॉल, 64% कुल रिकॉल, और सबसे व्यस्त दिन पर 85 फ़्लैग पाए। यह R1 और R2 के Mobile App हिस्से में फेल होता है, जबकि R3 के नीचे जगह बचती है, तो साफ़ कदम होगा थ्रेशहोल्ड घटाना।
दैनिक रिव्यू क्षमता के विरुद्ध फ्रॉड-वैल्यू रिकॉल टेस्ट करें
थ्रेशहोल्ड घटाने से अधिक फ्रॉड वैल्यू पकड़ेगी और अधिक ऑर्डर रिव्यू में जाएँगे। PayGuard को पहले में पर्याप्त चाहिए और दूसरे को दैनिक कैप के नीचे रखना है।
एजेंट ने एक बैच में कुछ मोटे थ्रेशहोल्ड आज़माए, फिर एकल ग्रिड पॉइंट्स तक सीमित हुआ। ट्रेस में कॉल 11, 12, 17, और 18 ने बात साफ़ कर दी।
इस वैलिडेशन विंडो पर, Mobile App की न्यूनतम जरूरत 0.108 या नीचे है, क्योंकि एक स्टेप ऊपर यह 70% से थोड़ा नीचे गिरता है। कैप के लिए 0.118 या ऊपर चाहिए। कोई थ्रेशहोल्ड दोनों नहीं करता।
कुल रिकॉल 0.137 तक बना रहता है, इसलिए R1 टकराव से बाहर है। 0.108 पर औसत दिन में लगभग 169 फ़्लैग होते हैं, और सिर्फ एक शनिवार ऊपर जाता है। यही वजह है कि नीति दैनिक औसत की बजाय सबसे व्यस्त दिन के वर्कलोड का उपयोग करती है।
मोबाइल रिकॉल और क्षमता कभी ओवरलैप नहीं करते। चित्र: लेखक।
दोनों भुगतान चैनलों पर प्रदर्शन जाँचें
कमज़ोर संकेतों वाला Mobile App फ्रॉड स्कोर रेंज के निचले हिस्से में बैठता है। Mobile App के लिए एक ही थ्रेशहोल्ड को 0.108 तक नीचे खींचना वैध Website ऑर्डर भी अधिक खींच लाता है, और उसी शनिवार को वे कुल को कैप से ऊपर धकेलते हैं।
कुल संख्या इसे छुपा देती है: 0.118 पर, कुल रिकॉल लगभग 87% है जबकि Mobile App अपना फ़्लोर से नीचे बैठा है। यदि आपकी नीति सेगमेंट्स का नाम लेती है, तो हर सेगमेंट को मापें, क्योंकि कुल पास हो सकता है जबकि कोई एक सेगमेंट फेल हो।
क्या Gemini 4 Carbon परस्पर-विरोधी डिप्लॉयमेंट आवश्यकताएँ पहचान सकता है?
हाँ, इस ऑडिट पर। फ्रीज़ की गई रिपोर्ट
not deployableकहती है, कहती है कि कोई एकल थ्रेशहोल्ड काम नहीं करता, और Mobile App के लिए R2 तथा R3 को टकराव के रूप में नाम देती है।Gemini 4 Carbon के डिप्लॉयमेंट वर्डिक्ट को उसके साक्ष्य से मिलाएँ
रिपोर्ट में दिए गए हर नंबर किसी टूल परिणाम से मेल खाते हैं, पर एक वाक्य एजेंट द्वारा मापे से अधिक दावा करता है। यह कहता है कि कोई भी थ्रेशहोल्ड "सभी 0.001 रिस्क-स्कोर ग्रिड पॉइंट्स" पर काम नहीं करता, जबकि एजेंट ने ऊपर ट्रेस में सिर्फ दो दर्जन टेस्ट किए, 1,002 संभावित थ्रेशहोल्ड्स में से।
दावा इसलिए ठहरता है क्योंकि थ्रेशहोल्ड बढ़ने पर रिकॉल और दैनिक काउंट दोनों गिरते हैं, जिसे रिपोर्ट कभी कहती नहीं। किसी एजेंट की रिपोर्ट में दिए हर दावे को इस आधार पर जाँचें कि उसने क्या मापा, और हमारी AI एजेंट्स के मूल्यांकन की गाइड इस तरह की और जाँचें कवर करती है।
थकाऊ Python इवैल्युएटर से टकराव वेरिफ़ाई करें
Gemini 4 Carbon ने थ्रेशहोल्ड सैंपल किए और निष्कर्ष निकाला कि कोई काम नहीं कर सकता। इवैल्युएटर इस वैलिडेशन सेट के लिए हर भिन्न फ़्लैग सेट जाँचकर, टूल्स के साथ कोड साझा किए बिना, परिणाम साबित करता है।
स्कोर 0.001 ग्रिड पर बैठते हैं, इसलिए 1,002 कैंडिडेट कटऑफ़ हर संभावित फ़्लैग सेट कवर करते हैं। इवैल्युएटर उन सबको, साथ ही हर चैनल-थ्रेशहोल्ड जोड़ी को जाँचता है, और 85% तथा 70% को सटीक रखने के लिए इंटीजर सेंट्स का उपयोग करता है।
थकाऊ जाँच और चार अस्वीकार की गई कॉन्फ़िगरेशन। चित्र: लेखक।
कोई ग्लोबल थ्रेशहोल्ड तीनों नियम पास नहीं करता, तो अब Gemini 4 Carbon का दावा प्रमाणित है। इवैल्युएटर ने एजेंट की प्रोबिंग से 0.108 और 0.118 सीमाएँ मैच कीं और 200 प्रति दिन पर पास होने वाली हज़ारों चैनल जोड़ियाँ पाईं।
इवैल्युएटर तभी काम का है जब वह खराब उत्तरों को खारिज कर दे, इसलिए मैंने उसे चार गलत कॉन्फ़िगरेशन दीं, और उसने चारों को अस्वीकार किया।
Gemini 4 Carbon के साथ डिप्लॉयमेंट विकल्पों का परीक्षण करें
Gemini 4 Carbon ने दोनों अनुमत बदलावों को टेस्ट किया और अतिरिक्त रिव्यूअर्स की बजाय मूल कैप पर अलग-अलग थ्रेशहोल्ड चुने। इसने उस चयन को व्यक्ति द्वारा स्वीकृत किए जाने वाली अपवाद के रूप में फ़्लैग किया।
मैनुअल रिव्यू क्षमता में वृद्धि का परीक्षण करें
यदि कैप 200 से 205 तक बढ़े तो एक ग्लोबल थ्रेशहोल्ड काम करता है, और इवैल्युएटर ने 205 को सबसे छोटी वृद्धि के रूप में कन्फ़र्म किया। Gemini 4 Carbon ने फिर भी इस विकल्प को दूसरा स्थान दिया, उस प्राथमिकता नियम की वजह से जिसका मैंने पहले वर्णन किया।
प्रत्येक भुगतान चैनल के लिए अलग थ्रेशहोल्ड का परीक्षण करें
चैनल पक्ष पर, एजेंट ने Mobile App थ्रेशहोल्ड को उसकी सीमा के पास रखा (इसने पहले ही देखा था कि 0.109 फ़्लोर तोड़ता है) और Website थ्रेशहोल्ड बढ़ाया, वैध Website ऑर्डरों पर फ़्लैग घटाते हुए। इसने सात जोड़ियाँ टेस्ट कीं, और एक सबसे व्यस्त दिन पर एक फ़्लैग से फेल हुई। इसने Website 0.3 और Mobile App 0.1 की सिफारिश की क्योंकि यह जोड़ी हर नियम आराम से पार करती है, और इवैल्युएटर ने इसे मूल कैप पर कन्फ़र्म किया।
वेरिफ़ाई किए गए विकल्पों की तुलना करें
ये संख्याएँ ऊपर आई थीं, और इवैल्युएटर ने हर एक को फिर से गिना:
विकल्प
थ्रेशहोल्ड्स
कुल
Website
Mobile App
सबसे व्यस्त दिन
अनुमोदन
मूल नीति
ग्लोबल 0.108
87.5%
98.2%
70.1%
205, कैप 200
असफ़ल
अधिक क्षमता
ग्लोबल 0.108
87.5%
98.2%
70.1%
205, कैप 205
आवश्यक
चैनल स्प्लिट
Website 0.3, Mobile App 0.1
86.2%
94.5%
72.8%
191, कैप 200
आवश्यक
चैनल स्प्लिट क्षमता विकल्प की तुलना में लगभग 6% कम ट्रांज़ैक्शन भी फ़्लैग करता है। हालाँकि, इसके आधे से कम फ़्लैग फ्रॉड हैं, जिसे रिपोर्ट ने खुले मुद्दे के रूप में सूचीबद्ध किया।
अनदेखे डाटा पर Gemini 4 Carbon की सिफारिश कैसे वेरिफ़ाई करें
आप सिफारिश को फ्रीज़ करके सीलबंद होल्डआउट पर लागू कर वेरिफ़ाई करते हैं। इवैल्युएटर से फर्क डाटा का है: इवैल्युएटर ने वे हफ्ते स्कोर किए जिन्हें एजेंट देख सकता था, और होल्डआउट चार बाद के हफ्ते स्कोर करता है जिन्हें कोई टूल नहीं पढ़ सका। यह जाँच प्रति फ्रीज़ की गई सिफारिश एक बार चलती है और अगर फ्रीज़ के बाद रिपोर्ट बदली हो तो शुरू नहीं होगी।
फ्रीज़ की गई सिफारिश होल्डआउट पर पास होती है। चित्र: लेखक।
यह तीनों नियम पास कर गई, और सबसे व्यस्त दिन कैप के नीचे रहा। पर इसे ज़्यादा न पढ़ें। तीन बातें इस परिणाम को संयत रखती हैं:
पहले दो तो संख्याओं से आते हैं।
Streamlit में पूरा ऑडिट देखें
रिपोजिटरी में एक Streamlit ऐप और छह रिकॉर्ड किए हुए प्रयास भी शामिल हैं, ताकि आप यह ऑडिट बिना API कॉल के खोल सकें। वीडियो में, मैं इसे लोड करता हूँ और हर टैब से होकर गुजरता हूँ।