import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")提供:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412提供:
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}提供:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.提供:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)提供:
有料の Google AI Studio プロジェクト、または Google Cloud 上の Gemini for business から利用できます。Gemini アプリ、Antigravity、AI Mode も Google AI Ultra サブスクライバーに提供しますが、これらのコンシューマー向けアプリは API キーを発行しません。
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.


前回のGemini 4 Argon API チュートリアルでは、エージェントの仕事は明確でした。遅いコードを見つけて修正し、隠れたテストを通過させることです。本稿の連動実験も、制御されたツールと外部チェックという同じ枠組みを保ちながら、判断の内容を変えます。Gemini 4 Carbon は、そもそも元のルールが満たせるかどうかを見極めなければなりません。
架空の EC ストア PayGuard には、不正注文をスコアリングする機械学習(ML)モデルがあります。運用ポリシーは、審査チームを圧迫しない範囲で、全体および各販売チャネルにおいて十分な不正金額を捕捉することを要求します。エージェントは、有効な閾値が存在するかを教えられないまま、これらのルールを調査する必要があります。
Gemini 4 Carbon は Google の推論モデルで、Interactions API を通じて Python から呼び出します。ここではAI エージェントとして動作し、どの検証を要求するかを選び、Python が関数呼び出しで3つの読み取り専用ツールを通じて実行します。今回の問いは、モデルが矛盾を特定し、根拠を説明し、承認済みとは扱わずに許容される変更を推奨できるかどうかです。
必要なのは基本的な Python と、API リクエストの経験が少しです。各不正検出指標は数値が登場する前に定義します。以下を扱います。
リリース経緯やベンチマークは Gemini 4 Carbon の概要にまとまっています。また、Claude Fable 5.2 と Gemini 4 Carbon の比較もご覧ください。本稿の実験は、Google が有料開発者向けに API を公開した翌日に実施しました。
Gemini 4 Carbon API とは?
Gemini 4 Carbon API は
gemini-4-carbonの有料 API で、モデルページでは長く多段のエージェント作業向けの推論モデルと説明されています。入力・思考・出力は合計 1,048,576 トークンのコンテキストウィンドウを共有し、同期応答は既定で思考+出力の合計が 65,536 トークンで停止します。ML モデル監査が Gemini 4 Carbon の良いテストになる理由
この課題は複数の検証、許容される変更の探索、そしてルールが解を許さないときの明確な打ち切りを要求します。Python で正解を計算できることから選びました。Gemini 4 Carbon の既知の限界としてモデルカードが幻覚を挙げているため、モデルは調査を行い、推奨の妥当性は Python が判断します。
プロジェクト:PayGuard の不正検出モデルを本番投入できるかの判断
PayGuard は冒頭の架空ストアで、プロジェクト全体はGitHub リポジトリにあります。分類器の学習はすでに完了しています。
PayGuard の取引スコアリング方法
各取引には UTC タイムスタンプ、金額、チャネル(Website または Mobile App)、リスクスコア、不正ラベルがあります。scikit-learn の
HistGradientBoostingClassifierがスコアを生成し、小数点第 3 位に丸めます。PayGuard はrisk_score >= thresholdのときに取引をフラグします。閾値の移動で何がフラグされるかがどう変わるかは、適合率-再現率曲線チュートリアルで解説し、モデリングの側面はFraud Detection in Pythonコースで扱っています。合成データは時間で分割しています。
現在の閾値は 0.5 で、実験中にデータとポリシーは変わりません。このデータでは Website の不正は明確なシグナルを残す一方、Mobile App の不正は多くが通常の注文のように見えます。
Gemini 4 Carbon が問い、Python が決める。画像:筆者作成。
PayGuard の 3 つの運用ルール
冒頭で述べた 3 つのルールを、ポリシーの記述に沿って示します。いずれも本稿のために設定した架空の目標です。
不正金額リコールは、フラグされた不正金額を不正の総金額で割ったものです。適合率 vs. 再現率ガイドの取引レベルの再現率と異なり、2,000 ドルの見逃しは 15 ドルの見逃しよりはるかに重く数えられ、フラグしたからといって金額が守られたとは限りません。R3 は最も忙しい 1 日を上限とし、その文言が監査の帰趨を決めます。
エージェントが調査できる変更は 2 つです。単一閾値のまま 1 日あたりのキャパシティを最大 260 に増やすか、元の上限のままチャネル別に閾値を分けるか。どちらも人の承認が必要で、併用は不可。追加審査員が不要な案を優先します。
正しい監査と見なされる条件
正しい監査は次の 4 点が正確であることです。最初のリクエスト前に決めておきましょう。
エージェントが呼べない評価器が答えを算出します。
Python で Gemini 4 Carbon API をセットアップする方法
Gemini 4 Carbon API のセットアップには Python 3.11 以上と、課金有効な Google AI Studio プロジェクトのAPI キーが必要です。なお、料金ページにはフリーティアがないと記載されています。
Google Gen AI SDK をインストールしてプロジェクトを準備する
本プロジェクトは、リリース当日版の
google-genai==3.1.0に固定してテストしました。このバージョンは Interactions のモデル一覧に PyPI のリリースとしてgemini-4-carbonを追加しました。プロジェクトをクローンし、仮想環境でインストールします。その後、リポジトリページにある 2 つのコマンドを実行して、固定シードでデータを生成し分類器を学習させます。新規クローンでは次のように出力されます。
固定シードで同一のデータセットを再現。画像:筆者作成。
次に
GEMINI_API_KEY=your-keyを.envファイルに設定します。リポジトリはキーを表示せずに読み込みます。最初の Gemini 4 Carbon API リクエストを作成する
以下の完全な例をプロジェクトフォルダで実行してください。ポリシーと分類器サマリを Gemini 4 Carbon に渡し、矛盾を示唆せずに、測るべき項目を尋ねます。
思考レベルは
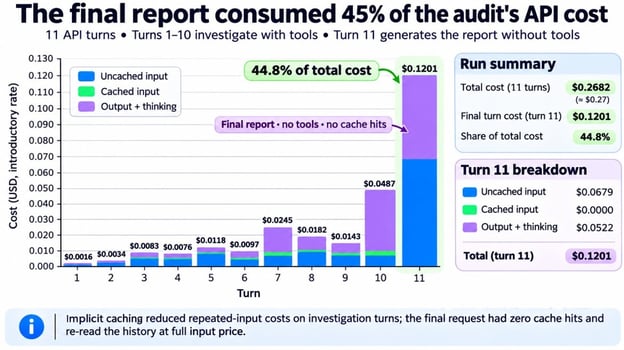
generation_configに設定し、output_textに回答が入ります。返ってきた内容の一部は次のとおりです。R3 をピークと読み取り、数値を見る前にポリシーの優先順を計画しました。ただし、同点やスコア丸めの扱いは一度も尋ねず、後で示す全探索はそこに厳密に依存します。呼び出しは約 40 秒、コストは約 2 セントでした。
temperature、top_p、top_kは Gemini 4 Carbon が無視するため指定不要です。またthinking_budgetも省きます。Gemini 4 Carbon の関数呼び出しで ML 監査エージェントを構築する方法
Gemini 4 Carbon の監査エージェントはループです。モデルが評価を要求し、Python が検証して実行し、結果を返すことを、モデルが要求をやめるまで繰り返します。
モデル評価用の読み取り専用ツールを定義する
エージェントは 3 つのツールを持ちます。いずれも検証期間に限定されます。
get_audit_context:分類器サマリ、現在の設定、ポリシー、許容される変更evaluate_global_threshold:単一閾値に対する、全体およびチャネル別の不正金額リコール、日別フラグ数、診断evaluate_policy_change:キャパシティ増加またはチャネル別閾値ペアに対する同様の測定完全なスキーマはリポジトリにあります。以下の抜粋は閾値やキャパシティのフィールドを省いた簡略版で、コピーして使える完全な宣言ではありません。ここで重要な境界だけを示します。すなわち、ツールは PayGuard が許す 2 つのポリシー変更を受け入れ、検証データを読み、承認は行いません。
Python は省略した閾値やキャパシティの項目を検証し、ポリシー外の変更は拒否し、合否フラグではなく測定値を返します。エージェントはホールドアウトに触れず、評価器を呼べず、ポリシーを変更できません。Gemini 4 Carbon の組み込みコード実行を見送った理由は FAQ で説明します。
エージェントに明確な目的と停止条件を与える
システムインストラクションが手順を定めます。最初のリクエストと同様、矛盾の所在は示唆しません。
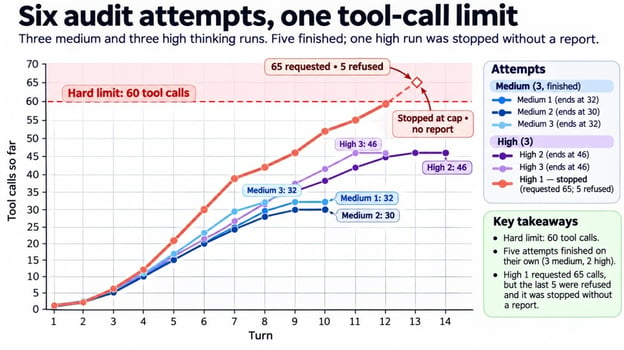
プロンプトは依頼しかできないため、上限などの制御はエージェントハーネス(モデルの周りの Python コード)側に置きます。API に予算設定がないため、アプリ側で試行ごとに上限を設定します。25 ターン、ツール呼び出し 60 回、30 分、$3、かつ各ターン間で支出をチェックします。
Interactions API で関数呼び出しのループを実装する
各ターンは 1 回の
client.interactions.create()呼び出しです。Gemini 4 Carbon は一度に複数のツールを要求することが多いため、ループは各function_callステップを処理します。以下が中核ループで、リポジトリ版はログと上限制御を追加しています。request辞書に設定をまとめ、フォローアップでも毎回再送します。previous_interaction_idが履歴を引き継ぎますが、tools、system_instruction、generation_configは 1 回のインタラクションにのみ適用されます。ターンがincompleteで終わった場合はmax_output_tokensによる切り捨てで、思考トークン分の課金は発生します。JSON スキーマで構造化された監査レポートを返す
Google の構造化出力ガイドは、ツールと JSON スキーマを 1 リクエストにまとめる Preview 機能(Gemini 4 Carbon を含む)を案内しています。本稿では分離しました。すなわち、調査のターンは測定のみにとどめ、同じ履歴と設定で最終ターンにツールなし+スキーマ指定でレポートを書かせます。
AuditReportは、判定・矛盾・証拠・推奨・承認要否を持つ Pydantic モデルです。時間とコストは Gemini 4 Carbon に報告させず、Python が計測します。詐欺検出モデルに対して Gemini 4 Carbon 監査を実行する
Gemini 4 Carbon は、望ましいジュニアアナリストのように、結論の前に測定から入る監査を行いました。最初の
medium試行では、監査コンテキストを読み、約 2 ダースの単一閾値をチェックし、8 つのポリシー変更をテストしました。全 32 回のツール呼び出しの順序。画像:筆者作成。
PayGuard の現在の閾値を評価する
現在の閾値 0.5 の評価では、Website 再現率 91%、Mobile App 再現率 20%、全体再現率 64%、最も忙しい日で 85 件のフラグという結果でした。R1 と R2 の Mobile App 側を満たせず、R3 には余裕があるため、明らかな一手は閾値を下げることです。
不正金額リコールを日次レビュー能力と突き合わせる
閾値を下げれば不正金額の捕捉は増えますが、レビューに回る注文も増えます。PayGuard は、前者を十分に確保しつつ、後者を日次上限内に収める必要があります。
エージェントは粗い閾値をバッチで試し、その後グリッドの単点に絞りました。トレースの呼び出し 11、12、17、18 が決め手になりました。
この検証期間では、Mobile App の下限達成に 0.108 以下が必要で、1 ステップ上げると 70% をわずかに割ります。一方、上限(キャパ)は 0.118 以上が必要。両方を同時に満たす閾値は存在しません。
全体再現率は 0.137 まで維持できるため、R1 はこの矛盾の外にあります。0.108 では平均で 1 日あたり約 169 件のフラグで、土曜の 1 日だけが上限を超えます。ポリシーが日平均ではなく最繁忙日の負荷を用いる理由がここにあります。
Mobile の再現率とキャパシティは交わらない。画像:筆者作成。
両方の決済チャネルでの性能を確認する
シグナルが弱い Mobile App の不正はスコア帯の低い方に分布します。Mobile App に合わせて単一閾値を 0.108 に引き下げると、正当な Website 注文もより多く巻き込み、土曜のその日に合計が上限を超えます。
全体の数字はこの事実を隠します。0.118 では全体再現率が約 87% でも、Mobile App は下限を下回ります。ポリシーがセグメントを名指ししているなら、必ずそれぞれ測定してください。合計が通っても、1 セグメントが落ちることがあります。
Gemini 4 Carbon は運用要件の矛盾を検出できるか?
本監査では可能でした。凍結レポートは
not deployable(本番不可)とし、単一閾値は存在しないこと、矛盾は Mobile App の R2 と R3 にあることを示しています。Gemini 4 Carbon の運用判定を証拠と突き合わせる
レポートが引用する数値はすべてツール結果と一致しましたが、1 文だけ測定以上の主張をしています。「0.001 の全グリッドで単一閾値は成り立たない」と述べますが、エージェントが実際に試したのは上のトレースの 2 ダースで、可能な 1,002 個の閾値すべてではありません。
この主張が成り立つのは、閾値が上がるとリコールも日次件数も下がるためです。ただし、レポート自体はそれを明言していません。エージェントのレポートにある主張は、測定した内容と照合してください。類似のチェックはAI エージェントの評価ガイドでも扱っています。
Python の全探索評価器で矛盾を検証する
Gemini 4 Carbon は閾値をサンプリングし、成立するものがないと推測しました。評価器は、ツールとコードを共有せずに、すべての異なるフラグ集合をチェックして、この検証集合に対する結果を証明します。
スコアは 0.001 グリッドに載るため、1,002 個の候補しきい値で全フラグ集合を網羅できます。評価器はそれら全部と、あらゆるチャネル別閾値ペアをチェックし、金額は整数センチ(¢)で扱って 85% と 70% を厳密に比較します。
全探索と 4 つの誤設定の却下。画像:筆者作成。
全ルールを満たすグローバル閾値は 1 つもないため、Gemini 4 Carbon の主張には裏付けが取れました。評価器は、エージェントの探索で得た 0.108 と 0.118 の境界と一致し、1 日 200 の上限で成立するチャネルペアを数千見つけました。
評価器は誤答を退けてこそ有用なので、あえて 4 つの誤設定を与えたところ、いずれも却下されました。
Gemini 4 Carbon で運用代替案を検証する
Gemini 4 Carbon は、許容される 2 つの変更を両方試し、追加審査員が不要な元の上限でのチャネル別閾値を選びました。この選択は人の承認が必要な例外としてフラグ付けされました。
手動レビュー能力の増加を試す
日次上限を 200 から 205 に上げれば単一閾値で成立し、評価器は 205 が最小の増加であると確認しました。ただし先述の優先ルールにより、Gemini 4 Carbon はこの案を 2 位に置きました。
決済チャネルごとの閾値を試す
チャネル側では、エージェントは Mobile App の閾値を下限近くに保ち(0.109 で下限割れをすでに観測)、Website の閾値を上げ、正当な Website 注文のフラグを減らしました。7 組をテストし、うち 1 組は最繁忙日で 1 件超過により失敗。Website 0.3、Mobile App 0.1 を推奨し、この組はすべてのルールを余裕を持って満たし、評価器も元の上限で確認しました。
検証済みの代替案を比較する
以下は前述の数値で、評価器がそれぞれ再計算しています。
オプション
閾値
全体
Website
Mobile App
最繁忙日
承認
元のポリシー
Global 0.108
87.5%
98.2%
70.1%
205、上限 200
失敗
キャパシティ増加
Global 0.108
87.5%
98.2%
70.1%
205、上限 205
要承認
チャネル分割
Website 0.3、Mobile App 0.1
86.2%
94.5%
72.8%
191、上限 200
要承認
チャネル分割は、キャパシティ案よりも約 6% 少ない取引をフラグします。ただし、フラグの半分未満が不正であり、これはレポートで未解決事項として挙げられました。
未見データで Gemini 4 Carbon の推奨を検証する方法
推奨を凍結し、非公開のホールドアウトに適用して検証します。評価器との違いはデータです。評価器はエージェントが見られる週を評価し、ホールドアウトはエージェントが読めない後続 4 週間を評価します。検証は凍結済み推奨ごとに 1 回だけ実行し、凍結後にレポートが変わっていれば開始しません。
凍結推奨はホールドアウトでも合格。画像:筆者作成。
3 つのルールすべてを満たし、最繁忙日も上限内でした。ただし過度な一般化は禁物です。次の 3 点から結果は控えめに解釈すべきです。
最初の 2 点は数値に基づきます。
Streamlit で監査全体を再生する
リポジトリには Streamlit アプリと 6 回分の記録も含まれており、API コールなしで監査を開けます。動画では、それを読み込み、各タブを順に見ていきます。