Gemini 4 Carbon API Tutorial: Baue einen Agenten, der ein Fraud-Modell auditiert
Lerne die Gemini 4 Carbon API in Python: Baue einen Agenten mit Function Calling, der ein Fraud-Modell auditiert, widersprüchliche Regeln findet und eine Policy-Änderung testet.
In unserem Gemini 4 Argon API Tutorial hatte der Agent einen klaren Auftrag: langsamen Code finden, ändern und versteckte Tests bestehen. Dieses ergänzende Experiment behält das Muster aus kontrollierten Tools und externer Prüfung bei, ändert aber die Entscheidung. Gemini 4 Carbon muss herausfinden, ob die ursprünglichen Regeln überhaupt erfüllbar sind.
PayGuard, ein fiktiver Onlineshop, hat ein trainiertes Machine-Learning-(ML)-Modell, das Bestellungen auf Betrug bewertet. Die Deployment-Policy verlangt, dass das Modell genügend Betrugswert insgesamt und pro Vertriebskanal abfängt, ohne das Review-Team zu überlasten. Der Agent soll diese Regeln prüfen, ohne zu wissen, ob es überhaupt einen gültigen Schwellenwert gibt.
Gemini 4 Carbon ist ein Google-Reasoning-Modell, das du aus Python über die Interactions API aufrufst. Hier agiert es als KI-Agent: Es wählt die Prüfungen aus, und Python führt sie über drei Read-only-Tools per Function Calling aus. Meine Frage ist, ob es den Konflikt erkennen, die Evidenz erklären und eine zulässige Änderung empfehlen kann, ohne diese Änderung als genehmigt zu behandeln.
Du brauchst grundlegendes Python und etwas Erfahrung mit API-Requests. Ich definiere jede Fraud-Metrik, bevor Zahlen sie verwenden. Wir behandeln, wie du:
Einen ersten Request aus Python an Gemini 4 Carbon sendest
Dem Modell Read-only-Tools gibst und sie mit Limits in einer Schleife ausführst
Das Urteil als JSON zurückbekommst, das dein Code prüfen kann
Dieses Urteil mit Code und Daten verifizierst, die das Modell nie sieht
Zwei Denkstufen vergleichst, die steuern, wie viel das Modell vor der Antwort begründet
Die Gemini 4 Carbon API ist die kostenpflichtige Programmierschnittstelle (API) für gemini-4-carbon, die auf der Modellseite als Reasoning-Modell für lange, mehrstufige Agentenaufgaben beschrieben wird. Input, Denken und Output teilen sich ein Kontextfenster mit 1.048.576 Token, und eine synchrone Antwort stoppt standardmäßig bei 65.536 Token aus Denken plus Output.
Warum ein ML-Model-Audit ein guter Test für Gemini 4 Carbon ist
Die Aufgabe erfordert mehrere Checks, eine Suche durch zulässige Änderungen und einen klaren Stopp, wenn die Regeln keine Antwort zulassen. Ich habe sie gewählt, weil Python das Referenzergebnis berechnen kann. Die Model Card listet Halluzinationen als bekannte Grenze von Gemini 4 Carbon, daher recherchiert das Modell, während Python entscheidet, ob die Empfehlung trägt.
Das Projekt: Entscheiden, ob PayGuards Fraud-Modell live gehen kann
PayGuard ist der fiktive Shop aus der Einleitung, und das komplette Projekt liegt im GitHub-Repository. Sein Klassifikator ist bereits trainiert.
So bewertet PayGuard Transaktionen
Jede Transaktion hat einen UTC-Zeitstempel, einen Betrag, einen Kanal (Website oder Mobile App), einen Risikoscore und ein Fraud-Label. Ein scikit-learn-HistGradientBoostingClassifier erzeugt den Score, auf 0,001 gerundet, und PayGuard markiert eine Transaktion, wenn risk_score >= threshold. Unser Precision-Recall-Kurven-Tutorial zeigt, wie ein verschobener Schwellenwert verändert, was markiert wird, und unser Kurs Fraud Detection in Python behandelt die Modellierung.
Die synthetischen Daten sind zeitlich gesplittet:
Training: die ersten neun Wochen, nur zum Fitten des Klassifikators
Validation: die nächsten vier Wochen, das einzige Fenster, das die Tools lesen dürfen
Holdout: die folgenden vier Wochen, versiegelt, bis die Empfehlung eingefroren ist
Der aktuelle Schwellenwert ist 0,5, und Daten sowie Policy ändern sich während des Experiments nie. Website-Betrug hinterlässt in diesen Daten deutliche Signale, während die meisten Mobile-App-Betrugsfälle wie reguläre Bestellungen aussehen.
Gemini 4 Carbon fragt, Python entscheidet. Bild: Autor.
PayGuards drei Deployment-Regeln
Hier sind die drei Regeln aus der Einleitung, so formuliert, wie sie in der Policy stehen. Es sind fiktive Zielwerte für dieses Experiment:
R1: Markierte Transaktionen decken mindestens 85% des gelabelten Betrugswerts insgesamt ab
R2: Sie decken mindestens 70% des gelabelten Betrugswerts in jedem Kanal ab
R3: Es werden an keinem einzelnen UTC-Tag mehr als 200 Transaktionen markiert
Fraud-Value-Recall ist der Wert des markierten Betrugs dividiert durch den gesamten Betrugswert. Anders als der transaktionsbasierte Recall in unserem Precision-vs.-Recall-Guide zählt ein verpasster Betrug über 2.000 $ deutlich mehr als einer über 15 $, und Markieren heißt nicht, dass das Geld gerettet wurde. R3 begrenzt den geschäftigsten Einzeltag, und genau diese Formulierung entscheidet am Ende das Audit.
Der Agent darf zwei Änderungen untersuchen: eine tägliche Kapazität bis 260 mit einem einzigen Schwellenwert oder getrennte Kanal-Schwellenwerte bei der ursprünglichen Obergrenze. Beides braucht menschliche Freigabe, lässt sich nicht kombinieren, und die Policy bevorzugt die Option ohne zusätzliche Reviewer.
Was als korrektes Audit zählt
Ein korrektes Audit trifft vier Punkte, die du vor dem ersten Request festlegen solltest:
Das Urteil: Ob ein einzelner Schwellenwert R1, R2 und R3 in der Validation erfüllt
Der Konflikt: Welche Anforderungen die ursprüngliche Policy unmöglich machen
Die Alternative: Eine zulässige Änderung, die alle Regeln besteht, wenn Python sie neu berechnet
Die Präferenz: Die Empfehlung folgt der Präferenzordnung der Policy
Ein Evaluator, den der Agent nicht aufrufen kann, berechnet die Antwort.
So richtest du die Gemini 4 Carbon API in Python ein
Für die Einrichtung brauchst du Python 3.11 oder neuer und einen API-Schlüssel aus einem Google AI Studio Projekt mit aktivierter Abrechnung, denn die Preisseite nennt keine Free-Tier.
Google Gen AI SDK installieren und Projekt vorbereiten
Ich habe dieses Projekt mit dem Google Gen AI SDK in Version google-genai==3.1.0 getestet, dem Launch-Release auf PyPI, das gemini-4-carbon zur Interactions-Modellliste hinzugefügt hat. Klone das Projekt und installiere es in einer virtuellen Umgebung:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS oder Linux: source .venv/bin/activate
pip install-r requirements.txtBereitgestellt von
Führe danach die zwei Kommandos auf der Repository-Seite aus, die die Daten bauen und den Klassifikator mit festen Seeds fitten. Bei einem frischen Clone geben sie Folgendes aus:
Feste Seeds erzeugen denselben Datensatz. Bild: Autor.
Lege dann GEMINI_API_KEY=dein-key in einer .env Datei ab. Das Repository lädt ihn, ohne ihn auszugeben.
Deine erste Gemini 4 Carbon API-Anfrage
Führe dieses vollständige Beispiel aus dem Projektordner aus. Es gibt Gemini 4 Carbon die Policy und die Klassifikator-Zusammenfassung und fragt, was gemessen werden müsste – ohne einen Konflikt anzudeuten:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # die Policy-Texte des Projekts, Threshold und Limits
os.environ.pop("GOOGLE_API_KEY",None)# hätte sonst Vorrang vor GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard ist ein E-Commerce-Fraud-Klassifikator, der jeder Transaktion einen Risikoscore von 0 bis 1 gibt. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"Der aktuelle Schwellenwert ist {cfg.CURRENT_THRESHOLD}. Bevor du beurteilst, ob dieses Modell ""deployt werden kann, liste in höchstens fünf kurzen Bulletpoints die Messungen auf, die du ""bräuchtest – und warum.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google empfiehlt mindestens 15 Minuten)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Bereitgestellt von
Die Denkstufe geht in generation_config, und output_text enthält die Antwort. Ein Ausschnitt der Rückgabe:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Bereitgestellt von
Es las R3 als Tages-Peak und plante die Präferenzordnung der Policy, noch bevor es Zahlen sah. Es fragte jedoch nie nach Ties oder Score-Rundung, und der exhaustive Check, den ich später zeige, hängt genau davon ab. Der Call dauerte etwa 40 Sekunden und kostete rund 2 Cent.
Lass temperature, top_p und top_k weg – Gemini 4 Carbon ignoriert sie – ebenso thinking_budget.
So baust du einen ML-Audit-Agenten mit Gemini 4 Carbon Function Calling
Ein Gemini-4-Carbon-Audit-Agent ist eine Schleife: Das Modell fordert eine Auswertung an, Python validiert und führt sie aus, und das Ergebnis geht zurück, bis das Modell keine Anfragen mehr stellt.
Read-only-Tools für die Modellauswertung definieren
Der Agent bekommt drei Tools. Alle sind auf das Validierungsfenster beschränkt:
get_audit_context: Klassifikator-Zusammenfassung, aktuelle Konfiguration, Policy und zulässige Änderungen
evaluate_global_threshold: Fraud-Value-Recall insgesamt und je Kanal, Flags pro Tag sowie Diagnostik für einen Schwellenwert
evaluate_policy_change: dieselben Messungen für eine Kapazitätserhöhung oder ein Kanal-Schwellenwertpaar
Die vollständigen Schemas findest du im Repository. Dieser vereinfachte Auszug lässt die Felder für Threshold und Kapazität weg, ist also keine vollständige Deklaration zum Kopieren. Er zeigt nur die hier relevante Grenze: Das Tool akzeptiert genau die zwei von PayGuard erlaubten Policy-Änderungen, liest Validierungsdaten und genehmigt nichts.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Bereitgestellt von
Python validiert die ausgelassenen Felder für Threshold und Kapazität, lehnt Änderungen außerhalb der Policy ab und gibt Messungen statt Pass/Fail-Flags zurück. Der Agent kann den Holdout nicht erreichen, den Evaluator nicht aufrufen und die Policy nicht ändern. Warum ich auf Gemini 4 Carbons integrierte Codeausführung verzichtet habe, erkläre ich in den FAQs.
Gib dem Agenten ein klares Ziel und Abbruchregeln
Die System-Instruction setzt die Methode. Wie der erste Request deutet sie den Konflikt nicht an:
- Lies zuerst den Audit-Kontext und evaluiere dann die aktuelle Konfiguration vor allem anderen.
- Prüfe jede Anforderung selbst, indem du Tool-Zahlen mit dem Policy-Text vergleichst: R1, R2 für
  Website, R2 für Mobile App und R3. R3 ist ein Limit für den geschäftigsten Einzeltag, nicht für den Durchschnitt.
- Verwende nur Zahlen, die ein Tool zurückgegeben hat. Schätze keine Metrik, die du nicht gemessen hast.
- Wenn die Evidenz eine Frage nicht klärt, sag das. "Inconclusive" ist eine akzeptable Antwort.Bereitgestellt von
Der Prompt kann nur bitten, daher leben die Limits im Agent Harness, also dem Python-Code um das Modell. Da die API kein Budget-Setting hat, setzt die Anwendung sie pro Versuch: 25 Turns, 60 Toolaufrufe, 30 Minuten und 3 $ – mit Ausgabekontrolle zwischen den Turns.
Die Function-Calling-Schleife mit der Interactions API implementieren
Jeder Turn ist ein client.interactions.create()-Call. Gemini 4 Carbon fordert oft mehrere Tools auf einmal an, daher läuft die Schleife jeden function_call-Schritt. Das ist die Kernschleife; die Repository-Version fügt Logging und Limitprüfungen hinzu:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: die Output-Grenze hat den Turn abgeschnitten
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# Allowlist, validiert
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# Turn-, Tool-Call-, Zeit- und Ausgabenlimits werden hier geprüft, vor dem nächsten Request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Bereitgestellt von
Ich halte diese Settings in einem request-Dict, sodass jeder Folge-Call sie erneut sendet. previous_interaction_id trägt die Historie, aber tools, system_instruction und generation_config gelten jeweils nur für eine Interaction. Endet ein Turn incomplete, hat max_output_tokens ihn abgeschnitten – die Thinking-Tokens bezahlst du trotzdem.
Einen strukturierten Audit-Report per JSON-Schema zurückgeben
Googles Structured-Output-Guide listet Tools plus ein JSON-Schema in einem Request als Preview-Feature auf, das auch Gemini 4 Carbon umfasst. Ich habe sie dennoch getrennt: Die Untersuchungsturns messen nur, und ein finaler Turn mit gleicher Historie und Config schreibt den Report mit Schema und ohne Tools:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Bereitgestellt von
AuditReport ist ein Pydantic-Modell mit Urteil, Konflikt, Evidenz, Empfehlung und Freigaben. Zeit und Kosten misst Python selbst, statt Gemini 4 Carbon sie berichten zu lassen.
Den Gemini 4 Carbon Audit auf dem Fraud-Detection-Modell ausführen
Gemini 4 Carbon hat das Modell so auditiert, wie ich es mir von einem Junior-Analysten wünsche – mit Messungen vor jeder Schlussfolgerung. Beim ersten medium-Versuch las es den Audit-Kontext, prüfte rund zwei Dutzend einzelne Schwellenwerte und testete acht Policy-Änderungen.
Alle 32 Toolaufrufe in Reihenfolge. Bild: Autor.
PayGuards aktuellen Schwellenwert evaluieren
Der Agent bewertete den aktuellen Schwellenwert 0,5 und fand 91% Recall auf der Website, 20% in der Mobile App, 64% insgesamt und 85 Flags am geschäftigsten Tag. Das verfehlt R1 und den Mobile-App-Teil von R2, mit Luft unter R3 – naheliegend ist also ein niedrigerer Schwellenwert.
Fraud-Value-Recall gegen tägliche Review-Kapazität testen
Ein niedrigerer Schwellenwert fängt mehr Betrugswert und schickt mehr Bestellungen ins Review. PayGuard braucht genug vom Ersten, während das Zweite unter einer Tagesobergrenze bleiben muss.
Der Agent probierte zunächst grobe Schwellenwerte in einem Batch und fokussierte dann auf einzelne Gitterpunkte. Calls 11, 12, 17 und 18 im Trace entschieden es.
In diesem Validierungsfenster braucht die Mobile App mindestens 0,108 oder niedriger, weil ein Schritt höher sie knapp unter 70% drückt. Die Obergrenze verlangt 0,118 oder höher. Kein Schwellenwert erfüllt beides.
Der Gesamt-Recall hält bis 0,137, daher liegt R1 außerhalb des Konflikts. Bei 0,108 hat der Durchschnittstag etwa 169 Flags, und nur ein Samstag liegt darüber. Deshalb nutzt die Policy die Tages-Spitze statt des Tagesdurchschnitts.
Mobile-Recall und Kapazität überlappen nie. Bild: Autor.
Performance über beide Zahlungskanäle prüfen
Mobile-App-Betrug mit schwächeren Signalen liegt weit unten im Score-Bereich. Einen globalen Schwellenwert auf 0,108 für die Mobile App zu ziehen, holt auch mehr legitime Website-Bestellungen herein, und an jenem Samstag drücken sie die Summe über das Limit.
Die Gesamtzahl verschleiert es: Bei 0,118 liegt der Gesamt-Recall bei rund 87%, während die Mobile App unter ihrer Untergrenze bleibt. Wenn deine Policy Segmente nennt, miss jedes einzelne – die Summe kann bestehen, während ein Segment durchfällt.
Kann Gemini 4 Carbon widersprüchliche Deployment-Anforderungen erkennen?
Ja, in diesem Audit. Der eingefrorene Report sagt not deployable, nennt, dass kein einzelner Schwellenwert funktioniert, und identifiziert R2 für die Mobile App und R3 als Konflikt.
Gemini 4 Carbons Deployment-Urteil gegen die Evidenz gegenprüfen
Jede zitierte Zahl entspricht einem Tool-Ergebnis, aber ein Satz behauptet mehr, als gemessen wurde. Er sagt, kein Schwellenwert funktioniere „across all 0.001 risk-score grid points“, obwohl der Agent nur die zwei Dutzend im obigen Trace testete – von 1.002 möglichen Schwellenwerten.
Die Behauptung hält, weil Recall und Tagesanzahl beide fallen, wenn der Schwellenwert steigt – was der Report nie ausspricht. Prüfe jede Aussage im Agentenreport gegen das, was er gemessen hat. Unser Leitfaden zum Bewerten von KI-Agenten deckt weitere solcher Checks ab.
Den Konflikt mit einem exhaustiven Python-Evaluator verifizieren
Gemini 4 Carbon hat Schwellenwerte gesampelt und gefolgert, dass keiner funktionieren könne. Der Evaluator beweist dieses Ergebnis für das Validierungsset, indem er jeden unterschiedlichen Flag-Satz prüft – ohne Code mit den Tools zu teilen.
Scores liegen auf einem 0,001-Raster, daher decken die 1.002 Kandidaten-Cutoffs jeden möglichen Flag-Satz ab. Der Evaluator prüft sie alle sowie jedes Paar von Kanal-Schwellenwerten, und nutzt ganze Centbeträge, sodass 85% und 70% exakt sind.
Exhaustiver Check und vier abgelehnte Konfigurationen. Bild: Autor.
Kein globaler Schwellenwert besteht alle drei Regeln, also steht Gemini 4 Carbons Aussage nun auf festem Boden. Der Evaluator bestätigte die Grenzen 0,108 und 0,118 aus der Agentensondierung und fand Tausende Kanalpaare, die bei 200 pro Tag bestehen.
Ein Evaluator hilft nur, wenn er schlechte Antworten verwirft, daher habe ich ihm vier falsche Konfigurationen gegeben – er hat alle vier abgelehnt.
Deployment-Alternativen mit Gemini 4 Carbon testen
Gemini 4 Carbon hat beide zulässigen Änderungen getestet und getrennte Schwellenwerte bei der ursprünglichen Obergrenze gegenüber zusätzlichen Reviewern bevorzugt. Es kennzeichnete diese Wahl als Ausnahme, die eine Person genehmigen muss.
Erhöhung der manuellen Review-Kapazität testen
Ein globaler Schwellenwert funktioniert, wenn die Obergrenze von 200 auf 205 steigt, und der Evaluator bestätigte 205 als kleinste Erhöhung. Dennoch rangierte Gemini 4 Carbon diese Option wegen der oben beschriebenen Präferenzregel an zweiter Stelle.
Getrennte Schwellenwerte je Zahlungskanal testen
Auf der Kanal-Seite hielt der Agent den Mobile-App-Schwellenwert nahe seiner Grenze (0,109 hatte bereits die Untergrenze gerissen) und erhöhte den Website-Schwellenwert, wodurch Flags auf legitime Website-Bestellungen sanken. Er testete sieben Paare, und eines scheiterte um ein einziges Flag am geschäftigsten Tag. Empfohlen wurden Website 0,3 und Mobile App 0,1, weil dieses Paar alle Regeln mit Puffer erfüllt; der Evaluator bestätigte es bei der ursprünglichen Obergrenze.
Die verifizierten Alternativen vergleichen
Diese Zahlen sind oben bereits aufgetaucht; der Evaluator hat jede neu berechnet:
Option
Schwellenwerte
Insgesamt
Website
Mobile App
Geschäftigster Tag
Freigabe
Original-Policy
Global 0,108
87,5%
98,2%
70,1%
205, Limit 200
Scheitert
Mehr Kapazität
Global 0,108
87,5%
98,2%
70,1%
205, Limit 205
Erforderlich
Kanal-Split
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, Limit 200
Erforderlich
Der Kanal-Split markiert außerdem rund 6% weniger Transaktionen als die Kapazitätsoption. Allerdings ist weniger als die Hälfte der Flags tatsächlich Betrug – ein offener Punkt im Report.
So verifizierst du Gemini 4 Carbons Empfehlung auf ungesehenen Daten
Du verifizierst die Empfehlung, indem du sie eingefroren auf den versiegelten Holdout anwendest. Der Unterschied zum Evaluator sind die Daten: Der Evaluator bewertete Wochen, die der Agent sehen konnte, und der Holdout umfasst vier spätere Wochen, die kein Tool lesen durfte. Der Check läuft einmal pro eingefrorener Empfehlung und startet nicht, wenn sich der Report nach dem Einfrieren geändert hat.
Die eingefrorene Empfehlung besteht im Holdout. Bild: Autor.
Sie bestand alle drei Regeln, und der geschäftigste Tag blieb unter der Obergrenze. Lies trotzdem nicht zu viel hinein. Drei Punkte relativieren das Ergebnis:
Der Holdout stammt aus demselben Generator, sagt also nichts über neue Betrugsarten oder Daten-Drift
Der Gesamt-Recall überschritt 85% um weniger als zwei Punkte
Ungetestete Vermutung: Der Split könnte die Obergrenze reißen, wenn der Mobile-App-Traffic schneller wächst als der Website-Traffic, weil der Mobile-App-Schwellenwert so niedrig liegt
Die ersten zwei folgen direkt aus den Zahlen.
Das komplette Audit in Streamlit ansehen
Das Repository enthält auch eine Streamlit-App und die sechs aufgezeichneten Versuche, sodass du dieses Audit ohne API-Call öffnen kannst. Im Video lade ich es und gehe Tab für Tab durch.
Die Streamlit-App zeigt ein Audit. Video: Autor.
Gemini 4 Carbon Medium vs. High Thinking: Genauigkeit, Zeit und Kosten
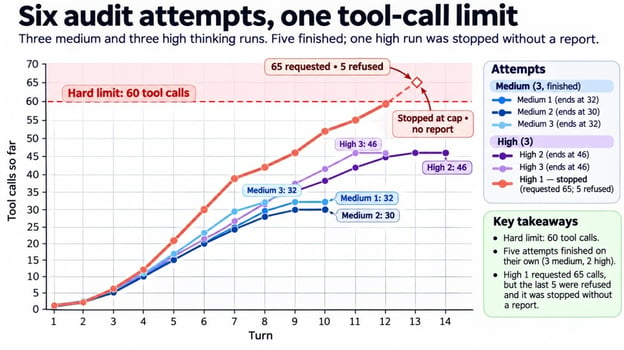
Erfolg heißt hier: innerhalb der Anwendungsgrenzen fertig werden und einen Report zurückgeben, den der Evaluator akzeptiert. Ein gestoppter Versuch hat kein Urteil zum Bewerten. Nach dieser Definition beendete medium jeden Versuch und kostete pro korrektem Audit weniger als die Hälfte.
Sechs Versuche sind zu wenig für eine allgemeine Regel. Wenn Denkstufen neu für dich sind, erklärt unser Gemini 3.8 Flash API Tutorialthinking_level ausführlicher.
Medium und High im selben Audit vergleichen
Das ist der vollständige Vergleich hinter dem TL;DR. Ich habe je drei Versuche pro Stufe ausgeführt, jeweils aus einem sauberen Zustand ohne Erinnerung an die anderen, mit identischen Daten, Prompt, Tools, Limits und Evaluator:
Pro Stufe
medium
high
Versuche, die mit Report endeten
3 von 3
2 von 3
Korrekte Audits darunter
3 von 3
2 von 2
Thinking-Tokens pro Versuch
Ca. 7.700
Ca. 17.500
Zeit pro Versuch
Ca. 5 Minuten
Ca. 6 Minuten
Kosten pro korrektem Audit, Einführungsrate
Ca. $0,25
Ca. $0,62
Kosten pro korrektem Audit, Standardrate
Ca. $0,51
Ca. $1,24
Die Kostenzeilen zählen die Ausgaben aller Versuche, inklusive des gestoppten. Jeder abgeschlossene Versuch kam zum selben Urteil und Konflikt und wählte ein Kanalpaar, das der Evaluator akzeptierte – die zusätzliche Denkleistung floss in mehr Checks.
Ein ähnliches Muster sah ich im Gemini-4-Argon-Coding-Experiment: highgab mehr aus und leistete mehr Arbeit für eine kleinere Veränderung im verifizierten Ergebnis. Die Aufgaben unterscheiden sich, daher sind ihre Kosten und Erfolgsraten nicht direkt vergleichbar. In beiden Fällen sagt die unabhängige Prüfung mehr aus als die Thinking-Summe.
Warum ein High-Thinking-Versuch nie fertig wurde
Der gestoppte Versuch war der erste mit high und lieferte nie ein falsches Urteil. Er sondierte jeden Gitterpunkt von 0,101 bis 0,119 und jagte dann der 70%-Grenze der Website nach, von der nichts abhing, und forderte immer weitere Checks an, bis er mein Limit von 60 Aufrufen riss und die Anwendung ihn stoppte, bevor ein Report geschrieben wurde.
Nur ein Versuch traf das Limit. Bild: Autor.
Genau dieser Stopp ist nützlich. Ein Prompt mit der Bitte um weniger Aufrufe hätte es nicht beendet, die Grenze im Code schon – nach rund 22 Cent.
Auch die fünf fertigen Reports bestanden Pythons weitere Checks. Keiner misslas die aktuelle Konfiguration, nannte eine Anforderung außerhalb des Konflikts, zitierte einen nicht existierenden Toolcall oder empfahl eine ungetestete Konfiguration.
Tokens, Zeit und Kosten pro Audit messen
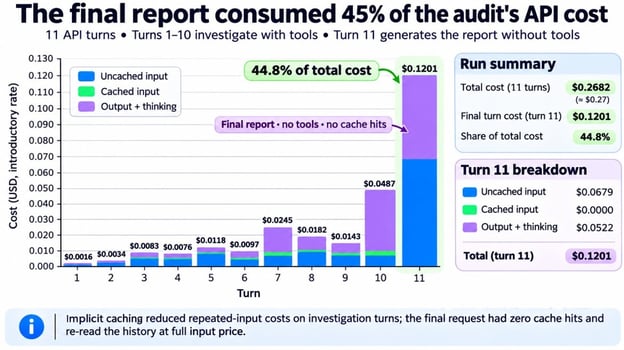
Ein Audit kostet die Summe der usage je Turn, bepreist mit $2,00 je Million Input-Tokens, $0,10 cached und $10,00 Output inklusive Thinking – alles verdoppelt sich am 1. Dezember 2026. total_input_tokens beinhaltet gecachte Tokens, daher bepreist der Code beide Teile getrennt.
Der Report-Turn kostet am meisten. Bild: Autor.
Überraschend war die Rechnung für den Report. Implizites Caching deckte rund drei Viertel der Input-Tokens in den Untersuchungsturns ab, aber der Report-Request ohne Tools traf nie den Cache.
Wahrscheinlicher Grund: Das Weglassen von tools verändert den Request-Anfang. So oder so las dieser Turn die ganze Historie zum vollen Preis erneut und nahm etwa 40% der Kosten jedes abgeschlossenen Versuchs ein. Berücksichtige diesen Turn beim Spend-Limit.
Grenzen beim Einsatz von Gemini 4 Carbon für ML-Model-Audits
Ich habe diesen Test und seine Daten selbst entworfen und generiert – das bringt folgende Einschränkungen mit sich:
Die Daten sind synthetisch und stammen von einem Klassifikator; ich habe den Generator so getunt, dass ein Konflikt existiert – vor jedem API-Call
Das Urteil gilt nur für diesen Klassifikator; ein besserer könnte alle drei Regeln mit einem Schwellenwert erfüllen
Einen Schwellenwert kann man prüfen, aber einen Kanal-Split zu genehmigen ist eine geschäftliche und Fairness-Entscheidung
Interactions werden im Paid-Tier standardmäßig 55 Tage gespeichert, und store=false schließt previous_interaction_id aus – ein Agent, der Transaktionszeilen sendet, braucht daher eine Datenprüfung
Der Evaluator löst das Schwellenwertproblem allein – ganz ohne Modell. Wenn du nur einen Schwellenwert brauchst, nutze einen Optimierungslöser. Was Gemini 4 Carbon hinzugefügt hat, war das Audit drumherum.
Nichts hier ist an Fraud gebunden. Das Setup passt auf jedes Modell, dessen Regeln Python messen kann.
Fazit
Das Hauptergebnis: Gemini 4 Carbon erkannte, dass die ursprüngliche Policy keinen gültigen globalen Schwellenwert zuließ. Alle 5 abgeschlossenen Versuche benannten den Konflikt und schlugen einen Kanal-Split vor, den der Evaluator akzeptierte; ein high-Versuch stoppte, bevor ein Report entstand.
Die Experimente mit Gemini 4 Argon und Gemini 4 Carbon testen zwei Seiten der Agenten-Zuverlässigkeit. Der Gemini-4-Argon-Agent änderte Code und musste Verhalten bewahren, während der Gemini-4-Carbon-Agent eine Entscheidung unter Regeln traf, die die ursprüngliche Antwort unmöglich machten. Beide brauchten enge Tools, Ressourcenlimits und eine Prüfung außerhalb des Modells.
Das ist der Standard, den ich für einen Agenten anlege: Definiere, was seine Tools belegen können, verifiziere das Ergebnis unabhängig und erlaube eine inconclusiveAntwort, wenn die Evidenz endet. Als Nächstes würde ich zwei oder drei Kandidatenklassifikatoren unter dieselbe Policy stellen und fragen, welcher – wenn überhaupt – shippen kann.
Ich bin Dateningenieur und Community-Builder und arbeite mit Datenpipelines, Cloud- und KI-Tools. Außerdem schreibe ich praktische, super nützliche Tutorials für DataCamp und angehende Entwickler.
FAQs
Wie erhalte ich Zugriff auf die Gemini 4 Carbon API?⌄
Über ein kostenpflichtiges Google AI Studio Projekt oder über Gemini for Business auf Google Cloud. Die Gemini App, Antigravity und AI Mode bieten es ebenfalls für Google AI Ultra Abonnenten, aber diese Consumer-Apps stellen keinen API-Schlüssel bereit.
Was kostet die Gemini 4 Carbon API?⌄
Alle 6 Audits hier kamen zusammen auf $2,00 zum Einführungspreis. Standard-Requests wie diese erhalten implizites Caching, sobald ein Request über 4.096 Input-Tokens liegt – halte also den Beginn jedes Requests identisch. Flex Inference, das Interactions-Requests ebenfalls unterstützen, halbiert die Tokenpreise im Tausch gegen langsamere, weniger zuverlässige Antworten.
Wie lauten die Rate Limits für die Gemini 4 Carbon API?⌄
Kostenpflichtige Projekte haben Limits pro Minute plus ein Ausgabenlimit – auf Tier 1 sind das $10 pro rollendem 10-Minuten-Fenster. Bei Überschreitung kommt 429 RESOURCE_EXHAUSTED. Ein Audit hier kostete unter $1, daher träfe es nur viele parallele Versuche. Die Limits steigen mit deinem Tier – prüfe Googles Rate-Limits-Seite für dein Projekt.
Was ist der Unterschied zwischen Medium und High Thinking in Gemini 4 Carbon?⌄
Gemini 4 Carbon hat drei Stufen, low, medium (Standard) und high. Hier habe ich nur die oberen zwei verglichen. Um zu sehen, wie sich das Mehr an Denken äußert, setze thinking_summariesauf "auto" – dann bekommst du komprimierte Zusammenfassungen neben jeder Antwort. Sie sind standardmäßig aus und können leer sein, wenn das Modell kaum begründet.
Kann Gemini 4 Carbon Python-Code ausführen?⌄
Ja. Füge {"type": "code_execution"} zu tools hinzu, und Gemini 4 Carbon kann Python auf Googles Seite schreiben und ausführen – abgerechnet zu den normalen Tokenraten. Ich habe es weggelassen, um die Kontrolle auf meiner Seite zu behalten: Die drei Tools bestimmen, was gemessen werden kann, und Rohtransaktionen sowie Holdout verlassen meine Maschine nicht.
Lerne die wichtigsten Arten von KI-Agenten kennen, wie sie mit ihrer Umgebung interagieren und wie sie in verschiedenen Branchen eingesetzt werden. Verstehe einfache reflexive, modellbasierte, zielbasierte, nutzenbasierte, lernende Agenten und mehr.
Lerne, wie man mit JSON in Python arbeitet, einschließlich Serialisierung, Deserialisierung, Formatierung, Leistungsoptimierung, Umgang mit APIs und Verständnis der Einschränkungen und Alternativen von JSON.
Lerne mehr über Python-Lambda-Funktionen, wozu sie gut sind und wann man sie benutzt. Enthält praktische Beispiele und bewährte Methoden für eine effektive Umsetzung.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.






In unserem Gemini 4 Argon API Tutorial hatte der Agent einen klaren Auftrag: langsamen Code finden, ändern und versteckte Tests bestehen. Dieses ergänzende Experiment behält das Muster aus kontrollierten Tools und externer Prüfung bei, ändert aber die Entscheidung. Gemini 4 Carbon muss herausfinden, ob die ursprünglichen Regeln überhaupt erfüllbar sind.
PayGuard, ein fiktiver Onlineshop, hat ein trainiertes Machine-Learning-(ML)-Modell, das Bestellungen auf Betrug bewertet. Die Deployment-Policy verlangt, dass das Modell genügend Betrugswert insgesamt und pro Vertriebskanal abfängt, ohne das Review-Team zu überlasten. Der Agent soll diese Regeln prüfen, ohne zu wissen, ob es überhaupt einen gültigen Schwellenwert gibt.
Gemini 4 Carbon ist ein Google-Reasoning-Modell, das du aus Python über die Interactions API aufrufst. Hier agiert es als KI-Agent: Es wählt die Prüfungen aus, und Python führt sie über drei Read-only-Tools per Function Calling aus. Meine Frage ist, ob es den Konflikt erkennen, die Evidenz erklären und eine zulässige Änderung empfehlen kann, ohne diese Änderung als genehmigt zu behandeln.
Du brauchst grundlegendes Python und etwas Erfahrung mit API-Requests. Ich definiere jede Fraud-Metrik, bevor Zahlen sie verwenden. Wir behandeln, wie du:
Wenn du die Launch-Story und Benchmarks willst, findest du sie in unserer Übersicht zu Gemini 4 Carbon, und unser Vergleich Claude Fable 5.2 vs. Gemini 4 Carbon stellt die beiden Modelle gegenüber. Ich habe dieses Experiment am Tag nach der API-Öffnung für zahlende Entwickler durchgeführt.
Was ist die Gemini 4 Carbon API?
Die Gemini 4 Carbon API ist die kostenpflichtige Programmierschnittstelle (API) für
gemini-4-carbon, die auf der Modellseite als Reasoning-Modell für lange, mehrstufige Agentenaufgaben beschrieben wird. Input, Denken und Output teilen sich ein Kontextfenster mit 1.048.576 Token, und eine synchrone Antwort stoppt standardmäßig bei 65.536 Token aus Denken plus Output.Warum ein ML-Model-Audit ein guter Test für Gemini 4 Carbon ist
Die Aufgabe erfordert mehrere Checks, eine Suche durch zulässige Änderungen und einen klaren Stopp, wenn die Regeln keine Antwort zulassen. Ich habe sie gewählt, weil Python das Referenzergebnis berechnen kann. Die Model Card listet Halluzinationen als bekannte Grenze von Gemini 4 Carbon, daher recherchiert das Modell, während Python entscheidet, ob die Empfehlung trägt.
Das Projekt: Entscheiden, ob PayGuards Fraud-Modell live gehen kann
PayGuard ist der fiktive Shop aus der Einleitung, und das komplette Projekt liegt im GitHub-Repository. Sein Klassifikator ist bereits trainiert.
So bewertet PayGuard Transaktionen
Jede Transaktion hat einen UTC-Zeitstempel, einen Betrag, einen Kanal (Website oder Mobile App), einen Risikoscore und ein Fraud-Label. Ein scikit-learn-
HistGradientBoostingClassifiererzeugt den Score, auf 0,001 gerundet, und PayGuard markiert eine Transaktion, wennrisk_score >= threshold. Unser Precision-Recall-Kurven-Tutorial zeigt, wie ein verschobener Schwellenwert verändert, was markiert wird, und unser Kurs Fraud Detection in Python behandelt die Modellierung.Die synthetischen Daten sind zeitlich gesplittet:
Der aktuelle Schwellenwert ist 0,5, und Daten sowie Policy ändern sich während des Experiments nie. Website-Betrug hinterlässt in diesen Daten deutliche Signale, während die meisten Mobile-App-Betrugsfälle wie reguläre Bestellungen aussehen.
Gemini 4 Carbon fragt, Python entscheidet. Bild: Autor.
PayGuards drei Deployment-Regeln
Hier sind die drei Regeln aus der Einleitung, so formuliert, wie sie in der Policy stehen. Es sind fiktive Zielwerte für dieses Experiment:
Fraud-Value-Recall ist der Wert des markierten Betrugs dividiert durch den gesamten Betrugswert. Anders als der transaktionsbasierte Recall in unserem Precision-vs.-Recall-Guide zählt ein verpasster Betrug über 2.000 $ deutlich mehr als einer über 15 $, und Markieren heißt nicht, dass das Geld gerettet wurde. R3 begrenzt den geschäftigsten Einzeltag, und genau diese Formulierung entscheidet am Ende das Audit.
Der Agent darf zwei Änderungen untersuchen: eine tägliche Kapazität bis 260 mit einem einzigen Schwellenwert oder getrennte Kanal-Schwellenwerte bei der ursprünglichen Obergrenze. Beides braucht menschliche Freigabe, lässt sich nicht kombinieren, und die Policy bevorzugt die Option ohne zusätzliche Reviewer.
Was als korrektes Audit zählt
Ein korrektes Audit trifft vier Punkte, die du vor dem ersten Request festlegen solltest:
Ein Evaluator, den der Agent nicht aufrufen kann, berechnet die Antwort.
So richtest du die Gemini 4 Carbon API in Python ein
Für die Einrichtung brauchst du Python 3.11 oder neuer und einen API-Schlüssel aus einem Google AI Studio Projekt mit aktivierter Abrechnung, denn die Preisseite nennt keine Free-Tier.
Google Gen AI SDK installieren und Projekt vorbereiten
Ich habe dieses Projekt mit dem Google Gen AI SDK in Version
google-genai==3.1.0getestet, dem Launch-Release auf PyPI, dasgemini-4-carbonzur Interactions-Modellliste hinzugefügt hat. Klone das Projekt und installiere es in einer virtuellen Umgebung:Führe danach die zwei Kommandos auf der Repository-Seite aus, die die Daten bauen und den Klassifikator mit festen Seeds fitten. Bei einem frischen Clone geben sie Folgendes aus:
Feste Seeds erzeugen denselben Datensatz. Bild: Autor.
Lege dann
GEMINI_API_KEY=dein-keyin einer.envDatei ab. Das Repository lädt ihn, ohne ihn auszugeben.Deine erste Gemini 4 Carbon API-Anfrage
Führe dieses vollständige Beispiel aus dem Projektordner aus. Es gibt Gemini 4 Carbon die Policy und die Klassifikator-Zusammenfassung und fragt, was gemessen werden müsste – ohne einen Konflikt anzudeuten:
Die Denkstufe geht in
generation_config, undoutput_textenthält die Antwort. Ein Ausschnitt der Rückgabe:Es las R3 als Tages-Peak und plante die Präferenzordnung der Policy, noch bevor es Zahlen sah. Es fragte jedoch nie nach Ties oder Score-Rundung, und der exhaustive Check, den ich später zeige, hängt genau davon ab. Der Call dauerte etwa 40 Sekunden und kostete rund 2 Cent.
Lass
temperature,top_pundtop_kweg – Gemini 4 Carbon ignoriert sie – ebensothinking_budget.So baust du einen ML-Audit-Agenten mit Gemini 4 Carbon Function Calling
Ein Gemini-4-Carbon-Audit-Agent ist eine Schleife: Das Modell fordert eine Auswertung an, Python validiert und führt sie aus, und das Ergebnis geht zurück, bis das Modell keine Anfragen mehr stellt.
Read-only-Tools für die Modellauswertung definieren
Der Agent bekommt drei Tools. Alle sind auf das Validierungsfenster beschränkt:
get_audit_context: Klassifikator-Zusammenfassung, aktuelle Konfiguration, Policy und zulässige Änderungenevaluate_global_threshold: Fraud-Value-Recall insgesamt und je Kanal, Flags pro Tag sowie Diagnostik für einen Schwellenwertevaluate_policy_change: dieselben Messungen für eine Kapazitätserhöhung oder ein Kanal-SchwellenwertpaarDie vollständigen Schemas findest du im Repository. Dieser vereinfachte Auszug lässt die Felder für Threshold und Kapazität weg, ist also keine vollständige Deklaration zum Kopieren. Er zeigt nur die hier relevante Grenze: Das Tool akzeptiert genau die zwei von PayGuard erlaubten Policy-Änderungen, liest Validierungsdaten und genehmigt nichts.
Python validiert die ausgelassenen Felder für Threshold und Kapazität, lehnt Änderungen außerhalb der Policy ab und gibt Messungen statt Pass/Fail-Flags zurück. Der Agent kann den Holdout nicht erreichen, den Evaluator nicht aufrufen und die Policy nicht ändern. Warum ich auf Gemini 4 Carbons integrierte Codeausführung verzichtet habe, erkläre ich in den FAQs.
Gib dem Agenten ein klares Ziel und Abbruchregeln
Die System-Instruction setzt die Methode. Wie der erste Request deutet sie den Konflikt nicht an:
Der Prompt kann nur bitten, daher leben die Limits im Agent Harness, also dem Python-Code um das Modell. Da die API kein Budget-Setting hat, setzt die Anwendung sie pro Versuch: 25 Turns, 60 Toolaufrufe, 30 Minuten und 3 $ – mit Ausgabekontrolle zwischen den Turns.
Die Function-Calling-Schleife mit der Interactions API implementieren
Jeder Turn ist ein
client.interactions.create()-Call. Gemini 4 Carbon fordert oft mehrere Tools auf einmal an, daher läuft die Schleife jedenfunction_call-Schritt. Das ist die Kernschleife; die Repository-Version fügt Logging und Limitprüfungen hinzu:Ich halte diese Settings in einem
request-Dict, sodass jeder Folge-Call sie erneut sendet.previous_interaction_idträgt die Historie, abertools,system_instructionundgeneration_configgelten jeweils nur für eine Interaction. Endet ein Turnincomplete, hatmax_output_tokensihn abgeschnitten – die Thinking-Tokens bezahlst du trotzdem.Einen strukturierten Audit-Report per JSON-Schema zurückgeben
Googles Structured-Output-Guide listet Tools plus ein JSON-Schema in einem Request als Preview-Feature auf, das auch Gemini 4 Carbon umfasst. Ich habe sie dennoch getrennt: Die Untersuchungsturns messen nur, und ein finaler Turn mit gleicher Historie und Config schreibt den Report mit Schema und ohne Tools:
AuditReportist ein Pydantic-Modell mit Urteil, Konflikt, Evidenz, Empfehlung und Freigaben. Zeit und Kosten misst Python selbst, statt Gemini 4 Carbon sie berichten zu lassen.Den Gemini 4 Carbon Audit auf dem Fraud-Detection-Modell ausführen
Gemini 4 Carbon hat das Modell so auditiert, wie ich es mir von einem Junior-Analysten wünsche – mit Messungen vor jeder Schlussfolgerung. Beim ersten
medium-Versuch las es den Audit-Kontext, prüfte rund zwei Dutzend einzelne Schwellenwerte und testete acht Policy-Änderungen.Alle 32 Toolaufrufe in Reihenfolge. Bild: Autor.
PayGuards aktuellen Schwellenwert evaluieren
Der Agent bewertete den aktuellen Schwellenwert 0,5 und fand 91% Recall auf der Website, 20% in der Mobile App, 64% insgesamt und 85 Flags am geschäftigsten Tag. Das verfehlt R1 und den Mobile-App-Teil von R2, mit Luft unter R3 – naheliegend ist also ein niedrigerer Schwellenwert.
Fraud-Value-Recall gegen tägliche Review-Kapazität testen
Ein niedrigerer Schwellenwert fängt mehr Betrugswert und schickt mehr Bestellungen ins Review. PayGuard braucht genug vom Ersten, während das Zweite unter einer Tagesobergrenze bleiben muss.
Der Agent probierte zunächst grobe Schwellenwerte in einem Batch und fokussierte dann auf einzelne Gitterpunkte. Calls 11, 12, 17 und 18 im Trace entschieden es.
In diesem Validierungsfenster braucht die Mobile App mindestens 0,108 oder niedriger, weil ein Schritt höher sie knapp unter 70% drückt. Die Obergrenze verlangt 0,118 oder höher. Kein Schwellenwert erfüllt beides.
Der Gesamt-Recall hält bis 0,137, daher liegt R1 außerhalb des Konflikts. Bei 0,108 hat der Durchschnittstag etwa 169 Flags, und nur ein Samstag liegt darüber. Deshalb nutzt die Policy die Tages-Spitze statt des Tagesdurchschnitts.
Mobile-Recall und Kapazität überlappen nie. Bild: Autor.
Performance über beide Zahlungskanäle prüfen
Mobile-App-Betrug mit schwächeren Signalen liegt weit unten im Score-Bereich. Einen globalen Schwellenwert auf 0,108 für die Mobile App zu ziehen, holt auch mehr legitime Website-Bestellungen herein, und an jenem Samstag drücken sie die Summe über das Limit.
Die Gesamtzahl verschleiert es: Bei 0,118 liegt der Gesamt-Recall bei rund 87%, während die Mobile App unter ihrer Untergrenze bleibt. Wenn deine Policy Segmente nennt, miss jedes einzelne – die Summe kann bestehen, während ein Segment durchfällt.
Kann Gemini 4 Carbon widersprüchliche Deployment-Anforderungen erkennen?
Ja, in diesem Audit. Der eingefrorene Report sagt
not deployable, nennt, dass kein einzelner Schwellenwert funktioniert, und identifiziert R2 für die Mobile App und R3 als Konflikt.Gemini 4 Carbons Deployment-Urteil gegen die Evidenz gegenprüfen
Jede zitierte Zahl entspricht einem Tool-Ergebnis, aber ein Satz behauptet mehr, als gemessen wurde. Er sagt, kein Schwellenwert funktioniere „across all 0.001 risk-score grid points“, obwohl der Agent nur die zwei Dutzend im obigen Trace testete – von 1.002 möglichen Schwellenwerten.
Die Behauptung hält, weil Recall und Tagesanzahl beide fallen, wenn der Schwellenwert steigt – was der Report nie ausspricht. Prüfe jede Aussage im Agentenreport gegen das, was er gemessen hat. Unser Leitfaden zum Bewerten von KI-Agenten deckt weitere solcher Checks ab.
Den Konflikt mit einem exhaustiven Python-Evaluator verifizieren
Gemini 4 Carbon hat Schwellenwerte gesampelt und gefolgert, dass keiner funktionieren könne. Der Evaluator beweist dieses Ergebnis für das Validierungsset, indem er jeden unterschiedlichen Flag-Satz prüft – ohne Code mit den Tools zu teilen.
Scores liegen auf einem 0,001-Raster, daher decken die 1.002 Kandidaten-Cutoffs jeden möglichen Flag-Satz ab. Der Evaluator prüft sie alle sowie jedes Paar von Kanal-Schwellenwerten, und nutzt ganze Centbeträge, sodass 85% und 70% exakt sind.
Exhaustiver Check und vier abgelehnte Konfigurationen. Bild: Autor.
Kein globaler Schwellenwert besteht alle drei Regeln, also steht Gemini 4 Carbons Aussage nun auf festem Boden. Der Evaluator bestätigte die Grenzen 0,108 und 0,118 aus der Agentensondierung und fand Tausende Kanalpaare, die bei 200 pro Tag bestehen.
Ein Evaluator hilft nur, wenn er schlechte Antworten verwirft, daher habe ich ihm vier falsche Konfigurationen gegeben – er hat alle vier abgelehnt.
Deployment-Alternativen mit Gemini 4 Carbon testen
Gemini 4 Carbon hat beide zulässigen Änderungen getestet und getrennte Schwellenwerte bei der ursprünglichen Obergrenze gegenüber zusätzlichen Reviewern bevorzugt. Es kennzeichnete diese Wahl als Ausnahme, die eine Person genehmigen muss.
Erhöhung der manuellen Review-Kapazität testen
Ein globaler Schwellenwert funktioniert, wenn die Obergrenze von 200 auf 205 steigt, und der Evaluator bestätigte 205 als kleinste Erhöhung. Dennoch rangierte Gemini 4 Carbon diese Option wegen der oben beschriebenen Präferenzregel an zweiter Stelle.
Getrennte Schwellenwerte je Zahlungskanal testen
Auf der Kanal-Seite hielt der Agent den Mobile-App-Schwellenwert nahe seiner Grenze (0,109 hatte bereits die Untergrenze gerissen) und erhöhte den Website-Schwellenwert, wodurch Flags auf legitime Website-Bestellungen sanken. Er testete sieben Paare, und eines scheiterte um ein einziges Flag am geschäftigsten Tag. Empfohlen wurden Website 0,3 und Mobile App 0,1, weil dieses Paar alle Regeln mit Puffer erfüllt; der Evaluator bestätigte es bei der ursprünglichen Obergrenze.
Die verifizierten Alternativen vergleichen
Diese Zahlen sind oben bereits aufgetaucht; der Evaluator hat jede neu berechnet:
Option
Schwellenwerte
Insgesamt
Website
Mobile App
Geschäftigster Tag
Freigabe
Original-Policy
Global 0,108
87,5%
98,2%
70,1%
205, Limit 200
Scheitert
Mehr Kapazität
Global 0,108
87,5%
98,2%
70,1%
205, Limit 205
Erforderlich
Kanal-Split
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, Limit 200
Erforderlich
Der Kanal-Split markiert außerdem rund 6% weniger Transaktionen als die Kapazitätsoption. Allerdings ist weniger als die Hälfte der Flags tatsächlich Betrug – ein offener Punkt im Report.
So verifizierst du Gemini 4 Carbons Empfehlung auf ungesehenen Daten
Du verifizierst die Empfehlung, indem du sie eingefroren auf den versiegelten Holdout anwendest. Der Unterschied zum Evaluator sind die Daten: Der Evaluator bewertete Wochen, die der Agent sehen konnte, und der Holdout umfasst vier spätere Wochen, die kein Tool lesen durfte. Der Check läuft einmal pro eingefrorener Empfehlung und startet nicht, wenn sich der Report nach dem Einfrieren geändert hat.
Die eingefrorene Empfehlung besteht im Holdout. Bild: Autor.
Sie bestand alle drei Regeln, und der geschäftigste Tag blieb unter der Obergrenze. Lies trotzdem nicht zu viel hinein. Drei Punkte relativieren das Ergebnis:
Die ersten zwei folgen direkt aus den Zahlen.
Das komplette Audit in Streamlit ansehen
Das Repository enthält auch eine Streamlit-App und die sechs aufgezeichneten Versuche, sodass du dieses Audit ohne API-Call öffnen kannst. Im Video lade ich es und gehe Tab für Tab durch.