ใน บทช่วยสอน Gemini 4 Argon API ของเรา เอเจนต์มีงานชัดเจน: หาโค้ดที่ช้า แก้ไข และผ่านการทดสอบที่ซ่อนอยู่ การทดลองชุดนี้ยังคงรูปแบบเดิมของเครื่องมือที่ควบคุมได้และการตรวจสอบจากภายนอก แต่เปลี่ยนการตัดสินใจ Gemini 4 Carbon ต้องพิจารณาว่ากฎเดิมสามารถปฏิบัติได้จริงหรือไม่
PayGuard ร้านค้าออนไลน์สมมติ มีโมเดลแมชชีนเลิร์นนิง (ML) ที่เทรนแล้วเพื่อให้คะแนนการสั่งซื้อสำหรับการทุจริต นโยบายการนำไปใช้งานกำหนดว่าโมเดลต้องจับมูลค่าการฉ้อโกงได้เพียงพอทั้งภาพรวมและในแต่ละช่องทางการขาย โดยไม่ทำให้ทีมรีวิวล้น เอเจนต์ต้องตรวจสอบกฎเหล่านั้นโดยไม่ได้รับบอกว่ามี threshold ที่ถูกต้องอยู่หรือไม่
Gemini 4 Carbon เป็นโมเดล reasoning ของ Google ที่เรียกใช้จาก Python ผ่าน Interactions API ที่นี่มันทำหน้าที่เป็น เอเจนต์ AI : เลือกการตรวจเช็คที่ต้องการ และ Python จะรันผ่านเครื่องมือแบบอ่านอย่างเดียวสามตัวด้วย function calling คำถามคือมันจะระบุความขัดแย้ง อธิบายหลักฐาน และแนะนำการเปลี่ยนแปลงที่อนุญาตได้หรือไม่ โดยไม่ถือว่าการเปลี่ยนแปลงนั้นได้รับอนุมัติแล้ว
จำเป็นต้องมีพื้นฐาน Python และประสบการณ์การเรียก API เล็กน้อย จะนิยามแต่ละเมตริกฉ้อโกงก่อนที่ตัวเลขจะถูกใช้งาน เราจะครอบคลุมวิธีการ:
ส่งคำร้องแรกถึง Gemini 4 Carbon จาก Python ให้โมเดลใช้เครื่องมือแบบอ่านอย่างเดียวและรันในลูปพร้อมข้อจำกัด รับคำตัดสินกลับมาเป็น JSON ที่โค้ดตรวจสอบได้ ยืนยันคำตัดสินนั้นด้วยโค้ดและข้อมูลที่โมเดลไม่เคยเห็น เปรียบเทียบสองระดับการคิด ซึ่งควบคุมว่ามอเดลใช้เหตุผลมากแค่ไหนก่อนตอบ
หากต้องการเรื่องราวการเปิดตัวและคะแนน benchmark โปรดดู ภาพรวม Gemini 4 Carbon และ Claude Fable 5.2 vs. Gemini 4 Carbon ที่เปรียบเทียบสองโมเดลนี้ การทดลองนี้รันในวันถัดมาหลัง Google เปิด API ให้ผู้พัฒนาแบบเสียเงิน
Gemini 4 Carbon API คืออะไร?
Gemini 4 Carbon API คือ API แบบเสียเงินสำหรับ gemini-4-carbon ซึ่ง หน้ารายละเอียดโมเดล อธิบายว่าเป็นโมเดล reasoning สำหรับงานเอเจนต์แบบยาวหลายขั้นตอน อินพุต การคิด และเอาต์พุต ใช้ร่วมกันใน context window 1,048,576 โทเคน และการตอบแบบ synchronous จะหยุดที่ 65,536 โทเคนของการคิดรวมเอาต์พุตโดยค่าเริ่มต้น
ทำไมการออดิตโมเดล ML จึงเป็นบททดสอบที่ดีสำหรับ Gemini 4 Carbon
งานนี้ต้องการการตรวจหลายอย่าง การค้นหาการเปลี่ยนแปลงที่อนุญาต และการหยุดอย่างชัดเจนเมื่อกฎทำให้ไม่มีคำตอบ เลือกงานนี้เพราะ Python คำนวณผลอ้างอิงได้ model card ระบุว่าอาการเพ้อฝันเป็นหนึ่งในข้อจำกัดที่ทราบของ Gemini 4 Carbon ดังนั้นโมเดลจะสืบค้น ขณะที่ Python เป็นผู้ตัดสินว่าคำแนะนำใช้ได้หรือไม่
โปรเจกต์: ตัดสินว่าโมเดลตรวจฉ้อโกงของ PayGuard พร้อมใช้งานหรือไม่
PayGuard คือร้านสมมติจากเกริ่นนำ และโปรเจกต์เต็มอยู่ใน ที่เก็บ GitHub ตัวจัดหมวดหมู่ (classifier) เทรนไว้แล้ว
PayGuard ให้คะแนนธุรกรรมอย่างไร
แต่ละธุรกรรมมี timestamp แบบเวลาสากลเชิงพิกัด (UTC) จำนวนเงิน ช่องทาง (เว็บไซต์หรือแอปมือถือ) คะแนนความเสี่ยง และป้ายกำกับฉ้อโกง scikit-learn HistGradientBoostingClassifier สร้างคะแนน ปัดเศษถึง 0.001 และ PayGuard จะติดธงธุรกรรมเมื่อ risk_score >= threshold บทช่วยสอน precision-recall curve ของเราแสดงว่าการขยับ threshold เปลี่ยนสิ่งที่ถูกติดธงอย่างไร และคอร์ส Fraud Detection in Python ครอบคลุมด้านการสร้างโมเดล
ข้อมูลสังเคราะห์ถูกแบ่งตามเวลา:
Training: 9 สัปดาห์แรก ใช้เฉพาะสำหรับ fit ตัวจัดหมวดหมู่ Validation: 4 สัปดาห์ถัดมา เป็นหน้าต่างเดียวที่เครื่องมืออ่านได้ Holdout: 4 สัปดาห์ถัดจากนั้น ถูกผนึกจนกว่าจะตรึงคำแนะนำ
threshold ปัจจุบันคือ 0.5 และข้อมูลกับนโยบายไม่เปลี่ยนระหว่างการทดลอง การฉ้อโกงบนเว็บไซต์ทิ้งสัญญาณชัดเจนในข้อมูลนี้ ขณะที่การฉ้อโกงบนแอปมือถือส่วนใหญ่ดูเหมือนออเดอร์ปกติ
Gemini 4 Carbon เป็นผู้ขอ Python เป็นผู้ตัดสิน ภาพโดยผู้เขียน
3 กฎสำหรับการนำไปใช้งานของ PayGuard
นี่คือสามกฎจากเกริ่นนำ เขียนตามถ้อยคำในนโยบาย ทั้งหมดเป็นเป้าหมายสมมติที่เลือกมาสำหรับการทดลองนี้:
R1: ธุรกรรมที่ติดธงต้องครอบคลุมอย่างน้อย 85% ของมูลค่าการฉ้อโกงที่ติดป้ายกำกับโดยรวม R2: ครอบคลุมอย่างน้อย 70% ของมูลค่าการฉ้อโกงที่ติดป้ายกำกับภายในแต่ละช่องทาง R3: ไม่ติดธงเกิน 200 ธุรกรรมในวัน UTC ใดวันหนึ่ง
fraud-value recall คือมูลค่าการฉ้อโกงที่ถูกติดธงหารด้วยมูลค่าการฉ้อโกงทั้งหมด ต่างจาก recall ระดับธุรกรรมใน คู่มือ precision กับ recall ของเรา การพลาดฉ้อโกง $2,000 สำคัญกว่าการพลาด $15 มาก และการติดธงไม่ได้หมายความว่าเงินถูกช่วยไว้ R3 จำกัดวันที่ยุ่งที่สุด และถ้อยคำนี้เองที่เป็นตัวชี้ขาดในการออดิต
เอเจนต์สามารถสืบค้นการเปลี่ยนแปลงสองอย่าง: เพิ่มขีดความสามารถรายวันได้สูงสุดถึง 260 พร้อม threshold เดียว หรือแยก threshold ต่อช่องทางที่เพดานเดิม ทั้งสองต้องได้รับอนุมัติจากมนุษย์ ห้ามรวมกัน และนโยบายให้ความสำคัญกับตัวเลือกที่ไม่ต้องเพิ่มผู้รีวิว
นิยามการออดิตที่ถูกต้อง
การออดิตที่ถูกต้องต้องตอบถูก 4 เรื่อง และควรกำหนดก่อนการร้องขอแรก:
คำตัดสิน: มี threshold เดียวใดบ้างที่ผ่าน R1, R2 และ R3 บน validation ความขัดแย้ง: ข้อกำหนดใดทำให้นโยบายเดิมเป็นไปไม่ได้ ทางเลือก: การเปลี่ยนแปลงที่อนุญาตซึ่งผ่านทุกกฎเมื่อ Python คำนวณซ้ำ ลำดับความสำคัญ: คำแนะนำต้องเป็นไปตามลำดับความชอบของนโยบาย
ผู้ประเมินที่เอเจนต์เรียกไม่ได้จะคำนวณคำตอบ
วิธีตั้งค่า Gemini 4 Carbon API ใน Python
การตั้งค่า Gemini 4 Carbon API ต้องใช้ Python 3.11 ขึ้นไป และ คีย์ API จากโปรเจกต์ Google AI Studio ที่เปิดการคิดเงิน เพราะ หน้าราคา ไม่มีระดับใช้ฟรี
ติดตั้ง Google Gen AI SDK และเตรียมโปรเจกต์
ทดสอบโปรเจกต์นี้ด้วย Google Gen AI SDK ที่ปักเวอร์ชันไว้ที่ google-genai==3.1.0 ซึ่งเป็น รีลีสวันเปิดตัวบน PyPI ที่เพิ่ม gemini-4-carbon ในรายชื่อโมเดลของ Interactions โคลนโปรเจกต์และติดตั้งใน virtual environment:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\ Scripts\ Activate.ps1
pip install -r requirements.txtขับเคลื่อนโดย จากนั้นรันสองคำสั่งบนหน้าที่เก็บเพื่อสร้างข้อมูลและ fit ตัวจัดหมวดหมู่ด้วย seed ที่ตรึงไว้ บนโคลนใหม่จะแสดงผลดังนี้:
การตรึง seed ทำให้สร้างชุดข้อมูลเดียวกันซ้ำได้ ภาพโดยผู้เขียน
จากนั้นใส่ GEMINI_API_KEY=your-key ลงในไฟล์ .env ที่เก็บจะโหลดโดยไม่พิมพ์ค่าออกมา
ส่งคำร้อง Gemini 4 Carbon API ครั้งแรก
รันตัวอย่างสมบูรณ์นี้จากโฟลเดอร์โปรเจกต์ มันจะให้ Gemini 4 Carbon อ่านนโยบายและสรุปตัวจัดหมวดหมู่ และถามว่าต้องวัดอะไรบ้าง โดยไม่ใบ้ถึงความขัดแย้ง:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg
os. environ. pop( "GOOGLE_API_KEY" , None )
os. environ[ "GEMINI_API_KEY" ] = dotenv_values( ".env" ) [ "GEMINI_API_KEY" ]
client = genai. Client( )
summary = json. loads( open ( "data/model_summary.json" ) . read( ) )
prompt = ( "PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "
f"Model summary: { json. dumps( summary) } \n\n { cfg. POLICY_TEXT} \n\n" f"The current threshold is { cfg. CURRENT_THRESHOLD} . Before you judge whether this model can be " "deployed, list in at most five short bullets the measurements you would need and why." )
interaction = client. interactions. create(
model= "gemini-4-carbon" ,
input = prompt,
generation_config= { "thinking_level" : "medium" } ,
timeout= 900 ,
)
print ( interaction. output_text)
u = interaction. usage
print ( f"status= { interaction. status} | input= { u. total_input_tokens} cached= { u. total_cached_tokens} " f"output= { u. total_output_tokens} thinking= { u. total_thought_tokens} " ) ขับเคลื่อนโดย ระดับการคิดกำหนดผ่าน generation_config และ output_text เก็บคำตอบ ตัวอย่างส่วนหนึ่งที่ได้กลับมาคือ:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412ขับเคลื่อนโดย
มันอ่าน R3 เป็นค่าสูงสุดรายวัน และวางแผนลำดับความชอบของนโยบายก่อนเห็นตัวเลข มันไม่ถามเลยว่าผลเสมอหรือการปัดเศษคะแนนทำงานอย่างไร ทั้งที่การตรวจแบบครอบคลุมที่จะอธิบายต่อไปขึ้นอยู่กับจุดนี้ คำเรียกครั้งนี้ใช้เวลาประมาณ 40 วินาที และมีค่าใช้จ่ายราว 2 เซนต์
เว้น temperature, top_p และ top_k ไว้ เพราะ Gemini 4 Carbon ไม่สนใจ รวมถึง thinking_budget ด้วย
วิธีสร้างเอเจนต์ออดิต ML ด้วย Gemini 4 Carbon Function Calling
เอเจนต์ออดิตของ Gemini 4 Carbon เป็นลูป: โมเดลร้องขอการประเมิน Python ตรวจสอบและรัน แล้วส่งผลกลับไปจนกว่าโมเดลจะหยุดขอ
กำหนดเครื่องมืออ่านอย่างเดียวสำหรับการประเมินโมเดล
เอเจนต์ได้เครื่องมือสามตัว ทั้งหมดจำกัดเฉพาะหน้าต่าง validation:
get_audit_context: สรุปตัวจัดหมวดหมู่ ค่าคอนฟิกปัจจุบัน นโยบาย และการเปลี่ยนแปลงที่อนุญาต evaluate_global_threshold: fraud-value recall โดยรวมและแยกตามช่องทาง จำนวนที่ติดธงต่อวัน และตัวช่วยวินิจฉัยสำหรับ threshold หนึ่งค่า evaluate_policy_change: การวัดเดียวกันสำหรับการเพิ่มขีดความสามารถหรือคู่ threshold ต่อช่องทาง
สคีมาแบบเต็มอยู่ในที่เก็บ โค้ดย่อยที่เรียบง่ายนี้ละช่อง threshold และขีดความสามารถ จึงไม่ใช่ประกาศที่คัดลอกได้ครบ มันแสดงขอบเขตสำคัญที่นี่: เครื่องมือรับเฉพาะการเปลี่ยนแปลงนโยบายสองแบบที่ PayGuard อนุญาต อ่านข้อมูล validation และไม่อนุมัติอะไรทั้งนั้น
{ "type" : "function" , "name" : "evaluate_policy_change" ,
"description" : ( "Evaluate one allowed policy change on validation. "
"Read-only; it approves nothing." ) ,
"parameters" : { "type" : "object" , "properties" : {
"change_type" : { "type" : "string" ,
"enum" : [ "capacity_increase" , "channel_thresholds" ] } } ,
"required" : [ "change_type" ] } } ขับเคลื่อนโดย Python จะตรวจสอบความถูกต้องของฟิลด์ threshold และขีดความสามารถที่ละไว้ ปฏิเสธการเปลี่ยนแปลงนอกนโยบาย และส่งกลับเป็นตัวชี้วัดแทนธง pass/fail เอเจนต์ไม่สามารถเข้าถึง holdout เรียกผู้ประเมิน หรือเปลี่ยนนโยบาย อธิบายในคำถามที่พบบ่อยว่าทำไมไม่ใช้ความสามารถรันโค้ดในตัวของ Gemini 4 Carbon
กำหนดวัตถุประสงค์และกติกาการหยุดที่ชัดเจนให้เอเจนต์
system instruction กำหนดวิธีการ เช่นเดียวกับคำร้องแรก มันไม่ใบ้ตำแหน่งความขัดแย้ง:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.ขับเคลื่อนโดย
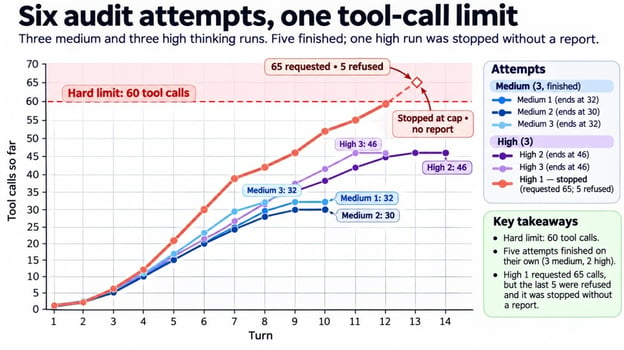
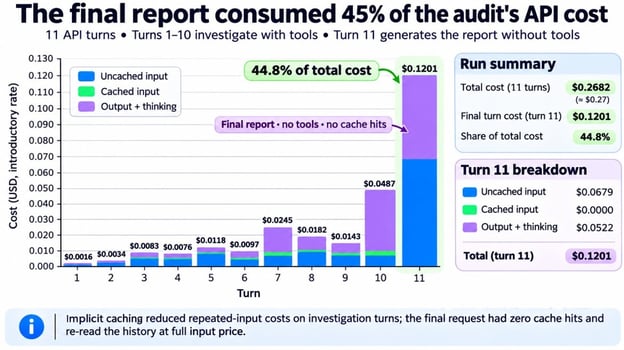
พรอมป์ตทำได้แค่ขอ ดังนั้นข้อจำกัดจึงอยู่ใน agent harness โค้ด Python ที่ครอบโมเดลไว้ เนื่องจาก API ไม่มีการตั้งงบประมาณ แอปพลิเคชันจึงตั้งตามครั้ง: 25 เทิร์น เครื่องมือ 60 ครั้ง 30 นาที และ $3 โดยตรวจสอบค่าใช้จ่ายระหว่างเทิร์น
ติดตั้งลูป function calling ด้วย Interactions API
แต่ละเทิร์นคือการเรียก client.interactions.create() หนึ่งครั้ง Gemini 4 Carbon มักขอหลายเครื่องมือพร้อมกัน จึงวนลูปที่ทุกขั้น function_call นี่คือแก่นของลูป และเวอร์ชันในที่เก็บเพิ่มการล็อกและตรวจข้อจำกัด:
request = dict ( model= "gemini-4-carbon" , system_instruction= SYSTEM_INSTRUCTION, tools= DECLARATIONS,
generation_config= { "thinking_level" : level, "max_output_tokens" : 65_536 ,
"thinking_summaries" : "auto" } )
interaction = client. interactions. create( input = TASK, timeout= 900 , ** request)
while True :
calls = [ s for s in interaction. steps if s. type == "function_call" ]
if interaction. status in ( "failed" , "cancelled" , "incomplete" ) or not calls:
break
results = [ ]
for call in calls:
out, is_error = tools. call( call. name, dict ( call. arguments) )
results. append( { "type" : "function_result" , "name" : call. name, "call_id" : call. id ,
"is_error" : is_error, "result" : [ { "type" : "text" , "text" : json. dumps( out) } ] } )
interaction = client. interactions. create( input = results, previous_interaction_id= interaction. id ,
timeout= 900 , ** request) ขับเคลื่อนโดย เก็บการตั้งค่าเหล่านี้ไว้ในดิกชันนารี request เดียวเพื่อให้ทุกคำร้องถัดไปส่งซ้ำ previous_interaction_id พาประวัติไปด้วย แต่ tools, system_instruction และ generation_config มีผลต่อ interaction เพียงครั้งเดียว หากเทิร์นจบแบบ incomplete แสดงว่า max_output_tokens ตัดคำตอบ และยังคงคิดค่าการคิดโทเคน
ส่งรายงานออดิตแบบมีโครงสร้างด้วย JSON schema
คู่มือ structured output ของ Google ระบุว่าเครื่องมือรวมกับ JSON schema ในคำร้องเดียวเป็นฟีเจอร์ Preview ที่รองรับ Gemini 4 Carbon อย่างไรก็ตามในที่นี้แยกกัน: เทิร์นการสืบค้นทำแค่การวัด และเทิร์นสุดท้ายบนประวัติและคอนฟิกเดียวกันจะเขียนรายงานด้วย schema และไม่มีเครื่องมือ:
final = client. interactions. create(
input = REPORT_PROMPT, previous_interaction_id= interaction. id , model= "gemini-4-carbon" ,
system_instruction= SYSTEM_INSTRUCTION, generation_config= request[ "generation_config" ] ,
response_format= { "type" : "text" , "mime_type" : "application/json" ,
"schema" : AuditReport. model_json_schema( ) } ,
timeout= 900 )
report = AuditReport. model_validate_json( final. output_text) ขับเคลื่อนโดย AuditReport เป็น โมเดล Pydantic ที่มีคำตัดสิน ความขัดแย้ง หลักฐาน คำแนะนำ และการอนุมัติ Python วัดเวลาและต้นทุนแทนที่จะขอให้ Gemini 4 Carbon รายงาน
รันการออดิต Gemini 4 Carbon บนโมเดลตรวจจับการฉ้อโกง
Gemini 4 Carbon ออดิตโมเดลเหมือนที่คาดหวังจากนักวิเคราะห์จูเนียร์ ทำการวัดก่อนสรุปผล ครั้งแรกที่ medium มันอ่านบริบทการออดิต ตรวจประมาณสองโหลของ threshold เดี่ยว และทดสอบการเปลี่ยนนโยบายแปดแบบ
การเรียกใช้เครื่องมือทั้ง 32 ครั้งตามลำดับ ภาพโดยผู้เขียน
ประเมิน threshold ปัจจุบันของ PayGuard
เอเจนต์ประเมิน threshold ปัจจุบันที่ 0.5 พบ recall เว็บไซต์ 91% แอปมือถือ 20% โดยรวม 64% และวันยุ่งที่สุด 85 ธง ซึ่งไม่ผ่าน R1 และครึ่งของ R2 ฝั่งแอปมือถือโดยยังเหลือพื้นที่ใต้ R3 ดังนั้นการลด threshold จึงเป็นทางเลือกชัดเจน
ทดสอบ fraud-value recall เทียบกับขีดความสามารถรีวิวรายวัน
การลด threshold จะจับมูลค่าฉ้อโกงได้มากขึ้นและส่งออเดอร์ไปรีวิวมากขึ้น PayGuard ต้องได้พอสำหรับอย่างแรก ขณะรักษาอย่างหลังให้อยู่ใต้เพดานรายวัน
เอเจนต์ลอง threshold แบบหยาบหลายค่าพร้อมกัน แล้วค่อยแคบลงเป็นจุดบนกริดเดียว การเรียกครั้งที่ 11, 12, 17 และ 18 ในทรซยืนยันผลนี้
ในหน้าต่าง validation นี้ ฝั่งแอปมือถือจำเป็นต้องใช้ 0.108 หรือต่ำกว่า เพราะเพิ่มขึ้นหนึ่งขั้นจะต่ำกว่า 70% เล็กน้อย ขณะที่เพดานต้องใช้ 0.118 หรือสูงกว่า ไม่มี threshold ใดทำได้ทั้งสองอย่าง
recall โดยรวมยังผ่านถึง 0.137 ดังนั้น R1 ไม่อยู่ในความขัดแย้ง ที่ 0.108 วันเฉลี่ยมีราว 169 ธง และมีเพียงวันเสาร์วันเดียวที่เกิน นี่คือเหตุผลที่นโยบายใช้ภาระงานของวันยุ่งที่สุดแทนค่าเฉลี่ยรายวัน
recall ฝั่งมือถือกับขีดความสามารถไม่ทับซ้อนกันเลย ภาพโดยผู้เขียน
ตรวจสมรรถนะข้ามสองช่องทางการชำระเงิน
การฉ้อโกงฝั่งแอปมือถือมีสัญญาณอ่อน อยู่ต่ำในช่วงคะแนน การดึง threshold เดียวลงมา 0.108 เพื่อแอปมือถือจะพาออเดอร์เว็บไซต์ที่ถูกต้องเพิ่มเข้ามาด้วย และในวันเสาร์นั้นรวมแล้วเกินเพดาน
ตัวเลขโดยรวมซ่อนปัญหา: ที่ 0.118 recall โดยรวมประมาณ 87% ขณะที่แอปมือถือยังต่ำกว่าค่าขั้น หากนโยบายระบุเซกเมนต์ ให้วัดแต่ละเซกเมนต์ เพราะผลรวมอาจผ่านแต่บางเซกเมนต์ตก
Gemini 4 Carbon ตรวจจับข้อกำหนดการนำไปใช้งานที่ขัดแย้งกันได้หรือไม่?
ได้ ในการออดิตนี้ รายงานที่ตรึงไว้ระบุว่า not deployable ไม่มี threshold เดียวที่ใช้ได้ และระบุ R2 ฝั่งแอปมือถือกับ R3 เป็นความขัดแย้ง
ตรวจคำตัดสินการนำไปใช้งานของ Gemini 4 Carbon กับหลักฐาน
ทุกตัวเลขที่รายงานอ้างอิงตรงกับผลจากเครื่องมือ แต่มีประโยคหนึ่งอ้างมากกว่าสิ่งที่เอเจนต์วัด มันบอกว่าไม่มี threshold ใช้ได้ "ครอบคลุมทุกจุดกริดคะแนนเสี่ยง 0.001" ทั้งที่เอเจนต์ทดสอบเพียงราวสองโหลตามทรซข้างบน จากความเป็นไปได้ 1,002 ค่า
ข้ออ้างถือว่ายังถูกเพราะ recall และจำนวนธงรายวันต่างก็ลดลงเมื่อ threshold สูงขึ้น ซึ่งรายงานไม่ได้กล่าวไว้ ตรวจทุกข้ออ้างในรายงานของเอเจนต์กับสิ่งที่มันวัด และคู่มือ การประเมินเอเจนต์ AI ของเราครอบคลุมการตรวจทำนองนี้เพิ่มเติม
ยืนยันความขัดแย้งด้วยผู้ประเมิน Python แบบครอบคลุม
Gemini 4 Carbon เลือก threshold แบบสุ่มตัวอย่างแล้วอนุมานว่าไม่มีค่าใดใช้ได้ ผู้ประเมินพิสูจน์ผลนั้นสำหรับชุด validation นี้โดยตรวจทุกชุดของธงที่แตกต่างกัน โดยไม่แชร์โค้ดกับเครื่องมือ
คะแนนอยู่บนกริด 0.001 ดังนั้น cutoff ผู้สมัคร 1,002 ค่าจึงครอบคลุมทุกชุดธงที่เป็นไปได้ ผู้ประเมินตรวจทั้งหมด รวมทั้งทุกคู่ threshold ต่อช่องทาง โดยใช้หน่วยเซ็นต์จำนวนเต็มเพื่อให้ 85% และ 70% เป็นค่าที่แน่นอน
การตรวจครอบคลุมและสี่คอนฟิกที่ถูกปฏิเสธ ภาพโดยผู้เขียน
ไม่มี threshold แบบ global ใดผ่านทั้งสามกฎ ดังนั้นข้ออ้างของ Gemini 4 Carbon จึงมีหลักฐานรองรับ ผู้ประเมินสอดคล้องกับขอบ 0.108 และ 0.118 ที่เอเจนต์ไล่หา และพบคู่ threshold ต่อช่องทางนับพันที่ผ่านเพดาน 200 ต่อวัน
ผู้ประเมินจะมีประโยชน์ก็ต่อเมื่อปฏิเสธคำตอบที่ผิด จึงป้อนคอนฟิกที่ผิดสี่แบบ และมันปฏิเสธทั้งหมด
ทดสอบทางเลือกการนำไปใช้งานด้วย Gemini 4 Carbon
Gemini 4 Carbon ทดสอบทั้งการเปลี่ยนแปลงที่อนุญาต และเลือก threshold แยกตามช่องทางที่เพดานเดิมเหนือการเพิ่มผู้รีวิว พร้อมระบุว่าเป็นข้อยกเว้นที่ต้องได้รับอนุมัติจากบุคคล
ทดสอบการเพิ่มขีดความสามารถรีวิวด้วยมือ
threshold เดียวใช้ได้หากเพดานเพิ่มจาก 200 เป็น 205 และผู้ประเมินยืนยันว่า 205 คือการเพิ่มขั้นต่ำ Gemini 4 Carbon ยังจัดอันดับตัวเลือกนี้เป็นที่สอง เพราะกฎลำดับความชอบที่กล่าวไว้ก่อนหน้า
ทดสอบ threshold แยกสำหรับแต่ละช่องทางการชำระเงิน
ฝั่งช่องทาง เอเจนต์คง threshold ของแอปมือถือไว้ใกล้ขอบ (เคยเห็นว่า 0.109 ทำให้ต่ำกว่าค่าขั้น) และยก threshold ของเว็บไซต์ ลดธงบนออเดอร์เว็บไซต์ที่ถูกต้อง มันทดสอบเจ็ดคู่ และคู่หนึ่งตกแค่หนึ่งธงในวันยุ่งที่สุด จึงแนะนำ เว็บไซต์ 0.3 และ แอปมือถือ 0.1 เพราะคู่ดังกล่าวผ่านทุกกฎแบบมีระยะเผื่อ และผู้ประเมินยืนยันที่เพดานเดิม
เปรียบเทียบทางเลือกที่ยืนยันแล้ว
ตัวเลขเหล่านี้กล่าวถึงไปแล้ว และผู้ประเมินคำนวณซ้ำแต่ละค่า:
ตัวเลือก
Thresholds
โดยรวม
เว็บไซต์
แอปมือถือ
วันยุ่งที่สุด
การอนุมัติ
นโยบายเดิม
Global 0.108
87.5%
98.2%
70.1%
205, cap 200
ไม่ผ่าน
เพิ่มขีดความสามารถ
Global 0.108
87.5%
98.2%
70.1%
205, cap 205
ต้องอนุมัติ
แยกตามช่องทาง
Website 0.3, Mobile App 0.1
86.2%
94.5%
72.8%
191, cap 200
ต้องอนุมัติ
การแยกตามช่องทางยังติดธงน้อยกว่าตัวเลือกเพิ่มขีดความสามารถราว 6% อย่างไรก็ตามน้อยกว่าครึ่งของธงเป็นฉ้อโกงจริง ซึ่งรายงานระบุไว้เป็นประเด็นเปิด
วิธียืนยันคำแนะนำของ Gemini 4 Carbon บนข้อมูลที่ไม่เคยเห็น
ยืนยันคำแนะนำโดยนำไปใช้แบบตรึงบนชุด holdout ที่ผนึกไว้ ความต่างจากผู้ประเมินคือข้อมูล: ผู้ประเมินให้คะแนนสัปดาห์ที่เอเจนต์เห็น ส่วน holdout ให้คะแนนอีกสี่สัปดาห์ถัดมาที่ไม่มีเครื่องมือใดอ่านได้ การตรวจนี้รันครั้งเดียวต่อคำแนะนำที่ตรึงและจะไม่เริ่มหากรายงานเปลี่ยนหลังตรึง
คำแนะนำที่ตรึงผ่านบน holdout ภาพโดยผู้เขียน
มันผ่านทั้งสามกฎ และวันยุ่งที่สุดยังต่ำกว่าเพดาน แต่อย่าอ่านความหมายมากเกินไป ผลนี้ยังถ่อมตัวจากสามประเด็น:
holdout มาจากตัวสร้างข้อมูลตัวเดียวกัน จึงไม่บอกอะไรเกี่ยวกับรูปแบบฉ้อโกงแบบใหม่หรือ data drift recall โดยรวมผ่าน 85% ไปไม่ถึงสองจุดเปอร์เซ็นต์ คาดการณ์ที่ยังไม่ทดสอบ: การแยกอาจทำให้เกินเพดานได้หากทราฟฟิกแอปมือถือโตเร็วกว่าทราฟฟิกเว็บไซต์ เพราะ threshold ฝั่งแอปมือถือต่ำมาก
สองข้อแรกมาจากตัวเลข
ดูการออดิตเต็มใน Streamlit
ที่เก็บยังมีแอป Streamlit และความพยายามที่บันทึกไว้หกครั้ง เพื่อให้เปิดการออดิตนี้ได้โดยไม่ต้องเรียก API ในวิดีโอจะโหลดและไล่ดูทีละแท็บ


ในบทช่วยสอน Gemini 4 Argon API ของเรา เอเจนต์มีงานชัดเจน: หาโค้ดที่ช้า แก้ไข และผ่านการทดสอบที่ซ่อนอยู่ การทดลองชุดนี้ยังคงรูปแบบเดิมของเครื่องมือที่ควบคุมได้และการตรวจสอบจากภายนอก แต่เปลี่ยนการตัดสินใจ Gemini 4 Carbon ต้องพิจารณาว่ากฎเดิมสามารถปฏิบัติได้จริงหรือไม่
PayGuard ร้านค้าออนไลน์สมมติ มีโมเดลแมชชีนเลิร์นนิง (ML) ที่เทรนแล้วเพื่อให้คะแนนการสั่งซื้อสำหรับการทุจริต นโยบายการนำไปใช้งานกำหนดว่าโมเดลต้องจับมูลค่าการฉ้อโกงได้เพียงพอทั้งภาพรวมและในแต่ละช่องทางการขาย โดยไม่ทำให้ทีมรีวิวล้น เอเจนต์ต้องตรวจสอบกฎเหล่านั้นโดยไม่ได้รับบอกว่ามี threshold ที่ถูกต้องอยู่หรือไม่
Gemini 4 Carbon เป็นโมเดล reasoning ของ Google ที่เรียกใช้จาก Python ผ่าน Interactions API ที่นี่มันทำหน้าที่เป็นเอเจนต์ AI: เลือกการตรวจเช็คที่ต้องการ และ Python จะรันผ่านเครื่องมือแบบอ่านอย่างเดียวสามตัวด้วย function calling คำถามคือมันจะระบุความขัดแย้ง อธิบายหลักฐาน และแนะนำการเปลี่ยนแปลงที่อนุญาตได้หรือไม่ โดยไม่ถือว่าการเปลี่ยนแปลงนั้นได้รับอนุมัติแล้ว
จำเป็นต้องมีพื้นฐาน Python และประสบการณ์การเรียก API เล็กน้อย จะนิยามแต่ละเมตริกฉ้อโกงก่อนที่ตัวเลขจะถูกใช้งาน เราจะครอบคลุมวิธีการ:
หากต้องการเรื่องราวการเปิดตัวและคะแนน benchmark โปรดดูภาพรวม Gemini 4 Carbon และ Claude Fable 5.2 vs. Gemini 4 Carbon ที่เปรียบเทียบสองโมเดลนี้ การทดลองนี้รันในวันถัดมาหลัง Google เปิด API ให้ผู้พัฒนาแบบเสียเงิน
Gemini 4 Carbon API คืออะไร?
Gemini 4 Carbon API คือ API แบบเสียเงินสำหรับ
gemini-4-carbonซึ่งหน้ารายละเอียดโมเดล อธิบายว่าเป็นโมเดล reasoning สำหรับงานเอเจนต์แบบยาวหลายขั้นตอน อินพุต การคิด และเอาต์พุต ใช้ร่วมกันใน context window 1,048,576 โทเคน และการตอบแบบ synchronous จะหยุดที่ 65,536 โทเคนของการคิดรวมเอาต์พุตโดยค่าเริ่มต้นทำไมการออดิตโมเดล ML จึงเป็นบททดสอบที่ดีสำหรับ Gemini 4 Carbon
งานนี้ต้องการการตรวจหลายอย่าง การค้นหาการเปลี่ยนแปลงที่อนุญาต และการหยุดอย่างชัดเจนเมื่อกฎทำให้ไม่มีคำตอบ เลือกงานนี้เพราะ Python คำนวณผลอ้างอิงได้ model card ระบุว่าอาการเพ้อฝันเป็นหนึ่งในข้อจำกัดที่ทราบของ Gemini 4 Carbon ดังนั้นโมเดลจะสืบค้น ขณะที่ Python เป็นผู้ตัดสินว่าคำแนะนำใช้ได้หรือไม่
โปรเจกต์: ตัดสินว่าโมเดลตรวจฉ้อโกงของ PayGuard พร้อมใช้งานหรือไม่
PayGuard คือร้านสมมติจากเกริ่นนำ และโปรเจกต์เต็มอยู่ในที่เก็บ GitHub ตัวจัดหมวดหมู่ (classifier) เทรนไว้แล้ว
PayGuard ให้คะแนนธุรกรรมอย่างไร
แต่ละธุรกรรมมี timestamp แบบเวลาสากลเชิงพิกัด (UTC) จำนวนเงิน ช่องทาง (เว็บไซต์หรือแอปมือถือ) คะแนนความเสี่ยง และป้ายกำกับฉ้อโกง scikit-learn
HistGradientBoostingClassifierสร้างคะแนน ปัดเศษถึง 0.001 และ PayGuard จะติดธงธุรกรรมเมื่อrisk_score >= thresholdบทช่วยสอนprecision-recall curve ของเราแสดงว่าการขยับ threshold เปลี่ยนสิ่งที่ถูกติดธงอย่างไร และคอร์สFraud Detection in Python ครอบคลุมด้านการสร้างโมเดลข้อมูลสังเคราะห์ถูกแบ่งตามเวลา:
threshold ปัจจุบันคือ 0.5 และข้อมูลกับนโยบายไม่เปลี่ยนระหว่างการทดลอง การฉ้อโกงบนเว็บไซต์ทิ้งสัญญาณชัดเจนในข้อมูลนี้ ขณะที่การฉ้อโกงบนแอปมือถือส่วนใหญ่ดูเหมือนออเดอร์ปกติ
Gemini 4 Carbon เป็นผู้ขอ Python เป็นผู้ตัดสิน ภาพโดยผู้เขียน
3 กฎสำหรับการนำไปใช้งานของ PayGuard
นี่คือสามกฎจากเกริ่นนำ เขียนตามถ้อยคำในนโยบาย ทั้งหมดเป็นเป้าหมายสมมติที่เลือกมาสำหรับการทดลองนี้:
fraud-value recall คือมูลค่าการฉ้อโกงที่ถูกติดธงหารด้วยมูลค่าการฉ้อโกงทั้งหมด ต่างจาก recall ระดับธุรกรรมในคู่มือ precision กับ recall ของเรา การพลาดฉ้อโกง $2,000 สำคัญกว่าการพลาด $15 มาก และการติดธงไม่ได้หมายความว่าเงินถูกช่วยไว้ R3 จำกัดวันที่ยุ่งที่สุด และถ้อยคำนี้เองที่เป็นตัวชี้ขาดในการออดิต
เอเจนต์สามารถสืบค้นการเปลี่ยนแปลงสองอย่าง: เพิ่มขีดความสามารถรายวันได้สูงสุดถึง 260 พร้อม threshold เดียว หรือแยก threshold ต่อช่องทางที่เพดานเดิม ทั้งสองต้องได้รับอนุมัติจากมนุษย์ ห้ามรวมกัน และนโยบายให้ความสำคัญกับตัวเลือกที่ไม่ต้องเพิ่มผู้รีวิว
นิยามการออดิตที่ถูกต้อง
การออดิตที่ถูกต้องต้องตอบถูก 4 เรื่อง และควรกำหนดก่อนการร้องขอแรก:
ผู้ประเมินที่เอเจนต์เรียกไม่ได้จะคำนวณคำตอบ
วิธีตั้งค่า Gemini 4 Carbon API ใน Python
การตั้งค่า Gemini 4 Carbon API ต้องใช้ Python 3.11 ขึ้นไป และคีย์ API จากโปรเจกต์ Google AI Studio ที่เปิดการคิดเงิน เพราะหน้าราคา ไม่มีระดับใช้ฟรี
ติดตั้ง Google Gen AI SDK และเตรียมโปรเจกต์
ทดสอบโปรเจกต์นี้ด้วย Google Gen AI SDK ที่ปักเวอร์ชันไว้ที่
google-genai==3.1.0ซึ่งเป็น รีลีสวันเปิดตัวบน PyPI ที่เพิ่มgemini-4-carbonในรายชื่อโมเดลของ Interactions โคลนโปรเจกต์และติดตั้งใน virtual environment:จากนั้นรันสองคำสั่งบนหน้าที่เก็บเพื่อสร้างข้อมูลและ fit ตัวจัดหมวดหมู่ด้วย seed ที่ตรึงไว้ บนโคลนใหม่จะแสดงผลดังนี้:
การตรึง seed ทำให้สร้างชุดข้อมูลเดียวกันซ้ำได้ ภาพโดยผู้เขียน
จากนั้นใส่
GEMINI_API_KEY=your-keyลงในไฟล์.envที่เก็บจะโหลดโดยไม่พิมพ์ค่าออกมาส่งคำร้อง Gemini 4 Carbon API ครั้งแรก
รันตัวอย่างสมบูรณ์นี้จากโฟลเดอร์โปรเจกต์ มันจะให้ Gemini 4 Carbon อ่านนโยบายและสรุปตัวจัดหมวดหมู่ และถามว่าต้องวัดอะไรบ้าง โดยไม่ใบ้ถึงความขัดแย้ง:
ระดับการคิดกำหนดผ่าน
generation_configและoutput_textเก็บคำตอบ ตัวอย่างส่วนหนึ่งที่ได้กลับมาคือ:มันอ่าน R3 เป็นค่าสูงสุดรายวัน และวางแผนลำดับความชอบของนโยบายก่อนเห็นตัวเลข มันไม่ถามเลยว่าผลเสมอหรือการปัดเศษคะแนนทำงานอย่างไร ทั้งที่การตรวจแบบครอบคลุมที่จะอธิบายต่อไปขึ้นอยู่กับจุดนี้ คำเรียกครั้งนี้ใช้เวลาประมาณ 40 วินาที และมีค่าใช้จ่ายราว 2 เซนต์
เว้น
temperature,top_pและtop_kไว้ เพราะ Gemini 4 Carbon ไม่สนใจ รวมถึงthinking_budgetด้วยวิธีสร้างเอเจนต์ออดิต ML ด้วย Gemini 4 Carbon Function Calling
เอเจนต์ออดิตของ Gemini 4 Carbon เป็นลูป: โมเดลร้องขอการประเมิน Python ตรวจสอบและรัน แล้วส่งผลกลับไปจนกว่าโมเดลจะหยุดขอ
กำหนดเครื่องมืออ่านอย่างเดียวสำหรับการประเมินโมเดล
เอเจนต์ได้เครื่องมือสามตัว ทั้งหมดจำกัดเฉพาะหน้าต่าง validation:
get_audit_context: สรุปตัวจัดหมวดหมู่ ค่าคอนฟิกปัจจุบัน นโยบาย และการเปลี่ยนแปลงที่อนุญาตevaluate_global_threshold: fraud-value recall โดยรวมและแยกตามช่องทาง จำนวนที่ติดธงต่อวัน และตัวช่วยวินิจฉัยสำหรับ threshold หนึ่งค่าevaluate_policy_change: การวัดเดียวกันสำหรับการเพิ่มขีดความสามารถหรือคู่ threshold ต่อช่องทางสคีมาแบบเต็มอยู่ในที่เก็บ โค้ดย่อยที่เรียบง่ายนี้ละช่อง threshold และขีดความสามารถ จึงไม่ใช่ประกาศที่คัดลอกได้ครบ มันแสดงขอบเขตสำคัญที่นี่: เครื่องมือรับเฉพาะการเปลี่ยนแปลงนโยบายสองแบบที่ PayGuard อนุญาต อ่านข้อมูล validation และไม่อนุมัติอะไรทั้งนั้น
Python จะตรวจสอบความถูกต้องของฟิลด์ threshold และขีดความสามารถที่ละไว้ ปฏิเสธการเปลี่ยนแปลงนอกนโยบาย และส่งกลับเป็นตัวชี้วัดแทนธง pass/fail เอเจนต์ไม่สามารถเข้าถึง holdout เรียกผู้ประเมิน หรือเปลี่ยนนโยบาย อธิบายในคำถามที่พบบ่อยว่าทำไมไม่ใช้ความสามารถรันโค้ดในตัวของ Gemini 4 Carbon
กำหนดวัตถุประสงค์และกติกาการหยุดที่ชัดเจนให้เอเจนต์
system instruction กำหนดวิธีการ เช่นเดียวกับคำร้องแรก มันไม่ใบ้ตำแหน่งความขัดแย้ง:
พรอมป์ตทำได้แค่ขอ ดังนั้นข้อจำกัดจึงอยู่ใน agent harness โค้ด Python ที่ครอบโมเดลไว้ เนื่องจาก API ไม่มีการตั้งงบประมาณ แอปพลิเคชันจึงตั้งตามครั้ง: 25 เทิร์น เครื่องมือ 60 ครั้ง 30 นาที และ $3 โดยตรวจสอบค่าใช้จ่ายระหว่างเทิร์น
ติดตั้งลูป function calling ด้วย Interactions API
แต่ละเทิร์นคือการเรียก
client.interactions.create()หนึ่งครั้ง Gemini 4 Carbon มักขอหลายเครื่องมือพร้อมกัน จึงวนลูปที่ทุกขั้นfunction_callนี่คือแก่นของลูป และเวอร์ชันในที่เก็บเพิ่มการล็อกและตรวจข้อจำกัด:เก็บการตั้งค่าเหล่านี้ไว้ในดิกชันนารี
requestเดียวเพื่อให้ทุกคำร้องถัดไปส่งซ้ำprevious_interaction_idพาประวัติไปด้วย แต่tools,system_instructionและgeneration_configมีผลต่อ interaction เพียงครั้งเดียว หากเทิร์นจบแบบincompleteแสดงว่าmax_output_tokensตัดคำตอบ และยังคงคิดค่าการคิดโทเคนส่งรายงานออดิตแบบมีโครงสร้างด้วย JSON schema
คู่มือstructured output ของ Google ระบุว่าเครื่องมือรวมกับ JSON schema ในคำร้องเดียวเป็นฟีเจอร์ Preview ที่รองรับ Gemini 4 Carbon อย่างไรก็ตามในที่นี้แยกกัน: เทิร์นการสืบค้นทำแค่การวัด และเทิร์นสุดท้ายบนประวัติและคอนฟิกเดียวกันจะเขียนรายงานด้วย schema และไม่มีเครื่องมือ:
AuditReportเป็นโมเดล Pydantic ที่มีคำตัดสิน ความขัดแย้ง หลักฐาน คำแนะนำ และการอนุมัติ Python วัดเวลาและต้นทุนแทนที่จะขอให้ Gemini 4 Carbon รายงานรันการออดิต Gemini 4 Carbon บนโมเดลตรวจจับการฉ้อโกง
Gemini 4 Carbon ออดิตโมเดลเหมือนที่คาดหวังจากนักวิเคราะห์จูเนียร์ ทำการวัดก่อนสรุปผล ครั้งแรกที่
mediumมันอ่านบริบทการออดิต ตรวจประมาณสองโหลของ threshold เดี่ยว และทดสอบการเปลี่ยนนโยบายแปดแบบการเรียกใช้เครื่องมือทั้ง 32 ครั้งตามลำดับ ภาพโดยผู้เขียน
ประเมิน threshold ปัจจุบันของ PayGuard
เอเจนต์ประเมิน threshold ปัจจุบันที่ 0.5 พบ recall เว็บไซต์ 91% แอปมือถือ 20% โดยรวม 64% และวันยุ่งที่สุด 85 ธง ซึ่งไม่ผ่าน R1 และครึ่งของ R2 ฝั่งแอปมือถือโดยยังเหลือพื้นที่ใต้ R3 ดังนั้นการลด threshold จึงเป็นทางเลือกชัดเจน
ทดสอบ fraud-value recall เทียบกับขีดความสามารถรีวิวรายวัน
การลด threshold จะจับมูลค่าฉ้อโกงได้มากขึ้นและส่งออเดอร์ไปรีวิวมากขึ้น PayGuard ต้องได้พอสำหรับอย่างแรก ขณะรักษาอย่างหลังให้อยู่ใต้เพดานรายวัน
เอเจนต์ลอง threshold แบบหยาบหลายค่าพร้อมกัน แล้วค่อยแคบลงเป็นจุดบนกริดเดียว การเรียกครั้งที่ 11, 12, 17 และ 18 ในทรซยืนยันผลนี้
ในหน้าต่าง validation นี้ ฝั่งแอปมือถือจำเป็นต้องใช้ 0.108 หรือต่ำกว่า เพราะเพิ่มขึ้นหนึ่งขั้นจะต่ำกว่า 70% เล็กน้อย ขณะที่เพดานต้องใช้ 0.118 หรือสูงกว่า ไม่มี threshold ใดทำได้ทั้งสองอย่าง
recall โดยรวมยังผ่านถึง 0.137 ดังนั้น R1 ไม่อยู่ในความขัดแย้ง ที่ 0.108 วันเฉลี่ยมีราว 169 ธง และมีเพียงวันเสาร์วันเดียวที่เกิน นี่คือเหตุผลที่นโยบายใช้ภาระงานของวันยุ่งที่สุดแทนค่าเฉลี่ยรายวัน
recall ฝั่งมือถือกับขีดความสามารถไม่ทับซ้อนกันเลย ภาพโดยผู้เขียน
ตรวจสมรรถนะข้ามสองช่องทางการชำระเงิน
การฉ้อโกงฝั่งแอปมือถือมีสัญญาณอ่อน อยู่ต่ำในช่วงคะแนน การดึง threshold เดียวลงมา 0.108 เพื่อแอปมือถือจะพาออเดอร์เว็บไซต์ที่ถูกต้องเพิ่มเข้ามาด้วย และในวันเสาร์นั้นรวมแล้วเกินเพดาน
ตัวเลขโดยรวมซ่อนปัญหา: ที่ 0.118 recall โดยรวมประมาณ 87% ขณะที่แอปมือถือยังต่ำกว่าค่าขั้น หากนโยบายระบุเซกเมนต์ ให้วัดแต่ละเซกเมนต์ เพราะผลรวมอาจผ่านแต่บางเซกเมนต์ตก
Gemini 4 Carbon ตรวจจับข้อกำหนดการนำไปใช้งานที่ขัดแย้งกันได้หรือไม่?
ได้ ในการออดิตนี้ รายงานที่ตรึงไว้ระบุว่า
not deployableไม่มี threshold เดียวที่ใช้ได้ และระบุ R2 ฝั่งแอปมือถือกับ R3 เป็นความขัดแย้งตรวจคำตัดสินการนำไปใช้งานของ Gemini 4 Carbon กับหลักฐาน
ทุกตัวเลขที่รายงานอ้างอิงตรงกับผลจากเครื่องมือ แต่มีประโยคหนึ่งอ้างมากกว่าสิ่งที่เอเจนต์วัด มันบอกว่าไม่มี threshold ใช้ได้ "ครอบคลุมทุกจุดกริดคะแนนเสี่ยง 0.001" ทั้งที่เอเจนต์ทดสอบเพียงราวสองโหลตามทรซข้างบน จากความเป็นไปได้ 1,002 ค่า
ข้ออ้างถือว่ายังถูกเพราะ recall และจำนวนธงรายวันต่างก็ลดลงเมื่อ threshold สูงขึ้น ซึ่งรายงานไม่ได้กล่าวไว้ ตรวจทุกข้ออ้างในรายงานของเอเจนต์กับสิ่งที่มันวัด และคู่มือการประเมินเอเจนต์ AI ของเราครอบคลุมการตรวจทำนองนี้เพิ่มเติม
ยืนยันความขัดแย้งด้วยผู้ประเมิน Python แบบครอบคลุม
Gemini 4 Carbon เลือก threshold แบบสุ่มตัวอย่างแล้วอนุมานว่าไม่มีค่าใดใช้ได้ ผู้ประเมินพิสูจน์ผลนั้นสำหรับชุด validation นี้โดยตรวจทุกชุดของธงที่แตกต่างกัน โดยไม่แชร์โค้ดกับเครื่องมือ
คะแนนอยู่บนกริด 0.001 ดังนั้น cutoff ผู้สมัคร 1,002 ค่าจึงครอบคลุมทุกชุดธงที่เป็นไปได้ ผู้ประเมินตรวจทั้งหมด รวมทั้งทุกคู่ threshold ต่อช่องทาง โดยใช้หน่วยเซ็นต์จำนวนเต็มเพื่อให้ 85% และ 70% เป็นค่าที่แน่นอน
การตรวจครอบคลุมและสี่คอนฟิกที่ถูกปฏิเสธ ภาพโดยผู้เขียน
ไม่มี threshold แบบ global ใดผ่านทั้งสามกฎ ดังนั้นข้ออ้างของ Gemini 4 Carbon จึงมีหลักฐานรองรับ ผู้ประเมินสอดคล้องกับขอบ 0.108 และ 0.118 ที่เอเจนต์ไล่หา และพบคู่ threshold ต่อช่องทางนับพันที่ผ่านเพดาน 200 ต่อวัน
ผู้ประเมินจะมีประโยชน์ก็ต่อเมื่อปฏิเสธคำตอบที่ผิด จึงป้อนคอนฟิกที่ผิดสี่แบบ และมันปฏิเสธทั้งหมด
ทดสอบทางเลือกการนำไปใช้งานด้วย Gemini 4 Carbon
Gemini 4 Carbon ทดสอบทั้งการเปลี่ยนแปลงที่อนุญาต และเลือก threshold แยกตามช่องทางที่เพดานเดิมเหนือการเพิ่มผู้รีวิว พร้อมระบุว่าเป็นข้อยกเว้นที่ต้องได้รับอนุมัติจากบุคคล
ทดสอบการเพิ่มขีดความสามารถรีวิวด้วยมือ
threshold เดียวใช้ได้หากเพดานเพิ่มจาก 200 เป็น 205 และผู้ประเมินยืนยันว่า 205 คือการเพิ่มขั้นต่ำ Gemini 4 Carbon ยังจัดอันดับตัวเลือกนี้เป็นที่สอง เพราะกฎลำดับความชอบที่กล่าวไว้ก่อนหน้า
ทดสอบ threshold แยกสำหรับแต่ละช่องทางการชำระเงิน
ฝั่งช่องทาง เอเจนต์คง threshold ของแอปมือถือไว้ใกล้ขอบ (เคยเห็นว่า 0.109 ทำให้ต่ำกว่าค่าขั้น) และยก threshold ของเว็บไซต์ ลดธงบนออเดอร์เว็บไซต์ที่ถูกต้อง มันทดสอบเจ็ดคู่ และคู่หนึ่งตกแค่หนึ่งธงในวันยุ่งที่สุด จึงแนะนำ เว็บไซต์ 0.3 และ แอปมือถือ 0.1 เพราะคู่ดังกล่าวผ่านทุกกฎแบบมีระยะเผื่อ และผู้ประเมินยืนยันที่เพดานเดิม
เปรียบเทียบทางเลือกที่ยืนยันแล้ว
ตัวเลขเหล่านี้กล่าวถึงไปแล้ว และผู้ประเมินคำนวณซ้ำแต่ละค่า:
ตัวเลือก
Thresholds
โดยรวม
เว็บไซต์
แอปมือถือ
วันยุ่งที่สุด
การอนุมัติ
นโยบายเดิม
Global 0.108
87.5%
98.2%
70.1%
205, cap 200
ไม่ผ่าน
เพิ่มขีดความสามารถ
Global 0.108
87.5%
98.2%
70.1%
205, cap 205
ต้องอนุมัติ
แยกตามช่องทาง
Website 0.3, Mobile App 0.1
86.2%
94.5%
72.8%
191, cap 200
ต้องอนุมัติ
การแยกตามช่องทางยังติดธงน้อยกว่าตัวเลือกเพิ่มขีดความสามารถราว 6% อย่างไรก็ตามน้อยกว่าครึ่งของธงเป็นฉ้อโกงจริง ซึ่งรายงานระบุไว้เป็นประเด็นเปิด
วิธียืนยันคำแนะนำของ Gemini 4 Carbon บนข้อมูลที่ไม่เคยเห็น
ยืนยันคำแนะนำโดยนำไปใช้แบบตรึงบนชุด holdout ที่ผนึกไว้ ความต่างจากผู้ประเมินคือข้อมูล: ผู้ประเมินให้คะแนนสัปดาห์ที่เอเจนต์เห็น ส่วน holdout ให้คะแนนอีกสี่สัปดาห์ถัดมาที่ไม่มีเครื่องมือใดอ่านได้ การตรวจนี้รันครั้งเดียวต่อคำแนะนำที่ตรึงและจะไม่เริ่มหากรายงานเปลี่ยนหลังตรึง
คำแนะนำที่ตรึงผ่านบน holdout ภาพโดยผู้เขียน
มันผ่านทั้งสามกฎ และวันยุ่งที่สุดยังต่ำกว่าเพดาน แต่อย่าอ่านความหมายมากเกินไป ผลนี้ยังถ่อมตัวจากสามประเด็น:
สองข้อแรกมาจากตัวเลข
ดูการออดิตเต็มใน Streamlit
ที่เก็บยังมีแอป Streamlit และความพยายามที่บันทึกไว้หกครั้ง เพื่อให้เปิดการออดิตนี้ได้โดยไม่ต้องเรียก API ในวิดีโอจะโหลดและไล่ดูทีละแท็บ