Tutorial API Gemini 4 Carbon: Construiește un agent care auditează un model de fraudă
Învață API-ul Gemini 4 Carbon în Python: construiește un agent cu function calling care auditează un model de fraudă, găsește reguli în conflict și testează o schimbare de politică.
În tutorialul despre API-ul Gemini 4 Argon, agentul avea o sarcină clară: să găsească cod lent, să-l schimbe și să treacă teste ascunse. Acest experiment complementar păstrează același tipar de unelte controlate și o verificare externă, dar schimbă decizia. Gemini 4 Carbon trebuie să stabilească dacă regulile originale pot fi îndeplinite măcar.
PayGuard, un magazin online fictiv, are un model de machine learning (ML) antrenat care punctează comenzile pentru fraudă. Politica de punere în producție cere ca modelul să captureze suficientă valoare de fraudă per total și pe fiecare canal de vânzare, fără să copleșească echipa de review. Agentul trebuie să investigheze acele reguli fără să i se spună dacă există sau nu un prag valid.
Gemini 4 Carbon este un model de raționare de la Google pe care îl apelezi din Python prin Interactions API. Aici, acționează ca un agent AI: alege ce verificări să ceară, iar Python le rulează prin trei unelte doar-citire folosind function calling. Întrebarea mea este dacă poate identifica conflictul, poate explica dovezile și poate recomanda o schimbare permisă fără a trata acea schimbare ca aprobată.
Ai nevoie de baze de Python și puțină experiență cu cereri API. Definim fiecare metrică de fraudă înainte ca numerele să o folosească. Vom acoperi cum să:
Trimiți o primă cerere către Gemini 4 Carbon din Python
Oferi modelului unelte doar-citire și le rulezi într-o buclă cu limite
Primești verdictul înapoi ca JSON pe care codul tău îl poate verifica
Verifici acel verdict cu cod și date pe care modelul nu le vede niciodată
Compari două niveluri de gândire, care controlează cât de mult raționează modelul înainte de a răspunde
Dacă vrei povestea lansării și scorurile de benchmark, prezentarea Gemini 4 Carbon le are, iar Claude Fable 5.2 vs. Gemini 4 Carbon compară cele două modele. Am rulat acest experiment în ziua de după ce Google a deschis API-ul pentru dezvoltatori plătitori.
Ce este API-ul Gemini 4 Carbon?
API-ul Gemini 4 Carbon este interfața de programare cu aplicații (API) plătită pentru gemini-4-carbon, pe care pagina modelului îl descrie ca un model de raționare pentru sarcini lungi, multi-pas ale agenților. Inputul, gândirea și outputul împart o fereastră de context de 1.048.576 de tokeni, iar un răspuns sincron se oprește implicit la 65.536 de tokeni de gândire plus output.
De ce un audit al unui model ML este un test bun pentru Gemini 4 Carbon
Sarcina cere mai multe verificări, o căutare prin schimbările permise și o oprire clară atunci când regulile nu lasă niciun răspuns. Am ales-o pentru că Python poate calcula rezultatul de referință. Fișa modelului listează halucinațiile printre limitele cunoscute ale Gemini 4 Carbon, așa că modelul investighează, iar Python decide dacă recomandarea lui se susține.
Proiectul: Decizia dacă modelul de fraudă al PayGuard poate intra în producție
PayGuard este magazinul fictiv din introducere, iar proiectul complet se află în repository-ul GitHub. Clasificatorul este deja antrenat.
Cum punctează PayGuard tranzacțiile
Fiecare tranzacție are un timestamp în Timpul Universal Coordonat (UTC), un cuantum, un canal (Website sau Mobile App), un scor de risc și o etichetă de fraudă. Un scikit-learn HistGradientBoostingClassifier produce scorul, rotunjit la 0,001, iar PayGuard marchează o tranzacție când risk_score >= threshold. Tutorialul despre curba precision-recall arată cum mutarea unui prag schimbă ce este marcat, iar cursul nostru Fraud Detection in Python acoperă partea de modelare.
Datele sintetice sunt împărțite în timp:
Training: primele nouă săptămâni, folosite doar pentru a potrivi clasificatorul
Validare: următoarele patru săptămâni, singura fereastră pe care uneltele o pot citi
Holdout: cele patru săptămâni de după aceea, sigilate până când recomandarea este înghețată
Pragul curent este 0,5, iar datele și politica nu se schimbă în timpul experimentului. Frauda pe Website lasă semnale clare în aceste date, în timp ce majoritatea fraudei pe Mobile App arată ca o comandă obișnuită.
Gemini 4 Carbon întreabă, Python decide. Imagine de autor.
Trei reguli de deploy ale PayGuard
Iată cele trei reguli din introducere, scrise așa cum le formulează politica. Toate sunt ținte fictive alese pentru acest experiment:
R1: tranzacțiile marcate acoperă cel puțin 85% din valoarea fraudei etichetate per total
R2: acoperă cel puțin 70% din valoarea fraudei etichetate în fiecare canal
R3: nu mai mult de 200 de tranzacții sunt marcate într-o singură zi UTC
Recall-ul valorii fraudei este valoarea fraudei marcate împărțită la valoarea totală a fraudei. Spre deosebire de recall-ul la nivel de tranzacție din ghidul nostru precision versus recall, o fraudă ratată de 2.000 $ contează mult mai mult decât una de 15 $, iar marcarea nu înseamnă că banii au fost salvați. R3 limitează cea mai aglomerată zi, iar acea formulare ajunge să decidă auditul.
Agentul poate investiga două schimbări: o capacitate zilnică de până la 260 cu un singur prag sau praguri separate pe canale la plafonul original. Ambele au nevoie de aprobare umană, nu pot fi combinate, iar politica preferă opțiunea fără recenzenți suplimentari.
Ce înseamnă un audit corect
Un audit corect bifează patru lucruri, iar tu ar trebui să le decizi înainte de prima cerere:
Verdictul: dacă vreun prag unic îndeplinește R1, R2 și R3 pe validare
Conflictul: ce cerințe fac imposibilă politica originală
Alternativa: o schimbare permisă care trece fiecare regulă când Python o recalculează
Preferința: recomandarea urmează ordinea de preferință a politicii
Un evaluator la care agentul nu are acces calculează răspunsul.
Cum să configurezi API-ul Gemini 4 Carbon în Python
Configurarea API-ului Gemini 4 Carbon necesită Python 3.11 sau mai nou și o cheie API dintr-un proiect Google AI Studio cu billing activ, deoarece pagina de prețuri nu oferă un nivel gratuit.
Instalează SDK-ul Google Gen AI și pregătește proiectul
Am testat acest proiect cu SDK-ul Google Gen AI blocat la google-genai==3.1.0, versiunea de pe PyPI din ziua lansării care a adăugat gemini-4-carbon în lista de modele Interactions. Clonează proiectul și instalează-l într-un mediu virtual:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS or Linux: source .venv/bin/activate
pip install-r requirements.txtFuncționează cu
După aceea, rulează cele două comenzi de pe pagina repository-ului care construiesc datele și potrivesc clasificatorul cu seed-uri fixe. Pe un clone proaspăt, acestea vor afișa:
Seed-urile fixe reconstruiesc același set de date. Imagine de autor.
Apoi pune GEMINI_API_KEY=your-key într-un fișier .env. Repository-ul îl încarcă fără să îl afișeze.
Fă prima ta cerere către API-ul Gemini 4 Carbon
Rulează acest exemplu complet din folderul proiectului. Îi oferă lui Gemini 4 Carbon politica și sumarul clasificatorului și îl întreabă de ce măsurători ar avea nevoie, fără a sugera un conflict:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Funcționează cu
Nivelul de gândire intră în generation_config, iar output_text conține răspunsul. Iată o parte din ce a venit înapoi:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Funcționează cu
A interpretat R3 ca un vârf și a planificat ordinea de preferință a politicii înainte de a vedea vreun număr. Nu a întrebat niciodată cum se tratează egalitățile sau rotunjirea scorurilor, iar verificarea exhaustivă pe care o voi arăta mai târziu depinde exact de asta. Apelul a durat aproximativ 40 de secunde și a costat cam 2 cenți.
Omite temperature, top_p și top_k, pe care Gemini 4 Carbon le ignoră, și thinking_budget.
Cum să construiești un agent de audit ML cu function calling în Gemini 4 Carbon
Un agent de audit Gemini 4 Carbon este o buclă: modelul cere o evaluare, Python o validează și o rulează, iar rezultatul se întoarce până când modelul încetează să mai ceară.
Definește unelte doar-citire pentru evaluarea modelului
Agentul primește trei unelte. Toate sunt limitate la fereastra de validare:
get_audit_context: sumarul clasificatorului, configurația curentă, politica și schimbările permise
evaluate_global_threshold: recall-ul valorii fraudei per total și pe canal, marcări pe zi și diagnostice pentru un prag
evaluate_policy_change: aceleași măsurători pentru o creștere de capacitate sau o pereche de praguri pe canale
Schemele complete sunt în repository. Acest extras simplificat omite câmpurile de prag și capacitate, deci nu este o declarație completă de copiat. Arată doar granița care contează aici: unealta acceptă cele două schimbări de politică permise de PayGuard, citește date de validare și nu aprobă nimic.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Funcționează cu
Python validează câmpurile de prag și capacitate omise, respinge schimbările în afara politicii și returnează măsurători în loc de steaguri de trecere sau eșec. Agentul nu poate accesa holdout-ul, nu poate apela evaluatorul și nu poate schimba politica. Explic în FAQ de ce am sărit peste execuția de cod integrată a lui Gemini 4 Carbon.
Oferă agentului un obiectiv clar și reguli de oprire
Instrucțiunea de sistem stabilește metoda. Ca și prima cerere, nu sugerează unde este conflictul:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.Funcționează cu
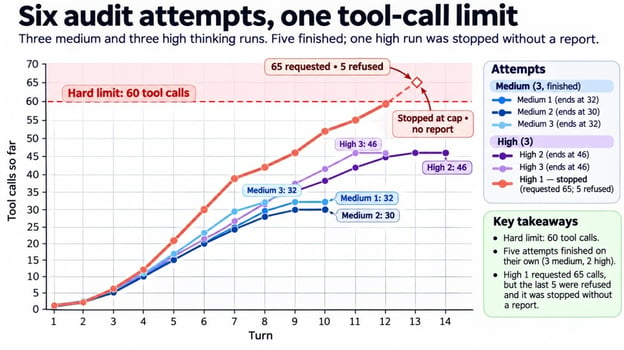
Promptul poate doar să ceară, așa că limitele trăiesc în harnasamentul agentului, codul Python din jurul modelului. Deoarece API-ul nu are setare de buget, aplicația le stabilește per încercare: 25 de ture, 60 de apeluri de unelte, 30 de minute și 3 $, cu cheltuiala verificată între ture.
Implementează bucla de function calling cu Interactions API
Fiecare tură este un apel client.interactions.create(). Gemini 4 Carbon cere adesea mai multe unelte deodată, așa că bucla rulează la fiecare pas function_call. Aceasta este bucla de bază, iar versiunea din repository adaugă logging și verificări de limite:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Funcționează cu
Păstrez aceste setări într-un dict request astfel încât fiecare apel ulterior să le retrimită. previous_interaction_id poartă istoricul, dar tools, system_instruction și generation_config se aplică doar unei interacțiuni. Dacă o tură se termină incomplete, max_output_tokens a tăiat-o, și tot plătești pentru tokenii de gândire.
Returnează un raport de audit structurat cu o schemă JSON
Ghidul Google pentru output structurat listează unelte plus o schemă JSON într-o singură cerere ca o funcționalitate Preview care include Gemini 4 Carbon. Eu le-am păstrat separate: turele de investigație doar măsoară, iar o tură finală pe același istoric și config scrie raportul cu o schemă și fără unelte:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Funcționează cu
AuditReport este un model Pydantic cu verdictul, conflictul, dovezile, recomandarea și aprobările. Python măsoară timpul și costul în loc să ceară lui Gemini 4 Carbon să le raporteze.
Rulează auditul Gemini 4 Carbon pe modelul de detecție a fraudei
Gemini 4 Carbon a auditat modelul așa cum mi-aș dori să o facă un analist junior: cu măsurători înainte de orice concluzie. La prima încercare pe medium, a citit contextul auditului, a verificat vreo două duzini de praguri unice și a testat opt schimbări de politică.
Toate cele 32 de apeluri de unelte, în ordine. Imagine de autor.
Evaluează pragul curent al PayGuard
Agentul a evaluat pragul curent de 0,5 și a găsit 91% recall pe Website, 20% pe Mobile App, 64% recall total și 85 de marcări în cea mai aglomerată zi. Asta eșuează la R1 și la jumătatea Mobile App a lui R2, cu spațiu sub R3, așa că mișcarea evidentă este un prag mai jos.
Testează recall-ul valorii fraudei vs. capacitatea zilnică de review
Scăderea unui prag prinde mai multă valoare de fraudă și trimite mai multe comenzi la review. PayGuard are nevoie de destul din prima, menținând în același timp a doua sub un plafon zilnic.
Agentul a încercat câteva praguri grosiere într-un lot, apoi a restrâns la puncte unice din grilă. Apelurile 11, 12, 17 și 18 din trasă au tranșat situația.
Pe această fereastră de validare, pragul minim pentru Mobile App are nevoie de 0,108 sau mai jos, deoarece un pas mai sus îl coboară chiar sub 70%. Plafonul cere 0,118 sau mai sus. Niciun prag nu le face pe ambele.
Recall-ul total se menține până la 0,137, deci R1 rămâne în afara conflictului. La 0,108, ziua medie are cam 169 de marcări, și doar un sâmbătă trece peste. De aceea politica folosește volumul celei mai aglomerate zile, nu media zilnică.
Recall-ul pe mobil și capacitatea nu se intersectează. Imagine de autor.
Verifică performanța pe ambele canale de plată
Frauda pe Mobile App, cu semnale mai slabe, stă jos în intervalul de scor. Tragerea unui singur prag până la 0,108 pentru Mobile App aduce și mai multe comenzi legitime de pe Website, iar în acel sâmbătă împing totalul peste plafon.
Numărul total o ascunde: la 0,118, recall-ul total este cam 87%, în timp ce Mobile App stă sub podeaua lui. Dacă politica ta numește segmente, măsoară fiecare în parte, pentru că totalul poate trece în timp ce un segment eșuează.
Poate Gemini 4 Carbon detecta cerințe de deploy aflate în conflict?
Da, în acest audit. Raportul înghețat spune not deployable, spune că niciun prag unic nu funcționează și numește R2 pentru Mobile App și R3 drept conflict.
Verifică verdictul de deploy al Gemini 4 Carbon față de dovezile lui
Fiecare număr citat în raport se potrivește cu un rezultat de unealtă, dar o propoziție afirmă mai mult decât a măsurat agentul. Spune că niciun prag nu funcționează „pe toate punctele grilei de scor de risc de 0,001”, totuși agentul a testat doar cele două duzini din trasă, din 1.002 praguri posibile.
Afirmația se susține pentru că recall-ul și numărul zilnic scad ambele pe măsură ce pragul crește, lucru pe care raportul nu îl spune. Verifică fiecare afirmație dintr-un raport de agent față de ce a măsurat, iar ghidul nostru despre evaluarea agenților AI acoperă mai multe astfel de verificări.
Verifică conflictul cu un evaluator Python exhaustiv
Gemini 4 Carbon a eșantionat praguri și a dedus că niciunul nu ar putea funcționa. Evaluatorul dovedește acel rezultat pentru acest set de validare verificând fiecare set distinct de marcări, fără a partaja cod cu uneltele.
Scorurile stau pe o grilă de 0,001, deci cele 1.002 cutoff-uri candidate acoperă fiecare set posibil de marcări. Evaluatorul le verifică pe toate, plus fiecare pereche de praguri pe canale, folosind cenți întregi astfel încât 85% și 70% să fie exacte.
Verificare exhaustivă și patru configurații respinse. Imagine de autor.
Niciun prag global nu trece toate cele trei reguli, astfel că afirmația lui Gemini 4 Carbon are acum dovadă în spate. Evaluatorul a potrivit limitele 0,108 și 0,118 din testarea agentului și a găsit mii de perechi pe canale care trec la 200 pe zi.
Un evaluator ajută doar dacă respinge răspunsuri greșite, așa că i-am dat patru configurații eronate și le-a respins pe toate.
Testează alternativele de deploy cu Gemini 4 Carbon
Gemini 4 Carbon a testat ambele schimbări permise și a ales praguri separate la plafonul original în locul recenzenților suplimentari. A marcat acea alegere ca o excepție ce trebuie aprobată de o persoană.
Testează o creștere a capacității de review manual
Un singur prag global funcționează dacă plafonul crește de la 200 la 205, iar evaluatorul a confirmat 205 ca fiind cea mai mică creștere. Gemini 4 Carbon tot a clasat această opțiune pe locul doi, din cauza regulii de preferință descrise mai devreme.
Testează praguri separate pentru fiecare canal de plată
Pe partea de canale, agentul a ținut pragul Mobile App aproape de limita lui (văzuse deja că 0,109 cade sub podea) și a ridicat pragul Website, scăzând marcările pe comenzi legitime de pe Website. A testat șapte perechi, iar una a eșuat la diferență de o singură marcare în cea mai aglomerată zi. A recomandat Website 0,3 și Mobile App 0,1 pentru că acea pereche trece toate regulile cu marjă, iar evaluatorul a confirmat-o la plafonul original.
Compară alternativele verificate
Aceste numere au apărut mai sus, iar evaluatorul le-a recalcultat pe fiecare:
Opțiune
Praguri
Total
Website
Mobile App
Cea mai aglomerată zi
Aprobare
Politica originală
Global 0,108
87,5%
98,2%
70,1%
205, plafon 200
Eșuează
Mai multă capacitate
Global 0,108
87,5%
98,2%
70,1%
205, plafon 205
Necesară
Split pe canale
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, plafon 200
Necesară
Splitul pe canale marchează și cu aproximativ 6% mai puține tranzacții decât opțiunea de capacitate. Totuși, mai puțin de jumătate din marcările lui sunt fraudă, lucru notat în raport ca problemă deschisă.
Cum să verifici recomandarea Gemini 4 Carbon pe date nevăzute
Verifici recomandarea aplicând-o, înghețată, pe holdout-ul sigilat. Diferența față de evaluator este în date: evaluatorul a punctat săptămâni pe care agentul le putea vedea, iar holdout-ul punctează patru săptămâni ulterioare pe care nicio unealtă nu le-a putut citi. Verificarea rulează o dată per recomandare înghețată și nu pornește dacă raportul s-a schimbat după înghețare.
Recomandarea înghețată trece pe holdout. Imagine de autor.
A trecut toate cele trei reguli, iar cea mai aglomerată zi a rămas sub plafon. Totuși, nu trage concluzii prea mari. Trei lucruri păstrează acest rezultat modest:
Holdout-ul provine din același generator, deci nu spune nimic despre tipuri noi de fraudă sau derivă de date
Recall-ul total a depășit 85% cu mai puțin de două puncte
Ghici neconfirmat: splitul ar putea depăși plafonul dacă traficul pe Mobile App crește mai repede decât pe Website, pentru că pragul Mobile App stă atât de jos
Primele două reies din numere.
Urmărește auditul complet în Streamlit
Repository-ul include și o aplicație Streamlit și cele șase încercări înregistrate, ca să poți deschide acest audit fără un apel API. În video, o încarc și trec prin fiecare tab.
Aplicația Streamlit arată un audit. Video de autor.
Gemini 4 Carbon, nivel mediu vs. înalt de gândire: acuratețe, timp și cost
Succes aici înseamnă să termini în limitele aplicației și să returnezi un raport pe care evaluatorul îl acceptă. O încercare oprită nu are verdict de punctat. După această definiție, medium a terminat fiecare încercare și a costat mai puțin de jumătate per audit corect.
Șase încercări sunt prea puține ca să facă din asta o regulă generală. Dacă nivelurile de gândire îți sunt noi, tutorialul nostru despre API-ul Gemini 3.8 Flash acoperă thinking_level în mai multe detalii.
Compară nivelul mediu și înalt pe același audit
Aceasta este comparația completă din spatele TL;DR-ului. Am rulat 3 încercări per nivel, fiecare dintr-o stare curată fără memorie despre celelalte, cu date, prompt, unelte, limite și evaluator identice:
Per nivel
medium
high
Încercări care au terminat cu raport
3 din 3
2 din 3
Auditurile corecte dintre acestea
3 din 3
2 din 2
Tokeni de gândire per încercare
Aproximativ 7.700
Aproximativ 17.500
Timp per încercare
Aproximativ 5 minute
Aproximativ 6 minute
Cost per audit corect, tarif introductiv
Aproximativ 0,25 $
Aproximativ 0,62 $
Cost per audit corect, tarif standard
Aproximativ 0,51 $
Aproximativ 1,24 $
Rândurile de cost includ cheltuiala fiecărei încercări, inclusiv pe cea care s-a oprit. Fiecare încercare finalizată a ajuns la același verdict și conflict și a ales o pereche pe canale pe care evaluatorul a acceptat-o, deci gândirea suplimentară a intrat în mai multe verificări.
Am văzut un tipar similar în experimentul de coding cu Gemini 4 Argon: higha cheltuit mai mult și a făcut mai multă muncă pentru o schimbare mai mică în rezultatul verificat. Sarcinile diferă, deci costurile și ratele de succes nu sunt direct comparabile. În ambele cazuri, verificarea independentă ne spune mai mult decât totalul de gândire.
De ce o încercare pe nivel înalt nu s-a terminat
Încercarea care s-a oprit a fost prima pe high și nu a dat niciun verdict greșit. A testat fiecare punct din grilă de la 0,101 la 0,119 și apoi a vânat limita de 70% a Website-ului, de care nu depindea nimic, continuând să ceară mai multe verificări până a atins limita de 60 de apeluri stabilită mai devreme, iar aplicația a oprit-o înainte de a scrie un raport.
Doar o încercare a atins limita. Imagine de autor.
Acea oprire este partea utilă. Un prompt care să ceară mai puține apeluri nu ar fi încheiat-o, iar limita din cod a făcut-o, după aproximativ 22 de cenți.
Cele cinci rapoarte finalizate au trecut și de celelalte verificări Python. Niciunul nu a citit greșit configurația curentă, nu a numit o cerință în afara conflictului, nu a citat un apel de unealtă inexistent sau nu a recomandat o configurație netestată.
Măsoară tokenii, timpul și costul per audit
Un audit costă suma usage a fiecărei ture, tarifată la 2,00 $ per milion de tokeni input, 0,10 $ cached și 10,00 $ output inclusiv gândire, toate dublându-se la 1 decembrie 2026. total_input_tokens include tokenii cache, deci codul tarifează separat cele două părți.
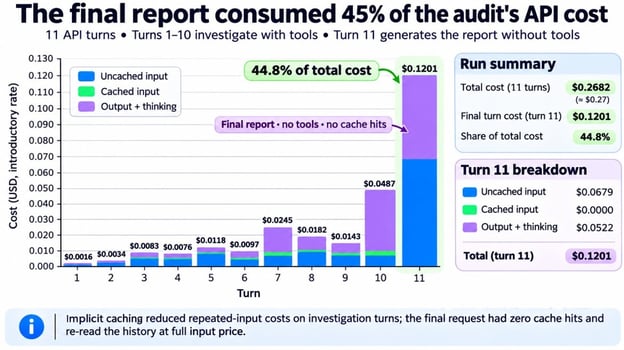
Tura de raport costă cel mai mult. Imagine de autor.
Surpriza a fost raportul sau, mai exact, factura lui. Caching-ul implicit a acoperit cam trei sferturi din tokenii de input în turele de investigație, dar cererea de raport fără unelte nu a avut niciun cache hit.
Cauza probabilă este că eliminarea tools schimbă începutul cererii. Oricum, acea tură a recitit întreg istoricul la preț întreg și a luat cam 40% din costul fiecărei încercări finalizate. Ia în calcul acea tură când setezi limita de cheltuială.
Limitări ale folosirii Gemini 4 Carbon pentru auditarea modelelor ML
Am proiectat acest test și am generat datele eu însumi, deci rezultatele au aceste limite:
Datele sunt sintetice și provin dintr-un singur clasificator, iar eu am ajustat generatorul până a existat un conflict, înainte de orice apel API
Verdictul acoperă doar acest clasificator, iar unul mai bun ar putea îndeplini toate cele trei reguli cu un singur prag
Un prag poate fi verificat, dar aprobarea unui split pe canale este o decizie de business și echitate
Interacțiunile sunt stocate 55 de zile pe nivelul plătit în mod implicit, iar store=false exclude previous_interaction_id, deci un agent care trimite rânduri de tranzacții are nevoie de o revizuire a datelor
Evaluatorul rezolvă problema pragului de unul singur, fără model. Dacă tot ce îți trebuie este un prag, folosește un solver de optimizare. Ce a adăugat Gemini 4 Carbon a fost auditul din jurul lui.
Nimic de aici nu este legat exclusiv de fraudă. Configurația se potrivește oricărui model ale cărui reguli pot fi măsurate în Python.
Gânduri finale
Rezultatul principal este că Gemini 4 Carbon a recunoscut că politica originală nu avea un prag global valid. Toate cele 5 încercări finalizate au numit conflictul și au propus un split pe canale pe care evaluatorul l-a acceptat; o încercare pe high s-a oprit înainte de a produce un raport.
Experimentele Gemini 4 Argon și Gemini 4 Carbon testează două fețe ale fiabilității agenților. Agentul Gemini 4 Argon a schimbat cod și a trebuit să păstreze comportamentul, în timp ce agentul Gemini 4 Carbon a ajuns la o decizie sub reguli care făceau răspunsul original imposibil. Ambele au avut nevoie de unelte înguste, limite de resurse și o verificare în afara modelului.
Acesta este standardul pe care l-aș folosi pentru un agent: definește ce pot stabili uneltele lui, verifică rezultatul independent și permite un răspuns inconclusiveatunci când dovezile se termină. Apoi, aș pune doi sau trei clasificatori candidați sub aceeași politică și aș întreba care, dacă vreunul, poate fi livrat.
Întrebări frecvente
Cum obțin acces la API-ul Gemini 4 Carbon?⌄
Printr-un proiect plătit Google AI Studio sau prin Gemini for business pe Google Cloud. Aplicația Gemini, Antigravity și AI Mode îl oferă și abonatilor Google AI Ultra, dar acele aplicații pentru consumatori nu îți oferă o cheie API.
Cât costă API-ul Gemini 4 Carbon?⌄
Toate cele 6 audituri de aici au ajuns la 2,00 $ la tariful introductiv. Cererile standard ca acestea obțin caching implicit odată ce o cerere depășește 4.096 de tokeni de input, deci păstrează începutul fiecărei cereri identic. Flex inference, pe care cererile Interactions îl suportă de asemenea, înjumătățește tarifele pe token în schimbul unor răspunsuri mai lente și mai puțin fiabile.
Care sunt limitele de rată pentru API-ul Gemini 4 Carbon?⌄
Proiectele plătite au limite pe minut plus o limită de cheltuială, care este 10 $ per fereastră rulantă de 10 minute pe Tiers 1, iar depășirea returnează 429 RESOURCE_EXHAUSTED. Un audit aici a costat sub 1 $, deci doar multe încercări paralele ar atinge limita. Limitele cresc cu nivelul tău, așa că verifică pagina de rate limits a Google pentru proiectul tău.
Care este diferența între nivelul mediu și cel înalt de gândire în Gemini 4 Carbon?⌄
Gemini 4 Carbon are trei niveluri, low, medium (implicit) și high, iar eu am comparat aici doar primele două. Ca să vezi cum arată gândirea suplimentară, setează thinking_summariesla "auto" și vei primi rezumate condensate lângă fiecare răspuns. Sunt oprite implicit și pot veni goale când modelul abia raționează.
Poate Gemini 4 Carbon să ruleze cod Python?⌄
Da. Adaugă {"type": "code_execution"} la toolsși Gemini 4 Carbon poate scrie și rula Python pe partea Google, taxat la tarifele normale pe token. L-am lăsat pe dinafară pentru a păstra controlul la mine: cele trei unelte decid ce poate măsura, iar tranzacțiile brute și holdout-ul nu părăsesc niciodată mașina mea.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.


În tutorialul despre API-ul Gemini 4 Argon, agentul avea o sarcină clară: să găsească cod lent, să-l schimbe și să treacă teste ascunse. Acest experiment complementar păstrează același tipar de unelte controlate și o verificare externă, dar schimbă decizia. Gemini 4 Carbon trebuie să stabilească dacă regulile originale pot fi îndeplinite măcar.
PayGuard, un magazin online fictiv, are un model de machine learning (ML) antrenat care punctează comenzile pentru fraudă. Politica de punere în producție cere ca modelul să captureze suficientă valoare de fraudă per total și pe fiecare canal de vânzare, fără să copleșească echipa de review. Agentul trebuie să investigheze acele reguli fără să i se spună dacă există sau nu un prag valid.
Gemini 4 Carbon este un model de raționare de la Google pe care îl apelezi din Python prin Interactions API. Aici, acționează ca un agent AI: alege ce verificări să ceară, iar Python le rulează prin trei unelte doar-citire folosind function calling. Întrebarea mea este dacă poate identifica conflictul, poate explica dovezile și poate recomanda o schimbare permisă fără a trata acea schimbare ca aprobată.
Ai nevoie de baze de Python și puțină experiență cu cereri API. Definim fiecare metrică de fraudă înainte ca numerele să o folosească. Vom acoperi cum să:
Dacă vrei povestea lansării și scorurile de benchmark, prezentarea Gemini 4 Carbon le are, iar Claude Fable 5.2 vs. Gemini 4 Carbon compară cele două modele. Am rulat acest experiment în ziua de după ce Google a deschis API-ul pentru dezvoltatori plătitori.
Ce este API-ul Gemini 4 Carbon?
API-ul Gemini 4 Carbon este interfața de programare cu aplicații (API) plătită pentru
gemini-4-carbon, pe care pagina modelului îl descrie ca un model de raționare pentru sarcini lungi, multi-pas ale agenților. Inputul, gândirea și outputul împart o fereastră de context de 1.048.576 de tokeni, iar un răspuns sincron se oprește implicit la 65.536 de tokeni de gândire plus output.De ce un audit al unui model ML este un test bun pentru Gemini 4 Carbon
Sarcina cere mai multe verificări, o căutare prin schimbările permise și o oprire clară atunci când regulile nu lasă niciun răspuns. Am ales-o pentru că Python poate calcula rezultatul de referință. Fișa modelului listează halucinațiile printre limitele cunoscute ale Gemini 4 Carbon, așa că modelul investighează, iar Python decide dacă recomandarea lui se susține.
Proiectul: Decizia dacă modelul de fraudă al PayGuard poate intra în producție
PayGuard este magazinul fictiv din introducere, iar proiectul complet se află în repository-ul GitHub. Clasificatorul este deja antrenat.
Cum punctează PayGuard tranzacțiile
Fiecare tranzacție are un timestamp în Timpul Universal Coordonat (UTC), un cuantum, un canal (Website sau Mobile App), un scor de risc și o etichetă de fraudă. Un scikit-learn
HistGradientBoostingClassifierproduce scorul, rotunjit la 0,001, iar PayGuard marchează o tranzacție cândrisk_score >= threshold. Tutorialul despre curba precision-recall arată cum mutarea unui prag schimbă ce este marcat, iar cursul nostru Fraud Detection in Python acoperă partea de modelare.Datele sintetice sunt împărțite în timp:
Pragul curent este 0,5, iar datele și politica nu se schimbă în timpul experimentului. Frauda pe Website lasă semnale clare în aceste date, în timp ce majoritatea fraudei pe Mobile App arată ca o comandă obișnuită.
Gemini 4 Carbon întreabă, Python decide. Imagine de autor.
Trei reguli de deploy ale PayGuard
Iată cele trei reguli din introducere, scrise așa cum le formulează politica. Toate sunt ținte fictive alese pentru acest experiment:
Recall-ul valorii fraudei este valoarea fraudei marcate împărțită la valoarea totală a fraudei. Spre deosebire de recall-ul la nivel de tranzacție din ghidul nostru precision versus recall, o fraudă ratată de 2.000 $ contează mult mai mult decât una de 15 $, iar marcarea nu înseamnă că banii au fost salvați. R3 limitează cea mai aglomerată zi, iar acea formulare ajunge să decidă auditul.
Agentul poate investiga două schimbări: o capacitate zilnică de până la 260 cu un singur prag sau praguri separate pe canale la plafonul original. Ambele au nevoie de aprobare umană, nu pot fi combinate, iar politica preferă opțiunea fără recenzenți suplimentari.
Ce înseamnă un audit corect
Un audit corect bifează patru lucruri, iar tu ar trebui să le decizi înainte de prima cerere:
Un evaluator la care agentul nu are acces calculează răspunsul.
Cum să configurezi API-ul Gemini 4 Carbon în Python
Configurarea API-ului Gemini 4 Carbon necesită Python 3.11 sau mai nou și o cheie API dintr-un proiect Google AI Studio cu billing activ, deoarece pagina de prețuri nu oferă un nivel gratuit.
Instalează SDK-ul Google Gen AI și pregătește proiectul
Am testat acest proiect cu SDK-ul Google Gen AI blocat la
google-genai==3.1.0, versiunea de pe PyPI din ziua lansării care a adăugatgemini-4-carbonîn lista de modele Interactions. Clonează proiectul și instalează-l într-un mediu virtual:După aceea, rulează cele două comenzi de pe pagina repository-ului care construiesc datele și potrivesc clasificatorul cu seed-uri fixe. Pe un clone proaspăt, acestea vor afișa:
Seed-urile fixe reconstruiesc același set de date. Imagine de autor.
Apoi pune
GEMINI_API_KEY=your-keyîntr-un fișier.env. Repository-ul îl încarcă fără să îl afișeze.Fă prima ta cerere către API-ul Gemini 4 Carbon
Rulează acest exemplu complet din folderul proiectului. Îi oferă lui Gemini 4 Carbon politica și sumarul clasificatorului și îl întreabă de ce măsurători ar avea nevoie, fără a sugera un conflict:
Nivelul de gândire intră în
generation_config, iaroutput_textconține răspunsul. Iată o parte din ce a venit înapoi:A interpretat R3 ca un vârf și a planificat ordinea de preferință a politicii înainte de a vedea vreun număr. Nu a întrebat niciodată cum se tratează egalitățile sau rotunjirea scorurilor, iar verificarea exhaustivă pe care o voi arăta mai târziu depinde exact de asta. Apelul a durat aproximativ 40 de secunde și a costat cam 2 cenți.
Omite
temperature,top_pșitop_k, pe care Gemini 4 Carbon le ignoră, șithinking_budget.Cum să construiești un agent de audit ML cu function calling în Gemini 4 Carbon
Un agent de audit Gemini 4 Carbon este o buclă: modelul cere o evaluare, Python o validează și o rulează, iar rezultatul se întoarce până când modelul încetează să mai ceară.
Definește unelte doar-citire pentru evaluarea modelului
Agentul primește trei unelte. Toate sunt limitate la fereastra de validare:
get_audit_context: sumarul clasificatorului, configurația curentă, politica și schimbările permiseevaluate_global_threshold: recall-ul valorii fraudei per total și pe canal, marcări pe zi și diagnostice pentru un pragevaluate_policy_change: aceleași măsurători pentru o creștere de capacitate sau o pereche de praguri pe canaleSchemele complete sunt în repository. Acest extras simplificat omite câmpurile de prag și capacitate, deci nu este o declarație completă de copiat. Arată doar granița care contează aici: unealta acceptă cele două schimbări de politică permise de PayGuard, citește date de validare și nu aprobă nimic.
Python validează câmpurile de prag și capacitate omise, respinge schimbările în afara politicii și returnează măsurători în loc de steaguri de trecere sau eșec. Agentul nu poate accesa holdout-ul, nu poate apela evaluatorul și nu poate schimba politica. Explic în FAQ de ce am sărit peste execuția de cod integrată a lui Gemini 4 Carbon.
Oferă agentului un obiectiv clar și reguli de oprire
Instrucțiunea de sistem stabilește metoda. Ca și prima cerere, nu sugerează unde este conflictul:
Promptul poate doar să ceară, așa că limitele trăiesc în harnasamentul agentului, codul Python din jurul modelului. Deoarece API-ul nu are setare de buget, aplicația le stabilește per încercare: 25 de ture, 60 de apeluri de unelte, 30 de minute și 3 $, cu cheltuiala verificată între ture.
Implementează bucla de function calling cu Interactions API
Fiecare tură este un apel
client.interactions.create(). Gemini 4 Carbon cere adesea mai multe unelte deodată, așa că bucla rulează la fiecare pasfunction_call. Aceasta este bucla de bază, iar versiunea din repository adaugă logging și verificări de limite:Păstrez aceste setări într-un dict
requestastfel încât fiecare apel ulterior să le retrimită.previous_interaction_idpoartă istoricul, dartools,system_instructionșigeneration_configse aplică doar unei interacțiuni. Dacă o tură se terminăincomplete,max_output_tokensa tăiat-o, și tot plătești pentru tokenii de gândire.Returnează un raport de audit structurat cu o schemă JSON
Ghidul Google pentru output structurat listează unelte plus o schemă JSON într-o singură cerere ca o funcționalitate Preview care include Gemini 4 Carbon. Eu le-am păstrat separate: turele de investigație doar măsoară, iar o tură finală pe același istoric și config scrie raportul cu o schemă și fără unelte:
AuditReporteste un model Pydantic cu verdictul, conflictul, dovezile, recomandarea și aprobările. Python măsoară timpul și costul în loc să ceară lui Gemini 4 Carbon să le raporteze.Rulează auditul Gemini 4 Carbon pe modelul de detecție a fraudei
Gemini 4 Carbon a auditat modelul așa cum mi-aș dori să o facă un analist junior: cu măsurători înainte de orice concluzie. La prima încercare pe
medium, a citit contextul auditului, a verificat vreo două duzini de praguri unice și a testat opt schimbări de politică.Toate cele 32 de apeluri de unelte, în ordine. Imagine de autor.
Evaluează pragul curent al PayGuard
Agentul a evaluat pragul curent de 0,5 și a găsit 91% recall pe Website, 20% pe Mobile App, 64% recall total și 85 de marcări în cea mai aglomerată zi. Asta eșuează la R1 și la jumătatea Mobile App a lui R2, cu spațiu sub R3, așa că mișcarea evidentă este un prag mai jos.
Testează recall-ul valorii fraudei vs. capacitatea zilnică de review
Scăderea unui prag prinde mai multă valoare de fraudă și trimite mai multe comenzi la review. PayGuard are nevoie de destul din prima, menținând în același timp a doua sub un plafon zilnic.
Agentul a încercat câteva praguri grosiere într-un lot, apoi a restrâns la puncte unice din grilă. Apelurile 11, 12, 17 și 18 din trasă au tranșat situația.
Pe această fereastră de validare, pragul minim pentru Mobile App are nevoie de 0,108 sau mai jos, deoarece un pas mai sus îl coboară chiar sub 70%. Plafonul cere 0,118 sau mai sus. Niciun prag nu le face pe ambele.
Recall-ul total se menține până la 0,137, deci R1 rămâne în afara conflictului. La 0,108, ziua medie are cam 169 de marcări, și doar un sâmbătă trece peste. De aceea politica folosește volumul celei mai aglomerate zile, nu media zilnică.
Recall-ul pe mobil și capacitatea nu se intersectează. Imagine de autor.
Verifică performanța pe ambele canale de plată
Frauda pe Mobile App, cu semnale mai slabe, stă jos în intervalul de scor. Tragerea unui singur prag până la 0,108 pentru Mobile App aduce și mai multe comenzi legitime de pe Website, iar în acel sâmbătă împing totalul peste plafon.
Numărul total o ascunde: la 0,118, recall-ul total este cam 87%, în timp ce Mobile App stă sub podeaua lui. Dacă politica ta numește segmente, măsoară fiecare în parte, pentru că totalul poate trece în timp ce un segment eșuează.
Poate Gemini 4 Carbon detecta cerințe de deploy aflate în conflict?
Da, în acest audit. Raportul înghețat spune
not deployable, spune că niciun prag unic nu funcționează și numește R2 pentru Mobile App și R3 drept conflict.Verifică verdictul de deploy al Gemini 4 Carbon față de dovezile lui
Fiecare număr citat în raport se potrivește cu un rezultat de unealtă, dar o propoziție afirmă mai mult decât a măsurat agentul. Spune că niciun prag nu funcționează „pe toate punctele grilei de scor de risc de 0,001”, totuși agentul a testat doar cele două duzini din trasă, din 1.002 praguri posibile.
Afirmația se susține pentru că recall-ul și numărul zilnic scad ambele pe măsură ce pragul crește, lucru pe care raportul nu îl spune. Verifică fiecare afirmație dintr-un raport de agent față de ce a măsurat, iar ghidul nostru despre evaluarea agenților AI acoperă mai multe astfel de verificări.
Verifică conflictul cu un evaluator Python exhaustiv
Gemini 4 Carbon a eșantionat praguri și a dedus că niciunul nu ar putea funcționa. Evaluatorul dovedește acel rezultat pentru acest set de validare verificând fiecare set distinct de marcări, fără a partaja cod cu uneltele.
Scorurile stau pe o grilă de 0,001, deci cele 1.002 cutoff-uri candidate acoperă fiecare set posibil de marcări. Evaluatorul le verifică pe toate, plus fiecare pereche de praguri pe canale, folosind cenți întregi astfel încât 85% și 70% să fie exacte.
Verificare exhaustivă și patru configurații respinse. Imagine de autor.
Niciun prag global nu trece toate cele trei reguli, astfel că afirmația lui Gemini 4 Carbon are acum dovadă în spate. Evaluatorul a potrivit limitele 0,108 și 0,118 din testarea agentului și a găsit mii de perechi pe canale care trec la 200 pe zi.
Un evaluator ajută doar dacă respinge răspunsuri greșite, așa că i-am dat patru configurații eronate și le-a respins pe toate.
Testează alternativele de deploy cu Gemini 4 Carbon
Gemini 4 Carbon a testat ambele schimbări permise și a ales praguri separate la plafonul original în locul recenzenților suplimentari. A marcat acea alegere ca o excepție ce trebuie aprobată de o persoană.
Testează o creștere a capacității de review manual
Un singur prag global funcționează dacă plafonul crește de la 200 la 205, iar evaluatorul a confirmat 205 ca fiind cea mai mică creștere. Gemini 4 Carbon tot a clasat această opțiune pe locul doi, din cauza regulii de preferință descrise mai devreme.
Testează praguri separate pentru fiecare canal de plată
Pe partea de canale, agentul a ținut pragul Mobile App aproape de limita lui (văzuse deja că 0,109 cade sub podea) și a ridicat pragul Website, scăzând marcările pe comenzi legitime de pe Website. A testat șapte perechi, iar una a eșuat la diferență de o singură marcare în cea mai aglomerată zi. A recomandat Website 0,3 și Mobile App 0,1 pentru că acea pereche trece toate regulile cu marjă, iar evaluatorul a confirmat-o la plafonul original.
Compară alternativele verificate
Aceste numere au apărut mai sus, iar evaluatorul le-a recalcultat pe fiecare:
Opțiune
Praguri
Total
Website
Mobile App
Cea mai aglomerată zi
Aprobare
Politica originală
Global 0,108
87,5%
98,2%
70,1%
205, plafon 200
Eșuează
Mai multă capacitate
Global 0,108
87,5%
98,2%
70,1%
205, plafon 205
Necesară
Split pe canale
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, plafon 200
Necesară
Splitul pe canale marchează și cu aproximativ 6% mai puține tranzacții decât opțiunea de capacitate. Totuși, mai puțin de jumătate din marcările lui sunt fraudă, lucru notat în raport ca problemă deschisă.
Cum să verifici recomandarea Gemini 4 Carbon pe date nevăzute
Verifici recomandarea aplicând-o, înghețată, pe holdout-ul sigilat. Diferența față de evaluator este în date: evaluatorul a punctat săptămâni pe care agentul le putea vedea, iar holdout-ul punctează patru săptămâni ulterioare pe care nicio unealtă nu le-a putut citi. Verificarea rulează o dată per recomandare înghețată și nu pornește dacă raportul s-a schimbat după înghețare.
Recomandarea înghețată trece pe holdout. Imagine de autor.
A trecut toate cele trei reguli, iar cea mai aglomerată zi a rămas sub plafon. Totuși, nu trage concluzii prea mari. Trei lucruri păstrează acest rezultat modest:
Primele două reies din numere.
Urmărește auditul complet în Streamlit
Repository-ul include și o aplicație Streamlit și cele șase încercări înregistrate, ca să poți deschide acest audit fără un apel API. În video, o încarc și trec prin fiecare tab.