Учебник по Gemini 4 Carbon API: создайте агента, который аудирует антифрод‑модель
Изучите Gemini 4 Carbon API в Python: создайте агента с function calling для аудита антифрод‑модели, поиска конфликтующих правил и тестирования изменения политики.
В нашем учебнике по Gemini 4 Argon API агент выполнял чёткую задачу: найти медленный код, исправить его и пройти скрытые тесты. Этот сопутствующий эксперимент сохраняет тот же шаблон с контролируемыми инструментами и внешней проверкой, но меняет тип решения. Gemini 4 Carbon должен понять, можно ли вообще удовлетворить исходные правила.
PayGuard, вымышленный интернет‑магазин, использует обученную ML‑модель, которая оценивает заказы на предмет мошенничества. Политика внедрения требует, чтобы модель отлавливала достаточно мошеннической стоимости в целом и по каждому каналу продаж, не перегружая команду ручной проверки. Агент должен исследовать эти правила, не зная заранее, существует ли допустимый порог.
Gemini 4 Carbon — это модель рассуждений Google, к которой вы обращаетесь из Python через Interactions API. Здесь она выступает как ИИ‑агент: выбирает, какие проверки запросить, а Python запускает их через три инструмента только для чтения с помощью function calling. Вопрос в том, сможет ли она выявить конфликт, объяснить доказательства и предложить разрешённое изменение, не считая это изменение заранее одобренным.
Потребуются базовые знания Python и небольшой опыт работы с API‑запросами. Я определяю каждую метрику мошенничества перед тем, как использовать её в расчётах. Мы разберём, как:
Отправить первый запрос к Gemini 4 Carbon из Python
Дать модели инструменты только для чтения и запускать их в цикле с ограничениями
Получить вердикт в виде JSON, который ваш код сможет проверить
Проверить этот вердикт кодом и данными, которых модель не видела
Сравнить два уровня рассуждений, определяющих, сколько модель думает перед ответом
Если вам нужна история запуска и бенчмарки, они есть в нашем обзоре Gemini 4 Carbon, а сравнение моделей смотрите в материале Claude Fable 5.2 vs. Gemini 4 Carbon. Этот эксперимент я проводил на следующий день после открытия API для платных разработчиков.
Что такое Gemini 4 Carbon API?
Gemini 4 Carbon API — это платный интерфейс программирования приложений (API) для gemini-4-carbon, который на странице модели описан как модель рассуждений для длинных, многошаговых задач агентов. Вход, рассуждения и вывод разделяют контекстное окно на 1 048 576 токенов, а синхронный ответ по умолчанию останавливается на 65 536 токенах рассуждений плюс вывода.
Почему аудит ML‑модели — хороший тест для Gemini 4 Carbon
Задача требует нескольких проверок, поиска среди разрешённых изменений и чёткого стоп‑сигнала, когда правила не оставляют ответа. Я выбрал её, потому что Python может вычислить эталонный результат. В карте модели среди известных ограничений Gemini 4 Carbon указаны галлюцинации, поэтому модель исследует, а Python решает, выдерживает ли её рекомендация проверку.
Проект: можно ли вывести антифрод‑модель PayGuard в прод
PayGuard — вымышленный магазин из вступления, полный проект лежит в репозитории на GitHub. Классификатор уже обучен.
Как PayGuard оценивает транзакции
У каждой транзакции есть отметка времени в UTC, сумма, канал (Website или Mobile App), риск‑балл и метка мошенничества. Модель scikit‑learn HistGradientBoostingClassifier выдаёт риск‑балл, округлённый до 0,001, и PayGuard помечает транзакцию, когда risk_score >= threshold. Наш учебник по кривой precision‑recall показывает, как сдвиг порога меняет состав флагов, а курс Fraud Detection in Python освещает моделирование.
Синтетические данные разбиты по времени:
Обучение: первые девять недель, используются только для обучения классификатора
Валидация: следующие четыре недели, единственное окно, доступное инструментам
Холд‑аут: ещё четыре недели после этого, запечатаны до заморозки рекомендации
Текущий порог — 0,5, данные и политика в ходе эксперимента не меняются. В этих данных мошенничество на Website оставляет явные сигналы, а большинство мошенничеств в Mobile App выглядит как обычный заказ.
Gemini 4 Carbon спрашивает, Python решает. Изображение автора.
Три правила внедрения PayGuard
Вот три правила из вступления, в формулировке, принятой в политике. Это вымышленные целевые значения, выбранные для эксперимента:
R1: помеченные транзакции покрывают не менее 85% стоимости размеченного мошенничества в целом
R2: они покрывают не менее 70% стоимости размеченного мошенничества внутри каждого канала
R3: не более 200 транзакций помечено в любой отдельный день по UTC
Recall по стоимости мошенничества — это стоимость помеченного мошенничества, делённая на общую стоимость мошенничества. В отличие от recall на уровне транзакций в нашем гайде по precision против recall, пропуск мошенничества на $2 000 весит гораздо больше, чем пропуск на $15, и флаг не означает, что деньги спасены. R3 ограничивает самый загруженный день — именно эта формулировка в итоге решает исход аудита.
Агент может исследовать два изменения: дневную ёмкость до 260 при одном пороге или раздельные пороги по каналам при исходном лимите. Оба варианта требуют одобрения человека, они не комбинируются, и политика предпочитает вариант без дополнительных проверяющих.
Что считается корректным аудитом
Корректный аудит даёт четыре верных ответа, и их стоит зафиксировать до первого запроса:
Вердикт: существует ли единый порог, который удовлетворяет R1, R2 и R3 на валидации
Конфликт: какие требования делают исходную политику невыполнимой
Альтернатива: разрешённое изменение, которое проходит все правила при повторном расчёте в Python
Предпочтение: рекомендация следует порядку предпочтений в политике
Ответ вычисляет независимый оценщик, к которому агент обратиться не может.
Как настроить Gemini 4 Carbon API в Python
Настройка Gemini 4 Carbon API требует Python 3.11 или новее и ключа API из проекта Google AI Studio с включённым биллингом, поскольку на странице цен нет бесплатного тарифа.
Установите Google Gen AI SDK и подготовьте проект
Я тестировал проект с SDK Google Gen AI, зафиксированным на версии google-genai==3.1.0 — это релиз дня запуска на PyPI, где gemini-4-carbon добавили в список моделей Interactions. Клонируйте проект и установите его в виртуальное окружение:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS or Linux: source .venv/bin/activate
pip install-r requirements.txtРаботает на
Затем выполните две команды со страницы репозитория для сборки данных и обучения классификатора с фиксированными сидами. На свежем клонe они выводят следующее:
Фиксированные сиды пересобирают тот же датасет. Изображение автора.
Затем добавьте GEMINI_API_KEY=your-key в файл .env. Репозиторий загрузит его, не печатая.
Сделайте первый запрос к Gemini 4 Carbon API
Запустите этот законченный пример из папки проекта. Он передаёт Gemini 4 Carbon политику и сводку классификатора и спрашивает, что нужно измерить, не намекая на конфликт:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Работает на
Уровень рассуждений указывается в generation_config, а output_text содержит ответ. Вот часть ответа:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Работает на
Она прочитала R3 как пиковое значение и распланировала порядок предпочтений политики ещё до численных данных. Однако не спросила, как обрабатываются равные значения и округление скорингов, а исчерпывающая проверка, показанная ниже, как раз зависит от этого. Вызов занял около 40 секунд и стоил около 2 центов.
Не указывайте temperature, top_p и top_k — Gemini 4 Carbon их игнорирует, а также thinking_budget.
Как создать агента аудита ML с function calling в Gemini 4 Carbon
Агент аудита Gemini 4 Carbon — это цикл: модель запрашивает оценку, Python валидирует и запускает её, затем возвращает результат, пока модель не прекратит запросы.
Определите инструменты только для чтения для оценки модели
У агента три инструмента. Все ограничены окном валидации:
get_audit_context: сводка классификатора, текущая конфигурация, политика и разрешённые изменения
evaluate_global_threshold: recall по стоимости мошенничества в целом и по каналам, флаги по дням и диагностика для одного порога
evaluate_policy_change: те же измерения для увеличения ёмкости или пары порогов по каналам
Полные схемы в репозитории. В этом упрощённом фрагменте опущены поля порогов и ёмкости, поэтому копировать его как готовое объявление нельзя. Он лишь показывает важную границу: инструмент принимает два изменения политики, разрешённые PayGuard, читает валидационные данные и ничего не утверждает.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Работает на
Python валидирует опущенные поля порога и ёмкости, отклоняет изменения вне политики и возвращает измерения вместо флагов «пройдено/не пройдено». Агент не может добраться до холд‑аута, вызвать оценщик или изменить политику. В разделе FAQ я объясняю, почему не стал использовать встроенное выполнение кода в Gemini 4 Carbon.
Дайте агенту чёткую цель и правила остановки
Системная инструкция задаёт метод. Как и первый запрос, она не подсказывает, где конфликт:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.Работает на
Промпт может только просить, поэтому ограничения живут в обвязке агента — Python‑коде вокруг модели. Поскольку в API нет параметра бюджета, приложение задаёт их на попытку: 25 ходов, 60 вызовов инструментов, 30 минут и $3, с проверкой трат между ходами.
Реализуйте цикл function calling с Interactions API
Каждый ход — это один вызов client.interactions.create(). Gemini 4 Carbon часто запрашивает несколько инструментов сразу, поэтому цикл обрабатывает каждый шаг function_call. Это основной цикл; в репозитории добавлены логирование и проверки лимитов:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Работает на
Я держу эти настройки в одном словаре request, чтобы каждое последующее обращение пересылало их. previous_interaction_id несёт историю, но tools, system_instruction и generation_config применяются только к одному взаимодействию. Если ход завершается со статусом incomplete, значит, его обрезал max_output_tokens, и за токены рассуждений вы всё равно платите.
Верните структурированный отчёт аудита по JSON‑схеме
В руководстве по структурированным ответам Google указано: инструменты плюс JSON‑схема в одном запросе — это функция Preview, доступная и для Gemini 4 Carbon. Я всё же разделил: в ходах расследования мы только измеряем, а финальный ход на той же истории и конфигурации пишет отчёт по схеме и без инструментов:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Работает на
AuditReport — это модель Pydantic с вердиктом, конфликтом, доказательствами, рекомендацией и одобрениями. Время и стоимость считает Python, не прося Gemini 4 Carbon их сообщать.
Запустите аудит Gemini 4 Carbon для модели обнаружения мошенничества
Gemini 4 Carbon провела аудит модели так, как я ожидал бы от младшего аналитика: сначала измерения, затем выводы. В первой попытке с уровнем medium она прочитала контекст аудита, проверила около двух десятков единых порогов и протестировала восемь вариантов изменений политики.
Все 32 вызова инструментов по порядку. Изображение автора.
Оцените текущий порог PayGuard
Агент оценил текущий порог 0,5 и получил 91% recall для Website, 20% для Mobile App, 64% в целом и 85 флагов в самый загруженный день. Это не проходит R1 и часть R2 для Mobile App при запасе по R3, так что очевидный шаг — понизить порог.
Проверьте recall по стоимости против дневной ёмкости на проверку
Понижение порога ловит больше стоимости мошенничества и отправляет на проверку больше заказов. PayGuard нужно достаточно первого, удерживая второе под дневным лимитом.
Агент попробовал несколько грубых порогов одним батчем, затем сузился до отдельных точек сетки. Решение дали вызовы 11, 12, 17 и 18 в трассе.
На этом окне валидации для Mobile App нижняя граница — 0,108 или ниже, поскольку шаг выше опускает показатель чуть ниже 70%. Лимит по ёмкости требует 0,118 или выше. Ни один порог не удовлетворяет обоим условиям.
Общий recall держится до 0,137, так что R1 вне конфликта. При 0,108 средний день даёт около 169 флагов, а лимит превышается только в одну субботу. Поэтому в политике используется нагрузка самого загруженного дня, а не среднее.
Recall Mobile и ёмкость не пересекаются. Изображение автора.
Проверьте качество по обоим платёжным каналам
Мошенничество в Mobile App со слабыми сигналами лежит низко в диапазоне баллов. Опускание единого порога до 0,108 ради Mobile App также втягивает больше легитимных заказов с Website, и в ту субботу они превышают лимит.
Общий показатель это скрывает: при 0,118 общий recall около 87%, тогда как Mobile App ниже своего порога. Если в вашей политике названы сегменты, измеряйте каждый: сумма может проходить, а сегмент — нет.
Может ли Gemini 4 Carbon выявлять конфликтующие требования внедрения?
Да, в этом аудите. Замороженный отчёт говорит not deployable, утверждает, что единый порог не работает, и называет конфликтом R2 для Mobile App и R3.
Сверьте вердикт Gemini 4 Carbon с его доказательствами
Каждое число в отчёте совпадает с результатом инструмента, но одно предложение заявляет больше, чем агент измерил. Сказано, что ни один порог не работает «по всем точкам сетки риск‑балла с шагом 0,001», хотя агент проверил лишь два десятка из 1 002 возможных порогов.
Утверждение верно, потому что recall и дневные количества падают при росте порога, чего отчёт не проговаривает. Сверяйте каждое заявление в отчёте агента с тем, что он измерил; подробнее об этом — в нашем гайде по оценке ИИ‑агентов.
Подтвердите конфликт исчерпывающим Python‑оценщиком
Gemini 4 Carbon пробывала пороги и сделала вывод, что ни один не подойдёт. Оценщик доказывает этот результат для данного валидационного набора, проверяя каждый возможный набор флагов, не разделяя код с инструментами.
Балы лежат на сетке 0,001, так что 1 002 кандидатных отсечки покрывают все возможные наборы флагов. Оценщик проверяет их все, плюс каждую пару порогов по каналам, используя целые центы для точности 85% и 70%.
Исчерпывающая проверка и четыре отклонённые конфигурации. Изображение автора.
Ни один глобальный порог не проходит все три правила, так что тезис Gemini 4 Carbon теперь подкреплён доказательством. Оценщик совпал с границами 0,108 и 0,118 из зондирования агента и нашёл тысячи пар по каналам, проходящих при лимите 200 в день.
Оценщик полезен только если отвергает плохие ответы, поэтому я подал ему четыре неверные конфигурации — все четыре были отвергнуты.
Протестируйте альтернативы внедрения с Gemini 4 Carbon
Gemini 4 Carbon проверила оба разрешённых изменения и предпочла раздельные пороги при исходном лимите дополнительным проверяющим. Это решение помечено как исключение, требующее одобрения человека.
Проверьте увеличение ёмкости ручной проверки
Один глобальный порог работает, если поднять лимит с 200 до 205; оценщик подтвердил, что 205 — минимальное увеличение. Всё же Gemini 4 Carbon поставила этот вариант на второе место из‑за правила предпочтений, описанного ранее.
Проверьте отдельные пороги для каждого платёжного канала
Со стороны каналов агент удерживал порог Mobile App у границы (он уже видел, что 0,109 ломает нижний предел) и поднимал порог Website, сокращая флаги по легитимным заказам Website. Он протестировал семь пар, причём одна не прошла из‑за одного флага в самый загруженный день. Рекомендованы Website 0,3 и Mobile App 0,1, поскольку пара проходит все правила с запасом; оценщик подтвердил её при исходном лимите.
Сравните проверенные альтернативы
Эти числа уже встречались выше; оценщик пересчитал каждое:
Вариант
Пороги
Итого
Website
Mobile App
Самый загруженный день
Одобрение
Исходная политика
Глобальный 0,108
87,5%
98,2%
70,1%
205, лимит 200
Не проходит
Больше ёмкости
Глобальный 0,108
87,5%
98,2%
70,1%
205, лимит 205
Нужно одобрение
Разделение по каналам
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, лимит 200
Нужно одобрение
Разделение по каналам также помечает примерно на 6% меньше транзакций, чем вариант с увеличением ёмкости. Однако менее половины помеченных — это мошенничества, и отчёт отметил это как открытый вопрос.
Как проверить рекомендацию Gemini 4 Carbon на невиданных данных
Вы проверяете рекомендацию, применяя её в замороженном виде к запечатанному холд‑ауту. Отличие от оценщика — в данных: оценщик считал недели, доступные агенту, а холд‑аут — это четыре последующие недели, которые инструменты не могли прочесть. Проверка запускается один раз на замороженную рекомендацию и не стартует, если отчёт изменился после заморозки.
Замороженная рекомендация проходит на холд‑ауте. Изображение автора.
Все три правила были выполнены, и самый загруженный день остался ниже лимита. Но не переоценивайте результат. Три момента делают его умеренным:
Холд‑аут создан тем же генератором, так что он ничего не говорит о новом виде мошенничества или дрейфе данных
Общий recall превысил 85% менее чем на два пункта
Непроверенная догадка: разделение может нарушить лимит, если трафик Mobile App вырастет быстрее Website, потому что порог Mobile App расположен очень низко
Первые два вывода продиктованы цифрами.
Посмотрите полный аудит в Streamlit
В репозитории есть и приложение Streamlit, и шесть записанных попыток, так что вы можете открыть этот аудит без API‑вызова. В видео я загружаю его и прохожу по вкладкам.
Приложение Streamlit показывает один аудит. Видео автора.
Gemini 4 Carbon: Medium против High по уровню рассуждений — точность, время и стоимость
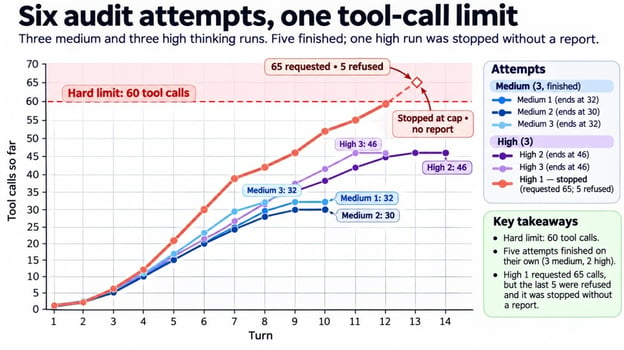
Успех здесь — уложиться в ограничения приложения и вернуть отчёт, принятый оценщиком. Остановленная попытка не даёт вердикта для оценки. По этому определению medium завершил все попытки и стоил менее половины за один корректный аудит.
Шести попыток слишком мало, чтобы делать общий вывод. Если уровни рассуждений для вас в новинку, в нашем учебнике по Gemini 3.8 Flash APIthinking_level разобран подробнее.
Сравните уровни medium и high на одном аудите
Полное сравнение за пределами TL;DR. Я провёл по три попытки на уровень, каждая — из чистого состояния, без памяти о других, с идентичными данными, промптом, инструментами, лимитами и оценщиком:
На уровень
medium
high
Попытки, завершившиеся отчётом
3 из 3
2 из 3
Корректные аудиты среди них
3 из 3
2 из 2
Токены рассуждений на попытку
Около 7 700
Около 17 500
Время на попытку
Около 5 минут
Около 6 минут
Стоимость за корректный аудит, вступительный тариф
Около $0,25
Около $0,62
Стоимость за корректный аудит, стандартный тариф
Около $0,51
Около $1,24
В строках со стоимостью учтены траты каждой попытки, включая остановленную. Каждый завершённый запуск пришёл к одному вердикту и конфликту и выбрал пару по каналам, принятую оценщиком, так что дополнительное рассуждение ушло на большее число проверок.
Похожую картину я наблюдал в эксперименте с Gemini 4 Argon по коду: highтратил больше и делал больше работы при небольшом изменении проверенного результата. Задачи разные, поэтому их стоимость и доля успеха напрямую несопоставимы. В обоих случаях независимая проверка даёт больше информации, чем сумма рассуждений.
Почему одна попытка на high не завершилась
Остановившаяся попытка была первой на high и не выдала неверного вердикта. Она прозондировала каждую точку сетки от 0,101 до 0,119, затем занялась поиском 70%‑й границы для Website, от которой ничего не зависело, и продолжала просить проверки, пока не упёрлась в лимит 60 вызовов, заданный ранее, после чего приложение остановило процесс до написания отчёта.
Только одна попытка дошла до лимита. Изображение автора.
Именно эта остановка и полезна. Просьба в промпте «запрашивать меньше» её бы не завершила, а лимит в коде — завершил, после примерно 22 центов.
Пять завершённых отчётов также прошли прочие проверки Python. Ни один не ошибся в текущей конфигурации, не назвал требование вне конфликта, не сослался на несуществующий вызов инструмента и не порекомендовал непроверенную конфигурацию.
Измеряйте токены, время и стоимость на аудит
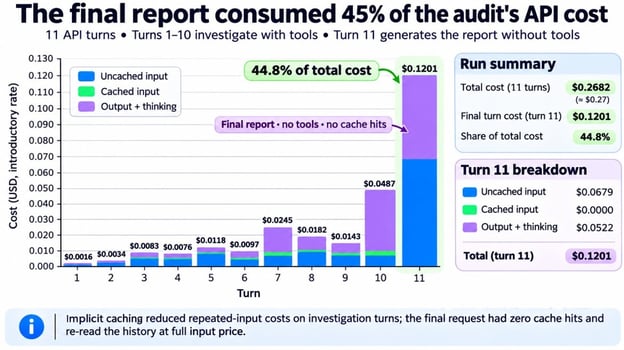
Стоимость аудита — сумма полей usage каждого хода, по $2,00 за миллион входных токенов, $0,10 — кэшированных и $10,00 — выходных, включая рассуждения; все ставки удваиваются 1 декабря 2026 года. Поле total_input_tokens включает кэшированные токены, так что код считает две части отдельно.
Ход с отчётом стоит дороже всего. Изображение автора.
Неожиданность — счёт за отчёт. Неявное кэширование покрывало около трёх четвертей входных токенов в ходах расследования, но запрос отчёта без инструментов не попал в кэш ни разу.
Вероятная причина — то, что исключение tools меняет начало запроса. Так или иначе, этот ход перечитал всю историю по полной цене и занял около 40% стоимости каждого завершённого запуска. Учтите этот ход при планировании лимита трат.
Ограничения использования Gemini 4 Carbon для аудита ML‑моделей
Я сам спроектировал тест и сгенерировал его данные, поэтому результаты имеют такие ограничения:
Данные синтетические и от одного классификатора; я подбирал генератор до появления конфликта — до любых API‑вызовов
Вердикт касается только этого классификатора; более удачный мог бы пройти все три правила единым порогом
Порог можно проверить алгоритмически, а вот одобрение разделения по каналам — деловое и этическое решение
В платном тарифе взаимодействия хранятся 55 дней по умолчанию, а store=false исключает previous_interaction_id, поэтому агент, который отправляет строки транзакций, требует проверки работы с данными
Оценщик сам по себе решает задачу подбора порога — без участия модели. Если вам нужен только порог, используйте оптимизационный солвер. То, что добавил Gemini 4 Carbon, — это аудит вокруг него.
Ничего здесь не привязано к мошенничеству. Сетап подходит для любой модели, чьи правила Python может измерить.
Заключение
Главный результат — Gemini 4 Carbon распознал, что по исходной политике не существует валидного глобального порога. Все 5 завершённых попыток назвали конфликт и предложили разделение по каналам, принятое оценщиком; одна попытка на high остановилась до формирования отчёта.
Эксперименты с Gemini 4 Argon и Gemini 4 Carbon проверяют надёжность агентов с двух сторон. Агент на Gemini 4 Argon менял код и должен был сохранить поведение, а агент на Gemini 4 Carbon принимал решение в условиях правил, делающих исходный ответ невозможным. В обоих случаях нужны узкие инструменты, лимиты ресурсов и проверка вне модели.
Это стандарт, которому я бы следовал для агента: определить, что его инструменты могут установить, независимо проверить результат и допускать ответ inconclusiveтам, где доказательств недостаточно. Далее я бы поместил два‑три кандидатных классификатора под одну политику и спросил, какой из них, если вообще какой‑то, готов к релизу.
FAQs
Как получить доступ к Gemini 4 Carbon API?⌄
Через платный проект Google AI Studio или через Gemini for business в Google Cloud. Приложение Gemini, Antigravity и AI Mode тоже предоставляют доступ подписчикам Google AI Ultra, но эти потребительские приложения не дают ключ API.
Сколько стоит Gemini 4 Carbon API?⌄
Все 6 аудитов здесь обошлись в $2,00 по вступительной ставке. Стандартные запросы получают неявное кэширование после превышения 4 096 входных токенов, так что сохраняйте начало каждого запроса идентичным. Flex inference, который также поддерживают запросы Interactions, вдвое снижает тарификацию токенов в обмен на более медленные и менее надёжные ответы.
Каковы лимиты скорости для Gemini 4 Carbon API?⌄
В платных проектах есть поминутные лимиты и лимит трат: $10 за скользящее окно в 10 минут на уровне Tier 1. Превышение возвращает 429 RESOURCE_EXHAUSTED. Один аудит здесь стоит менее $1, так что только множество параллельных запусков упрётся в лимит. Лимиты растут с уровнем, поэтому смотрите страницу лимитов для вашего проекта.
В чём разница между уровнями medium и high в Gemini 4 Carbon?⌄
В Gemini 4 Carbon три уровня: low, medium (по умолчанию) и high. Здесь я сравнивал только два старших. Чтобы увидеть, как выглядит дополнительное рассуждение, установите thinking_summariesв "auto" — вы получите сжатые сводки рядом с каждым ответом. По умолчанию они выключены и могут быть пустыми, когда модель почти не рассуждает.
Может ли Gemini 4 Carbon выполнять код на Python?⌄
Да. Добавьте {"type": "code_execution"} в tools— и Gemini 4 Carbon сможет писать и запускать Python на стороне Google, тарифицируясь по обычным ставкам за токены. Я оставил это за бортом, чтобы сохранить контроль на своей стороне: три инструмента определяют, что можно измерить, а сырые транзакции и холд‑аут не покидают мою машину.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.


В нашем учебнике по Gemini 4 Argon API агент выполнял чёткую задачу: найти медленный код, исправить его и пройти скрытые тесты. Этот сопутствующий эксперимент сохраняет тот же шаблон с контролируемыми инструментами и внешней проверкой, но меняет тип решения. Gemini 4 Carbon должен понять, можно ли вообще удовлетворить исходные правила.
PayGuard, вымышленный интернет‑магазин, использует обученную ML‑модель, которая оценивает заказы на предмет мошенничества. Политика внедрения требует, чтобы модель отлавливала достаточно мошеннической стоимости в целом и по каждому каналу продаж, не перегружая команду ручной проверки. Агент должен исследовать эти правила, не зная заранее, существует ли допустимый порог.
Gemini 4 Carbon — это модель рассуждений Google, к которой вы обращаетесь из Python через Interactions API. Здесь она выступает как ИИ‑агент: выбирает, какие проверки запросить, а Python запускает их через три инструмента только для чтения с помощью function calling. Вопрос в том, сможет ли она выявить конфликт, объяснить доказательства и предложить разрешённое изменение, не считая это изменение заранее одобренным.
Потребуются базовые знания Python и небольшой опыт работы с API‑запросами. Я определяю каждую метрику мошенничества перед тем, как использовать её в расчётах. Мы разберём, как:
Если вам нужна история запуска и бенчмарки, они есть в нашем обзоре Gemini 4 Carbon, а сравнение моделей смотрите в материале Claude Fable 5.2 vs. Gemini 4 Carbon. Этот эксперимент я проводил на следующий день после открытия API для платных разработчиков.
Что такое Gemini 4 Carbon API?
Gemini 4 Carbon API — это платный интерфейс программирования приложений (API) для
gemini-4-carbon, который на странице модели описан как модель рассуждений для длинных, многошаговых задач агентов. Вход, рассуждения и вывод разделяют контекстное окно на 1 048 576 токенов, а синхронный ответ по умолчанию останавливается на 65 536 токенах рассуждений плюс вывода.Почему аудит ML‑модели — хороший тест для Gemini 4 Carbon
Задача требует нескольких проверок, поиска среди разрешённых изменений и чёткого стоп‑сигнала, когда правила не оставляют ответа. Я выбрал её, потому что Python может вычислить эталонный результат. В карте модели среди известных ограничений Gemini 4 Carbon указаны галлюцинации, поэтому модель исследует, а Python решает, выдерживает ли её рекомендация проверку.
Проект: можно ли вывести антифрод‑модель PayGuard в прод
PayGuard — вымышленный магазин из вступления, полный проект лежит в репозитории на GitHub. Классификатор уже обучен.
Как PayGuard оценивает транзакции
У каждой транзакции есть отметка времени в UTC, сумма, канал (Website или Mobile App), риск‑балл и метка мошенничества. Модель scikit‑learn
HistGradientBoostingClassifierвыдаёт риск‑балл, округлённый до 0,001, и PayGuard помечает транзакцию, когдаrisk_score >= threshold. Наш учебник по кривой precision‑recall показывает, как сдвиг порога меняет состав флагов, а курс Fraud Detection in Python освещает моделирование.Синтетические данные разбиты по времени:
Текущий порог — 0,5, данные и политика в ходе эксперимента не меняются. В этих данных мошенничество на Website оставляет явные сигналы, а большинство мошенничеств в Mobile App выглядит как обычный заказ.
Gemini 4 Carbon спрашивает, Python решает. Изображение автора.
Три правила внедрения PayGuard
Вот три правила из вступления, в формулировке, принятой в политике. Это вымышленные целевые значения, выбранные для эксперимента:
Recall по стоимости мошенничества — это стоимость помеченного мошенничества, делённая на общую стоимость мошенничества. В отличие от recall на уровне транзакций в нашем гайде по precision против recall, пропуск мошенничества на $2 000 весит гораздо больше, чем пропуск на $15, и флаг не означает, что деньги спасены. R3 ограничивает самый загруженный день — именно эта формулировка в итоге решает исход аудита.
Агент может исследовать два изменения: дневную ёмкость до 260 при одном пороге или раздельные пороги по каналам при исходном лимите. Оба варианта требуют одобрения человека, они не комбинируются, и политика предпочитает вариант без дополнительных проверяющих.
Что считается корректным аудитом
Корректный аудит даёт четыре верных ответа, и их стоит зафиксировать до первого запроса:
Ответ вычисляет независимый оценщик, к которому агент обратиться не может.
Как настроить Gemini 4 Carbon API в Python
Настройка Gemini 4 Carbon API требует Python 3.11 или новее и ключа API из проекта Google AI Studio с включённым биллингом, поскольку на странице цен нет бесплатного тарифа.
Установите Google Gen AI SDK и подготовьте проект
Я тестировал проект с SDK Google Gen AI, зафиксированным на версии
google-genai==3.1.0— это релиз дня запуска на PyPI, гдеgemini-4-carbonдобавили в список моделей Interactions. Клонируйте проект и установите его в виртуальное окружение:Затем выполните две команды со страницы репозитория для сборки данных и обучения классификатора с фиксированными сидами. На свежем клонe они выводят следующее:
Фиксированные сиды пересобирают тот же датасет. Изображение автора.
Затем добавьте
GEMINI_API_KEY=your-keyв файл.env. Репозиторий загрузит его, не печатая.Сделайте первый запрос к Gemini 4 Carbon API
Запустите этот законченный пример из папки проекта. Он передаёт Gemini 4 Carbon политику и сводку классификатора и спрашивает, что нужно измерить, не намекая на конфликт:
Уровень рассуждений указывается в
generation_config, аoutput_textсодержит ответ. Вот часть ответа:Она прочитала R3 как пиковое значение и распланировала порядок предпочтений политики ещё до численных данных. Однако не спросила, как обрабатываются равные значения и округление скорингов, а исчерпывающая проверка, показанная ниже, как раз зависит от этого. Вызов занял около 40 секунд и стоил около 2 центов.
Не указывайте
temperature,top_pиtop_k— Gemini 4 Carbon их игнорирует, а такжеthinking_budget.Как создать агента аудита ML с function calling в Gemini 4 Carbon
Агент аудита Gemini 4 Carbon — это цикл: модель запрашивает оценку, Python валидирует и запускает её, затем возвращает результат, пока модель не прекратит запросы.
Определите инструменты только для чтения для оценки модели
У агента три инструмента. Все ограничены окном валидации:
get_audit_context: сводка классификатора, текущая конфигурация, политика и разрешённые измененияevaluate_global_threshold: recall по стоимости мошенничества в целом и по каналам, флаги по дням и диагностика для одного порогаevaluate_policy_change: те же измерения для увеличения ёмкости или пары порогов по каналамПолные схемы в репозитории. В этом упрощённом фрагменте опущены поля порогов и ёмкости, поэтому копировать его как готовое объявление нельзя. Он лишь показывает важную границу: инструмент принимает два изменения политики, разрешённые PayGuard, читает валидационные данные и ничего не утверждает.
Python валидирует опущенные поля порога и ёмкости, отклоняет изменения вне политики и возвращает измерения вместо флагов «пройдено/не пройдено». Агент не может добраться до холд‑аута, вызвать оценщик или изменить политику. В разделе FAQ я объясняю, почему не стал использовать встроенное выполнение кода в Gemini 4 Carbon.
Дайте агенту чёткую цель и правила остановки
Системная инструкция задаёт метод. Как и первый запрос, она не подсказывает, где конфликт:
Промпт может только просить, поэтому ограничения живут в обвязке агента — Python‑коде вокруг модели. Поскольку в API нет параметра бюджета, приложение задаёт их на попытку: 25 ходов, 60 вызовов инструментов, 30 минут и $3, с проверкой трат между ходами.
Реализуйте цикл function calling с Interactions API
Каждый ход — это один вызов
client.interactions.create(). Gemini 4 Carbon часто запрашивает несколько инструментов сразу, поэтому цикл обрабатывает каждый шагfunction_call. Это основной цикл; в репозитории добавлены логирование и проверки лимитов:Я держу эти настройки в одном словаре
request, чтобы каждое последующее обращение пересылало их.previous_interaction_idнесёт историю, ноtools,system_instructionиgeneration_configприменяются только к одному взаимодействию. Если ход завершается со статусомincomplete, значит, его обрезалmax_output_tokens, и за токены рассуждений вы всё равно платите.Верните структурированный отчёт аудита по JSON‑схеме
В руководстве по структурированным ответам Google указано: инструменты плюс JSON‑схема в одном запросе — это функция Preview, доступная и для Gemini 4 Carbon. Я всё же разделил: в ходах расследования мы только измеряем, а финальный ход на той же истории и конфигурации пишет отчёт по схеме и без инструментов:
AuditReport— это модель Pydantic с вердиктом, конфликтом, доказательствами, рекомендацией и одобрениями. Время и стоимость считает Python, не прося Gemini 4 Carbon их сообщать.Запустите аудит Gemini 4 Carbon для модели обнаружения мошенничества
Gemini 4 Carbon провела аудит модели так, как я ожидал бы от младшего аналитика: сначала измерения, затем выводы. В первой попытке с уровнем
mediumона прочитала контекст аудита, проверила около двух десятков единых порогов и протестировала восемь вариантов изменений политики.Все 32 вызова инструментов по порядку. Изображение автора.
Оцените текущий порог PayGuard
Агент оценил текущий порог 0,5 и получил 91% recall для Website, 20% для Mobile App, 64% в целом и 85 флагов в самый загруженный день. Это не проходит R1 и часть R2 для Mobile App при запасе по R3, так что очевидный шаг — понизить порог.
Проверьте recall по стоимости против дневной ёмкости на проверку
Понижение порога ловит больше стоимости мошенничества и отправляет на проверку больше заказов. PayGuard нужно достаточно первого, удерживая второе под дневным лимитом.
Агент попробовал несколько грубых порогов одним батчем, затем сузился до отдельных точек сетки. Решение дали вызовы 11, 12, 17 и 18 в трассе.
На этом окне валидации для Mobile App нижняя граница — 0,108 или ниже, поскольку шаг выше опускает показатель чуть ниже 70%. Лимит по ёмкости требует 0,118 или выше. Ни один порог не удовлетворяет обоим условиям.
Общий recall держится до 0,137, так что R1 вне конфликта. При 0,108 средний день даёт около 169 флагов, а лимит превышается только в одну субботу. Поэтому в политике используется нагрузка самого загруженного дня, а не среднее.
Recall Mobile и ёмкость не пересекаются. Изображение автора.
Проверьте качество по обоим платёжным каналам
Мошенничество в Mobile App со слабыми сигналами лежит низко в диапазоне баллов. Опускание единого порога до 0,108 ради Mobile App также втягивает больше легитимных заказов с Website, и в ту субботу они превышают лимит.
Общий показатель это скрывает: при 0,118 общий recall около 87%, тогда как Mobile App ниже своего порога. Если в вашей политике названы сегменты, измеряйте каждый: сумма может проходить, а сегмент — нет.
Может ли Gemini 4 Carbon выявлять конфликтующие требования внедрения?
Да, в этом аудите. Замороженный отчёт говорит
not deployable, утверждает, что единый порог не работает, и называет конфликтом R2 для Mobile App и R3.Сверьте вердикт Gemini 4 Carbon с его доказательствами
Каждое число в отчёте совпадает с результатом инструмента, но одно предложение заявляет больше, чем агент измерил. Сказано, что ни один порог не работает «по всем точкам сетки риск‑балла с шагом 0,001», хотя агент проверил лишь два десятка из 1 002 возможных порогов.
Утверждение верно, потому что recall и дневные количества падают при росте порога, чего отчёт не проговаривает. Сверяйте каждое заявление в отчёте агента с тем, что он измерил; подробнее об этом — в нашем гайде по оценке ИИ‑агентов.
Подтвердите конфликт исчерпывающим Python‑оценщиком
Gemini 4 Carbon пробывала пороги и сделала вывод, что ни один не подойдёт. Оценщик доказывает этот результат для данного валидационного набора, проверяя каждый возможный набор флагов, не разделяя код с инструментами.
Балы лежат на сетке 0,001, так что 1 002 кандидатных отсечки покрывают все возможные наборы флагов. Оценщик проверяет их все, плюс каждую пару порогов по каналам, используя целые центы для точности 85% и 70%.
Исчерпывающая проверка и четыре отклонённые конфигурации. Изображение автора.
Ни один глобальный порог не проходит все три правила, так что тезис Gemini 4 Carbon теперь подкреплён доказательством. Оценщик совпал с границами 0,108 и 0,118 из зондирования агента и нашёл тысячи пар по каналам, проходящих при лимите 200 в день.
Оценщик полезен только если отвергает плохие ответы, поэтому я подал ему четыре неверные конфигурации — все четыре были отвергнуты.
Протестируйте альтернативы внедрения с Gemini 4 Carbon
Gemini 4 Carbon проверила оба разрешённых изменения и предпочла раздельные пороги при исходном лимите дополнительным проверяющим. Это решение помечено как исключение, требующее одобрения человека.
Проверьте увеличение ёмкости ручной проверки
Один глобальный порог работает, если поднять лимит с 200 до 205; оценщик подтвердил, что 205 — минимальное увеличение. Всё же Gemini 4 Carbon поставила этот вариант на второе место из‑за правила предпочтений, описанного ранее.
Проверьте отдельные пороги для каждого платёжного канала
Со стороны каналов агент удерживал порог Mobile App у границы (он уже видел, что 0,109 ломает нижний предел) и поднимал порог Website, сокращая флаги по легитимным заказам Website. Он протестировал семь пар, причём одна не прошла из‑за одного флага в самый загруженный день. Рекомендованы Website 0,3 и Mobile App 0,1, поскольку пара проходит все правила с запасом; оценщик подтвердил её при исходном лимите.
Сравните проверенные альтернативы
Эти числа уже встречались выше; оценщик пересчитал каждое:
Вариант
Пороги
Итого
Website
Mobile App
Самый загруженный день
Одобрение
Исходная политика
Глобальный 0,108
87,5%
98,2%
70,1%
205, лимит 200
Не проходит
Больше ёмкости
Глобальный 0,108
87,5%
98,2%
70,1%
205, лимит 205
Нужно одобрение
Разделение по каналам
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, лимит 200
Нужно одобрение
Разделение по каналам также помечает примерно на 6% меньше транзакций, чем вариант с увеличением ёмкости. Однако менее половины помеченных — это мошенничества, и отчёт отметил это как открытый вопрос.
Как проверить рекомендацию Gemini 4 Carbon на невиданных данных
Вы проверяете рекомендацию, применяя её в замороженном виде к запечатанному холд‑ауту. Отличие от оценщика — в данных: оценщик считал недели, доступные агенту, а холд‑аут — это четыре последующие недели, которые инструменты не могли прочесть. Проверка запускается один раз на замороженную рекомендацию и не стартует, если отчёт изменился после заморозки.
Замороженная рекомендация проходит на холд‑ауте. Изображение автора.
Все три правила были выполнены, и самый загруженный день остался ниже лимита. Но не переоценивайте результат. Три момента делают его умеренным:
Первые два вывода продиктованы цифрами.
Посмотрите полный аудит в Streamlit
В репозитории есть и приложение Streamlit, и шесть записанных попыток, так что вы можете открыть этот аудит без API‑вызова. В видео я загружаю его и прохожу по вкладкам.