Gemini 4 Carbon API‑handledning: Bygg en agent som granskar en bedrägerimodell
Lär dig Gemini 4 Carbon API i Python: bygg en agent med funktionsanrop som granskar en bedrägerimodell, hittar motstridiga regler och testar en policyändring.
I vår Gemini 4 Argon API‑handledning hade agenten ett tydligt uppdrag: hitta långsam kod, ändra den och klara dolda tester. Det här kompletterande experimentet behåller samma mönster med kontrollerade verktyg och en extern kontroll, men ändrar beslutet. Gemini 4 Carbon måste avgöra om de ursprungliga reglerna överhuvudtaget går att uppfylla.
PayGuard, en fiktiv nätbutik, har en tränad maskininlärningsmodell (ML) som poängsätter beställningar för bedrägeri. Dess driftsättningspolicy kräver att modellen fångar tillräckligt med bedrägerivärde totalt sett och på varje säljkanal utan att överbelasta granskningsteamet. Agenten måste undersöka dessa regler utan att få veta om det finns en giltig tröskel.
Gemini 4 Carbon är en Google‑resonemangsmodell som du anropar från Python via Interactions API. Här agerar den som en AI‑agent: den väljer vilka kontroller som ska begäras, och Python kör dem via tre skrivskyddade verktyg med funktionsanrop. Min fråga är om den kan identifiera konflikten, förklara underlaget och rekommendera en tillåten ändring utan att behandla den ändringen som godkänd.
Du behöver grundläggande Python och lite erfarenhet av API‑anrop. Jag definierar varje bedrägerimått innan siffrorna använder det. Vi går igenom hur du:
Skickar en första förfrågan till Gemini 4 Carbon från Python
Ger modellen skrivskyddade verktyg och kör dem i en loop med gränser
Hämtar utslaget som JSON som din kod kan kontrollera
Verifierar det utslaget med kod och data som modellen aldrig ser
Jämför två tänkenivåer, som styr hur mycket modellen resonerar innan den svarar
Om du vill ha lanseringsberättelsen och benchmarkresultaten hittar du dem i vår översikt av Gemini 4 Carbon, och vår jämförelse Claude Fable 5.2 vs. Gemini 4 Carbon ställer modellerna mot varandra. Jag körde det här experimentet dagen efter att Google öppnade API:et för betalande utvecklare.
Vad är Gemini 4 Carbon API?
Gemini 4 Carbon API är det betalda programgränssnittet (API) för gemini-4-carbon, som modellsidan beskriver som en resonemangsmodell för långa, flerstegiga agentuppgifter. Inmatning, tänk och utdata delar ett kontextfönster på 1 048 576 token, och ett synkront svar stannar vid 65 536 token för tänk plus utdata som standard.
Varför en ML‑modellgranskning är ett bra test för Gemini 4 Carbon
Uppgiften kräver flera kontroller, en sökning genom tillåtna ändringar och ett tydligt stopp när reglerna lämnar inget svar. Jag valde den eftersom Python kan räkna ut referensresultatet. Modellkortet listar hallucinationer bland kända begränsningar för Gemini 4 Carbon, så modellen undersöker medan Python avgör om dess rekommendation håller.
Projektet: Avgöra om PayGuards bedrägerimodell kan gå i drift
PayGuard är den fiktiva butiken från introt, och hela projektet finns i GitHub‑arkivet. Dess klassificerare är redan tränad.
Hur PayGuard poängsätter transaktioner
Varje transaktion har en UTC‑tidsstämpel, ett belopp, en kanal (Website eller Mobile App), en riskscore och en bedrägerietikett. En scikit‑learn HistGradientBoostingClassifier genererar scoren, avrundad till 0,001, och PayGuard flaggar en transaktion när risk_score >= threshold. Vår handledning om precision‑recall‑kurvan visar hur en förflyttad tröskel ändrar vad som flaggas, och vår kurs Fraud Detection in Python täcker modelleringsdelen.
Den syntetiska datan är tidsuppdelad:
Träning: de första nio veckorna, används bara för att passa klassificeraren
Validering: de följande fyra veckorna, det enda fönstret som verktygen kan läsa
Holdout: de fyra veckorna därefter, förseglade tills rekommendationen är fryst
Den aktuella tröskeln är 0,5, och data och policy ändras aldrig under experimentet. Bedrägeri på Website lämnar tydliga signaler i den här datan, medan de flesta Mobile App‑bedrägerier ser ut som en vanlig order.
Gemini 4 Carbon frågar, Python avgör. Bild av författaren.
PayGuards tre driftsättningsregler
Här är de tre reglerna från introt, skrivna som policyn uttrycker dem. Alla är fiktiva mål jag valde för det här experimentet:
R1: flaggade transaktioner täcker minst 85 % av det etiketterade bedrägerivärdet totalt
R2: de täcker minst 70 % av det etiketterade bedrägerivärdet inom varje kanal
R3: högst 200 transaktioner flaggas under en och samma UTC‑dag
Bedrägerivärdets recall är värdet av flaggat bedrägeri delat med det totala värdet av bedrägeri. Till skillnad från transaktionsnivåns recall i vår guide om precision kontra recall väger ett missat bedrägeri på $2 000 mycket tyngre än ett missat på $15, och att flagga betyder inte att pengarna räddades. R3 begränsar den mest belastade enskilda dagen, och den formuleringen avgör till slut granskningen.
Agenten får undersöka två ändringar: en daglig kapacitet upp till 260 med en tröskel, eller separata kanaltrösklar vid det ursprungliga taket. Båda kräver mänskligt godkännande, de kan inte kombineras, och policyn föredrar alternativet utan extra granskare.
Vad som räknas som en korrekt granskning
En korrekt granskning sätter fyra saker rätt, och du bör bestämma dem före första förfrågan:
Utslaget: huruvida någon enskild tröskel uppfyller R1, R2 och R3 på valideringen
Konflikten: vilka krav som gör den ursprungliga policyn omöjlig
Alternativet: en tillåten ändring som klarar varje regel när Python räknar om den
En utvärderare som agenten inte kan anropa räknar ut svaret.
Så ställer du in Gemini 4 Carbon API i Python
Att sätta upp Gemini 4 Carbon API kräver Python 3.11 eller nyare och en API‑nyckel från ett Google AI Studio‑projekt med fakturering påslagen, eftersom prissidan inte listar någon gratisnivå.
Installera Google Gen AI SDK och förbered projektet
Jag testade det här projektet med Google Gen AI‑SDK låst till google-genai==3.1.0, lanseringsdagens release på PyPI som lade till gemini-4-carbon i Interactions modellista. Klona projektet och installera det i en virtuell miljö:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS or Linux: source .venv/bin/activate
pip install-r requirements.txtDrivs av
Kör sedan de två kommandona på arkivsidan som bygger datan och tränar klassificeraren med fasta frön. I en ny klon skriver de ut detta:
Fasta frön återskapar samma dataset. Bild av författaren.
Lägg sedan in GEMINI_API_KEY=din-nyckel i en .env‑fil. Arkivet laddar den utan att skriva ut den.
Gör din första förfrågan till Gemini 4 Carbon API
Kör det här kompletta exemplet från projektmappen. Det ger Gemini 4 Carbon policyn och klassificerarens sammanfattning och frågar vad den skulle behöva mäta, utan att antyda en konflikt:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Drivs av
Tänkenivån sätts i generation_config, och output_text innehåller svaret. Här är en del av vad som kom tillbaka:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Drivs av
Den tolkade R3 som en topp och planerade policyns preferensordning innan den såg en siffra. Den frågade aldrig hur lika värden eller scoreavrundning fungerar, och den uttömmande kontroll jag visar senare beror just på det. Anropet tog cirka 40 sekunder och kostade cirka 2 cent.
Lämna ute temperature, top_p och top_k, som Gemini 4 Carbon ignorerar, samt thinking_budget.
Så bygger du en ML‑granskningsagent med Gemini 4 Carbon‑funktionsanrop
En Gemini 4 Carbon‑granskningsagent är en loop: modellen begär en utvärdering, Python validerar och kör den, och resultatet skickas tillbaka tills modellen slutar fråga.
Definiera skrivskyddade verktyg för modellevaluering
Agenten får tre verktyg. Alla är begränsade till valideringsfönstret:
get_audit_context: klassificerarens sammanfattning, aktuell konfiguration, policy och tillåtna ändringar
evaluate_global_threshold: recall för bedrägerivärde totalt och per kanal, flaggar per dag samt diagnostik för en tröskel
evaluate_policy_change: samma mätningar för en kapacitetsökning eller ett par kanaltrösklar
De fullständiga schemana finns i arkivet. Det här förenklade utdraget utelämnar tröskel- och kapacitetsfält, så det är inte en komplett deklaration att kopiera. Det visar bara gränsen som är viktig här: verktyget accepterar de två policyändringar som PayGuard tillåter, läser valideringsdata och godkänner inget.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Drivs av
Python validerar de utelämnade tröskel- och kapacitetsfälten, avvisar ändringar utanför policyn och returnerar mätvärden i stället för pass/fail‑flaggor. Agenten kan inte nå holdouten, anropa utvärderaren eller ändra policyn. I FAQ:n förklarar jag varför jag hoppade över Gemini 4 Carbons inbyggda kodkörning.
Ge agenten ett tydligt mål och stoppregler
Systeminstruktionen sätter metoden. Liksom den första förfrågan antyder den inte var konflikten finns:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.Drivs av
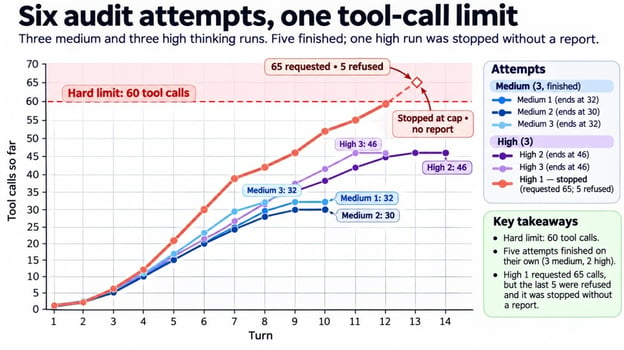
Prompten kan bara be, så gränserna ligger i agentens hölje, Python‑koden runt modellen. Eftersom API:et saknar budgetinställning sätter applikationen dem per försök: 25 varv, 60 verktygsanrop, 30 minuter och $3, med kostnadskontroll mellan varven.
Implementera funktionsanropsloopen med Interactions API
Varje varv är ett client.interactions.create()‑anrop. Gemini 4 Carbon begär ofta flera verktyg samtidigt, så loopen kör varje function_call‑steg. Det här är kärnloopen, och arkivversionen lägger till loggning och gränskontroller:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Drivs av
Jag behåller dessa inställningar i en request‑dict så att varje uppföljningsanrop skickar dem igen. previous_interaction_id bär historiken, men tools, system_instruction och generation_config gäller bara för en interaktion. Om ett varv slutar som incomplete, kapade max_output_tokens av det, och du betalar ändå för dess tänketoken.
Returnera en strukturerad granskningsrapport med ett JSON‑schema
Googles guide för strukturerad utdata listar verktyg plus ett JSON‑schema i en och samma förfrågan som en förhandsvisningsfunktion som inkluderar Gemini 4 Carbon. Jag höll dem ändå åtskilda: undersökningsvarven mäter bara, och ett sista varv på samma historik och konfiguration skriver rapporten med ett schema och utan verktyg:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Drivs av
AuditReport är en Pydantic‑modell med utslag, konflikt, underlag, rekommendation och godkännanden. Python mäter tid och kostnad i stället för att be Gemini 4 Carbon rapportera dem.
Kör Gemini 4 Carbon‑granskningen på bedrägeridetektionsmodellen
Gemini 4 Carbon granskade modellen som jag skulle vilja att en junior analytiker gör, med mätningar före någon slutsats. Vid första medium‑försöket läste den granskningskontexten, kontrollerade ett par dussin enskilda trösklar och testade åtta policyändringar.
Alla 32 verktygsanrop, i ordning. Bild av författaren.
Utvärdera PayGuards nuvarande tröskel
Agenten utvärderade den nuvarande tröskeln 0,5 och fann 91 % recall för Website, 20 % för Mobile App, 64 % totalt och 85 flaggor på den mest belastade dagen. Det missar R1 och Mobile App‑delen av R2 med marginal under R3, så den uppenbara åtgärden är en lägre tröskel.
Testa recall för bedrägerivärde mot daglig granskarkapacitet
Att sänka en tröskel fångar mer bedrägerivärde och skickar fler order till granskning. PayGuard behöver tillräckligt av det första samtidigt som det andra hålls under ett dagligt tak.
Agenten provade några grova trösklar i en batch och smalnade sedan av till enskilda rutnätspunkter. Anrop 11, 12, 17 och 18 i spåret avgjorde det.
I det här valideringsfönstret kräver Mobile App‑golvet 0,108 eller lägre, eftersom ett steg högre sänker det precis under 70 %. Taket kräver 0,118 eller högre. Ingen tröskel klarar båda.
Den totala recallen håller upp till 0,137, så R1 ligger utanför konflikten. Vid 0,108 har genomsnittsdagen omkring 169 flaggor, och bara en lördag går över. Det är därför policyn använder den mest belastade dagens arbetsbelastning snarare än dagssnittet.
Mobilrecall och kapacitet överlappar aldrig. Bild av författaren.
Kontrollera prestanda över båda betalningskanalerna
Mobile App‑bedrägerier, med sina svagare signaler, ligger lågt i scoreintervallet. Att dra ner en tröskel till 0,108 för Mobile App drar också in fler legitima Website‑order, och den där lördagen driver de upp totalen över taket.
Totalsiffran döljer det: vid 0,118 är total recall cirka 87 % medan Mobile App ligger under sitt golv. Om din policy namnger segment, mät varje, eftersom totalen kan klara sig medan ett segment faller.
Kan Gemini 4 Carbon upptäcka motstridiga driftsättningskrav?
Ja, i den här granskningen. Den frysta rapporten säger not deployable, säger att ingen enskild tröskel fungerar och namnger R2 för Mobile App och R3 som konflikten.
Kontrollera Gemini 4 Carbons driftsättningsutslag mot dess underlag
Varje siffra som rapporten hänvisar till matchar ett verktygsresultat, men en mening påstår mer än vad agenten mätte. Den säger att ingen tröskel fungerar ”över alla 0,001‑riskscores rutnätspunkter”, men agenten testade bara de två dussin i spåret ovan, av 1 002 möjliga trösklar.
Påståendet håller eftersom recall och dagliga antal båda faller när tröskeln stiger, vilket rapporten aldrig säger. Kontrollera varje påstående i en agents rapport mot vad den mätte, och vår guide till utvärdering av AI‑agenter tar upp fler kontroller av det här slaget.
Verifiera konflikten med en uttömmande Python‑utvärderare
Gemini 4 Carbon samplade trösklar och drog slutsatsen att ingen kunde fungera. Utvärderaren bevisar det resultatet för detta valideringsset genom att kontrollera varje distinkt flagsats utan att dela kod med verktygen.
Scorer ligger på ett 0,001‑rutnät, så de 1 002 kandidatsnitten täcker varje möjlig flagsats. Utvärderaren kontrollerar alla, plus varje par kanaltrösklar, med heltalscent så att 85 % och 70 % blir exakta.
Uttömmande kontroll och fyra avvisade konfigurationer. Bild av författaren.
Ingen global tröskel klarar alla tre regler, så Gemini 4 Carbons påstående har nu bevis bakom sig. Utvärderaren matchade gränserna 0,108 och 0,118 från agentens sondering och fann tusentals kanalpar som klarar sig vid 200 per dag.
En utvärderare hjälper bara om den avvisar dåliga svar, så jag matade den med fyra felaktiga konfigurationer, och den avvisade alla fyra.
Testa driftsättningsalternativ med Gemini 4 Carbon
Gemini 4 Carbon testade båda tillåtna ändringar och valde separata trösklar vid det ursprungliga taket framför extra granskare. Den markerade valet som ett undantag som en person måste godkänna.
Testa en ökning av manuell granskarkapacitet
En global tröskel fungerar om taket höjs från 200 till 205, och utvärderaren bekräftade 205 som den minsta ökningen. Gemini 4 Carbon rankade ändå detta alternativ som nummer två, på grund av preferensregeln jag beskrev tidigare.
Testa separata trösklar för varje betalningskanal
På kanalsidan höll agenten Mobile App‑tröskeln nära dess gräns (den hade redan sett 0,109 bryta golvet) och höjde Website‑tröskeln, vilket minskade flaggor på legitima Website‑order. Den testade sju par, och ett föll på en enda flagga under den mest belastade dagen. Den rekommenderade Website 0,3 och Mobile App 0,1 eftersom det paret klarar varje regel med marginal, och utvärderaren bekräftade det vid det ursprungliga taket.
Jämför de verifierade alternativen
Dessa siffror dök upp ovan, och utvärderaren räknade om var och en:
Alternativ
Trösklar
Totalt
Website
Mobile App
Mest belastad dag
Godkännande
Ursprunglig policy
Global 0,108
87,5 %
98,2 %
70,1 %
205, tak 200
Underkänns
Mer kapacitet
Global 0,108
87,5 %
98,2 %
70,1 %
205, tak 205
Krävs
Kanaldelning
Website 0,3, Mobile App 0,1
86,2 %
94,5 %
72,8 %
191, tak 200
Krävs
Kanaldelningen flaggar också cirka 6 % färre transaktioner än kapacitetsalternativet. Mindre än hälften av dess flaggor är dock bedrägerier, vilket rapporten listade som en öppen fråga.
Så verifierar du Gemini 4 Carbons rekommendation på osedd data
Du verifierar rekommendationen genom att tillämpa den, fryst, på den förseglade holdouten. Skillnaden mot utvärderaren är datan: utvärderaren poängsatte veckor som agenten kunde se, och holdouten poängsätter fyra senare veckor som inget verktyg kunde läsa. Kontrollkörningen sker en gång per fryst rekommendation och startar inte om rapporten ändrades efter infrysningen.
Den frysta rekommendationen klarar holdouten. Bild av författaren.
Den klarade alla tre regler, och den mest belastade dagen höll sig under taket. Läs dock inte in för mycket i det. Tre saker gör resultatet måttligt:
Holdouten kommer från samma generator, så den säger inget om nya typer av bedrägerier eller datadrift
Total recall klarade 85 % med mindre än två punkter
Min otestade gissning: delningen kan spräcka taket om Mobile App‑trafiken växer snabbare än Website‑trafiken, eftersom Mobile App‑tröskeln ligger så lågt
De två första kommer från siffrorna.
Titta på hela granskningen i Streamlit
Arkivet innehåller också en Streamlit‑app och de sex inspelade försöken, så att du kan öppna den här granskningen utan ett API‑anrop. I videon laddar jag den och går igenom varje flik.
Streamlit‑appen visar en granskning. Video av författaren.
Gemini 4 Carbon medium vs. high thinking: noggrannhet, tid och kostnad
Framgång här innebär att slutföra inom applikationsgränserna och returnera en rapport som utvärderaren godkänner. Ett stoppat försök har inget utslag att betygsätta. Enligt den definitionen slutförde medium varje försök och kostade mindre än hälften per korrekt granskning.
Sex försök är för få för att göra det till en generell regel. Om tänkenivåer är nya för dig går vår Gemini 3.8 Flash API‑handledning igenom thinking_level mer i detalj.
Jämför medium och high thinking på samma granskning
Detta är den fulla jämförelsen bakom TL;DR. Jag körde 3 försök per nivå, varje från ett rent tillstånd utan minne av de andra, med identisk data, prompt, verktyg, gränser och utvärderare:
Per nivå
medium
high
Försök som slutfördes med en rapport
3 av 3
2 av 3
Korrekt granskningar bland dessa
3 av 3
2 av 2
Tänketoken per försök
Cirka 7 700
Cirka 17 500
Tid per försök
Cirka 5 minuter
Cirka 6 minuter
Kostnad per korrekt granskning, introduktionspris
Cirka $0,25
Cirka $0,62
Kostnad per korrekt granskning, ordinarie pris
Cirka $0,51
Cirka $1,24
Kostnadsraderna räknar varje försöks utgift, inklusive det som stoppades. Varje slutfört försök nådde samma utslag och konflikt och valde ett kanalpar som utvärderaren godkände, så det extra tänket gick åt till fler kontroller.
Jag såg ett liknande mönster i Gemini 4 Argon‑kodningsexperimentet: highspenderade mer och gjorde mer arbete för en mindre förändring i det verifierade resultatet. Uppgifterna är olika, så deras kostnader och framgångsgrader är inte direkt jämförbara. I båda fallen säger den oberoende kontrollen mer än tänketotalen.
Varför ett high‑försök aldrig slutfördes
Försöket som stoppades var highs första, och det gav aldrig ett felaktigt utslag. Det sonderade varje rutnätspunkt från 0,101 till 0,119 och gav sig sedan ut för att hitta Websites 70 %‑gräns, som inget berodde på, och det fortsatte be om fler kontroller tills det nådde 60‑anropsgränsen jag satte tidigare och applikationen stoppade det innan det skrev en rapport.
Endast ett försök träffade gränsen. Bild av författaren.
Det stoppet är den nyttiga delen. En prompt som ber om färre anrop hade inte avslutat det, och gränsen i kod gjorde det, efter cirka 22 cent.
De fem slutförda rapporterna klarade också Pythons andra kontroller. Ingen misstolkade den aktuella konfigurationen, namngav ett krav utanför konflikten, hänvisade till ett verktygsanrop som inte fanns eller rekommenderade en konfiguration som den inte hade testat.
Mät token, tid och kostnad per granskning
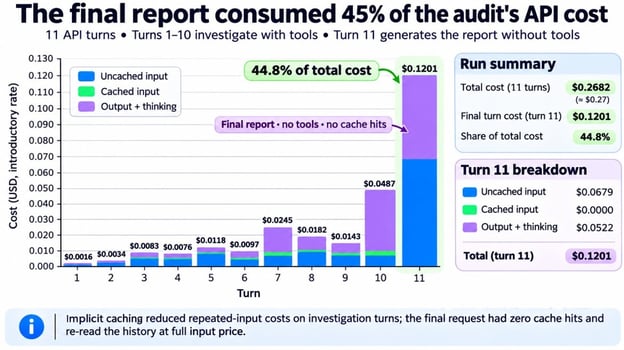
En granskning kostar summan av varje varvs usage, prissatt till $2,00 per miljon inputtoken, $0,10 cachade och $10,00 utdata inklusive tänk, allt som dubblas den 1 december 2026. total_input_tokens inkluderar cachade token, så koden prissätter de två delarna separat.
Rapportvarvet kostar mest. Bild av författaren.
Överraskningen var rapporten, eller mer exakt, dess nota. Implicit caching täckte omkring tre fjärdedelar av inputtoken i undersökningsvarven, men rapportförfrågan utan verktyg fick aldrig en cacheträff.
Den sannolika orsaken är att borttag av tools ändrar början av förfrågan. Oavsett så läste det varvet om hela historiken till fullt pris och stod för cirka 40 % av kostnaden för varje slutfört försök. Räkna med det varvet när du sätter din utgiftsgräns.
Begränsningar med att använda Gemini 4 Carbon för ML‑modellgranskning
Jag designade testet och genererade dess data själv, så resultaten har dessa begränsningar:
Datan är syntetisk och kommer från en klassificerare, och jag trimmade generatorn tills en konflikt fanns, före något API‑anrop
Utslaget gäller bara denna klassificerare, och en bättre kan klara alla tre regler med en tröskel
En tröskel kan kontrolleras, men att godkänna en kanaldelning är ett affärs‑ och rättvisebeslut
Interaktioner lagras i 55 dagar på den betalda nivån som standard, och store=false utesluter previous_interaction_id, så en agent som skickar transaktionsrader behöver en datagranskning
Utvärderaren löser tröskelproblemet på egen hand, utan modell inblandad. Om allt du behöver är en tröskel, använd en optimeringslösare. Det Gemini 4 Carbon adderade var granskningen runtom.
Inget här är knutet till bedrägeri. Upplägget passar alla modeller vars regler Python kan mäta.
Avslutande tankar
Huvudresultatet är att Gemini 4 Carbon insåg att den ursprungliga policyn saknade en giltig global tröskel. Alla 5 slutförda försök namngav konflikten och föreslog en kanaldelning som utvärderaren accepterade; ett high‑försök stoppades innan en rapport togs fram.
Experimenten med Gemini 4 Argon och Gemini 4 Carbon testar två sidor av agentpålitlighet. Gemini 4 Argon‑agenten ändrade kod och måste bevara beteende, medan Gemini 4 Carbon‑agenten nådde ett beslut under regler som gjorde det ursprungliga svaret omöjligt. Båda behövde snäva verktyg, resursgränser och en kontroll utanför modellen.
Det är den standard jag skulle använda för en agent: definiera vad dess verktyg kan fastställa, verifiera resultatet oberoende och tillåt ett inconclusivesvar när underlaget tar slut. Nästa steg vore att lägga två eller tre kandidatklassificerare under samma policy och fråga vilken, om någon, som kan skeppas.
FAQs
Hur får jag tillgång till Gemini 4 Carbon API?⌄
Genom ett betalt Google AI Studio‑projekt eller via Gemini för företag på Google Cloud. Appen Gemini, Antigravity och AI Mode erbjuder det också till Google AI Ultra‑prenumeranter, men de konsumentapparna ger dig ingen API‑nyckel.
Hur mycket kostar Gemini 4 Carbon API?⌄
Alla 6 granskningar här landade på $2,00 till introduktionspris. Standardförfrågningar som dessa får implicit caching när en förfrågan passerar 4 096 inputtoken, så håll början av varje förfrågan identisk. Flex inference, som Interactions‑förfrågningar också stöder, halverar tokenpriserna i utbyte mot långsammare och mindre tillförlitliga svar.
Vilka hastighetsgränser gäller för Gemini 4 Carbon API?⌄
Betalprojekt har gränser per minut plus en utgiftsgräns, som är $10 per rullande 10‑minutersfönster på nivå 1, och att gå över returnerar 429 RESOURCE_EXHAUSTED. En granskning här kostade under $1, så bara många parallella försök skulle nå den. Gränserna stiger med din nivå, så kontrollera Googles sida om hastighetsgränser för ditt projekt.
Vad är skillnaden mellan medium och high thinking i Gemini 4 Carbon?⌄
Gemini 4 Carbon har tre nivåer, low, medium (standard) och high, och jag jämförde bara de två översta här. För att se hur det extra tänket ser ut, sätt thinking_summariestill "auto" så får du kondenserade sammanfattningar bredvid varje svar. De är av som standard och kan bli tomma när modellen knappt resonerar.
Kan Gemini 4 Carbon köra Python‑kod?⌄
Ja. Lägg till {"type": "code_execution"} i toolsså kan Gemini 4 Carbon skriva och köra Python på Googles sida, debiterat enligt dess normala tokenpriser. Jag lämnade det utanför för att behålla kontrollen på min sida: de tre verktygen avgör vad den kan mäta, och råtransaktionerna och holdouten lämnar aldrig min maskin.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.


I vår Gemini 4 Argon API‑handledning hade agenten ett tydligt uppdrag: hitta långsam kod, ändra den och klara dolda tester. Det här kompletterande experimentet behåller samma mönster med kontrollerade verktyg och en extern kontroll, men ändrar beslutet. Gemini 4 Carbon måste avgöra om de ursprungliga reglerna överhuvudtaget går att uppfylla.
PayGuard, en fiktiv nätbutik, har en tränad maskininlärningsmodell (ML) som poängsätter beställningar för bedrägeri. Dess driftsättningspolicy kräver att modellen fångar tillräckligt med bedrägerivärde totalt sett och på varje säljkanal utan att överbelasta granskningsteamet. Agenten måste undersöka dessa regler utan att få veta om det finns en giltig tröskel.
Gemini 4 Carbon är en Google‑resonemangsmodell som du anropar från Python via Interactions API. Här agerar den som en AI‑agent: den väljer vilka kontroller som ska begäras, och Python kör dem via tre skrivskyddade verktyg med funktionsanrop. Min fråga är om den kan identifiera konflikten, förklara underlaget och rekommendera en tillåten ändring utan att behandla den ändringen som godkänd.
Du behöver grundläggande Python och lite erfarenhet av API‑anrop. Jag definierar varje bedrägerimått innan siffrorna använder det. Vi går igenom hur du:
Om du vill ha lanseringsberättelsen och benchmarkresultaten hittar du dem i vår översikt av Gemini 4 Carbon, och vår jämförelse Claude Fable 5.2 vs. Gemini 4 Carbon ställer modellerna mot varandra. Jag körde det här experimentet dagen efter att Google öppnade API:et för betalande utvecklare.
Vad är Gemini 4 Carbon API?
Gemini 4 Carbon API är det betalda programgränssnittet (API) för
gemini-4-carbon, som modellsidan beskriver som en resonemangsmodell för långa, flerstegiga agentuppgifter. Inmatning, tänk och utdata delar ett kontextfönster på 1 048 576 token, och ett synkront svar stannar vid 65 536 token för tänk plus utdata som standard.Varför en ML‑modellgranskning är ett bra test för Gemini 4 Carbon
Uppgiften kräver flera kontroller, en sökning genom tillåtna ändringar och ett tydligt stopp när reglerna lämnar inget svar. Jag valde den eftersom Python kan räkna ut referensresultatet. Modellkortet listar hallucinationer bland kända begränsningar för Gemini 4 Carbon, så modellen undersöker medan Python avgör om dess rekommendation håller.
Projektet: Avgöra om PayGuards bedrägerimodell kan gå i drift
PayGuard är den fiktiva butiken från introt, och hela projektet finns i GitHub‑arkivet. Dess klassificerare är redan tränad.
Hur PayGuard poängsätter transaktioner
Varje transaktion har en UTC‑tidsstämpel, ett belopp, en kanal (Website eller Mobile App), en riskscore och en bedrägerietikett. En scikit‑learn
HistGradientBoostingClassifiergenererar scoren, avrundad till 0,001, och PayGuard flaggar en transaktion närrisk_score >= threshold. Vår handledning om precision‑recall‑kurvan visar hur en förflyttad tröskel ändrar vad som flaggas, och vår kurs Fraud Detection in Python täcker modelleringsdelen.Den syntetiska datan är tidsuppdelad:
Den aktuella tröskeln är 0,5, och data och policy ändras aldrig under experimentet. Bedrägeri på Website lämnar tydliga signaler i den här datan, medan de flesta Mobile App‑bedrägerier ser ut som en vanlig order.
Gemini 4 Carbon frågar, Python avgör. Bild av författaren.
PayGuards tre driftsättningsregler
Här är de tre reglerna från introt, skrivna som policyn uttrycker dem. Alla är fiktiva mål jag valde för det här experimentet:
Bedrägerivärdets recall är värdet av flaggat bedrägeri delat med det totala värdet av bedrägeri. Till skillnad från transaktionsnivåns recall i vår guide om precision kontra recall väger ett missat bedrägeri på $2 000 mycket tyngre än ett missat på $15, och att flagga betyder inte att pengarna räddades. R3 begränsar den mest belastade enskilda dagen, och den formuleringen avgör till slut granskningen.
Agenten får undersöka två ändringar: en daglig kapacitet upp till 260 med en tröskel, eller separata kanaltrösklar vid det ursprungliga taket. Båda kräver mänskligt godkännande, de kan inte kombineras, och policyn föredrar alternativet utan extra granskare.
Vad som räknas som en korrekt granskning
En korrekt granskning sätter fyra saker rätt, och du bör bestämma dem före första förfrågan:
En utvärderare som agenten inte kan anropa räknar ut svaret.
Så ställer du in Gemini 4 Carbon API i Python
Att sätta upp Gemini 4 Carbon API kräver Python 3.11 eller nyare och en API‑nyckel från ett Google AI Studio‑projekt med fakturering påslagen, eftersom prissidan inte listar någon gratisnivå.
Installera Google Gen AI SDK och förbered projektet
Jag testade det här projektet med Google Gen AI‑SDK låst till
google-genai==3.1.0, lanseringsdagens release på PyPI som lade tillgemini-4-carboni Interactions modellista. Klona projektet och installera det i en virtuell miljö:Kör sedan de två kommandona på arkivsidan som bygger datan och tränar klassificeraren med fasta frön. I en ny klon skriver de ut detta:
Fasta frön återskapar samma dataset. Bild av författaren.
Lägg sedan in
GEMINI_API_KEY=din-nyckeli en.env‑fil. Arkivet laddar den utan att skriva ut den.Gör din första förfrågan till Gemini 4 Carbon API
Kör det här kompletta exemplet från projektmappen. Det ger Gemini 4 Carbon policyn och klassificerarens sammanfattning och frågar vad den skulle behöva mäta, utan att antyda en konflikt:
Tänkenivån sätts i
generation_config, ochoutput_textinnehåller svaret. Här är en del av vad som kom tillbaka:Den tolkade R3 som en topp och planerade policyns preferensordning innan den såg en siffra. Den frågade aldrig hur lika värden eller scoreavrundning fungerar, och den uttömmande kontroll jag visar senare beror just på det. Anropet tog cirka 40 sekunder och kostade cirka 2 cent.
Lämna ute
temperature,top_pochtop_k, som Gemini 4 Carbon ignorerar, samtthinking_budget.Så bygger du en ML‑granskningsagent med Gemini 4 Carbon‑funktionsanrop
En Gemini 4 Carbon‑granskningsagent är en loop: modellen begär en utvärdering, Python validerar och kör den, och resultatet skickas tillbaka tills modellen slutar fråga.
Definiera skrivskyddade verktyg för modellevaluering
Agenten får tre verktyg. Alla är begränsade till valideringsfönstret:
get_audit_context: klassificerarens sammanfattning, aktuell konfiguration, policy och tillåtna ändringarevaluate_global_threshold: recall för bedrägerivärde totalt och per kanal, flaggar per dag samt diagnostik för en tröskelevaluate_policy_change: samma mätningar för en kapacitetsökning eller ett par kanaltrösklarDe fullständiga schemana finns i arkivet. Det här förenklade utdraget utelämnar tröskel- och kapacitetsfält, så det är inte en komplett deklaration att kopiera. Det visar bara gränsen som är viktig här: verktyget accepterar de två policyändringar som PayGuard tillåter, läser valideringsdata och godkänner inget.
Python validerar de utelämnade tröskel- och kapacitetsfälten, avvisar ändringar utanför policyn och returnerar mätvärden i stället för pass/fail‑flaggor. Agenten kan inte nå holdouten, anropa utvärderaren eller ändra policyn. I FAQ:n förklarar jag varför jag hoppade över Gemini 4 Carbons inbyggda kodkörning.
Ge agenten ett tydligt mål och stoppregler
Systeminstruktionen sätter metoden. Liksom den första förfrågan antyder den inte var konflikten finns:
Prompten kan bara be, så gränserna ligger i agentens hölje, Python‑koden runt modellen. Eftersom API:et saknar budgetinställning sätter applikationen dem per försök: 25 varv, 60 verktygsanrop, 30 minuter och $3, med kostnadskontroll mellan varven.
Implementera funktionsanropsloopen med Interactions API
Varje varv är ett
client.interactions.create()‑anrop. Gemini 4 Carbon begär ofta flera verktyg samtidigt, så loopen kör varjefunction_call‑steg. Det här är kärnloopen, och arkivversionen lägger till loggning och gränskontroller:Jag behåller dessa inställningar i en
request‑dict så att varje uppföljningsanrop skickar dem igen.previous_interaction_idbär historiken, mentools,system_instructionochgeneration_configgäller bara för en interaktion. Om ett varv slutar somincomplete, kapademax_output_tokensav det, och du betalar ändå för dess tänketoken.Returnera en strukturerad granskningsrapport med ett JSON‑schema
Googles guide för strukturerad utdata listar verktyg plus ett JSON‑schema i en och samma förfrågan som en förhandsvisningsfunktion som inkluderar Gemini 4 Carbon. Jag höll dem ändå åtskilda: undersökningsvarven mäter bara, och ett sista varv på samma historik och konfiguration skriver rapporten med ett schema och utan verktyg:
AuditReportär en Pydantic‑modell med utslag, konflikt, underlag, rekommendation och godkännanden. Python mäter tid och kostnad i stället för att be Gemini 4 Carbon rapportera dem.Kör Gemini 4 Carbon‑granskningen på bedrägeridetektionsmodellen
Gemini 4 Carbon granskade modellen som jag skulle vilja att en junior analytiker gör, med mätningar före någon slutsats. Vid första
medium‑försöket läste den granskningskontexten, kontrollerade ett par dussin enskilda trösklar och testade åtta policyändringar.Alla 32 verktygsanrop, i ordning. Bild av författaren.
Utvärdera PayGuards nuvarande tröskel
Agenten utvärderade den nuvarande tröskeln 0,5 och fann 91 % recall för Website, 20 % för Mobile App, 64 % totalt och 85 flaggor på den mest belastade dagen. Det missar R1 och Mobile App‑delen av R2 med marginal under R3, så den uppenbara åtgärden är en lägre tröskel.
Testa recall för bedrägerivärde mot daglig granskarkapacitet
Att sänka en tröskel fångar mer bedrägerivärde och skickar fler order till granskning. PayGuard behöver tillräckligt av det första samtidigt som det andra hålls under ett dagligt tak.
Agenten provade några grova trösklar i en batch och smalnade sedan av till enskilda rutnätspunkter. Anrop 11, 12, 17 och 18 i spåret avgjorde det.
I det här valideringsfönstret kräver Mobile App‑golvet 0,108 eller lägre, eftersom ett steg högre sänker det precis under 70 %. Taket kräver 0,118 eller högre. Ingen tröskel klarar båda.
Den totala recallen håller upp till 0,137, så R1 ligger utanför konflikten. Vid 0,108 har genomsnittsdagen omkring 169 flaggor, och bara en lördag går över. Det är därför policyn använder den mest belastade dagens arbetsbelastning snarare än dagssnittet.
Mobilrecall och kapacitet överlappar aldrig. Bild av författaren.
Kontrollera prestanda över båda betalningskanalerna
Mobile App‑bedrägerier, med sina svagare signaler, ligger lågt i scoreintervallet. Att dra ner en tröskel till 0,108 för Mobile App drar också in fler legitima Website‑order, och den där lördagen driver de upp totalen över taket.
Totalsiffran döljer det: vid 0,118 är total recall cirka 87 % medan Mobile App ligger under sitt golv. Om din policy namnger segment, mät varje, eftersom totalen kan klara sig medan ett segment faller.
Kan Gemini 4 Carbon upptäcka motstridiga driftsättningskrav?
Ja, i den här granskningen. Den frysta rapporten säger
not deployable, säger att ingen enskild tröskel fungerar och namnger R2 för Mobile App och R3 som konflikten.Kontrollera Gemini 4 Carbons driftsättningsutslag mot dess underlag
Varje siffra som rapporten hänvisar till matchar ett verktygsresultat, men en mening påstår mer än vad agenten mätte. Den säger att ingen tröskel fungerar ”över alla 0,001‑riskscores rutnätspunkter”, men agenten testade bara de två dussin i spåret ovan, av 1 002 möjliga trösklar.
Påståendet håller eftersom recall och dagliga antal båda faller när tröskeln stiger, vilket rapporten aldrig säger. Kontrollera varje påstående i en agents rapport mot vad den mätte, och vår guide till utvärdering av AI‑agenter tar upp fler kontroller av det här slaget.
Verifiera konflikten med en uttömmande Python‑utvärderare
Gemini 4 Carbon samplade trösklar och drog slutsatsen att ingen kunde fungera. Utvärderaren bevisar det resultatet för detta valideringsset genom att kontrollera varje distinkt flagsats utan att dela kod med verktygen.
Scorer ligger på ett 0,001‑rutnät, så de 1 002 kandidatsnitten täcker varje möjlig flagsats. Utvärderaren kontrollerar alla, plus varje par kanaltrösklar, med heltalscent så att 85 % och 70 % blir exakta.
Uttömmande kontroll och fyra avvisade konfigurationer. Bild av författaren.
Ingen global tröskel klarar alla tre regler, så Gemini 4 Carbons påstående har nu bevis bakom sig. Utvärderaren matchade gränserna 0,108 och 0,118 från agentens sondering och fann tusentals kanalpar som klarar sig vid 200 per dag.
En utvärderare hjälper bara om den avvisar dåliga svar, så jag matade den med fyra felaktiga konfigurationer, och den avvisade alla fyra.
Testa driftsättningsalternativ med Gemini 4 Carbon
Gemini 4 Carbon testade båda tillåtna ändringar och valde separata trösklar vid det ursprungliga taket framför extra granskare. Den markerade valet som ett undantag som en person måste godkänna.
Testa en ökning av manuell granskarkapacitet
En global tröskel fungerar om taket höjs från 200 till 205, och utvärderaren bekräftade 205 som den minsta ökningen. Gemini 4 Carbon rankade ändå detta alternativ som nummer två, på grund av preferensregeln jag beskrev tidigare.
Testa separata trösklar för varje betalningskanal
På kanalsidan höll agenten Mobile App‑tröskeln nära dess gräns (den hade redan sett 0,109 bryta golvet) och höjde Website‑tröskeln, vilket minskade flaggor på legitima Website‑order. Den testade sju par, och ett föll på en enda flagga under den mest belastade dagen. Den rekommenderade Website 0,3 och Mobile App 0,1 eftersom det paret klarar varje regel med marginal, och utvärderaren bekräftade det vid det ursprungliga taket.
Jämför de verifierade alternativen
Dessa siffror dök upp ovan, och utvärderaren räknade om var och en:
Alternativ
Trösklar
Totalt
Website
Mobile App
Mest belastad dag
Godkännande
Ursprunglig policy
Global 0,108
87,5 %
98,2 %
70,1 %
205, tak 200
Underkänns
Mer kapacitet
Global 0,108
87,5 %
98,2 %
70,1 %
205, tak 205
Krävs
Kanaldelning
Website 0,3, Mobile App 0,1
86,2 %
94,5 %
72,8 %
191, tak 200
Krävs
Kanaldelningen flaggar också cirka 6 % färre transaktioner än kapacitetsalternativet. Mindre än hälften av dess flaggor är dock bedrägerier, vilket rapporten listade som en öppen fråga.
Så verifierar du Gemini 4 Carbons rekommendation på osedd data
Du verifierar rekommendationen genom att tillämpa den, fryst, på den förseglade holdouten. Skillnaden mot utvärderaren är datan: utvärderaren poängsatte veckor som agenten kunde se, och holdouten poängsätter fyra senare veckor som inget verktyg kunde läsa. Kontrollkörningen sker en gång per fryst rekommendation och startar inte om rapporten ändrades efter infrysningen.
Den frysta rekommendationen klarar holdouten. Bild av författaren.
Den klarade alla tre regler, och den mest belastade dagen höll sig under taket. Läs dock inte in för mycket i det. Tre saker gör resultatet måttligt:
De två första kommer från siffrorna.
Titta på hela granskningen i Streamlit
Arkivet innehåller också en Streamlit‑app och de sex inspelade försöken, så att du kan öppna den här granskningen utan ett API‑anrop. I videon laddar jag den och går igenom varje flik.