Trong Hướng dẫn API Gemini 4 Argon, agent có một nhiệm vụ rõ ràng: tìm đoạn mã chậm, chỉnh sửa nó và vượt qua các bài kiểm tra ẩn. Thí nghiệm đi kèm này giữ nguyên mô thức công cụ kiểm soát và kiểm tra bên ngoài, nhưng thay đổi quyết định. Gemini 4 Carbon phải xác định xem các quy tắc ban đầu có thể được đáp ứng hay không.
PayGuard, một cửa hàng trực tuyến hư cấu, có một mô hình máy học (ML) đã được huấn luyện để chấm điểm gian lận cho đơn hàng. Chính sách triển khai yêu cầu mô hình bắt đủ tổng giá trị gian lận nói chung và trên từng kênh bán hàng mà không làm quá tải đội ngũ rà soát. Agent phải điều tra các quy tắc đó mà không được cho biết liệu có tồn tại ngưỡng hợp lệ hay không.
Gemini 4 Carbon là một mô hình suy luận của Google mà bạn gọi từ Python thông qua Interactions API. Ở đây, nó hoạt động như một tác tử AI: nó chọn những phép kiểm tra nào cần yêu cầu, và Python chạy chúng qua ba công cụ chỉ đọc bằng gọi hàm. Câu hỏi của tôi là liệu nó có thể xác định xung đột, giải thích bằng chứng và đề xuất một thay đổi được phép mà không coi thay đổi đó như đã được phê duyệt hay không.
Bạn sẽ cần Python cơ bản và chút kinh nghiệm với yêu cầu API. Tôi định nghĩa từng chỉ số gian lận trước khi các con số sử dụng nó. Chúng ta sẽ tìm hiểu cách:
Gửi yêu cầu đầu tiên đến Gemini 4 Carbon từ Python
Cấp cho mô hình các công cụ chỉ đọc và chạy chúng trong một vòng lặp với giới hạn
Nhận lại phán quyết dưới dạng JSON để mã của bạn có thể kiểm tra
Xác minh phán quyết đó bằng mã và dữ liệu mà mô hình không bao giờ nhìn thấy
So sánh hai mức suy luận, điều khiển mức độ mô hình lập luận trước khi trả lời
Gemini 4 Carbon API là giao diện lập trình ứng dụng (API) trả phí cho gemini-4-carbon, mà trang mô hình mô tả là mô hình suy luận cho các tác vụ agent dài, nhiều bước. Đầu vào, suy nghĩ và đầu ra dùng chung một cửa sổ ngữ cảnh 1.048.576 token, và phản hồi đồng bộ dừng ở 65.536 token suy nghĩ cộng đầu ra theo mặc định.
Vì sao kiểm toán mô hình ML là bài kiểm tra tốt cho Gemini 4 Carbon
Nhiệm vụ đòi hỏi nhiều phép kiểm tra, tìm kiếm qua các thay đổi được phép và dừng rõ ràng khi các quy tắc khiến không còn câu trả lời. Tôi chọn nó vì Python có thể tính kết quả tham chiếu. Thẻ mô hình liệt kê ảo tưởng (hallucinations) trong số những giới hạn đã biết của Gemini 4 Carbon, nên mô hình điều tra trong khi Python quyết định đề xuất của nó có đứng vững hay không.
Dự án: Quyết định xem mô hình gian lận của PayGuard có thể đưa vào hoạt động
PayGuard là cửa hàng hư cấu từ phần mở đầu, và toàn bộ dự án có trong kho GitHub. Bộ phân loại của nó đã được huấn luyện sẵn.
Cách PayGuard chấm điểm giao dịch
Mỗi giao dịch có dấu thời gian UTC, số tiền, kênh (Website hoặc Ứng dụng di động), điểm rủi ro và nhãn gian lận. Một HistGradientBoostingClassifier của scikit-learn tạo ra điểm số, làm tròn đến 0,001, và PayGuard gắn cờ một giao dịch khi risk_score >= threshold. Hướng dẫn đường cong precision-recall của chúng tôi cho thấy việc di chuyển ngưỡng thay đổi những gì bị gắn cờ ra sao, và khóa học Phát hiện gian lận bằng Python của chúng tôi đề cập đến khía cạnh mô hình hóa.
Dữ liệu tổng hợp được chia theo thời gian:
Huấn luyện: chín tuần đầu, chỉ dùng để fit bộ phân loại
Xác thực: bốn tuần tiếp theo, là khung thời gian duy nhất các công cụ có thể đọc
Giữ lại: bốn tuần sau nữa, được niêm phong cho đến khi đề xuất được đóng băng
Ngưỡng hiện tại là 0,5, và dữ liệu cùng chính sách không bao giờ thay đổi trong suốt thí nghiệm. Gian lận trên Website để lại tín hiệu rõ ràng trong dữ liệu này, trong khi đa số gian lận trên Ứng dụng di động trông như đơn hàng bình thường.
Gemini 4 Carbon hỏi, Python quyết định. Hình: Tác giả.
Ba quy tắc triển khai của PayGuard
Dưới đây là ba quy tắc từ phần mở đầu, được viết theo cách chính sách nêu ra. Tất cả đều là mục tiêu hư cấu tôi chọn cho thí nghiệm này:
R1: giao dịch bị gắn cờ bao phủ ít nhất 85% tổng giá trị gian lận đã gán nhãn
R2: chúng bao phủ ít nhất 70% giá trị gian lận đã gán nhãn trong mỗi kênh
R3: không quá 200 giao dịch bị gắn cờ trong bất kỳ một ngày UTC nào
Recall theo giá trị gian lận là giá trị gian lận bị gắn cờ chia cho tổng giá trị gian lận. Khác với recall theo mức giao dịch trong hướng dẫn precision so với recall của chúng tôi, một vụ gian lận 2.000 đô bị bỏ lỡ có trọng số lớn hơn nhiều so với vụ 15 đô, và việc gắn cờ không có nghĩa là đã cứu được tiền. R3 giới hạn ngày bận nhất, và cách diễn đạt đó cuối cùng quyết định cuộc kiểm toán.
Agent có thể điều tra hai thay đổi: năng lực xử lý hằng ngày lên tối đa 260 với một ngưỡng, hoặc tách ngưỡng theo kênh ở mức trần ban đầu. Cả hai đều cần con người phê duyệt, không thể kết hợp, và chính sách ưu tiên phương án không cần thêm người rà soát.
Thế nào là một cuộc kiểm toán đúng
Một kiểm toán đúng cần xác định bốn điều, và bạn nên quyết định chúng trước yêu cầu đầu tiên:
Phán quyết: liệu bất kỳ ngưỡng đơn nào có đáp ứng R1, R2 và R3 trên tập xác thực hay không
Xung đột: những yêu cầu nào khiến chính sách ban đầu là không thể thực hiện
Phương án thay thế: một thay đổi được phép vượt qua mọi quy tắc khi Python tính lại
Ưu tiên: khuyến nghị tuân theo thứ tự ưu tiên của chính sách
Một bộ đánh giá mà agent không thể gọi sẽ tính câu trả lời.
Cách thiết lập API Gemini 4 Carbon trong Python
Thiết lập Gemini 4 Carbon API cần Python 3.11 trở lên và một khóa API từ một dự án Google AI Studio có bật thanh toán, vì trang giá không có bậc miễn phí.
Cài đặt Google Gen AI SDK và chuẩn bị dự án
Tôi đã thử nghiệm dự án này với bộ SDK Google Gen AI cố định tại google-genai==3.1.0, bản phát hành trên PyPI vào ngày ra mắt đã thêm gemini-4-carbon vào danh sách mô hình Interactions. Hãy clone dự án và cài đặt trong môi trường ảo:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS or Linux: source .venv/bin/activate
pip install-r requirements.txtĐược hỗ trợ bởi
Sau đó, chạy hai lệnh trên trang kho để dựng dữ liệu và fit bộ phân loại với seed cố định. Trên một bản clone mới, chúng in ra như sau:
Seed cố định tái tạo cùng một bộ dữ liệu. Hình: Tác giả.
Tiếp theo đặt GEMINI_API_KEY=your-key trong tệp .env. Kho sẽ tải nó mà không in ra.
Thực hiện yêu cầu API Gemini 4 Carbon đầu tiên của bạn
Chạy ví dụ hoàn chỉnh này từ thư mục dự án. Nó cung cấp cho Gemini 4 Carbon chính sách và tóm tắt bộ phân loại và hỏi những gì nó cần đo lường, mà không gợi ý về xung đột:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Được hỗ trợ bởi
Mức suy luận nằm trong generation_config, và output_text chứa câu trả lời. Đây là một phần phản hồi trả về:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Được hỗ trợ bởi
Nó đọc R3 là giá trị đỉnh và lập kế hoạch theo thứ tự ưu tiên của chính sách trước cả khi thấy con số. Tuy nhiên, nó không bao giờ hỏi cách xử lý đồng điểm hoặc làm tròn điểm, và phép kiểm tra toàn diện mà tôi sẽ trình bày sau phụ thuộc chính xác vào điều đó. Lệnh gọi mất khoảng 40 giây và tốn khoảng 2 xu.
Bỏ qua temperature, top_p và top_k, vì Gemini 4 Carbon bỏ qua chúng, và cả thinking_budget.
Cách xây dựng Agent kiểm toán ML với gọi hàm của Gemini 4 Carbon
Một agent kiểm toán Gemini 4 Carbon là một vòng lặp: mô hình yêu cầu đánh giá, Python xác thực và chạy nó, và kết quả được gửi lại cho đến khi mô hình ngừng yêu cầu.
Định nghĩa các công cụ chỉ đọc để đánh giá mô hình
Agent có ba công cụ. Tất cả đều bị giới hạn trong khung xác thực:
get_audit_context: tóm tắt bộ phân loại, cấu hình hiện tại, chính sách và các thay đổi được phép
evaluate_global_threshold: recall theo giá trị gian lận tổng thể và theo kênh, số lượng gắn cờ theo ngày, và chẩn đoán cho một ngưỡng
evaluate_policy_change: các phép đo tương tự cho việc tăng năng lực hoặc một cặp ngưỡng theo kênh
Các schema đầy đủ có trong kho. Trích đoạn rút gọn này lược bỏ các trường ngưỡng và năng lực, nên không phải là khai báo hoàn chỉnh để sao chép. Nó chỉ cho thấy ranh giới quan trọng ở đây: công cụ chấp nhận hai thay đổi chính sách mà PayGuard cho phép, đọc dữ liệu xác thực và không phê duyệt gì cả.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Được hỗ trợ bởi
Python xác thực các trường ngưỡng và năng lực bị lược bỏ, từ chối các thay đổi ngoài chính sách, và trả về phép đo thay vì cờ pass/fail. Agent không thể truy cập tập giữ lại, gọi bộ đánh giá, hay thay đổi chính sách. Tôi giải thích trong phần Câu hỏi thường gặp vì sao tôi bỏ qua tính năng thực thi mã tích hợp của Gemini 4 Carbon.
Đưa cho agent một mục tiêu rõ ràng và quy tắc dừng
Lời dẫn hệ thống (system instruction) đặt phương pháp. Giống yêu cầu đầu tiên, nó không gợi ý xung đột ở đâu:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.Được hỗ trợ bởi
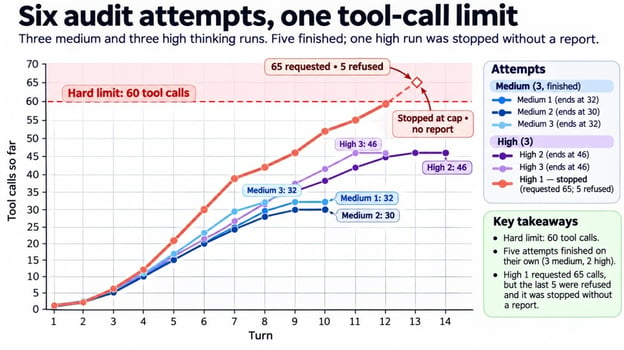
Prompt chỉ có thể yêu cầu, vì vậy các giới hạn nằm trong agent harness, tức mã Python bao quanh mô hình. Vì API không có thiết lập ngân sách, ứng dụng đặt chúng theo mỗi lần thử: 25 lượt, 60 lần gọi công cụ, 30 phút và 3 đô, với chi tiêu được kiểm tra giữa các lượt.
Triển khai vòng lặp gọi hàm với Interactions API
Mỗi lượt là một lệnh gọi client.interactions.create(). Gemini 4 Carbon thường yêu cầu nhiều công cụ cùng lúc, nên vòng lặp chạy ở mỗi bước function_call. Đây là vòng lõi, và phiên bản trong kho bổ sung logging và kiểm tra giới hạn:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Được hỗ trợ bởi
Tôi giữ các thiết lập này trong một dict request để mọi lệnh gọi tiếp theo gửi lại chúng. previous_interaction_id mang lịch sử, nhưng tools, system_instruction và generation_config chỉ áp dụng cho một tương tác. Nếu một lượt kết thúc incomplete, max_output_tokens đã cắt ngắn nó, và bạn vẫn phải trả tiền cho token suy nghĩ.
Trả về báo cáo kiểm toán có cấu trúc với JSON schema
Tài liệu structured output của Google liệt kê công cụ cộng với JSON schema trong một yêu cầu dưới dạng tính năng Preview bao gồm Gemini 4 Carbon. Tôi vẫn tách chúng: các lượt điều tra chỉ đo lường, và một lượt cuối cùng trên cùng lịch sử và cấu hình viết báo cáo với schema và không có công cụ:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Được hỗ trợ bởi
AuditReport là một mô hình Pydantic với phán quyết, xung đột, bằng chứng, khuyến nghị và phê duyệt. Python đo thời gian và chi phí thay vì yêu cầu Gemini 4 Carbon báo cáo chúng.
Chạy kiểm toán Gemini 4 Carbon trên mô hình phát hiện gian lận
Gemini 4 Carbon đã kiểm toán mô hình theo cách tôi mong một nhà phân tích mới làm: đo lường trước khi kết luận. Ở lần thử medium đầu tiên, nó đọc ngữ cảnh kiểm toán, kiểm tra khoảng hai chục ngưỡng đơn và thử nghiệm tám thay đổi chính sách.
Cả 32 lần gọi công cụ, theo thứ tự. Hình: Tác giả.
Đánh giá ngưỡng hiện tại của PayGuard
Agent đánh giá ngưỡng hiện tại 0,5 và tìm thấy recall Website 91%, recall Ứng dụng di động 20%, recall tổng thể 64%, và 85 lượt gắn cờ ở ngày bận nhất. Điều đó không đạt R1 và phần R2 của Ứng dụng di động với dư địa dưới R3, nên bước hiển nhiên là hạ ngưỡng.
Kiểm tra recall theo giá trị gian lận so với năng lực rà soát hằng ngày
Hạ ngưỡng bắt được nhiều giá trị gian lận hơn và gửi nhiều đơn hàng hơn để rà soát. PayGuard cần đủ điều đầu tiên đồng thời giữ điều thứ hai dưới trần theo ngày.
Agent thử vài ngưỡng thô trong một lô, rồi thu hẹp đến các điểm lưới đơn. Các lần gọi 11, 12, 17 và 18 trong vết theo dõi đã kết luận.
Trong khung xác thực này, sàn của Ứng dụng di động cần 0,108 hoặc thấp hơn, vì cao hơn một bước sẽ rơi ngay dưới 70%. Trần cần 0,118 hoặc cao hơn. Không có ngưỡng nào đáp ứng cả hai.
Recall tổng thể giữ được đến 0,137, nên R1 nằm ngoài xung đột. Ở 0,108, ngày trung bình có khoảng 169 lượt gắn cờ, và chỉ một ngày thứ Bảy vượt quá. Đây là lý do chính sách dùng khối lượng công việc của ngày bận nhất thay vì trung bình ngày.
Recall của Mobile và năng lực không bao giờ giao nhau. Hình: Tác giả.
Kiểm tra hiệu năng trên cả hai kênh thanh toán
Gian lận trên Ứng dụng di động, với tín hiệu yếu hơn, nằm thấp trong dải điểm số. Kéo một ngưỡng xuống 0,108 cho Ứng dụng di động cũng lôi vào nhiều đơn Website hợp lệ hơn, và vào ngày thứ Bảy đó, chúng đẩy tổng vượt trần.
Con số tổng thể che giấu điều đó: ở 0,118, recall tổng thể khoảng 87% trong khi Ứng dụng di động nằm dưới sàn của nó. Nếu chính sách của bạn nêu các phân đoạn, hãy đo từng phân đoạn, vì tổng có thể đạt trong khi một phân đoạn không đạt.
Gemini 4 Carbon có phát hiện được các yêu cầu triển khai mâu thuẫn không?
Có, trong kiểm toán này. Báo cáo đóng băng ghi not deployable, nói rằng không có ngưỡng đơn nào hoạt động, và nêu R2 cho Ứng dụng di động và R3 là xung đột.
Đối chiếu phán quyết triển khai của Gemini 4 Carbon với bằng chứng của nó
Mọi con số báo cáo trích dẫn đều khớp với kết quả công cụ, nhưng một câu khẳng định nhiều hơn những gì agent đo được. Nó nói không có ngưỡng nào hoạt động "trên tất cả các điểm lưới điểm rủi ro 0,001", nhưng agent chỉ kiểm tra khoảng hai chục điểm trong vết theo dõi ở trên, trong tổng số 1.002 ngưỡng có thể có.
Khẳng định này vẫn đúng vì recall và số lượt theo ngày đều giảm khi ngưỡng tăng, điều mà báo cáo không bao giờ nói ra. Hãy kiểm tra từng khẳng định trong báo cáo của một agent so với những gì nó đã đo, và hướng dẫn của chúng tôi về đánh giá tác tử AI bao quát thêm các kiểm tra dạng này.
Xác minh xung đột bằng bộ đánh giá Python toàn diện
Gemini 4 Carbon lấy mẫu các ngưỡng và suy ra rằng không ngưỡng nào có thể hoạt động. Bộ đánh giá chứng minh kết quả đó cho tập xác thực này bằng cách kiểm tra mọi tập gắn cờ khác nhau, không dùng chung mã với các công cụ.
Điểm số nằm trên lưới 0,001, nên 1.002 điểm cắt ứng viên bao phủ mọi tập gắn cờ có thể. Bộ đánh giá kiểm tra tất cả, cộng mọi cặp ngưỡng theo kênh, sử dụng đơn vị xu để 85% và 70% là số chính xác.
Kiểm tra toàn diện và bốn cấu hình bị từ chối. Hình: Tác giả.
Không có ngưỡng toàn cục nào vượt qua cả ba quy tắc, nên tuyên bố của Gemini 4 Carbon giờ có bằng chứng phía sau. Bộ đánh giá khớp các ranh giới 0,108 và 0,118 từ phép thăm dò của agent và tìm thấy hàng nghìn cặp kênh đạt ở mức 200 mỗi ngày.
Một bộ đánh giá chỉ hữu ích nếu nó loại bỏ câu trả lời kém, nên tôi đưa vào bốn cấu hình sai, và nó loại bỏ cả bốn.
Thử nghiệm các phương án triển khai với Gemini 4 Carbon
Gemini 4 Carbon thử cả hai thay đổi được phép và chọn tách ngưỡng theo kênh ở mức trần ban đầu thay vì thêm người rà soát. Nó gắn cờ lựa chọn đó là ngoại lệ cần con người phê duyệt.
Thử tăng năng lực rà soát thủ công
Một ngưỡng toàn cục hoạt động nếu trần tăng từ 200 lên 205, và bộ đánh giá xác nhận 205 là mức tăng nhỏ nhất. Gemini 4 Carbon vẫn xếp phương án này thứ hai, vì quy tắc ưu tiên tôi đã mô tả trước đó.
Thử tách ngưỡng cho từng kênh thanh toán
Về phía kênh, agent giữ ngưỡng Ứng dụng di động gần giới hạn của nó (nó đã thấy 0,109 làm vỡ sàn) và nâng ngưỡng Website, giảm lượt gắn cờ ở các đơn Website hợp lệ. Nó thử bảy cặp, và một cặp trượt chỉ vì thiếu một lượt gắn cờ trong ngày bận nhất. Nó đề xuất Website 0,3 và Ứng dụng di động 0,1 vì cặp này vượt qua mọi quy tắc với dư địa, và bộ đánh giá xác nhận ở mức trần ban đầu.
So sánh các phương án đã được xác minh
Những con số này đã xuất hiện ở trên, và bộ đánh giá tính lại từng số:
Phương án
Ngưỡng
Tổng thể
Website
Ứng dụng di động
Ngày bận nhất
Phê duyệt
Chính sách gốc
Toàn cục 0,108
87,5%
98,2%
70,1%
205, trần 200
Trượt
Tăng năng lực
Toàn cục 0,108
87,5%
98,2%
70,1%
205, trần 205
Cần phê duyệt
Tách kênh
Website 0,3, Ứng dụng di động 0,1
86,2%
94,5%
72,8%
191, trần 200
Cần phê duyệt
Phương án tách kênh cũng gắn cờ ít giao dịch hơn khoảng 6% so với phương án tăng năng lực. Tuy nhiên, dưới một nửa lượt gắn cờ là gian lận, điều mà báo cáo liệt kê là một vấn đề mở.
Cách xác minh khuyến nghị của Gemini 4 Carbon trên dữ liệu chưa thấy
Bạn xác minh khuyến nghị bằng cách áp dụng nó, ở trạng thái đóng băng, lên tập giữ lại đã niêm phong. Khác biệt với bộ đánh giá là dữ liệu: bộ đánh giá chấm điểm các tuần mà agent có thể xem, còn tập giữ lại chấm điểm bốn tuần sau đó mà không công cụ nào có thể đọc. Bài kiểm tra chạy một lần cho mỗi khuyến nghị đóng băng và sẽ không bắt đầu nếu báo cáo thay đổi sau khi đóng băng.
Khuyến nghị đóng băng vượt qua trên tập giữ lại. Hình: Tác giả.
Nó vượt qua cả ba quy tắc, và ngày bận nhất vẫn dưới trần. Tuy nhiên đừng diễn giải quá nhiều. Ba điều khiển kết quả này ở mức khiêm tốn:
Tập giữ lại đến từ cùng một bộ sinh, nên nó không nói gì về dạng gian lận mới hay trôi dữ liệu
Recall tổng thể vượt 85% chưa đến hai điểm phần trăm
Phỏng đoán chưa kiểm chứng của tôi: tách kênh có thể phá vỡ trần nếu lưu lượng Ứng dụng di động tăng nhanh hơn Website, vì ngưỡng của Ứng dụng di động đặt khá thấp
Hai điều đầu đến từ các con số.
Xem toàn bộ kiểm toán trên Streamlit
Kho cũng bao gồm một ứng dụng Streamlit và sáu lần thử đã được ghi lại, vì vậy bạn có thể mở kiểm toán này mà không cần gọi API. Trong video, tôi tải nó và bước qua từng tab.
Ứng dụng Streamlit hiển thị một cuộc kiểm toán. Video: Tác giả.
Gemini 4 Carbon mức Medium so với High: Độ chính xác, thời gian và chi phí
Thành công ở đây nghĩa là hoàn thành trong giới hạn của ứng dụng và trả về một báo cáo được bộ đánh giá chấp nhận. Một lần thử bị dừng không có phán quyết để chấm điểm. Theo định nghĩa đó, medium hoàn thành mọi lần thử và tốn chưa đến một nửa chi phí cho mỗi kiểm toán đúng.
Sáu lần thử là quá ít để biến điều đó thành quy tắc chung. Nếu mức suy luận là mới với bạn, hướng dẫn API Gemini 3.8 Flash của chúng tôi trình bày chi tiết hơn về thinking_level.
So sánh mức medium và high trên cùng một kiểm toán
Đây là so sánh đầy đủ phía sau TL;DR. Tôi chạy 3 lần thử mỗi mức, mỗi lần từ trạng thái sạch không nhớ lần khác, với dữ liệu, prompt, công cụ, giới hạn và bộ đánh giá giống hệt:
Mỗi mức
medium
high
Lần thử kết thúc với báo cáo
3/3
2/3
Kiểm toán đúng trong số đó
3/3
2/2
Token suy nghĩ mỗi lần thử
Khoảng 7.700
Khoảng 17.500
Thời gian mỗi lần thử
Khoảng 5 phút
Khoảng 6 phút
Chi phí mỗi kiểm toán đúng, mức giá giới thiệu
Khoảng $0,25
Khoảng $0,62
Chi phí mỗi kiểm toán đúng, mức giá tiêu chuẩn
Khoảng $0,51
Khoảng $1,24
Các hàng chi phí tính tổng chi tiêu của mọi lần thử, bao gồm lần bị dừng. Mọi lần thử hoàn tất đều đi đến cùng phán quyết và xung đột, và chọn một cặp kênh được bộ đánh giá chấp nhận, nên suy nghĩ thêm được dùng cho nhiều kiểm tra hơn.
Tôi thấy mô thức tương tự trong thí nghiệm mã hóa Gemini 4 Argon: hightiêu nhiều hơn và làm nhiều việc hơn cho thay đổi nhỏ hơn trong kết quả đã xác minh. Nhiệm vụ khác nhau, nên chi phí và tỷ lệ thành công không thể so sánh trực tiếp. Ở cả hai, kiểm tra độc lập cho chúng ta biết nhiều hơn tổng suy nghĩ.
Vì sao một lần thử ở mức high không bao giờ hoàn tất
Lần thử bị dừng là lần đầu của mức high, và nó chưa bao giờ đưa ra phán quyết sai. Nó thăm dò mọi điểm lưới từ 0,101 đến 0,119 rồi đi săn ranh giới 70% của Website, vốn không ảnh hưởng đến điều gì, và nó cứ yêu cầu thêm kiểm tra cho đến khi chạm giới hạn 60 lần gọi mà tôi đặt trước đó và ứng dụng dừng nó trước khi viết báo cáo.
Chỉ một lần thử chạm giới hạn. Hình: Tác giả.
Điểm dừng đó là phần hữu ích. Một prompt yêu cầu ít lần gọi hơn sẽ không kết thúc nó, và giới hạn trong mã đã làm được, sau khoảng 22 xu.
Năm báo cáo hoàn tất cũng vượt qua các kiểm tra khác của Python. Không có báo cáo nào đọc sai cấu hình hiện tại, nêu yêu cầu ngoài xung đột, trích dẫn một lần gọi công cụ không tồn tại, hoặc khuyến nghị một cấu hình mà nó chưa thử.
Đo lường token, thời gian và chi phí mỗi kiểm toán
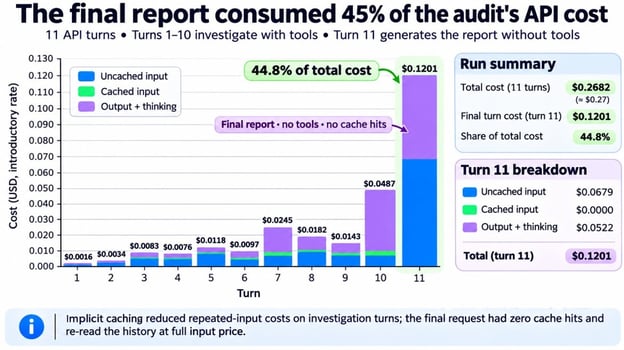
Một kiểm toán có chi phí bằng tổng usage của mỗi lượt, tính giá $2,00 mỗi triệu token đầu vào, $0,10 cache, và $10,00 cho đầu ra gồm suy nghĩ, tất cả sẽ tăng gấp đôi vào ngày 1 tháng 12 năm 2026. total_input_tokens bao gồm token được cache, nên mã định giá hai phần riêng biệt.
Lượt báo cáo tốn kém nhất. Hình: Tác giả.
Điều bất ngờ là báo cáo, hay chính xác hơn, hóa đơn của nó. Caching ngầm bao phủ khoảng ba phần tư số token đầu vào ở các lượt điều tra, nhưng yêu cầu báo cáo không công cụ không bao giờ được cache hit.
Nguyên nhân có thể là bỏ tools làm thay đổi phần đầu của yêu cầu. Dù thế nào, lượt đó đọc lại toàn bộ lịch sử với giá đầy đủ và chiếm khoảng 40% chi phí của mỗi lần thử hoàn tất. Hãy tính lượt đó khi bạn đặt giới hạn chi tiêu.
Hạn chế khi dùng Gemini 4 Carbon cho kiểm toán mô hình ML
Tôi tự thiết kế bài kiểm tra này và sinh dữ liệu của nó, nên kết quả mang các giới hạn sau:
Dữ liệu là tổng hợp và đến từ một bộ phân loại, và tôi tinh chỉnh bộ sinh cho đến khi xuất hiện xung đột, trước bất kỳ lệnh gọi API nào
Phán quyết chỉ bao phủ bộ phân loại này, và một bộ tốt hơn có thể đáp ứng cả ba quy tắc với một ngưỡng
Một ngưỡng có thể kiểm tra được, nhưng phê duyệt tách kênh là quyết định kinh doanh và công bằng
Tương tác được lưu trữ trong 55 ngày ở bậc trả phí theo mặc định, và store=false loại trừ previous_interaction_id, nên một agent gửi hàng loạt dòng giao dịch cần được rà soát dữ liệu
Bộ đánh giá tự giải quyết bài toán ngưỡng, không cần mô hình. Nếu tất cả những gì bạn cần là một ngưỡng, hãy dùng một trình giải tối ưu hóa. Điều Gemini 4 Carbon bổ sung là phần kiểm toán xung quanh nó.
Không có gì ở đây gắn chặt với gian lận. Thiết lập này phù hợp với bất kỳ mô hình nào có các quy tắc Python có thể đo lường.
Kết luận
Kết quả chính là Gemini 4 Carbon nhận ra chính sách ban đầu không có ngưỡng toàn cục hợp lệ. Cả 5 lần thử hoàn tất đều nêu xung đột và đề xuất tách kênh được bộ đánh giá chấp nhận; một lần high dừng lại trước khi tạo báo cáo.
Thí nghiệm Gemini 4 Argon và Gemini 4 Carbon kiểm tra hai mặt của độ tin cậy agent. Agent Gemini 4 Argon thay đổi mã và phải giữ nguyên hành vi, trong khi agent Gemini 4 Carbon đi đến quyết định theo các quy tắc khiến câu trả lời ban đầu là không thể. Cả hai đều cần công cụ hẹp, giới hạn tài nguyên và kiểm tra ngoài mô hình.
Đó là tiêu chuẩn tôi sẽ dùng cho một agent: xác định những gì công cụ của nó có thể xác lập, xác minh kết quả một cách độc lập, và cho phép câu trả lời inconclusivekhi bằng chứng cạn kiệt. Tiếp theo, tôi sẽ đặt hai hoặc ba bộ phân loại ứng viên dưới cùng một chính sách và hỏi bộ nào, nếu có, có thể đưa vào hoạt động.
Tôi là một kỹ sư dữ liệu và người xây dựng cộng đồng, làm việc với pipeline dữ liệu, đám mây và công cụ AI, đồng thời viết các hướng dẫn thực hành, tác động cao cho DataCamp và các nhà phát triển mới nổi.
FAQs
Làm sao tôi có thể truy cập Gemini 4 Carbon API?⌄
Thông qua một dự án Google AI Studio trả phí hoặc thông qua Gemini for business trên Google Cloud. Ứng dụng Gemini, Antigravity và AI Mode cũng cung cấp cho người đăng ký Google AI Ultra, nhưng các ứng dụng người dùng đó không cấp khóa API cho bạn.
Gemini 4 Carbon API có giá bao nhiêu?⌄
Tổng chi phí cho 6 lần kiểm toán ở đây là $2,00 theo mức giá giới thiệu. Các yêu cầu tiêu chuẩn như thế này nhận được caching ngầm sau khi một yêu cầu vượt 4.096 token đầu vào, vì vậy hãy giữ phần đầu của mỗi yêu cầu giống hệt nhau. Flex inference, cũng được Interactions hỗ trợ, giảm một nửa mức giá token đổi lấy phản hồi chậm hơn, kém ổn định hơn.
Giới hạn tần suất của Gemini 4 Carbon API là gì?⌄
Các dự án trả phí có giới hạn theo phút cộng giới hạn chi tiêu, là $10 mỗi cửa sổ 10 phút cuộn ở Tier 1, và vượt quá sẽ trả về 429 RESOURCE_EXHAUSTED. Một lần kiểm toán ở đây tốn dưới $1, nên chỉ nhiều lần thử song song mới chạm giới hạn. Các giới hạn tăng theo tier của bạn, vì vậy hãy kiểm tra trang giới hạn tần suất của Google cho dự án của bạn.
Sự khác biệt giữa mức medium và high trong Gemini 4 Carbon là gì?⌄
Gemini 4 Carbon có ba mức, low, medium (mặc định) và high, và tôi chỉ so sánh hai mức trên cùng ở đây. Để xem suy nghĩ bổ sung trông như thế nào, đặt thinking_summariesthành "auto" và bạn sẽ nhận được các bản tóm tắt cô đọng bên cạnh mỗi câu trả lời. Chúng tắt theo mặc định và có thể trống khi mô hình hầu như không suy luận.
Gemini 4 Carbon có thể chạy mã Python không?⌄
Có. Thêm {"type": "code_execution"} vào toolsvà Gemini 4 Carbon có thể viết và chạy Python phía Google, tính phí theo mức token bình thường. Tôi bỏ qua để giữ quyền kiểm soát phía mình: ba công cụ quyết định nó có thể đo gì, và các giao dịch thô cùng tập giữ lại không rời máy của tôi.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.





Trong Hướng dẫn API Gemini 4 Argon, agent có một nhiệm vụ rõ ràng: tìm đoạn mã chậm, chỉnh sửa nó và vượt qua các bài kiểm tra ẩn. Thí nghiệm đi kèm này giữ nguyên mô thức công cụ kiểm soát và kiểm tra bên ngoài, nhưng thay đổi quyết định. Gemini 4 Carbon phải xác định xem các quy tắc ban đầu có thể được đáp ứng hay không.
PayGuard, một cửa hàng trực tuyến hư cấu, có một mô hình máy học (ML) đã được huấn luyện để chấm điểm gian lận cho đơn hàng. Chính sách triển khai yêu cầu mô hình bắt đủ tổng giá trị gian lận nói chung và trên từng kênh bán hàng mà không làm quá tải đội ngũ rà soát. Agent phải điều tra các quy tắc đó mà không được cho biết liệu có tồn tại ngưỡng hợp lệ hay không.
Gemini 4 Carbon là một mô hình suy luận của Google mà bạn gọi từ Python thông qua Interactions API. Ở đây, nó hoạt động như một tác tử AI: nó chọn những phép kiểm tra nào cần yêu cầu, và Python chạy chúng qua ba công cụ chỉ đọc bằng gọi hàm. Câu hỏi của tôi là liệu nó có thể xác định xung đột, giải thích bằng chứng và đề xuất một thay đổi được phép mà không coi thay đổi đó như đã được phê duyệt hay không.
Bạn sẽ cần Python cơ bản và chút kinh nghiệm với yêu cầu API. Tôi định nghĩa từng chỉ số gian lận trước khi các con số sử dụng nó. Chúng ta sẽ tìm hiểu cách:
Nếu bạn muốn câu chuyện ra mắt và điểm benchmark, phần tổng quan Gemini 4 Carbon của chúng tôi có đầy đủ, và bài So sánh Claude Fable 5.2 và Gemini 4 Carbon đối chiếu hai mô hình. Tôi chạy thí nghiệm này ngay ngày hôm sau khi Google mở API cho nhà phát triển trả phí.
Gemini 4 Carbon API là gì?
Gemini 4 Carbon API là giao diện lập trình ứng dụng (API) trả phí cho
gemini-4-carbon, mà trang mô hình mô tả là mô hình suy luận cho các tác vụ agent dài, nhiều bước. Đầu vào, suy nghĩ và đầu ra dùng chung một cửa sổ ngữ cảnh 1.048.576 token, và phản hồi đồng bộ dừng ở 65.536 token suy nghĩ cộng đầu ra theo mặc định.Vì sao kiểm toán mô hình ML là bài kiểm tra tốt cho Gemini 4 Carbon
Nhiệm vụ đòi hỏi nhiều phép kiểm tra, tìm kiếm qua các thay đổi được phép và dừng rõ ràng khi các quy tắc khiến không còn câu trả lời. Tôi chọn nó vì Python có thể tính kết quả tham chiếu. Thẻ mô hình liệt kê ảo tưởng (hallucinations) trong số những giới hạn đã biết của Gemini 4 Carbon, nên mô hình điều tra trong khi Python quyết định đề xuất của nó có đứng vững hay không.
Dự án: Quyết định xem mô hình gian lận của PayGuard có thể đưa vào hoạt động
PayGuard là cửa hàng hư cấu từ phần mở đầu, và toàn bộ dự án có trong kho GitHub. Bộ phân loại của nó đã được huấn luyện sẵn.
Cách PayGuard chấm điểm giao dịch
Mỗi giao dịch có dấu thời gian UTC, số tiền, kênh (Website hoặc Ứng dụng di động), điểm rủi ro và nhãn gian lận. Một
HistGradientBoostingClassifiercủa scikit-learn tạo ra điểm số, làm tròn đến 0,001, và PayGuard gắn cờ một giao dịch khirisk_score >= threshold. Hướng dẫn đường cong precision-recall của chúng tôi cho thấy việc di chuyển ngưỡng thay đổi những gì bị gắn cờ ra sao, và khóa học Phát hiện gian lận bằng Python của chúng tôi đề cập đến khía cạnh mô hình hóa.Dữ liệu tổng hợp được chia theo thời gian:
Ngưỡng hiện tại là 0,5, và dữ liệu cùng chính sách không bao giờ thay đổi trong suốt thí nghiệm. Gian lận trên Website để lại tín hiệu rõ ràng trong dữ liệu này, trong khi đa số gian lận trên Ứng dụng di động trông như đơn hàng bình thường.
Gemini 4 Carbon hỏi, Python quyết định. Hình: Tác giả.
Ba quy tắc triển khai của PayGuard
Dưới đây là ba quy tắc từ phần mở đầu, được viết theo cách chính sách nêu ra. Tất cả đều là mục tiêu hư cấu tôi chọn cho thí nghiệm này:
Recall theo giá trị gian lận là giá trị gian lận bị gắn cờ chia cho tổng giá trị gian lận. Khác với recall theo mức giao dịch trong hướng dẫn precision so với recall của chúng tôi, một vụ gian lận 2.000 đô bị bỏ lỡ có trọng số lớn hơn nhiều so với vụ 15 đô, và việc gắn cờ không có nghĩa là đã cứu được tiền. R3 giới hạn ngày bận nhất, và cách diễn đạt đó cuối cùng quyết định cuộc kiểm toán.
Agent có thể điều tra hai thay đổi: năng lực xử lý hằng ngày lên tối đa 260 với một ngưỡng, hoặc tách ngưỡng theo kênh ở mức trần ban đầu. Cả hai đều cần con người phê duyệt, không thể kết hợp, và chính sách ưu tiên phương án không cần thêm người rà soát.
Thế nào là một cuộc kiểm toán đúng
Một kiểm toán đúng cần xác định bốn điều, và bạn nên quyết định chúng trước yêu cầu đầu tiên:
Một bộ đánh giá mà agent không thể gọi sẽ tính câu trả lời.
Cách thiết lập API Gemini 4 Carbon trong Python
Thiết lập Gemini 4 Carbon API cần Python 3.11 trở lên và một khóa API từ một dự án Google AI Studio có bật thanh toán, vì trang giá không có bậc miễn phí.
Cài đặt Google Gen AI SDK và chuẩn bị dự án
Tôi đã thử nghiệm dự án này với bộ SDK Google Gen AI cố định tại
google-genai==3.1.0, bản phát hành trên PyPI vào ngày ra mắt đã thêmgemini-4-carbonvào danh sách mô hình Interactions. Hãy clone dự án và cài đặt trong môi trường ảo:Sau đó, chạy hai lệnh trên trang kho để dựng dữ liệu và fit bộ phân loại với seed cố định. Trên một bản clone mới, chúng in ra như sau:
Seed cố định tái tạo cùng một bộ dữ liệu. Hình: Tác giả.
Tiếp theo đặt
GEMINI_API_KEY=your-keytrong tệp.env. Kho sẽ tải nó mà không in ra.Thực hiện yêu cầu API Gemini 4 Carbon đầu tiên của bạn
Chạy ví dụ hoàn chỉnh này từ thư mục dự án. Nó cung cấp cho Gemini 4 Carbon chính sách và tóm tắt bộ phân loại và hỏi những gì nó cần đo lường, mà không gợi ý về xung đột:
Mức suy luận nằm trong
generation_config, vàoutput_textchứa câu trả lời. Đây là một phần phản hồi trả về:Nó đọc R3 là giá trị đỉnh và lập kế hoạch theo thứ tự ưu tiên của chính sách trước cả khi thấy con số. Tuy nhiên, nó không bao giờ hỏi cách xử lý đồng điểm hoặc làm tròn điểm, và phép kiểm tra toàn diện mà tôi sẽ trình bày sau phụ thuộc chính xác vào điều đó. Lệnh gọi mất khoảng 40 giây và tốn khoảng 2 xu.
Bỏ qua
temperature,top_pvàtop_k, vì Gemini 4 Carbon bỏ qua chúng, và cảthinking_budget.Cách xây dựng Agent kiểm toán ML với gọi hàm của Gemini 4 Carbon
Một agent kiểm toán Gemini 4 Carbon là một vòng lặp: mô hình yêu cầu đánh giá, Python xác thực và chạy nó, và kết quả được gửi lại cho đến khi mô hình ngừng yêu cầu.
Định nghĩa các công cụ chỉ đọc để đánh giá mô hình
Agent có ba công cụ. Tất cả đều bị giới hạn trong khung xác thực:
get_audit_context: tóm tắt bộ phân loại, cấu hình hiện tại, chính sách và các thay đổi được phépevaluate_global_threshold: recall theo giá trị gian lận tổng thể và theo kênh, số lượng gắn cờ theo ngày, và chẩn đoán cho một ngưỡngevaluate_policy_change: các phép đo tương tự cho việc tăng năng lực hoặc một cặp ngưỡng theo kênhCác schema đầy đủ có trong kho. Trích đoạn rút gọn này lược bỏ các trường ngưỡng và năng lực, nên không phải là khai báo hoàn chỉnh để sao chép. Nó chỉ cho thấy ranh giới quan trọng ở đây: công cụ chấp nhận hai thay đổi chính sách mà PayGuard cho phép, đọc dữ liệu xác thực và không phê duyệt gì cả.
Python xác thực các trường ngưỡng và năng lực bị lược bỏ, từ chối các thay đổi ngoài chính sách, và trả về phép đo thay vì cờ pass/fail. Agent không thể truy cập tập giữ lại, gọi bộ đánh giá, hay thay đổi chính sách. Tôi giải thích trong phần Câu hỏi thường gặp vì sao tôi bỏ qua tính năng thực thi mã tích hợp của Gemini 4 Carbon.
Đưa cho agent một mục tiêu rõ ràng và quy tắc dừng
Lời dẫn hệ thống (system instruction) đặt phương pháp. Giống yêu cầu đầu tiên, nó không gợi ý xung đột ở đâu:
Prompt chỉ có thể yêu cầu, vì vậy các giới hạn nằm trong agent harness, tức mã Python bao quanh mô hình. Vì API không có thiết lập ngân sách, ứng dụng đặt chúng theo mỗi lần thử: 25 lượt, 60 lần gọi công cụ, 30 phút và 3 đô, với chi tiêu được kiểm tra giữa các lượt.
Triển khai vòng lặp gọi hàm với Interactions API
Mỗi lượt là một lệnh gọi
client.interactions.create(). Gemini 4 Carbon thường yêu cầu nhiều công cụ cùng lúc, nên vòng lặp chạy ở mỗi bướcfunction_call. Đây là vòng lõi, và phiên bản trong kho bổ sung logging và kiểm tra giới hạn:Tôi giữ các thiết lập này trong một dict
requestđể mọi lệnh gọi tiếp theo gửi lại chúng.previous_interaction_idmang lịch sử, nhưngtools,system_instructionvàgeneration_configchỉ áp dụng cho một tương tác. Nếu một lượt kết thúcincomplete,max_output_tokensđã cắt ngắn nó, và bạn vẫn phải trả tiền cho token suy nghĩ.Trả về báo cáo kiểm toán có cấu trúc với JSON schema
Tài liệu structured output của Google liệt kê công cụ cộng với JSON schema trong một yêu cầu dưới dạng tính năng Preview bao gồm Gemini 4 Carbon. Tôi vẫn tách chúng: các lượt điều tra chỉ đo lường, và một lượt cuối cùng trên cùng lịch sử và cấu hình viết báo cáo với schema và không có công cụ:
AuditReportlà một mô hình Pydantic với phán quyết, xung đột, bằng chứng, khuyến nghị và phê duyệt. Python đo thời gian và chi phí thay vì yêu cầu Gemini 4 Carbon báo cáo chúng.Chạy kiểm toán Gemini 4 Carbon trên mô hình phát hiện gian lận
Gemini 4 Carbon đã kiểm toán mô hình theo cách tôi mong một nhà phân tích mới làm: đo lường trước khi kết luận. Ở lần thử
mediumđầu tiên, nó đọc ngữ cảnh kiểm toán, kiểm tra khoảng hai chục ngưỡng đơn và thử nghiệm tám thay đổi chính sách.Cả 32 lần gọi công cụ, theo thứ tự. Hình: Tác giả.
Đánh giá ngưỡng hiện tại của PayGuard
Agent đánh giá ngưỡng hiện tại 0,5 và tìm thấy recall Website 91%, recall Ứng dụng di động 20%, recall tổng thể 64%, và 85 lượt gắn cờ ở ngày bận nhất. Điều đó không đạt R1 và phần R2 của Ứng dụng di động với dư địa dưới R3, nên bước hiển nhiên là hạ ngưỡng.
Kiểm tra recall theo giá trị gian lận so với năng lực rà soát hằng ngày
Hạ ngưỡng bắt được nhiều giá trị gian lận hơn và gửi nhiều đơn hàng hơn để rà soát. PayGuard cần đủ điều đầu tiên đồng thời giữ điều thứ hai dưới trần theo ngày.
Agent thử vài ngưỡng thô trong một lô, rồi thu hẹp đến các điểm lưới đơn. Các lần gọi 11, 12, 17 và 18 trong vết theo dõi đã kết luận.
Trong khung xác thực này, sàn của Ứng dụng di động cần 0,108 hoặc thấp hơn, vì cao hơn một bước sẽ rơi ngay dưới 70%. Trần cần 0,118 hoặc cao hơn. Không có ngưỡng nào đáp ứng cả hai.
Recall tổng thể giữ được đến 0,137, nên R1 nằm ngoài xung đột. Ở 0,108, ngày trung bình có khoảng 169 lượt gắn cờ, và chỉ một ngày thứ Bảy vượt quá. Đây là lý do chính sách dùng khối lượng công việc của ngày bận nhất thay vì trung bình ngày.
Recall của Mobile và năng lực không bao giờ giao nhau. Hình: Tác giả.
Kiểm tra hiệu năng trên cả hai kênh thanh toán
Gian lận trên Ứng dụng di động, với tín hiệu yếu hơn, nằm thấp trong dải điểm số. Kéo một ngưỡng xuống 0,108 cho Ứng dụng di động cũng lôi vào nhiều đơn Website hợp lệ hơn, và vào ngày thứ Bảy đó, chúng đẩy tổng vượt trần.
Con số tổng thể che giấu điều đó: ở 0,118, recall tổng thể khoảng 87% trong khi Ứng dụng di động nằm dưới sàn của nó. Nếu chính sách của bạn nêu các phân đoạn, hãy đo từng phân đoạn, vì tổng có thể đạt trong khi một phân đoạn không đạt.
Gemini 4 Carbon có phát hiện được các yêu cầu triển khai mâu thuẫn không?
Có, trong kiểm toán này. Báo cáo đóng băng ghi
not deployable, nói rằng không có ngưỡng đơn nào hoạt động, và nêu R2 cho Ứng dụng di động và R3 là xung đột.Đối chiếu phán quyết triển khai của Gemini 4 Carbon với bằng chứng của nó
Mọi con số báo cáo trích dẫn đều khớp với kết quả công cụ, nhưng một câu khẳng định nhiều hơn những gì agent đo được. Nó nói không có ngưỡng nào hoạt động "trên tất cả các điểm lưới điểm rủi ro 0,001", nhưng agent chỉ kiểm tra khoảng hai chục điểm trong vết theo dõi ở trên, trong tổng số 1.002 ngưỡng có thể có.
Khẳng định này vẫn đúng vì recall và số lượt theo ngày đều giảm khi ngưỡng tăng, điều mà báo cáo không bao giờ nói ra. Hãy kiểm tra từng khẳng định trong báo cáo của một agent so với những gì nó đã đo, và hướng dẫn của chúng tôi về đánh giá tác tử AI bao quát thêm các kiểm tra dạng này.
Xác minh xung đột bằng bộ đánh giá Python toàn diện
Gemini 4 Carbon lấy mẫu các ngưỡng và suy ra rằng không ngưỡng nào có thể hoạt động. Bộ đánh giá chứng minh kết quả đó cho tập xác thực này bằng cách kiểm tra mọi tập gắn cờ khác nhau, không dùng chung mã với các công cụ.
Điểm số nằm trên lưới 0,001, nên 1.002 điểm cắt ứng viên bao phủ mọi tập gắn cờ có thể. Bộ đánh giá kiểm tra tất cả, cộng mọi cặp ngưỡng theo kênh, sử dụng đơn vị xu để 85% và 70% là số chính xác.
Kiểm tra toàn diện và bốn cấu hình bị từ chối. Hình: Tác giả.
Không có ngưỡng toàn cục nào vượt qua cả ba quy tắc, nên tuyên bố của Gemini 4 Carbon giờ có bằng chứng phía sau. Bộ đánh giá khớp các ranh giới 0,108 và 0,118 từ phép thăm dò của agent và tìm thấy hàng nghìn cặp kênh đạt ở mức 200 mỗi ngày.
Một bộ đánh giá chỉ hữu ích nếu nó loại bỏ câu trả lời kém, nên tôi đưa vào bốn cấu hình sai, và nó loại bỏ cả bốn.
Thử nghiệm các phương án triển khai với Gemini 4 Carbon
Gemini 4 Carbon thử cả hai thay đổi được phép và chọn tách ngưỡng theo kênh ở mức trần ban đầu thay vì thêm người rà soát. Nó gắn cờ lựa chọn đó là ngoại lệ cần con người phê duyệt.
Thử tăng năng lực rà soát thủ công
Một ngưỡng toàn cục hoạt động nếu trần tăng từ 200 lên 205, và bộ đánh giá xác nhận 205 là mức tăng nhỏ nhất. Gemini 4 Carbon vẫn xếp phương án này thứ hai, vì quy tắc ưu tiên tôi đã mô tả trước đó.
Thử tách ngưỡng cho từng kênh thanh toán
Về phía kênh, agent giữ ngưỡng Ứng dụng di động gần giới hạn của nó (nó đã thấy 0,109 làm vỡ sàn) và nâng ngưỡng Website, giảm lượt gắn cờ ở các đơn Website hợp lệ. Nó thử bảy cặp, và một cặp trượt chỉ vì thiếu một lượt gắn cờ trong ngày bận nhất. Nó đề xuất Website 0,3 và Ứng dụng di động 0,1 vì cặp này vượt qua mọi quy tắc với dư địa, và bộ đánh giá xác nhận ở mức trần ban đầu.
So sánh các phương án đã được xác minh
Những con số này đã xuất hiện ở trên, và bộ đánh giá tính lại từng số:
Phương án
Ngưỡng
Tổng thể
Website
Ứng dụng di động
Ngày bận nhất
Phê duyệt
Chính sách gốc
Toàn cục 0,108
87,5%
98,2%
70,1%
205, trần 200
Trượt
Tăng năng lực
Toàn cục 0,108
87,5%
98,2%
70,1%
205, trần 205
Cần phê duyệt
Tách kênh
Website 0,3, Ứng dụng di động 0,1
86,2%
94,5%
72,8%
191, trần 200
Cần phê duyệt
Phương án tách kênh cũng gắn cờ ít giao dịch hơn khoảng 6% so với phương án tăng năng lực. Tuy nhiên, dưới một nửa lượt gắn cờ là gian lận, điều mà báo cáo liệt kê là một vấn đề mở.
Cách xác minh khuyến nghị của Gemini 4 Carbon trên dữ liệu chưa thấy
Bạn xác minh khuyến nghị bằng cách áp dụng nó, ở trạng thái đóng băng, lên tập giữ lại đã niêm phong. Khác biệt với bộ đánh giá là dữ liệu: bộ đánh giá chấm điểm các tuần mà agent có thể xem, còn tập giữ lại chấm điểm bốn tuần sau đó mà không công cụ nào có thể đọc. Bài kiểm tra chạy một lần cho mỗi khuyến nghị đóng băng và sẽ không bắt đầu nếu báo cáo thay đổi sau khi đóng băng.
Khuyến nghị đóng băng vượt qua trên tập giữ lại. Hình: Tác giả.
Nó vượt qua cả ba quy tắc, và ngày bận nhất vẫn dưới trần. Tuy nhiên đừng diễn giải quá nhiều. Ba điều khiển kết quả này ở mức khiêm tốn:
Hai điều đầu đến từ các con số.
Xem toàn bộ kiểm toán trên Streamlit
Kho cũng bao gồm một ứng dụng Streamlit và sáu lần thử đã được ghi lại, vì vậy bạn có thể mở kiểm toán này mà không cần gọi API. Trong video, tôi tải nó và bước qua từng tab.