Tutorial API Gemini 4 Carbon: Bangun Agen yang Mengaudit Model Penipuan
Pelajari API Gemini 4 Carbon di Python: bangun agen dengan function calling yang mengaudit model penipuan, menemukan aturan yang bertentangan, dan menguji perubahan kebijakan.
Dalam Tutorial API Gemini 4 Argon kami, agen memiliki tugas yang jelas: temukan kode lambat, ubah, dan lolos dari pengujian tersembunyi. Eksperimen pendamping ini mempertahankan pola yang sama dengan alat terkontrol dan pemeriksaan eksternal, tetapi mengganti keputusan. Gemini 4 Carbon harus menentukan apakah aturan asli dapat dipenuhi sama sekali.
PayGuard, sebuah toko online fiktif, memiliki model machine learning (ML) terlatih yang memberi skor pesanan untuk penipuan. Kebijakan penerapannya mengharuskan model menangkap nilai penipuan yang cukup secara keseluruhan dan pada setiap kanal penjualan tanpa membebani tim review. Agen harus menyelidiki aturan-aturan tersebut tanpa diberi tahu apakah ada ambang batas yang valid.
Gemini 4 Carbon adalah model penalaran Google yang Anda panggil dari Python melalui Interactions API. Di sini, model bertindak sebagai agen AI: model memilih pemeriksaan apa yang diminta, dan Python menjalankannya melalui tiga alat hanya-baca menggunakan function calling. Pertanyaan saya adalah apakah model dapat mengidentifikasi konflik, menjelaskan buktinya, dan merekomendasikan perubahan yang diizinkan tanpa menganggap perubahan tersebut telah disetujui.
Anda memerlukan dasar Python dan sedikit pengalaman dengan permintaan API. Saya mendefinisikan setiap metrik penipuan sebelum angka-angka menggunakannya. Kita akan membahas cara:
Mengirim permintaan pertama ke Gemini 4 Carbon dari Python
Memberi model alat hanya-baca dan menjalankannya dalam loop dengan batasan
Mendapatkan putusan kembali sebagai JSON yang dapat diperiksa kode Anda
Memverifikasi putusan tersebut dengan kode dan data yang tidak pernah dilihat model
Membandingkan dua tingkat penalaran, yang mengontrol seberapa banyak model bernalar sebelum menjawab
Jika Anda menginginkan cerita peluncuran dan skor tolok ukur, ringkasan Gemini 4 Carbon kami menyediakannya, dan perbandingan Claude Fable 5.2 vs. Gemini 4 Carbon kami membandingkan kedua model tersebut. Saya menjalankan eksperimen ini sehari setelah Google membuka API untuk pengembang berbayar.
Apa itu API Gemini 4 Carbon?
API Gemini 4 Carbon adalah antarmuka pemrograman aplikasi (API) berbayar untuk gemini-4-carbon, yang halaman model jelaskan sebagai model penalaran untuk tugas agen yang panjang dan multi-langkah. Input, penalaran, dan output berbagi jendela konteks 1.048.576 token, dan respons sinkron berhenti di 65.536 token penalaran plus output secara default.
Mengapa audit model ML merupakan uji yang baik untuk Gemini 4 Carbon
Tugas ini memerlukan beberapa pemeriksaan, pencarian melalui perubahan yang diizinkan, dan berhenti jelas saat aturan tidak memberi jawaban. Saya memilihnya karena Python dapat menghitung hasil referensi. Kartu model mencantumkan halusinasi di antara batasan yang diketahui dari Gemini 4 Carbon, sehingga model menyelidiki sementara Python memutuskan apakah rekomendasinya berlaku.
Proyek: Menentukan Apakah Model Penipuan PayGuard Dapat Diterapkan
PayGuard adalah toko fiktif dari bagian pengantar, dan proyek lengkap ada di repositori GitHub. Klasifikatornya sudah dilatih.
Cara PayGuard memberi skor transaksi
Setiap transaksi memiliki stempel waktu UTC, jumlah, kanal (Website atau Aplikasi Seluler), skor risiko, dan label penipuan. Sebuah scikit-learn HistGradientBoostingClassifier menghasilkan skor, dibulatkan ke 0,001, dan PayGuard menandai transaksi ketika risk_score >= threshold. Tutorial kurva precision-recall kami menunjukkan bagaimana memindahkan ambang batas mengubah apa yang ditandai, dan kursus Fraud Detection in Python kami membahas sisi pemodelannya.
Data sintetis dibagi berdasarkan waktu:
Pelatihan: sembilan minggu pertama, hanya digunakan untuk menyesuaikan klasifikator
Validasi: empat minggu berikutnya, satu-satunya jendela yang dapat dibaca alat
Holdout: empat minggu setelah itu, disegel hingga rekomendasi dibekukan
Ambang batas saat ini adalah 0,5, dan data serta kebijakan tidak pernah berubah selama eksperimen. Penipuan Website meninggalkan sinyal yang jelas dalam data ini, sementara sebagian besar penipuan Aplikasi Seluler terlihat seperti pesanan biasa.
Gemini 4 Carbon bertanya, Python memutuskan. Gambar oleh Penulis.
Tiga aturan penerapan PayGuard
Berikut tiga aturan dari pengantar, ditulis sesuai kebijakan. Semuanya adalah target fiksi yang saya pilih untuk eksperimen ini:
R1: transaksi yang ditandai mencakup setidaknya 85% dari nilai penipuan berlabel secara keseluruhan
R2: mencakup setidaknya 70% dari nilai penipuan berlabel dalam setiap kanal
R3: tidak lebih dari 200 transaksi ditandai pada satu hari UTC mana pun
Recall nilai penipuan adalah nilai penipuan yang ditandai dibagi dengan total nilai penipuan. Berbeda dengan recall tingkat transaksi dalam panduan precision versus recall kami, penipuan $2.000 yang terlewat dihitung jauh lebih besar daripada yang $15, dan penandaan tidak berarti uangnya terselamatkan. R3 membatasi hari tersibuk, dan perumusan itu yang akhirnya menentukan audit.
Agen boleh menyelidiki dua perubahan: kapasitas harian hingga 260 dengan satu ambang global, atau ambang terpisah per kanal pada batas asli. Keduanya memerlukan persetujuan manusia, tidak dapat digabungkan, dan kebijakan memprioritaskan opsi tanpa peninjau tambahan.
Apa yang dianggap sebagai audit yang benar
Audit yang benar menyelesaikan empat hal, dan Anda sebaiknya memutuskan sebelum permintaan pertama:
Putusan: apakah ada satu ambang global yang memenuhi R1, R2, dan R3 pada validasi
Konflik: persyaratan mana yang membuat kebijakan asli menjadi tidak mungkin
Alternatif: perubahan yang diizinkan yang lolos semua aturan saat Python menghitung ulang
Preferensi: rekomendasi mengikuti urutan preferensi kebijakan
Seorang evaluator yang tidak dapat dipanggil agen menghitung jawabannya.
Cara Menyiapkan API Gemini 4 Carbon di Python
Menyiapkan API Gemini 4 Carbon memerlukan Python 3.11 atau lebih baru dan kunci API dari proyek Google AI Studio dengan penagihan aktif, karena halaman harga tidak memiliki tingkat gratis.
Instal Google Gen AI SDK dan siapkan proyek
Saya menguji proyek ini dengan Google Gen AI software development kit (SDK) yang dipatok pada google-genai==3.1.0, rilis hari peluncuran di PyPI yang menambahkan gemini-4-carbon ke daftar model Interactions. Klon proyek dan instal dalam virtual environment:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS or Linux: source .venv/bin/activate
pip install-r requirements.txtDidukung oleh
Setelah itu, jalankan dua perintah pada halaman repositori yang membangun data dan melatih klasifikator dengan seed tetap. Pada klon baru, outputnya seperti ini:
Seed tetap membangun ulang dataset yang sama. Gambar oleh Penulis.
Lalu taruh GEMINI_API_KEY=your-key di file .env. Repositori memuatnya tanpa menampilkannya.
Buat permintaan API Gemini 4 Carbon pertama Anda
Jalankan contoh lengkap ini dari folder proyek. Contoh ini memberikan kebijakan dan ringkasan klasifikator kepada Gemini 4 Carbon dan menanyakan apa yang perlu diukur, tanpa memberi petunjuk adanya konflik:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Didukung oleh
Tingkat penalaran dimasukkan ke dalam generation_config, dan output_text berisi jawabannya. Berikut sebagian dari hasil yang kembali:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Didukung oleh
Model membaca R3 sebagai puncak dan merencanakan urutan preferensi kebijakan sebelum melihat angka. Namun, model tidak pernah menanyakan bagaimana tie atau pembulatan skor bekerja, dan pemeriksaan menyeluruh yang akan saya tunjukkan nanti bergantung tepat pada hal itu. Panggilan memakan waktu sekitar 40 detik dan biaya sekitar 2 sen.
Abaikan temperature, top_p, dan top_k, yang diabaikan oleh Gemini 4 Carbon, serta thinking_budget.
Cara Membangun Agen Audit ML dengan Function Calling Gemini 4 Carbon
Agen audit Gemini 4 Carbon adalah sebuah loop: model meminta evaluasi, Python memvalidasi dan menjalankannya, dan hasilnya dikembalikan hingga model berhenti meminta.
Definisikan alat hanya-baca untuk evaluasi model
Agen mendapat tiga alat. Semuanya terbatas pada jendela validasi:
get_audit_context: ringkasan klasifikator, konfigurasi saat ini, kebijakan, dan perubahan yang diizinkan
evaluate_global_threshold: recall nilai penipuan secara keseluruhan dan per kanal, jumlah tanda per hari, dan diagnostik untuk satu ambang
evaluate_policy_change: pengukuran yang sama untuk peningkatan kapasitas atau pasangan ambang per kanal
Skema lengkap ada di repositori. Cuplikan sederhana ini menghilangkan bidang ambang dan kapasitas, sehingga bukan deklarasi lengkap untuk disalin. Cuplikan hanya menunjukkan batas yang penting di sini: alat menerima dua perubahan kebijakan yang diizinkan PayGuard, membaca data validasi, dan tidak menyetujui apa pun.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Didukung oleh
Python memvalidasi bidang ambang dan kapasitas yang dihilangkan, menolak perubahan di luar kebijakan, dan mengembalikan pengukuran alih-alih bendera lolos atau gagal. Agen tidak dapat mengakses holdout, memanggil evaluator, atau mengubah kebijakan. Saya jelaskan di FAQ mengapa saya melewatkan eksekusi kode bawaan Gemini 4 Carbon.
Beri agen tujuan yang jelas dan aturan penghentian
Instruksi sistem menetapkan metodenya. Seperti permintaan pertama, instruksi tidak memberi petunjuk lokasi konflik:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.Didukung oleh
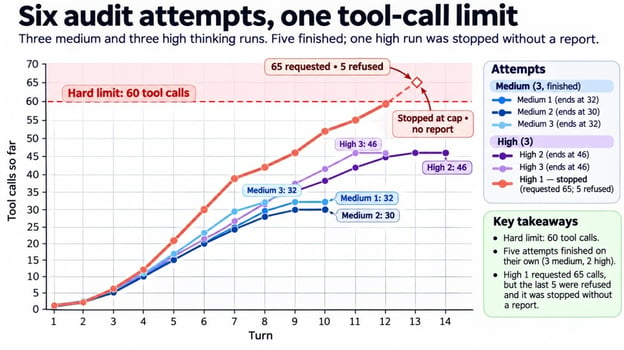
Prompt hanya bisa meminta, jadi batasan berada di agent harness, yaitu kode Python di sekitar model. Karena API tidak memiliki pengaturan anggaran, aplikasi menetapkannya per percobaan: 25 giliran, 60 panggilan alat, 30 menit, dan $3, dengan pengeluaran diperiksa antar giliran.
Implementasikan loop function calling dengan Interactions API
Setiap giliran adalah satu panggilan client.interactions.create(). Gemini 4 Carbon sering meminta beberapa alat sekaligus, jadi loop berjalan di setiap langkah function_call. Ini adalah loop inti, dan versi repositori menambahkan logging dan pemeriksaan batas:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Didukung oleh
Saya menyimpan pengaturan ini dalam satu dict request agar setiap panggilan lanjutan mengirim ulang pengaturan tersebut. previous_interaction_id membawa riwayat, tetapi tools, system_instruction, dan generation_config berlaku untuk satu interaksi saja. Jika sebuah giliran berakhir incomplete, max_output_tokens memotongnya, dan Anda tetap membayar token penalarannya.
Kembalikan laporan audit terstruktur dengan skema JSON
Panduan structured output Google mencantumkan alat plus skema JSON dalam satu permintaan sebagai fitur Pratinjau yang mencakup Gemini 4 Carbon. Saya tetap memisahkannya: giliran investigasi hanya mengukur, dan giliran akhir pada riwayat dan konfigurasi yang sama menulis laporan dengan skema dan tanpa alat:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Didukung oleh
AuditReport adalah model Pydantic dengan putusan, konflik, bukti, rekomendasi, dan persetujuan. Python mengukur waktu dan biaya alih-alih meminta Gemini 4 Carbon melaporkannya.
Jalankan Audit Gemini 4 Carbon pada Model Deteksi Penipuan
Gemini 4 Carbon mengaudit model seperti yang saya harapkan dari analis junior: melakukan pengukuran sebelum kesimpulan apa pun. Pada percobaan pertama dengan medium, model membaca konteks audit, memeriksa sekitar dua lusin ambang global tunggal, dan menguji delapan perubahan kebijakan.
Semua 32 panggilan alat, berurutan. Gambar oleh Penulis.
Evaluasi ambang saat ini milik PayGuard
Agen mengevaluasi ambang saat ini 0,5 dan menemukan recall Website 91%, recall Aplikasi Seluler 20%, recall keseluruhan 64%, dan 85 tanda pada hari tersibuk. Itu gagal R1 dan bagian R2 untuk Aplikasi Seluler dengan ruang di bawah R3, jadi langkah jelasnya adalah menurunkan ambang.
Uji recall nilai penipuan terhadap kapasitas review harian
Menurunkan ambang menangkap lebih banyak nilai penipuan dan mengirim lebih banyak pesanan untuk ditinjau. PayGuard membutuhkan cukup banyak yang pertama sambil menjaga yang kedua di bawah batas harian.
Agen mencoba beberapa ambang kasar dalam satu batch, lalu mempersempit ke titik grid tunggal. Panggilan 11, 12, 17, dan 18 dalam jejak menyelesaikannya.
Pada jendela validasi ini, batas bawah Aplikasi Seluler membutuhkan 0,108 atau lebih rendah, karena satu langkah lebih tinggi menjatuhkannya tepat di bawah 70%. Batas kapasitas membutuhkan 0,118 atau lebih tinggi. Tidak ada ambang yang memenuhi keduanya.
Recall keseluruhan bertahan hingga 0,137, jadi R1 tetap di luar konflik. Pada 0,108, hari rata-rata memiliki sekitar 169 tanda, dan hanya satu hari Sabtu yang melebihi batas. Inilah alasan kebijakan menggunakan beban kerja hari tersibuk, bukan rata-rata harian.
Recall Mobile dan kapasitas tidak pernah tumpang tindih. Gambar oleh Penulis.
Periksa kinerja di kedua kanal pembayaran
Penipuan Aplikasi Seluler, dengan sinyal yang lebih lemah, berada di rentang skor rendah. Menarik satu ambang turun ke 0,108 untuk Aplikasi Seluler juga menarik lebih banyak pesanan Website yang sah, dan pada hari Sabtu itu mendorong total melewati batas.
Angka keseluruhan menyembunyikannya: pada 0,118, recall keseluruhan sekitar 87% sementara Aplikasi Seluler berada di bawah batasnya. Jika kebijakan Anda menyebut segmen, ukurlah masing-masing, karena total bisa lolos sementara satu segmen gagal.
Dapatkah Gemini 4 Carbon Mendeteksi Persyaratan Penerapan yang Bertentangan?
Ya, pada audit ini. Laporan beku menyatakan not deployable, menyebutkan tidak ada satu ambang pun yang berhasil, dan menamai R2 untuk Aplikasi Seluler dan R3 sebagai konflik.
Periksa putusan penerapan Gemini 4 Carbon terhadap buktinya
Setiap angka yang dikutip laporan cocok dengan hasil alat, tetapi satu kalimat mengklaim lebih dari yang diukur agen. Disebutkan tidak ada ambang yang bekerja "melintasi semua titik grid skor risiko 0,001," padahal agen hanya menguji dua lusin seperti pada jejak di atas, dari 1.002 ambang yang mungkin.
Klaim itu berlaku karena recall dan jumlah harian keduanya menurun saat ambang naik, yang tidak pernah disebutkan laporan. Periksa setiap klaim dalam laporan agen terhadap apa yang diukurnya, dan panduan kami tentang mengevaluasi agen AI mencakup lebih banyak pemeriksaan semacam ini.
Verifikasi konflik dengan evaluator Python yang menyeluruh
Gemini 4 Carbon mengambil sampel ambang dan menyimpulkan bahwa tidak ada yang bisa berfungsi. Evaluator membuktikan hasil itu untuk set validasi ini dengan memeriksa setiap set tanda yang berbeda, tanpa berbagi kode dengan alat.
Skor berada pada grid 0,001, sehingga 1.002 cutoff kandidat mencakup setiap kemungkinan set tanda. Evaluator memeriksa semuanya, plus setiap pasangan ambang kanal, menggunakan sen integer sehingga 85% dan 70% menjadi tepat.
Pemeriksaan menyeluruh dan empat konfigurasi yang ditolak. Gambar oleh Penulis.
Tidak ada ambang global yang lolos ketiga aturan, jadi klaim Gemini 4 Carbon kini memiliki bukti di belakangnya. Evaluator mencocokkan batas 0,108 dan 0,118 dari penelusuran agen dan menemukan ribuan pasangan kanal yang lolos pada 200 per hari.
Evaluator hanya berguna jika menolak jawaban buruk, jadi saya memberinya empat konfigurasi yang salah, dan semuanya ditolak.
Uji Alternatif Penerapan dengan Gemini 4 Carbon
Gemini 4 Carbon menguji kedua perubahan yang diizinkan dan memilih ambang terpisah pada batas asli daripada peninjau tambahan. Model menandai pilihan itu sebagai pengecualian yang harus disetujui manusia.
Uji peningkatan kapasitas review manual
Satu ambang global berfungsi jika batas naik dari 200 menjadi 205, dan evaluator mengonfirmasi 205 sebagai peningkatan terkecil. Gemini 4 Carbon tetap menempatkan opsi ini di urutan kedua, karena aturan preferensi yang saya jelaskan sebelumnya.
Uji ambang terpisah untuk setiap kanal pembayaran
Di sisi kanal, agen menjaga ambang Aplikasi Seluler dekat batasnya (model sudah melihat 0,109 melanggar batas bawah) dan menaikkan ambang Website, menurunkan tanda pada pesanan Website yang sah. Agen menguji tujuh pasangan, dan satu gagal hanya karena selisih satu tanda pada hari tersibuk. Agen merekomendasikan Website 0,3 dan Aplikasi Seluler 0,1 karena pasangan itu melewati setiap aturan dengan ruang sisa, dan evaluator mengonfirmasinya pada batas asli.
Bandingkan alternatif yang telah diverifikasi
Angka-angka ini sudah muncul di atas, dan evaluator menghitung ulang masing-masing:
Opsi
Ambang
Keseluruhan
Website
Aplikasi Seluler
Hari tersibuk
Persetujuan
Kebijakan asli
Global 0,108
87,5%
98,2%
70,1%
205, batas 200
Gagal
Kapasitas lebih
Global 0,108
87,5%
98,2%
70,1%
205, batas 205
Butuh persetujuan
Pembagian kanal
Website 0,3, Aplikasi Seluler 0,1
86,2%
94,5%
72,8%
191, batas 200
Butuh persetujuan
Pembagian kanal juga menandai sekitar 6% lebih sedikit transaksi dibanding opsi kapasitas. Namun, kurang dari setengah tandanya adalah penipuan, yang dicantumkan laporan sebagai isu terbuka.
Cara Memverifikasi Rekomendasi Gemini 4 Carbon pada Data yang Tidak Terlihat
Anda memverifikasi rekomendasi dengan menerapkannya, dalam keadaan beku, pada holdout yang disegel. Perbedaannya dari evaluator adalah datanya: evaluator memberi skor minggu-minggu yang dapat dilihat agen, dan holdout memberi skor empat minggu berikutnya yang tidak dapat dibaca alat mana pun. Pemeriksaan dijalankan sekali per rekomendasi beku dan tidak akan dimulai jika laporan berubah setelah dibekukan.
Rekomendasi beku lolos pada holdout. Gambar oleh Penulis.
Rekomendasi tersebut lolos ketiga aturan, dan hari tersibuk tetap di bawah batas. Namun jangan terlalu jauh menafsirkannya. Tiga hal membuat hasil ini tetap sederhana:
Holdout berasal dari generator yang sama, jadi tidak mengatakan apa pun tentang jenis penipuan baru atau pergeseran data
Recall keseluruhan melewati 85% kurang dari dua poin
Dugaan saya yang belum diuji: pembagian bisa melampaui batas jika trafik Aplikasi Seluler tumbuh lebih cepat daripada Website, karena ambang Aplikasi Seluler sangat rendah
Dua poin pertama terlihat dari angka-angka.
Lihat audit lengkap di Streamlit
Repositori juga menyertakan aplikasi Streamlit dan enam percobaan yang direkam, sehingga Anda dapat membuka audit ini tanpa panggilan API. Dalam video, saya memuatnya dan melangkah melalui setiap tab.
Aplikasi Streamlit menampilkan satu audit. Video oleh Penulis.
Gemini 4 Carbon Medium vs. High Thinking: Akurasi, Waktu, dan Biaya
Keberhasilan di sini berarti selesai dalam batas aplikasi dan mengembalikan laporan yang diterima evaluator. Percobaan yang berhenti tidak memiliki putusan untuk dinilai. Dengan definisi itu, medium menyelesaikan setiap percobaan dan biayanya kurang dari setengah per audit yang benar.
Enam percobaan terlalu sedikit untuk menjadikannya aturan umum. Jika tingkat penalaran baru bagi Anda, tutorial API Gemini 3.8 Flash kami membahas thinking_level secara lebih rinci.
Bandingkan medium dan high thinking pada audit yang sama
Ini adalah perbandingan lengkap di balik TL;DR. Saya menjalankan 3 percobaan per tingkat, masing-masing dari keadaan bersih tanpa memori satu sama lain, dengan data, prompt, alat, batas, dan evaluator yang identik:
Per tingkat
medium
high
Percobaan yang selesai dengan laporan
3 dari 3
2 dari 3
Audit benar di antaranya
3 dari 3
2 dari 2
Token penalaran per percobaan
Sekitar 7.700
Sekitar 17.500
Waktu per percobaan
Sekitar 5 menit
Sekitar 6 menit
Biaya per audit benar, tarif perkenalan
Sekitar $0,25
Sekitar $0,62
Biaya per audit benar, tarif standar
Sekitar $0,51
Sekitar $1,24
Baris biaya menghitung pengeluaran setiap percobaan, termasuk yang berhenti. Setiap percobaan yang selesai mencapai putusan dan konflik yang sama dan memilih pasangan kanal yang diterima evaluator, jadi penalaran ekstra masuk ke lebih banyak pemeriksaan.
Saya melihat pola serupa dalam eksperimen pengkodean Gemini 4 Argon: highmenghabiskan lebih banyak dan melakukan lebih banyak pekerjaan untuk perubahan yang lebih kecil pada hasil yang terverifikasi. Tugasnya berbeda, jadi biaya dan tingkat keberhasilan tidak dapat dibandingkan langsung. Dalam kedua kasus, pemeriksaan independen memberi tahu kita lebih banyak daripada total penalaran.
Mengapa satu percobaan high thinking tidak pernah selesai
Percobaan yang berhenti adalah percobaan pertama high, dan tidak pernah memberikan putusan yang salah. Agen menelusuri setiap titik grid dari 0,101 hingga 0,119 lalu mencari batas 70% untuk Website, yang tidak memengaruhi apa pun, dan terus meminta lebih banyak pemeriksaan hingga mencapai batas 60 panggilan yang saya tetapkan sebelumnya dan aplikasi menghentikannya sebelum menulis laporan.
Hanya satu percobaan yang mencapai batas. Gambar oleh Penulis.
Penghentian itu adalah bagian yang berguna. Prompt yang meminta lebih sedikit panggilan tidak akan mengakhirinya, dan batas dalam kode melakukannya, setelah sekitar 22 sen.
Lima laporan yang selesai juga lolos pemeriksaan Python lainnya. Tidak ada yang salah membaca konfigurasi saat ini, menamai persyaratan di luar konflik, mengutip panggilan alat yang tidak ada, atau merekomendasikan konfigurasi yang belum diuji.
Ukur token, waktu, dan biaya per audit
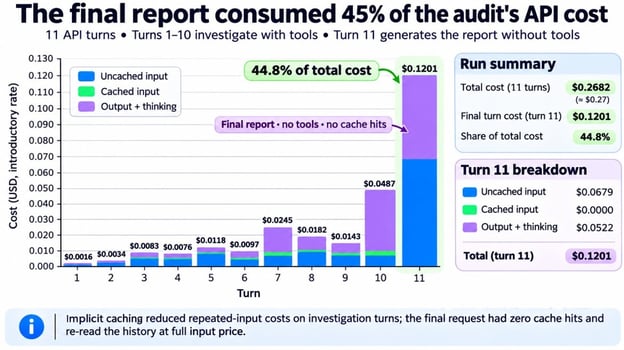
Biaya audit adalah jumlah usage setiap giliran, dihargai $2,00 per sejuta token input, $0,10 untuk yang di-cache, dan $10,00 untuk output termasuk penalaran, semuanya menjadi dua kali lipat pada 1 Desember 2026. total_input_tokens mencakup token yang di-cache, jadi kode memberi harga dua bagian secara terpisah.
Giliran laporan paling mahal. Gambar oleh Penulis.
Hal yang mengejutkan adalah laporan, atau lebih tepatnya, tagihannya. Caching implisit mencakup sekitar tiga perempat token input pada giliran investigasi, tetapi permintaan laporan tanpa alat tidak pernah terkena cache.
Kemungkinan penyebabnya adalah menghapus tools mengubah awal permintaan. Apa pun itu, giliran tersebut membaca ulang seluruh riwayat dengan harga penuh dan mengambil sekitar 40% dari biaya setiap percobaan yang selesai. Hitung giliran itu saat Anda menetapkan batas pengeluaran.
Keterbatasan Menggunakan Gemini 4 Carbon untuk Audit Model ML
Saya merancang uji ini dan menghasilkan datanya sendiri, sehingga hasilnya memiliki batasan berikut:
Datanya sintetis dan berasal dari satu klasifikator, dan saya menyetel generator hingga konflik ada, sebelum panggilan API apa pun
Putusan hanya mencakup klasifikator ini, dan yang lebih baik mungkin memenuhi ketiga aturan dengan satu ambang
Ambang bisa diperiksa, tetapi menyetujui pembagian kanal adalah keputusan bisnis dan keadilan
Interaksi disimpan selama 55 hari pada tingkat berbayar secara default, dan store=false meniadakan previous_interaction_id, jadi agen yang mengirim baris transaksi memerlukan peninjauan data
Evaluator menyelesaikan masalah ambang secara mandiri, tanpa model apa pun. Jika yang Anda butuhkan hanya ambang, gunakan solver optimisasi. Yang ditambahkan Gemini 4 Carbon adalah audit di sekelilingnya.
Tidak ada yang di sini terikat pada penipuan. Penyiapan ini cocok untuk model apa pun yang aturannya bisa diukur Python.
Pemikiran Akhir
Hasil utama adalah Gemini 4 Carbon mengenali bahwa kebijakan asli tidak memiliki ambang global yang valid. Semua 5 percobaan yang selesai menyebut konflik dan mengusulkan pembagian kanal yang diterima evaluator; satu percobaan high berhenti sebelum menghasilkan laporan.
Eksperimen Gemini 4 Argon dan Gemini 4 Carbon menguji dua sisi keandalan agen. Agen Gemini 4 Argon mengubah kode dan harus mempertahankan perilaku, sementara agen Gemini 4 Carbon mencapai keputusan di bawah aturan yang membuat jawaban asli tidak mungkin. Keduanya membutuhkan alat sempit, batas sumber daya, dan pemeriksaan di luar model.
Itu standar yang akan saya gunakan untuk sebuah agen: tetapkan apa yang dapat dibuktikan oleh alatnya, verifikasi hasilnya secara independen, dan izinkan jawaban inconclusiveketika buktinya habis. Selanjutnya, saya akan menempatkan dua atau tiga klasifikator kandidat di bawah kebijakan yang sama dan menanyakan mana yang, jika ada, dapat dirilis.
Saya seorang data engineer dan pembangun komunitas yang bekerja lintas pipeline data, cloud, dan perkakas AI sambil menulis tutorial praktis dan berdampak tinggi untuk DataCamp dan pengembang yang sedang berkembang.
FAQs
Bagaimana cara mendapatkan akses ke API Gemini 4 Carbon?⌄
Melalui proyek Google AI Studio berbayar atau melalui Gemini for business di Google Cloud. Aplikasi Gemini, Antigravity, dan AI Mode juga menawarkannya kepada pelanggan Google AI Ultra, tetapi aplikasi konsumen tersebut tidak memberi Anda kunci API.
Berapa biaya API Gemini 4 Carbon?⌄
Total biaya 6 audit di sini adalah $2,00 pada tarif perkenalan. Permintaan standar seperti ini mendapat caching implisit setelah permintaan melewati 4.096 token input, jadi buat awal setiap permintaan identik. Flex inference, yang juga didukung oleh permintaan Interactions, memangkas separuh tarif token dengan imbalan respons yang lebih lambat dan kurang andal.
Berapa batas laju untuk API Gemini 4 Carbon?⌄
Proyek berbayar memiliki batas per menit plus batas pengeluaran, yaitu $10 per jendela 10 menit bergulir pada Tier 1, dan jika terlampaui akan mengembalikan 429 RESOURCE_EXHAUSTED. Satu audit di sini berbiaya di bawah $1, jadi hanya banyak percobaan paralel yang akan mengenainya. Batas naik sesuai tier Anda, jadi periksa halaman batas laju Google untuk proyek Anda.
Apa perbedaan antara medium dan high thinking di Gemini 4 Carbon?⌄
Gemini 4 Carbon memiliki tiga tingkat, low, medium (default), dan high, dan saya hanya membandingkan dua teratas di sini. Untuk melihat seperti apa penalaran ekstra itu, atur thinking_summarieske "auto" dan Anda akan mendapatkan ringkasan ringkas di samping setiap jawaban. Secara default mati dan bisa kembali kosong saat model hampir tidak bernalar.
Apakah Gemini 4 Carbon dapat menjalankan kode Python?⌄
Ya. Tambahkan {"type": "code_execution"} ke toolsdan Gemini 4 Carbon dapat menulis dan menjalankan Python di sisi Google, ditagihkan pada tarif token normalnya. Saya tidak memasukkannya untuk menjaga kontrol di sisi saya: tiga alat memutuskan apa yang dapat diukur, dan transaksi mentah serta holdout tidak pernah meninggalkan mesin saya.
Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.
Pelajari cara memadukan bisnis, data, dan AI, serta menetapkan tujuan untuk mendorong kesuksesan dengan Strategi AI yang dapat diskalakan secara efektif.





Dalam Tutorial API Gemini 4 Argon kami, agen memiliki tugas yang jelas: temukan kode lambat, ubah, dan lolos dari pengujian tersembunyi. Eksperimen pendamping ini mempertahankan pola yang sama dengan alat terkontrol dan pemeriksaan eksternal, tetapi mengganti keputusan. Gemini 4 Carbon harus menentukan apakah aturan asli dapat dipenuhi sama sekali.
PayGuard, sebuah toko online fiktif, memiliki model machine learning (ML) terlatih yang memberi skor pesanan untuk penipuan. Kebijakan penerapannya mengharuskan model menangkap nilai penipuan yang cukup secara keseluruhan dan pada setiap kanal penjualan tanpa membebani tim review. Agen harus menyelidiki aturan-aturan tersebut tanpa diberi tahu apakah ada ambang batas yang valid.
Gemini 4 Carbon adalah model penalaran Google yang Anda panggil dari Python melalui Interactions API. Di sini, model bertindak sebagai agen AI: model memilih pemeriksaan apa yang diminta, dan Python menjalankannya melalui tiga alat hanya-baca menggunakan function calling. Pertanyaan saya adalah apakah model dapat mengidentifikasi konflik, menjelaskan buktinya, dan merekomendasikan perubahan yang diizinkan tanpa menganggap perubahan tersebut telah disetujui.
Anda memerlukan dasar Python dan sedikit pengalaman dengan permintaan API. Saya mendefinisikan setiap metrik penipuan sebelum angka-angka menggunakannya. Kita akan membahas cara:
Jika Anda menginginkan cerita peluncuran dan skor tolok ukur, ringkasan Gemini 4 Carbon kami menyediakannya, dan perbandingan Claude Fable 5.2 vs. Gemini 4 Carbon kami membandingkan kedua model tersebut. Saya menjalankan eksperimen ini sehari setelah Google membuka API untuk pengembang berbayar.
Apa itu API Gemini 4 Carbon?
API Gemini 4 Carbon adalah antarmuka pemrograman aplikasi (API) berbayar untuk
gemini-4-carbon, yang halaman model jelaskan sebagai model penalaran untuk tugas agen yang panjang dan multi-langkah. Input, penalaran, dan output berbagi jendela konteks 1.048.576 token, dan respons sinkron berhenti di 65.536 token penalaran plus output secara default.Mengapa audit model ML merupakan uji yang baik untuk Gemini 4 Carbon
Tugas ini memerlukan beberapa pemeriksaan, pencarian melalui perubahan yang diizinkan, dan berhenti jelas saat aturan tidak memberi jawaban. Saya memilihnya karena Python dapat menghitung hasil referensi. Kartu model mencantumkan halusinasi di antara batasan yang diketahui dari Gemini 4 Carbon, sehingga model menyelidiki sementara Python memutuskan apakah rekomendasinya berlaku.
Proyek: Menentukan Apakah Model Penipuan PayGuard Dapat Diterapkan
PayGuard adalah toko fiktif dari bagian pengantar, dan proyek lengkap ada di repositori GitHub. Klasifikatornya sudah dilatih.
Cara PayGuard memberi skor transaksi
Setiap transaksi memiliki stempel waktu UTC, jumlah, kanal (Website atau Aplikasi Seluler), skor risiko, dan label penipuan. Sebuah scikit-learn
HistGradientBoostingClassifiermenghasilkan skor, dibulatkan ke 0,001, dan PayGuard menandai transaksi ketikarisk_score >= threshold. Tutorial kurva precision-recall kami menunjukkan bagaimana memindahkan ambang batas mengubah apa yang ditandai, dan kursus Fraud Detection in Python kami membahas sisi pemodelannya.Data sintetis dibagi berdasarkan waktu:
Ambang batas saat ini adalah 0,5, dan data serta kebijakan tidak pernah berubah selama eksperimen. Penipuan Website meninggalkan sinyal yang jelas dalam data ini, sementara sebagian besar penipuan Aplikasi Seluler terlihat seperti pesanan biasa.
Gemini 4 Carbon bertanya, Python memutuskan. Gambar oleh Penulis.
Tiga aturan penerapan PayGuard
Berikut tiga aturan dari pengantar, ditulis sesuai kebijakan. Semuanya adalah target fiksi yang saya pilih untuk eksperimen ini:
Recall nilai penipuan adalah nilai penipuan yang ditandai dibagi dengan total nilai penipuan. Berbeda dengan recall tingkat transaksi dalam panduan precision versus recall kami, penipuan $2.000 yang terlewat dihitung jauh lebih besar daripada yang $15, dan penandaan tidak berarti uangnya terselamatkan. R3 membatasi hari tersibuk, dan perumusan itu yang akhirnya menentukan audit.
Agen boleh menyelidiki dua perubahan: kapasitas harian hingga 260 dengan satu ambang global, atau ambang terpisah per kanal pada batas asli. Keduanya memerlukan persetujuan manusia, tidak dapat digabungkan, dan kebijakan memprioritaskan opsi tanpa peninjau tambahan.
Apa yang dianggap sebagai audit yang benar
Audit yang benar menyelesaikan empat hal, dan Anda sebaiknya memutuskan sebelum permintaan pertama:
Seorang evaluator yang tidak dapat dipanggil agen menghitung jawabannya.
Cara Menyiapkan API Gemini 4 Carbon di Python
Menyiapkan API Gemini 4 Carbon memerlukan Python 3.11 atau lebih baru dan kunci API dari proyek Google AI Studio dengan penagihan aktif, karena halaman harga tidak memiliki tingkat gratis.
Instal Google Gen AI SDK dan siapkan proyek
Saya menguji proyek ini dengan Google Gen AI software development kit (SDK) yang dipatok pada
google-genai==3.1.0, rilis hari peluncuran di PyPI yang menambahkangemini-4-carbonke daftar model Interactions. Klon proyek dan instal dalam virtual environment:Setelah itu, jalankan dua perintah pada halaman repositori yang membangun data dan melatih klasifikator dengan seed tetap. Pada klon baru, outputnya seperti ini:
Seed tetap membangun ulang dataset yang sama. Gambar oleh Penulis.
Lalu taruh
GEMINI_API_KEY=your-keydi file.env. Repositori memuatnya tanpa menampilkannya.Buat permintaan API Gemini 4 Carbon pertama Anda
Jalankan contoh lengkap ini dari folder proyek. Contoh ini memberikan kebijakan dan ringkasan klasifikator kepada Gemini 4 Carbon dan menanyakan apa yang perlu diukur, tanpa memberi petunjuk adanya konflik:
Tingkat penalaran dimasukkan ke dalam
generation_config, danoutput_textberisi jawabannya. Berikut sebagian dari hasil yang kembali:Model membaca R3 sebagai puncak dan merencanakan urutan preferensi kebijakan sebelum melihat angka. Namun, model tidak pernah menanyakan bagaimana tie atau pembulatan skor bekerja, dan pemeriksaan menyeluruh yang akan saya tunjukkan nanti bergantung tepat pada hal itu. Panggilan memakan waktu sekitar 40 detik dan biaya sekitar 2 sen.
Abaikan
temperature,top_p, dantop_k, yang diabaikan oleh Gemini 4 Carbon, sertathinking_budget.Cara Membangun Agen Audit ML dengan Function Calling Gemini 4 Carbon
Agen audit Gemini 4 Carbon adalah sebuah loop: model meminta evaluasi, Python memvalidasi dan menjalankannya, dan hasilnya dikembalikan hingga model berhenti meminta.
Definisikan alat hanya-baca untuk evaluasi model
Agen mendapat tiga alat. Semuanya terbatas pada jendela validasi:
get_audit_context: ringkasan klasifikator, konfigurasi saat ini, kebijakan, dan perubahan yang diizinkanevaluate_global_threshold: recall nilai penipuan secara keseluruhan dan per kanal, jumlah tanda per hari, dan diagnostik untuk satu ambangevaluate_policy_change: pengukuran yang sama untuk peningkatan kapasitas atau pasangan ambang per kanalSkema lengkap ada di repositori. Cuplikan sederhana ini menghilangkan bidang ambang dan kapasitas, sehingga bukan deklarasi lengkap untuk disalin. Cuplikan hanya menunjukkan batas yang penting di sini: alat menerima dua perubahan kebijakan yang diizinkan PayGuard, membaca data validasi, dan tidak menyetujui apa pun.
Python memvalidasi bidang ambang dan kapasitas yang dihilangkan, menolak perubahan di luar kebijakan, dan mengembalikan pengukuran alih-alih bendera lolos atau gagal. Agen tidak dapat mengakses holdout, memanggil evaluator, atau mengubah kebijakan. Saya jelaskan di FAQ mengapa saya melewatkan eksekusi kode bawaan Gemini 4 Carbon.
Beri agen tujuan yang jelas dan aturan penghentian
Instruksi sistem menetapkan metodenya. Seperti permintaan pertama, instruksi tidak memberi petunjuk lokasi konflik:
Prompt hanya bisa meminta, jadi batasan berada di agent harness, yaitu kode Python di sekitar model. Karena API tidak memiliki pengaturan anggaran, aplikasi menetapkannya per percobaan: 25 giliran, 60 panggilan alat, 30 menit, dan $3, dengan pengeluaran diperiksa antar giliran.
Implementasikan loop function calling dengan Interactions API
Setiap giliran adalah satu panggilan
client.interactions.create(). Gemini 4 Carbon sering meminta beberapa alat sekaligus, jadi loop berjalan di setiap langkahfunction_call. Ini adalah loop inti, dan versi repositori menambahkan logging dan pemeriksaan batas:Saya menyimpan pengaturan ini dalam satu dict
requestagar setiap panggilan lanjutan mengirim ulang pengaturan tersebut.previous_interaction_idmembawa riwayat, tetapitools,system_instruction, dangeneration_configberlaku untuk satu interaksi saja. Jika sebuah giliran berakhirincomplete,max_output_tokensmemotongnya, dan Anda tetap membayar token penalarannya.Kembalikan laporan audit terstruktur dengan skema JSON
Panduan structured output Google mencantumkan alat plus skema JSON dalam satu permintaan sebagai fitur Pratinjau yang mencakup Gemini 4 Carbon. Saya tetap memisahkannya: giliran investigasi hanya mengukur, dan giliran akhir pada riwayat dan konfigurasi yang sama menulis laporan dengan skema dan tanpa alat:
AuditReportadalah model Pydantic dengan putusan, konflik, bukti, rekomendasi, dan persetujuan. Python mengukur waktu dan biaya alih-alih meminta Gemini 4 Carbon melaporkannya.Jalankan Audit Gemini 4 Carbon pada Model Deteksi Penipuan
Gemini 4 Carbon mengaudit model seperti yang saya harapkan dari analis junior: melakukan pengukuran sebelum kesimpulan apa pun. Pada percobaan pertama dengan
medium, model membaca konteks audit, memeriksa sekitar dua lusin ambang global tunggal, dan menguji delapan perubahan kebijakan.Semua 32 panggilan alat, berurutan. Gambar oleh Penulis.
Evaluasi ambang saat ini milik PayGuard
Agen mengevaluasi ambang saat ini 0,5 dan menemukan recall Website 91%, recall Aplikasi Seluler 20%, recall keseluruhan 64%, dan 85 tanda pada hari tersibuk. Itu gagal R1 dan bagian R2 untuk Aplikasi Seluler dengan ruang di bawah R3, jadi langkah jelasnya adalah menurunkan ambang.
Uji recall nilai penipuan terhadap kapasitas review harian
Menurunkan ambang menangkap lebih banyak nilai penipuan dan mengirim lebih banyak pesanan untuk ditinjau. PayGuard membutuhkan cukup banyak yang pertama sambil menjaga yang kedua di bawah batas harian.
Agen mencoba beberapa ambang kasar dalam satu batch, lalu mempersempit ke titik grid tunggal. Panggilan 11, 12, 17, dan 18 dalam jejak menyelesaikannya.
Pada jendela validasi ini, batas bawah Aplikasi Seluler membutuhkan 0,108 atau lebih rendah, karena satu langkah lebih tinggi menjatuhkannya tepat di bawah 70%. Batas kapasitas membutuhkan 0,118 atau lebih tinggi. Tidak ada ambang yang memenuhi keduanya.
Recall keseluruhan bertahan hingga 0,137, jadi R1 tetap di luar konflik. Pada 0,108, hari rata-rata memiliki sekitar 169 tanda, dan hanya satu hari Sabtu yang melebihi batas. Inilah alasan kebijakan menggunakan beban kerja hari tersibuk, bukan rata-rata harian.
Recall Mobile dan kapasitas tidak pernah tumpang tindih. Gambar oleh Penulis.
Periksa kinerja di kedua kanal pembayaran
Penipuan Aplikasi Seluler, dengan sinyal yang lebih lemah, berada di rentang skor rendah. Menarik satu ambang turun ke 0,108 untuk Aplikasi Seluler juga menarik lebih banyak pesanan Website yang sah, dan pada hari Sabtu itu mendorong total melewati batas.
Angka keseluruhan menyembunyikannya: pada 0,118, recall keseluruhan sekitar 87% sementara Aplikasi Seluler berada di bawah batasnya. Jika kebijakan Anda menyebut segmen, ukurlah masing-masing, karena total bisa lolos sementara satu segmen gagal.
Dapatkah Gemini 4 Carbon Mendeteksi Persyaratan Penerapan yang Bertentangan?
Ya, pada audit ini. Laporan beku menyatakan
not deployable, menyebutkan tidak ada satu ambang pun yang berhasil, dan menamai R2 untuk Aplikasi Seluler dan R3 sebagai konflik.Periksa putusan penerapan Gemini 4 Carbon terhadap buktinya
Setiap angka yang dikutip laporan cocok dengan hasil alat, tetapi satu kalimat mengklaim lebih dari yang diukur agen. Disebutkan tidak ada ambang yang bekerja "melintasi semua titik grid skor risiko 0,001," padahal agen hanya menguji dua lusin seperti pada jejak di atas, dari 1.002 ambang yang mungkin.
Klaim itu berlaku karena recall dan jumlah harian keduanya menurun saat ambang naik, yang tidak pernah disebutkan laporan. Periksa setiap klaim dalam laporan agen terhadap apa yang diukurnya, dan panduan kami tentang mengevaluasi agen AI mencakup lebih banyak pemeriksaan semacam ini.
Verifikasi konflik dengan evaluator Python yang menyeluruh
Gemini 4 Carbon mengambil sampel ambang dan menyimpulkan bahwa tidak ada yang bisa berfungsi. Evaluator membuktikan hasil itu untuk set validasi ini dengan memeriksa setiap set tanda yang berbeda, tanpa berbagi kode dengan alat.
Skor berada pada grid 0,001, sehingga 1.002 cutoff kandidat mencakup setiap kemungkinan set tanda. Evaluator memeriksa semuanya, plus setiap pasangan ambang kanal, menggunakan sen integer sehingga 85% dan 70% menjadi tepat.
Pemeriksaan menyeluruh dan empat konfigurasi yang ditolak. Gambar oleh Penulis.
Tidak ada ambang global yang lolos ketiga aturan, jadi klaim Gemini 4 Carbon kini memiliki bukti di belakangnya. Evaluator mencocokkan batas 0,108 dan 0,118 dari penelusuran agen dan menemukan ribuan pasangan kanal yang lolos pada 200 per hari.
Evaluator hanya berguna jika menolak jawaban buruk, jadi saya memberinya empat konfigurasi yang salah, dan semuanya ditolak.
Uji Alternatif Penerapan dengan Gemini 4 Carbon
Gemini 4 Carbon menguji kedua perubahan yang diizinkan dan memilih ambang terpisah pada batas asli daripada peninjau tambahan. Model menandai pilihan itu sebagai pengecualian yang harus disetujui manusia.
Uji peningkatan kapasitas review manual
Satu ambang global berfungsi jika batas naik dari 200 menjadi 205, dan evaluator mengonfirmasi 205 sebagai peningkatan terkecil. Gemini 4 Carbon tetap menempatkan opsi ini di urutan kedua, karena aturan preferensi yang saya jelaskan sebelumnya.
Uji ambang terpisah untuk setiap kanal pembayaran
Di sisi kanal, agen menjaga ambang Aplikasi Seluler dekat batasnya (model sudah melihat 0,109 melanggar batas bawah) dan menaikkan ambang Website, menurunkan tanda pada pesanan Website yang sah. Agen menguji tujuh pasangan, dan satu gagal hanya karena selisih satu tanda pada hari tersibuk. Agen merekomendasikan Website 0,3 dan Aplikasi Seluler 0,1 karena pasangan itu melewati setiap aturan dengan ruang sisa, dan evaluator mengonfirmasinya pada batas asli.
Bandingkan alternatif yang telah diverifikasi
Angka-angka ini sudah muncul di atas, dan evaluator menghitung ulang masing-masing:
Opsi
Ambang
Keseluruhan
Website
Aplikasi Seluler
Hari tersibuk
Persetujuan
Kebijakan asli
Global 0,108
87,5%
98,2%
70,1%
205, batas 200
Gagal
Kapasitas lebih
Global 0,108
87,5%
98,2%
70,1%
205, batas 205
Butuh persetujuan
Pembagian kanal
Website 0,3, Aplikasi Seluler 0,1
86,2%
94,5%
72,8%
191, batas 200
Butuh persetujuan
Pembagian kanal juga menandai sekitar 6% lebih sedikit transaksi dibanding opsi kapasitas. Namun, kurang dari setengah tandanya adalah penipuan, yang dicantumkan laporan sebagai isu terbuka.
Cara Memverifikasi Rekomendasi Gemini 4 Carbon pada Data yang Tidak Terlihat
Anda memverifikasi rekomendasi dengan menerapkannya, dalam keadaan beku, pada holdout yang disegel. Perbedaannya dari evaluator adalah datanya: evaluator memberi skor minggu-minggu yang dapat dilihat agen, dan holdout memberi skor empat minggu berikutnya yang tidak dapat dibaca alat mana pun. Pemeriksaan dijalankan sekali per rekomendasi beku dan tidak akan dimulai jika laporan berubah setelah dibekukan.
Rekomendasi beku lolos pada holdout. Gambar oleh Penulis.
Rekomendasi tersebut lolos ketiga aturan, dan hari tersibuk tetap di bawah batas. Namun jangan terlalu jauh menafsirkannya. Tiga hal membuat hasil ini tetap sederhana:
Dua poin pertama terlihat dari angka-angka.
Lihat audit lengkap di Streamlit
Repositori juga menyertakan aplikasi Streamlit dan enam percobaan yang direkam, sehingga Anda dapat membuka audit ini tanpa panggilan API. Dalam video, saya memuatnya dan melangkah melalui setiap tab.