import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")技术支持
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412技术支持
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}技术支持
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.技术支持
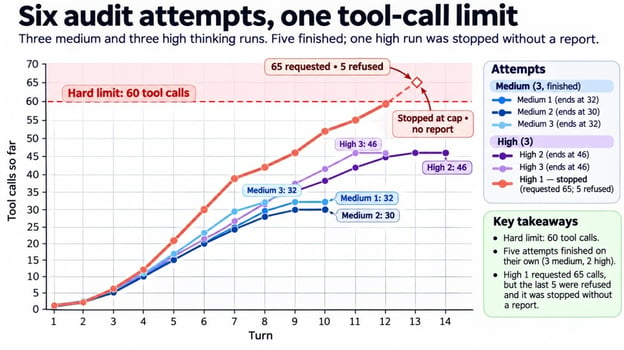
提示词只能提出请求,因此限制保存在代理框架中,也就是围绕模型的 Python 代码。由于 API 没有预算设置,应用按尝试设置:25 回合、60 次工具调用、30 分钟和 3 美元,并在回合间检查支出。
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)技术支持
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.



在我们的Gemini 4 Argon API 教程中,代理的任务很明确:找出慢代码、修改它,并通过隐藏测试。本篇配套实验延续了受控工具和外部校验的模式,但改变了决策内容。Gemini 4 Carbon 需要判断原始规则是否根本就能被满足。
虚构的线上商店 PayGuard 拥有一个训练好的机器学习(ML)模型,对订单进行欺诈评分。其上线策略要求模型在总体以及各销售渠道上抓住足够的欺诈金额,同时不至于压垮人工复核团队。代理必须在不被告知是否存在有效阈值的情况下,调查这些规则。
Gemini 4 Carbon 是 Google 的推理模型,您可以通过 Interactions API 从 Python 调用。在这里,它充当一个AI 代理:它选择要发起哪些检查,Python 则通过 函数调用 运行三种只读工具。我的问题是,它能否识别冲突、解释证据,并在不把该更改视为已批准的前提下,给出一个允许的变更建议。
您需要具备基础的 Python 能力和少量 API 请求经验。我会在用到数字之前定义每个欺诈指标。我们将涵盖如何:
如果您想了解发布背景和基准分数,请查阅我们的Gemini 4 Carbon 概览;我们的Claude Fable 5.2 vs. Gemini 4 Carbon 一文则对两款模型进行比较。我在 Google 向付费开发者开放 API 的次日就进行了这次实验。
什么是 Gemini 4 Carbon API?
Gemini 4 Carbon API 是面向
gemini-4-carbon的付费应用程序编程接口(API),其模型页面将其描述为适用于长、多步骤代理任务的推理模型。输入、思考与输出共享 1,048,576 令牌的上下文窗口,且同步响应默认在 65,536 个思考加输出令牌处停止。为何用 ML 模型审计来测试 Gemini 4 Carbon
该任务需要多项检查、在允许的变更中搜索,并在规则无解时明确停止。我之所以选择它,是因为 Python 可以计算参考结果。 模型卡将幻觉列为 Gemini 4 Carbon 的已知限制之一,因此由模型负责调查,而 Python 决定其建议是否成立。
项目:判断 PayGuard 的欺诈模型是否可以上线
PayGuard 是引言中的虚构商店,完整项目见 GitHub 仓库。其分类器已训练完成。
PayGuard 如何对交易评分
每笔交易包含协调世界时(UTC)时间戳、金额、渠道(网站或移动应用)、风险评分和欺诈标签。一个 scikit-learn 的
HistGradientBoostingClassifier生成评分,四舍五入到 0.001,当risk_score >= threshold时 PayGuard 标记该笔交易。我们的精确率-召回率曲线教程展示了移动阈值如何改变标记结果,而我们的用 Python 进行欺诈检测课程涵盖了建模方面。合成数据按时间切分:
当前阈值为 0.5,实验期间数据和策略均不变。在这份数据中,网站渠道的欺诈信号明显,而多数移动应用渠道的欺诈看起来像普通订单。
Gemini 4 Carbon 负责提问,Python 负责裁决。作者供图。
PayGuard 的三条部署规则
以下是引言中的三条规则,按策略原文表述。均为我为本实验设定的虚构目标:
“欺诈金额召回率”指被标记的欺诈金额除以欺诈总金额。不同于我们精确率与召回率指南中的交易级别召回,一个 2,000 美元的漏判比 15 美元的漏判重要得多,且被标记并不意味着资金被挽回。R3 对最繁忙的单日设上限,而这一定义最终决定了审计结论。
代理可以调查两种变更:在单一阈值下,将每日处理能力提高至最多 260;或在原有上限下设置独立的渠道阈值。两者都需要人工批准,不能组合使用,且策略偏好不增加复核员数量的选项。
何为正确的审计
正确的审计需要把四件事做对,且应在首次请求前就定好:
代理无法调用的评估器负责计算答案。
如何在 Python 中设置 Gemini 4 Carbon API
设置 Gemini 4 Carbon API 需要 Python 3.11 或更高版本,以及来自启用计费的 Google AI Studio 项目的API 密钥,因为定价页面未列出免费层。
安装 Google Gen AI SDK 并准备项目
我用固定版本
google-genai==3.1.0测试了该项目,这是在 PyPI 的首发版本,将gemini-4-carbon加入了 Interactions 的模型列表。克隆项目并在虚拟环境中安装:之后,运行仓库页面上的两条命令,使用固定随机种子构建数据并拟合分类器。在全新克隆上,它们会打印如下输出:
固定随机种子可重建相同数据集。作者供图。
然后将
GEMINI_API_KEY=your-key放入.env文件中。仓库会加载它且不会打印出来。发起您的首个 Gemini 4 Carbon API 请求
在项目文件夹中运行以下完整示例。它将策略和分类器摘要提供给 Gemini 4 Carbon,并在不暗示存在冲突的情况下询问其需要测量什么:
思考级别通过
generation_config指定,output_text存放答案。以下是返回内容的一部分:它将 R3 理解为峰值限制,并在看到任何数字之前就规划了策略的偏好顺序。不过,它从未询问并列或分数四舍五入的处理方式,而我稍后展示的穷举检查正依赖于此。此次调用耗时约 40 秒,成本约 2 美分。
无需填写
temperature、top_p和top_k(Gemini 4 Carbon 会忽略),也不需要thinking_budget。如何用 Gemini 4 Carbon 函数调用构建 ML 审计代理
Gemini 4 Carbon 审计代理是一个循环:模型请求一次评估,Python 验证并执行,请求结果回传给模型,直至模型停止提出请求。
为模型评估定义只读工具
代理拥有三种工具,且都仅限读取验证窗口:
get_audit_context:分类器摘要、当前配置、策略与允许的变更evaluate_global_threshold:针对单一阈值,计算总体及分渠道的欺诈金额召回、每日标记数与诊断信息evaluate_policy_change:对提高处理能力或设置渠道阈值对,给出相同的度量完整架构见仓库。此简化片段省略了阈值和处理能力字段,因此并非可直接复制的完整声明。它仅展示此处关键边界:该工具仅接受 PayGuard 允许的两类策略变更,读取验证数据,不审批任何事项。
Python 会验证被省略的阈值和处理能力字段,拒绝超出策略范围的变更,并返回测量值而非通过/失败标记。代理无法访问保留集、调用评估器或更改策略。我在常见问题中解释了为何未使用 Gemini 4 Carbon 的内置代码执行功能。
为代理提供清晰目标与停止规则
系统指令规定了方法。和首个请求一样,它并不暗示冲突所在:
提示词只能提出请求,因此限制保存在代理框架中,也就是围绕模型的 Python 代码。由于 API 没有预算设置,应用按尝试设置:25 回合、60 次工具调用、30 分钟和 3 美元,并在回合间检查支出。
用 Interactions API 实现函数调用循环
每一回合都是一次
client.interactions.create()调用。Gemini 4 Carbon 常常一次请求多个工具,因此循环会运行每个function_call步骤。以下是核心循环,仓库版本还加入了日志与限额检查:我将这些设置置于一个
request字典中,以便每次跟进请求都重新发送它们。previous_interaction_id携带历史,但tools、system_instruction和generation_config仅适用于一次交互。如果某回合以incomplete结束,说明max_output_tokens将其截断,而您仍需为该回合的思考令牌付费。用 JSON 架构返回结构化审计报告
Google 的结构化输出指南列出了在一次请求中同时包含工具和 JSON 架构的方式,作为包含 Gemini 4 Carbon 在内的预览特性。我仍将二者分开:调查回合只做测量,随后在相同历史和配置上,由一个最终回合用架构写出报告,不再使用工具:
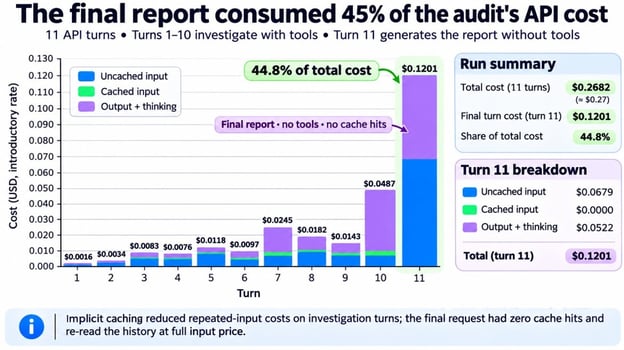
AuditReport是一个Pydantic 模型,包含裁定、冲突、证据、建议和审批。Python 负责度量时间和成本,而不是让 Gemini 4 Carbon 报告它们。在欺诈检测模型上运行 Gemini 4 Carbon 审计
Gemini 4 Carbon 按我对初级分析师的期待来进行审计:先测量,后结论。第一次
medium尝试中,它读取审计上下文,检查了约两打单一阈值,并测试了八种策略变更。全部 32 次工具调用的顺序。作者供图。
评估 PayGuard 当前阈值
代理评估了当前 0.5 的阈值,得到网站渠道 91% 的召回、移动应用渠道 20% 的召回、总体 64% 的召回,以及最繁忙日 85 笔标记。这在 R3 留有余量的同时未达成 R1 和 R2 的移动应用部分,因此显而易见的动作是降低阈值。
将欺诈金额召回与每日复核能力对照测试
降低阈值会捕获更多欺诈金额,同时也会送更多订单去复核。PayGuard 需要在提升前者的同时将后者控制在每日上限之内。
代理先在一批中尝试了几个粗粒度阈值,然后收敛到单个网格点。跟踪中的第 11、12、17 和 18 次调用给出了结论。
在这个验证窗口上,移动应用的下限需要 0.108 或更低,因为再高一个档位就会略低于 70%。而上限需要 0.118 或更高。没有一个阈值能同时满足二者。
总体召回可稳定至 0.137,因此 R1 不在冲突范围内。在 0.108 时,平均每日约有 169 笔标记,且只有一个周六超过上限。这正是策略采用“最繁忙单日”的工作量而非“日均”的原因。
移动端召回与处理能力从未重叠。作者供图。
检查跨两个支付渠道的表现
移动应用渠道的欺诈信号较弱,集中在较低分数段。将单一阈值拖到 0.108 以满足移动应用,也会吸入更多合法的网站订单,而在那个周六,它们会把总数推高至超出上限。
总体数字会掩盖这一点:在 0.118 时,总体召回约 87%,而移动应用低于其下限。如果您的策略点名了分段,就应分别度量,因为总体可能通过,而某个分段未通过。
Gemini 4 Carbon 能识别部署要求间的冲突吗?
在这次审计中,答案是肯定的。冻结报告给出
not deployable(不可部署),说明没有单一阈值可行,并将冲突归因于移动应用的 R2 与 R3。将 Gemini 4 Carbon 的部署裁定与其证据进行核对
报告中引用的每个数字都与某次工具结果匹配,但有一句话超出了代理的测量范围。它称没有阈值在“所有 0.001 风险分数网格点上”可行,然而代理仅测试了上面跟踪中的两打阈值,而非 1,002 个可能阈值。
该断言之所以成立,是因为阈值升高时,召回与每日计数都会下降,而报告并未说明这一点。请将代理报告中的每条论断与其实际测量进行核对;我们的AI 代理评估指南涵盖了更多类似检查。
用穷举式 Python 评估器验证冲突
Gemini 4 Carbon 采样了若干阈值,并推断出没有一个可行。评估器通过检查每一种不同的标记集合,来对该验证集证明这一结果,且不与工具共享代码。
评分位于 0.001 的网格上,因此 1,002 个候选截断点涵盖了所有可能的标记集合。评估器会检查它们全部,以及每一对渠道阈值,并使用“分”为单位的整数金额使 85% 与 70% 精确可比。
穷举检查与四个被拒配置。作者供图。
没有全局阈值能通过三条规则,因此现在 Gemini 4 Carbon 的断言有了背书。评估器与代理探测出的 0.108 和 0.118 边界一致,并找到在每日 200 笔上限下通过的数千组渠道阈值对。
评估器只有在能否定错误答案时才有用,因此我给它喂了四个错误配置,结果全部被拒。
用 Gemini 4 Carbon 测试部署替代方案
Gemini 4 Carbon 测试了两种允许的变更,并在原有上限下选择了渠道分阈值,而不是增加复核员人数。它将此选择标注为需要人工批准的例外。
测试提高人工复核能力
如果将上限从 200 提高到 205,一个全局阈值即可可行,评估器确认 205 为最小增量。不过,Gemini 4 Carbon 仍将该选项排在第二,因为此前所述的偏好规则。
测试为各支付渠道设置独立阈值
在渠道方面,代理将移动应用阈值维持在其极限附近(它已看到 0.109 会跌破下限),同时提高网站阈值,减少对合法网站订单的标记。它测试了七组阈值对,其中一组在最繁忙日仅差一个标记未通过。它建议网站 0.3、移动应用 0.1,因为这组在所有规则上均有余量通过,评估器也在原有上限下确认了它。
对比已验证的替代方案
这些数字上文已出现,评估器也逐一重新计算:
选项
阈值
总体
网站
移动应用
最繁忙日
审批
原始策略
全局 0.108
87.5%
98.2%
70.1%
205,上限 200
不通过
增加处理能力
全局 0.108
87.5%
98.2%
70.1%
205,上限 205
需要
渠道拆分
网站 0.3、移动应用 0.1
86.2%
94.5%
72.8%
191,上限 200
需要
渠道拆分比提高处理能力的方案少标记约 6% 的交易。不过其标记中不足一半为欺诈,报告将其列为待解决问题。
如何在未见过的数据上验证 Gemini 4 Carbon 的建议
通过将“冻结”的建议应用到“封存”的保留集来进行验证。它与评估器的区别在于数据:评估器在代理可见的几周上计分,而保留集计分的是之后四周,任何工具都无法读取。每条冻结建议仅运行一次该检查,且如果报告在冻结后发生变化,检查将不会启动。
冻结的建议在保留集上通过。作者供图。
它通过了三条规则,且最繁忙日保持在上限之下。但不要过度解读。三个因素使该结果仍然保守:
前两点来自于数据本身的数字。
在 Streamlit 中观看完整审计
该仓库还包含一个 Streamlit 应用和六次已录制的尝试,因此您无需 API 调用也能打开本次审计。在视频中,我加载它并逐个标签页演示。