Tutorial de la API Gemini 4 Carbon: crea un agente que audita un modelo de fraude
Aprende la API Gemini 4 Carbon en Python: crea un agente con function calling que audita un modelo de fraude, encuentra reglas en conflicto y prueba un cambio de política.
En nuestro tutorial de la API Gemini 4 Argon, el agente tenía un cometido claro: encontrar código lento, cambiarlo y pasar pruebas ocultas. Este experimento complementario sigue el mismo patrón de herramientas controladas y verificación externa, pero cambia la decisión. Gemini 4 Carbon tiene que determinar si las reglas originales pueden satisfacerse en absoluto.
PayGuard, una tienda online ficticia, tiene un modelo de machine learning (ML) entrenado que puntúa pedidos por riesgo de fraude. Su política de despliegue exige que el modelo capture suficiente valor de fraude en total y en cada canal de venta sin desbordar al equipo de revisión. El agente debe investigar esas reglas sin saber de antemano si existe un umbral válido.
Gemini 4 Carbon es un modelo de razonamiento de Google al que llamas desde Python a través de la Interactions API. Aquí actúa como agente de IA: elige qué comprobaciones solicitar, y Python las ejecuta mediante tres herramientas de solo lectura usando function calling. Mi pregunta es si puede identificar el conflicto, explicar las evidencias y recomendar un cambio permitido sin tratar ese cambio como aprobado.
Necesitarás Python básico y algo de experiencia con peticiones a APIs. Defino cada métrica de fraude antes de que aparezcan los números. Veremos cómo:
Enviar tu primera petición a Gemini 4 Carbon desde Python
Dar al modelo herramientas de solo lectura y ejecutarlas en un bucle con límites
Recibir el veredicto en JSON para que tu código lo valide
Verificar ese veredicto con código y datos que el modelo nunca ve
Comparar dos niveles de razonamiento, que controlan cuánto piensa el modelo antes de responder
Si quieres el relato del lanzamiento y los benchmarks, nuestro resumen de Gemini 4 Carbon los recoge, y nuestro Claude Fable 5.2 vs. Gemini 4 Carbon compara ambos modelos. Ejecuté este experimento el día después de que Google abriera la API a desarrolladores de pago.
¿Qué es la API Gemini 4 Carbon?
La API Gemini 4 Carbon es la interfaz de programación de aplicaciones (API) de pago para gemini-4-carbon, que la página del modelo describe como un modelo de razonamiento para tareas largas y con múltiples pasos en agentes. La entrada, el razonamiento y la salida comparten una ventana de contexto de 1.048.576 tokens, y por defecto una respuesta síncrona se detiene a los 65.536 tokens de razonamiento más salida.
Por qué una auditoría de un modelo de ML es una buena prueba para Gemini 4 Carbon
La tarea requiere varias comprobaciones, buscar cambios permitidos y un corte claro cuando las reglas no dejan respuesta. La elegí porque Python puede calcular el resultado de referencia. La model card recoge las alucinaciones entre los límites conocidos de Gemini 4 Carbon, así que el modelo investiga mientras Python decide si su recomendación se sostiene.
El proyecto: decidir si el modelo de fraude de PayGuard puede salir a producción
PayGuard es la tienda ficticia de la introducción, y el proyecto completo está en el repositorio de GitHub. Su clasificador ya está entrenado.
Cómo puntúa PayGuard las transacciones
Cada transacción tiene una marca temporal en hora universal coordinada (UTC), un importe, un canal (Website o Mobile App), una puntuación de riesgo y una etiqueta de fraude. Un HistGradientBoostingClassifier de scikit-learn produce la puntuación, redondeada a 0,001, y PayGuard marca una transacción cuando risk_score >= threshold. Nuestro tutorial sobre la curva precisión-recall muestra cómo mover el umbral cambia lo que se marca, y nuestro curso de Fraud Detection in Python cubre el lado de modelado.
Los datos sintéticos se dividen por tiempo:
Entrenamiento: las primeras nueve semanas, usadas solo para ajustar el clasificador
Validación: las cuatro semanas siguientes, la única ventana que las herramientas pueden leer
Holdout: las cuatro semanas posteriores, selladas hasta congelar la recomendación
El umbral actual es 0,5, y los datos y la política no cambian durante el experimento. En este conjunto, el fraude en Website deja señales claras, mientras que la mayoría del fraude en Mobile App parece un pedido normal.
Gemini 4 Carbon pregunta, Python decide. Imagen del autor.
Las tres reglas de despliegue de PayGuard
Estas son las tres reglas de la introducción, tal como las especifica la política. Todos son objetivos ficticios elegidos para este experimento:
R1: las transacciones marcadas cubren al menos el 85% del valor de fraude etiquetado en total
R2: cubren al menos el 70% del valor de fraude etiquetado dentro de cada canal
R3: no se marcan más de 200 transacciones en ningún día UTC concreto
El recall por valor de fraude es el valor de fraude marcado dividido por el valor total de fraude. A diferencia del recall a nivel de transacción de nuestra guía de precisión frente a recall, un fraude de 2.000 $ perdido cuenta mucho más que uno de 15 $, y marcar no implica que se haya salvado el dinero. R3 limita el día más cargado, y ese matiz termina decidiendo la auditoría.
El agente puede investigar dos cambios: una capacidad diaria de hasta 260 con un único umbral, o umbrales por canal manteniendo el tope original. Ambos requieren aprobación humana, no pueden combinarse y la política prefiere la opción sin aumentar revisores.
Qué cuenta como una auditoría correcta
Una auditoría correcta acierta en cuatro cosas, y deberías decidirlas antes de la primera petición:
El veredicto: si algún umbral único cumple R1, R2 y R3 en validación
El conflicto: qué requisitos hacen imposible la política original
La alternativa: un cambio permitido que pase todas las reglas cuando Python lo recomputa
La preferencia: la recomendación sigue el orden de preferencia de la política
Un evaluador al que el agente no puede llamar calcula la respuesta.
Cómo configurar la API Gemini 4 Carbon en Python
Configurar la API Gemini 4 Carbon requiere Python 3.11 o superior y una clave de API de un proyecto de Google AI Studio con facturación activa, ya que la página de precios no ofrece plan gratuito.
Instala el SDK de Google Gen AI y prepara el proyecto
Probé este proyecto con el SDK de Google Gen AI fijado en google-genai==3.1.0, la versión de lanzamiento en PyPI que añadió gemini-4-carbon a la lista de modelos de Interactions. Clona el proyecto e instálalo en un entorno virtual:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS o Linux: source .venv/bin/activate
pip install-r requirements.txtCon la tecnología de
Después, ejecuta los dos comandos de la página del repositorio que construyen los datos y ajustan el clasificador con semillas fijas. En un clon nuevo, imprimen esto:
Semillas fijas reconstruyen el mismo dataset. Imagen del autor.
Después añade GEMINI_API_KEY=your-key en un archivo .env. El repositorio lo carga sin imprimirlo.
Haz tu primera petición a la API Gemini 4 Carbon
Ejecuta este ejemplo completo desde la carpeta del proyecto. Le da a Gemini 4 Carbon la política y el resumen del clasificador y le pregunta qué necesitaría medir, sin insinuar ningún conflicto:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Con la tecnología de
El nivel de razonamiento va en generation_config, y output_text contiene la respuesta. Esto es parte de lo que devolvió:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Con la tecnología de
Interpretó R3 como un pico y planificó el orden de preferencia de la política antes de ver ningún número. No preguntó nunca cómo funcionan los empates o el redondeo de puntuaciones, y la comprobación exhaustiva que verás después depende justo de eso. La llamada tardó unos 40 segundos y costó unos 2 céntimos.
Omite temperature, top_p y top_k, que Gemini 4 Carbon ignora, y thinking_budget.
Cómo construir un agente de auditoría ML con function calling de Gemini 4 Carbon
Un agente de auditoría con Gemini 4 Carbon es un bucle: el modelo solicita una evaluación, Python la valida y ejecuta, y el resultado vuelve hasta que el modelo deja de pedir más.
Define herramientas de solo lectura para evaluar el modelo
El agente recibe tres herramientas. Todas están limitadas a la ventana de validación:
get_audit_context: el resumen del clasificador, configuración actual, política y cambios permitidos
evaluate_global_threshold: recall por valor de fraude en total y por canal, marcados por día y diagnósticos para un umbral
evaluate_policy_change: las mismas métricas para un aumento de capacidad o un par de umbrales por canal
Los esquemas completos están en el repositorio. Este extracto simplificado omite los campos de umbral y capacidad, así que no es una declaración completa para copiar. Solo muestra el límite que importa aquí: la herramienta acepta los dos cambios de política que permite PayGuard, lee datos de validación y no aprueba nada.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Con la tecnología de
Python valida los campos de umbral y capacidad omitidos, rechaza cambios fuera de la política y devuelve mediciones en lugar de flags de aprobado o fallido. El agente no puede acceder al holdout, llamar al evaluador ni cambiar la política. En las FAQs explico por qué omití la ejecución de código integrada de Gemini 4 Carbon.
Da al agente un objetivo claro y reglas de parada
La instrucción del sistema marca el método. Como la primera petición, no insinúa dónde está el conflicto:
- Lee primero el contexto de auditoría y luego evalúa la configuración actual antes que nada.
- Comprueba tú mismo cada requisito comparando los números de las herramientas con el texto de la
  política: R1, R2 para Website, R2 para Mobile App y R3. R3 es un límite en el día más cargado,
  no en el promedio.
- Usa solo números devueltos por una herramienta. No estimes una métrica que no hayas medido.
- Si la evidencia no resuelve una cuestión, dilo. "Inconclusive" es una respuesta aceptable.Con la tecnología de
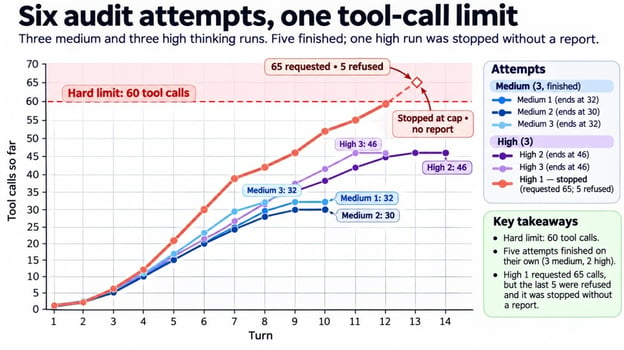
El prompt solo puede pedir, así que los límites viven en el agent harness, el código Python alrededor del modelo. Como la API no tiene ajuste de presupuesto, la aplicación los fija por intento: 25 turnos, 60 llamadas a herramientas, 30 minutos y 3 $, con el gasto comprobado entre turnos.
Implementa el bucle de function calling con la Interactions API
Cada turno es una llamada a client.interactions.create(). Gemini 4 Carbon suele pedir varias herramientas a la vez, así que el bucle procesa cada paso de function_call. Este es el bucle central; la versión del repositorio añade registro y comprobaciones de límites:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Con la tecnología de
Mantengo estos ajustes en un dict request para que cada llamada de seguimiento los reenvíe. previous_interaction_id arrastra el historial, pero tools, system_instruction y generation_config aplican a una interacción únicamente. Si un turno termina como incomplete, max_output_tokens lo cortó, y aun así pagas los tokens de razonamiento.
Devuelve un informe de auditoría estructurado con un esquema JSON
La guía de salida estructurada de Google lista herramientas más un esquema JSON en una sola petición como función en Preview que incluye Gemini 4 Carbon. Aun así las separé: los turnos de investigación solo miden, y un turno final con el mismo historial y configuración escribe el informe con un esquema y sin herramientas:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Con la tecnología de
AuditReport es un modelo de Pydantic con el veredicto, conflicto, evidencias, recomendación y aprobaciones. Python mide tiempo y coste en lugar de pedir a Gemini 4 Carbon que los informe.
Ejecuta la auditoría con Gemini 4 Carbon sobre el modelo de fraude
Gemini 4 Carbon auditó el modelo como le pediría a una analista junior: medir antes de concluir. En el primer intento con medium, leyó el contexto de auditoría, comprobó unas dos docenas de umbrales únicos y probó ocho cambios de política.
Las 32 llamadas a herramientas, en orden. Imagen del autor.
Evalúa el umbral actual de PayGuard
El agente evaluó el umbral actual de 0,5 y encontró 91% de recall en Website, 20% en Mobile App, 64% en total y 85 marcados en el día más cargado. Eso incumple R1 y la parte de Mobile App de R2, con margen bajo R3, así que lo obvio es bajar el umbral.
Pon a prueba el recall por valor de fraude frente a la capacidad diaria de revisión
Bajar un umbral captura más valor de fraude y envía más pedidos a revisión. PayGuard necesita suficiente de lo primero manteniendo lo segundo por debajo de un tope diario.
El agente probó algunos umbrales gruesos en un lote y luego afinó a puntos de rejilla individuales. Las llamadas 11, 12, 17 y 18 en el trazo lo resolvieron.
En esta ventana de validación, el suelo de Mobile App exige 0,108 o menos, porque un paso más alto lo deja justo por debajo del 70%. El tope exige 0,118 o más. Ningún umbral satisface ambas cosas.
El recall total aguanta hasta 0,137, así que R1 queda fuera del conflicto. A 0,108 el día medio tiene unos 169 marcados y solo un sábado se pasa. Por eso la política usa la carga del día más intenso y no la media diaria.
El recall en Mobile y la capacidad nunca se solapan. Imagen del autor.
Revisa el rendimiento en ambos canales de pago
El fraude en Mobile App, con señales más débiles, cae en el tramo bajo de puntuaciones. Arrastrar un umbral único hasta 0,108 para Mobile App también incorpora más pedidos legítimos de Website, y ese sábado empujan el total por encima del tope.
El número total lo oculta: a 0,118, el recall global ronda el 87% mientras Mobile App queda por debajo de su suelo. Si tu política nombra segmentos, mide cada uno, porque el total puede pasar mientras un segmento falla.
¿Puede Gemini 4 Carbon detectar requisitos de despliegue en conflicto?
Sí, en esta auditoría. El informe congelado dice not deployable, confirma que ningún umbral único funciona y señala R2 para Mobile App y R3 como el conflicto.
Contrasta el veredicto de despliegue con sus evidencias
Cada número citado en el informe coincide con el resultado de una herramienta, pero una frase afirma más de lo que el agente midió. Dice que ningún umbral funciona "en todos los puntos de la rejilla de 0,001" y el agente solo probó las dos docenas del trazo, de 1.002 posibles.
La afirmación se sostiene porque tanto el recall como los recuentos diarios caen al subir el umbral, algo que el informe no llega a decir. Comprueba cada afirmación de un informe de agente contra lo que midió, y nuestra guía para evaluar agentes de IA cubre más comprobaciones de este tipo.
Verifica el conflicto con un evaluador exhaustivo en Python
Gemini 4 Carbon muestreó umbrales e infirió que ninguno podía funcionar. El evaluador demuestra ese resultado para este set de validación comprobando todos los conjuntos de marcados posibles, sin compartir código con las herramientas.
Las puntuaciones están en rejilla de 0,001, así que los 1.002 cortes candidatos cubren todos los posibles conjuntos de marcados. El evaluador comprueba todos, además de cada par de umbrales por canal, usando céntimos enteros para que 85% y 70% sean exactos.
Comprobación exhaustiva y cuatro configuraciones rechazadas. Imagen del autor.
Ningún umbral global pasa las tres reglas, así que ahora la afirmación de Gemini 4 Carbon tiene una prueba detrás. El evaluador coincidió con los límites 0,108 y 0,118 detectados por el sondeo del agente y encontró miles de pares por canal que pasan con 200 al día.
Un evaluador solo ayuda si rechaza malas respuestas, así que le pasé cuatro configuraciones erróneas y rechazó las cuatro.
Prueba alternativas de despliegue con Gemini 4 Carbon
Gemini 4 Carbon probó ambos cambios permitidos y eligió umbrales por canal con el tope original antes que más revisores. Señaló que esa elección es una excepción que debe aprobar una persona.
Prueba un aumento de la capacidad de revisión manual
Un umbral global funciona si el tope sube de 200 a 205, y el evaluador confirmó 205 como el menor incremento. Aun así, Gemini 4 Carbon situó esta opción en segundo lugar, por la regla de preferencia que describí antes.
Prueba umbrales separados para cada canal de pago
En el lado por canal, el agente mantuvo el umbral de Mobile App cerca de su límite (ya había visto que 0,109 rompe el suelo) y subió el umbral de Website, reduciendo marcados de pedidos legítimos en Website. Probó siete pares y uno falló por un solo marcado en el día más cargado. Recomendó Website 0,3 y Mobile App 0,1 porque ese par cumple todas las reglas con margen, y el evaluador lo confirmó con el tope original.
Compara las alternativas verificadas
Estos números ya han salido, y el evaluador recomputó cada uno:
Opción
Umbrales
Total
Website
Mobile App
Día más cargado
Aprobación
Política original
Global 0,108
87,5%
98,2%
70,1%
205, tope 200
Falla
Más capacidad
Global 0,108
87,5%
98,2%
70,1%
205, tope 205
Necesita
Separación por canal
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, tope 200
Necesita
La separación por canal también marca alrededor de un 6% menos de transacciones que la opción de capacidad. Aun así, menos de la mitad de sus marcados son fraude, algo que el informe dejó como tema abierto.
Cómo verificar la recomendación de Gemini 4 Carbon en datos no vistos
Verificas la recomendación aplicándola, congelada, al holdout sellado. La diferencia con el evaluador son los datos: el evaluador puntúa semanas que el agente pudo ver, y el holdout puntúa cuatro semanas posteriores que ninguna herramienta pudo leer. La comprobación se ejecuta una vez por recomendación congelada y no arranca si el informe cambió tras congelarla.
La recomendación congelada pasa en holdout. Imagen del autor.
Cumplió las tres reglas y el día más cargado se mantuvo por debajo del tope. Aun así, no lo sobredimensiones. Tres cosas hacen que este resultado sea modesto:
El holdout proviene del mismo generador, así que no dice nada de nuevas clases de fraude ni de deriva de datos
El recall global superó el 85% por menos de dos puntos
Mi conjetura sin probar: la separación podría romper el tope si el tráfico de Mobile App crece más rápido que el de Website, porque el umbral de Mobile App queda muy bajo
Las dos primeras se desprenden de los números.
Mira la auditoría completa en Streamlit
El repositorio también incluye una app de Streamlit y los seis intentos grabados, para que puedas abrir esta auditoría sin una llamada a la API. En el vídeo, la cargo y recorro cada pestaña.
La app de Streamlit muestra una auditoría. Vídeo del autor.
Gemini 4 Carbon: thinking medio vs. alto — precisión, tiempo y coste
Aquí, tener éxito significa terminar dentro de los límites de la aplicación y devolver un informe que el evaluador acepte. Un intento detenido no tiene veredicto que puntuar. Con esa definición, medium terminó todos los intentos y costó menos de la mitad por auditoría correcta.
Seis intentos son pocos para convertirlo en regla general. Si los niveles de razonamiento son nuevos para ti, nuestro tutorial de la API Gemini 3.8 Flash explica thinking_level con más detalle.
Compara thinking medio y alto en la misma auditoría
Esta es la comparación completa detrás del TL;DR. Ejecuté 3 intentos por nivel, cada uno desde un estado limpio sin memoria de los demás, con datos, prompt, herramientas, límites y evaluador idénticos:
Por nivel
medium
high
Intentos que terminaron con informe
3 de 3
2 de 3
Auditorías correctas entre esas
3 de 3
2 de 2
Tokens de razonamiento por intento
Unos 7.700
Unos 17.500
Tiempo por intento
Unos 5 minutos
Unos 6 minutos
Coste por auditoría correcta, tarifa de introducción
Unos 0,25 $
Unos 0,62 $
Coste por auditoría correcta, tarifa estándar
Unos 0,51 $
Unos 1,24 $
Las filas de coste cuentan el gasto de todos los intentos, incluido el que se detuvo. Todos los intentos completados llegaron al mismo veredicto y conflicto y eligieron un par por canal que el evaluador aceptó, así que el extra de razonamiento se fue en más comprobaciones.
Vi un patrón similar en el experimento de codificación con Gemini 4 Argon: highgastó más e hizo más trabajo para un cambio menor en el resultado verificado. Las tareas son distintas, por lo que sus costes y tasas de éxito no son comparables directamente. En ambos casos, la comprobación independiente nos dice más que el total de razonamiento.
Por qué un intento con thinking alto no terminó
El intento que se detuvo fue el primero con high, y nunca dio un veredicto erróneo. Sondeó todos los puntos de la rejilla de 0,101 a 0,119 y luego se puso a buscar el límite del 70% de Website, del que nada dependía, y siguió pidiendo más comprobaciones hasta chocar con el límite de 60 llamadas que fijé antes; la aplicación lo paró antes de que escribiera un informe.
Solo un intento alcanzó el límite. Imagen del autor.
Esa parada es la parte útil. Un prompt pidiendo menos llamadas no lo habría terminado, y el límite en código sí lo hizo, tras unos 22 céntimos.
Los cinco informes terminados también pasaron las otras comprobaciones de Python. Ninguno interpretó mal la configuración actual, señaló un requisito fuera del conflicto, citó una llamada a herramienta inexistente o recomendó una configuración que no hubiera probado.
Mide tokens, tiempo y coste por auditoría
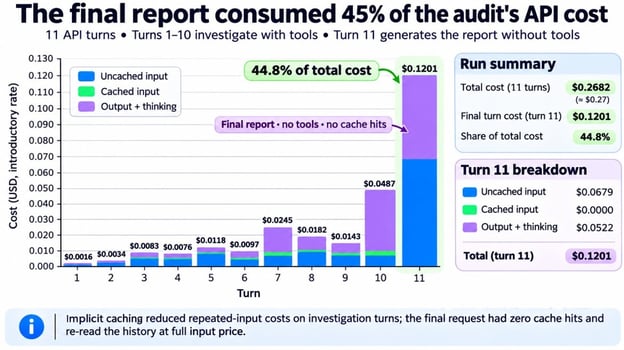
Una auditoría cuesta la suma del usage de cada turno, con precios de 2,00 $ por millón de tokens de entrada, 0,10 $ en caché y 10,00 $ de salida incluyendo razonamiento, todo duplicándose el 1 de diciembre de 2026. total_input_tokens incluye tokens cacheados, así que el código valora ambas partes por separado.
El turno del informe es el más caro. Imagen del autor.
La sorpresa fue el informe, o más bien, su factura. La caché implícita cubrió alrededor de tres cuartas partes de los tokens de entrada en los turnos de investigación, pero la petición del informe sin herramientas nunca obtuvo acierto de caché.
La causa probable es que quitar tools cambia el inicio de la petición. En cualquier caso, ese turno releyó todo el historial a precio completo y supuso cerca del 40% del coste de cada intento completado. Tenlo en cuenta al dimensionar tu límite de gasto.
Limitaciones de usar Gemini 4 Carbon para auditar modelos de ML
Diseñé esta prueba y generé sus datos yo mismo, así que los resultados tienen estos límites:
Los datos son sintéticos y proceden de un único clasificador, y ajusté el generador hasta que existiera un conflicto, antes de cualquier llamada a la API
El veredicto cubre solo este clasificador; uno mejor podría cumplir las tres reglas con un único umbral
Un umbral puede comprobarse, pero aprobar una separación por canal es un juicio de negocio y de equidad
Las interacciones se almacenan 55 días en el plan de pago por defecto, y store=false impide usar previous_interaction_id, así que un agente que envíe filas de transacciones necesita una revisión de datos
El evaluador resuelve el problema del umbral por sí solo, sin modelo de por medio. Si solo necesitas un umbral, usa un solver de optimización. Lo que aportó Gemini 4 Carbon fue la auditoría alrededor.
Nada aquí está atado al fraude. La configuración sirve para cualquier modelo cuyas reglas Python pueda medir.
Reflexiones finales
El principal resultado es que Gemini 4 Carbon reconoció que la política original no tenía un umbral global válido. Los 5 intentos completados nombraron el conflicto y propusieron una separación por canal que el evaluador aceptó; un intento con high se detuvo antes de producir un informe.
Los experimentos con Gemini 4 Argon y Gemini 4 Carbon ponen a prueba dos caras de la fiabilidad de agentes. El agente con Gemini 4 Argon cambiaba código y debía preservar el comportamiento; el agente con Gemini 4 Carbon llegaba a una decisión bajo reglas que hacían imposible la respuesta original. Ambos necesitaron herramientas estrechas, límites de recursos y una comprobación fuera del modelo.
Ese es el estándar que usaría para un agente: define qué pueden establecer sus herramientas, verifica el resultado de forma independiente y permite una respuesta inconclusivecuando la evidencia se agota. Después, pondría dos o tres clasificadores candidatos bajo la misma política y preguntaría cuál, si alguno, puede salir.
Soy ingeniero de datos y creador de comunidades. Trabajo con canalizaciones de datos, nube y herramientas de IA, al tiempo que escribo tutoriales prácticos y de gran impacto para DataCamp y programadores emergentes.
Preguntas frecuentes
¿Cómo obtengo acceso a la API Gemini 4 Carbon?⌄
A través de un proyecto de pago en Google AI Studio o mediante Gemini para empresas en Google Cloud. La app Gemini, Antigravity y AI Mode también lo ofrecen a suscriptores de Google AI Ultra, pero esas apps de consumo no te dan una clave de API.
¿Cuánto cuesta la API Gemini 4 Carbon?⌄
Las 6 auditorías de aquí sumaron 2,00 $ a la tarifa de introducción. Las peticiones estándar como estas obtienen caché implícita cuando superan 4.096 tokens de entrada, así que mantén idéntico el inicio de cada petición. Flex inference, que también admiten las peticiones de Interactions, reduce a la mitad las tarifas de token a cambio de respuestas más lentas y menos fiables.
¿Cuáles son los límites de tasa de la API Gemini 4 Carbon?⌄
Los proyectos de pago tienen límites por minuto además de un límite de gasto, que es de 10 $ por ventana móvil de 10 minutos en el nivel 1; si lo superas devuelve 429 RESOURCE_EXHAUSTED. Una auditoría aquí costó menos de 1 $, así que solo muchos intentos en paralelo lo alcanzarían. Los límites suben con tu nivel, así que consulta la página de límites de tasa de Google para tu proyecto.
¿Cuál es la diferencia entre thinking medio y alto en Gemini 4 Carbon?⌄
Gemini 4 Carbon tiene tres niveles, low, medium (por defecto) y high, y aquí solo comparé los dos superiores. Para ver cómo se ve el razonamiento extra, pon thinking_summariesen "auto" y obtendrás resúmenes condensados junto a cada respuesta. Están desactivados por defecto y pueden venir vacíos cuando el modelo apenas razona.
¿Puede Gemini 4 Carbon ejecutar código Python?⌄
Sí. Añade {"type": "code_execution"} a toolsy Gemini 4 Carbon puede escribir y ejecutar Python del lado de Google, con facturación a sus tarifas normales de tokens. Yo lo dejé fuera para mantener el control de mi lado: las tres herramientas deciden qué puede medir, y las transacciones en crudo y el holdout no salen de mi máquina.
Aprende a utilizar modelos de IA generativa para crear un editor de imágenes, un chatbot similar a ChatGPT con pocos recursos y una aplicación clasificadora de aprobación de préstamos y a automatizar interacciones PDF y un asistente de voz con GPT.
Libere todo el potencial de GPT-3 mediante el ajuste fino. Aprenda a utilizar la API de OpenAI y Python para mejorar este modelo de red neuronal avanzado para su caso de uso específico.
Un tutorial completo sobre la construcción de agentes LangChain multiherramienta para automatizar tareas en Python utilizando LLMs y modelos de chat utilizando OpenAI.
Comprender y aplicar el optimizador Adam en Python. Aprende la intuición, las matemáticas y las aplicaciones prácticas del aprendizaje automático con PyTorch
Descubra cómo la nueva capacidad de llamada a funciones de OpenAI permite a los modelos GPT generar salidas JSON estructuradas, resolviendo problemas comunes de desarrollo causados por salidas irregulares.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.





En nuestro tutorial de la API Gemini 4 Argon, el agente tenía un cometido claro: encontrar código lento, cambiarlo y pasar pruebas ocultas. Este experimento complementario sigue el mismo patrón de herramientas controladas y verificación externa, pero cambia la decisión. Gemini 4 Carbon tiene que determinar si las reglas originales pueden satisfacerse en absoluto.
PayGuard, una tienda online ficticia, tiene un modelo de machine learning (ML) entrenado que puntúa pedidos por riesgo de fraude. Su política de despliegue exige que el modelo capture suficiente valor de fraude en total y en cada canal de venta sin desbordar al equipo de revisión. El agente debe investigar esas reglas sin saber de antemano si existe un umbral válido.
Gemini 4 Carbon es un modelo de razonamiento de Google al que llamas desde Python a través de la Interactions API. Aquí actúa como agente de IA: elige qué comprobaciones solicitar, y Python las ejecuta mediante tres herramientas de solo lectura usando function calling. Mi pregunta es si puede identificar el conflicto, explicar las evidencias y recomendar un cambio permitido sin tratar ese cambio como aprobado.
Necesitarás Python básico y algo de experiencia con peticiones a APIs. Defino cada métrica de fraude antes de que aparezcan los números. Veremos cómo:
Si quieres el relato del lanzamiento y los benchmarks, nuestro resumen de Gemini 4 Carbon los recoge, y nuestro Claude Fable 5.2 vs. Gemini 4 Carbon compara ambos modelos. Ejecuté este experimento el día después de que Google abriera la API a desarrolladores de pago.
¿Qué es la API Gemini 4 Carbon?
La API Gemini 4 Carbon es la interfaz de programación de aplicaciones (API) de pago para
gemini-4-carbon, que la página del modelo describe como un modelo de razonamiento para tareas largas y con múltiples pasos en agentes. La entrada, el razonamiento y la salida comparten una ventana de contexto de 1.048.576 tokens, y por defecto una respuesta síncrona se detiene a los 65.536 tokens de razonamiento más salida.Por qué una auditoría de un modelo de ML es una buena prueba para Gemini 4 Carbon
La tarea requiere varias comprobaciones, buscar cambios permitidos y un corte claro cuando las reglas no dejan respuesta. La elegí porque Python puede calcular el resultado de referencia. La model card recoge las alucinaciones entre los límites conocidos de Gemini 4 Carbon, así que el modelo investiga mientras Python decide si su recomendación se sostiene.
El proyecto: decidir si el modelo de fraude de PayGuard puede salir a producción
PayGuard es la tienda ficticia de la introducción, y el proyecto completo está en el repositorio de GitHub. Su clasificador ya está entrenado.
Cómo puntúa PayGuard las transacciones
Cada transacción tiene una marca temporal en hora universal coordinada (UTC), un importe, un canal (Website o Mobile App), una puntuación de riesgo y una etiqueta de fraude. Un
HistGradientBoostingClassifierde scikit-learn produce la puntuación, redondeada a 0,001, y PayGuard marca una transacción cuandorisk_score >= threshold. Nuestro tutorial sobre la curva precisión-recall muestra cómo mover el umbral cambia lo que se marca, y nuestro curso de Fraud Detection in Python cubre el lado de modelado.Los datos sintéticos se dividen por tiempo:
El umbral actual es 0,5, y los datos y la política no cambian durante el experimento. En este conjunto, el fraude en Website deja señales claras, mientras que la mayoría del fraude en Mobile App parece un pedido normal.
Gemini 4 Carbon pregunta, Python decide. Imagen del autor.
Las tres reglas de despliegue de PayGuard
Estas son las tres reglas de la introducción, tal como las especifica la política. Todos son objetivos ficticios elegidos para este experimento:
El recall por valor de fraude es el valor de fraude marcado dividido por el valor total de fraude. A diferencia del recall a nivel de transacción de nuestra guía de precisión frente a recall, un fraude de 2.000 $ perdido cuenta mucho más que uno de 15 $, y marcar no implica que se haya salvado el dinero. R3 limita el día más cargado, y ese matiz termina decidiendo la auditoría.
El agente puede investigar dos cambios: una capacidad diaria de hasta 260 con un único umbral, o umbrales por canal manteniendo el tope original. Ambos requieren aprobación humana, no pueden combinarse y la política prefiere la opción sin aumentar revisores.
Qué cuenta como una auditoría correcta
Una auditoría correcta acierta en cuatro cosas, y deberías decidirlas antes de la primera petición:
Un evaluador al que el agente no puede llamar calcula la respuesta.
Cómo configurar la API Gemini 4 Carbon en Python
Configurar la API Gemini 4 Carbon requiere Python 3.11 o superior y una clave de API de un proyecto de Google AI Studio con facturación activa, ya que la página de precios no ofrece plan gratuito.
Instala el SDK de Google Gen AI y prepara el proyecto
Probé este proyecto con el SDK de Google Gen AI fijado en
google-genai==3.1.0, la versión de lanzamiento en PyPI que añadiógemini-4-carbona la lista de modelos de Interactions. Clona el proyecto e instálalo en un entorno virtual:Después, ejecuta los dos comandos de la página del repositorio que construyen los datos y ajustan el clasificador con semillas fijas. En un clon nuevo, imprimen esto:
Semillas fijas reconstruyen el mismo dataset. Imagen del autor.
Después añade
GEMINI_API_KEY=your-keyen un archivo.env. El repositorio lo carga sin imprimirlo.Haz tu primera petición a la API Gemini 4 Carbon
Ejecuta este ejemplo completo desde la carpeta del proyecto. Le da a Gemini 4 Carbon la política y el resumen del clasificador y le pregunta qué necesitaría medir, sin insinuar ningún conflicto:
El nivel de razonamiento va en
generation_config, youtput_textcontiene la respuesta. Esto es parte de lo que devolvió:Interpretó R3 como un pico y planificó el orden de preferencia de la política antes de ver ningún número. No preguntó nunca cómo funcionan los empates o el redondeo de puntuaciones, y la comprobación exhaustiva que verás después depende justo de eso. La llamada tardó unos 40 segundos y costó unos 2 céntimos.
Omite
temperature,top_pytop_k, que Gemini 4 Carbon ignora, ythinking_budget.Cómo construir un agente de auditoría ML con function calling de Gemini 4 Carbon
Un agente de auditoría con Gemini 4 Carbon es un bucle: el modelo solicita una evaluación, Python la valida y ejecuta, y el resultado vuelve hasta que el modelo deja de pedir más.
Define herramientas de solo lectura para evaluar el modelo
El agente recibe tres herramientas. Todas están limitadas a la ventana de validación:
get_audit_context: el resumen del clasificador, configuración actual, política y cambios permitidosevaluate_global_threshold: recall por valor de fraude en total y por canal, marcados por día y diagnósticos para un umbralevaluate_policy_change: las mismas métricas para un aumento de capacidad o un par de umbrales por canalLos esquemas completos están en el repositorio. Este extracto simplificado omite los campos de umbral y capacidad, así que no es una declaración completa para copiar. Solo muestra el límite que importa aquí: la herramienta acepta los dos cambios de política que permite PayGuard, lee datos de validación y no aprueba nada.
Python valida los campos de umbral y capacidad omitidos, rechaza cambios fuera de la política y devuelve mediciones en lugar de flags de aprobado o fallido. El agente no puede acceder al holdout, llamar al evaluador ni cambiar la política. En las FAQs explico por qué omití la ejecución de código integrada de Gemini 4 Carbon.
Da al agente un objetivo claro y reglas de parada
La instrucción del sistema marca el método. Como la primera petición, no insinúa dónde está el conflicto:
El prompt solo puede pedir, así que los límites viven en el agent harness, el código Python alrededor del modelo. Como la API no tiene ajuste de presupuesto, la aplicación los fija por intento: 25 turnos, 60 llamadas a herramientas, 30 minutos y 3 $, con el gasto comprobado entre turnos.
Implementa el bucle de function calling con la Interactions API
Cada turno es una llamada a
client.interactions.create(). Gemini 4 Carbon suele pedir varias herramientas a la vez, así que el bucle procesa cada paso defunction_call. Este es el bucle central; la versión del repositorio añade registro y comprobaciones de límites:Mantengo estos ajustes en un dict
requestpara que cada llamada de seguimiento los reenvíe.previous_interaction_idarrastra el historial, perotools,system_instructionygeneration_configaplican a una interacción únicamente. Si un turno termina comoincomplete,max_output_tokenslo cortó, y aun así pagas los tokens de razonamiento.Devuelve un informe de auditoría estructurado con un esquema JSON
La guía de salida estructurada de Google lista herramientas más un esquema JSON en una sola petición como función en Preview que incluye Gemini 4 Carbon. Aun así las separé: los turnos de investigación solo miden, y un turno final con el mismo historial y configuración escribe el informe con un esquema y sin herramientas:
AuditReportes un modelo de Pydantic con el veredicto, conflicto, evidencias, recomendación y aprobaciones. Python mide tiempo y coste en lugar de pedir a Gemini 4 Carbon que los informe.Ejecuta la auditoría con Gemini 4 Carbon sobre el modelo de fraude
Gemini 4 Carbon auditó el modelo como le pediría a una analista junior: medir antes de concluir. En el primer intento con
medium, leyó el contexto de auditoría, comprobó unas dos docenas de umbrales únicos y probó ocho cambios de política.Las 32 llamadas a herramientas, en orden. Imagen del autor.
Evalúa el umbral actual de PayGuard
El agente evaluó el umbral actual de 0,5 y encontró 91% de recall en Website, 20% en Mobile App, 64% en total y 85 marcados en el día más cargado. Eso incumple R1 y la parte de Mobile App de R2, con margen bajo R3, así que lo obvio es bajar el umbral.
Pon a prueba el recall por valor de fraude frente a la capacidad diaria de revisión
Bajar un umbral captura más valor de fraude y envía más pedidos a revisión. PayGuard necesita suficiente de lo primero manteniendo lo segundo por debajo de un tope diario.
El agente probó algunos umbrales gruesos en un lote y luego afinó a puntos de rejilla individuales. Las llamadas 11, 12, 17 y 18 en el trazo lo resolvieron.
En esta ventana de validación, el suelo de Mobile App exige 0,108 o menos, porque un paso más alto lo deja justo por debajo del 70%. El tope exige 0,118 o más. Ningún umbral satisface ambas cosas.
El recall total aguanta hasta 0,137, así que R1 queda fuera del conflicto. A 0,108 el día medio tiene unos 169 marcados y solo un sábado se pasa. Por eso la política usa la carga del día más intenso y no la media diaria.
El recall en Mobile y la capacidad nunca se solapan. Imagen del autor.
Revisa el rendimiento en ambos canales de pago
El fraude en Mobile App, con señales más débiles, cae en el tramo bajo de puntuaciones. Arrastrar un umbral único hasta 0,108 para Mobile App también incorpora más pedidos legítimos de Website, y ese sábado empujan el total por encima del tope.
El número total lo oculta: a 0,118, el recall global ronda el 87% mientras Mobile App queda por debajo de su suelo. Si tu política nombra segmentos, mide cada uno, porque el total puede pasar mientras un segmento falla.
¿Puede Gemini 4 Carbon detectar requisitos de despliegue en conflicto?
Sí, en esta auditoría. El informe congelado dice
not deployable, confirma que ningún umbral único funciona y señala R2 para Mobile App y R3 como el conflicto.Contrasta el veredicto de despliegue con sus evidencias
Cada número citado en el informe coincide con el resultado de una herramienta, pero una frase afirma más de lo que el agente midió. Dice que ningún umbral funciona "en todos los puntos de la rejilla de 0,001" y el agente solo probó las dos docenas del trazo, de 1.002 posibles.
La afirmación se sostiene porque tanto el recall como los recuentos diarios caen al subir el umbral, algo que el informe no llega a decir. Comprueba cada afirmación de un informe de agente contra lo que midió, y nuestra guía para evaluar agentes de IA cubre más comprobaciones de este tipo.
Verifica el conflicto con un evaluador exhaustivo en Python
Gemini 4 Carbon muestreó umbrales e infirió que ninguno podía funcionar. El evaluador demuestra ese resultado para este set de validación comprobando todos los conjuntos de marcados posibles, sin compartir código con las herramientas.
Las puntuaciones están en rejilla de 0,001, así que los 1.002 cortes candidatos cubren todos los posibles conjuntos de marcados. El evaluador comprueba todos, además de cada par de umbrales por canal, usando céntimos enteros para que 85% y 70% sean exactos.
Comprobación exhaustiva y cuatro configuraciones rechazadas. Imagen del autor.
Ningún umbral global pasa las tres reglas, así que ahora la afirmación de Gemini 4 Carbon tiene una prueba detrás. El evaluador coincidió con los límites 0,108 y 0,118 detectados por el sondeo del agente y encontró miles de pares por canal que pasan con 200 al día.
Un evaluador solo ayuda si rechaza malas respuestas, así que le pasé cuatro configuraciones erróneas y rechazó las cuatro.
Prueba alternativas de despliegue con Gemini 4 Carbon
Gemini 4 Carbon probó ambos cambios permitidos y eligió umbrales por canal con el tope original antes que más revisores. Señaló que esa elección es una excepción que debe aprobar una persona.
Prueba un aumento de la capacidad de revisión manual
Un umbral global funciona si el tope sube de 200 a 205, y el evaluador confirmó 205 como el menor incremento. Aun así, Gemini 4 Carbon situó esta opción en segundo lugar, por la regla de preferencia que describí antes.
Prueba umbrales separados para cada canal de pago
En el lado por canal, el agente mantuvo el umbral de Mobile App cerca de su límite (ya había visto que 0,109 rompe el suelo) y subió el umbral de Website, reduciendo marcados de pedidos legítimos en Website. Probó siete pares y uno falló por un solo marcado en el día más cargado. Recomendó Website 0,3 y Mobile App 0,1 porque ese par cumple todas las reglas con margen, y el evaluador lo confirmó con el tope original.
Compara las alternativas verificadas
Estos números ya han salido, y el evaluador recomputó cada uno:
Opción
Umbrales
Total
Website
Mobile App
Día más cargado
Aprobación
Política original
Global 0,108
87,5%
98,2%
70,1%
205, tope 200
Falla
Más capacidad
Global 0,108
87,5%
98,2%
70,1%
205, tope 205
Necesita
Separación por canal
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, tope 200
Necesita
La separación por canal también marca alrededor de un 6% menos de transacciones que la opción de capacidad. Aun así, menos de la mitad de sus marcados son fraude, algo que el informe dejó como tema abierto.
Cómo verificar la recomendación de Gemini 4 Carbon en datos no vistos
Verificas la recomendación aplicándola, congelada, al holdout sellado. La diferencia con el evaluador son los datos: el evaluador puntúa semanas que el agente pudo ver, y el holdout puntúa cuatro semanas posteriores que ninguna herramienta pudo leer. La comprobación se ejecuta una vez por recomendación congelada y no arranca si el informe cambió tras congelarla.
La recomendación congelada pasa en holdout. Imagen del autor.
Cumplió las tres reglas y el día más cargado se mantuvo por debajo del tope. Aun así, no lo sobredimensiones. Tres cosas hacen que este resultado sea modesto:
Las dos primeras se desprenden de los números.
Mira la auditoría completa en Streamlit
El repositorio también incluye una app de Streamlit y los seis intentos grabados, para que puedas abrir esta auditoría sin una llamada a la API. En el vídeo, la cargo y recorro cada pestaña.