Gemini 4 Carbon API-tutorial: Bouw een agent die een fraudemodel auditeert
Leer de Gemini 4 Carbon API in Python: bouw een agent met function calling die een fraudemodel auditeert, conflicterende regels vindt en een beleidswijziging test.
In onze Gemini 4 Argon API-tutorial had de agent een duidelijke taak: trage code vinden, aanpassen en verborgen tests doorstaan. Dit bijbehorende experiment houdt hetzelfde patroon van gecontroleerde tools en een externe controle, maar verandert de beslissing. Gemini 4 Carbon moet uitzoeken of de oorspronkelijke regels überhaupt haalbaar zijn.
PayGuard, een fictieve webwinkel, heeft een getraind machine learning (ML)-model dat bestellingen op fraude scoort. Het uitrolbeleid vereist dat het model voldoende fraudewaarde afvangt, zowel totaal als per verkoopkanaal, zonder het reviewteam te overspoelen. De agent moet die regels onderzoeken zonder te weten of er een geldige drempel bestaat.
Gemini 4 Carbon is een Google-redenatiemodel dat je vanuit Python aanroept via de Interactions API. Hier fungeert het als een AI-agent: het kiest welke checks het wil aanvragen, en Python voert die uit via drie alleen-lezen tools met function calling. Mijn vraag is of het de tegenstrijdigheid kan identificeren, het bewijs kan uitleggen en een toegestane wijziging kan aanbevelen zonder die wijziging als goedgekeurd te behandelen.
Je hebt basiskennis van Python nodig en een beetje ervaring met API-requests. Ik definieer elke fraudemetriek voordat de cijfers die gebruiken. We behandelen hoe je:
Een eerste request naar Gemini 4 Carbon vanuit Python stuurt
Het model alleen-lezen tools geeft en die in een lus met limieten laat draaien
Het oordeel terugkrijgt als JSON dat je code kan controleren
Dat oordeel verifieert met code en data die het model nooit ziet
Twee denk-niveaus vergelijkt, die bepalen hoeveel het model redeneert vóór het antwoorden
Wil je het lanceringsverhaal en benchmark-scores, dan staan die in onze overzicht van Gemini 4 Carbon en onze Claude Fable 5.2 vs. Gemini 4 Carbon-analyse vergelijkt de twee modellen. Ik draaide dit experiment de dag nadat Google de API opende voor betalende developers.
Wat is de Gemini 4 Carbon API?
De Gemini 4 Carbon API is de betaalde application programming interface (API) voor gemini-4-carbon, die de modelpagina omschrijft als een redenatiemodel voor lange, meerstaps agent-taken. Input, denken en output delen een contextvenster van 1.048.576 tokens, en een synchrone respons stopt standaard bij 65.536 tokens aan denken plus output.
Waarom een ML-modelaudit een goede test is voor Gemini 4 Carbon
De taak vereist meerdere checks, een zoektocht door toegestane wijzigingen en een duidelijke stop wanneer de regels geen antwoord toelaten. Ik koos dit omdat Python het referentieresultaat kan uitrekenen. De modelkaart noemt hallucinaties als een bekende beperking van Gemini 4 Carbon, dus het model onderzoekt terwijl Python beslist of de aanbeveling standhoudt.
Het project: bepalen of PayGuards fraudemodel live kan
PayGuard is de fictieve winkel uit de intro, en het volledige project staat in de GitHub-repository. De classifier is al getraind.
Hoe PayGuard transacties scoort
Elke transactie heeft een UTC-timestamp, een bedrag, een kanaal (Website of Mobile App), een risicoscore en een fraudelabel. Een scikit-learn HistGradientBoostingClassifier produceert de score, afgerond op 0,001, en PayGuard markeert een transactie wanneer risk_score >= threshold. Onze precision-recall curvetutorial laat zien hoe het verschuiven van een drempel beïnvloedt wat gemarkeerd wordt, en onze cursus Fraudedetectie in Python behandelt de modelkant.
De synthetische data is tijdgesplitst:
Training: de eerste negen weken, alleen gebruikt om de classifier te fitten
Validatie: de volgende vier weken, het enige venster dat de tools kunnen lezen
Holdout: de vier weken daarna, verzegeld totdat de aanbeveling is bevroren
De huidige drempel is 0,5, en data en beleid veranderen niet tijdens het experiment. Websitefraude laat in deze data duidelijke signalen achter, terwijl de meeste Mobile App-fraude op een gewone bestelling lijkt.
Gemini 4 Carbon vraagt, Python beslist. Afbeelding door auteur.
PayGuards drie uitrolregels
Hier zijn de drie regels uit de intro, opgeschreven zoals het beleid ze stelt. Het zijn allemaal fictieve doelen die ik voor dit experiment heb gekozen:
R1: gemarkeerde transacties dekken minstens 85% van de gelabelde fraudewaarde in totaal
R2: ze dekken minstens 70% van de gelabelde fraudewaarde binnen elk kanaal
R3: op geen enkele enkele UTC-dag worden meer dan 200 transacties gemarkeerd
Fraudewaarde-recall is de waarde van gemarkeerde fraude gedeeld door de totale waarde van fraude. Anders dan de transactie-level recall in onze gids over precisie versus recall telt een gemiste $2.000-fraude veel zwaarder dan een gemiste van $15, en markeren betekent niet dat het geld is gered. R3 begrenst de drukste enkele dag, en die formulering bepaalt uiteindelijk de audit.
De agent mag twee wijzigingen onderzoeken: een dagelijkse capaciteit tot 260 met één drempel, of aparte kanaaldrempels bij de oorspronkelijke cap. Beide vereisen menselijke goedkeuring, ze kunnen niet worden gecombineerd, en het beleid geeft de voorkeur aan de optie zonder extra reviewers.
Wat telt als een correcte audit
Een correcte audit krijgt vier dingen goed, en je zou die vóór het eerste request moeten bepalen:
Het oordeel: of een enkele drempel R1, R2 en R3 op validatie haalt
Het conflict: welke vereisten het oorspronkelijke beleid onmogelijk maken
Het alternatief: een toegestane wijziging die elke regel haalt wanneer Python het herberekent
De voorkeur: de aanbeveling volgt de voorkeursvolgorde van het beleid
Een evaluator die de agent niet kan aanroepen berekent het antwoord.
Hoe je de Gemini 4 Carbon API in Python instelt
Het instellen van de Gemini 4 Carbon API vereist Python 3.11 of nieuwer en een API-sleutel van een Google AI Studio-project met billing aan, aangezien de prijspagina geen gratis tier vermeldt.
Installeer de Google Gen AI SDK en bereid het project voor
Ik testte dit project met de Google Gen AI software development kit (SDK) vastgezet op google-genai==3.1.0, de release op PyPI van de lanceringsdag die gemini-4-carbon toevoegde aan de Interactions-modellijst. Clone het project en installeer het in een virtual environment:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS of Linux: source .venv/bin/activate
pip install-r requirements.txtMogelijk gemaakt door
Voer daarna de twee commando's op de repositorypagina uit die de data bouwen en de classifier met vaste seeds fitten. Op een verse clone printen ze dit:
Vaste seeds bouwen dezelfde dataset opnieuw. Afbeelding door auteur.
Zet daarna GEMINI_API_KEY=your-key in een .env-bestand. De repository laadt hem zonder hem te printen.
Doe je eerste Gemini 4 Carbon API-request
Draai dit volledige voorbeeld vanuit de projectmap. Het geeft Gemini 4 Carbon het beleid en de classifier-samenvatting en vraagt wat het zou moeten meten, zonder een hint van een conflict:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Mogelijk gemaakt door
Het denk-niveau gaat in generation_config, en output_text bevat het antwoord. Dit is een deel van wat terugkwam:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Mogelijk gemaakt door
Het las R3 als een piek en plande de voorkeursvolgorde van het beleid voordat het een getal zag. Het vroeg echter nooit hoe ties of afronden van scores werken, en de uitputtende check die ik later laat zien hangt daar precies vanaf. De call duurde ongeveer 40 seconden en kostte ongeveer 2 cent.
Laat temperature, top_p en top_k weg, die negeert Gemini 4 Carbon toch, evenals thinking_budget.
Hoe je een ML-auditagent bouwt met Gemini 4 Carbon Function Calling
Een Gemini 4 Carbon-auditagent is een lus: het model vraagt om een evaluatie, Python valideert en voert die uit, en het resultaat gaat terug totdat het model stopt met vragen.
Definieer alleen-lezen tools voor modelevaluatie
De agent krijgt drie tools. Allemaal beperkt tot het validatievenster:
get_audit_context: de classifier-samenvatting, huidige configuratie, beleid en toegestane wijzigingen
evaluate_global_threshold: fraudewaarde-recall totaal en per kanaal, flags per dag en diagnostiek voor één drempel
evaluate_policy_change: dezelfde metingen voor een capaciteitsverhoging of een paar kanaaldrempels
De volledige schema's staan in de repository. Dit vereenvoudigde fragment laat de drempel- en capaciteitsvelden weg, dus het is geen complete declaratie om te kopiëren. Het toont alleen de grens die hier telt: de tool accepteert de twee beleidswijzigingen die PayGuard toestaat, leest validatiedata en keurt niets goed.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Mogelijk gemaakt door
Python valideert de weggelaten drempel- en capaciteitsvelden, wijst wijzigingen buiten het beleid af en retourneert metingen in plaats van pass/fail-vlaggen. De agent kan niet bij de holdout, kan de evaluator niet aanroepen en kan het beleid niet wijzigen. In de FAQ leg ik uit waarom ik de ingebouwde code-executie van Gemini 4 Carbon heb overgeslagen.
Geef de agent een duidelijk doel en stopregels
De systeeminstructie bepaalt de werkwijze. Net als het eerste request geeft het geen hint waar het conflict zit:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.Mogelijk gemaakt door
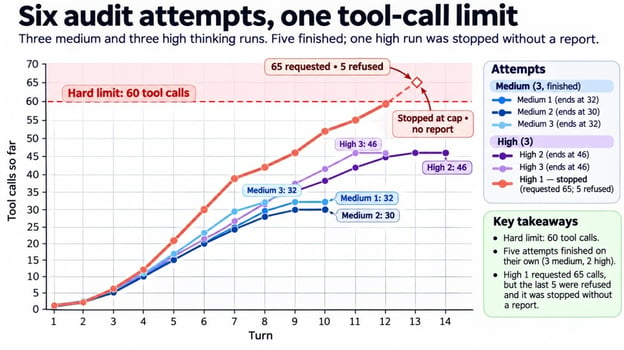
De prompt kan alleen vragen, dus de limieten leven in de agent harness, de Python-code rond het model. Aangezien de API geen budgetinstelling heeft, zet de applicatie ze per poging: 25 beurten, 60 tool-calls, 30 minuten en $3, met uitgavencontrole tussen de beurten.
Implementeer de function calling-lus met de Interactions API
Elke beurt is één client.interactions.create()-aanroep. Gemini 4 Carbon vraagt vaak meerdere tools tegelijk, dus de lus draait elke function_call-stap. Dit is de kernlus; de repositoryversie voegt logging en limietchecks toe:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Mogelijk gemaakt door
Ik houd deze instellingen in één request-dict zodat elke vervolgcall ze opnieuw meestuurt. previous_interaction_id draagt de geschiedenis, maar tools, system_instruction en generation_config gelden per interaction. Als een beurt incomplete eindigt, heeft max_output_tokens hem afgekapt, en je betaalt alsnog voor de thinking tokens.
Geef een gestructureerd auditrapport terug met een JSON-schema
Googles gids voor gestructureerde output noemt tools plus een JSON-schema in één request als een Preview-functie die ook Gemini 4 Carbon omvat. Ik hield ze toch gescheiden: de onderzoekbeurten meten alleen, en een laatste beurt op dezelfde geschiedenis en config schrijft het rapport met een schema en zonder tools:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Mogelijk gemaakt door
AuditReport is een Pydantic-model met het oordeel, het conflict, het bewijs, de aanbeveling en de approvals. Python meet tijd en kosten in plaats van Gemini 4 Carbon te vragen die te rapporteren.
Voer de Gemini 4 Carbon-audit uit op het fraudedetectiemodel
Gemini 4 Carbon auditeerde het model zoals ik een junior analist dat zou willen: met metingen vóór elke conclusie. Bij de eerste medium-poging las het de auditcontext, controleerde een twintigtal enkele drempels en testte acht beleidswijzigingen.
Alle 32 tool-calls, op volgorde. Afbeelding door auteur.
Evalueer PayGuards huidige drempel
De agent evalueerde de huidige drempel van 0,5 en vond 91% Website-recall, 20% Mobile App-recall, 64% totale recall en 85 flags op de drukste dag. Dat faalt R1 en de Mobile App-helft van R2 met ruimte onder R3, dus de voor de hand liggende stap is een lagere drempel.
Test fraudewaarde-recall tegenover dagelijkse reviewcapaciteit
Een drempel verlagen vangt meer fraudewaarde en stuurt meer orders naar review. PayGuard heeft genoeg van het eerste nodig terwijl het tweede onder een dagelijkse cap blijft.
De agent probeerde wat grove drempels in één batch en verfijnde daarna naar enkele roosterpunten. Calls 11, 12, 17 en 18 in de trace gaven de doorslag.
In dit validatievenster heeft de Mobile App-ondergrens 0,108 of lager nodig, want één stap hoger duwt het net onder 70%. De cap vereist 0,118 of hoger. Geen drempel doet beide.
De totale recall houdt stand tot 0,137, dus R1 blijft buiten het conflict. Bij 0,108 heeft de gemiddelde dag ongeveer 169 flags, en alleen één zaterdag gaat erover. Daarom gebruikt het beleid de werkdruk van de drukste dag in plaats van het daggemiddelde.
Mobile-recall en capaciteit overlappen nooit. Afbeelding door auteur.
Check performance over beide betaal kanalen
Mobile App-fraude, met zwakkere signalen, zit laag in het scorerange. Eén drempel omlaag naar 0,108 voor de Mobile App trekt ook meer legitieme Website-orders binnen, en op die zaterdag duwen die het totaal over de cap.
Het totaal verbergt het: bij 0,118 is de totale recall ongeveer 87% terwijl de Mobile App onder zijn ondergrens zit. Als je beleid segmenten noemt, meet elk segment, want het totaal kan slagen terwijl één segment faalt.
Kan Gemini 4 Carbon conflicterende uitrolvereisten detecteren?
Ja, in deze audit. Het bevroren rapport zegt not deployable, stelt dat geen enkele drempel werkt en noemt R2 voor de Mobile App en R3 als het conflict.
Check het uitroloordeel van Gemini 4 Carbon tegen het bewijs
Elk getal dat het rapport aanhaalt komt overeen met een toolresultaat, maar één zin claimt meer dan de agent heeft gemeten. Er staat dat geen drempel werkt "across all 0.001 risk-score grid points", terwijl de agent alleen de twee dozijn in de bovenstaande trace testte, uit 1.002 mogelijke drempels.
De claim houdt stand omdat recall en dagelijkse aantallen beide dalen naarmate de drempel stijgt, wat het rapport nooit zegt. Check elke claim in een agentrapport tegen wat er gemeten is, en onze gids voor het evalueren van AI-agents behandelt meer van dit soort checks.
Verifieer het conflict met een uitputtende Python-evaluator
Gemini 4 Carbon samplede drempels en leidde af dat geen enkele kon werken. De evaluator bewijst dat resultaat voor deze validatieset door elke distincte flagset te controleren, zonder code met de tools te delen.
Scores liggen op een 0,001-rooster, dus de 1.002 kandidaat-cutoffs dekken elke mogelijke flagset. De evaluator controleert ze allemaal, plus elk paar kanaaldrempels, met gehele centen zodat 85% en 70% exact zijn.
Uitputtende check en vier afgewezen configuraties. Afbeelding door auteur.
Geen globale drempel haalt alle drie de regels, dus de claim van Gemini 4 Carbon heeft nu bewijs erachter. De evaluator kwam uit op dezelfde grenzen 0,108 en 0,118 als de agent vond en vond duizenden kanaalparen die slagen bij 200 per dag.
Een evaluator helpt alleen als hij foute antwoorden afwijst, dus ik voerde hem vier verkeerde configuraties, en hij wees alle vier af.
Test uitrolalternatieven met Gemini 4 Carbon
Gemini 4 Carbon testte beide toegestane wijzigingen en koos gescheiden drempels bij de oorspronkelijke cap boven extra reviewers. Het markeerde die keuze als een uitzondering die een persoon moet goedkeuren.
Test een verhoging van de handmatige reviewcapaciteit
Eén globale drempel werkt als de cap stijgt van 200 naar 205, en de evaluator bevestigde 205 als de kleinste verhoging. Gemini 4 Carbon rangschikte deze optie toch als tweede, vanwege de voorkeurregel die ik eerder beschreef.
Test aparte drempels voor elk betaal kanaal
Aan de kanaalkant hield de agent de Mobile App-drempel dicht bij zijn grens (het had al gezien dat 0,109 de ondergrens brak) en verhoogde de Website-drempel, waardoor flags op legitieme Website-orders omlaag gingen. Het testte zeven paren, en één faalde met één enkele flag op de drukste dag. Het raadde Website 0,3 en Mobile App 0,1 aan omdat dat paar elke regel ruim haalt, en de evaluator bevestigde het bij de oorspronkelijke cap.
Vergelijk de geverifieerde alternatieven
Deze cijfers kwamen hierboven langs, en de evaluator rekende ze elk opnieuw uit:
Optie
Drempels
Totaal
Website
Mobile App
Drukste dag
Goedkeuring
Oorspronkelijk beleid
Globaal 0,108
87,5%
98,2%
70,1%
205, cap 200
Faalt
Meer capaciteit
Globaal 0,108
87,5%
98,2%
70,1%
205, cap 205
Nodig
Kanaalsplitsing
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, cap 200
Nodig
De kanaalsplitsing markeert ook circa 6% minder transacties dan de capaciteitsoptie. Minder dan de helft van de flags is echter fraude, wat het rapport als open punt noteerde.
Hoe je de aanbeveling van Gemini 4 Carbon verifieert op onzichtbare data
Je verifieert de aanbeveling door die, bevroren, toe te passen op de verzegelde holdout. Het verschil met de evaluator is de data: de evaluator scoorde weken die de agent kon zien, en de holdout scoort vier latere weken die geen enkele tool kon lezen. De check draait één keer per bevroren aanbeveling en start niet als het rapport na het bevriezen is gewijzigd.
De bevroren aanbeveling slaagt op de holdout. Afbeelding door auteur.
Het haalde alle drie de regels, en de drukste dag bleef onder de cap. Lees er niet te veel in, though. Drie dingen houden dit resultaat bescheiden:
De holdout komt van dezelfde generator, dus zegt niets over nieuwe soorten fraude of datadrift
De totale recall haalde 85% met minder dan twee punten marge
Mijn ongeteste gok: de splitsing kan de cap breken als Mobile App-verkeer sneller groeit dan Website-verkeer, omdat de Mobile App-drempel zo laag staat
De eerste twee komen uit de cijfers.
Bekijk de volledige audit in Streamlit
De repository bevat ook een Streamlit-app en de zes opgenomen pogingen, zodat je deze audit kunt openen zonder API-call. In de video laad ik hem en loop ik tab voor tab door.
De Streamlit-app toont één audit. Video door auteur.
Gemini 4 Carbon medium vs. high thinking: nauwkeurigheid, tijd en kosten
Succes betekent hier binnen de applicatielimieten eindigen en een rapport retourneren dat de evaluator accepteert. Een gestopte poging heeft geen oordeel om te scoren. Volgens die definitie eindigde medium elke poging en kostte het minder dan de helft per correcte audit.
Zes pogingen zijn te weinig om daar een algemene regel van te maken. Als denk-niveaus nieuw voor je zijn, behandelt onze Gemini 3.8 Flash API-tutorialthinking_level uitgebreider.
Vergelijk medium en high thinking op dezelfde audit
Dit is de volledige vergelijking achter de TL;DR. Ik draaide 3 pogingen per niveau, elk vanuit een schone staat zonder geheugen aan de anderen, met identieke data, prompt, tools, limieten en evaluator:
Per niveau
medium
high
Pogingen die eindigden met een rapport
3 van 3
2 van 3
Correcte audits daarvan
3 van 3
2 van 2
Thinking tokens per poging
Ongeveer 7.700
Ongeveer 17.500
Tijd per poging
Ongeveer 5 minuten
Ongeveer 6 minuten
Kosten per correcte audit, introductietarief
Ongeveer $0,25
Ongeveer $0,62
Kosten per correcte audit, standaardtarief
Ongeveer $0,51
Ongeveer $1,24
De kostenrijen tellen de uitgaven van elke poging mee, inclusief de gestopte. Elke voltooide poging kwam tot hetzelfde oordeel en conflict en koos een kanaalpaar dat de evaluator accepteerde, dus de extra denkarbeid ging naar meer checks.
Ik zag een vergelijkbaar patroon in het Gemini 4 Argon-codeerexperiment: highgaf meer uit en deed meer werk voor een kleinere verandering in het geverifieerde resultaat. De taken verschillen, dus hun kosten en slagingspercentages zijn niet direct vergelijkbaar. In beide gevallen vertelt de onafhankelijke check ons meer dan het totaal aan denken.
Waarom één high thinking-poging nooit eindigde
De poging die stopte was de eerste van high, en hij gaf nooit een fout oordeel. Hij onderzocht elk roosterpunt van 0,101 tot 0,119 en ging daarna op zoek naar de 70%-grens van de Website, waar niets van afhing, en bleef om meer checks vragen tot hij de eerder ingestelde limiet van 60 calls raakte en de applicatie hem stopte vóór het rapport.
Slechts één poging tikte de limiet aan. Afbeelding door auteur.
Die stop is het nuttige deel. Een prompt die om minder calls vraagt had het niet beëindigd, en de limiet in code deed dat wel, na ongeveer 22 cent.
De vijf voltooide rapporten doorstonden ook de andere Python-checks. Geen enkel las de huidige configuratie verkeerd, noemde een vereiste buiten het conflict, haalde een tool-call aan die niet bestond of raadde een configuratie aan die het niet had getest.
Meet tokens, tijd en kosten per audit
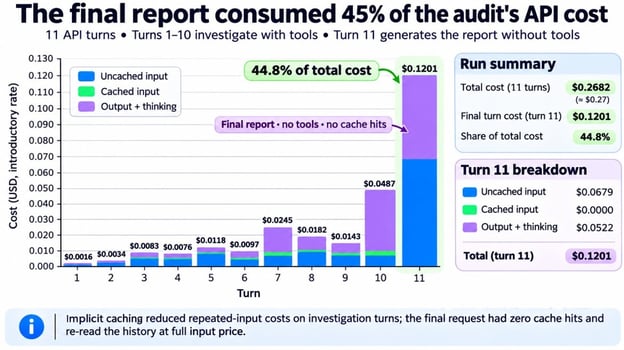
Een audit kost de som van elke beurt zijn usage, geprijsd op $2,00 per miljoen inputtokens, $0,10 cached, en $10,00 output inclusief denken, en die verdubbelen op 1 december 2026. total_input_tokens omvat cached tokens, dus de code prijst de twee delen apart.
De rapportbeurt kost het meest. Afbeelding door auteur.
De verrassing zat in het rapport, of preciezer, de rekening. Impliciete caching dekte circa driekwart van de inputtokens in de onderzoekbeurten, maar de reportrequest zonder tools kreeg nooit een cache-hit.
De waarschijnlijke oorzaak is dat het weglaten van tools het begin van het request verandert. Hoe dan ook, die beurt herlas de hele geschiedenis tegen volle prijs en nam ongeveer 40% van de kosten van elke voltooide poging. Tel die beurt mee als je je uitgavenlimiet vaststelt.
Beperkingen bij het gebruik van Gemini 4 Carbon voor ML-modelauditing
Ik ontwierp deze test en genereerde de data zelf, dus de resultaten kennen deze beperkingen:
De data is synthetisch en komt van één classifier, en ik heb de generator afgestemd totdat er een conflict bestond, vóór enige API-call
Het oordeel geldt alleen voor deze classifier, en een betere zou alle drie de regels met één drempel kunnen halen
Een drempel kun je controleren, maar een kanaalsplitsing goedkeuren is een business- en fairnessafweging
Interactions worden op de betaalde tier standaard 55 dagen opgeslagen, en store=false sluit previous_interaction_id uit, dus een agent die transactierijen verstuurt heeft een datareview nodig
De evaluator lost het drempelprobleem zelfstandig op, zonder model. Als je alleen een drempel nodig hebt, gebruik dan een optimalisatie-oplosser. Wat Gemini 4 Carbon toevoegde was de audit eromheen.
Niets hier is aan fraude gebonden. De setup past bij elk model waarvan Python de regels kan meten.
Tot slot
Het belangrijkste resultaat is dat Gemini 4 Carbon herkende dat het oorspronkelijke beleid geen geldige globale drempel had. Alle 5 voltooide pogingen noemden het conflict en stelden een kanaalsplitsing voor die de evaluator accepteerde; één high-poging stopte vóór het produceren van een rapport.
De Gemini 4 Argon- en Gemini 4 Carbon-experimenten testen twee kanten van agentbetrouwbaarheid. De Gemini 4 Argon-agent paste code aan en moest gedrag behouden, terwijl de Gemini 4 Carbon-agent tot een besluit kwam onder regels die het oorspronkelijke antwoord onmogelijk maakten. Beide hadden smalle tools, hulpbronnenlimieten en een check buiten het model nodig.
Dat is de standaard die ik voor een agent zou gebruiken: definieer wat zijn tools kunnen vaststellen, verifieer het resultaat onafhankelijk en sta een inconclusiveantwoord toe wanneer het bewijs op is. Vervolgens zou ik twee of drie kandidaat-classifiers onder hetzelfde beleid zetten en vragen welke, als er één is, kan worden verscheept.
Ik ben een data-engineer en communitybouwer die werkt aan datapijplijnen, cloud en AI-tools, en tegelijkertijd praktische, impactvolle tutorials schrijft voor DataCamp en beginnende developers.
FAQs
Hoe krijg ik toegang tot de Gemini 4 Carbon API?⌄
Via een betaald Google AI Studio-project of via Gemini for business op Google Cloud. De Gemini-app, Antigravity en AI Mode bieden het ook aan Google AI Ultra-abonnees, maar die consumentenapps geven je geen API-sleutel.
Wat kost de Gemini 4 Carbon API?⌄
Alle 6 audits hier kwamen uit op $2,00 tegen het introductietarief. Standaardrequests zoals deze krijgen impliciete caching zodra een request meer dan 4.096 inputtokens bevat, dus houd het begin van elk request identiek. Flex inference, dat Interactions-requests ook ondersteunen, halveert de tokenprijzen in ruil voor tragere, minder betrouwbare responses.
Wat zijn de rate limits voor de Gemini 4 Carbon API?⌄
Betaalde projecten hebben per-minuutilimieten plus een uitgavenlimiet, die op Tier 1 $10 per rollend venster van 10 minuten is, en daaroverheen krijg je 429 RESOURCE_EXHAUSTED. Eén audit hier kostte minder dan $1, dus alleen veel parallelle pogingen zouden die raken. De limieten stijgen met je tier, dus check Googles pagina met rate limits voor jouw project.
Wat is het verschil tussen medium en high thinking in Gemini 4 Carbon?⌄
Gemini 4 Carbon heeft drie niveaus, low, medium (de standaard) en high, en ik vergeleek hier alleen de bovenste twee. Wil je zien hoe het extra denken eruitziet, zet thinking_summariesop "auto" en je krijgt beknopte samenvattingen naast elk antwoord. Ze staan standaard uit en kunnen leeg blijven als het model nauwelijks redeneert.
Kan Gemini 4 Carbon Python-code draaien?⌄
Ja. Voeg {"type": "code_execution"} toe aan toolsen Gemini 4 Carbon kan Python schrijven en draaien aan Googles kant, gefactureerd tegen de normale tokenprijzen. Ik liet het weg om de controle aan mijn kant te houden: de drie tools bepalen wat het kan meten, en de ruwe transacties en de holdout verlaten mijn machine niet.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.





In onze Gemini 4 Argon API-tutorial had de agent een duidelijke taak: trage code vinden, aanpassen en verborgen tests doorstaan. Dit bijbehorende experiment houdt hetzelfde patroon van gecontroleerde tools en een externe controle, maar verandert de beslissing. Gemini 4 Carbon moet uitzoeken of de oorspronkelijke regels überhaupt haalbaar zijn.
PayGuard, een fictieve webwinkel, heeft een getraind machine learning (ML)-model dat bestellingen op fraude scoort. Het uitrolbeleid vereist dat het model voldoende fraudewaarde afvangt, zowel totaal als per verkoopkanaal, zonder het reviewteam te overspoelen. De agent moet die regels onderzoeken zonder te weten of er een geldige drempel bestaat.
Gemini 4 Carbon is een Google-redenatiemodel dat je vanuit Python aanroept via de Interactions API. Hier fungeert het als een AI-agent: het kiest welke checks het wil aanvragen, en Python voert die uit via drie alleen-lezen tools met function calling. Mijn vraag is of het de tegenstrijdigheid kan identificeren, het bewijs kan uitleggen en een toegestane wijziging kan aanbevelen zonder die wijziging als goedgekeurd te behandelen.
Je hebt basiskennis van Python nodig en een beetje ervaring met API-requests. Ik definieer elke fraudemetriek voordat de cijfers die gebruiken. We behandelen hoe je:
Wil je het lanceringsverhaal en benchmark-scores, dan staan die in onze overzicht van Gemini 4 Carbon en onze Claude Fable 5.2 vs. Gemini 4 Carbon-analyse vergelijkt de twee modellen. Ik draaide dit experiment de dag nadat Google de API opende voor betalende developers.
Wat is de Gemini 4 Carbon API?
De Gemini 4 Carbon API is de betaalde application programming interface (API) voor
gemini-4-carbon, die de modelpagina omschrijft als een redenatiemodel voor lange, meerstaps agent-taken. Input, denken en output delen een contextvenster van 1.048.576 tokens, en een synchrone respons stopt standaard bij 65.536 tokens aan denken plus output.Waarom een ML-modelaudit een goede test is voor Gemini 4 Carbon
De taak vereist meerdere checks, een zoektocht door toegestane wijzigingen en een duidelijke stop wanneer de regels geen antwoord toelaten. Ik koos dit omdat Python het referentieresultaat kan uitrekenen. De modelkaart noemt hallucinaties als een bekende beperking van Gemini 4 Carbon, dus het model onderzoekt terwijl Python beslist of de aanbeveling standhoudt.
Het project: bepalen of PayGuards fraudemodel live kan
PayGuard is de fictieve winkel uit de intro, en het volledige project staat in de GitHub-repository. De classifier is al getraind.
Hoe PayGuard transacties scoort
Elke transactie heeft een UTC-timestamp, een bedrag, een kanaal (Website of Mobile App), een risicoscore en een fraudelabel. Een scikit-learn
HistGradientBoostingClassifierproduceert de score, afgerond op 0,001, en PayGuard markeert een transactie wanneerrisk_score >= threshold. Onze precision-recall curvetutorial laat zien hoe het verschuiven van een drempel beïnvloedt wat gemarkeerd wordt, en onze cursus Fraudedetectie in Python behandelt de modelkant.De synthetische data is tijdgesplitst:
De huidige drempel is 0,5, en data en beleid veranderen niet tijdens het experiment. Websitefraude laat in deze data duidelijke signalen achter, terwijl de meeste Mobile App-fraude op een gewone bestelling lijkt.
Gemini 4 Carbon vraagt, Python beslist. Afbeelding door auteur.
PayGuards drie uitrolregels
Hier zijn de drie regels uit de intro, opgeschreven zoals het beleid ze stelt. Het zijn allemaal fictieve doelen die ik voor dit experiment heb gekozen:
Fraudewaarde-recall is de waarde van gemarkeerde fraude gedeeld door de totale waarde van fraude. Anders dan de transactie-level recall in onze gids over precisie versus recall telt een gemiste $2.000-fraude veel zwaarder dan een gemiste van $15, en markeren betekent niet dat het geld is gered. R3 begrenst de drukste enkele dag, en die formulering bepaalt uiteindelijk de audit.
De agent mag twee wijzigingen onderzoeken: een dagelijkse capaciteit tot 260 met één drempel, of aparte kanaaldrempels bij de oorspronkelijke cap. Beide vereisen menselijke goedkeuring, ze kunnen niet worden gecombineerd, en het beleid geeft de voorkeur aan de optie zonder extra reviewers.
Wat telt als een correcte audit
Een correcte audit krijgt vier dingen goed, en je zou die vóór het eerste request moeten bepalen:
Een evaluator die de agent niet kan aanroepen berekent het antwoord.
Hoe je de Gemini 4 Carbon API in Python instelt
Het instellen van de Gemini 4 Carbon API vereist Python 3.11 of nieuwer en een API-sleutel van een Google AI Studio-project met billing aan, aangezien de prijspagina geen gratis tier vermeldt.
Installeer de Google Gen AI SDK en bereid het project voor
Ik testte dit project met de Google Gen AI software development kit (SDK) vastgezet op
google-genai==3.1.0, de release op PyPI van de lanceringsdag diegemini-4-carbontoevoegde aan de Interactions-modellijst. Clone het project en installeer het in een virtual environment:Voer daarna de twee commando's op de repositorypagina uit die de data bouwen en de classifier met vaste seeds fitten. Op een verse clone printen ze dit:
Vaste seeds bouwen dezelfde dataset opnieuw. Afbeelding door auteur.
Zet daarna
GEMINI_API_KEY=your-keyin een.env-bestand. De repository laadt hem zonder hem te printen.Doe je eerste Gemini 4 Carbon API-request
Draai dit volledige voorbeeld vanuit de projectmap. Het geeft Gemini 4 Carbon het beleid en de classifier-samenvatting en vraagt wat het zou moeten meten, zonder een hint van een conflict:
Het denk-niveau gaat in
generation_config, enoutput_textbevat het antwoord. Dit is een deel van wat terugkwam:Het las R3 als een piek en plande de voorkeursvolgorde van het beleid voordat het een getal zag. Het vroeg echter nooit hoe ties of afronden van scores werken, en de uitputtende check die ik later laat zien hangt daar precies vanaf. De call duurde ongeveer 40 seconden en kostte ongeveer 2 cent.
Laat
temperature,top_pentop_kweg, die negeert Gemini 4 Carbon toch, evenalsthinking_budget.Hoe je een ML-auditagent bouwt met Gemini 4 Carbon Function Calling
Een Gemini 4 Carbon-auditagent is een lus: het model vraagt om een evaluatie, Python valideert en voert die uit, en het resultaat gaat terug totdat het model stopt met vragen.
Definieer alleen-lezen tools voor modelevaluatie
De agent krijgt drie tools. Allemaal beperkt tot het validatievenster:
get_audit_context: de classifier-samenvatting, huidige configuratie, beleid en toegestane wijzigingenevaluate_global_threshold: fraudewaarde-recall totaal en per kanaal, flags per dag en diagnostiek voor één drempelevaluate_policy_change: dezelfde metingen voor een capaciteitsverhoging of een paar kanaaldrempelsDe volledige schema's staan in de repository. Dit vereenvoudigde fragment laat de drempel- en capaciteitsvelden weg, dus het is geen complete declaratie om te kopiëren. Het toont alleen de grens die hier telt: de tool accepteert de twee beleidswijzigingen die PayGuard toestaat, leest validatiedata en keurt niets goed.
Python valideert de weggelaten drempel- en capaciteitsvelden, wijst wijzigingen buiten het beleid af en retourneert metingen in plaats van pass/fail-vlaggen. De agent kan niet bij de holdout, kan de evaluator niet aanroepen en kan het beleid niet wijzigen. In de FAQ leg ik uit waarom ik de ingebouwde code-executie van Gemini 4 Carbon heb overgeslagen.
Geef de agent een duidelijk doel en stopregels
De systeeminstructie bepaalt de werkwijze. Net als het eerste request geeft het geen hint waar het conflict zit:
De prompt kan alleen vragen, dus de limieten leven in de agent harness, de Python-code rond het model. Aangezien de API geen budgetinstelling heeft, zet de applicatie ze per poging: 25 beurten, 60 tool-calls, 30 minuten en $3, met uitgavencontrole tussen de beurten.
Implementeer de function calling-lus met de Interactions API
Elke beurt is één
client.interactions.create()-aanroep. Gemini 4 Carbon vraagt vaak meerdere tools tegelijk, dus de lus draait elkefunction_call-stap. Dit is de kernlus; de repositoryversie voegt logging en limietchecks toe:Ik houd deze instellingen in één
request-dict zodat elke vervolgcall ze opnieuw meestuurt.previous_interaction_iddraagt de geschiedenis, maartools,system_instructionengeneration_configgelden per interaction. Als een beurtincompleteeindigt, heeftmax_output_tokenshem afgekapt, en je betaalt alsnog voor de thinking tokens.Geef een gestructureerd auditrapport terug met een JSON-schema
Googles gids voor gestructureerde output noemt tools plus een JSON-schema in één request als een Preview-functie die ook Gemini 4 Carbon omvat. Ik hield ze toch gescheiden: de onderzoekbeurten meten alleen, en een laatste beurt op dezelfde geschiedenis en config schrijft het rapport met een schema en zonder tools:
AuditReportis een Pydantic-model met het oordeel, het conflict, het bewijs, de aanbeveling en de approvals. Python meet tijd en kosten in plaats van Gemini 4 Carbon te vragen die te rapporteren.Voer de Gemini 4 Carbon-audit uit op het fraudedetectiemodel
Gemini 4 Carbon auditeerde het model zoals ik een junior analist dat zou willen: met metingen vóór elke conclusie. Bij de eerste
medium-poging las het de auditcontext, controleerde een twintigtal enkele drempels en testte acht beleidswijzigingen.Alle 32 tool-calls, op volgorde. Afbeelding door auteur.
Evalueer PayGuards huidige drempel
De agent evalueerde de huidige drempel van 0,5 en vond 91% Website-recall, 20% Mobile App-recall, 64% totale recall en 85 flags op de drukste dag. Dat faalt R1 en de Mobile App-helft van R2 met ruimte onder R3, dus de voor de hand liggende stap is een lagere drempel.
Test fraudewaarde-recall tegenover dagelijkse reviewcapaciteit
Een drempel verlagen vangt meer fraudewaarde en stuurt meer orders naar review. PayGuard heeft genoeg van het eerste nodig terwijl het tweede onder een dagelijkse cap blijft.
De agent probeerde wat grove drempels in één batch en verfijnde daarna naar enkele roosterpunten. Calls 11, 12, 17 en 18 in de trace gaven de doorslag.
In dit validatievenster heeft de Mobile App-ondergrens 0,108 of lager nodig, want één stap hoger duwt het net onder 70%. De cap vereist 0,118 of hoger. Geen drempel doet beide.
De totale recall houdt stand tot 0,137, dus R1 blijft buiten het conflict. Bij 0,108 heeft de gemiddelde dag ongeveer 169 flags, en alleen één zaterdag gaat erover. Daarom gebruikt het beleid de werkdruk van de drukste dag in plaats van het daggemiddelde.
Mobile-recall en capaciteit overlappen nooit. Afbeelding door auteur.
Check performance over beide betaal kanalen
Mobile App-fraude, met zwakkere signalen, zit laag in het scorerange. Eén drempel omlaag naar 0,108 voor de Mobile App trekt ook meer legitieme Website-orders binnen, en op die zaterdag duwen die het totaal over de cap.
Het totaal verbergt het: bij 0,118 is de totale recall ongeveer 87% terwijl de Mobile App onder zijn ondergrens zit. Als je beleid segmenten noemt, meet elk segment, want het totaal kan slagen terwijl één segment faalt.
Kan Gemini 4 Carbon conflicterende uitrolvereisten detecteren?
Ja, in deze audit. Het bevroren rapport zegt
not deployable, stelt dat geen enkele drempel werkt en noemt R2 voor de Mobile App en R3 als het conflict.Check het uitroloordeel van Gemini 4 Carbon tegen het bewijs
Elk getal dat het rapport aanhaalt komt overeen met een toolresultaat, maar één zin claimt meer dan de agent heeft gemeten. Er staat dat geen drempel werkt "across all 0.001 risk-score grid points", terwijl de agent alleen de twee dozijn in de bovenstaande trace testte, uit 1.002 mogelijke drempels.
De claim houdt stand omdat recall en dagelijkse aantallen beide dalen naarmate de drempel stijgt, wat het rapport nooit zegt. Check elke claim in een agentrapport tegen wat er gemeten is, en onze gids voor het evalueren van AI-agents behandelt meer van dit soort checks.
Verifieer het conflict met een uitputtende Python-evaluator
Gemini 4 Carbon samplede drempels en leidde af dat geen enkele kon werken. De evaluator bewijst dat resultaat voor deze validatieset door elke distincte flagset te controleren, zonder code met de tools te delen.
Scores liggen op een 0,001-rooster, dus de 1.002 kandidaat-cutoffs dekken elke mogelijke flagset. De evaluator controleert ze allemaal, plus elk paar kanaaldrempels, met gehele centen zodat 85% en 70% exact zijn.
Uitputtende check en vier afgewezen configuraties. Afbeelding door auteur.
Geen globale drempel haalt alle drie de regels, dus de claim van Gemini 4 Carbon heeft nu bewijs erachter. De evaluator kwam uit op dezelfde grenzen 0,108 en 0,118 als de agent vond en vond duizenden kanaalparen die slagen bij 200 per dag.
Een evaluator helpt alleen als hij foute antwoorden afwijst, dus ik voerde hem vier verkeerde configuraties, en hij wees alle vier af.
Test uitrolalternatieven met Gemini 4 Carbon
Gemini 4 Carbon testte beide toegestane wijzigingen en koos gescheiden drempels bij de oorspronkelijke cap boven extra reviewers. Het markeerde die keuze als een uitzondering die een persoon moet goedkeuren.
Test een verhoging van de handmatige reviewcapaciteit
Eén globale drempel werkt als de cap stijgt van 200 naar 205, en de evaluator bevestigde 205 als de kleinste verhoging. Gemini 4 Carbon rangschikte deze optie toch als tweede, vanwege de voorkeurregel die ik eerder beschreef.
Test aparte drempels voor elk betaal kanaal
Aan de kanaalkant hield de agent de Mobile App-drempel dicht bij zijn grens (het had al gezien dat 0,109 de ondergrens brak) en verhoogde de Website-drempel, waardoor flags op legitieme Website-orders omlaag gingen. Het testte zeven paren, en één faalde met één enkele flag op de drukste dag. Het raadde Website 0,3 en Mobile App 0,1 aan omdat dat paar elke regel ruim haalt, en de evaluator bevestigde het bij de oorspronkelijke cap.
Vergelijk de geverifieerde alternatieven
Deze cijfers kwamen hierboven langs, en de evaluator rekende ze elk opnieuw uit:
Optie
Drempels
Totaal
Website
Mobile App
Drukste dag
Goedkeuring
Oorspronkelijk beleid
Globaal 0,108
87,5%
98,2%
70,1%
205, cap 200
Faalt
Meer capaciteit
Globaal 0,108
87,5%
98,2%
70,1%
205, cap 205
Nodig
Kanaalsplitsing
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, cap 200
Nodig
De kanaalsplitsing markeert ook circa 6% minder transacties dan de capaciteitsoptie. Minder dan de helft van de flags is echter fraude, wat het rapport als open punt noteerde.
Hoe je de aanbeveling van Gemini 4 Carbon verifieert op onzichtbare data
Je verifieert de aanbeveling door die, bevroren, toe te passen op de verzegelde holdout. Het verschil met de evaluator is de data: de evaluator scoorde weken die de agent kon zien, en de holdout scoort vier latere weken die geen enkele tool kon lezen. De check draait één keer per bevroren aanbeveling en start niet als het rapport na het bevriezen is gewijzigd.
De bevroren aanbeveling slaagt op de holdout. Afbeelding door auteur.
Het haalde alle drie de regels, en de drukste dag bleef onder de cap. Lees er niet te veel in, though. Drie dingen houden dit resultaat bescheiden:
De eerste twee komen uit de cijfers.
Bekijk de volledige audit in Streamlit
De repository bevat ook een Streamlit-app en de zes opgenomen pogingen, zodat je deze audit kunt openen zonder API-call. In de video laad ik hem en loop ik tab voor tab door.