Tutoriel API Gemini 4 Carbon : créez un agent qui audite un modèle de fraude
Apprenez l’API Gemini 4 Carbon en Python : créez un agent à appel de fonctions qui audite un modèle de fraude, détecte des règles contradictoires et teste un changement de politique.
Dans notre tutoriel sur l’API Gemini 4 Argon, l’agent avait une mission claire : trouver le code lent, le modifier et réussir des tests cachés. Cette expérience complémentaire reprend le même schéma — outils contrôlés et vérification externe — mais change la décision. Gemini 4 Carbon doit déterminer si les règles d’origine peuvent être satisfaites, ou pas, tout court.
PayGuard, une boutique en ligne fictive, dispose d’un modèle de machine learning (ML) entraîné qui attribue un score de risque de fraude aux commandes. Sa politique de déploiement exige que le modèle capte suffisamment de valeur de fraude, au global et par canal de vente, sans saturer l’équipe de revue. L’agent doit examiner ces règles sans savoir d’emblée si un seuil valide existe.
Gemini 4 Carbon est un modèle de raisonnement Google que vous appelez depuis Python via l’Interactions API. Ici, il agit comme un agent IA : il choisit les vérifications à demander, et Python les exécute via trois outils en lecture seule grâce à l’appel de fonctions. Mon enjeu : peut-il identifier le conflit, exposer les preuves et recommander une modification autorisée sans considérer celle-ci comme déjà approuvée ?
Il vous faut des bases en Python et un peu d’expérience avec les requêtes API. Je définis chaque métrique de fraude avant son utilisation dans les chiffres. Nous verrons comment :
Envoyer une première requête à Gemini 4 Carbon depuis Python
Donner au modèle des outils en lecture seule et les exécuter en boucle avec des limites
Récupérer le verdict en JSON pour que votre code puisse le contrôler
Vérifier ce verdict avec du code et des données que le modèle ne voit jamais
Comparer deux niveaux de réflexion, qui pilotent l’ampleur du raisonnement avant réponse
Pour le récit du lancement et les scores de benchmarks, consultez notre aperçu de Gemini 4 Carbon et notre comparaison Claude Fable 5.2 vs. Gemini 4 Carbon. J’ai mené cette expérience le lendemain de l’ouverture de l’API aux développeurs payants par Google.
Qu’est-ce que l’API Gemini 4 Carbon ?
L’API Gemini 4 Carbon est l’interface de programmation applicative (API) payante de gemini-4-carbon, que la page modèle décrit comme un modèle de raisonnement pour des tâches d’agent longues et multi-étapes. Entrée, réflexion et sortie partagent une fenêtre de contexte d’1 048 576 tokens, et une réponse synchrone s’arrête par défaut à 65 536 tokens de réflexion plus sortie.
Pourquoi l’audit d’un modèle ML est un bon test pour Gemini 4 Carbon
La tâche exige plusieurs vérifications, une recherche parmi les changements autorisés et un arrêt net quand les règles ne laissent aucune réponse. Je l’ai choisie car Python peut calculer le résultat de référence. La fiche modèle liste les hallucinations parmi les limites connues de Gemini 4 Carbon, donc le modèle enquête tandis que Python tranche si sa recommandation tient.
Le projet : décider si le modèle de fraude de PayGuard peut être mis en production
PayGuard est la boutique fictive de l’introduction, et le projet complet se trouve dans le référentiel GitHub. Son classifieur est déjà entraîné.
Comment PayGuard note les transactions
Chaque transaction possède un horodatage UTC, un montant, un canal (Website ou Mobile App), un score de risque et une étiquette fraude. Un HistGradientBoostingClassifier de scikit-learn produit le score, arrondi à 0,001, et PayGuard signale une transaction lorsque risk_score >= threshold. Notre tutoriel sur la courbe précision-rappel montre comment déplacer un seuil change ce qui est signalé, et notre cours Fraud Detection in Python couvre l’aspect modélisation.
Les données synthétiques sont découpées dans le temps :
Entraînement : les neuf premières semaines, uniquement pour ajuster le classifieur
Validation : les quatre suivantes, seule fenêtre lisible par les outils
Holdout : les quatre semaines d’après, scellées jusqu’à la gelée de la recommandation
Le seuil actuel est 0,5, et les données comme la politique ne changent jamais pendant l’expérience. La fraude Website laisse des signaux nets dans ces données, tandis que la plupart des fraudes Mobile App ressemblent à une commande ordinaire.
Gemini 4 Carbon pose les questions, Python tranche. Image de l’auteur.
Les trois règles de déploiement de PayGuard
Voici les trois règles de l’intro, écrites comme dans la politique. Ce sont des objectifs fictifs choisis pour cette expérience :
R1 : les transactions signalées couvrent au moins 85 % de la valeur de fraude étiquetée au global
R2 : elles couvrent au moins 70 % de la valeur de fraude étiquetée dans chaque canal
R3 : pas plus de 200 transactions signalées sur une seule journée UTC
Le rappel en valeur de fraude est la valeur de fraude signalée divisée par la valeur totale de fraude. Contrairement au rappel au niveau transaction dans notre guide précision vs rappel, une fraude de 2 000 $ manquée pèse bien plus qu’une de 15 $, et signaler ne signifie pas que l’argent a été sauvé. R3 borne la journée la plus chargée, et ce libellé finit par décider l’audit.
L’agent peut étudier deux modifications : une capacité quotidienne jusqu’à 260 avec un seuil unique, ou des seuils distincts par canal au plafond d’origine. Les deux exigent une approbation humaine, ne peuvent pas être combinées, et la politique privilégie l’option sans renforts supplémentaires en revue.
Ce qui définit un audit correct
Un audit correct coche quatre points, à décider avant la première requête :
Le verdict : si un seuil unique satisfait R1, R2 et R3 sur validation
Le conflit : quelles exigences rendent la politique d’origine impossible
L’alternative : un changement autorisé qui passe toutes les règles quand Python le recalcule
La préférence : la recommandation suit l’ordre de priorité de la politique
Un évaluateur hors de portée de l’agent calcule la réponse.
Comment configurer l’API Gemini 4 Carbon en Python
La configuration de l’API Gemini 4 Carbon nécessite Python 3.11 ou plus et une clé API d’un projet Google AI Studio avec facturation active, puisque la page des tarifs n’annonce pas de palier gratuit.
Installer le SDK Google Gen AI et préparer le projet
J’ai testé ce projet avec le kit de développement logiciel (SDK) Google Gen AI figé à google-genai==3.1.0, la version de lancement sur PyPI qui a ajouté gemini-4-carbon à la liste des modèles Interactions. Clonez le projet et installez-le dans un environnement virtuel :
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS ou Linux : source .venv/bin/activate
pip install-r requirements.txtPropulsé par
Ensuite, exécutez les deux commandes de la page du dépôt qui génèrent les données et ajustent le classifieur avec des graines fixes. Sur un clone neuf, elles affichent ceci :
Des graines fixes reconstruisent le même jeu de données. Image de l’auteur.
Placez ensuite GEMINI_API_KEY=your-key dans un fichier .env. Le dépôt le charge sans l’afficher.
Envoyer votre première requête à l’API Gemini 4 Carbon
Exécutez cet exemple complet depuis le dossier du projet. Il donne à Gemini 4 Carbon la politique et le résumé du classifieur et demande ce qu’il aurait besoin de mesurer, sans suggérer de conflit :
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # texte de politique du projet, seuil et limites
os.environ.pop("GOOGLE_API_KEY",None)# elle primerait sur GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard est un classifieur de fraude e-commerce qui attribue à chaque transaction un score de risque de 0 à 1. "f"Résumé du modèle : {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"Le seuil actuel est {cfg.CURRENT_THRESHOLD}. Avant de juger si ce modèle peut être ""déployé, listez en au plus cinq puces courtes les mesures nécessaires et pourquoi.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommande au moins 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Propulsé par
Le niveau de réflexion se règle dans generation_config, et output_text contient la réponse. Voici un extrait de la sortie :
* Pic de signalements sur une journée UTC au seuil 0,5 : le nombre maximal de transactions
  signalées sur une journée calendaire UTC donnée, pour vérifier ... le plafond strict R3 ...
* Grille de seuils par canal : ... pour tester l’alternative préférée sans capacité additionnelle
  (<= 200/jour) si aucun seuil global ne respecte la politique.

status=completed | input=536 cached=0 output=310 thinking=1412Propulsé par
Il a interprété R3 comme un pic et planifié l’ordre de préférence de la politique avant de voir un seul chiffre. Il n’a toutefois jamais demandé comment gérer les ex æquo ou l’arrondi des scores, alors que le contrôle exhaustif que je montrerai plus loin en dépend précisément. L’appel a pris environ 40 secondes et coûté environ 2 cents.
N’indiquez pas temperature, top_p ni top_k, ignorés par Gemini 4 Carbon, ni thinking_budget.
Construire un agent d’audit ML avec l’appel de fonctions de Gemini 4 Carbon
Un agent d’audit Gemini 4 Carbon fonctionne en boucle : le modèle demande une évaluation, Python la valide et l’exécute, puis renvoie le résultat jusqu’à ce que le modèle cesse de demander.
Définir des outils en lecture seule pour évaluer le modèle
L’agent dispose de trois outils, tous limités à la fenêtre de validation :
get_audit_context : résumé du classifieur, configuration actuelle, politique et changements autorisés
evaluate_global_threshold : rappel en valeur de fraude au global et par canal, signaux par jour et diagnostics pour un seuil
evaluate_policy_change : les mêmes mesures pour une hausse de capacité ou une paire de seuils par canal
Les schémas complets sont dans le dépôt. Cet extrait simplifié omet les champs de seuil et de capacité ; ce n’est donc pas une déclaration complète à copier. Il montre seulement la frontière utile ici : l’outil accepte les deux changements de politique autorisés par PayGuard, lit les données de validation, et n’approuve rien.
{"type":"function","name":"evaluate_policy_change","description":("Évaluer une modification de politique autorisée sur validation. ""Lecture seule ; n’approuve rien."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Propulsé par
Python valide les champs de seuil et de capacité omis, rejette les changements hors politique et renvoie des mesures, pas des drapeaux réussite/échec. L’agent ne peut pas atteindre le holdout, appeler l’évaluateur ni modifier la politique. J’explique dans la FAQ pourquoi j’ai écarté l’exécution de code intégrée de Gemini 4 Carbon.
Donner à l’agent un objectif clair et des règles d’arrêt
L’instruction système définit la méthode. Comme la première requête, elle ne donne aucun indice sur l’emplacement du conflit :
- Lisez d’abord le contexte d’audit, puis évaluez la configuration actuelle avant toute autre chose.
- Vérifiez chaque exigence vous-même en comparant les nombres des outils avec le texte de la politique : R1, R2 pour
  Website, R2 pour Mobile App, et R3. R3 borne la journée la plus chargée, pas la moyenne.
- Utilisez uniquement des nombres renvoyés par un outil. N’estimez pas une métrique que vous n’avez pas mesurée.
- Si les éléments ne tranchent pas une question, dites-le. « Inconcluant » est une réponse acceptable.Propulsé par
Le prompt ne peut que demander ; les limites résident dans le harness d’agent, le code Python autour du modèle. Comme l’API n’a pas de budget intégré, l’application fixe ces limites par tentative : 25 tours, 60 appels d’outils, 30 minutes et 3 $, avec contrôle des dépenses entre les tours.
Implémenter la boucle d’appel de fonctions avec l’Interactions API
Chaque tour correspond à un appel client.interactions.create(). Gemini 4 Carbon demande souvent plusieurs outils en même temps, donc la boucle traite chaque étape function_call. Voici le cœur de la boucle ; la version du dépôt ajoute des logs et des contrôles de limites :
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete : le plafond de sortie a coupé le tour
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# liste blanche, validé
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# ici, contrôles des limites de tours, d’appels d’outils, de temps et de dépenses avant le prochain appel
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Propulsé par
Je regroupe ces paramètres dans un seul dict request pour les renvoyer à chaque relance. previous_interaction_id transporte l’historique, mais tools, system_instruction et generation_config s’appliquent à une seule interaction. Si un tour finit incomplete, max_output_tokens l’a coupé, et vous payez quand même les tokens de réflexion.
Retourner un rapport d’audit structuré avec un schéma JSON
Le guide des sorties structurées de Google liste outils et schéma JSON dans une même requête comme une fonctionnalité Preview prenant en charge Gemini 4 Carbon. J’ai tout de même séparé : les tours d’enquête ne font que mesurer, et un tour final, sur le même historique et la même config, rédige le rapport avec un schéma et sans outils :
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Propulsé par
AuditReport est un modèle Pydantic avec le verdict, le conflit, les preuves, la recommandation et les validations. Python mesure le temps et le coût au lieu de demander à Gemini 4 Carbon de les rapporter.
Exécuter l’audit Gemini 4 Carbon sur le modèle de détection de fraude
Gemini 4 Carbon a audité le modèle comme je l’attendrais d’un analyste junior : des mesures d’abord, les conclusions ensuite. À la première tentative en niveau medium, il a lu le contexte d’audit, vérifié une bonne vingtaine de seuils uniques et testé huit modifications de politique.
Les 32 appels d’outils, dans l’ordre. Image de l’auteur.
Évaluer le seuil actuel de PayGuard
L’agent a évalué le seuil actuel de 0,5 et trouvé 91 % de rappel Website, 20 % Mobile App, 64 % au global, et 85 signalements le jour le plus chargé. Cela échoue à R1 et à la partie Mobile App de R2, avec de la marge sous R3 ; la piste évidente est donc d’abaisser le seuil.
Tester le rappel en valeur de fraude face à la capacité quotidienne de revue
Abaisser un seuil capte plus de valeur de fraude et envoie plus de commandes en revue. PayGuard doit obtenir assez du premier tout en gardant le second sous un plafond quotidien.
L’agent a tenté quelques seuils grossiers en un lot, puis s’est resserré sur des points de grille précis. Les appels 11, 12, 17 et 18 du traçage ont tranché.
Sur cette fenêtre de validation, le plancher Mobile App exige 0,108 ou moins, car un cran au-dessus le fait passer juste sous 70 %. Le plafond de charge impose 0,118 ou plus. Aucun seuil ne satisfait les deux.
Le rappel global tient jusqu’à 0,137, donc R1 reste hors conflit. À 0,108, la journée moyenne compte environ 169 signalements, et seul un samedi dépasse. C’est pourquoi la politique borne la charge de la journée la plus chargée plutôt que la moyenne.
Le rappel Mobile et la capacité ne se recouvrent jamais. Image de l’auteur.
Contrôler la performance sur les deux canaux de paiement
La fraude Mobile App, aux signaux plus faibles, se situe bas dans l’échelle des scores. Tirer un seuil unique vers 0,108 pour Mobile App fait aussi remonter davantage de commandes Website légitimes, et ce samedi-là, elles font franchir le plafond total.
Le total le masque : à 0,118, le rappel global est d’environ 87 % alors que Mobile App reste sous son plancher. Si votre politique cite des segments, mesurez chacun ; le total peut réussir tandis qu’un segment échoue.
Gemini 4 Carbon peut-il détecter des exigences de déploiement contradictoires ?
Oui, dans cet audit. Le rapport figé indique not deployable, précise qu’aucun seuil unique ne fonctionne et cite R2 pour Mobile App et R3 comme conflit.
Vérifier le verdict de déploiement de Gemini 4 Carbon par rapport à ses preuves
Chaque chiffre cité dans le rapport correspond à un résultat d’outil, mais une phrase dépasse ce que l’agent a mesuré. Elle affirme qu’aucun seuil ne marche « sur tous les points de grille à 0,001 », alors que l’agent n’a testé que les deux douzaines du traçage ci-dessus, sur 1 002 seuils possibles.
L’affirmation tient car le rappel et les volumes quotidiens baissent tous deux quand le seuil monte, ce que le rapport ne précise jamais. Contrôlez chaque allégation d’un rapport d’agent par rapport à ce qui a été mesuré ; notre guide évaluer des agents IA couvre d’autres vérifications de ce type.
Confirmer le conflit avec un évaluateur Python exhaustif
Gemini 4 Carbon a échantillonné des seuils et inféré qu’aucun ne pouvait marcher. L’évaluateur prouve ce résultat pour cet ensemble de validation en vérifiant chaque ensemble de signalements distinct, sans partager de code avec les outils.
Les scores sont sur une grille de 0,001, donc 1 002 coupures candidates couvrent tous les ensembles possibles de signalements. L’évaluateur les vérifie tous, plus chaque paire de seuils par canal, en cents entiers pour que 85 % et 70 % soient exacts.
Contrôle exhaustif et quatre configurations rejetées. Image de l’auteur.
Aucun seuil global ne passe les trois règles ; l’affirmation de Gemini 4 Carbon a donc désormais une preuve. L’évaluateur a retrouvé les bornes 0,108 et 0,118 déduites par l’agent et a identifié des milliers de paires par canal qui passent à 200 par jour.
Un évaluateur n’est utile que s’il rejette les mauvaises réponses, donc je lui ai soumis quatre configurations erronées ; il a rejeté les quatre.
Tester des alternatives de déploiement avec Gemini 4 Carbon
Gemini 4 Carbon a testé les deux changements autorisés et préféré des seuils séparés au plafond d’origine plutôt que des réviseurs supplémentaires. Il a signalé ce choix comme une exception nécessitant une approbation humaine.
Tester une hausse de la capacité de revue manuelle
Un seuil global fonctionne si le plafond passe de 200 à 205, et l’évaluateur a confirmé 205 comme la plus petite hausse. Gemini 4 Carbon a tout de même classé cette option en second, en raison de la règle de préférence mentionnée plus haut.
Tester des seuils séparés par canal de paiement
Côté canaux, l’agent a maintenu le seuil Mobile App près de sa limite (il avait déjà vu 0,109 casser le plancher) et relevé le seuil Website, réduisant les signalements de commandes Website légitimes. Il a testé sept paires, dont une a échoué à un seul signalement le jour le plus chargé. Il a recommandé Website 0,3 et Mobile App 0,1 car cette paire respecte chaque règle avec de la marge, et l’évaluateur l’a confirmée au plafond d’origine.
Comparer les alternatives vérifiées
Ces chiffres ont déjà été mentionnés, et l’évaluateur a tout recomputé :
Option
Seuils
Global
Website
Mobile App
Jour le plus chargé
Approbation
Politique d’origine
Global 0,108
87,5 %
98,2 %
70,1 %
205, plafond 200
Échec
Plus de capacité
Global 0,108
87,5 %
98,2 %
70,1 %
205, plafond 205
Nécessaire
Découpage par canal
Website 0,3, Mobile App 0,1
86,2 %
94,5 %
72,8 %
191, plafond 200
Nécessaire
Le découpage par canal signale aussi environ 6 % de transactions en moins que l’option capacité. Moins de la moitié de ses signalements sont de la fraude, cependant, ce que le rapport a listé comme point ouvert.
Comment vérifier la recommandation de Gemini 4 Carbon sur des données inédites
Vous vérifiez la recommandation en l’appliquant, gelée, au holdout scellé. La différence avec l’évaluateur, ce sont les données : l’évaluateur a scoré des semaines visibles par l’agent, et le holdout couvre quatre semaines ultérieures qu’aucun outil n’a pu lire. Le contrôle s’exécute une fois par recommandation gelée et ne démarre pas si le rapport a changé après la gelée.
La recommandation figée passe sur holdout. Image de l’auteur.
Elle a respecté les trois règles, et le jour le plus chargé est resté sous le plafond. N’en tirez pas trop de conclusions pour autant. Trois éléments relativisent ce résultat :
Le holdout provient du même générateur ; il ne dit rien sur de nouveaux types de fraude ni sur la dérive des données
Le rappel global a dépassé 85 % de moins de deux points
Mon hypothèse non testée : le découpage pourrait dépasser le plafond si le trafic Mobile App croît plus vite que Website, car le seuil Mobile App est très bas
Les deux premiers points découlent des chiffres.
Visionner l’audit complet dans Streamlit
Le dépôt inclut aussi une application Streamlit et six tentatives enregistrées, pour ouvrir cet audit sans appel d’API. Dans la vidéo, je la charge et parcours chaque onglet.
L’application Streamlit montre un audit. Vidéo de l’auteur.
Gemini 4 Carbon : réflexion medium vs high — précision, temps et coût
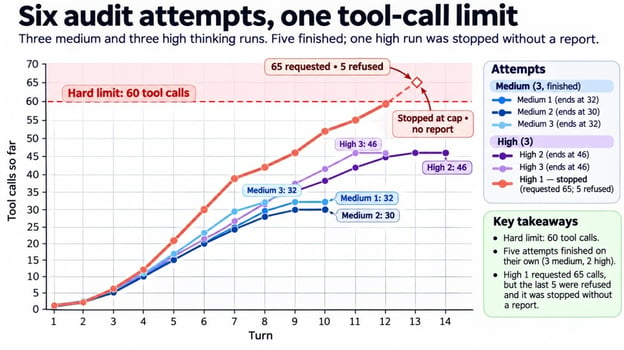
Ici, réussir signifie terminer dans les limites de l’application et renvoyer un rapport accepté par l’évaluateur. Une tentative stoppée n’a pas de verdict à noter. Selon cette définition, medium a terminé chaque tentative et a coûté moins de la moitié par audit correct.
Six tentatives sont trop peu pour en faire une règle générale. Si les niveaux de réflexion vous sont nouveaux, notre tutoriel sur l’API Gemini 3.8 Flash détaille thinking_level.
Comparer medium et high sur le même audit
Voici la comparaison complète derrière le TL;DR. J’ai lancé 3 tentatives par niveau, chacune depuis un état propre sans mémoire des autres, avec données, prompt, outils, limites et évaluateur identiques :
Par niveau
medium
high
Tentatives terminées avec rapport
3 sur 3
2 sur 3
Audits corrects parmi celles-ci
3 sur 3
2 sur 2
Tokens de réflexion par tentative
Environ 7 700
Environ 17 500
Temps par tentative
Environ 5 minutes
Environ 6 minutes
Coût par audit correct, tarif d’introduction
Environ 0,25 $
Environ 0,62 $
Coût par audit correct, tarif standard
Environ 0,51 $
Environ 1,24 $
Les lignes de coût comptent la dépense de chaque tentative, y compris celle qui s’est arrêtée. Chaque tentative aboutie a mené au même verdict et conflit et choisi une paire de canaux acceptée par l’évaluateur ; l’excès de réflexion est donc allé dans des contrôles supplémentaires.
J’ai observé un schéma similaire dans l’expérience de codage Gemini 4 Argon : higha dépensé plus et travaillé davantage pour un gain modeste sur le résultat vérifié. Les tâches diffèrent, donc coûts et taux de succès ne sont pas directement comparables. Dans les deux cas, le contrôle indépendant en dit plus que le total de réflexion.
Pourquoi une tentative en high n’a jamais terminé
La tentative stoppée était la première en high et n’a jamais donné de mauvais verdict. Elle a sondé chaque point de grille de 0,101 à 0,119 puis est partie chercher la borne 70 % de Website, dont rien ne dépendait, et a continué à demander d’autres contrôles jusqu’à heurter la limite de 60 appels fixée plus tôt, l’application l’arrêtant avant la rédaction du rapport.
Une seule tentative a atteint la limite. Image de l’auteur.
Cet arrêt est l’élément utile. Un prompt demandant moins d’appels ne l’aurait pas stoppée ; la limite codée, si. Coût : ~0,22 $.
Les cinq rapports terminés ont aussi passé les autres contrôles Python. Aucun n’a mal lu la configuration actuelle, cité une exigence hors conflit, invoqué un appel d’outil inexistant, ni recommandé une configuration non testée.
Mesurer tokens, temps et coût par audit
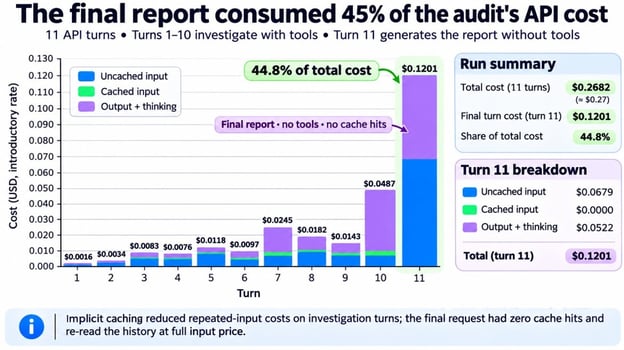
Un audit coûte la somme des usage de chaque tour, tarifés à 2,00 $ par million de tokens d’entrée, 0,10 $ en cache, et 10,00 $ en sortie incluant la réflexion, le tout doublant au 1er décembre 2026. total_input_tokens inclut les tokens mis en cache, donc le code tarifie séparément les deux parties.
Le tour de rapport coûte le plus. Image de l’auteur.
La surprise venait du rapport, ou plus exactement, de sa facture. La mise en cache implicite a couvert environ les trois quarts des tokens d’entrée dans les tours d’enquête, mais la requête de rapport sans outils n’a jamais eu de cache hit.
La cause probable : le fait d’omettre tools change le début de la requête. Quoi qu’il en soit, ce tour a relu tout l’historique plein tarif et représenté environ 40 % du coût de chaque tentative aboutie. Tenez-en compte pour dimensionner votre plafond de dépense.
Limites de l’usage de Gemini 4 Carbon pour auditer des modèles ML
J’ai conçu ce test et généré ses données moi-même, d’où ces limites :
Les données sont synthétiques et proviennent d’un seul classifieur ; j’ai réglé le générateur jusqu’à créer un conflit, avant tout appel à l’API
Le verdict concerne ce classifieur uniquement ; un meilleur modèle pourrait satisfaire les trois règles avec un seul seuil
On peut vérifier un seuil, mais approuver un découpage par canal relève d’un jugement métier et équité
Les interactions sont stockées 55 jours par défaut en palier payant, et store=false interdit previous_interaction_id, donc un agent qui envoie des lignes de transactions nécessite une revue des données
L’évaluateur résout seul le problème de seuil, sans modèle. Si vous ne cherchez qu’un seuil, utilisez un solveur d’optimisation. Ce que Gemini 4 Carbon a apporté, c’est l’audit autour.
Rien ici n’est propre à la fraude. Ce montage convient à tout modèle dont les règles sont mesurables en Python.
Conclusion
Le principal résultat : Gemini 4 Carbon a reconnu que la politique d’origine n’admettait aucun seuil global valide. Les 5 tentatives abouties ont nommé le conflit et proposé un découpage par canal accepté par l’évaluateur ; une tentative en high s’est arrêtée avant de produire un rapport.
Les expériences Gemini 4 Argon et Gemini 4 Carbon testent deux facettes de la fiabilité des agents. L’agent Gemini 4 Argon modifiait du code en préservant le comportement, tandis que l’agent Gemini 4 Carbon aboutissait à une décision sous des règles rendant la réponse initiale impossible. Dans les deux cas : outils étroits, limites de ressources et contrôle hors modèle sont indispensables.
C’est le standard que j’emploierais pour un agent : définir ce que ses outils peuvent établir, vérifier le résultat de façon indépendante et accepter une réponse inconclusivequand les preuves manquent. Ensuite, je passerais deux ou trois classifieurs candidats sous la même politique pour demander lequel, le cas échéant, peut partir en production.
Je suis ingénieur de données et créateur de communautés. Je travaille sur les pipelines de données, le cloud et les outils d'IA, tout en rédigeant des tutoriels pratiques et percutants pour DataCamp et les développeurs émergents.
FAQs
Comment accéder à l’API Gemini 4 Carbon ?⌄
Via un projet payant Google AI Studio ou via Gemini for business sur Google Cloud. L’application Gemini, Antigravity et AI Mode le proposent aussi aux abonnés Google AI Ultra, mais ces apps grand public ne fournissent pas de clé API.
Combien coûte l’API Gemini 4 Carbon ?⌄
Les 6 audits ici ont coûté 2,00 $ au tarif d’introduction. Les requêtes standard comme celles-ci bénéficient d’un cache implicite au-delà de 4 096 tokens d’entrée ; gardez donc le début de chaque requête identique. Flex inference, également pris en charge par Interactions, divise par deux les tarifs tokens en échange de réponses plus lentes et moins fiables.
Quelles sont les limites de débit de l’API Gemini 4 Carbon ?⌄
Les projets payants ont des limites par minute plus un plafond de dépense, de 10 $ par fenêtre glissante de 10 minutes au palier 1 ; au-delà, l’API renvoie 429 RESOURCE_EXHAUSTED. Un audit ici a coûté moins de 1 $, donc seules de nombreuses tentatives parallèles atteindraient la limite. Les plafonds montent avec votre palier, vérifiez la page des limites de débit pour votre projet.
Quelle est la différence entre réflexion medium et high dans Gemini 4 Carbon ?⌄
Gemini 4 Carbon propose trois niveaux : low, medium (par défaut) et high. Je n’ai comparé ici que les deux plus élevés. Pour voir à quoi ressemble la réflexion supplémentaire, réglez thinking_summariessur "auto" et vous obtiendrez des synthèses condensées à côté de chaque réponse. Elles sont désactivées par défaut et peuvent être vides quand le modèle raisonne à peine.
Gemini 4 Carbon peut-il exécuter du code Python ?⌄
Oui. Ajoutez {"type": "code_execution"} à toolset Gemini 4 Carbon peut écrire et exécuter du Python côté Google, facturé à ses tarifs tokens normaux. Je l’ai exclu pour garder le contrôle de mon côté : les trois outils définissent ce qu’il peut mesurer, et les transactions brutes comme le holdout ne quittent jamais ma machine.
Apprenez à utiliser l'API DeepSeek : choix des modèles, gestion des paramètres, optimisation des coûts, mise en cache du contexte et optimisation du chain-of-thought.
Apprenez à utiliser JSON en Python, notamment la sérialisation, la désérialisation, le formatage, l'optimisation des performances, la gestion des API, ainsi que les limites et les alternatives de JSON.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.










Dans notre tutoriel sur l’API Gemini 4 Argon, l’agent avait une mission claire : trouver le code lent, le modifier et réussir des tests cachés. Cette expérience complémentaire reprend le même schéma — outils contrôlés et vérification externe — mais change la décision. Gemini 4 Carbon doit déterminer si les règles d’origine peuvent être satisfaites, ou pas, tout court.
PayGuard, une boutique en ligne fictive, dispose d’un modèle de machine learning (ML) entraîné qui attribue un score de risque de fraude aux commandes. Sa politique de déploiement exige que le modèle capte suffisamment de valeur de fraude, au global et par canal de vente, sans saturer l’équipe de revue. L’agent doit examiner ces règles sans savoir d’emblée si un seuil valide existe.
Gemini 4 Carbon est un modèle de raisonnement Google que vous appelez depuis Python via l’Interactions API. Ici, il agit comme un agent IA : il choisit les vérifications à demander, et Python les exécute via trois outils en lecture seule grâce à l’appel de fonctions. Mon enjeu : peut-il identifier le conflit, exposer les preuves et recommander une modification autorisée sans considérer celle-ci comme déjà approuvée ?
Il vous faut des bases en Python et un peu d’expérience avec les requêtes API. Je définis chaque métrique de fraude avant son utilisation dans les chiffres. Nous verrons comment :
Pour le récit du lancement et les scores de benchmarks, consultez notre aperçu de Gemini 4 Carbon et notre comparaison Claude Fable 5.2 vs. Gemini 4 Carbon. J’ai mené cette expérience le lendemain de l’ouverture de l’API aux développeurs payants par Google.
Qu’est-ce que l’API Gemini 4 Carbon ?
L’API Gemini 4 Carbon est l’interface de programmation applicative (API) payante de
gemini-4-carbon, que la page modèle décrit comme un modèle de raisonnement pour des tâches d’agent longues et multi-étapes. Entrée, réflexion et sortie partagent une fenêtre de contexte d’1 048 576 tokens, et une réponse synchrone s’arrête par défaut à 65 536 tokens de réflexion plus sortie.Pourquoi l’audit d’un modèle ML est un bon test pour Gemini 4 Carbon
La tâche exige plusieurs vérifications, une recherche parmi les changements autorisés et un arrêt net quand les règles ne laissent aucune réponse. Je l’ai choisie car Python peut calculer le résultat de référence. La fiche modèle liste les hallucinations parmi les limites connues de Gemini 4 Carbon, donc le modèle enquête tandis que Python tranche si sa recommandation tient.
Le projet : décider si le modèle de fraude de PayGuard peut être mis en production
PayGuard est la boutique fictive de l’introduction, et le projet complet se trouve dans le référentiel GitHub. Son classifieur est déjà entraîné.
Comment PayGuard note les transactions
Chaque transaction possède un horodatage UTC, un montant, un canal (Website ou Mobile App), un score de risque et une étiquette fraude. Un
HistGradientBoostingClassifierde scikit-learn produit le score, arrondi à 0,001, et PayGuard signale une transaction lorsquerisk_score >= threshold. Notre tutoriel sur la courbe précision-rappel montre comment déplacer un seuil change ce qui est signalé, et notre cours Fraud Detection in Python couvre l’aspect modélisation.Les données synthétiques sont découpées dans le temps :
Le seuil actuel est 0,5, et les données comme la politique ne changent jamais pendant l’expérience. La fraude Website laisse des signaux nets dans ces données, tandis que la plupart des fraudes Mobile App ressemblent à une commande ordinaire.
Gemini 4 Carbon pose les questions, Python tranche. Image de l’auteur.
Les trois règles de déploiement de PayGuard
Voici les trois règles de l’intro, écrites comme dans la politique. Ce sont des objectifs fictifs choisis pour cette expérience :
Le rappel en valeur de fraude est la valeur de fraude signalée divisée par la valeur totale de fraude. Contrairement au rappel au niveau transaction dans notre guide précision vs rappel, une fraude de 2 000 $ manquée pèse bien plus qu’une de 15 $, et signaler ne signifie pas que l’argent a été sauvé. R3 borne la journée la plus chargée, et ce libellé finit par décider l’audit.
L’agent peut étudier deux modifications : une capacité quotidienne jusqu’à 260 avec un seuil unique, ou des seuils distincts par canal au plafond d’origine. Les deux exigent une approbation humaine, ne peuvent pas être combinées, et la politique privilégie l’option sans renforts supplémentaires en revue.
Ce qui définit un audit correct
Un audit correct coche quatre points, à décider avant la première requête :
Un évaluateur hors de portée de l’agent calcule la réponse.
Comment configurer l’API Gemini 4 Carbon en Python
La configuration de l’API Gemini 4 Carbon nécessite Python 3.11 ou plus et une clé API d’un projet Google AI Studio avec facturation active, puisque la page des tarifs n’annonce pas de palier gratuit.
Installer le SDK Google Gen AI et préparer le projet
J’ai testé ce projet avec le kit de développement logiciel (SDK) Google Gen AI figé à
google-genai==3.1.0, la version de lancement sur PyPI qui a ajoutégemini-4-carbonà la liste des modèles Interactions. Clonez le projet et installez-le dans un environnement virtuel :Ensuite, exécutez les deux commandes de la page du dépôt qui génèrent les données et ajustent le classifieur avec des graines fixes. Sur un clone neuf, elles affichent ceci :
Des graines fixes reconstruisent le même jeu de données. Image de l’auteur.
Placez ensuite
GEMINI_API_KEY=your-keydans un fichier.env. Le dépôt le charge sans l’afficher.Envoyer votre première requête à l’API Gemini 4 Carbon
Exécutez cet exemple complet depuis le dossier du projet. Il donne à Gemini 4 Carbon la politique et le résumé du classifieur et demande ce qu’il aurait besoin de mesurer, sans suggérer de conflit :
Le niveau de réflexion se règle dans
generation_config, etoutput_textcontient la réponse. Voici un extrait de la sortie :Il a interprété R3 comme un pic et planifié l’ordre de préférence de la politique avant de voir un seul chiffre. Il n’a toutefois jamais demandé comment gérer les ex æquo ou l’arrondi des scores, alors que le contrôle exhaustif que je montrerai plus loin en dépend précisément. L’appel a pris environ 40 secondes et coûté environ 2 cents.
N’indiquez pas
temperature,top_pnitop_k, ignorés par Gemini 4 Carbon, nithinking_budget.Construire un agent d’audit ML avec l’appel de fonctions de Gemini 4 Carbon
Un agent d’audit Gemini 4 Carbon fonctionne en boucle : le modèle demande une évaluation, Python la valide et l’exécute, puis renvoie le résultat jusqu’à ce que le modèle cesse de demander.
Définir des outils en lecture seule pour évaluer le modèle
L’agent dispose de trois outils, tous limités à la fenêtre de validation :
get_audit_context: résumé du classifieur, configuration actuelle, politique et changements autorisésevaluate_global_threshold: rappel en valeur de fraude au global et par canal, signaux par jour et diagnostics pour un seuilevaluate_policy_change: les mêmes mesures pour une hausse de capacité ou une paire de seuils par canalLes schémas complets sont dans le dépôt. Cet extrait simplifié omet les champs de seuil et de capacité ; ce n’est donc pas une déclaration complète à copier. Il montre seulement la frontière utile ici : l’outil accepte les deux changements de politique autorisés par PayGuard, lit les données de validation, et n’approuve rien.
Python valide les champs de seuil et de capacité omis, rejette les changements hors politique et renvoie des mesures, pas des drapeaux réussite/échec. L’agent ne peut pas atteindre le holdout, appeler l’évaluateur ni modifier la politique. J’explique dans la FAQ pourquoi j’ai écarté l’exécution de code intégrée de Gemini 4 Carbon.
Donner à l’agent un objectif clair et des règles d’arrêt
L’instruction système définit la méthode. Comme la première requête, elle ne donne aucun indice sur l’emplacement du conflit :
Le prompt ne peut que demander ; les limites résident dans le harness d’agent, le code Python autour du modèle. Comme l’API n’a pas de budget intégré, l’application fixe ces limites par tentative : 25 tours, 60 appels d’outils, 30 minutes et 3 $, avec contrôle des dépenses entre les tours.
Implémenter la boucle d’appel de fonctions avec l’Interactions API
Chaque tour correspond à un appel
client.interactions.create(). Gemini 4 Carbon demande souvent plusieurs outils en même temps, donc la boucle traite chaque étapefunction_call. Voici le cœur de la boucle ; la version du dépôt ajoute des logs et des contrôles de limites :Je regroupe ces paramètres dans un seul dict
requestpour les renvoyer à chaque relance.previous_interaction_idtransporte l’historique, maistools,system_instructionetgeneration_configs’appliquent à une seule interaction. Si un tour finitincomplete,max_output_tokensl’a coupé, et vous payez quand même les tokens de réflexion.Retourner un rapport d’audit structuré avec un schéma JSON
Le guide des sorties structurées de Google liste outils et schéma JSON dans une même requête comme une fonctionnalité Preview prenant en charge Gemini 4 Carbon. J’ai tout de même séparé : les tours d’enquête ne font que mesurer, et un tour final, sur le même historique et la même config, rédige le rapport avec un schéma et sans outils :
AuditReportest un modèle Pydantic avec le verdict, le conflit, les preuves, la recommandation et les validations. Python mesure le temps et le coût au lieu de demander à Gemini 4 Carbon de les rapporter.Exécuter l’audit Gemini 4 Carbon sur le modèle de détection de fraude
Gemini 4 Carbon a audité le modèle comme je l’attendrais d’un analyste junior : des mesures d’abord, les conclusions ensuite. À la première tentative en niveau
medium, il a lu le contexte d’audit, vérifié une bonne vingtaine de seuils uniques et testé huit modifications de politique.Les 32 appels d’outils, dans l’ordre. Image de l’auteur.
Évaluer le seuil actuel de PayGuard
L’agent a évalué le seuil actuel de 0,5 et trouvé 91 % de rappel Website, 20 % Mobile App, 64 % au global, et 85 signalements le jour le plus chargé. Cela échoue à R1 et à la partie Mobile App de R2, avec de la marge sous R3 ; la piste évidente est donc d’abaisser le seuil.
Tester le rappel en valeur de fraude face à la capacité quotidienne de revue
Abaisser un seuil capte plus de valeur de fraude et envoie plus de commandes en revue. PayGuard doit obtenir assez du premier tout en gardant le second sous un plafond quotidien.
L’agent a tenté quelques seuils grossiers en un lot, puis s’est resserré sur des points de grille précis. Les appels 11, 12, 17 et 18 du traçage ont tranché.
Sur cette fenêtre de validation, le plancher Mobile App exige 0,108 ou moins, car un cran au-dessus le fait passer juste sous 70 %. Le plafond de charge impose 0,118 ou plus. Aucun seuil ne satisfait les deux.
Le rappel global tient jusqu’à 0,137, donc R1 reste hors conflit. À 0,108, la journée moyenne compte environ 169 signalements, et seul un samedi dépasse. C’est pourquoi la politique borne la charge de la journée la plus chargée plutôt que la moyenne.
Le rappel Mobile et la capacité ne se recouvrent jamais. Image de l’auteur.
Contrôler la performance sur les deux canaux de paiement
La fraude Mobile App, aux signaux plus faibles, se situe bas dans l’échelle des scores. Tirer un seuil unique vers 0,108 pour Mobile App fait aussi remonter davantage de commandes Website légitimes, et ce samedi-là, elles font franchir le plafond total.
Le total le masque : à 0,118, le rappel global est d’environ 87 % alors que Mobile App reste sous son plancher. Si votre politique cite des segments, mesurez chacun ; le total peut réussir tandis qu’un segment échoue.
Gemini 4 Carbon peut-il détecter des exigences de déploiement contradictoires ?
Oui, dans cet audit. Le rapport figé indique
not deployable, précise qu’aucun seuil unique ne fonctionne et cite R2 pour Mobile App et R3 comme conflit.Vérifier le verdict de déploiement de Gemini 4 Carbon par rapport à ses preuves
Chaque chiffre cité dans le rapport correspond à un résultat d’outil, mais une phrase dépasse ce que l’agent a mesuré. Elle affirme qu’aucun seuil ne marche « sur tous les points de grille à 0,001 », alors que l’agent n’a testé que les deux douzaines du traçage ci-dessus, sur 1 002 seuils possibles.
L’affirmation tient car le rappel et les volumes quotidiens baissent tous deux quand le seuil monte, ce que le rapport ne précise jamais. Contrôlez chaque allégation d’un rapport d’agent par rapport à ce qui a été mesuré ; notre guide évaluer des agents IA couvre d’autres vérifications de ce type.
Confirmer le conflit avec un évaluateur Python exhaustif
Gemini 4 Carbon a échantillonné des seuils et inféré qu’aucun ne pouvait marcher. L’évaluateur prouve ce résultat pour cet ensemble de validation en vérifiant chaque ensemble de signalements distinct, sans partager de code avec les outils.
Les scores sont sur une grille de 0,001, donc 1 002 coupures candidates couvrent tous les ensembles possibles de signalements. L’évaluateur les vérifie tous, plus chaque paire de seuils par canal, en cents entiers pour que 85 % et 70 % soient exacts.
Contrôle exhaustif et quatre configurations rejetées. Image de l’auteur.
Aucun seuil global ne passe les trois règles ; l’affirmation de Gemini 4 Carbon a donc désormais une preuve. L’évaluateur a retrouvé les bornes 0,108 et 0,118 déduites par l’agent et a identifié des milliers de paires par canal qui passent à 200 par jour.
Un évaluateur n’est utile que s’il rejette les mauvaises réponses, donc je lui ai soumis quatre configurations erronées ; il a rejeté les quatre.
Tester des alternatives de déploiement avec Gemini 4 Carbon
Gemini 4 Carbon a testé les deux changements autorisés et préféré des seuils séparés au plafond d’origine plutôt que des réviseurs supplémentaires. Il a signalé ce choix comme une exception nécessitant une approbation humaine.
Tester une hausse de la capacité de revue manuelle
Un seuil global fonctionne si le plafond passe de 200 à 205, et l’évaluateur a confirmé 205 comme la plus petite hausse. Gemini 4 Carbon a tout de même classé cette option en second, en raison de la règle de préférence mentionnée plus haut.
Tester des seuils séparés par canal de paiement
Côté canaux, l’agent a maintenu le seuil Mobile App près de sa limite (il avait déjà vu 0,109 casser le plancher) et relevé le seuil Website, réduisant les signalements de commandes Website légitimes. Il a testé sept paires, dont une a échoué à un seul signalement le jour le plus chargé. Il a recommandé Website 0,3 et Mobile App 0,1 car cette paire respecte chaque règle avec de la marge, et l’évaluateur l’a confirmée au plafond d’origine.
Comparer les alternatives vérifiées
Ces chiffres ont déjà été mentionnés, et l’évaluateur a tout recomputé :
Option
Seuils
Global
Website
Mobile App
Jour le plus chargé
Approbation
Politique d’origine
Global 0,108
87,5 %
98,2 %
70,1 %
205, plafond 200
Échec
Plus de capacité
Global 0,108
87,5 %
98,2 %
70,1 %
205, plafond 205
Nécessaire
Découpage par canal
Website 0,3, Mobile App 0,1
86,2 %
94,5 %
72,8 %
191, plafond 200
Nécessaire
Le découpage par canal signale aussi environ 6 % de transactions en moins que l’option capacité. Moins de la moitié de ses signalements sont de la fraude, cependant, ce que le rapport a listé comme point ouvert.
Comment vérifier la recommandation de Gemini 4 Carbon sur des données inédites
Vous vérifiez la recommandation en l’appliquant, gelée, au holdout scellé. La différence avec l’évaluateur, ce sont les données : l’évaluateur a scoré des semaines visibles par l’agent, et le holdout couvre quatre semaines ultérieures qu’aucun outil n’a pu lire. Le contrôle s’exécute une fois par recommandation gelée et ne démarre pas si le rapport a changé après la gelée.
La recommandation figée passe sur holdout. Image de l’auteur.
Elle a respecté les trois règles, et le jour le plus chargé est resté sous le plafond. N’en tirez pas trop de conclusions pour autant. Trois éléments relativisent ce résultat :
Les deux premiers points découlent des chiffres.
Visionner l’audit complet dans Streamlit
Le dépôt inclut aussi une application Streamlit et six tentatives enregistrées, pour ouvrir cet audit sans appel d’API. Dans la vidéo, je la charge et parcours chaque onglet.