Tutorial da Gemini 4 Carbon API: crie um agente que audita um modelo de fraude
Aprenda a Gemini 4 Carbon API em Python: construa um agente com function calling que audita um modelo de fraude, encontra regras conflitantes e testa uma mudança de política.
No nosso tutorial da Gemini 4 Argon API, o agente tinha uma missão clara: encontrar código lento, corrigir e passar em testes ocultos. Este experimento complementar mantém o mesmo padrão de ferramentas controladas e validação externa, mas muda a decisão. A Gemini 4 Carbon precisa determinar se as regras originais podem ser atendidas — ou se são incompatíveis entre si.
A PayGuard, uma loja online fictícia, possui um modelo de machine learning (ML) treinado para pontuar pedidos com risco de fraude. A política de implantação exige que o modelo capture valor de fraude suficiente no geral e em cada canal de vendas, sem sobrecarregar o time de revisão. O agente deve investigar essas regras sem receber a resposta de antemão sobre a existência de um limiar válido.
A Gemini 4 Carbon é um modelo de raciocínio da Google que você chama em Python via Interactions API. Aqui, ela atua como um agente de IA: escolhe quais verificações solicitar, e o Python as executa por meio de três ferramentas somente leitura usando function calling. Minha pergunta é se ela consegue identificar o conflito, explicar as evidências e recomendar uma mudança permitida — sem tratar essa mudança como já aprovada.
Você vai precisar de Python básico e um pouco de experiência com requisições de API. Eu defino cada métrica de fraude antes de os números aparecerem. Vamos ver como:
Enviar a primeira requisição para a Gemini 4 Carbon a partir do Python
Fornecer ferramentas somente leitura ao modelo e executá-las em loop com limites
Receber o veredito em JSON para o seu código checar
Verificar esse veredito com código e dados que o modelo nunca vê
Comparar dois níveis de raciocínio, que controlam quanto o modelo pensa antes de responder
Se você quiser a história do lançamento e benchmarks, nosso overview da Gemini 4 Carbon traz tudo isso, e nossa análise Claude Fable 5.2 vs. Gemini 4 Carbon compara os dois modelos. Eu rodei este experimento no dia seguinte à abertura da API para desenvolvedores pagantes.
O que é a Gemini 4 Carbon API?
A Gemini 4 Carbon API é a interface paga de programação de aplicativos (API) para gemini-4-carbon, que a página do modelo descreve como um modelo de raciocínio para tarefas longas e multi-etapas de agentes. Entrada, raciocínio e saída compartilham uma janela de contexto de 1.048.576 tokens, e uma resposta síncrona para por padrão em 65.536 tokens somando raciocínio e saída.
Por que uma auditoria de modelo de ML é um bom teste para a Gemini 4 Carbon
A tarefa exige várias verificações, uma busca por mudanças permitidas e uma parada clara quando as regras não deixam resposta. Eu a escolhi porque o Python consegue calcular o resultado de referência. O model card lista alucinações entre os limites conhecidos da Gemini 4 Carbon, então o modelo investiga enquanto o Python decide se a recomendação se sustenta.
O projeto: decidir se o modelo de fraude da PayGuard pode ir para produção
PayGuard é a loja fictícia da introdução, e o projeto completo está no repositório no GitHub. Seu classificador já está treinado.
Como a PayGuard pontua transações
Cada transação tem um carimbo de data/hora em UTC, um valor, um canal (Website ou Mobile App), um score de risco e um rótulo de fraude. Um HistGradientBoostingClassifier do scikit-learn produz o score, arredondado para 0,001, e a PayGuard sinaliza uma transação quando risk_score >= threshold. Nosso tutorial de curva precisão-recall mostra como mover o limiar muda o que é sinalizado, e nosso curso de Fraud Detection in Python cobre o lado de modelagem.
Os dados sintéticos são separados por tempo:
Treino: as nove primeiras semanas, usadas apenas para ajustar o classificador
Validação: as quatro semanas seguintes, a única janela que as ferramentas podem ler
Holdout: as quatro semanas posteriores, lacradas até a recomendação ser congelada
O limiar atual é 0,5, e os dados e a política nunca mudam durante o experimento. Fraudes no Website deixam sinais claros nestes dados, enquanto a maioria das fraudes no Mobile App se parece com um pedido comum.
A Gemini 4 Carbon pergunta, o Python decide. Imagem do autor.
As três regras de implantação da PayGuard
Aqui estão as três regras da introdução, escritas como na política. Todos os alvos são fictícios, definidos para este experimento:
R1: as transações sinalizadas cobrem pelo menos 85% do valor rotulado de fraude no geral
R2: elas cobrem pelo menos 70% do valor rotulado de fraude dentro de cada canal
R3: no máximo 200 transações são sinalizadas em qualquer dia UTC
O recall por valor de fraude é o valor de fraudes sinalizadas dividido pelo valor total de fraudes. Diferente do recall por transação no nosso guia de precisão versus recall, uma fraude de US$ 2.000 perdida pesa muito mais do que uma de US$ 15, e sinalizar não significa que o dinheiro foi recuperado. A R3 limita o dia mais movimentado, e essa redação acaba decidindo a auditoria.
O agente pode investigar duas mudanças: uma capacidade diária de até 260 com um único limiar, ou limiares separados por canal mantendo o teto original. Ambas precisam de aprovação humana, não podem ser combinadas e a política prefere a opção sem revisores extras.
O que conta como uma auditoria correta
Uma auditoria correta acerta quatro pontos — e você deve defini-los antes da primeira requisição:
O veredito: se algum limiar único atende R1, R2 e R3 na validação
O conflito: quais requisitos tornam a política original impossível
A alternativa: uma mudança permitida que passa em todas as regras quando o Python a recalcula
A preferência: a recomendação segue a ordem de preferência da política
Um avaliador que o agente não pode chamar computa a resposta.
Como configurar a Gemini 4 Carbon API em Python
A configuração da Gemini 4 Carbon API exige Python 3.11 ou mais recente e uma chave de API de um projeto no Google AI Studio com billing ativo, já que a página de preços não lista camada gratuita.
Instale o SDK Google Gen AI e prepare o projeto
Testei este projeto com o SDK Google Gen AI fixado em google-genai==3.1.0, o release no PyPI do dia do lançamento que adicionou gemini-4-carbon à lista de modelos do Interactions. Clone o projeto e instale em um ambiente virtual:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS ou Linux: source .venv/bin/activate
pip install-r requirements.txtTecnologia
Depois, rode os dois comandos na página do repositório que constroem os dados e ajustam o classificador com seeds fixas. Em um clone novo, eles imprimem isto:
Seeds fixas recriam o mesmo dataset. Imagem do autor.
Depois, coloque GEMINI_API_KEY=your-key em um arquivo .env. O repositório carrega sem imprimir a chave.
Faça sua primeira requisição à Gemini 4 Carbon API
Execute este exemplo completo na pasta do projeto. Ele fornece à Gemini 4 Carbon a política e o resumo do classificador e pergunta o que seria necessário medir, sem sugerir qualquer conflito:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # texto da política do projeto, limiar e limites
os.environ.pop("GOOGLE_API_KEY",None)# teria precedência sobre GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Tecnologia
O nível de raciocínio vai em generation_config, e output_text contém a resposta. Aqui está parte do que voltou:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Tecnologia
Ela leu a R3 como pico e planejou a ordem de preferência da política antes de ver qualquer número. Porém, não perguntou como funcionam empates ou arredondamento de score, e a checagem exaustiva que mostrarei depois depende justamente disso. A chamada levou cerca de 40 segundos e custou por volta de 2 centavos.
Deixe de fora temperature, top_p e top_k, que a Gemini 4 Carbon ignora, e também thinking_budget.
Como construir um agente de auditoria de ML com function calling da Gemini 4 Carbon
Um agente de auditoria com a Gemini 4 Carbon é um loop: o modelo solicita uma avaliação, o Python valida e executa, e o resultado volta até o modelo parar de pedir.
Defina ferramentas somente leitura para avaliar o modelo
O agente recebe três ferramentas, todas limitadas à janela de validação:
get_audit_context: resumo do classificador, configuração atual, política e mudanças permitidas
evaluate_global_threshold: recall por valor de fraude no geral e por canal, sinalizações por dia e diagnósticos para um limiar
evaluate_policy_change: as mesmas medições para aumento de capacidade ou um par de limiares por canal
Os esquemas completos estão no repositório. Este trecho simplificado omite os campos de limiar e capacidade, então não é uma declaração completa para copiar. Ele só mostra a fronteira que importa aqui: a ferramenta aceita as duas mudanças de política permitidas pela PayGuard, lê dados de validação e não aprova nada.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Tecnologia
O Python valida os campos omitidos de limiar e capacidade, rejeita mudanças fora da política e retorna medições em vez de flags de aprovado/reprovado. O agente não alcança o holdout, não chama o avaliador e não muda a política. Explico nas FAQs por que deixei de fora a execução de código embutida na Gemini 4 Carbon.
Dê ao agente um objetivo claro e regras de parada
A instrução de sistema define o método. Como na primeira requisição, ela não indica onde está o conflito:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.Tecnologia
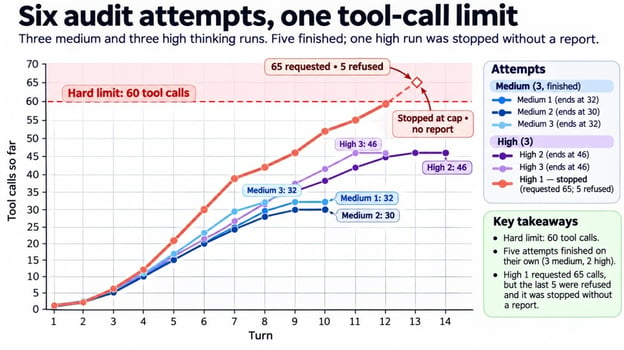
O prompt só pode pedir; então os limites vivem no agent harness, o código Python em volta do modelo. Como a API não tem configuração de budget, o app define por tentativa: 25 turnos, 60 chamadas de ferramenta, 30 minutos e US$ 3, com o gasto checado entre os turnos.
Implemente o loop de function calling com a Interactions API
Cada turno é uma chamada client.interactions.create(). A Gemini 4 Carbon costuma solicitar várias ferramentas de uma vez, então o loop roda a cada etapa de function_call. Este é o loop central; a versão no repositório adiciona logs e checagens de limite:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Tecnologia
Eu mantenho essas configurações em um único dict request para que cada chamada subsequente as reenvie. previous_interaction_id carrega o histórico, mas tools, system_instruction e generation_config valem para uma interação apenas. Se um turno termina como incomplete, max_output_tokens o cortou — e você ainda paga pelos tokens de raciocínio.
Retorne um relatório estruturado de auditoria com um esquema JSON
O guia de output estruturado do Google lista ferramentas mais um esquema JSON em uma única requisição como um recurso Preview que inclui a Gemini 4 Carbon. Eu mantive separados: os turnos de investigação apenas medem, e um turno final, com o mesmo histórico e config, escreve o relatório com um esquema e sem ferramentas:
AuditReport é um modelo Pydantic com o veredito, conflito, evidências, recomendação e aprovações. O Python mede tempo e custo em vez de pedir para a Gemini 4 Carbon reportá-los.
Rode a auditoria da Gemini 4 Carbon no modelo de detecção de fraude
A Gemini 4 Carbon auditou o modelo como eu esperaria de um analista júnior: medições antes de qualquer conclusão. Na primeira tentativa em medium, ela leu o contexto da auditoria, checou cerca de duas dezenas de limiares únicos e testou oito mudanças de política.
Todas as 32 chamadas de ferramenta, em ordem. Imagem do autor.
Avalie o limiar atual da PayGuard
O agente avaliou o limiar atual de 0,5 e encontrou 91% de recall no Website, 20% no Mobile App, 64% no geral e 85 sinalizações no dia mais movimentado. Isso falha a R1 e a metade do R2 para Mobile App, com folga na R3 — então o movimento óbvio é reduzir o limiar.
Teste o recall por valor de fraude vs. capacidade diária de revisão
Reduzir um limiar captura mais valor de fraude e envia mais pedidos para revisão. A PayGuard precisa do suficiente do primeiro mantendo o segundo abaixo de um teto diário.
O agente tentou alguns limiares mais grossos em um lote, depois afinou para pontos específicos da grade. As chamadas 11, 12, 17 e 18 na trilha resolveram.
Nesta janela de validação, o piso do Mobile App exige 0,108 ou menos, porque um passo acima derruba para pouco abaixo de 70%. O teto exige 0,118 ou mais. Nenhum limiar faz os dois.
O recall geral se sustenta até 0,137, então a R1 fica fora do conflito. Em 0,108, o dia médio tem cerca de 169 sinalizações, e só um sábado passa do limite. É por isso que a política usa a carga do dia mais movimentado e não a média diária.
Recall no Mobile e capacidade não se sobrepõem. Imagem do autor.
Cheque o desempenho nos dois canais de pagamento
A fraude no Mobile App, com sinais mais fracos, fica na parte baixa da faixa de scores. Puxar um único limiar para 0,108 para o Mobile App também traz mais pedidos legítimos do Website e, naquele sábado, eles empurram o total acima do teto.
O número geral esconde isso: em 0,118, o recall geral é ~87% enquanto o Mobile App fica abaixo do piso. Se sua política nomeia segmentos, meça cada um, porque o total pode passar enquanto um segmento falha.
A Gemini 4 Carbon consegue detectar requisitos de implantação conflitantes?
Sim, nesta auditoria. O relatório congelado diz not deployable, afirma que nenhum limiar único funciona e nomeia R2 para Mobile App e R3 como o conflito.
Cheque o veredito de implantação vs. as evidências da Gemini 4 Carbon
Cada número citado no relatório bate com um resultado de ferramenta, mas uma frase afirma mais do que o agente mediu. Ela diz que nenhum limiar funciona "em todos os pontos da grade de 0,001 do risk score", mas o agente testou só duas dezenas, de 1.002 possíveis.
A afirmação se sustenta porque recall e contagens diárias caem conforme o limiar sobe — algo que o relatório não menciona. Verifique cada alegação de um agente contra o que ele mediu; nosso guia de avaliação de agentes de IA cobre mais checagens desse tipo.
Verifique o conflito com um avaliador exaustivo em Python
A Gemini 4 Carbon amostrou limiares e inferiu que nenhum funcionaria. O avaliador comprova o resultado para este conjunto de validação checando todo conjunto distinto de sinalizações, sem compartilhar código com as ferramentas.
Os scores estão em uma grade de 0,001, então os 1.002 cortes candidatos cobrem todo conjunto de sinalizações possível. O avaliador checa todos eles e todos os pares de limiares por canal, usando centavos inteiros para que 85% e 70% fiquem exatos.
Checagem exaustiva e quatro configurações rejeitadas. Imagem do autor.
Nenhum limiar global passa nas três regras, então a afirmação da Gemini 4 Carbon agora tem prova. O avaliador bateu as fronteiras 0,108 e 0,118 encontradas pelo agente e achou milhares de pares por canal que passam com 200 por dia.
Um avaliador só ajuda se rejeita respostas ruins, então eu o alimentei com quatro configurações erradas — e ele rejeitou todas.
Teste alternativas de implantação com a Gemini 4 Carbon
A Gemini 4 Carbon testou as duas mudanças permitidas e escolheu limiares separados mantendo o teto original, em vez de revisores extras. Ela marcou essa escolha como exceção que precisa de aprovação humana.
Teste um aumento na capacidade de revisão manual
Um limiar global funciona se o teto subir de 200 para 205, e o avaliador confirmou 205 como o menor aumento. Ainda assim, a Gemini 4 Carbon ranqueou essa opção em segundo, por causa da regra de preferência que descrevi.
Teste limiares separados por canal de pagamento
Do lado dos canais, o agente manteve o limiar do Mobile App próximo ao limite (ele já tinha visto 0,109 quebrar o piso) e elevou o limiar do Website, reduzindo sinalizações em pedidos legítimos do Website. Ele testou sete pares; um falhou por uma única sinalização no dia mais movimentado. Recomendou Website 0,3 e Mobile App 0,1 porque esse par cumpre todas as regras com margem, e o avaliador confirmou no teto original.
Compare as alternativas verificadas
Estes números já apareceram acima, e o avaliador recalculou cada um:
Opção
Limiar(es)
Geral
Website
Mobile App
Dia mais cheio
Aprovação
Política original
Global 0,108
87,5%
98,2%
70,1%
205, teto 200
Falha
Mais capacidade
Global 0,108
87,5%
98,2%
70,1%
205, teto 205
Precisa
Divisão por canal
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, teto 200
Precisa
A divisão por canal também sinaliza cerca de 6% menos transações do que a opção de capacidade. Porém, menos da metade das sinalizações são fraudes, o que o relatório listou como ponto em aberto.
Como verificar a recomendação da Gemini 4 Carbon em dados não vistos
Você verifica a recomendação aplicando-a, congelada, ao holdout lacrado. A diferença para o avaliador está nos dados: o avaliador pontuou semanas que o agente podia ver; o holdout pontua quatro semanas posteriores que nenhuma ferramenta pôde ler. A checagem roda uma vez por recomendação congelada e não começa se o relatório mudou depois de congelar.
A recomendação congelada passa no holdout. Imagem do autor.
Ela passou nas três regras, e o dia mais movimentado ficou abaixo do teto. Mas não superestime isso. Três pontos deixam o resultado modesto:
O holdout vem do mesmo gerador, então não diz nada sobre novos tipos de fraude ou deriva de dados
O recall geral passou de 85% por menos de dois pontos
Meu palpite não testado: a divisão pode estourar o teto se o tráfego do Mobile App crescer mais rápido que o do Website, porque o limiar do Mobile App está muito baixo
Os dois primeiros vêm dos próprios números.
Veja a auditoria completa no Streamlit
O repositório também inclui um app em Streamlit e as seis tentativas gravadas, para você abrir esta auditoria sem chamada à API. No vídeo, eu carrego e passo por cada aba.
O app em Streamlit mostra uma auditoria. Vídeo do autor.
Gemini 4 Carbon: thinking médio vs. alto — acurácia, tempo e custo
Sucesso aqui significa terminar dentro dos limites do app e retornar um relatório que o avaliador aceita. Uma tentativa interrompida não tem veredito para pontuar. Por essa definição, medium terminou todas as tentativas e custou menos da metade por auditoria correta.
Seis tentativas são poucas para generalizar. Se níveis de raciocínio são novidade para você, nosso tutorial da Gemini 3.8 Flash API explica thinking_level em mais detalhe.
Compare thinking médio e alto na mesma auditoria
Esta é a comparação completa por trás do TL;DR. Rodei 3 tentativas por nível, cada uma de um estado limpo, sem memória das outras, com dados, prompt, ferramentas, limites e avaliador idênticos:
Por nível
medium
high
Tentativas que finalizaram com relatório
3 de 3
2 de 3
Auditorias corretas entre elas
3 de 3
2 de 2
Tokens de raciocínio por tentativa
~7.700
~17.500
Tempo por tentativa
~5 minutos
~6 minutos
Custo por auditoria correta, preço introdutório
~US$ 0,25
~US$ 0,62
Custo por auditoria correta, preço padrão
~US$ 0,51
~US$ 1,24
As linhas de custo contam o gasto de toda tentativa, inclusive a que parou. Toda tentativa concluída chegou ao mesmo veredito e conflito e escolheu um par de canais aceito pelo avaliador — então o raciocínio extra foi para mais checagens.
Vi padrão parecido no experimento de código com a Gemini 4 Argon: highgastou mais e fez mais trabalho por uma mudança pequena no resultado verificado. As tarefas são diferentes, então custos e taxas de sucesso não são diretamente comparáveis. Nos dois casos, a verificação independente fala mais do que o total de raciocínio.
Por que uma tentativa com thinking alto não terminou
A tentativa que parou foi a primeira de high — e ela nunca deu veredito errado. Ela sondou cada ponto da grade de 0,101 a 0,119 e depois foi caçar a fronteira de 70% do Website, da qual nada dependia, e continuou pedindo mais checagens até bater o limite de 60 chamadas que defini antes; o app interrompeu antes de escrever um relatório.
Só uma tentativa bateu no limite. Imagem do autor.
Essa parada é a parte útil. Um prompt pedindo menos chamadas não teria encerrado; o limite em código sim, após ~US$ 0,22.
Os cinco relatórios concluídos também passaram nas outras checagens em Python. Nenhum leu errado a configuração atual, nomeou requisito fora do conflito, citou chamada inexistente ou recomendou configuração não testada.
Meça tokens, tempo e custo por auditoria
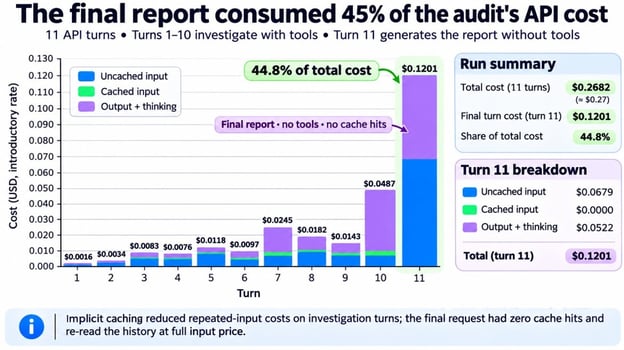
Uma auditoria custa a soma do usage de cada turno, precificado a US$ 2,00 por milhão de tokens de entrada, US$ 0,10 em cache e US$ 10,00 de saída incluindo raciocínio — tudo dobrando em 1º de dezembro de 2026. total_input_tokens inclui tokens em cache, então o código precifica as duas partes separadamente.
O turno do relatório custa mais. Imagem do autor.
A surpresa foi o relatório — ou melhor, sua fatura. O cache implícito cobriu cerca de três quartos dos tokens de entrada nos turnos de investigação, mas a requisição do relatório sem ferramentas nunca aproveitou cache.
A causa provável é que remover tools muda o início da requisição. De qualquer forma, aquele turno releu todo o histórico a preço cheio e levou cerca de 40% do custo de cada tentativa concluída. Conte esse turno ao definir o limite de gasto.
Limitações do uso da Gemini 4 Carbon para auditar modelos de ML
Eu projetei este teste e gerei os dados, então os resultados têm estes limites:
Os dados são sintéticos e vêm de um classificador; ajustei o gerador até existir conflito — antes de qualquer chamada à API
O veredito cobre só este classificador; um melhor pode atender as três regras com um único limiar
Um limiar pode ser verificado, mas aprovar divisão por canal é decisão de negócio e equidade
Interações ficam armazenadas por 55 dias na camada paga por padrão, e store=false impede previous_interaction_id, então um agente que envia linhas de transação precisa de revisão de dados
O avaliador resolve o problema do limiar sozinho, sem modelo algum. Se tudo o que você precisa é um limiar, use um solver de otimização. O que a Gemini 4 Carbon adicionou foi a auditoria ao redor.
Nada aqui é exclusivo de fraude. A configuração serve para qualquer modelo cujas regras o Python consegue medir.
Considerações finais
O principal resultado é que a Gemini 4 Carbon reconheceu que a política original não tinha limiar global válido. Todas as 5 tentativas concluídas nomearam o conflito e propuseram divisão por canal aceita pelo avaliador; uma tentativa em high parou antes de produzir relatório.
Os experimentos com Gemini 4 Argon e Gemini 4 Carbon testam dois lados da confiabilidade de agentes. O agente da Argon alterou código e precisava preservar o comportamento; o agente da Carbon chegou a uma decisão sob regras que tornavam impossível a resposta original. Ambos exigiram ferramentas estreitas, limites de recursos e uma validação fora do modelo.
Esse é o padrão que eu usaria para um agente: defina o que suas ferramentas podem comprovar, verifique o resultado de forma independente e aceite uma resposta inconclusivequando as evidências acabarem. Depois, eu colocaria dois ou três classificadores candidatos sob a mesma política e perguntaria qual deles, se algum, pode ir a produção.
Sou engenheiro de dados e criador de comunidades que trabalha com pipelines de dados, nuvem e ferramentas de IA, além de escrever tutoriais práticos e de alto impacto para o DataCamp e desenvolvedores iniciantes.
FAQs
Como faço para obter acesso à Gemini 4 Carbon API?⌄
Por meio de um projeto pago no Google AI Studio ou via Gemini para empresas no Google Cloud. O app Gemini, o Antigravity e o Modo de IA também oferecem acesso para assinantes do Google AI Ultra, mas esses apps para consumidor não fornecem chave de API.
Quanto custa a Gemini 4 Carbon API?⌄
As 6 auditorias aqui somaram US$ 2,00 na tarifa introdutória. Requisições padrão como estas têm cache implícito quando passam de 4.096 tokens de entrada, então mantenha o início de cada requisição idêntico. O Flex inference, que as requisições Interactions também suportam, reduz pela metade as tarifas de tokens em troca de respostas mais lentas e menos confiáveis.
Quais são os rate limits da Gemini 4 Carbon API?⌄
Projetos pagos têm limites por minuto e um limite de gasto — US$ 10 por janela móvel de 10 minutos no Nível 1; ao ultrapassar, retorna 429 RESOURCE_EXHAUSTED. Uma auditoria aqui custou menos de US$ 1, então só muitas tentativas em paralelo atingiriam esse limite. Os limites sobem conforme o seu nível; confira a página de rate limits do seu projeto.
Qual a diferença entre thinking médio e alto na Gemini 4 Carbon?⌄
A Gemini 4 Carbon tem três níveis, low, medium (padrão) e high — e aqui comparei só os dois de topo. Para ver como é o raciocínio extra, defina thinking_summariescomo "auto" e você receberá resumos condensados ao lado de cada resposta. Eles vêm desligados por padrão e podem vir vazios quando o modelo quase não raciocina.
A Gemini 4 Carbon consegue rodar código Python?⌄
Sim. Adicione {"type": "code_execution"} em toolse a Gemini 4 Carbon pode escrever e executar Python no lado da Google, cobrado pelas tarifas normais de tokens. Eu deixei de fora para manter o controle do meu lado: as três ferramentas decidem o que medir, e as transações brutas e o holdout não saem da minha máquina.
Um tutorial abrangente sobre a criação de agentes LangChain com várias ferramentas para automatizar tarefas em Python usando LLMs e modelos de bate-papo usando OpenAI.
Saiba como o novo recurso de Chamada de Função da OpenAI permite que os modelos GPT gerem saída JSON estruturada, resolvendo problemas comuns de desenvolvimento causados por saídas irregulares.
Saiba mais sobre os modelos Claude 3, benchmarks de desempenho detalhados e como acessá-los. Além disso, descubra a nova API Python do Claude 3 para geração de texto, acesso a recursos de visão e streaming.
Explore o potencial inexplorado dos modelos de linguagem grandes com o LangChain, uma estrutura Python de código aberto para criar aplicativos avançados de IA.
Compreender e implementar o otimizador Adam em Python. Com o PyTorch, você aprenderá a intuição, a matemática e as aplicações práticas do machine learning
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.








No nosso tutorial da Gemini 4 Argon API, o agente tinha uma missão clara: encontrar código lento, corrigir e passar em testes ocultos. Este experimento complementar mantém o mesmo padrão de ferramentas controladas e validação externa, mas muda a decisão. A Gemini 4 Carbon precisa determinar se as regras originais podem ser atendidas — ou se são incompatíveis entre si.
A PayGuard, uma loja online fictícia, possui um modelo de machine learning (ML) treinado para pontuar pedidos com risco de fraude. A política de implantação exige que o modelo capture valor de fraude suficiente no geral e em cada canal de vendas, sem sobrecarregar o time de revisão. O agente deve investigar essas regras sem receber a resposta de antemão sobre a existência de um limiar válido.
A Gemini 4 Carbon é um modelo de raciocínio da Google que você chama em Python via Interactions API. Aqui, ela atua como um agente de IA: escolhe quais verificações solicitar, e o Python as executa por meio de três ferramentas somente leitura usando function calling. Minha pergunta é se ela consegue identificar o conflito, explicar as evidências e recomendar uma mudança permitida — sem tratar essa mudança como já aprovada.
Você vai precisar de Python básico e um pouco de experiência com requisições de API. Eu defino cada métrica de fraude antes de os números aparecerem. Vamos ver como:
Se você quiser a história do lançamento e benchmarks, nosso overview da Gemini 4 Carbon traz tudo isso, e nossa análise Claude Fable 5.2 vs. Gemini 4 Carbon compara os dois modelos. Eu rodei este experimento no dia seguinte à abertura da API para desenvolvedores pagantes.
O que é a Gemini 4 Carbon API?
A Gemini 4 Carbon API é a interface paga de programação de aplicativos (API) para
gemini-4-carbon, que a página do modelo descreve como um modelo de raciocínio para tarefas longas e multi-etapas de agentes. Entrada, raciocínio e saída compartilham uma janela de contexto de 1.048.576 tokens, e uma resposta síncrona para por padrão em 65.536 tokens somando raciocínio e saída.Por que uma auditoria de modelo de ML é um bom teste para a Gemini 4 Carbon
A tarefa exige várias verificações, uma busca por mudanças permitidas e uma parada clara quando as regras não deixam resposta. Eu a escolhi porque o Python consegue calcular o resultado de referência. O model card lista alucinações entre os limites conhecidos da Gemini 4 Carbon, então o modelo investiga enquanto o Python decide se a recomendação se sustenta.
O projeto: decidir se o modelo de fraude da PayGuard pode ir para produção
PayGuard é a loja fictícia da introdução, e o projeto completo está no repositório no GitHub. Seu classificador já está treinado.
Como a PayGuard pontua transações
Cada transação tem um carimbo de data/hora em UTC, um valor, um canal (Website ou Mobile App), um score de risco e um rótulo de fraude. Um
HistGradientBoostingClassifierdo scikit-learn produz o score, arredondado para 0,001, e a PayGuard sinaliza uma transação quandorisk_score >= threshold. Nosso tutorial de curva precisão-recall mostra como mover o limiar muda o que é sinalizado, e nosso curso de Fraud Detection in Python cobre o lado de modelagem.Os dados sintéticos são separados por tempo:
O limiar atual é 0,5, e os dados e a política nunca mudam durante o experimento. Fraudes no Website deixam sinais claros nestes dados, enquanto a maioria das fraudes no Mobile App se parece com um pedido comum.
A Gemini 4 Carbon pergunta, o Python decide. Imagem do autor.
As três regras de implantação da PayGuard
Aqui estão as três regras da introdução, escritas como na política. Todos os alvos são fictícios, definidos para este experimento:
O recall por valor de fraude é o valor de fraudes sinalizadas dividido pelo valor total de fraudes. Diferente do recall por transação no nosso guia de precisão versus recall, uma fraude de US$ 2.000 perdida pesa muito mais do que uma de US$ 15, e sinalizar não significa que o dinheiro foi recuperado. A R3 limita o dia mais movimentado, e essa redação acaba decidindo a auditoria.
O agente pode investigar duas mudanças: uma capacidade diária de até 260 com um único limiar, ou limiares separados por canal mantendo o teto original. Ambas precisam de aprovação humana, não podem ser combinadas e a política prefere a opção sem revisores extras.
O que conta como uma auditoria correta
Uma auditoria correta acerta quatro pontos — e você deve defini-los antes da primeira requisição:
Um avaliador que o agente não pode chamar computa a resposta.
Como configurar a Gemini 4 Carbon API em Python
A configuração da Gemini 4 Carbon API exige Python 3.11 ou mais recente e uma chave de API de um projeto no Google AI Studio com billing ativo, já que a página de preços não lista camada gratuita.
Instale o SDK Google Gen AI e prepare o projeto
Testei este projeto com o SDK Google Gen AI fixado em
google-genai==3.1.0, o release no PyPI do dia do lançamento que adicionougemini-4-carbonà lista de modelos do Interactions. Clone o projeto e instale em um ambiente virtual:Depois, rode os dois comandos na página do repositório que constroem os dados e ajustam o classificador com seeds fixas. Em um clone novo, eles imprimem isto:
Seeds fixas recriam o mesmo dataset. Imagem do autor.
Depois, coloque
GEMINI_API_KEY=your-keyem um arquivo.env. O repositório carrega sem imprimir a chave.Faça sua primeira requisição à Gemini 4 Carbon API
Execute este exemplo completo na pasta do projeto. Ele fornece à Gemini 4 Carbon a política e o resumo do classificador e pergunta o que seria necessário medir, sem sugerir qualquer conflito:
O nível de raciocínio vai em
generation_config, eoutput_textcontém a resposta. Aqui está parte do que voltou:Ela leu a R3 como pico e planejou a ordem de preferência da política antes de ver qualquer número. Porém, não perguntou como funcionam empates ou arredondamento de score, e a checagem exaustiva que mostrarei depois depende justamente disso. A chamada levou cerca de 40 segundos e custou por volta de 2 centavos.
Deixe de fora
temperature,top_petop_k, que a Gemini 4 Carbon ignora, e tambémthinking_budget.Como construir um agente de auditoria de ML com function calling da Gemini 4 Carbon
Um agente de auditoria com a Gemini 4 Carbon é um loop: o modelo solicita uma avaliação, o Python valida e executa, e o resultado volta até o modelo parar de pedir.
Defina ferramentas somente leitura para avaliar o modelo
O agente recebe três ferramentas, todas limitadas à janela de validação:
get_audit_context: resumo do classificador, configuração atual, política e mudanças permitidasevaluate_global_threshold: recall por valor de fraude no geral e por canal, sinalizações por dia e diagnósticos para um limiarevaluate_policy_change: as mesmas medições para aumento de capacidade ou um par de limiares por canalOs esquemas completos estão no repositório. Este trecho simplificado omite os campos de limiar e capacidade, então não é uma declaração completa para copiar. Ele só mostra a fronteira que importa aqui: a ferramenta aceita as duas mudanças de política permitidas pela PayGuard, lê dados de validação e não aprova nada.
O Python valida os campos omitidos de limiar e capacidade, rejeita mudanças fora da política e retorna medições em vez de flags de aprovado/reprovado. O agente não alcança o holdout, não chama o avaliador e não muda a política. Explico nas FAQs por que deixei de fora a execução de código embutida na Gemini 4 Carbon.
Dê ao agente um objetivo claro e regras de parada
A instrução de sistema define o método. Como na primeira requisição, ela não indica onde está o conflito:
O prompt só pode pedir; então os limites vivem no agent harness, o código Python em volta do modelo. Como a API não tem configuração de budget, o app define por tentativa: 25 turnos, 60 chamadas de ferramenta, 30 minutos e US$ 3, com o gasto checado entre os turnos.
Implemente o loop de function calling com a Interactions API
Cada turno é uma chamada
client.interactions.create(). A Gemini 4 Carbon costuma solicitar várias ferramentas de uma vez, então o loop roda a cada etapa defunction_call. Este é o loop central; a versão no repositório adiciona logs e checagens de limite:Eu mantenho essas configurações em um único dict
requestpara que cada chamada subsequente as reenvie.previous_interaction_idcarrega o histórico, mastools,system_instructionegeneration_configvalem para uma interação apenas. Se um turno termina comoincomplete,max_output_tokenso cortou — e você ainda paga pelos tokens de raciocínio.Retorne um relatório estruturado de auditoria com um esquema JSON
O guia de output estruturado do Google lista ferramentas mais um esquema JSON em uma única requisição como um recurso Preview que inclui a Gemini 4 Carbon. Eu mantive separados: os turnos de investigação apenas medem, e um turno final, com o mesmo histórico e config, escreve o relatório com um esquema e sem ferramentas:
AuditReporté um modelo Pydantic com o veredito, conflito, evidências, recomendação e aprovações. O Python mede tempo e custo em vez de pedir para a Gemini 4 Carbon reportá-los.Rode a auditoria da Gemini 4 Carbon no modelo de detecção de fraude
A Gemini 4 Carbon auditou o modelo como eu esperaria de um analista júnior: medições antes de qualquer conclusão. Na primeira tentativa em
medium, ela leu o contexto da auditoria, checou cerca de duas dezenas de limiares únicos e testou oito mudanças de política.Todas as 32 chamadas de ferramenta, em ordem. Imagem do autor.
Avalie o limiar atual da PayGuard
O agente avaliou o limiar atual de 0,5 e encontrou 91% de recall no Website, 20% no Mobile App, 64% no geral e 85 sinalizações no dia mais movimentado. Isso falha a R1 e a metade do R2 para Mobile App, com folga na R3 — então o movimento óbvio é reduzir o limiar.
Teste o recall por valor de fraude vs. capacidade diária de revisão
Reduzir um limiar captura mais valor de fraude e envia mais pedidos para revisão. A PayGuard precisa do suficiente do primeiro mantendo o segundo abaixo de um teto diário.
O agente tentou alguns limiares mais grossos em um lote, depois afinou para pontos específicos da grade. As chamadas 11, 12, 17 e 18 na trilha resolveram.
Nesta janela de validação, o piso do Mobile App exige 0,108 ou menos, porque um passo acima derruba para pouco abaixo de 70%. O teto exige 0,118 ou mais. Nenhum limiar faz os dois.
O recall geral se sustenta até 0,137, então a R1 fica fora do conflito. Em 0,108, o dia médio tem cerca de 169 sinalizações, e só um sábado passa do limite. É por isso que a política usa a carga do dia mais movimentado e não a média diária.
Recall no Mobile e capacidade não se sobrepõem. Imagem do autor.
Cheque o desempenho nos dois canais de pagamento
A fraude no Mobile App, com sinais mais fracos, fica na parte baixa da faixa de scores. Puxar um único limiar para 0,108 para o Mobile App também traz mais pedidos legítimos do Website e, naquele sábado, eles empurram o total acima do teto.
O número geral esconde isso: em 0,118, o recall geral é ~87% enquanto o Mobile App fica abaixo do piso. Se sua política nomeia segmentos, meça cada um, porque o total pode passar enquanto um segmento falha.
A Gemini 4 Carbon consegue detectar requisitos de implantação conflitantes?
Sim, nesta auditoria. O relatório congelado diz
not deployable, afirma que nenhum limiar único funciona e nomeia R2 para Mobile App e R3 como o conflito.Cheque o veredito de implantação vs. as evidências da Gemini 4 Carbon
Cada número citado no relatório bate com um resultado de ferramenta, mas uma frase afirma mais do que o agente mediu. Ela diz que nenhum limiar funciona "em todos os pontos da grade de 0,001 do risk score", mas o agente testou só duas dezenas, de 1.002 possíveis.
A afirmação se sustenta porque recall e contagens diárias caem conforme o limiar sobe — algo que o relatório não menciona. Verifique cada alegação de um agente contra o que ele mediu; nosso guia de avaliação de agentes de IA cobre mais checagens desse tipo.
Verifique o conflito com um avaliador exaustivo em Python
A Gemini 4 Carbon amostrou limiares e inferiu que nenhum funcionaria. O avaliador comprova o resultado para este conjunto de validação checando todo conjunto distinto de sinalizações, sem compartilhar código com as ferramentas.
Os scores estão em uma grade de 0,001, então os 1.002 cortes candidatos cobrem todo conjunto de sinalizações possível. O avaliador checa todos eles e todos os pares de limiares por canal, usando centavos inteiros para que 85% e 70% fiquem exatos.
Checagem exaustiva e quatro configurações rejeitadas. Imagem do autor.
Nenhum limiar global passa nas três regras, então a afirmação da Gemini 4 Carbon agora tem prova. O avaliador bateu as fronteiras 0,108 e 0,118 encontradas pelo agente e achou milhares de pares por canal que passam com 200 por dia.
Um avaliador só ajuda se rejeita respostas ruins, então eu o alimentei com quatro configurações erradas — e ele rejeitou todas.
Teste alternativas de implantação com a Gemini 4 Carbon
A Gemini 4 Carbon testou as duas mudanças permitidas e escolheu limiares separados mantendo o teto original, em vez de revisores extras. Ela marcou essa escolha como exceção que precisa de aprovação humana.
Teste um aumento na capacidade de revisão manual
Um limiar global funciona se o teto subir de 200 para 205, e o avaliador confirmou 205 como o menor aumento. Ainda assim, a Gemini 4 Carbon ranqueou essa opção em segundo, por causa da regra de preferência que descrevi.
Teste limiares separados por canal de pagamento
Do lado dos canais, o agente manteve o limiar do Mobile App próximo ao limite (ele já tinha visto 0,109 quebrar o piso) e elevou o limiar do Website, reduzindo sinalizações em pedidos legítimos do Website. Ele testou sete pares; um falhou por uma única sinalização no dia mais movimentado. Recomendou Website 0,3 e Mobile App 0,1 porque esse par cumpre todas as regras com margem, e o avaliador confirmou no teto original.
Compare as alternativas verificadas
Estes números já apareceram acima, e o avaliador recalculou cada um:
Opção
Limiar(es)
Geral
Website
Mobile App
Dia mais cheio
Aprovação
Política original
Global 0,108
87,5%
98,2%
70,1%
205, teto 200
Falha
Mais capacidade
Global 0,108
87,5%
98,2%
70,1%
205, teto 205
Precisa
Divisão por canal
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, teto 200
Precisa
A divisão por canal também sinaliza cerca de 6% menos transações do que a opção de capacidade. Porém, menos da metade das sinalizações são fraudes, o que o relatório listou como ponto em aberto.
Como verificar a recomendação da Gemini 4 Carbon em dados não vistos
Você verifica a recomendação aplicando-a, congelada, ao holdout lacrado. A diferença para o avaliador está nos dados: o avaliador pontuou semanas que o agente podia ver; o holdout pontua quatro semanas posteriores que nenhuma ferramenta pôde ler. A checagem roda uma vez por recomendação congelada e não começa se o relatório mudou depois de congelar.
A recomendação congelada passa no holdout. Imagem do autor.
Ela passou nas três regras, e o dia mais movimentado ficou abaixo do teto. Mas não superestime isso. Três pontos deixam o resultado modesto:
Os dois primeiros vêm dos próprios números.
Veja a auditoria completa no Streamlit
O repositório também inclui um app em Streamlit e as seis tentativas gravadas, para você abrir esta auditoria sem chamada à API. No vídeo, eu carrego e passo por cada aba.