Samouczek Gemini 4 Carbon API: zbuduj agenta, który audytuje model nadużyć
Poznaj Gemini 4 Carbon API w Pythonie: zbuduj agenta wywołującego funkcje, który audytuje model nadużyć, znajduje sprzeczne reguły i testuje zmianę polityki.
W naszym samouczku Gemini 4 Argon API agent miał jasne zadanie: znaleźć wolny kod, zmienić go i przejść ukryte testy. Ten towarzyszący eksperyment zachowuje ten sam schemat kontrolowanych narzędzi i zewnętrznej weryfikacji, ale zmienia decyzję. Gemini 4 Carbon musi ustalić, czy oryginalne zasady w ogóle da się spełnić.
PayGuard, fikcyjny sklep internetowy, ma wytrenowany model uczenia maszynowego (ML), który ocenia zamówienia pod kątem nadużyć. Polityka wdrożeniowa wymaga, by model wyłapywał wystarczająco dużą wartość nadużyć łącznie i w każdym kanale sprzedaży, nie przeciążając zespołu weryfikującego. Agent ma zbadać te zasady, nie wiedząc, czy istnieje poprawny próg.
Gemini 4 Carbon to model rozumowania Google, który wywołujesz z Pythona przez Interactions API. Tutaj działa jako agent AI: wybiera, które sprawdzenia zlecić, a Python wykonuje je trzema narzędziami tylko do odczytu, używając wywoływania funkcji. Moje pytanie brzmi, czy potrafi zidentyfikować konflikt, wyjaśnić dowody i zarekomendować dozwoloną zmianę, nie traktując tej zmiany jako zatwierdzonej.
Przyda ci się podstawowa znajomość Pythona i trochę doświadczenia z zapytaniami do API. Każdą metrykę nadużyć zdefiniuję przed użyciem liczb. Omówimy, jak:
Wysłać pierwsze zapytanie do Gemini 4 Carbon z Pythona
Dać modelowi narzędzia tylko do odczytu i uruchamiać je w pętli z limitami
Odebrać werdykt jako JSON, który twój kod może sprawdzić
Zweryfikować ten werdykt kodem i danymi, których model nigdy nie widzi
Porównać dwa poziomy rozumowania, które kontrolują, jak bardzo model rozumuje przed odpowiedzią
Gemini 4 Carbon API to płatny interfejs programistyczny (API) dla gemini-4-carbon, który strona modelu opisuje jako model rozumowania do długich, wieloetapowych zadań agentskich. Wejście, rozumowanie i wyjście współdzielą kontekst o rozmiarze 1 048 576 tokenów, a synchroniczna odpowiedź domyślnie zatrzymuje się przy 65 536 tokenach rozumowania plus wyjście.
Dlaczego audyt modelu ML to dobry test dla Gemini 4 Carbon
Zadanie wymaga kilku kontroli, przeszukania dozwolonych zmian i jasnego zatrzymania się, gdy zasady nie zostawiają odpowiedzi. Wybrałem je, bo Python może policzyć wynik referencyjny. Karta modelu wymienia halucynacje wśród znanych ograniczeń Gemini 4 Carbon, więc model bada, a Python decyduje, czy jego rekomendacja się broni.
Projekt: decyzja, czy model nadużyć PayGuard może trafić na produkcję
PayGuard to fikcyjny sklep z wstępu, a cały projekt znajdziesz w repozytorium GitHub. Klasyfikator jest już wytrenowany.
Jak PayGuard ocenia transakcje
Każda transakcja ma znacznik czasu UTC, kwotę, kanał (Website lub Mobile App), wynik ryzyka i etykietę nadużycia. Skorę generuje HistGradientBoostingClassifier ze scikit-learn, zaokrąglony do 0,001, a PayGuard oznacza transakcję, gdy risk_score >= threshold. Nasz tutorial o krzywej precision–recall pokazuje, jak przesuwanie progu zmienia to, co trafia na listę, a kurs Fraud Detection in Python omawia stronę modelowania.
Syntetyczne dane są podzielone w czasie:
Trening: pierwsze dziewięć tygodni, użyte wyłącznie do dopasowania klasyfikatora
Walidacja: kolejne cztery tygodnie, jedyne okno, które mogą czytać narzędzia
Holdout: cztery tygodnie po nich, zaplombowane do czasu zamrożenia rekomendacji
Obecny próg to 0,5, a dane i polityka nie zmieniają się w trakcie eksperymentu. Nadużycia na Website zostawiają w tych danych wyraźne sygnały, podczas gdy większość nadużyć w Mobile App wygląda jak zwykłe zamówienie.
Gemini 4 Carbon pyta, Python decyduje. Obraz: autor.
Trzy zasady wdrożeniowe PayGuard
Oto trzy zasady ze wstępu, zapisane tak, jak stanowi polityka. Wszystkie to fikcyjne cele, które wybrałem do tego eksperymentu:
R1: oznaczone transakcje obejmują co najmniej 85% wartości oznaczonych nadużyć łącznie
R2: obejmują co najmniej 70% wartości oznaczonych nadużyć w każdym kanale
R3: nie więcej niż 200 transakcji jest oznaczanych w dowolnym pojedynczym dniu UTC
Recall wartości nadużyć to wartość oznaczonych nadużyć podzielona przez łączną wartość nadużyć. W odróżnieniu od recallu na poziomie transakcji z naszego poradnika precision kontra recall, pominięte nadużycie za 2 000 $ liczy się znacznie bardziej niż pominięte za 15 $, a oznaczenie nie znaczy, że pieniądze zostały uratowane. R3 ogranicza najbardziej pracowity pojedynczy dzień i to sformułowanie ostatecznie rozstrzyga audyt.
Agent może zbadać dwie zmiany: dzienną przepustowość do 260 przy jednym progu lub osobne progi dla kanałów przy oryginalnym limicie. Obie wymagają akceptacji człowieka, nie można ich łączyć, a polityka preferuje opcję bez dodatkowych recenzentów.
Co liczy się jako poprawny audyt
Poprawny audyt trafia w cztery elementy i powinieneś je ustalić przed pierwszym żądaniem:
Werdykt: czy jakikolwiek pojedynczy próg spełnia R1, R2 i R3 na walidacji
Konflikt: które wymagania czynią oryginalną politykę niemożliwą
Alternatywa: dozwolona zmiana, która przechodzi wszystkie reguły, gdy Python to przeliczy
Preferencja: rekomendacja podąża za kolejnością preferencji z polityki
Niezależny ewaluator, którego agent nie może wywołać, oblicza odpowiedź.
Jak skonfigurować Gemini 4 Carbon API w Pythonie
Konfiguracja Gemini 4 Carbon API wymaga Pythona 3.11 lub nowszego oraz klucza API z projektu Google AI Studio z włączonym rozliczaniem, ponieważ strona cen nie przewiduje darmowego progu.
Zainstaluj Google Gen AI SDK i przygotuj projekt
Testowałem ten projekt z Google Gen AI SDK przypiętym do wersji google-genai==3.1.0, wydaniem na PyPI z dnia premiery, które dodało gemini-4-carbon do listy modeli Interactions. Sklonuj projekt i zainstaluj go w wirtualnym środowisku:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS or Linux: source .venv/bin/activate
pip install-r requirements.txtObsługiwane przez
Następnie uruchom dwa polecenia ze strony repozytorium, które budują dane i dopasowują klasyfikator ze stałymi ziarnami losowości. Na świeżej kopii wydrukują to:
Stałe ziarna odtwarzają ten sam zbiór danych. Obraz: autor.
Potem umieść GEMINI_API_KEY=your-key w pliku .env. Repozytorium go wczytuje, nie drukując.
Zrób swoje pierwsze zapytanie do Gemini 4 Carbon API
Uruchom ten kompletny przykład z folderu projektu. Przekazuje Gemini 4 Carbon politykę i podsumowanie klasyfikatora oraz pyta, co trzeba by zmierzyć — bez sugerowania konfliktu:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Obsługiwane przez
Poziom rozumowania trafia do generation_config, a output_text zawiera odpowiedź. Oto fragment, który wrócił:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Obsługiwane przez
Odczytał R3 jako maksimum i ułożył kolejność preferencji polityki, zanim zobaczył jakąkolwiek liczbę. Nie zapytał jednak, jak działają remisy czy zaokrąglanie skoru, a wyczerpująca kontrola, którą pokażę później, dokładnie od tego zależy. Wywołanie trwało około 40 sekund i kosztowało około 2 centów.
Pomiń temperature, top_p i top_k, które Gemini 4 Carbon ignoruje, oraz thinking_budget.
Jak zbudować agenta audytu ML z wywoływaniem funkcji w Gemini 4 Carbon
Agent audytu Gemini 4 Carbon to pętla: model żąda ewaluacji, Python ją weryfikuje i wykonuje, a wynik wraca dopóki model nie przestanie prosić.
Zdefiniuj narzędzia tylko do odczytu do oceny modelu
Agent dostaje trzy narzędzia. Wszystkie są ograniczone do okna walidacyjnego:
get_audit_context: podsumowanie klasyfikatora, obecna konfiguracja, polityka i dozwolone zmiany
evaluate_global_threshold: recall wartości nadużyć łącznie i per kanał, liczba oznaczeń na dzień oraz diagnostyka dla jednego progu
evaluate_policy_change: te same pomiary dla zwiększenia przepustowości lub pary progów kanałowych
Pełne schematy są w repozytorium. Ten uproszczony wycinek pomija pola progu i przepustowości, więc nie jest kompletną deklaracją do skopiowania. Pokazuje tylko ważną tu granicę: narzędzie akceptuje dwie zmiany polityki dozwolone przez PayGuard, czyta dane walidacyjne i niczego nie zatwierdza.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Obsługiwane przez
Python weryfikuje pominięte pola progu i przepustowości, odrzuca zmiany poza polityką i zwraca pomiary zamiast flag pass/fail. Agent nie może dostać się do holdoutu, wywołać ewaluatora ani zmienić polityki. W FAQ wyjaśniam, czemu pominąłem wbudowane wykonywanie kodu przez Gemini 4 Carbon.
Daj agentowi jasny cel i zasady zatrzymania
Instrukcja systemowa ustawia metodę. Jak pierwsze żądanie, nie sugeruje, gdzie jest konflikt:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.Obsługiwane przez
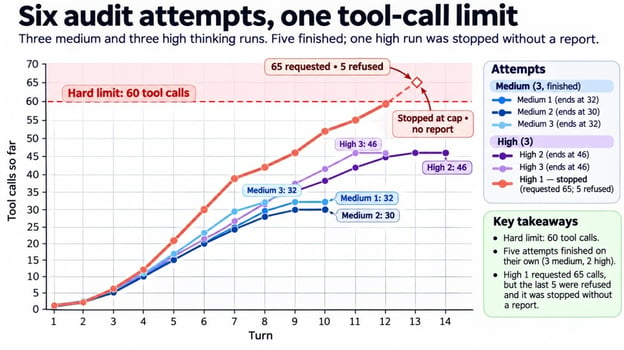
Prompt może tylko prosić, więc limity mieszkają w harnessie agenta, czyli kodzie Pythona wokół modelu. Ponieważ API nie ma ustawienia budżetu, aplikacja ustawiają je per próbę: 25 tur, 60 wywołań narzędzi, 30 minut i 3 $, z kontrolą wydatków między turami.
Zaimplementuj pętlę wywołań funkcji z Interactions API
Każda tura to jedno wywołanie client.interactions.create(). Gemini 4 Carbon często prosi o kilka narzędzi naraz, więc pętla obsługuje każdy krok function_call. To jest rdzeń pętli, a wersja w repo dodaje logowanie i sprawdzanie limitów:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Obsługiwane przez
Trzymam te ustawienia w jednym słowniku request, żeby każde kolejne wywołanie je ponawiało. previous_interaction_id przenosi historię, ale tools, system_instruction i generation_config obowiązują tylko dla jednego interaction. Jeśli tura kończy się jako incomplete, to max_output_tokens ją ucięło — a za tokeny rozumowania i tak płacisz.
Zwróć ustrukturyzowany raport audytowy ze schematem JSON
W przewodniku po ustrukturyzowanych odpowiedziach Google narzędzia plus schemat JSON w jednym żądaniu są funkcją Preview, która obejmuje Gemini 4 Carbon. I tak rozdzieliłem je: tury dochodzeniowe tylko mierzą, a ostatnia tura na tej samej historii i konfiguracji pisze raport ze schematem i bez narzędzi:
final = client.interactions.create(input=REPORT_PROMPT, previous_interaction_id=interaction.id, model="gemini-4-carbon",
system_instruction=SYSTEM_INSTRUCTION, generation_config=request["generation_config"],
response_format={"type":"text","mime_type":"application/json","schema": AuditReport.model_json_schema()},
timeout=900)
report = AuditReport.model_validate_json(final.output_text)Obsługiwane przez
AuditReport to model Pydantic z werdyktem, konfliktem, dowodami, rekomendacją i akceptacjami. Python mierzy czas i koszt zamiast prosić Gemini 4 Carbon o ich raportowanie.
Uruchom audyt Gemini 4 Carbon na modelu wykrywania nadużyć
Gemini 4 Carbon przeprowadził audyt tak, jak chciałbym, by zrobił to młodszy analityk — z pomiarami przed wnioskami. W pierwszej próbie na poziomie medium przeczytał kontekst audytu, sprawdził około dwudziestu kilku pojedynczych progów i przetestował osiem zmian polityki.
Wszystkie 32 wywołania narzędzi, w kolejności. Obraz: autor.
Oceń obecny próg PayGuard
Agent ocenił obecny próg 0,5 i znalazł 91% recallu na Website, 20% recallu w Mobile App, 64% łącznie i 85 oznaczeń w najbardziej pracowity dzień. To oblewa R1 i część R2 dla Mobile App, zostawiając zapas względem R3, więc oczywistym ruchem jest niższy próg.
Przetestuj recall wartości nadużyć względem dziennej przepustowości przeglądu
Obniżenie progu łapie więcej wartości nadużyć i wysyła więcej zamówień do przeglądu. PayGuard potrzebuje wystarczająco dużo pierwszego, trzymając drugie pod dziennym limitem.
Agent spróbował kilku zgrubnych progów w jednej partii, potem zawęził do pojedynczych punktów siatki. Rozstrzygnęły to wywołania 11, 12, 17 i 18 w śladzie.
Na tym oknie walidacyjnym podłoga dla Mobile App wymaga 0,108 lub niżej, bo jeden krok wyżej spada tuż poniżej 70%. Limit wymaga 0,118 lub wyżej. Żaden próg nie spełnia obu.
Recall łączny utrzymuje się do 0,137, więc R1 pozostaje poza konfliktem. Przy 0,108 przeciętny dzień ma około 169 oznaczeń, a tylko jedna sobota przekracza limit. Dlatego polityka używa obciążenia najbardziej pracowitego dnia, a nie średniej dziennej.
Recall w Mobile i przepustowość nigdy się nie pokrywają. Obraz: autor.
Sprawdź wydajność w obu kanałach płatności
Nadużycia w Mobile App, przy słabszych sygnałach, leżą nisko w zakresie skoru. Ściągnięcie jednego progu do 0,108 dla Mobile App wciąga też więcej prawidłowych zamówień z Website i w tę sobotę to one wypychają sumę ponad limit.
Liczba łączna to maskuje: przy 0,118 recall łączny to około 87%, podczas gdy Mobile App jest poniżej swojej podłogi. Jeśli twoja polityka nazywa segmenty, mierz każdy z nich, bo całość może przechodzić, gdy jeden segment oblewa.
Czy Gemini 4 Carbon potrafi wykryć sprzeczne wymagania wdrożeniowe?
Tak, w tym audycie. Zamrożony raport mówi not deployable, stwierdza, że żaden pojedynczy próg nie działa, i wskazuje R2 dla Mobile App oraz R3 jako konflikt.
Sprawdź werdykt wdrożeniowy Gemini 4 Carbon wobec jego dowodów
Każda liczba cytowana w raporcie zgadza się z wynikiem narzędzia, ale jedno zdanie twierdzi więcej, niż agent zmierzył. Mówi, że żaden próg nie działa „na całej siatce punktów co 0,001”, a agent przetestował tylko dwadzieścia kilka z powyższego śladu, z 1 002 możliwych progów.
Teza się broni, ponieważ recall i dzienne zliczenia spadają wraz ze wzrostem progu, czego raport nie mówi. Sprawdź każde twierdzenie w raporcie agenta względem tego, co zmierzył, a nasz przewodnik po ewaluacji agentów AI obejmuje więcej takich kontroli.
Zweryfikuj konflikt wyczerpującym ewaluatorem w Pythonie
Gemini 4 Carbon próbkował progi i wywnioskował, że żaden nie zadziała. Ewaluator dowodzi tego wyniku dla tego zbioru walidacyjnego, sprawdzając każdy odrębny zestaw oznaczeń, bez współdzielenia kodu z narzędziami.
Skory leżą na siatce 0,001, więc 1 002 kandydackie progi pokrywają każdy możliwy zestaw oznaczeń. Ewaluator sprawdza wszystkie z nich oraz każdą parę progów kanałowych, używając całych centów, by 85% i 70% były dokładne.
Wyczerpująca kontrola i cztery odrzucone konfiguracje. Obraz: autor.
Żaden globalny próg nie przechodzi wszystkich trzech reguł, więc teza Gemini 4 Carbon ma teraz za sobą dowód. Ewaluator potwierdził granice 0,108 i 0,118 z sondowania agenta i znalazł tysiące par kanałowych, które przechodzą przy 200 dziennie.
Ewaluator pomaga tylko, jeśli odrzuca złe odpowiedzi, więc podałem mu cztery błędne konfiguracje i odrzucił wszystkie cztery.
Przetestuj alternatywy wdrożenia z Gemini 4 Carbon
Gemini 4 Carbon przetestował obie dozwolone zmiany i wybrał osobne progi przy oryginalnym limicie zamiast dodatkowych recenzentów. Zaznaczył ten wybór jako wyjątek wymagający zgody człowieka.
Jeden globalny próg działa, jeśli limit wzrośnie z 200 do 205, a ewaluator potwierdził 205 jako najmniejszy wzrost. Gemini 4 Carbon i tak dał tej opcji drugie miejsce, z uwagi na zasadę preferencji opisaną wcześniej.
Przetestuj osobne progi dla każdego kanału płatności
Po stronie kanałów agent trzymał próg Mobile App blisko jego granicy (widział już, że 0,109 łamie podłogę) i podniósł próg dla Website, obniżając liczbę oznaczeń prawidłowych zamówień z Website. Przetestował siedem par i jedna oblała o jedno oznaczenie w najbardziej pracowity dzień. Zarekomendował Website 0,3 i Mobile App 0,1, bo ta para przechodzi wszystkie reguły z zapasem, a ewaluator to potwierdził przy oryginalnym limicie.
Porównaj zweryfikowane alternatywy
Te liczby pojawiły się wyżej, a ewaluator każdą przeliczył:
Opcja
Progi
Łącznie
Website
Mobile App
Najbardziej pracowity dzień
Zgoda
Oryginalna polityka
Globalny 0,108
87,5%
98,2%
70,1%
205, limit 200
Nie przechodzi
Więcej przepustowości
Globalny 0,108
87,5%
98,2%
70,1%
205, limit 205
Wymagana
Podział kanałów
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, limit 200
Wymagana
Podział kanałów oznacza też około 6% mniej transakcji niż opcja przepustowości. Mniej niż połowa jego oznaczeń to jednak nadużycia, co raport wymienił jako kwestię otwartą.
Jak zweryfikować rekomendację Gemini 4 Carbon na niewidzianych danych
Rekomendację weryfikujesz, stosując ją — zamrożoną — do zaplombowanego holdoutu. Różnica względem ewaluatora to dane: ewaluator oceniał tygodnie, które agent mógł widzieć, a holdout ocenia cztery późniejsze tygodnie, których żadne narzędzie nie mogło czytać. Kontrola uruchamia się raz na zamrożoną rekomendację i nie wystartuje, jeśli raport zmienił się po zamrożeniu.
Zamrożona rekomendacja przechodzi na holdoucie. Obraz: autor.
Przeszła wszystkie trzy reguły, a najbardziej pracowity dzień pozostał poniżej limitu. Nie wyciągaj jednak z tego zbyt daleko idących wniosków. Trzy rzeczy trzymają ten wynik w ryzach:
Holdout pochodzi z tego samego generatora, więc nic nie mówi o nowych typach nadużyć ani dryfcie danych
Recall łączny przekroczył 85% o mniej niż dwa punkty
Mój nietestowany domysł: podział mógłby złamać limit, jeśli ruch Mobile App rósłby szybciej niż Website, bo próg Mobile App leży bardzo nisko
Pierwsze dwa wynikają z liczb.
Obejrzyj pełny audyt w Streamlit
Repozytorium zawiera też aplikację Streamlit i sześć nagranych prób, więc możesz otworzyć ten audyt bez wywołania API. Na wideo ładuję go i przechodzę po kolejnych kartach.
Aplikacja Streamlit pokazuje jeden audyt. Wideo: autor.
Gemini 4 Carbon: medium vs high thinking — dokładność, czas i koszt
Sukces oznacza tu zakończenie w granicach limitów aplikacji i zwrot raportu, który akceptuje ewaluator. Zatrzymana próba nie ma werdyktu do oceny. W tej definicji medium ukończył każdą próbę i kosztował mniej niż połowę na poprawny audyt.
Sześć prób to za mało, by robić z tego regułę. Jeśli poziomy rozumowania są dla ciebie nowe, nasz samouczek Gemini 3.8 Flash API omawia thinking_level szerzej.
Porównaj medium i high na tym samym audycie
To pełne porównanie stojące za TL;DR. Uruchomiłem po 3 próby na poziom, każdą ze świeżego stanu, bez pamięci o innych, z identycznymi danymi, promptem, narzędziami, limitami i ewaluatorem:
Na poziom
medium
high
Próby zakończone raportem
3 z 3
2 z 3
Poprawne audyty wśród nich
3 z 3
2 z 2
Tokeny rozumowania na próbę
Około 7 700
Około 17 500
Czas na próbę
Około 5 minut
Około 6 minut
Koszt na poprawny audyt, stawka wprowadzająca
Około 0,25 $
Około 0,62 $
Koszt na poprawny audyt, stawka standardowa
Około 0,51 $
Około 1,24 $
Wiersze kosztów liczą wydatki każdej próby, łącznie z tą, która się zatrzymała. Każda ukończona próba doszła do tego samego werdyktu i konfliktu oraz wybrała parę kanałową zaakceptowaną przez ewaluatora, więc dodatkowe rozumowanie poszło w więcej sprawdzeń.
Podobny wzorzec widziałem w eksperymencie z Gemini 4 Argon do kodowania: highwydawał więcej i robił więcej pracy przy mniejszej zmianie w zweryfikowanym wyniku. Zadania są różne, więc ich koszty i skuteczności nie są bezpośrednio porównywalne. W obu przypadkach niezależna kontrola mówi więcej niż łączna liczba tokenów rozumowania.
Dlaczego jedna próba na high nie skończyła
Zatrzymana próba była pierwszą na high i nigdy nie dała złego werdyktu. Sondowała każdy punkt siatki od 0,101 do 0,119, a potem zaczęła szukać granicy 70% dla Website, od której nic nie zależało, i prosiła o kolejne sprawdzenia, aż uderzyła w limit 60 wywołań ustawiony wcześniej — aplikacja zatrzymała ją, zanim napisała raport.
Tylko jedna próba uderzyła w limit. Obraz: autor.
Ten stop jest tu pożyteczny. Prompt proszący o mniej wywołań by go nie zakończył, a limit w kodzie — tak, po około 22 centach.
Pięć zakończonych raportów przeszło też inne kontrole w Pythonie. Żaden nie źle odczytał bieżącej konfiguracji, nie wskazał wymagania poza konfliktem, nie zacytował nieistniejącego wywołania narzędzia ani nie polecił konfiguracji, której nie testował.
Mierz tokeny, czas i koszt na audyt
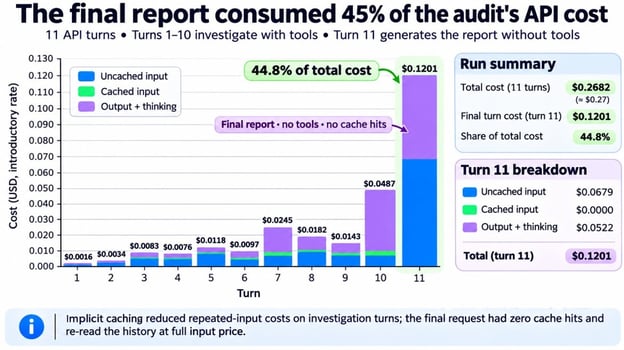
Koszt audytu to suma usage z każdej tury, liczone po 2,00 $ za milion tokenów wejściowych, 0,10 $ za cache i 10,00 $ za wyjście łącznie z rozumowaniem — wszystko podwaja się 1 grudnia 2026. total_input_tokens zawiera tokeny z cache, więc kod wycenia te dwie części osobno.
Tura z raportem kosztuje najwięcej. Obraz: autor.
Zaskoczeniem był raport — a dokładniej jego rachunek. Implicit caching pokrył około trzech czwartych tokenów wejściowych w turach dochodzeniowych, ale żądanie raportu bez narzędzi nie trafiło w cache ani razu.
Prawdopodobną przyczyną jest to, że usunięcie tools zmienia początek żądania. Tak czy inaczej, ta tura przeczytała całą historię po pełnej cenie i zabrała około 40% kosztu każdej ukończonej próby. Policzyć ją, gdy ustawiasz limit wydatków.
Ograniczenia użycia Gemini 4 Carbon do audytu modeli ML
Ten test zaprojektowałem i dane wygenerowałem sam, więc wyniki mają te ograniczenia:
Dane są syntetyczne i pochodzą z jednego klasyfikatora, a generator strojeniem doprowadziłem do istnienia konfliktu — przed jakimkolwiek wywołaniem API
Werdykt dotyczy tylko tego klasyfikatora; lepszy mógłby spełnić trzy reguły jednym progiem
Próg można sprawdzić, ale zatwierdzenie podziału kanałów to decyzja biznesowa i kwestia fair
Interakcje są domyślnie przechowywane 55 dni w płatnej warstwie, a store=false wyklucza previous_interaction_id, więc agent wysyłający wiersze transakcji wymaga przeglądu danych
Ewaluator sam rozwiązuje problem progu, bez udziału modelu. Jeśli potrzebujesz tylko progu, użyj solwera optymalizacyjnego. To, co dodał Gemini 4 Carbon, to audyt wokół niego.
Nic tu nie jest przywiązane do nadużyć. Układ pasuje do każdego modelu, którego reguły Python może zmierzyć.
Na koniec
Główny wynik jest taki, że Gemini 4 Carbon rozpoznał, iż oryginalna polityka nie ma poprawnego globalnego progu. Wszystkie 5 ukończonych prób nazwało konflikt i zaproponowało podział kanałów zaakceptowany przez ewaluatora; jedna próba na high zatrzymała się przed wygenerowaniem raportu.
Eksperymenty z Gemini 4 Argon i Gemini 4 Carbon testują dwie strony niezawodności agentów. Agent z Gemini 4 Argon zmieniał kod i musiał zachować zachowanie, a agent z Gemini 4 Carbon dojść do decyzji przy zasadach uniemożliwiających oryginalną odpowiedź. Oba potrzebowały wąskich narzędzi, limitów zasobów i kontroli poza modelem.
Taki standard przyjąłbym dla agenta: zdefiniować, co jego narzędzia mogą ustalić, niezależnie zweryfikować wynik i dopuścić odpowiedź inconclusive, gdy dowody się kończą. Następnie wziąłbym dwa–trzy kandydackie klasyfikatory pod tę samą politykę i zapytał, który, jeśli w ogóle, można wysłać na produkcję.
FAQs
Jak uzyskać dostęp do Gemini 4 Carbon API?⌄
Przez płatny projekt w Google AI Studio lub przez Gemini for business w Google Cloud. Aplikacja Gemini, Antigravity i AI Mode też oferują go subskrybentom Google AI Ultra, ale te aplikacje konsumenckie nie dają klucza API.
Ile kosztuje Gemini 4 Carbon API?⌄
Wszystkie 6 audytów tutaj kosztowało łącznie 2,00 $ przy stawce wprowadzającej. Standardowe żądania jak te mają implicit caching po przekroczeniu 4 096 tokenów wejściowych, więc utrzymuj początek każdego żądania identyczny. Flex inference, które wspierają też żądania Interactions, obniża stawki za tokeny o połowę w zamian za wolniejsze, mniej niezawodne odpowiedzi.
Jakie są limity szybkości Gemini 4 Carbon API?⌄
Płatne projekty mają limity na minutę plus limit wydatków — 10 $ na kroczącym 10‑minutowym oknie w Tier 1 — a po przekroczeniu dostajesz 429 RESOURCE_EXHAUSTED. Jeden audyt tutaj kosztował poniżej 1 $, więc tylko wiele równoległych prób by to uderzyło. Limity rosną wraz z twoim tierem, więc sprawdź stronę limitów dla twojego projektu.
Jaka jest różnica między medium i high thinking w Gemini 4 Carbon?⌄
Gemini 4 Carbon ma trzy poziomy: low, medium (domyślny) i high, a tutaj porównałem tylko dwa najwyższe. Żeby zobaczyć, jak wygląda dodatkowe rozumowanie, ustaw thinking_summariesna "auto" — dostaniesz skondensowane podsumowania obok każdej odpowiedzi. Domyślnie są wyłączone i mogą być puste, gdy model ledwie rozumuje.
Czy Gemini 4 Carbon może uruchamiać kod Pythona?⌄
Tak. Dodaj {"type": "code_execution"} do tools i Gemini 4 Carbon może pisać i uruchamiać Pythona po stronie Google, rozliczane według zwykłych stawek za tokeny. Pominąłem to, by zachować kontrolę po swojej stronie: trzy narzędzia decydują, co może mierzyć, a surowe transakcje i holdout nigdy nie opuszczają mojej maszyny.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.


W naszym samouczku Gemini 4 Argon API agent miał jasne zadanie: znaleźć wolny kod, zmienić go i przejść ukryte testy. Ten towarzyszący eksperyment zachowuje ten sam schemat kontrolowanych narzędzi i zewnętrznej weryfikacji, ale zmienia decyzję. Gemini 4 Carbon musi ustalić, czy oryginalne zasady w ogóle da się spełnić.
PayGuard, fikcyjny sklep internetowy, ma wytrenowany model uczenia maszynowego (ML), który ocenia zamówienia pod kątem nadużyć. Polityka wdrożeniowa wymaga, by model wyłapywał wystarczająco dużą wartość nadużyć łącznie i w każdym kanale sprzedaży, nie przeciążając zespołu weryfikującego. Agent ma zbadać te zasady, nie wiedząc, czy istnieje poprawny próg.
Gemini 4 Carbon to model rozumowania Google, który wywołujesz z Pythona przez Interactions API. Tutaj działa jako agent AI: wybiera, które sprawdzenia zlecić, a Python wykonuje je trzema narzędziami tylko do odczytu, używając wywoływania funkcji. Moje pytanie brzmi, czy potrafi zidentyfikować konflikt, wyjaśnić dowody i zarekomendować dozwoloną zmianę, nie traktując tej zmiany jako zatwierdzonej.
Przyda ci się podstawowa znajomość Pythona i trochę doświadczenia z zapytaniami do API. Każdą metrykę nadużyć zdefiniuję przed użyciem liczb. Omówimy, jak:
Jeśli chcesz historię premiery i wyniki benchmarków, znajdziesz je w naszym przeglądzie Gemini 4 Carbon oraz w analizie Claude Fable 5.2 vs. Gemini 4 Carbon. Ten eksperyment przeprowadziłem dzień po tym, jak Google udostępnił API płacącym deweloperom.
Czym jest Gemini 4 Carbon API?
Gemini 4 Carbon API to płatny interfejs programistyczny (API) dla
gemini-4-carbon, który strona modelu opisuje jako model rozumowania do długich, wieloetapowych zadań agentskich. Wejście, rozumowanie i wyjście współdzielą kontekst o rozmiarze 1 048 576 tokenów, a synchroniczna odpowiedź domyślnie zatrzymuje się przy 65 536 tokenach rozumowania plus wyjście.Dlaczego audyt modelu ML to dobry test dla Gemini 4 Carbon
Zadanie wymaga kilku kontroli, przeszukania dozwolonych zmian i jasnego zatrzymania się, gdy zasady nie zostawiają odpowiedzi. Wybrałem je, bo Python może policzyć wynik referencyjny. Karta modelu wymienia halucynacje wśród znanych ograniczeń Gemini 4 Carbon, więc model bada, a Python decyduje, czy jego rekomendacja się broni.
Projekt: decyzja, czy model nadużyć PayGuard może trafić na produkcję
PayGuard to fikcyjny sklep z wstępu, a cały projekt znajdziesz w repozytorium GitHub. Klasyfikator jest już wytrenowany.
Jak PayGuard ocenia transakcje
Każda transakcja ma znacznik czasu UTC, kwotę, kanał (Website lub Mobile App), wynik ryzyka i etykietę nadużycia. Skorę generuje
HistGradientBoostingClassifierze scikit-learn, zaokrąglony do 0,001, a PayGuard oznacza transakcję, gdyrisk_score >= threshold. Nasz tutorial o krzywej precision–recall pokazuje, jak przesuwanie progu zmienia to, co trafia na listę, a kurs Fraud Detection in Python omawia stronę modelowania.Syntetyczne dane są podzielone w czasie:
Obecny próg to 0,5, a dane i polityka nie zmieniają się w trakcie eksperymentu. Nadużycia na Website zostawiają w tych danych wyraźne sygnały, podczas gdy większość nadużyć w Mobile App wygląda jak zwykłe zamówienie.
Gemini 4 Carbon pyta, Python decyduje. Obraz: autor.
Trzy zasady wdrożeniowe PayGuard
Oto trzy zasady ze wstępu, zapisane tak, jak stanowi polityka. Wszystkie to fikcyjne cele, które wybrałem do tego eksperymentu:
Recall wartości nadużyć to wartość oznaczonych nadużyć podzielona przez łączną wartość nadużyć. W odróżnieniu od recallu na poziomie transakcji z naszego poradnika precision kontra recall, pominięte nadużycie za 2 000 $ liczy się znacznie bardziej niż pominięte za 15 $, a oznaczenie nie znaczy, że pieniądze zostały uratowane. R3 ogranicza najbardziej pracowity pojedynczy dzień i to sformułowanie ostatecznie rozstrzyga audyt.
Agent może zbadać dwie zmiany: dzienną przepustowość do 260 przy jednym progu lub osobne progi dla kanałów przy oryginalnym limicie. Obie wymagają akceptacji człowieka, nie można ich łączyć, a polityka preferuje opcję bez dodatkowych recenzentów.
Co liczy się jako poprawny audyt
Poprawny audyt trafia w cztery elementy i powinieneś je ustalić przed pierwszym żądaniem:
Niezależny ewaluator, którego agent nie może wywołać, oblicza odpowiedź.
Jak skonfigurować Gemini 4 Carbon API w Pythonie
Konfiguracja Gemini 4 Carbon API wymaga Pythona 3.11 lub nowszego oraz klucza API z projektu Google AI Studio z włączonym rozliczaniem, ponieważ strona cen nie przewiduje darmowego progu.
Zainstaluj Google Gen AI SDK i przygotuj projekt
Testowałem ten projekt z Google Gen AI SDK przypiętym do wersji
google-genai==3.1.0, wydaniem na PyPI z dnia premiery, które dodałogemini-4-carbondo listy modeli Interactions. Sklonuj projekt i zainstaluj go w wirtualnym środowisku:Następnie uruchom dwa polecenia ze strony repozytorium, które budują dane i dopasowują klasyfikator ze stałymi ziarnami losowości. Na świeżej kopii wydrukują to:
Stałe ziarna odtwarzają ten sam zbiór danych. Obraz: autor.
Potem umieść
GEMINI_API_KEY=your-keyw pliku.env. Repozytorium go wczytuje, nie drukując.Zrób swoje pierwsze zapytanie do Gemini 4 Carbon API
Uruchom ten kompletny przykład z folderu projektu. Przekazuje Gemini 4 Carbon politykę i podsumowanie klasyfikatora oraz pyta, co trzeba by zmierzyć — bez sugerowania konfliktu:
Poziom rozumowania trafia do
generation_config, aoutput_textzawiera odpowiedź. Oto fragment, który wrócił:Odczytał R3 jako maksimum i ułożył kolejność preferencji polityki, zanim zobaczył jakąkolwiek liczbę. Nie zapytał jednak, jak działają remisy czy zaokrąglanie skoru, a wyczerpująca kontrola, którą pokażę później, dokładnie od tego zależy. Wywołanie trwało około 40 sekund i kosztowało około 2 centów.
Pomiń
temperature,top_pitop_k, które Gemini 4 Carbon ignoruje, orazthinking_budget.Jak zbudować agenta audytu ML z wywoływaniem funkcji w Gemini 4 Carbon
Agent audytu Gemini 4 Carbon to pętla: model żąda ewaluacji, Python ją weryfikuje i wykonuje, a wynik wraca dopóki model nie przestanie prosić.
Zdefiniuj narzędzia tylko do odczytu do oceny modelu
Agent dostaje trzy narzędzia. Wszystkie są ograniczone do okna walidacyjnego:
get_audit_context: podsumowanie klasyfikatora, obecna konfiguracja, polityka i dozwolone zmianyevaluate_global_threshold: recall wartości nadużyć łącznie i per kanał, liczba oznaczeń na dzień oraz diagnostyka dla jednego proguevaluate_policy_change: te same pomiary dla zwiększenia przepustowości lub pary progów kanałowychPełne schematy są w repozytorium. Ten uproszczony wycinek pomija pola progu i przepustowości, więc nie jest kompletną deklaracją do skopiowania. Pokazuje tylko ważną tu granicę: narzędzie akceptuje dwie zmiany polityki dozwolone przez PayGuard, czyta dane walidacyjne i niczego nie zatwierdza.
Python weryfikuje pominięte pola progu i przepustowości, odrzuca zmiany poza polityką i zwraca pomiary zamiast flag pass/fail. Agent nie może dostać się do holdoutu, wywołać ewaluatora ani zmienić polityki. W FAQ wyjaśniam, czemu pominąłem wbudowane wykonywanie kodu przez Gemini 4 Carbon.
Daj agentowi jasny cel i zasady zatrzymania
Instrukcja systemowa ustawia metodę. Jak pierwsze żądanie, nie sugeruje, gdzie jest konflikt:
Prompt może tylko prosić, więc limity mieszkają w harnessie agenta, czyli kodzie Pythona wokół modelu. Ponieważ API nie ma ustawienia budżetu, aplikacja ustawiają je per próbę: 25 tur, 60 wywołań narzędzi, 30 minut i 3 $, z kontrolą wydatków między turami.
Zaimplementuj pętlę wywołań funkcji z Interactions API
Każda tura to jedno wywołanie
client.interactions.create(). Gemini 4 Carbon często prosi o kilka narzędzi naraz, więc pętla obsługuje każdy krokfunction_call. To jest rdzeń pętli, a wersja w repo dodaje logowanie i sprawdzanie limitów:Trzymam te ustawienia w jednym słowniku
request, żeby każde kolejne wywołanie je ponawiało.previous_interaction_idprzenosi historię, aletools,system_instructionigeneration_configobowiązują tylko dla jednego interaction. Jeśli tura kończy się jakoincomplete, tomax_output_tokensją ucięło — a za tokeny rozumowania i tak płacisz.Zwróć ustrukturyzowany raport audytowy ze schematem JSON
W przewodniku po ustrukturyzowanych odpowiedziach Google narzędzia plus schemat JSON w jednym żądaniu są funkcją Preview, która obejmuje Gemini 4 Carbon. I tak rozdzieliłem je: tury dochodzeniowe tylko mierzą, a ostatnia tura na tej samej historii i konfiguracji pisze raport ze schematem i bez narzędzi:
AuditReportto model Pydantic z werdyktem, konfliktem, dowodami, rekomendacją i akceptacjami. Python mierzy czas i koszt zamiast prosić Gemini 4 Carbon o ich raportowanie.Uruchom audyt Gemini 4 Carbon na modelu wykrywania nadużyć
Gemini 4 Carbon przeprowadził audyt tak, jak chciałbym, by zrobił to młodszy analityk — z pomiarami przed wnioskami. W pierwszej próbie na poziomie
mediumprzeczytał kontekst audytu, sprawdził około dwudziestu kilku pojedynczych progów i przetestował osiem zmian polityki.Wszystkie 32 wywołania narzędzi, w kolejności. Obraz: autor.
Oceń obecny próg PayGuard
Agent ocenił obecny próg 0,5 i znalazł 91% recallu na Website, 20% recallu w Mobile App, 64% łącznie i 85 oznaczeń w najbardziej pracowity dzień. To oblewa R1 i część R2 dla Mobile App, zostawiając zapas względem R3, więc oczywistym ruchem jest niższy próg.
Przetestuj recall wartości nadużyć względem dziennej przepustowości przeglądu
Obniżenie progu łapie więcej wartości nadużyć i wysyła więcej zamówień do przeglądu. PayGuard potrzebuje wystarczająco dużo pierwszego, trzymając drugie pod dziennym limitem.
Agent spróbował kilku zgrubnych progów w jednej partii, potem zawęził do pojedynczych punktów siatki. Rozstrzygnęły to wywołania 11, 12, 17 i 18 w śladzie.
Na tym oknie walidacyjnym podłoga dla Mobile App wymaga 0,108 lub niżej, bo jeden krok wyżej spada tuż poniżej 70%. Limit wymaga 0,118 lub wyżej. Żaden próg nie spełnia obu.
Recall łączny utrzymuje się do 0,137, więc R1 pozostaje poza konfliktem. Przy 0,108 przeciętny dzień ma około 169 oznaczeń, a tylko jedna sobota przekracza limit. Dlatego polityka używa obciążenia najbardziej pracowitego dnia, a nie średniej dziennej.
Recall w Mobile i przepustowość nigdy się nie pokrywają. Obraz: autor.
Sprawdź wydajność w obu kanałach płatności
Nadużycia w Mobile App, przy słabszych sygnałach, leżą nisko w zakresie skoru. Ściągnięcie jednego progu do 0,108 dla Mobile App wciąga też więcej prawidłowych zamówień z Website i w tę sobotę to one wypychają sumę ponad limit.
Liczba łączna to maskuje: przy 0,118 recall łączny to około 87%, podczas gdy Mobile App jest poniżej swojej podłogi. Jeśli twoja polityka nazywa segmenty, mierz każdy z nich, bo całość może przechodzić, gdy jeden segment oblewa.
Czy Gemini 4 Carbon potrafi wykryć sprzeczne wymagania wdrożeniowe?
Tak, w tym audycie. Zamrożony raport mówi
not deployable, stwierdza, że żaden pojedynczy próg nie działa, i wskazuje R2 dla Mobile App oraz R3 jako konflikt.Sprawdź werdykt wdrożeniowy Gemini 4 Carbon wobec jego dowodów
Każda liczba cytowana w raporcie zgadza się z wynikiem narzędzia, ale jedno zdanie twierdzi więcej, niż agent zmierzył. Mówi, że żaden próg nie działa „na całej siatce punktów co 0,001”, a agent przetestował tylko dwadzieścia kilka z powyższego śladu, z 1 002 możliwych progów.
Teza się broni, ponieważ recall i dzienne zliczenia spadają wraz ze wzrostem progu, czego raport nie mówi. Sprawdź każde twierdzenie w raporcie agenta względem tego, co zmierzył, a nasz przewodnik po ewaluacji agentów AI obejmuje więcej takich kontroli.
Zweryfikuj konflikt wyczerpującym ewaluatorem w Pythonie
Gemini 4 Carbon próbkował progi i wywnioskował, że żaden nie zadziała. Ewaluator dowodzi tego wyniku dla tego zbioru walidacyjnego, sprawdzając każdy odrębny zestaw oznaczeń, bez współdzielenia kodu z narzędziami.
Skory leżą na siatce 0,001, więc 1 002 kandydackie progi pokrywają każdy możliwy zestaw oznaczeń. Ewaluator sprawdza wszystkie z nich oraz każdą parę progów kanałowych, używając całych centów, by 85% i 70% były dokładne.
Wyczerpująca kontrola i cztery odrzucone konfiguracje. Obraz: autor.
Żaden globalny próg nie przechodzi wszystkich trzech reguł, więc teza Gemini 4 Carbon ma teraz za sobą dowód. Ewaluator potwierdził granice 0,108 i 0,118 z sondowania agenta i znalazł tysiące par kanałowych, które przechodzą przy 200 dziennie.
Ewaluator pomaga tylko, jeśli odrzuca złe odpowiedzi, więc podałem mu cztery błędne konfiguracje i odrzucił wszystkie cztery.
Przetestuj alternatywy wdrożenia z Gemini 4 Carbon
Gemini 4 Carbon przetestował obie dozwolone zmiany i wybrał osobne progi przy oryginalnym limicie zamiast dodatkowych recenzentów. Zaznaczył ten wybór jako wyjątek wymagający zgody człowieka.
Przetestuj zwiększenie przepustowości ręcznego przeglądu
Jeden globalny próg działa, jeśli limit wzrośnie z 200 do 205, a ewaluator potwierdził 205 jako najmniejszy wzrost. Gemini 4 Carbon i tak dał tej opcji drugie miejsce, z uwagi na zasadę preferencji opisaną wcześniej.
Przetestuj osobne progi dla każdego kanału płatności
Po stronie kanałów agent trzymał próg Mobile App blisko jego granicy (widział już, że 0,109 łamie podłogę) i podniósł próg dla Website, obniżając liczbę oznaczeń prawidłowych zamówień z Website. Przetestował siedem par i jedna oblała o jedno oznaczenie w najbardziej pracowity dzień. Zarekomendował Website 0,3 i Mobile App 0,1, bo ta para przechodzi wszystkie reguły z zapasem, a ewaluator to potwierdził przy oryginalnym limicie.
Porównaj zweryfikowane alternatywy
Te liczby pojawiły się wyżej, a ewaluator każdą przeliczył:
Opcja
Progi
Łącznie
Website
Mobile App
Najbardziej pracowity dzień
Zgoda
Oryginalna polityka
Globalny 0,108
87,5%
98,2%
70,1%
205, limit 200
Nie przechodzi
Więcej przepustowości
Globalny 0,108
87,5%
98,2%
70,1%
205, limit 205
Wymagana
Podział kanałów
Website 0,3, Mobile App 0,1
86,2%
94,5%
72,8%
191, limit 200
Wymagana
Podział kanałów oznacza też około 6% mniej transakcji niż opcja przepustowości. Mniej niż połowa jego oznaczeń to jednak nadużycia, co raport wymienił jako kwestię otwartą.
Jak zweryfikować rekomendację Gemini 4 Carbon na niewidzianych danych
Rekomendację weryfikujesz, stosując ją — zamrożoną — do zaplombowanego holdoutu. Różnica względem ewaluatora to dane: ewaluator oceniał tygodnie, które agent mógł widzieć, a holdout ocenia cztery późniejsze tygodnie, których żadne narzędzie nie mogło czytać. Kontrola uruchamia się raz na zamrożoną rekomendację i nie wystartuje, jeśli raport zmienił się po zamrożeniu.
Zamrożona rekomendacja przechodzi na holdoucie. Obraz: autor.
Przeszła wszystkie trzy reguły, a najbardziej pracowity dzień pozostał poniżej limitu. Nie wyciągaj jednak z tego zbyt daleko idących wniosków. Trzy rzeczy trzymają ten wynik w ryzach:
Pierwsze dwa wynikają z liczb.
Obejrzyj pełny audyt w Streamlit
Repozytorium zawiera też aplikację Streamlit i sześć nagranych prób, więc możesz otworzyć ten audyt bez wywołania API. Na wideo ładuję go i przechodzę po kolejnych kartach.