Gemini 4 Carbon API Eğitimi: Bir Sahtekarlık Modelini Denetleyen Bir Aracı Oluşturun
Gemini 4 Carbon API’yi Python’da öğrenin: bir sahtekarlık modelini denetleyen, çelişen kuralları bulan ve bir politika değişikliğini test eden fonksiyon çağıran bir aracı oluşturun.
Şu Gemini 4 Argon API Eğitimimizde aracının net bir işi vardı: yavaş kodu bul, değiştir ve gizli testleri geç. Bu eşlik eden deney, kontrollü araçlar ve harici bir kontrol kalıbını koruyor, ancak kararı değiştiriyor. Gemini 4 Carbon, orijinal kuralların hiç uygulanabilir olup olmadığını anlamak zorunda.
Kurgusal bir çevrim içi mağaza olan PayGuard, siparişleri sahtekarlık için puanlayan eğitilmiş bir makine öğrenimi (ML) modeline sahip. Yayına alma politikası, modeli inceleme ekibini bunaltmadan hem toplamda hem de her satış kanalında yeterli sahtekarlık değerini yakalamaya zorluyor. Aracı, geçerli bir eşik olup olmadığı söylenmeden bu kuralları araştırmak zorunda.
Gemini 4 Carbon, Python’dan Interactions API üzerinden çağırdığınız bir Google akıl yürütme modelidir. Burada bir Yapay Zeka aracısı gibi davranır: hangi kontrolleri isteyeceğine o karar verir ve Python bunları fonksiyon çağırma ile üç salt-okunur araç üzerinden çalıştırır. Benim sorum, bir çatışmayı tespit edip kanıtı açıklayabilir ve bu değişikliği onaylanmış saymadan izin verilen bir değişiklik önerebilir mi?
Temel düzeyde Python ve API isteklerine biraz aşinalık gerekecek. Her sahtekarlık metriğini kullanılmadan önce tanımlıyorum. Şunları ele alacağız:
Python’dan Gemini 4 Carbon’a ilk isteği gönderin
Modele salt-okunur araçlar verin ve bunları sınırlı bir döngüde çalıştırın
Kararı, kodunuzun doğrulayabileceği JSON olarak geri alın
Modelin asla görmediği kod ve verilerle bu kararı doğrulayın
Cevaplamadan önce modelin ne kadar akıl yürüteceğini belirleyen iki düşünme seviyesini karşılaştırın
Gemini 4 Carbon API, gemini-4-carbon için ücretli uygulama programlama arayüzüdür (API); model sayfası bunu uzun, çok adımlı aracı görevleri için bir akıl yürütme modeli olarak tanımlar. Girdi, düşünme ve çıktı, 1.048.576 tokenlık bir bağlam penceresini paylaşır ve senkron bir yanıt varsayılan olarak 65.536 token düşünme artı çıktıdan sonra durur.
Neden bir ML modeli denetimi Gemini 4 Carbon için iyi bir testtir
Görev birkaç kontrol, izin verilen değişiklikler arasında bir arama ve kurallar bir yanıt bırakmadığında net bir durma gerektirir. Bunu seçtim çünkü Python referans sonucu hesaplayabilir. Model kartı, Gemini 4 Carbon’un bilinen sınırları arasında halüsinasyonları listeler; bu nedenle modeli, önerisinin geçerli olup olmadığına Python karar verirken araştırma yapar.
Proje: PayGuard’ın Sahtekarlık Modelinin Yayına Alınıp Alınamayacağına Karar Vermek
PayGuard, girişteki kurgusal mağazadır ve projenin tamamı GitHub deposundadır. Sınıflandırıcı zaten eğitilmiştir.
PayGuard işlemleri nasıl puanlar
Her işlemde Eşgüdümlü Evrensel Zaman (UTC) zaman damgası, bir tutar, bir kanal (Web Sitesi veya Mobil Uygulama), bir risk puanı ve bir sahtekarlık etiketi bulunur. Bir scikit-learn HistGradientBoostingClassifier puanı üretir, 0,001’e yuvarlanır ve PayGuard, risk_score >= threshold olduğunda işlemi işaretler. Kesinlik-duyarlılık eğrisi eğitimimiz, bir eşiğin hareket ettirilmesinin nelerin işaretleneceğini nasıl değiştirdiğini gösterir ve Python’da Sahtekarlık Tespiti kursumuz modelleme tarafını kapsar.
Sentetik veri zamana göre bölünmüştür:
Eğitim: yalnızca sınıflandırıcıyı uydurmak için kullanılan ilk dokuz hafta
Doğrulama: araçların okuyabildiği tek pencere olan sonraki dört hafta
Ayrılmış: bunun ardından gelen dört hafta, öneri dondurulana kadar mühürlü
Geçerli eşik 0,5’tir ve deney boyunca veri ve politika asla değişmez. Bu veride Web Sitesi sahtekarlığı net sinyaller bırakırken, çoğu Mobil Uygulama sahtekarlığı sıradan bir sipariş gibi görünür.
Soran Gemini 4 Carbon, karar veren Python. Görsel: Yazar.
PayGuard’ın üç yayına alma kuralı
İşte girişteki üç kural; politikanın yazdığı şekilde. Hepsi bu deney için seçtiğim kurgusal hedeflerdir:
R1: işaretlenen işlemler, etiketli sahtekarlık değerinin en az %85’ini toplamda kapsar
R2: her kanal içinde etiketli sahtekarlık değerinin en az %70’ini kapsarlar
R3: tek bir UTC gününde 200’den fazla işlem işaretlenmez
Sahtekarlık-değeri duyarlılığı, işaretlenen sahtekarlık değerinin toplam sahtekarlık değerine bölünmesidir. Kesinlik ve duyarlılık rehberimizdeki işlem düzeyi duyarlılığın aksine, kaçırılan 2.000 $’lık bir sahtekarlık, kaçırılan 15 $’lık bir sahtekarlıktan çok daha fazla önem taşır ve işaretlemek paranın kurtarıldığı anlamına gelmez. R3, en yoğun tek günü sınırlar ve bu ifade sonunda denetimi belirler.
Aracı iki değişikliği araştırabilir: tek bir eşikle günde en fazla 260’a kadar günlük kapasite veya orijinal sınırda ayrı kanal eşikleri. Her ikisi de insan onayı gerektirir, birleştirilemez ve politika, ekstra değerlendirici gerektirmeyen seçeneği tercih eder.
Doğru denetim ne sayılır
Doğru bir denetim dört şeyi doğru yapar ve bunları ilk istekten önce belirlemelisiniz:
Hüküm: tek bir eşiğin doğrulamada R1, R2 ve R3’ü karşılayıp karşılamadığı
Çatışma: orijinal politikayı imkansız kılan gereksinimler
Alternatif: Python yeniden hesapladığında her kuralı geçen izinli bir değişiklik
Tercih: öneri, politikanın tercih sırasını izler
Aracının çağıramadığı bir değerlendirici yanıtı hesaplar.
Gemini 4 Carbon API’yi Python’da Nasıl Kurarsınız
Gemini 4 Carbon API’yi kurmak için Python 3.11 veya daha yenisi ve faturalandırması açık bir Google AI Studio projesinden bir API anahtarı gerekir; çünkü fiyatlandırma sayfası ücretsiz katman olmadığını belirtir.
Google Gen AI SDK’sını kurun ve projeyi hazırlayın
Bu projeyi, gemini-4-carbon’ı Interactions model listesine ekleyen lansman günü PyPI sürümü olan google-genai==3.1.0 ile test ettim. Projeyi klonlayın ve sanal bir ortamda kurun:
git clone https://github.com/KhalidAbdelaty/gemini-4-carbon-api.git
cd gemini-4-carbon-api
python -m venv .venv
.venv\Scripts\Activate.ps1 # macOS or Linux: source .venv/bin/activate
pip install-r requirements.txtAltyapı:
Bundan sonra, veriyi oluşturan ve sınıflandırıcıyı sabit tohumlarla eğiten, depo sayfasındaki iki komutu çalıştırın. Yeni bir klonda, şunu yazdırırlar:
Sabit tohumlar aynı veri setini yeniden oluşturur. Görsel: Yazar.
Ardından GEMINI_API_KEY=your-key değerini bir .env dosyasına koyun. Depo bunu yazdırmadan yükler.
İlk Gemini 4 Carbon API isteğinizi yapın
Bu tam örneği proje klasöründen çalıştırın. Gemini 4 Carbon’a politikayı ve sınıflandırıcı özetini verir ve bir çatışmaya ima etmeden, neyi ölçmesi gerektiğini sorar:
import json
import os
from dotenv import dotenv_values
from google import genai
import config as cfg # the project's policy text, threshold, and limits
os.environ.pop("GOOGLE_API_KEY",None)# it would take precedence over GEMINI_API_KEY
os.environ["GEMINI_API_KEY"]= dotenv_values(".env")["GEMINI_API_KEY"]
client = genai.Client()
summary = json.loads(open("data/model_summary.json").read())
prompt =("PayGuard is an e-commerce fraud classifier that gives each transaction a risk score from 0 to 1. "f"Model summary: {json.dumps(summary)}\n\n{cfg.POLICY_TEXT}\n\n"f"The current threshold is {cfg.CURRENT_THRESHOLD}. Before you judge whether this model can be ""deployed, list in at most five short bullets the measurements you would need and why.")
interaction = client.interactions.create(
model="gemini-4-carbon",input=prompt,
generation_config={"thinking_level":"medium"},
timeout=900,# Google recommends at least 15 minutes)print(interaction.output_text)
u = interaction.usage
print(f"status={interaction.status} | input={u.total_input_tokens} cached={u.total_cached_tokens} "f"output={u.total_output_tokens} thinking={u.total_thought_tokens}")Altyapı:
Düşünme seviyesi generation_config içine girer ve output_text yanıtı tutar. Geri gelenlerin bir kısmı şuydu:
* Peak single-day UTC flag count at threshold 0.5: The maximum number of transactions
  flagged on any single UTC calendar day, to check ... the strict R3 cap ...
* Channel-specific threshold grid: ... to test the preferred zero-extra-capacity
  alternative (<= 200/day) if no single global threshold complies.

status=completed | input=536 cached=0 output=310 thinking=1412Altyapı:
R3’ü bir tepe değer olarak okudu ve bir sayı görmeden önce politikanın tercih sırasını planladı. Ancak beraberliklerin veya puan yuvarlamanın nasıl çalıştığını asla sormadı ve birazdan göstereceğim kapsamlı kontrol tam da buna bağlı. Çağrı yaklaşık 40 saniye sürdü ve yaklaşık 2 sent tuttu.
temperature, top_p ve top_k ayarlarını eklemeyin; Gemini 4 Carbon bunları yok sayar; ayrıca thinking_budget’i de eklemeyin.
Gemini 4 Carbon Fonksiyon Çağırma ile Bir ML Denetim Aracısı Nasıl Kurulur
Bir Gemini 4 Carbon denetim aracısı bir döngüdür: model bir değerlendirme ister, Python bunu doğrular ve çalıştırır ve model istemeyi bırakana kadar sonuç geri gönderilir.
Model değerlendirme için salt-okunur araçlar tanımlayın
Aracı üç araç alır. Hepsi doğrulama penceresiyle sınırlıdır:
get_audit_context: sınıflandırıcı özeti, mevcut yapılandırma, politika ve izin verilen değişiklikler
evaluate_global_threshold: tek bir eşik için toplamda ve kanala göre sahtekarlık-değeri duyarlılığı, gün başına işaretler ve tanılama
evaluate_policy_change: kapasite artışı veya bir kanal-eşik çifti için aynı ölçümler
Tam şemalar depoda. Bu sadeleştirilmiş alıntı, eşik ve kapasite alanlarını atlar; bu yüzden kopyalanacak eksiksiz bir bildirim değildir. Burada önemli olan sınırı gösterir: araç, PayGuard’ın izin verdiği iki politika değişikliğini kabul eder, doğrulama verilerini okur ve hiçbir şeyi onaylamaz.
{"type":"function","name":"evaluate_policy_change","description":("Evaluate one allowed policy change on validation. ""Read-only; it approves nothing."),"parameters":{"type":"object","properties":{"change_type":{"type":"string","enum":["capacity_increase","channel_thresholds"]}},"required":["change_type"]}}Altyapı:
Python, atlanan eşik ve kapasite alanlarını doğrular, politika dışındaki değişiklikleri reddeder ve geçme/kalma bayrakları yerine ölçümler döndürür. Aracı, ayrılmış kümeye ulaşamaz, değerlendiriciyi çağıramaz veya politikayı değiştiremez. SSS’de neden Gemini 4 Carbon’un yerleşik kod yürütmesini atladığımı açıklıyorum.
Aracıya net bir hedef ve durdurma kuralları verin
Sistem talimatı yöntemi belirler. İlk istek gibi, çatışmanın nerede olduğuna dair ipucu vermez:
- Read the audit context first, then evaluate the current configuration before anything else.
- Check every requirement yourself by comparing tool numbers with the policy text: R1, R2 for
  Website, R2 for Mobile App, and R3. R3 is a limit on the busiest single day, not on the average.
- Use only numbers that a tool returned. Do not estimate a metric you have not measured.
- If the evidence does not settle a question, say so. Inconclusive is an acceptable answer.Altyapı:
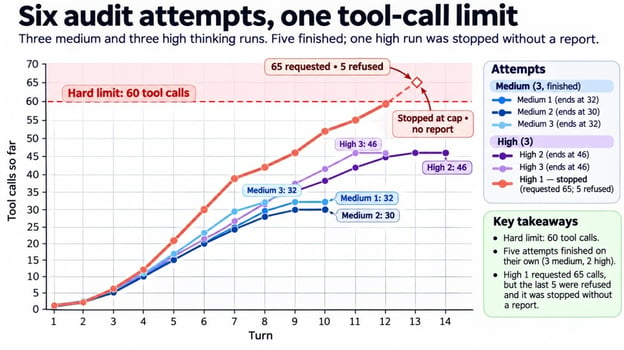
İstem yalnızca isteyebilir; bu nedenle sınırlar, modelin etrafındaki Python kodu olan aracı kılıfında bulunur. API’nin bütçe ayarı olmadığından, uygulama bunları deneme başına ayarlar: 25 tur, 60 araç çağrısı, 30 dakika ve 3 $, harcama turlar arasında kontrol edilir.
Interactions API ile fonksiyon çağırma döngüsünü uygulayın
Her tur bir client.interactions.create() çağrısıdır. Gemini 4 Carbon sıklıkla aynı anda birkaç araç ister; bu yüzden döngü, her function_call adımını çalıştırır. Burası çekirdek döngüdür; depo sürümü günlükleme ve sınır kontrolleri ekler:
request =dict(model="gemini-4-carbon", system_instruction=SYSTEM_INSTRUCTION, tools=DECLARATIONS,
generation_config={"thinking_level": level,"max_output_tokens":65_536,"thinking_summaries":"auto"})
interaction = client.interactions.create(input=TASK, timeout=900,**request)whileTrue:
calls =[s for s in interaction.steps if s.type=="function_call"]if interaction.status in("failed","cancelled","incomplete")ornot calls:break# incomplete: the output cap cut the turn off
results =[]for call in calls:
out, is_error = tools.call(call.name,dict(call.arguments))# allowlisted, validated
results.append({"type":"function_result","name": call.name,"call_id": call.id,"is_error": is_error,"result":[{"type":"text","text": json.dumps(out)}]})# turn, tool-call, time, and spend limits are checked here, before the next request
interaction = client.interactions.create(input=results, previous_interaction_id=interaction.id,
timeout=900,**request)Altyapı:
request ayarlarını tek bir sözlükte tutarım ki her takip çağrısı bunları yeniden göndersin. previous_interaction_id geçmişi taşır; ancak tools, system_instruction ve generation_config yalnızca bir etkileşime uygulanır. Bir tur incomplete biterse, max_output_tokens onu kesti ve yine de düşünme tokenları için ücret ödersiniz.
JSON şemasıyla yapılandırılmış bir denetim raporu döndürün
Google’ın yapılandırılmış çıktı rehberi, araçları ve JSON şemasını tek bir istekte listeleyen ve Gemini 4 Carbon’u da içeren bir Önizleme özelliğidir. Yine de onları ayrı tuttum: araştırma turları yalnızca ölçer ve aynı geçmiş ve yapılandırma üzerinde bir son tur, araçsız ve bir şemayla raporu yazar:
AuditReport, hüküm, çatışma, kanıt, öneri ve onayları içeren bir Pydantic modeli’dir. Python, bunları Gemini 4 Carbon’dan istemek yerine süre ve maliyeti ölçer.
Sahtekarlık Tespit Modelinde Gemini 4 Carbon Denetimini Çalıştırın
Gemini 4 Carbon, model denetimini bir junior analistten bekleyeceğim şekilde yaptı: herhangi bir sonuçtan önce ölçümlerle. İlk medium denemede, denetim bağlamını okudu, yaklaşık iki düzine tekil eşiği kontrol etti ve sekiz politika değişikliğini test etti.
Sırayla tüm 32 araç çağrısı. Görsel: Yazar.
PayGuard’ın mevcut eşiğini değerlendirin
Aracı, 0,5’lik mevcut eşiği değerlendirdi ve %91 Web Sitesi duyarlılığı, %20 Mobil Uygulama duyarlılığı, %64 toplam duyarlılık ve en yoğun günde 85 işaret buldu. Bu, R1’i ve R2’nin Mobil Uygulama kısmını, R3 altında pay bırakmasına rağmen başarısız kılar; dolayısıyla bariz hamle daha düşük bir eştir.
Sahtekarlık-değeri duyarlılığını günlük inceleme kapasitesine karşı test edin
Eşiğin düşürülmesi daha fazla sahtekarlık değerini yakalar ve daha fazla siparişi incelemeye gönderir. PayGuard, ikincisini günlük bir sınırın altında tutarken birinciden yeterince ister.
Aracı, bir seferde birkaç kaba eşiği denedi, ardından tekil ızgara noktalarına daralttı. İzdeki 11, 12, 17 ve 18 numaralı çağrılar bunu netleştirdi.
Bu doğrulama penceresinde, Mobil Uygulama tabanı %70’in biraz altına düşüren bir adım üstte olduğundan 0,108 veya daha düşük bir eşik gerektirir. Sınır ise 0,118 veya daha yüksek gerekir. Her ikisini de yapan bir eşik yok.
Toplam duyarlılık 0,137’ye kadar ayakta kalır; bu nedenle R1 çatışmanın dışında kalır. 0,108’de ortalama gün yaklaşık 169 işarete sahiptir ve yalnızca bir Cumartesi bunun üzerine çıkar. Politikanın, günlük ortalama yerine en yoğun günün iş yükünü kullanmasının nedeni budur.
Mobil duyarlılık ve kapasite asla örtüşmüyor. Görsel: Yazar.
Her iki ödeme kanalında performansı kontrol edin
Daha zayıf sinyallere sahip Mobil Uygulama sahtekarlığı puan aralığının altlarında yer alır. Eşiği Mobil Uygulama için 0,108’e çekmek, daha fazla meşru Web Sitesi siparişini de içeri alır ve o Cumartesi günü toplamı sınırın üzerine iterler.
Toplam sayı bunu gizler: 0,118’de toplam duyarlılık yaklaşık %87 iken Mobil Uygulama tabanının altındadır. Politikanız segmentleri adıyla anıyorsa, her birini ölçün; çünkü toplam geçerken bir segment başarısız olabilir.
Gemini 4 Carbon Çakışan Yayına Alma Gereksinimlerini Tespit Edebilir mi?
Evet, bu denetimde. Donmuş rapor not deployable diyor, tek bir eşik çalışmıyor diyor ve çatışma olarak Mobil Uygulama için R2 ile R3’ü adlandırıyor.
Gemini 4 Carbon’un yayına alma hükmünü kanıtlarıyla karşılaştırın
Raporun alıntıladığı her sayı bir araç sonucuyla eşleşir; ancak bir cümle, aracının ölçtüğünden fazlasını iddia eder. "Tüm 0,001 risk puanı ızgara noktalarında" hiçbir eşiğin çalışmadığını söylüyor; oysa aracı, 1.002 olası eşikten yalnızca yukarıdaki izdeki iki düzineyi test etti.
İddia geçerlidir; çünkü eşik yükseldikçe hem duyarlılık hem de günlük sayımlar düşer; ancak rapor bunu söylemez. Bir aracının raporundaki her iddiayı, ölçtüklerine karşı kontrol edin; yapay zeka aracılarının değerlendirilmesi rehberimiz bu tür daha fazla kontrolü kapsar.
Çatışmayı kapsamlı bir Python değerlendiricisiyle doğrulayın
Gemini 4 Carbon eşikleri örnekledi ve hiçbirinin çalışamayacağını çıkarsadı. Değerlendirici, araçlarla kod paylaşmadan her farklı işaret setini kontrol ederek bu doğrulama kümesi için sonucu kanıtlar.
Puanlar 0,001’lik bir ızgaraya oturur; bu nedenle 1.002 aday kesme noktası tüm olası işaret setlerini kapsar. Değerlendirici bunların tamamını ve her kanal eşiği çiftini, 85% ve 70% tam olsun diye tamsayı sentler kullanarak kontrol eder.
Kapsamlı kontrol ve reddedilen dört yapılandırma. Görsel: Yazar.
Hiçbir küresel eşik üç kuralın tamamını geçmiyor; bu nedenle Gemini 4 Carbon’un iddiasının artık arkasında kanıt var. Değerlendirici, aracının yoklayarak bulduğu 0,108 ve 0,118 sınırlarıyla eşleşti ve günde 200’de geçen binlerce kanal çifti buldu.
Bir değerlendirici yalnızca kötü yanıtları reddederse faydalıdır; bu yüzden ona dört yanlış yapılandırma verdim ve dördünü de reddetti.
Gemini 4 Carbon ile Yayına Alma Alternatiflerini Test Edin
Gemini 4 Carbon her iki izinli değişikliği de test etti ve ekstra değerlendiriciler yerine orijinal sınırda ayrı eşikleri seçti. Bu seçimi, bir kişinin onaylaması gereken bir istisna olarak işaretledi.
Manuel inceleme kapasitesinde artışı test edin
Küresel tek eşik, sınır 200’den 205’e çıkarsa çalışır ve değerlendirici, en küçük artış olarak 205’i doğruladı. Gemini 4 Carbon yine de bu seçeneği ikinci sıraya koydu; daha önce açıkladığım tercih kuralı nedeniyle.
Her ödeme kanalı için ayrı eşikleri test edin
Kanal tarafında, aracı Mobil Uygulama eşiğini sınırına yakın tuttu (0,109’un tabanı bozduğunu zaten görmüştü) ve Web Sitesi eşiğini yükseltti; böylece meşru Web Sitesi siparişlerindeki işaretleri düşürdü. Yedi çifti test etti ve biri en yoğun günde tek bir işaretle başarısız oldu. Web Sitesi 0,3 ve Mobil Uygulama 0,1’i önerdi; çünkü bu çift her kuralı rahatlıkla geçiyor ve değerlendirici bunu orijinal sınırda doğruladı.
Doğrulanmış alternatifleri karşılaştırın
Bu sayılar yukarıda geçti ve değerlendirici her birini yeniden hesapladı:
Seçenek
Eşikler
Toplam
Web Sitesi
Mobil Uygulama
En yoğun gün
Onay
Orijinal politika
Küresel 0,108
%87,5
%98,2
%70,1
205, sınır 200
Başarısız
Daha fazla kapasite
Küresel 0,108
%87,5
%98,2
%70,1
205, sınır 205
Gerekli
Kanal bölümü
Web Sitesi 0,3, Mobil Uygulama 0,1
%86,2
%94,5
%72,8
191, sınır 200
Gerekli
Kanal bölümü, kapasite seçeneğine kıyasla yaklaşık %6 daha az işlemi işaretler. Ancak işaretlerin yarısından azı sahtekarlıktır; rapor bunu açık bir mesele olarak listeledi.
Gemini 4 Carbon’un Önerisini Görülmeyen Veride Nasıl Doğrularsınız
Öneriyi, dondurulmuş halde, mühürlü ayrılmış kümeye uygulayarak doğrularsınız. Değerlendiriciden farkı veridir: değerlendirici, aracının görebildiği haftaları puanladı ve ayrılmış küme, hiçbir aracın okuyamadığı dört sonraki haftayı puanlar. Kontrol, donmuş öneri başına bir kez çalışır ve rapor dondurma sonrası değiştiyse başlamaz.
Donmuş öneri ayrılmış kümede geçiyor. Görsel: Yazar.
Üç kuralın hepsini geçti ve en yoğun gün sınırın altında kaldı. Yine de bundan fazla anlam çıkarmayın. Üç şey bu sonucu mütevazı kılar:
Ayrılmış küme aynı üreteçten gelir; bu nedenle yeni sahtekarlık türleri veya veri kayması hakkında bir şey söylemez
Toplam duyarlılık %85’i iki puandan az farkla geçti
Test etmediğim tahminim: Mobil Uygulama trafiği Web Sitesi trafiğinden daha hızlı büyürse, Mobil Uygulama eşiği çok düşükte durduğu için bölüm sınırı aşabilir
İlk ikisi sayılardan gelir.
Tüm denetimi Streamlit’te izleyin
Depoda ayrıca bir Streamlit uygulaması ve altı kaydedilmiş deneme bulunur; böylece bu denetimi API çağrısı olmadan açabilirsiniz. Videoda, uygulamayı yüklüyor ve her sekmeyi adım adım geçiyorum.
Streamlit uygulaması tek bir denetimi gösterir. Video: Yazar.
Gemini 4 Carbon Orta vs. Yüksek Düşünme: Doğruluk, Süre ve Maliyet
Burada başarı, uygulama sınırları içinde bitirmek ve değerlendiricinin kabul ettiği bir rapor döndürmektir. Durdurulan bir denemenin puanlanacak bir hükmü yoktur. Bu tanıma göre, medium her denemeyi tamamladı ve doğru denetim başına yarıdan az maliyete mal oldu.
Altı deneme bunu genel bir kural yapmak için çok az. Düşünme seviyeleri sizin için yeniyse, Gemini 3.8 Flash API eğitimimizthinking_level ayarını daha ayrıntılı ele alır.
Aynı denetimde orta ve yüksek düşünmeyi karşılaştırın
TL;DR’nin arkasındaki tam karşılaştırma bu. Her seviye için 3 deneme yaptım; her biri diğerlerini hatırlamayan temiz bir durumdan, aynı veri, istem, araçlar, sınırlar ve değerlendiriciyle:
Seviye başına
medium
high
Raporla biten denemeler
3 / 3
2 / 3
Bunlar arasında doğru denetimler
3 / 3
2 / 2
Deneme başına düşünme tokenı
Yaklaşık 7.700
Yaklaşık 17.500
Deneme başına süre
Yaklaşık 5 dakika
Yaklaşık 6 dakika
Doğru denetim başına maliyet, giriş oranı
Yaklaşık 0,25 $
Yaklaşık 0,62 $
Doğru denetim başına maliyet, standart oran
Yaklaşık 0,51 $
Yaklaşık 1,24 $
Maliyet satırları, duran bir deneme dahil her denemenin harcamasını sayar. Tamamlanan her deneme aynı hükme ve çatışmaya ulaştı ve değerlendiricinin kabul ettiği bir kanal çifti seçti; dolayısıyla ekstra düşünme daha fazla kontrole gitti.
Gemini 4 Argon kodlama deneyinde benzer bir desen gördüm: highdaha fazla harcadı ve doğrulanmış sonuçta daha küçük bir değişim için daha fazla iş yaptı. Görevler farklıdır; bu yüzden maliyetleri ve başarı oranları doğrudan karşılaştırılamaz. Her iki durumda da bağımsız kontrol, düşünme toplamından daha fazla şey anlatır.
Neden bir yüksek-düşünme denemesi hiç bitmedi
Duran deneme high’ın ilkiydi ve asla yanlış bir hüküm vermedi. 0,101’den 0,119’a kadar her ızgara noktasını yokladı; sonra hiçbir şeyin bağlı olmadığı Web Sitesi’nin %70 sınırını aramaya çıktı ve daha fazla kontrol istemeye devam ederek, daha önce belirlediğim 60 çağrı sınırına ulaştı; uygulama bir rapor yazmadan önce onu durdurdu.
Yalnızca bir deneme sınıra çarptı. Görsel: Yazar.
Bu durdurma faydalı olan kısım. Daha az çağrı isteyen bir istem onu bitirmezdi; koddaki sınır ise, yaklaşık 22 sent sonra bitirdi.
Tamamlanan beş rapor Python’un diğer kontrollerini de geçti. Hiçbiri mevcut yapılandırmayı yanlış okumadı, çatışma dışındaki bir gereksinimi adlandırmadı, var olmayan bir araç çağrısını alıntılamadı veya test etmediği bir yapılandırmayı önermedi.
Denetim başına token, süre ve maliyeti ölçün
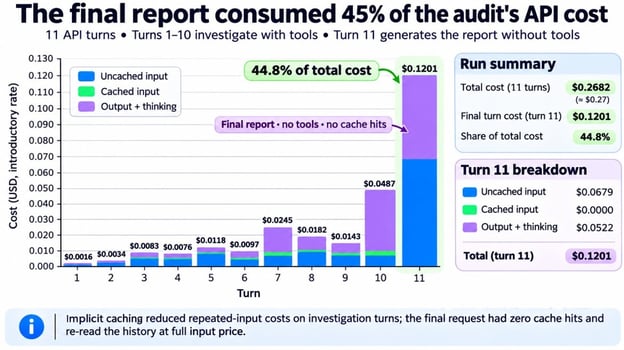
Bir denetimin maliyeti, her turun usage toplamıdır; milyon başına 2,00 $ girdi, 0,10 $ önbellek ve düşünme dahil 10,00 $ çıktı olarak fiyatlanır; hepsi 1 Aralık 2026’da iki katına çıkar. total_input_tokens önbelleğe alınan tokenları içerir; bu nedenle kod iki kısmı ayrı fiyatlar.
Rapor turu en pahalı olandır. Görsel: Yazar.
Sürpriz, raporun kendisi, daha doğrusu faturasıydı. Dolaylı önbellekleme, araştırma turlarındaki girdi tokenlarının yaklaşık dörtte üçünü karşıladı; ancak araçsız rapor isteği asla bir önbellek isabeti almadı.
Muhtemel neden, tools öğesinin düşmesi, isteğin başlangıcını değiştirir. Her halükarda, bu tur tüm geçmişi tam fiyattan yeniden okudu ve tamamlanan her denemenin maliyetinin yaklaşık %40’ını aldı. Harcama sınırınızı ayarlarken bu turu da sayın.
ML Modeli Denetimi İçin Gemini 4 Carbon Kullanmanın Sınırlamaları
Bu testi kendim tasarladım ve verisini kendim ürettim; bu nedenle sonuçlar şu sınırlara sahiptir:
Veri sentetiktir ve tek bir sınıflandırıcıdan gelir ve API çağrısından önce bir çatışma var olana kadar üreteci ayarladım
Hüküm yalnızca bu sınıflandırıcıyı kapsar ve daha iyisi tek bir eşikle üç kuralın tamamını karşılayabilir
Bir eşik kontrol edilebilir; ancak bir kanal bölümü onaylamak, iş ve adalet yargısıdır
Ücretli katmanda etkileşimler varsayılan olarak 55 gün saklanır ve store=false, previous_interaction_id kullanımını dışlar; bu nedenle işlem satırları gönderen bir aracı, bir veri incelemesi gerektirir
Değerlendirici, eşiği kendi başına, hiçbir model olmadan çözer. İhtiyacınız yalnızca bir eşikse bir optimizasyon çözücüsü kullanın. Gemini 4 Carbon’un kattığı şey bunun etrafındaki denetimdi.
Buradaki hiçbir şey sahtekarlığa özgü değil. Kurulum, kurallarını Python’un ölçebildiği herhangi bir modele uyar.
Son Düşünceler
Ana sonuç, Gemini 4 Carbon’un orijinal politikanın geçerli bir küresel eşiğe sahip olmadığını fark etmesidir. Tamamlanan 5 denemenin tümü çatışmayı adlandırdı ve değerlendiricinin kabul ettiği bir kanal bölümünü önerdi; bir high deneme rapor üretmeden önce durdu.
Gemini 4 Argon ve Gemini 4 Carbon deneyleri, aracı güvenilirliğinin iki yönünü test eder. Gemini 4 Argon aracısı kodu değiştirdi ve davranışı korumak zorundaydı; Gemini 4 Carbon aracısı ise orijinal cevabı imkansız kılan kurallar altında bir karara vardı. Her ikisi de dar araçlar, kaynak sınırları ve modelin dışında bir kontrol gerektirdi.
Bir aracı için kullanacağım standart budur: araçlarının neyi kanıtlayabileceğini tanımlayın, sonucu bağımsız olarak doğrulayın ve kanıt tükendiğinde inconclusiveyanıtına izin verin. Sonraki adımda, aynı politika altında iki veya üç aday sınıflandırıcıyı koyar ve hangisinin, varsa, sevk edilebileceğini sorardım.
Veri hatları, bulut ve YZ araçları üzerinde çalışan; aynı zamanda DataCamp ve gelişmekte olan geliştiriciler için pratik, yüksek etkili eğiticiler yazan bir veri mühendisi ve topluluk inşacısıyım.
SSS
Gemini 4 Carbon API’ye nasıl erişim elde ederim?⌄
Ücretli bir Google AI Studio projesi aracılığıyla veya Google Cloud üzerinde işletmeler için Gemini aracılığıyla. Gemini uygulaması, Antigravity ve AI Mode da Google AI Ultra abonelerine sunar; ancak bu tüketici uygulamaları size bir API anahtarı vermez.
Gemini 4 Carbon API ne kadara mal olur?⌄
Buradaki 6 denetimin toplamı giriş oranında 2,00 $ tuttu. Bu tür standart istekler, bir istek 4.096 girdi tokenını aştığında dolaylı önbellekleme alır; dolayısıyla her isteğin başlangıcını aynı tutun. Interactions isteklerinin de desteklediği esnek kestirim (flex inference), daha yavaş ve daha az güvenilir yanıtlara karşılık token oranlarını yarıya indirir.
Gemini 4 Carbon API için hız (rate) sınırları nelerdir?⌄
Ücretli projelerin dakika başına sınırları ve bir harcama sınırı vardır; Seviye 1’de 10 dakikalık kayan pencerede 10 $’dır ve aşmak 429 RESOURCE_EXHAUSTED döndürür. Buradaki bir denetim 1 $’ın altına mal oldu; bu nedenle yalnızca çok sayıda paralel deneme bunu vurur. Sınırlar seviyenizle artar; projeniz için Google’ın oran sınırları sayfasını kontrol edin.
Gemini 4 Carbon’da orta ve yüksek düşünme arasındaki fark nedir?⌄
Gemini 4 Carbon’un üç seviyesi vardır: low, medium (varsayılan) ve high ve burada yalnızca en üstteki ikisini karşılaştırdım. Ek düşünmenin nasıl göründüğünü görmek için thinking_summaries ayarını "auto" olarak belirleyin; her yanıtın yanında yoğunlaştırılmış özetler alırsınız. Varsayılan olarak kapalıdırlar ve model zar zor akıl yürüttüğünde boş dönebilirler.
Gemini 4 Carbon Python kodu çalıştırabilir mi?⌄
Evet. {"type": "code_execution"} ögesini tools listesine ekleyin; Gemini 4 Carbon, normal token oranlarıyla ücretlendirilerek Google tarafında Python yazıp çalıştırabilir. Bunu, kontrolü kendi tarafımda tutmak için dışarıda bıraktım: üç araç, neyi ölçebileceğini belirler ve ham işlemler ile ayrılmış küme makinemden asla çıkmaz.
Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!
Requesty’nin birleşik LLM geçidi, failover’lar, önbellekleme ve analitiklerini kullanarak birden çok sağlayıcıda güvenilir, maliyet-etkin yapay zeka uygulamaları oluşturmayı öğrenin.
Analyze data smarter with Gemini in Google Sheets. Use AI-powered insights, formula suggestions, and automation to simplify spreadsheets and boost productivity.
Connect data sources to your app to build a search and analysis engine. Master capabilities like deep research agents, ideation, and NotebookLM for analysis.










Şu Gemini 4 Argon API Eğitimimizde aracının net bir işi vardı: yavaş kodu bul, değiştir ve gizli testleri geç. Bu eşlik eden deney, kontrollü araçlar ve harici bir kontrol kalıbını koruyor, ancak kararı değiştiriyor. Gemini 4 Carbon, orijinal kuralların hiç uygulanabilir olup olmadığını anlamak zorunda.
Kurgusal bir çevrim içi mağaza olan PayGuard, siparişleri sahtekarlık için puanlayan eğitilmiş bir makine öğrenimi (ML) modeline sahip. Yayına alma politikası, modeli inceleme ekibini bunaltmadan hem toplamda hem de her satış kanalında yeterli sahtekarlık değerini yakalamaya zorluyor. Aracı, geçerli bir eşik olup olmadığı söylenmeden bu kuralları araştırmak zorunda.
Gemini 4 Carbon, Python’dan Interactions API üzerinden çağırdığınız bir Google akıl yürütme modelidir. Burada bir Yapay Zeka aracısı gibi davranır: hangi kontrolleri isteyeceğine o karar verir ve Python bunları fonksiyon çağırma ile üç salt-okunur araç üzerinden çalıştırır. Benim sorum, bir çatışmayı tespit edip kanıtı açıklayabilir ve bu değişikliği onaylanmış saymadan izin verilen bir değişiklik önerebilir mi?
Temel düzeyde Python ve API isteklerine biraz aşinalık gerekecek. Her sahtekarlık metriğini kullanılmadan önce tanımlıyorum. Şunları ele alacağız:
Lansman hikayesi ve kıyaslama puanları için Gemini 4 Carbon genel bakışımız onları içerir ve Claude Fable 5.2 vs. Gemini 4 Carbon karşılaştırmamız iki modeli kıyaslar. Bu deneyi, Google API’yi ücretli geliştiricilere açtıktan bir gün sonra yaptım.
Gemini 4 Carbon API Nedir?
Gemini 4 Carbon API,
gemini-4-carboniçin ücretli uygulama programlama arayüzüdür (API); model sayfası bunu uzun, çok adımlı aracı görevleri için bir akıl yürütme modeli olarak tanımlar. Girdi, düşünme ve çıktı, 1.048.576 tokenlık bir bağlam penceresini paylaşır ve senkron bir yanıt varsayılan olarak 65.536 token düşünme artı çıktıdan sonra durur.Neden bir ML modeli denetimi Gemini 4 Carbon için iyi bir testtir
Görev birkaç kontrol, izin verilen değişiklikler arasında bir arama ve kurallar bir yanıt bırakmadığında net bir durma gerektirir. Bunu seçtim çünkü Python referans sonucu hesaplayabilir. Model kartı, Gemini 4 Carbon’un bilinen sınırları arasında halüsinasyonları listeler; bu nedenle modeli, önerisinin geçerli olup olmadığına Python karar verirken araştırma yapar.
Proje: PayGuard’ın Sahtekarlık Modelinin Yayına Alınıp Alınamayacağına Karar Vermek
PayGuard, girişteki kurgusal mağazadır ve projenin tamamı GitHub deposundadır. Sınıflandırıcı zaten eğitilmiştir.
PayGuard işlemleri nasıl puanlar
Her işlemde Eşgüdümlü Evrensel Zaman (UTC) zaman damgası, bir tutar, bir kanal (Web Sitesi veya Mobil Uygulama), bir risk puanı ve bir sahtekarlık etiketi bulunur. Bir scikit-learn
HistGradientBoostingClassifierpuanı üretir, 0,001’e yuvarlanır ve PayGuard,risk_score >= thresholdolduğunda işlemi işaretler. Kesinlik-duyarlılık eğrisi eğitimimiz, bir eşiğin hareket ettirilmesinin nelerin işaretleneceğini nasıl değiştirdiğini gösterir ve Python’da Sahtekarlık Tespiti kursumuz modelleme tarafını kapsar.Sentetik veri zamana göre bölünmüştür:
Geçerli eşik 0,5’tir ve deney boyunca veri ve politika asla değişmez. Bu veride Web Sitesi sahtekarlığı net sinyaller bırakırken, çoğu Mobil Uygulama sahtekarlığı sıradan bir sipariş gibi görünür.
Soran Gemini 4 Carbon, karar veren Python. Görsel: Yazar.
PayGuard’ın üç yayına alma kuralı
İşte girişteki üç kural; politikanın yazdığı şekilde. Hepsi bu deney için seçtiğim kurgusal hedeflerdir:
Sahtekarlık-değeri duyarlılığı, işaretlenen sahtekarlık değerinin toplam sahtekarlık değerine bölünmesidir. Kesinlik ve duyarlılık rehberimizdeki işlem düzeyi duyarlılığın aksine, kaçırılan 2.000 $’lık bir sahtekarlık, kaçırılan 15 $’lık bir sahtekarlıktan çok daha fazla önem taşır ve işaretlemek paranın kurtarıldığı anlamına gelmez. R3, en yoğun tek günü sınırlar ve bu ifade sonunda denetimi belirler.
Aracı iki değişikliği araştırabilir: tek bir eşikle günde en fazla 260’a kadar günlük kapasite veya orijinal sınırda ayrı kanal eşikleri. Her ikisi de insan onayı gerektirir, birleştirilemez ve politika, ekstra değerlendirici gerektirmeyen seçeneği tercih eder.
Doğru denetim ne sayılır
Doğru bir denetim dört şeyi doğru yapar ve bunları ilk istekten önce belirlemelisiniz:
Aracının çağıramadığı bir değerlendirici yanıtı hesaplar.
Gemini 4 Carbon API’yi Python’da Nasıl Kurarsınız
Gemini 4 Carbon API’yi kurmak için Python 3.11 veya daha yenisi ve faturalandırması açık bir Google AI Studio projesinden bir API anahtarı gerekir; çünkü fiyatlandırma sayfası ücretsiz katman olmadığını belirtir.
Google Gen AI SDK’sını kurun ve projeyi hazırlayın
Bu projeyi,
gemini-4-carbon’ı Interactions model listesine ekleyen lansman günü PyPI sürümü olangoogle-genai==3.1.0ile test ettim. Projeyi klonlayın ve sanal bir ortamda kurun:Bundan sonra, veriyi oluşturan ve sınıflandırıcıyı sabit tohumlarla eğiten, depo sayfasındaki iki komutu çalıştırın. Yeni bir klonda, şunu yazdırırlar:
Sabit tohumlar aynı veri setini yeniden oluşturur. Görsel: Yazar.
Ardından
GEMINI_API_KEY=your-keydeğerini bir.envdosyasına koyun. Depo bunu yazdırmadan yükler.İlk Gemini 4 Carbon API isteğinizi yapın
Bu tam örneği proje klasöründen çalıştırın. Gemini 4 Carbon’a politikayı ve sınıflandırıcı özetini verir ve bir çatışmaya ima etmeden, neyi ölçmesi gerektiğini sorar:
Düşünme seviyesi
generation_configiçine girer veoutput_textyanıtı tutar. Geri gelenlerin bir kısmı şuydu:R3’ü bir tepe değer olarak okudu ve bir sayı görmeden önce politikanın tercih sırasını planladı. Ancak beraberliklerin veya puan yuvarlamanın nasıl çalıştığını asla sormadı ve birazdan göstereceğim kapsamlı kontrol tam da buna bağlı. Çağrı yaklaşık 40 saniye sürdü ve yaklaşık 2 sent tuttu.
temperature,top_pvetop_kayarlarını eklemeyin; Gemini 4 Carbon bunları yok sayar; ayrıcathinking_budget’i de eklemeyin.Gemini 4 Carbon Fonksiyon Çağırma ile Bir ML Denetim Aracısı Nasıl Kurulur
Bir Gemini 4 Carbon denetim aracısı bir döngüdür: model bir değerlendirme ister, Python bunu doğrular ve çalıştırır ve model istemeyi bırakana kadar sonuç geri gönderilir.
Model değerlendirme için salt-okunur araçlar tanımlayın
Aracı üç araç alır. Hepsi doğrulama penceresiyle sınırlıdır:
get_audit_context: sınıflandırıcı özeti, mevcut yapılandırma, politika ve izin verilen değişikliklerevaluate_global_threshold: tek bir eşik için toplamda ve kanala göre sahtekarlık-değeri duyarlılığı, gün başına işaretler ve tanılamaevaluate_policy_change: kapasite artışı veya bir kanal-eşik çifti için aynı ölçümlerTam şemalar depoda. Bu sadeleştirilmiş alıntı, eşik ve kapasite alanlarını atlar; bu yüzden kopyalanacak eksiksiz bir bildirim değildir. Burada önemli olan sınırı gösterir: araç, PayGuard’ın izin verdiği iki politika değişikliğini kabul eder, doğrulama verilerini okur ve hiçbir şeyi onaylamaz.
Python, atlanan eşik ve kapasite alanlarını doğrular, politika dışındaki değişiklikleri reddeder ve geçme/kalma bayrakları yerine ölçümler döndürür. Aracı, ayrılmış kümeye ulaşamaz, değerlendiriciyi çağıramaz veya politikayı değiştiremez. SSS’de neden Gemini 4 Carbon’un yerleşik kod yürütmesini atladığımı açıklıyorum.
Aracıya net bir hedef ve durdurma kuralları verin
Sistem talimatı yöntemi belirler. İlk istek gibi, çatışmanın nerede olduğuna dair ipucu vermez:
İstem yalnızca isteyebilir; bu nedenle sınırlar, modelin etrafındaki Python kodu olan aracı kılıfında bulunur. API’nin bütçe ayarı olmadığından, uygulama bunları deneme başına ayarlar: 25 tur, 60 araç çağrısı, 30 dakika ve 3 $, harcama turlar arasında kontrol edilir.
Interactions API ile fonksiyon çağırma döngüsünü uygulayın
Her tur bir
client.interactions.create()çağrısıdır. Gemini 4 Carbon sıklıkla aynı anda birkaç araç ister; bu yüzden döngü, herfunction_calladımını çalıştırır. Burası çekirdek döngüdür; depo sürümü günlükleme ve sınır kontrolleri ekler:requestayarlarını tek bir sözlükte tutarım ki her takip çağrısı bunları yeniden göndersin.previous_interaction_idgeçmişi taşır; ancaktools,system_instructionvegeneration_configyalnızca bir etkileşime uygulanır. Bir turincompletebiterse,max_output_tokensonu kesti ve yine de düşünme tokenları için ücret ödersiniz.JSON şemasıyla yapılandırılmış bir denetim raporu döndürün
Google’ın yapılandırılmış çıktı rehberi, araçları ve JSON şemasını tek bir istekte listeleyen ve Gemini 4 Carbon’u da içeren bir Önizleme özelliğidir. Yine de onları ayrı tuttum: araştırma turları yalnızca ölçer ve aynı geçmiş ve yapılandırma üzerinde bir son tur, araçsız ve bir şemayla raporu yazar:
AuditReport, hüküm, çatışma, kanıt, öneri ve onayları içeren bir Pydantic modeli’dir. Python, bunları Gemini 4 Carbon’dan istemek yerine süre ve maliyeti ölçer.Sahtekarlık Tespit Modelinde Gemini 4 Carbon Denetimini Çalıştırın
Gemini 4 Carbon, model denetimini bir junior analistten bekleyeceğim şekilde yaptı: herhangi bir sonuçtan önce ölçümlerle. İlk
mediumdenemede, denetim bağlamını okudu, yaklaşık iki düzine tekil eşiği kontrol etti ve sekiz politika değişikliğini test etti.Sırayla tüm 32 araç çağrısı. Görsel: Yazar.
PayGuard’ın mevcut eşiğini değerlendirin
Aracı, 0,5’lik mevcut eşiği değerlendirdi ve %91 Web Sitesi duyarlılığı, %20 Mobil Uygulama duyarlılığı, %64 toplam duyarlılık ve en yoğun günde 85 işaret buldu. Bu, R1’i ve R2’nin Mobil Uygulama kısmını, R3 altında pay bırakmasına rağmen başarısız kılar; dolayısıyla bariz hamle daha düşük bir eştir.
Sahtekarlık-değeri duyarlılığını günlük inceleme kapasitesine karşı test edin
Eşiğin düşürülmesi daha fazla sahtekarlık değerini yakalar ve daha fazla siparişi incelemeye gönderir. PayGuard, ikincisini günlük bir sınırın altında tutarken birinciden yeterince ister.
Aracı, bir seferde birkaç kaba eşiği denedi, ardından tekil ızgara noktalarına daralttı. İzdeki 11, 12, 17 ve 18 numaralı çağrılar bunu netleştirdi.
Bu doğrulama penceresinde, Mobil Uygulama tabanı %70’in biraz altına düşüren bir adım üstte olduğundan 0,108 veya daha düşük bir eşik gerektirir. Sınır ise 0,118 veya daha yüksek gerekir. Her ikisini de yapan bir eşik yok.
Toplam duyarlılık 0,137’ye kadar ayakta kalır; bu nedenle R1 çatışmanın dışında kalır. 0,108’de ortalama gün yaklaşık 169 işarete sahiptir ve yalnızca bir Cumartesi bunun üzerine çıkar. Politikanın, günlük ortalama yerine en yoğun günün iş yükünü kullanmasının nedeni budur.
Mobil duyarlılık ve kapasite asla örtüşmüyor. Görsel: Yazar.
Her iki ödeme kanalında performansı kontrol edin
Daha zayıf sinyallere sahip Mobil Uygulama sahtekarlığı puan aralığının altlarında yer alır. Eşiği Mobil Uygulama için 0,108’e çekmek, daha fazla meşru Web Sitesi siparişini de içeri alır ve o Cumartesi günü toplamı sınırın üzerine iterler.
Toplam sayı bunu gizler: 0,118’de toplam duyarlılık yaklaşık %87 iken Mobil Uygulama tabanının altındadır. Politikanız segmentleri adıyla anıyorsa, her birini ölçün; çünkü toplam geçerken bir segment başarısız olabilir.
Gemini 4 Carbon Çakışan Yayına Alma Gereksinimlerini Tespit Edebilir mi?
Evet, bu denetimde. Donmuş rapor
not deployablediyor, tek bir eşik çalışmıyor diyor ve çatışma olarak Mobil Uygulama için R2 ile R3’ü adlandırıyor.Gemini 4 Carbon’un yayına alma hükmünü kanıtlarıyla karşılaştırın
Raporun alıntıladığı her sayı bir araç sonucuyla eşleşir; ancak bir cümle, aracının ölçtüğünden fazlasını iddia eder. "Tüm 0,001 risk puanı ızgara noktalarında" hiçbir eşiğin çalışmadığını söylüyor; oysa aracı, 1.002 olası eşikten yalnızca yukarıdaki izdeki iki düzineyi test etti.
İddia geçerlidir; çünkü eşik yükseldikçe hem duyarlılık hem de günlük sayımlar düşer; ancak rapor bunu söylemez. Bir aracının raporundaki her iddiayı, ölçtüklerine karşı kontrol edin; yapay zeka aracılarının değerlendirilmesi rehberimiz bu tür daha fazla kontrolü kapsar.
Çatışmayı kapsamlı bir Python değerlendiricisiyle doğrulayın
Gemini 4 Carbon eşikleri örnekledi ve hiçbirinin çalışamayacağını çıkarsadı. Değerlendirici, araçlarla kod paylaşmadan her farklı işaret setini kontrol ederek bu doğrulama kümesi için sonucu kanıtlar.
Puanlar 0,001’lik bir ızgaraya oturur; bu nedenle 1.002 aday kesme noktası tüm olası işaret setlerini kapsar. Değerlendirici bunların tamamını ve her kanal eşiği çiftini, 85% ve 70% tam olsun diye tamsayı sentler kullanarak kontrol eder.
Kapsamlı kontrol ve reddedilen dört yapılandırma. Görsel: Yazar.
Hiçbir küresel eşik üç kuralın tamamını geçmiyor; bu nedenle Gemini 4 Carbon’un iddiasının artık arkasında kanıt var. Değerlendirici, aracının yoklayarak bulduğu 0,108 ve 0,118 sınırlarıyla eşleşti ve günde 200’de geçen binlerce kanal çifti buldu.
Bir değerlendirici yalnızca kötü yanıtları reddederse faydalıdır; bu yüzden ona dört yanlış yapılandırma verdim ve dördünü de reddetti.
Gemini 4 Carbon ile Yayına Alma Alternatiflerini Test Edin
Gemini 4 Carbon her iki izinli değişikliği de test etti ve ekstra değerlendiriciler yerine orijinal sınırda ayrı eşikleri seçti. Bu seçimi, bir kişinin onaylaması gereken bir istisna olarak işaretledi.
Manuel inceleme kapasitesinde artışı test edin
Küresel tek eşik, sınır 200’den 205’e çıkarsa çalışır ve değerlendirici, en küçük artış olarak 205’i doğruladı. Gemini 4 Carbon yine de bu seçeneği ikinci sıraya koydu; daha önce açıkladığım tercih kuralı nedeniyle.
Her ödeme kanalı için ayrı eşikleri test edin
Kanal tarafında, aracı Mobil Uygulama eşiğini sınırına yakın tuttu (0,109’un tabanı bozduğunu zaten görmüştü) ve Web Sitesi eşiğini yükseltti; böylece meşru Web Sitesi siparişlerindeki işaretleri düşürdü. Yedi çifti test etti ve biri en yoğun günde tek bir işaretle başarısız oldu. Web Sitesi 0,3 ve Mobil Uygulama 0,1’i önerdi; çünkü bu çift her kuralı rahatlıkla geçiyor ve değerlendirici bunu orijinal sınırda doğruladı.
Doğrulanmış alternatifleri karşılaştırın
Bu sayılar yukarıda geçti ve değerlendirici her birini yeniden hesapladı:
Seçenek
Eşikler
Toplam
Web Sitesi
Mobil Uygulama
En yoğun gün
Onay
Orijinal politika
Küresel 0,108
%87,5
%98,2
%70,1
205, sınır 200
Başarısız
Daha fazla kapasite
Küresel 0,108
%87,5
%98,2
%70,1
205, sınır 205
Gerekli
Kanal bölümü
Web Sitesi 0,3, Mobil Uygulama 0,1
%86,2
%94,5
%72,8
191, sınır 200
Gerekli
Kanal bölümü, kapasite seçeneğine kıyasla yaklaşık %6 daha az işlemi işaretler. Ancak işaretlerin yarısından azı sahtekarlıktır; rapor bunu açık bir mesele olarak listeledi.
Gemini 4 Carbon’un Önerisini Görülmeyen Veride Nasıl Doğrularsınız
Öneriyi, dondurulmuş halde, mühürlü ayrılmış kümeye uygulayarak doğrularsınız. Değerlendiriciden farkı veridir: değerlendirici, aracının görebildiği haftaları puanladı ve ayrılmış küme, hiçbir aracın okuyamadığı dört sonraki haftayı puanlar. Kontrol, donmuş öneri başına bir kez çalışır ve rapor dondurma sonrası değiştiyse başlamaz.
Donmuş öneri ayrılmış kümede geçiyor. Görsel: Yazar.
Üç kuralın hepsini geçti ve en yoğun gün sınırın altında kaldı. Yine de bundan fazla anlam çıkarmayın. Üç şey bu sonucu mütevazı kılar:
İlk ikisi sayılardan gelir.
Tüm denetimi Streamlit’te izleyin
Depoda ayrıca bir Streamlit uygulaması ve altı kaydedilmiş deneme bulunur; böylece bu denetimi API çağrısı olmadan açabilirsiniz. Videoda, uygulamayı yüklüyor ve her sekmeyi adım adım geçiyorum.