트랙
개발자를 위한 AI 엔지니어 보조
26시간
Grok Voice Transcribe 2.0(grok-voice-transcribe-2.0)은 SpaceXAI의 음성-텍스트 모델입니다. REST 경로는 완료된 파일을 전사하고, WebSocket 경로는 실시간 오디오를 처리합니다.
SpaceXAI의 Grok Voice Transcribe 2.0 발표는 전화 통화, 다중 화자, 자격 증명, 다국어 음성을 강조합니다. 벤치마크 비교는 Grok Voice Transcribe 2.0 개요를 참고하세요.
통제된 Qivora Sync 시나리오는 오디오와 API 설정이 바뀌는 동안 고정되어 있습니다. 통화에는 가상의 제품명, 말더듬이, 언어 전환, 구두로 읽는 연락처, 받아쓰기 중 멈춤, 세 번째 화자가 포함됩니다.
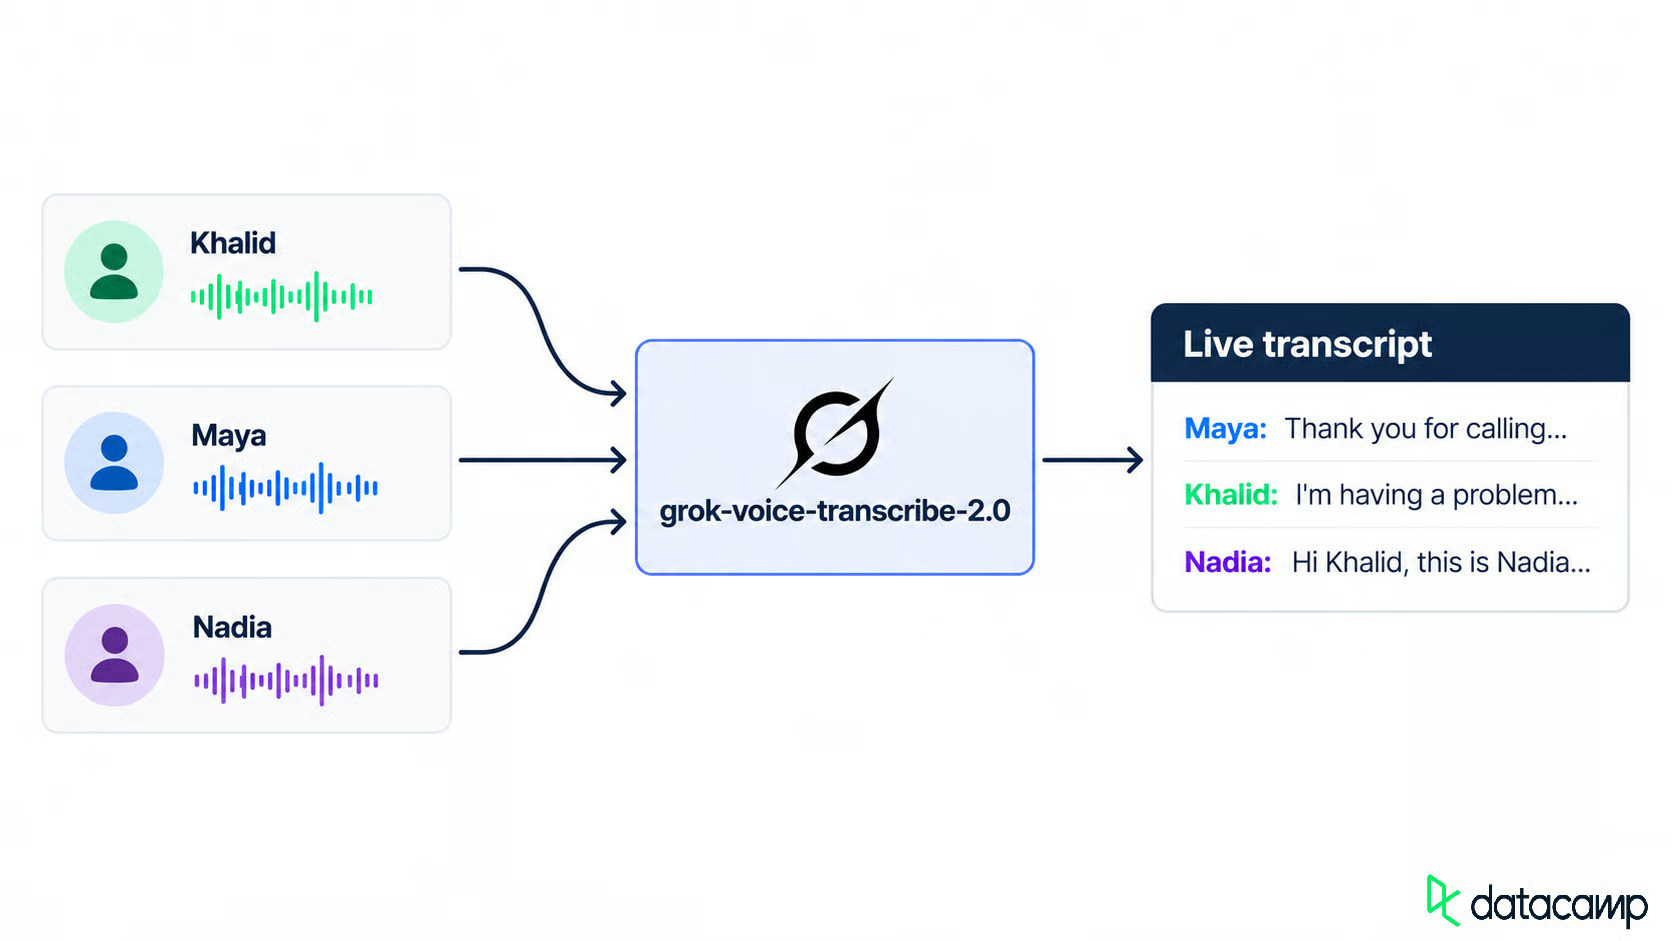
세 화자가 하나의 실시간 전사로 합쳐집니다. 이미지: 작성자.
통제된 시나리오는 Grok Text to Speech API의 서로 다른 세 음성을 사용합니다. 각 언어 구간은 별도로 합성한 뒤 ffmpeg로 연결하여 전환 지점이 고정되도록 합니다. API는 language=auto도 허용합니다. 요청을 분리한 것은 실험 설계상의 선택이며, API 요구사항이 아닙니다.
첫 요청 전, 예상 텍스트, 화자, 제품 표기, 고객 정보, 말더듬이, 멈춤을 정의합니다. 이후 모든 설정은 같은 목표를 갖습니다.
오디오를 보내기 전에 종속 항목을 설치하세요.
Python 3.10 이상, xAI API 키, 오디오 생성을 위한 ffmpeg가 필요합니다. Python 클라이언트는 requests, websockets, 그리고 python-dotenv를 사용합니다.
Speech to Text 문서에 따르면 2.0은 model을 생략하면 기본값이며, grok-voice-transcribe-1.0은 2026년 10월 2일 서비스 종료(EOL)에 도달했습니다. 그래도 버전이 명시된 ID를 고정해 두길 권합니다.
저장소를 클론하고, 키를 .env에 추가한 뒤 샘플 오디오를 빌드하세요:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
설정 명령은 이후에 사용할 대화 스크립트와 오디오 파일을 생성합니다. 자체 녹음이 있다면 이 명령은 건너뛰세요.
.env를 Windows에서 작성하면 키 끝에 \r이 남을 수 있으며, requests 는 SpaceXAI에 도달하기 전에 헤더를 거부합니다. 권한 헤더에 추가하기 전에 키의 공백과 개행을 제거하세요.
기준선은 아무 옵션도 켜지 않은 모델 상태입니다. 이후 모든 변경은 이에 대비해 비교합니다. 첫 요청은 파일과 고정 모델을 전송합니다:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
응답에는 text, 감지된 language, duration, 그리고 시간 정보가 있는 words 배열이 포함됩니다. REST 레퍼런스는 단어별 confidence를 보여주지만, 이 시나리오의 배치 응답에는 나타나지 않았습니다. 해당 필드는 선택적으로 취급하고, 사용 전 각 API 응답을 확인하세요. 선택 필드는 file 앞에 두세요. 뒤의 필드는 무시될 수 있습니다.
기준선은 말더듬이를 제거하고, 아랍어는 아랍 문자로 유지했으며, 구두로 읽은 숫자는 분리된 상태로 남겼습니다. 가상의 제품명은 일관되게 오기되었습니다.
지원 전사에는 화자 라벨, 정확한 제품 표기, 사용 가능한 고객 정보가 필요합니다. 각 설정은 폼 필드를 하나 더 추가합니다:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
같은 오디오에 옵션을 하나씩 추가해 보세요. 화자 라벨부터 시작합니다.
화자 분할(diarization)은 단어에 이름이 아닌 숫자 화자 ID를 부여합니다. 같은 ID가 연속되는 단어를 묶어 턴을 구성하세요:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
깨끗한 오디오에서는 각 알려진 턴이 일관된 화자 ID로 유지되었습니다. 최초 등장 순서로 이름을 매핑하는 방식은 통화 순서를 이미 알고 있을 때만 유효합니다. 프로덕션 시스템에서는 자체 화자 매핑이 필요합니다.
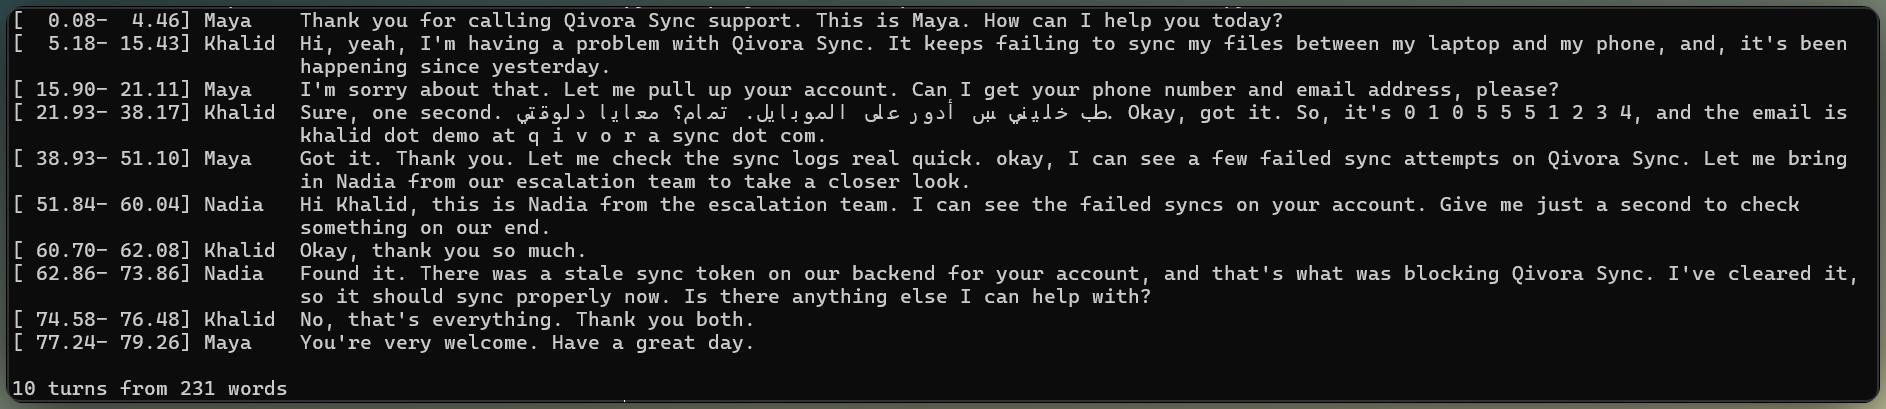
깨끗한 오디오는 화자 라벨을 일관되게 유지합니다. 이미지: 작성자.
키터ーム 바이어싱은 학습이 아닌 요청 단위의 힌트입니다. keyterm=Qivora Sync(최대 100개 용어, 각 50자)를 전달하면, 오디오가 뒷받침하는 범위에서 해당 표기를 선호합니다.
키터ーム은 기준선의 제품명 오류를 주변 전사에 영향을 주지 않고 바로잡았습니다.
별도의 실시간 화자 점검에서는 강하게 편향된 어휘가 희미한 메아리를 키터ーム 쪽으로 끌었습니다. 이는 키터ーム만으로 거짓 텍스트가 생성된다는 의미가 아니라, 애매한 오디오는 여전히 메아리 여부 확인이 필요하다는 뜻입니다.
기준선에서 보았듯이 Khalid의 아랍어는 아랍 문자로 유지되었습니다. 자동 감지와 language=en을 사용해도 결과는 같았습니다. language는 출력 언어를 강제하는 대신 포매팅 규칙을 선택하기 때문입니다.
기준선은 구두로 읽은 숫자를 분리된 상태로 유지했습니다. 역 텍스트 정규화(ITN)는 구어형을 문어형으로 바꿉니다. format=true 는 ITN을 켜며 language가 필요합니다. 없으면 400 오류가 납니다.
전화번호는 하나의 연속된 숫자 문자열이 되었습니다. 이메일은 부분적으로만 정규화되었습니다. 문장부호는 개선됐지만, 구두의 "at"과 철자 스펠링된 도메인은 여전히 정리가 필요했습니다.
균일하지 않은 결과는 아쉽습니다. ITN은 텍스트를 포매팅할 뿐, 연락처 데이터를 검증하지 않습니다. 두 필드는 저장 전에 검증하길 권합니다.
ITN은 일반적인 기간 표현을 약어 형태의 수량으로 바꿀 수도 있습니다. 이 시나리오의 배치 응답에서는 최상위 text만 정규화되었고, words 배열은 구어형을 유지했습니다.
기준선에서 보았듯이, 기본적으로 말더듬이는 text와 words에서 제거됩니다. filler_words=true로 Khalid의 "uh", "um"이 예상 위치에 복원되었습니다. 지원 노트에는 끄고, 정확한 QA 기록에는 켜두는 것이 좋습니다.
배치 출력으로 화자, 어휘, 포매팅, 말더듬이 제어를 갖췄습니다. 이제 같은 오디오를 실시간 스트림으로 전송합니다.
스트리밍 경로는 설정 메시지 대신 쿼리 매개변수를 사용합니다. transcript.created를 기다린 뒤, 원시 바이너리 오디오(base64 아님)를 전송하고, {"type": "audio.done"}로 종료합니다. 우리의 GPT Live Transcribe 튜토리얼도 다른 모델이지만 같은 패턴을 사용합니다.
이벤트를 먼저 이해하고, 그다음 클라이언트를 연결하세요.
배치에서는 문서에 나온 대로 format=true와 language=en을 사용합니다. 스트리밍 문서에 따르면 language 가 ITN을 켠다고 하지만, 실시간 테스트에서는 language=en만으로 전사가 바뀌지 않았습니다. WebSocket 쿼리에는 format이 없으므로, 본 튜토리얼은 스트리밍 ITN을 의존 대상이 아닌 검증 대상 동작으로 취급합니다.
모든 전사 업데이트는 두 개의 불리언이 있는 transcript.partial 이벤트입니다. 중간 텍스트는 변경될 수 있습니다. 청크 최종(is_final=true)은 턴이 열린 상태에서 약 3초 분량을 고정하고, 발화 최종(speech_final=true)은 턴을 닫습니다.
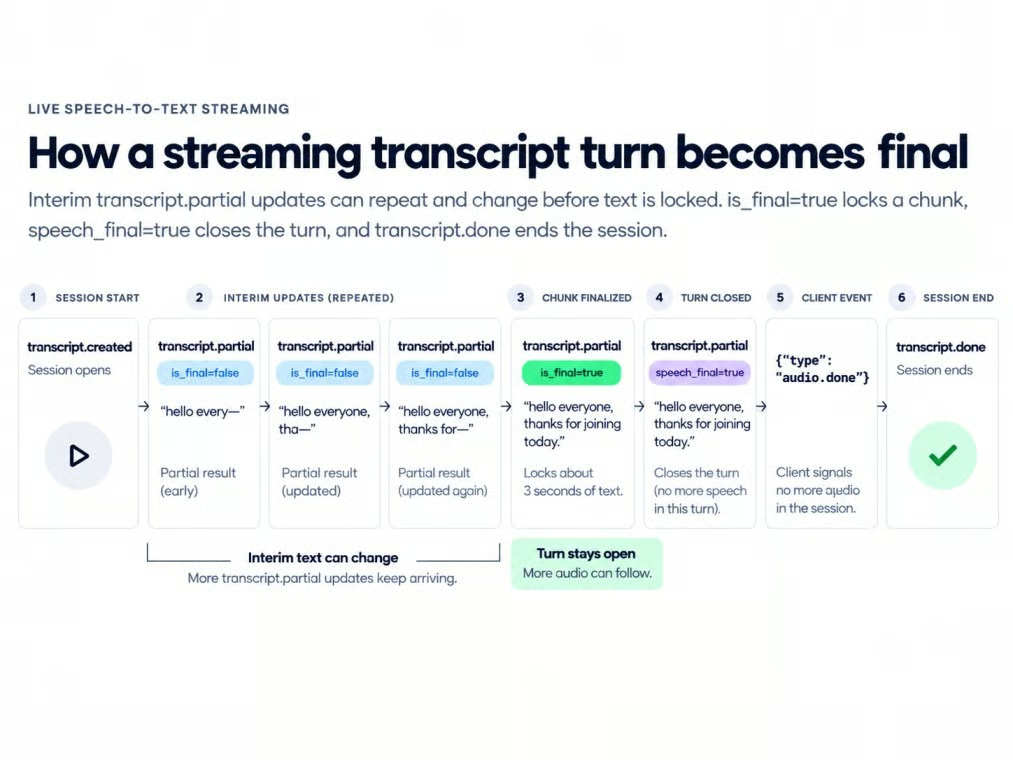
스트리밍 상태는 텍스트를 최종화로 이끕니다. 이미지: 작성자.
스트리밍을 위해서는 원본을 먼저 모노 16비트 PCM 16 kHz로 리샘플링하세요. 코어 클라이언트는 100밀리초 청크를 실시간 속도로 전송하고, 다른 태스크가 전사 이벤트를 수신합니다:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
중간 텍스트는 약 0.5초마다 업데이트되었습니다. 이는 로컬 측정치이며, 공식 지연 시간은 아닙니다.
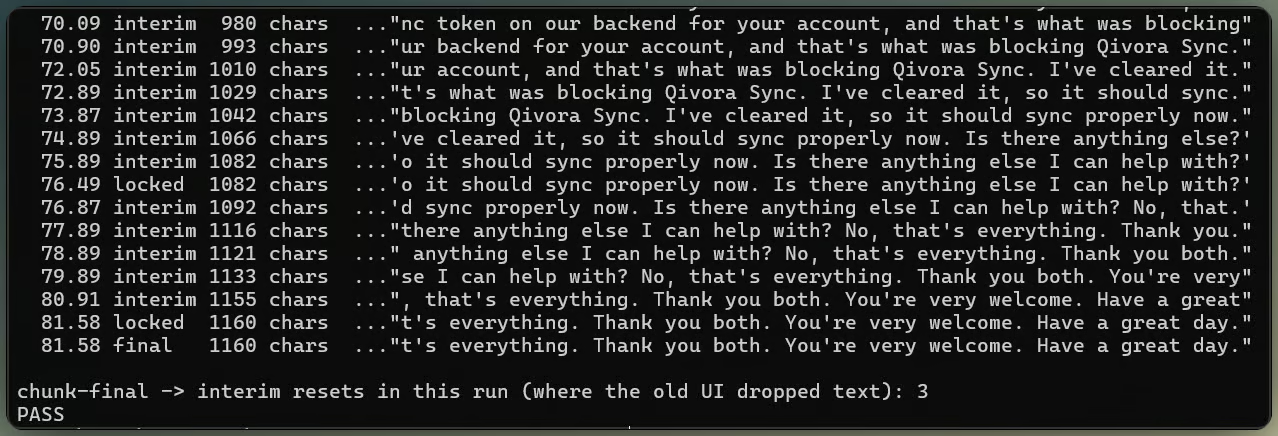
부분 캡션이 최종 전사로 수렴합니다. 이미지: 작성자.
청크 최종은 턴을 닫지 않고 텍스트를 고정합니다. Smart Turn은 speech_final이 턴을 언제 닫을지 제어합니다.
활성 이벤트만 표시하면 각 청크가 최종화된 뒤 이전 단어가 사라집니다. 다음 중간 전사가 들어오는 오디오에서 다시 시작하기 때문입니다.
잠긴 청크는 모두 보관하고, 현재 중간 전사를 덧붙인 뒤, 발화 최종에서 둘을 교체하세요.
이렇게 하면 앞선 청크를 잃지 않고 텍스트가 자랍니다. 표시 상태를 처리하고 나면, 남은 스트리밍 과제는 턴 경계입니다.
Smart Turn은 각 침묵을 평가하여 화자가 마쳤는지 추정합니다. 이는 Khalid의 번호 "zero one zero, five five five, [pause], one two three four"처럼, 침묵만으로는 생각하는 멈춤과 종료를 구분하기 어려운 경우를 위한 기능입니다.
임계값은 전사 신뢰도도, VAD 임계값도 아닙니다. 이는 침묵이 speech_final을 트리거하기 위해 넘어야 하는 턴 종료 확률입니다. 그 미만이면 턴은 열린 상태로 남습니다. 두 개의 쿼리 매개변수로 설정합니다:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
문서에 따르면 0.5는 균형, 0.7은 숫자 시퀀스에 보수적, 0.9는 매우 보수적입니다. 이 시나리오에서는 기본 endpointing 윈도보다 짧은 멈춤은 유용한 Smart Turn 결정을 내지 못했습니다. 이는 관찰된 결과일 뿐, 문서화된 타이밍 규칙은 아닙니다.
스트리밍 테스트에서 오디오 프레임 전송을 중단해도 관찰된 침묵 타이머는 진행되지 않았습니다. 디지털 침묵을 계속 전송하면 Smart Turn이 발화를 닫을 수 있습니다.
숫자 받아쓰기 중 멈춤을 늘리면 동작이 더 잘 보입니다. 짧은 멈춤은 하나의 턴 안에 머무르고, 긴 멈춤은 세 임계값 모두를 넘으면 각 임계에서 턴을 분할합니다.
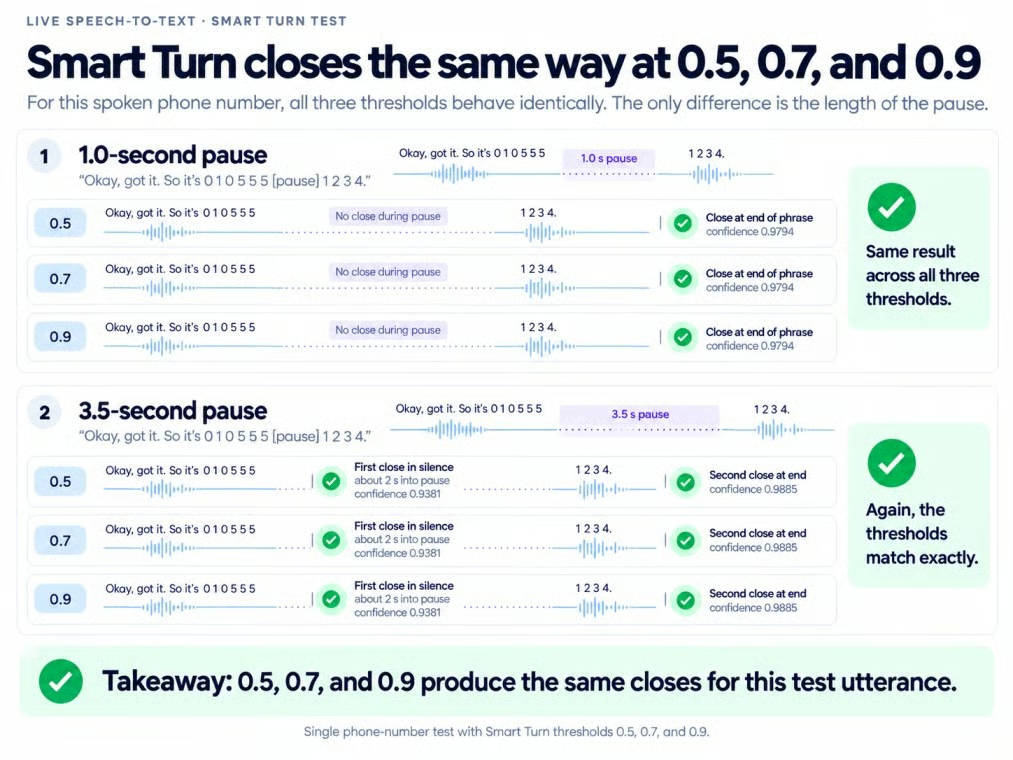
긴 멈춤은 숫자 받아쓰기를 분할할 수 있습니다. 이미지: 작성자.
사람 발신자는 덜 예측 가능합니다. 짧은 숫자열이 끝난 것처럼 보여도, 이어서 계속할 수 있습니다.
숫자 받아쓰기 중 Smart Turn이 닫히면, 잠시 기다렸다가 이어지는 내용을 합친 뒤 응답하세요.
smart_turn_timeout 은 Smart Turn이 확신하지 못하더라도 고정된 침묵 시간이 지나면 턴을 닫습니다. 빠른 3인 화자 스트림에서는 Smart Turn이 여러 알려진 턴을 묶다가 타임아웃으로 강제 종료되었습니다.
턴 경계를 이미 알고 있다면 각 경계에서 {"type": "finalize"}를 보내세요. 그렇지 않다면 Smart Turn과 타임아웃을 함께 사용하세요.
턴 경계를 통제하고 나면, 같은 발신자가 8 kHz 회선을 거쳐야 합니다.
여기서의 전화 품질 오디오는 동일한 통화에서 만든 8 kHz G.711 mu-law입니다:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.raw원시(컨테이너 없는) 전화 오디오는 audio_format=mulaw와 sample_rate=8000을 배치 폼에 설정해야 하며, 소켓에서는 encoding=mulaw&sample_rate=8000로 설정합니다. 텍스트와 화자 라벨은 따로 점검하세요.
앞서의 키터ーム, 포매팅, 언어 전환 결과는 8 kHz에서도 크게 달라지지 않았습니다.
화자 라벨의 신뢰도는 떨어졌습니다. 전화 버전에서는 추가 화자 ID가 생겼고, 마무리 턴이 잘못된 사람에게 할당되었습니다. 세그먼트 수만 세면 두 오류 모두 가려집니다.
불안정한 버전은 통화의 대역을 300–3400 Hz로 제한하고, 8 kHz mu-law로 인코딩하며, 20밀리초 패킷을 0.03의 확률로 드롭합니다. 고정 난수 시드 7로 매 재생마다 같은 간극이 유지됩니다.
이 샘플에서는 그러한 패킷 손실이 영어 전사를 크게 바꾸지 않았고, 구두로 읽은 연락처 정보도 순서가 유지되었습니다. 이 결과는 본 샘플에 한정됩니다.
전화 시뮬레이션은 오디오 대역을 좁히고 패킷을 드롭합니다. 이미지: 작성자.
음성 활동 감지(VAD)는 오디오가 음성인지 여부를 판정합니다. 문서는 조용한 전화 음성에 대해 vad_threshold를 낮추라고 제안하지만, 노이즈로 인한 잡음 텍스트 위험이 있습니다.
vad_threshold를 낮춰도 조용한 전화 음성이 회수될 여지가 없던 깨끗한 전화 오디오에서는 변화가 없었습니다. 이 무효 결과는 한 가지 원칙을 뒷받침합니다. 전화 음성이 누락될 때에만 임계값을 낮추세요.
이번에는 diarize 없이 새로운 배치 폼을 사용합니다:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API는 WAV나 다른 컨테이너에서 채널 수를 감지합니다. 원시 다중 채널 오디오의 경우 ("channels", "3")를 추가하세요. WebSocket 다중 채널 입력도 명시적 채널 수가 필요합니다.
앞서 보인 REST 요청으로 다중 채널 파일과 함께 폼을 전송한 뒤, result["channels"]를 읽습니다. 각 항목에는 인덱스, 전사 텍스트, 시간 정보가 있는 단어가 포함됩니다. 통제된 3채널 시나리오에서는 각 채널에 해당 화자만 있었습니다. 스트리밍에서는 같은 분리를 사용하며 이벤트에 channel_index가 추가됩니다.
가능하면 전화 시스템이 제공하는 별도 회선을 사용하겠습니다. 전화 오디오 섹션의 화자 분할과 달리, 알려진 분리는 화자를 추정하지 않습니다.
완전한 클라이언트는 하나의 설정 그룹을 제공하고, 이후 REST 폼 또는 WebSocket URL을 별도로 구성합니다. 공통 설정은 화자 분할, 키터ーム, 말더듬이, 오디오 인코딩, 턴 처리를 다루며, 포매팅은 앞서 설명한 전송 방식별 규칙을 따릅니다.
최종 설정을 전화 품질 녹음에 적용한 뒤, 제품 표기, 언어 전환, 연락처, 화자 라벨을 각각 점검하세요. 통제된 시나리오에서는 텍스트 점검은 통과했지만, 한 화자 라벨은 여전히 검토가 필요했습니다. 이후 비교가 같은 설정을 사용하도록 각 전사와 함께 설정과 화자 매핑을 저장하세요.
지원 전사 튜토리얼은 최종 점검으로 마무리됩니다. 저장소에는 생성된 답변, 음성 출력, 인터럽트, 메아리 처리까지 포함한 별도의 보이스 에이전트 확장도 있습니다.
이 데모에서도 전사의 역할은 동일합니다. 텍스트를 생성하고, 언어 모델이 답변을 작성하며, Grok TTS가 이를 음성으로 전달합니다.
DataCamp으로 AI를 배워보세요!
트랙
트랙
강의