学习路径
面向开发者的 AI 工程师助理
26 小时
Grok Voice Transcribe 2.0(grok-voice-transcribe-2.0)是 SpaceXAI 的语音转文字模型。REST 路径用于转写完整文件,WebSocket 路径用于处理实时音频。
SpaceXAI 的 Grok Voice Transcribe 2.0 公告重点介绍了电话通话、多说话人、凭据以及多语言语音。基准对比请参见我们的 Grok Voice Transcribe 2.0 概览。
我们使用受控的 Qivora Sync 固定场景,让音频与 API 设置变化时场景不变。通话包含一个虚构产品名、语气填充词、语言切换、口述联系方式、口述过程中的停顿,以及第三位说话人。
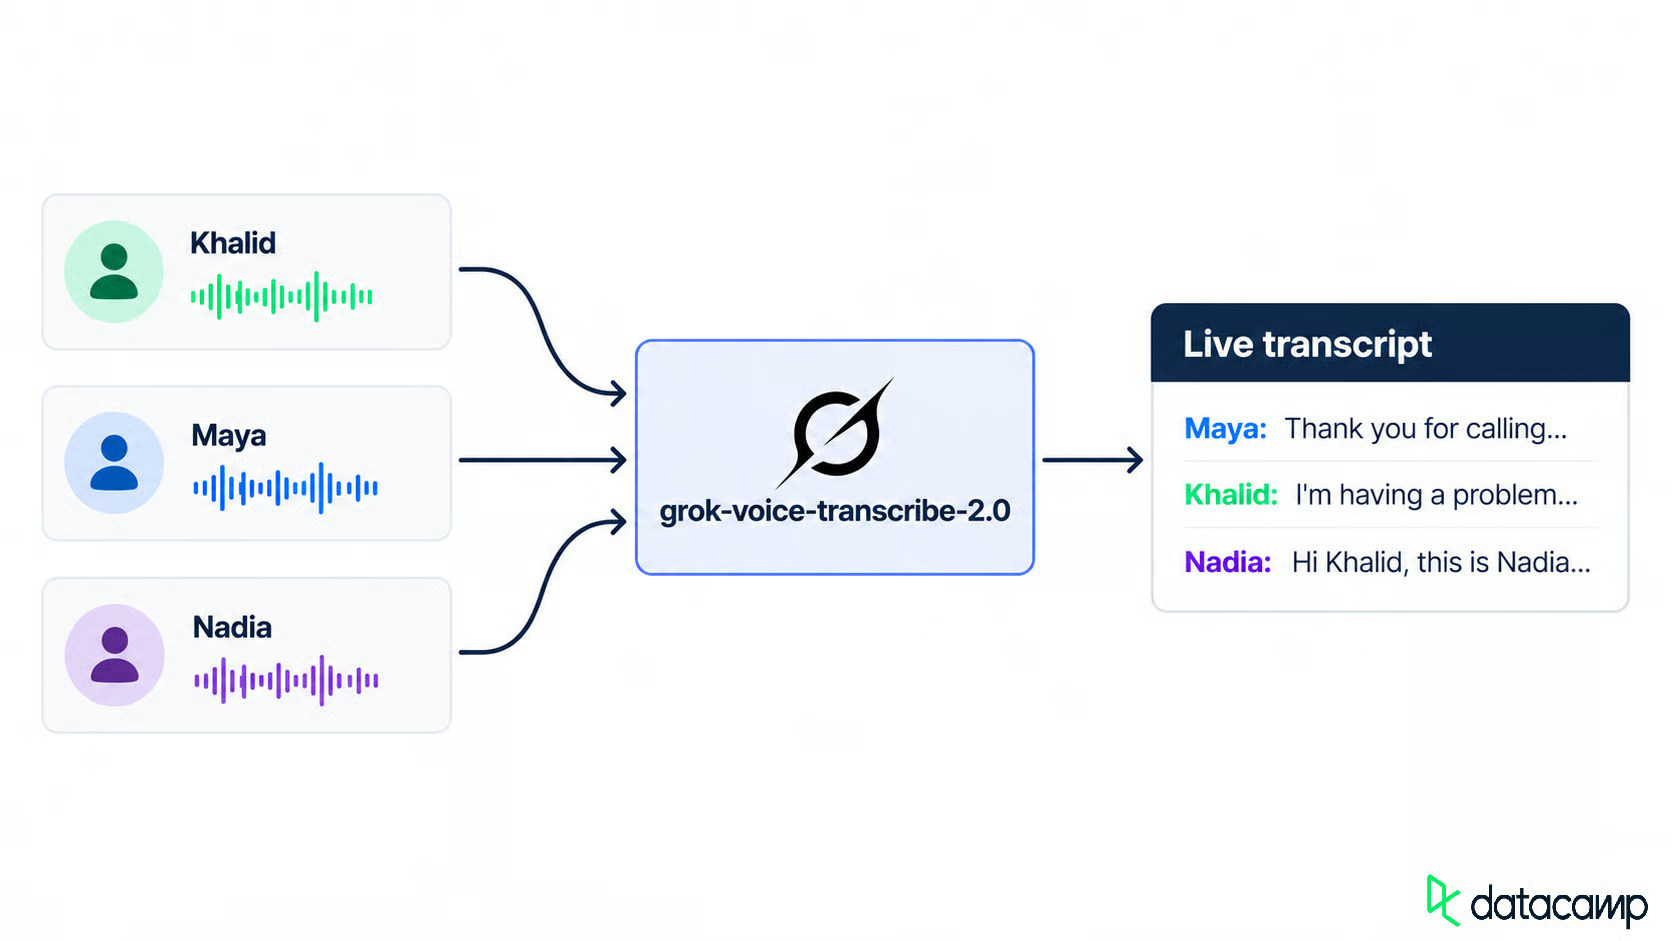
三位说话人汇成一份实时转写。图片来源:作者。
该受控场景使用来自 Grok 文本转语音 API 的三种不同声音。每个语言片段分别合成,并用 ffmpeg 拼接,以保证切换点固定。API 也接受 language=auto;分开请求只是实验设计选择,并非 API 要求。
在首次请求前,先定义预期文本、说话人、产品拼写、客户信息、填充词与停顿。之后每次设置都以同一目标为准。
发送音频前先安装依赖。
您需要 Python 3.10 或更高版本、一个 xAI API 密钥,以及用于构建音频的 ffmpeg。Python 客户端使用 requests、websockets 和 python-dotenv。
语音转文字文档指出:当省略 model 时,默认即为 2.0;而 grok-voice-transcribe-1.0 已于 2026 年 10 月 2 日停止支持。我仍建议固定使用带版本的 ID。
克隆仓库,将密钥添加到 .env,并构建示例音频:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
该设置命令会创建后文使用的对话与音频文件。若您已有录音,可跳过此命令。
在 Windows 上写入的 .env 可能在密钥后留下 \r,requests 会在到达 SpaceXAI 之前就因该请求头而拒绝。将密钥去除多余字符后再加入授权头。
基线是指在未启用任何选项的模型输出,以便之后的每项更改都有对照。首次请求发送文件与固定模型:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
响应包含 text、检测到的 language、duration,以及带时间戳的 words 数组。参见 REST 参考,其中展示了逐词 confidence,但在本场景的批处理响应中未出现。我会将该字段视为可选,并在使用前检查每次 API 响应。将可选字段置于 file 之前;之后的字段可能被忽略。
基线移除了填充词,阿拉伯语保持阿拉伯文脚本,口述数字保持分开。虚构产品名的拼写始终有误。
客服转写需要说话人标签、正确的产品拼写,以及可用的客户信息。每个设置都对应一个额外的表单字段:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
对同一段音频逐项添加选项。先从说话人标签开始。
说话人分离为单词赋予数字型说话人 ID,而非姓名。将相邻且同一 ID 的单词分组以构建轮次:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
在干净音频中,每个已知轮次都保持一致的说话人 ID。按首次出现顺序映射姓名只在通话顺序已知时有效;生产系统应有自己的说话人映射。
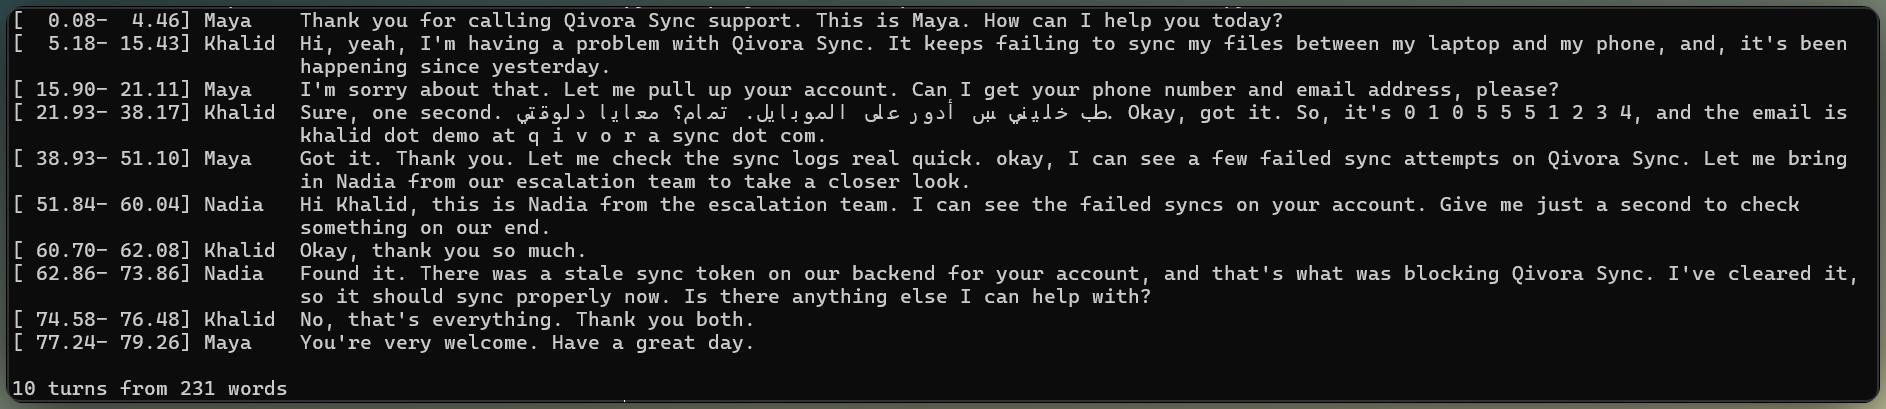
干净音频有助于保持说话人标签一致。图片来源:作者。
关键词偏置是逐次请求的提示,而非训练。传入 keyterm=Qivora Sync(最多 100 个词条,每个不超过 50 个字符),模型会在音频支持的情况下朝该拼写倾斜。
该关键词纠正了基线中的产品名错误,而未改变周围转写。
在另一次实时说话人检查中,强词汇偏置将微弱回声拉向该关键词。这并不意味着关键词会凭空生成错误文本;而是说明含糊音频仍需回声检查。
如基线所示,Khalid 的阿拉伯语保持阿拉伯文脚本。无论使用自动检测还是 language=en,结果都相同,因为 language 用于选择格式化规则,而非强制输出语言。
基线保持口述数字分开。逆文本规范化(ITN)将口述形式转换为书面形式。 format=true 可开启该功能,并需要 language,否则请求将以 400 失败。
电话号码变为连续数字串。邮箱仅部分被规范化:标点改善了,但口述的“at”和拼读的域名仍需清理。
该不均衡结果令人沮丧。ITN 负责格式化文本;并不校验联系数据。我会在入库前同时校验这两项。
ITN 还可将普通的时长短语重写为缩写数量。在本场景的批处理格式化响应中,仅顶层 text 被规范化;words 数组仍保留口述形式。
如基线所示,默认会从 text 与 words 中移除填充词。设置 filler_words=true 会在预期位置恢复 Khalid 的 “uh” 与 “um”。撰写支持记录时建议关闭,做逐字 QA 记录时建议开启。
批处理输出涵盖了说话人、词汇、格式化和填充词控制。接下来,将同一音频以实时流方式发送。
流式路径使用查询参数而非初始化消息。等待 transcript.created,发送原始二进制音频(非 base64),并以 {"type": "audio.done"} 结束。我们的 GPT 实时转写教程也以另一模型采用了同样的模式。
先了解事件,再连接客户端。
批处理使用文档中的 format=true 加 language=en。流式文档称 language 会开启 ITN,但在一次实时探测中,仅 language=en 并未改变转写。WebSocket 查询参数不包含 format,因此本教程将流式 ITN 视为需验证而非依赖的行为。
每次转写更新都是 transcript.partial 事件,并带有两个布尔值。中间文本仍可能变化。块级最终(is_final=true)会在轮次仍未关闭时锁定约 3 秒文本;话语最终(speech_final=true)则关闭该轮次。
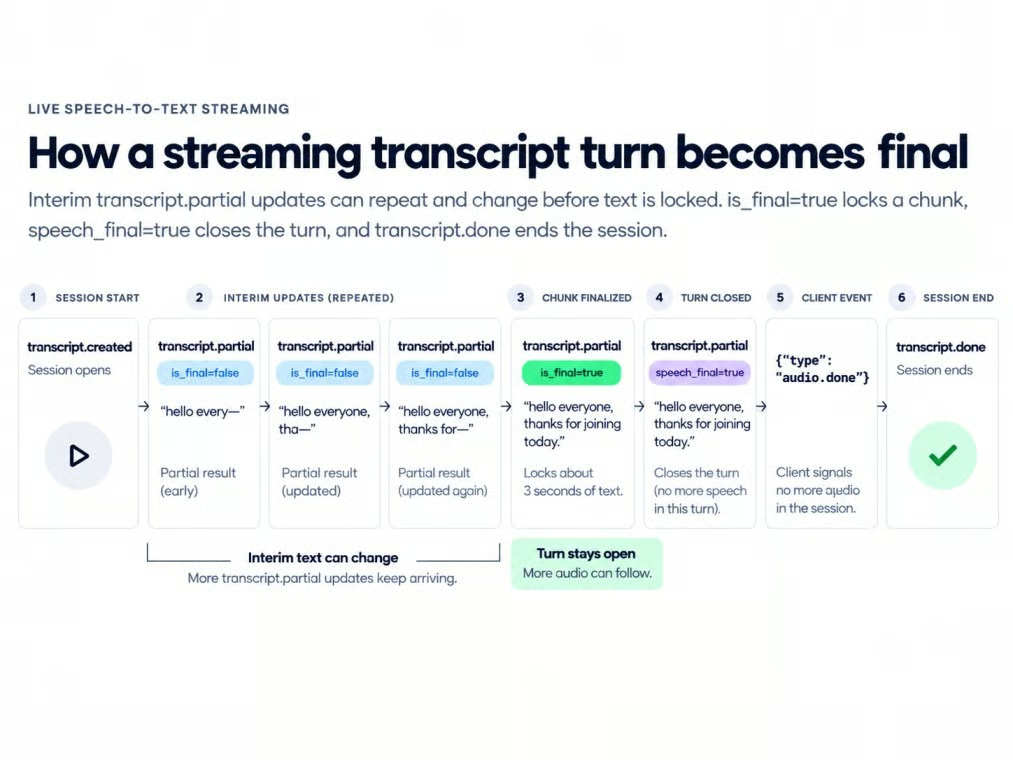
流式状态推动文本走向最终确定。图片来源:作者。
用于流式处理时,先将源音频重采样为 16 kHz、单声道、16 位 PCM。核心客户端以实时节奏每 100 毫秒发送一块音频,同时由另一任务接收转写事件:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
中间文本大约每半秒增长一次。这是本地测量数据,非官方时延。
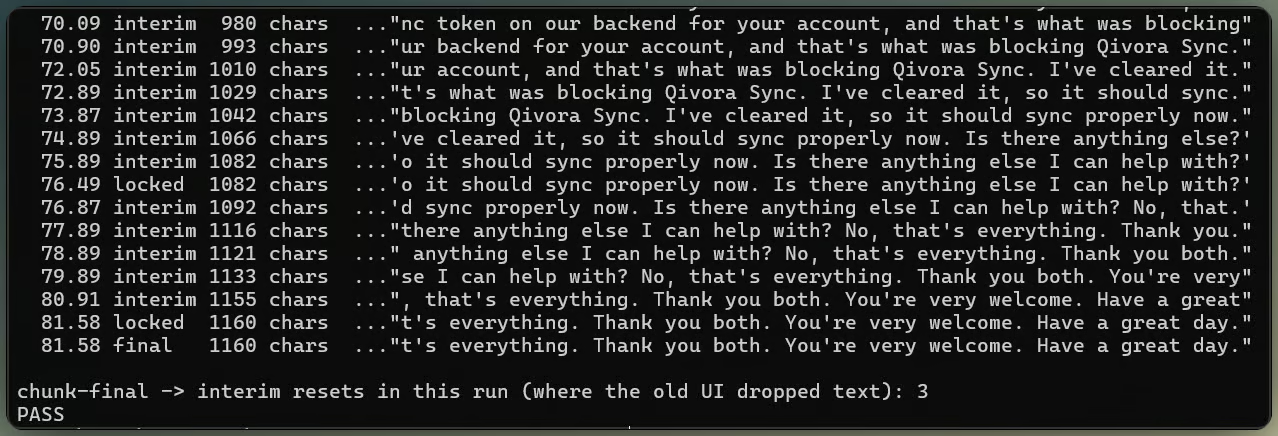
部分字幕最终沉淀为最终转写。图片来源:作者。
块级最终会冻结文本,而不关闭当前轮次。Smart Turn 则控制何时由 speech_final 关闭。
只显示当前事件会导致每个块设为最终后早先的单词“消失”,因为下一个中间结果会从新到达的音频重新开始。
保留所有锁定的块,追加当前中间结果,并在话语最终时用其替换两者。
这样文本可在不丢失早先块的情况下增长。显示状态就绪后,余下的流式问题在于轮次边界。
Smart Turn 会评估每次静音并估计说话人是否结束。它正是为 Khalid 报读号码而设:“zero one zero, five five five, [停顿], one two three four”,仅凭静音无法分辨思考停顿与结束。
该阈值不是转写置信度,也不是 VAD 阈值。它是静音需要超过的轮次结束概率,超过才会触发 speech_final;低于则保持轮次打开。两个查询参数用于设置:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
文档称 0.5 为均衡,0.7 在数字序列上更保守,0.9 非常保守。在本场景中,短于默认 endpointing 窗口的停顿未产生有用的 Smart Turn 判定。这是观察结果,而非文档化的时序规则。
在流式测试中,停止发送音频帧不会推进观测到的静音计时;持续发送数字静音可让 Smart Turn 关闭该话语。
延长口述号码过程中的停顿可让行为更明显。短停顿保持在同一轮次,而长停顿在置信度超过三档设置时,会在每个阈值处分割。
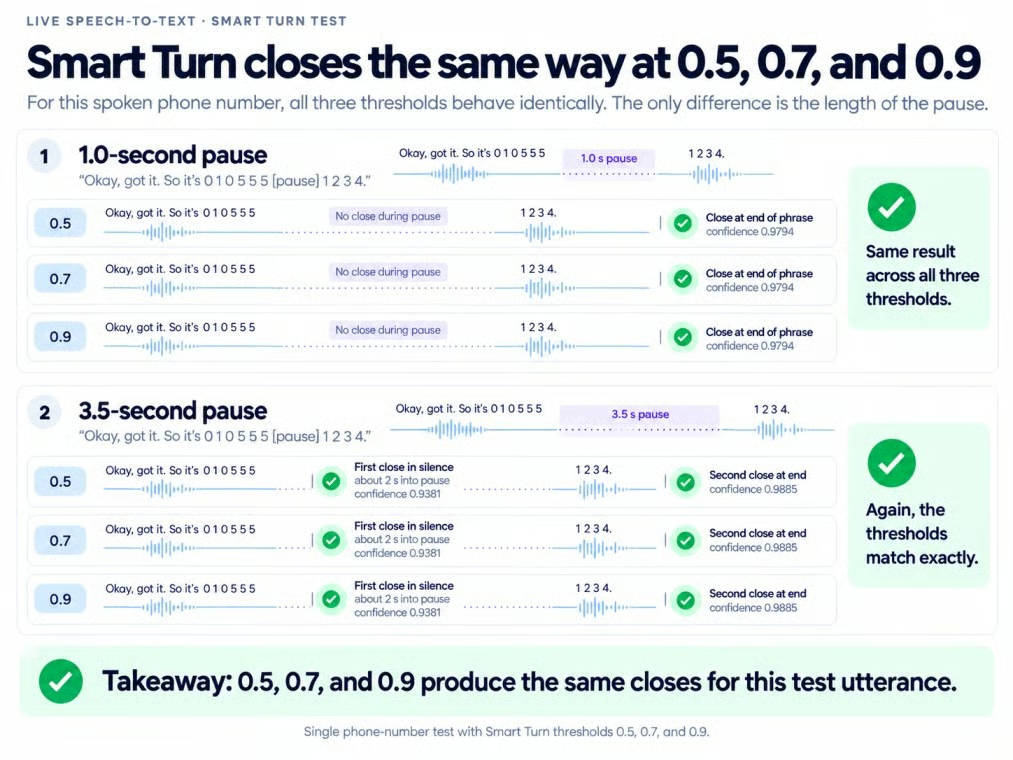
长停顿可能分割号码口述。图片来源:作者。
真人来电更难预测。短数字序列可能看似结束,随后又继续。
若 Smart Turn 在口述号码时关闭轮次,请稍作等待并在回复前合并后续部分。
smart_turn_timeout 会在固定静音后关闭轮次,即使 Smart Turn 仍不确定。在快速的三说话人流中,Smart Turn 将若干已知轮次合到一起,随后超时强制关闭。
若您已知轮次边界位置,请在每个边界发送 {"type": "finalize"};否则将 Smart Turn 与超时配合使用。
当轮次边界得到控制后,还需让相同来电在 8 kHz 线路上依旧可用。
此处的电话级音频为 8 kHz G.711 mu-law,由同一通话生成:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.raw原始电话音频没有容器,因此在批处理表单中设置 audio_format=mulaw 和 sample_rate=8000;或在套接字上设置 encoding=mulaw&sample_rate=8000。请分别检查文本与说话人标签。
先前关于关键词、格式化与语言切换的结论在 8 kHz 下变化不大。
说话人标签变得不可靠。电话版本引入了一个额外说话人 ID,并将结尾轮次分配给了错误的人。仅统计分段数量会掩盖这两类错误。
不稳定版本将通话带宽限制在 300–3400 Hz,编码为 8 kHz mu-law,并以 0.03 的概率丢弃每个 20 毫秒分组。固定随机种子 7 确保每次回放间隙一致。
该分组丢失并未显著改变本样本的英文转写,且口述的联系信息保持顺序。该结果仅适用于本样本。
电话仿真会缩窄音频并丢包。图片来源:作者。
语音活动检测(VAD)判断音频是否为语音。文档建议在安静的电话语音场景下降低 vad_threshold,但存在因噪声产生杂散文本的风险。
在干净的电话音频上降低 vad_threshold 并未带来变化,因为没有可恢复的低音量语音。该空结果支持一条规则:仅在电话语音缺失时才降低阈值。
使用不含 diarize 的全新批处理表单:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API 会从 WAV 或其他容器中检测声道数。对于原始多通道音频,请添加 ("channels", "3");WebSocket 的多通道输入同样需要显式声道数。
将带多通道文件的表单通过前述 REST 请求发送,然后读取 result["channels"]。每个条目包含索引、转写文本与逐词时间。在受控的三通道场景中,每个通道仅包含其指定说话人。流式同样拆分,并在事件中添加 channel_index。
若电话系统可提供独立通路,我会优先使用。与电话音频部分中的分离不同,已知的通道拆分无需推断说话人。
完整客户端暴露一组设置,然后分别构建 REST 表单或 WebSocket URL。共享设置涵盖说话人分离、关键词、填充词、音频编码与轮次处理;格式化遵循前文所述的传输特定规则。
将最终设置应用于电话音质录音,然后分别检查产品拼写、语言切换、联系信息与说话人标签。在受控场景中,文本检查通过,但仍有一个说话人标签需要复核。与每份转写一并保存设置与说话人映射,以便后续对比使用相同配置。
客服转写教程以该最终检查收尾。仓库还包含一个独立的语音代理扩展,支持生成式回复、语音输出、打断与回声处理。
在该演示中,Transcribe 的角色不变:负责产出文本。语言模型负责编写回复,Grok TTS 负责朗读。
在 DataCamp 学习 AI!
学习路径
学习路径
课程