Traseu de învățare
Inginer AI asociat pentru dezvoltatori
26 ore
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) este modelul speech-to-text al SpaceXAI. Ruta REST transcrie un fișier finalizat, în timp ce ruta WebSocket gestionează audio live.
Anunțul Grok Voice Transcribe 2.0 de la SpaceXAI evidențiază apeluri telefonice, mai mulți vorbitori, credențiale și vorbire multilingvă. Pentru comparații de benchmark, vezi prezentarea noastră Grok Voice Transcribe 2.0.
Fixture-ul controlat Qivora Sync rămâne fix, în timp ce audio-ul și setările API se schimbă. Apelul include un nume de produs inventat, umpluturi, o comutare de limbă, detalii de contact rostite, o pauză în timpul dictării și un al treilea vorbitor.
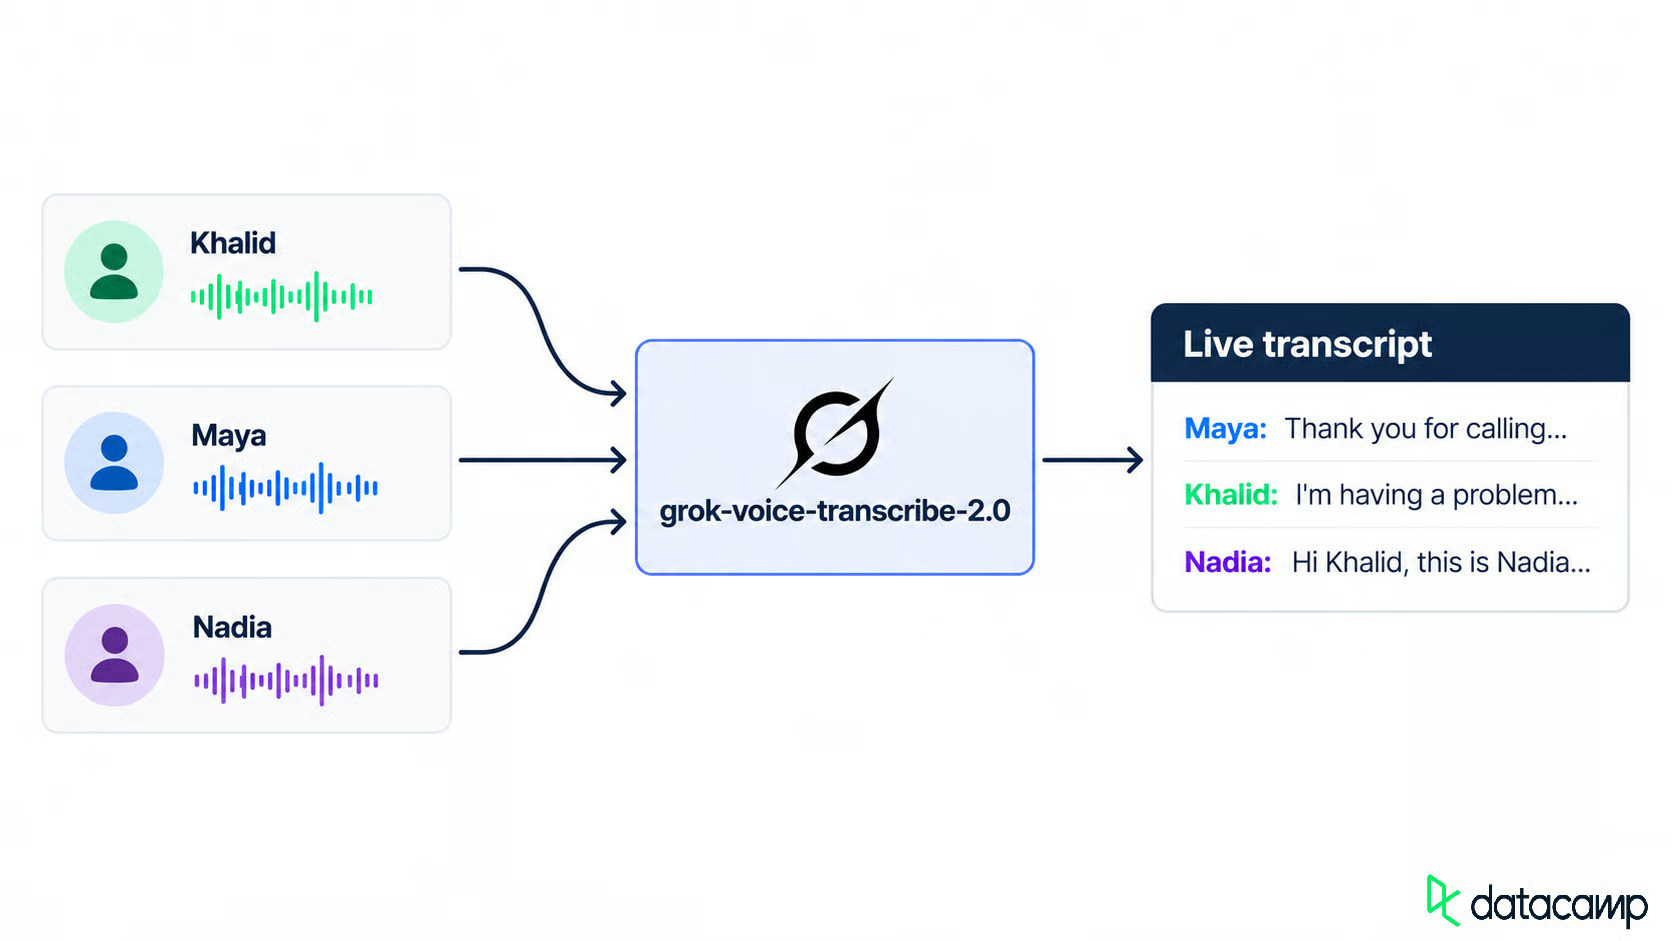
Trei vorbitori devin o singură transcriere live. Imagine de autor.
Fixture-ul controlat folosește trei voci distincte din API-ul Grok Text to Speech. Fiecare segment de limbă este sintetizat separat și îmbinat cu ffmpeg astfel încât punctele de comutare să rămână fixe. API-ul acceptă și language=auto; cererile separate sunt o alegere de design pentru experiment, nu o cerință a API-ului.
Înainte de prima cerere, definește textul așteptat, vorbitorii, ortografia produsului, detaliile clientului, umpluturile și pauzele. Fiecare configurare are apoi aceeași țintă.
Instalează dependențele înainte de a trimite audio.
Ai nevoie de Python 3.10 sau mai nou, o cheie de API xAI și ffmpeg pentru a construi audio-ul. Clienții Python folosesc requests, websockets și python-dotenv.
Documentația pentru Speech to Text spune că 2.0 este implicit când omiti model, iar grok-voice-transcribe-1.0 a ajuns la end of life pe 2 octombrie 2026. Totuși, aș fixa ID-ul versiunii.
Clonează repository-ul, adaugă cheia în .env și construiește audio-ul de exemplu:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
Comanda de configurare creează dialogul și fișierele audio folosite ulterior. Dacă ai propria înregistrare, sari peste acea comandă.
Un .env scris pe Windows poate lăsa un \r în cheie, iar requests respinge antetul înainte ca ceva să ajungă la SpaceXAI. Curăță cheia înainte de a o adăuga în antetul de autorizare.
Un etalon este modelul cu totul dezactivat, astfel încât fiecare modificare ulterioară are cu ce să se compare. Prima cerere trimite fișierul și un model fixat:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
Răspunsul conține text, language detectată, duration și un array words cu timpi. Referința REST arată câmpul confidence pe cuvânt, dar nu a apărut în răspunsurile batch pentru acest fixture. Aș trata câmpul ca opțional și aș verifica fiecare răspuns al API-ului înainte de a-l folosi. Pune câmpurile opționale înainte de file; câmpurile ulterioare pot fi ignorate.
Etalonul a eliminat umpluturile, a păstrat araba în scriere arabă și a lăsat cifrele rostite separate. A greșit consecvent ortografia numelui de produs inventat.
O transcriere de suport are nevoie de etichete de vorbitor, ortografia corectă a produsului și detalii utilizabile ale clientului. Fiecare setare este încă un câmp de formular:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
Adaugă o opțiune pe rând la același audio. Începe cu etichetele de vorbitor.
Diarizarea vorbitorilor atribuie cuvintelor ID-uri numerice de vorbitor, nu nume. Grupează cuvintele consecutive cu același ID pentru a construi ture:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Pe audio curat, fiecare tură cunoscută a rămas cu un ID de vorbitor consecvent. Maparea numelor după ordinea primei apariții funcționează doar când ordinea apelului este deja cunoscută; sistemele de producție au nevoie de propria mapare de vorbitori.
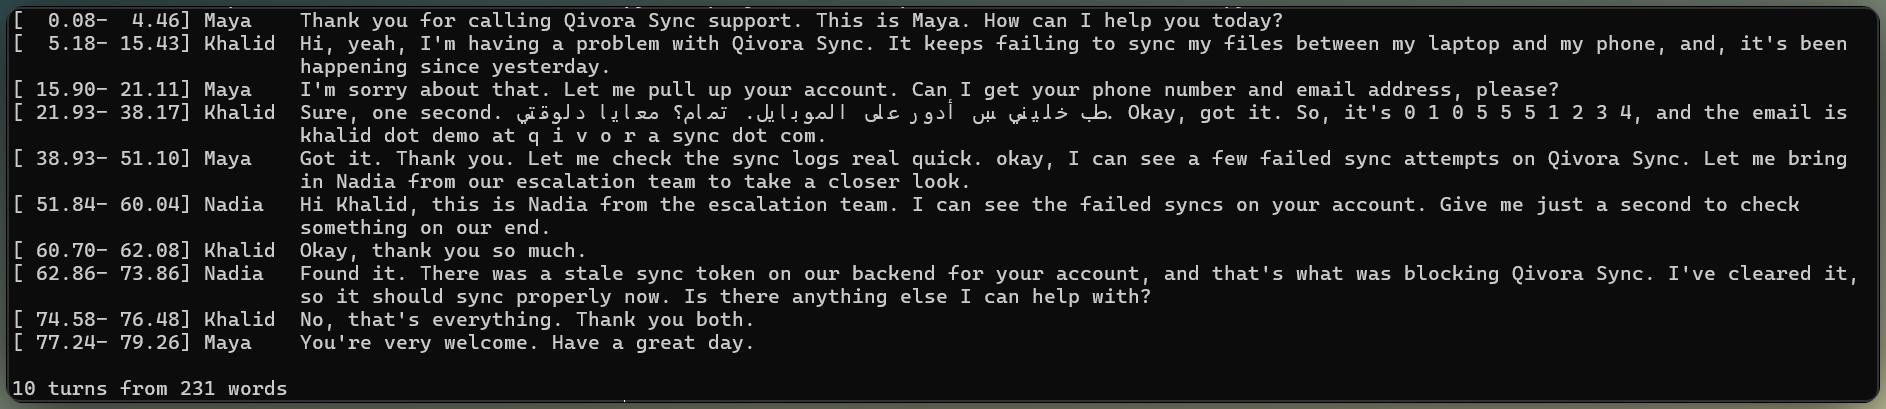
Audio-ul curat păstrează etichetele de vorbitor consecvente. Imagine de autor.
Biasarea cu termeni-cheie este un indiciu per cerere, nu antrenare. Trimite keyterm=Qivora Sync (până la 100 de termeni, 50 de caractere fiecare), iar modelul se înclină către acea ortografie când audio-ul o susține.
Termenul-cheie a corectat eroarea etalonului privind numele produsului fără a schimba transcrierea din jur.
Într-o verificare separată cu vorbitor live, un vocabular puternic biasat a atras un ecou slab către termenul-cheie. Acest rezultat nu înseamnă că termenii-cheie creează singuri text fals; înseamnă că audio-ul ambiguu încă are nevoie de o verificare a ecoului.
După cum a arătat etalonul, araba lui Khalid a rămas în scriere arabă. Rezultatul a fost același cu detectare automată și cu language=en, pentru că language selectează reguli de formatare, nu forțează o limbă de ieșire.
Etalonul a păstrat cifrele rostite separat. Inverse Text Normalization (ITN) transformă aceste forme rostite în unele scrise. format=true îl activează și are nevoie de language, altfel cererea eșuează cu 400.
Numărul de telefon a devenit un șir continuu de cifre. Emailul a fost doar parțial normalizat: punctuația s-a îmbunătățit, dar „at”-ul rostit și domeniul literat au mai avut nevoie de curățare.
Acest rezultat neuniform e frustrant. ITN formatează textul; nu validează datele de contact. Aș valida ambele câmpuri înainte de stocare.
ITN poate rescrie și expresii obișnuite de durată ca valori abreviate. În răspunsul batch formatat pentru acest fixture, doar text-ul de nivel superior a fost normalizat; array-ul words a păstrat forma rostită.
După cum a arătat etalonul, umpluturile sunt eliminate din text și words în mod implicit. filler_words=true le-a readus „ăă” și „hmm” ale lui Khalid acolo unde era de așteptat. Ține-le dezactivate pentru notele de suport și active pentru un registru verbatim de QA.
Ieșirea batch include controlul vorbitorilor, vocabularului, formatării și cuvintelor de umplutură. În continuare, trimite același audio ca flux live.
Calea de streaming folosește parametri de interogare, nu un mesaj de inițializare. Așteaptă transcript.created, trimite audio binar brut (fără base64) și închide cu {"type": "audio.done"}. Tutorialul nostru GPT Live Transcribe folosește același tipar cu un alt model.
Începe cu evenimentele, apoi conectează clientul.
Batch folosește format=true documentat cu language=en. Documentația de streaming spune că language activează ITN, dar într-o probă live, language=en singur nu a schimbat transcrierea. Lista de parametri WebSocket nu include format, așa că acest tutorial tratează ITN în streaming ca un comportament de verificat, nu de presupus.
Fiecare actualizare de transcriere este un eveniment transcript.partial cu doi booleeni. Textul interimar se poate schimba. Un chunk final (is_final=true) blochează aproximativ 3 secunde de text cât timp tura rămâne deschisă, iar un final de enunț (speech_final=true) închide tura.
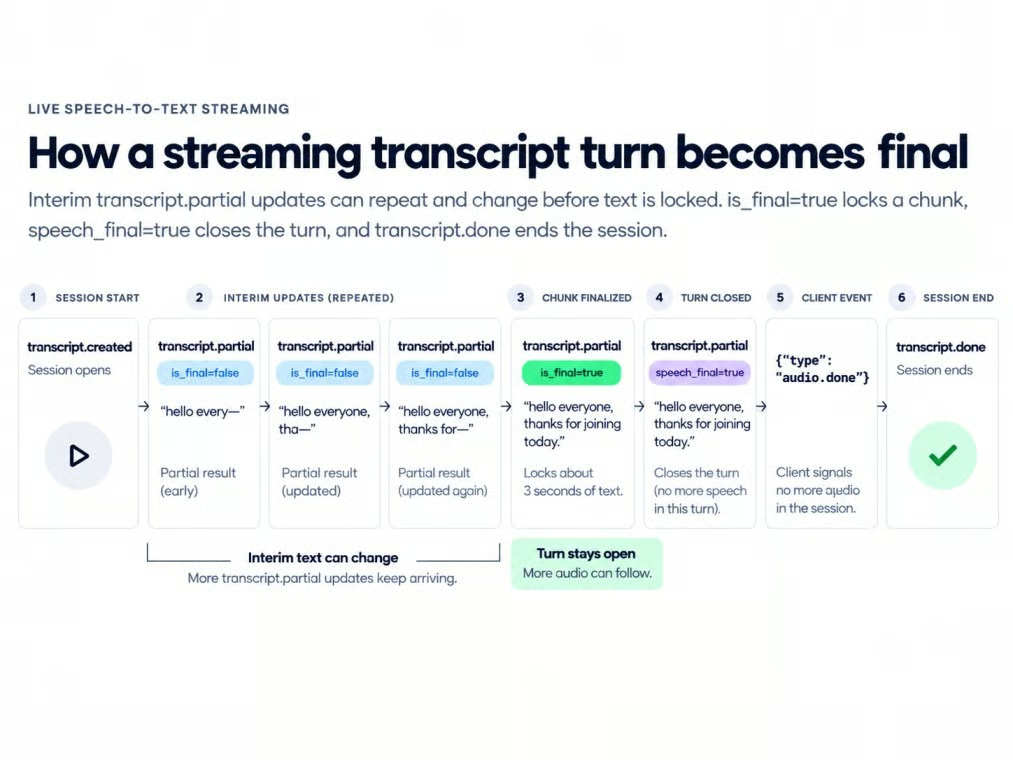
Stările de streaming duc textul către finalizare. Imagine de autor.
Pentru streaming, resamplează mai întâi sursa la mono PCM pe 16 biți la 16 kHz. Clientul de bază trimite bucăți de 100 de milisecunde în ritm de timp real, în timp ce o altă sarcină primește evenimentele de transcriere:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Textul interimar a crescut cam la fiecare jumătate de secundă. Aceasta este o măsurare locală, nu o latență oficială.
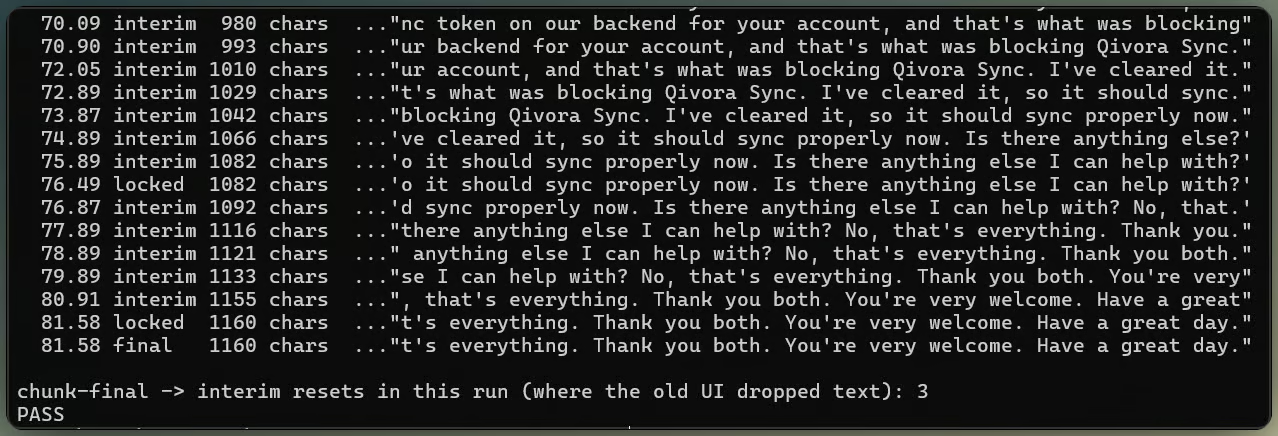
Subtitrările parțiale se stabilizează în transcrierea finală. Imagine de autor.
Finalele de chunk îngheață textul fără a închide tura. Smart Turn controlează când speech_final o închide.
Afișarea doar a evenimentului activ face ca cuvintele anterioare să dispară după fiecare final de chunk, deoarece următorul interimar pornește din nou de la audio-ul care sosește.
Păstrează fiecare chunk blocat, anexează interimarul curent și lasă finalul de enunț să le înlocuiască pe amândouă.
Textul poate crește fără a pierde bucățile anterioare. Odată rezolvată starea de afișare, granițele de tură rămân problema streamingului.
Smart Turn evaluează fiecare tăcere și estimează dacă vorbitorul a terminat. Există pentru numărul lui Khalid, „zero unu zero, cinci cinci cinci, [pauză], unu doi trei patru”, unde tăcerea singură nu poate separa o pauză de gândire de final.
Pragul nu este încrederea transcrierii și nici pragul VAD. Este probabilitatea de final de tură pe care o tăcere trebuie s-o depășească pentru ca speech_final să pornească; sub ea, tura rămâne deschisă. Doi parametri de interogare o setează:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
Documentația numește 0.5 echilibrat, 0.7 conservator pentru secvențe de numere și 0.9 foarte conservator. În acest fixture, pauzele mai scurte decât fereastra implicită de endpointing nu au produs o decizie utilă Smart Turn. Acesta este un rezultat observat, nu o regulă de temporizare documentată.
În testul de streaming, oprirea cadrelor audio nu a avansat cronometrul de tăcere observat. Continuarea trimiterii de tăcere digitală permite lui Smart Turn să închidă enunțul.
Prelungirea pauzei în timpul dictării numărului face comportamentul vizibil. Pauzele scurte rămân într-o singură tură, în timp ce o pauză lungă o împarte la fiecare prag când încrederea depășește toate cele trei setări.
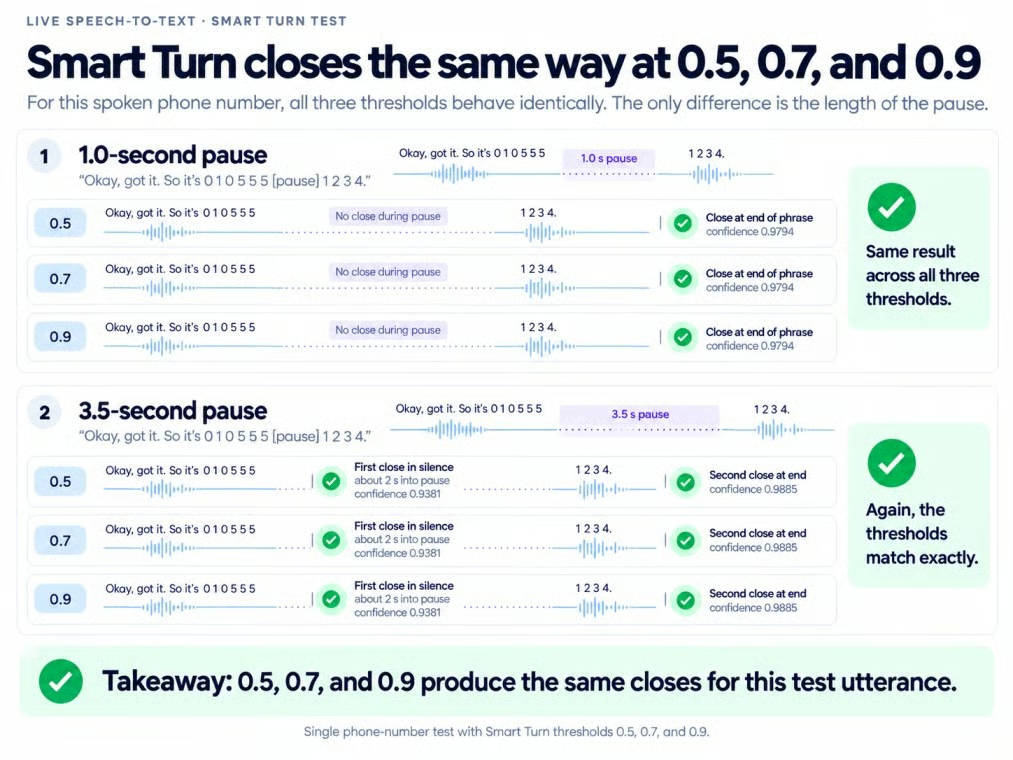
Pauzele lungi pot împărți dictarea numerelor. Imagine de autor.
Apelanții umani sunt mai imprevizibili. O secvență scurtă de cifre poate părea încheiată. Apoi apelantul continuă.
Dacă Smart Turn închide în timpul dictării numărului, așteaptă puțin și unește o continuare înainte de a răspunde.
smart_turn_timeout închide o tură după o tăcere fixă, chiar dacă Smart Turn nu e sigur. Pe fluxul rapid cu trei vorbitori, Smart Turn a grupat mai multe ture cunoscute înainte ca timeout-ul să forțeze închiderea.
Dacă știi deja unde se termină turele, trimite {"type": "finalize"} la fiecare limită; altfel, cuplează Smart Turn cu un timeout.
După ce granițele de tură sunt sub control, același apelant trebuie să reziste unei linii de 8 kHz.
Audio de calitate telefonică aici este G.711 mu-law la 8 kHz, obținut din același apel:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawAudio-ul de telefon brut nu are container, așa că setează audio_format=mulaw și sample_rate=8000 în formularul batch, sau encoding=mulaw&sample_rate=8000 pe socket. Verifică separat textul și etichetele de vorbitor.
Constatările anterioare privind termenii-cheie, formatarea și comutarea limbii s-au schimbat puțin la 8 kHz.
Etichetele de vorbitor au devenit mai puțin fiabile. Versiunea de telefon a introdus un ID suplimentar de vorbitor și a atribuit o tură de închidere persoanei greșite. Doar numărarea segmentelor ascunde ambele greșeli.
Versiunea instabilă limitează banda apelului la 300-3400 Hz, îl codifică drept mu-law la 8 kHz și renunță la fiecare pachet de 20 de milisecunde cu probabilitatea 0.03. O sămânță aleatoare fixă 7 păstrează aceleași goluri la fiecare redare.
Acea pierdere de pachete nu a schimbat mult transcrierea în engleză în acest eșantion, iar detaliile de contact rostite au rămas în ordine. Acest rezultat se aplică doar acestui eșantion.
Simularea de telefon îngustează audio-ul și pierde pachete. Imagine de autor.
Detecția activității vocale (VAD) decide dacă audio-ul este vorbire deloc. Documentația sugerează scăderea vad_threshold pentru vorbire de telefon înceată, cu riscul de text parazit din zgomot.
Scăderea vad_threshold nu a schimbat nimic pe audio de telefon curat, pentru că nu a existat vorbire încetă de recuperat. Rezultatul nul susține o regulă: scade pragul doar când vorbirea de telefon lipsește.
Folosește un formular batch nou, fără diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API-ul detectează numărul de canale dintr-un WAV sau alt container. Pentru audio multicanal brut, adaugă ("channels", "3"); intrarea multicanal pe WebSocket necesită și ea un număr de canale explicit.
Trimite formularul cu fișierul multicanal prin cererea REST de mai devreme, apoi citește result["channels"]. Fiecare element conține un index, textul transcrierii și cuvinte cu timpi. În fixture-ul controlat cu trei canale, fiecare canal a conținut doar vorbitorul său alocat. Streamingul folosește aceeași împărțire și adaugă channel_index evenimentelor sale.
Aș folosi picioare separate ori de câte ori sistemul telefonic le oferă. Spre deosebire de diarizarea din secțiunea audio de telefon, o împărțire cunoscută nu deduce vorbitori.
Clientul complet expune un grup de setări, apoi construiește separat formularul REST sau URL-ul WebSocket. Setările comune acoperă diarizarea, termenii-cheie, cuvintele de umplutură, codarea audio și gestionarea turaelor; formatarea urmează regulile specifice transportului acoperite mai sus.
Aplică setările finale la o înregistrare de calitate telefonică, apoi verifică separat ortografia produsului, comutările de limbă, detaliile de contact și etichetele de vorbitor. În fixture-ul controlat, verificările de text au trecut, în timp ce o etichetă de vorbitor a necesitat totuși revizuire. Salvează setările și maparea vorbitorilor odată cu fiecare transcriere, astfel încât comparațiile ulterioare să folosească aceeași configurare.
Tutorialul de transcriere pentru suport se încheie cu acea verificare finală. Repository-ul conține și o extensie separată de agent vocal cu răspunsuri generate, ieșire vorbită, întreruperi și gestionarea ecoului.
Transcribe păstrează același rol în acel demo: produce text. Un model de limbaj scrie răspunsurile, iar Grok TTS le rostește.
Învață AI cu DataCamp!
Traseu de învățare
Traseu de învățare
Curs