Programa
Associate AI Engineer para desenvolvedores
26 h
O Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) é o modelo de fala para texto da SpaceXAI. A rota REST transcreve um arquivo finalizado, enquanto o WebSocket lida com áudio ao vivo.
O anúncio do Grok Voice Transcribe 2.0 da SpaceXAI destaca chamadas telefônicas, múltiplos falantes, credenciais e fala multilíngue. Para comparações de benchmark, veja nosso panorama do Grok Voice Transcribe 2.0.
O cenário controlado do Qivora Sync permanece fixo enquanto o áudio e as configurações da API mudam. A chamada inclui um nome de produto inventado, preenchimentos, troca de idioma, dados de contato ditados, uma pausa durante a digitação e um terceiro falante.
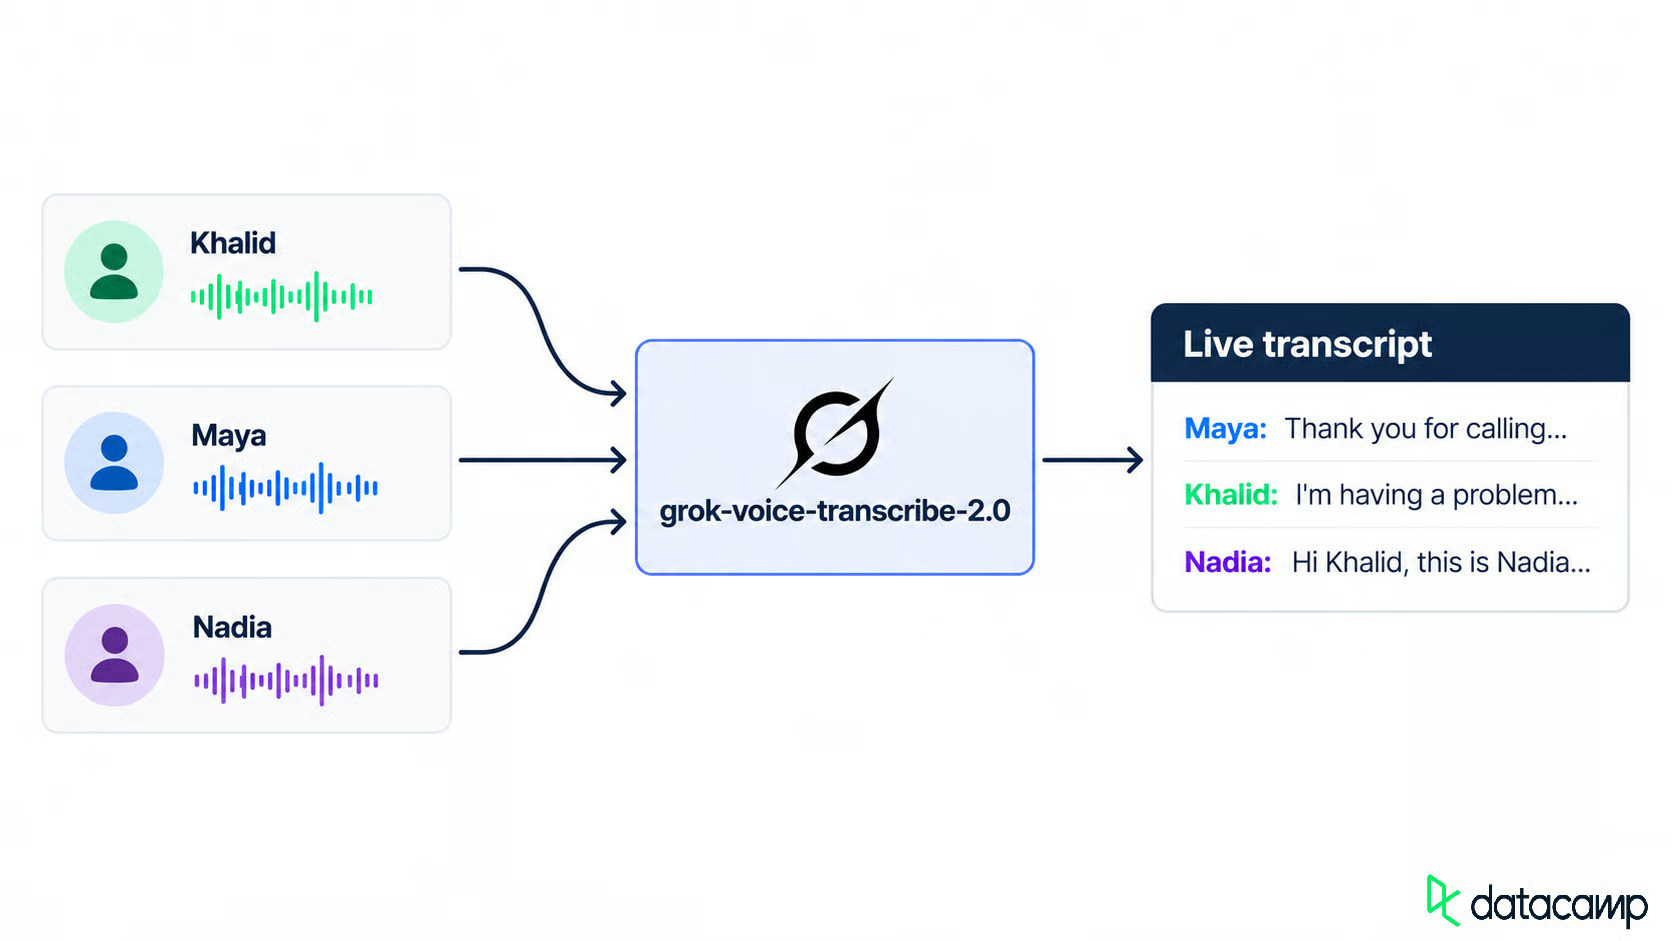
Três falantes viram uma transcrição ao vivo. Imagem do autor.
O cenário controlado usa três vozes distintas do Grok Text to Speech API. Cada trecho de idioma é sintetizado separadamente e unido com ffmpeg para que os pontos de troca permaneçam fixos. A API também aceita language=auto; requisições separadas são uma escolha de design do experimento, não uma exigência da API.
Antes da primeira requisição, defina o texto esperado, falantes, grafia do produto, dados do cliente, preenchimentos e pausas. Assim, cada configuração terá o mesmo alvo.
Instale as dependências antes de enviar o áudio.
Você precisa do Python 3.10 ou superior, de uma chave de API xAI e do ffmpeg para montar o áudio. Os clientes em Python usam requests, websockets e python-dotenv.
A documentação de Speech to Text informa que a versão 2.0 é o padrão quando você omite model, e que grok-voice-transcribe-1.0 chegou ao fim de vida em 2 de outubro de 2026. Ainda assim, eu fixaria o ID versionado.
Clone o repositório, adicione sua chave ao .env e gere o áudio de exemplo:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # depois cole sua chave no .env
python project/scripts/make_fixtures.py
O comando de setup cria o diálogo e os arquivos de áudio usados depois. Se você tiver sua própria gravação, pode pular esse comando.
Um .env escrito no Windows pode deixar um \r na chave, e o requests rejeita o header antes de algo chegar à SpaceXAI. Remova espaços/quebras da chave antes de usá-la no header de autorização.
A linha de base é o modelo sem nada ativado, para que cada mudança posterior tenha com o que comparar. A primeira requisição envia o arquivo e um modelo fixado:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
A resposta traz text, language detectado, duration e um array words com tempos. A referência REST mostra confidence por palavra, mas esse campo não apareceu nas respostas em lote deste cenário. Trate-o como opcional e verifique cada resposta antes de usar. Coloque campos opcionais antes de file; campos depois podem ser ignorados.
Na linha de base, os preenchimentos foram removidos, o árabe ficou em escrita árabe e os dígitos ditos permaneceram separados. O nome de produto inventado saiu grafado errado de forma consistente.
Uma transcrição de suporte precisa de rótulos de falante, grafia correta do produto e dados de contato utilizáveis. Cada ajuste é mais um campo no formulário:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # um id de falante em cada palavra
    ("keyterm", "Qivora Sync"),  # repita o campo para mais termos
    ("language", "en"),          # exigido pelo format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # padrão; true mantém "uh" e "um"
]
Ative uma opção por vez no mesmo áudio. Comece pelos rótulos de falante.
Diarização de falantes atribui IDs numéricos, não nomes. Agrupe palavras consecutivas com o mesmo ID para formar os turnos:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Em áudio limpo, cada turno conhecido manteve um ID consistente. Mapear nomes pela ordem de primeira aparição só funciona quando a ordem dos falantes já é conhecida; sistemas de produção precisam do próprio mapeamento.
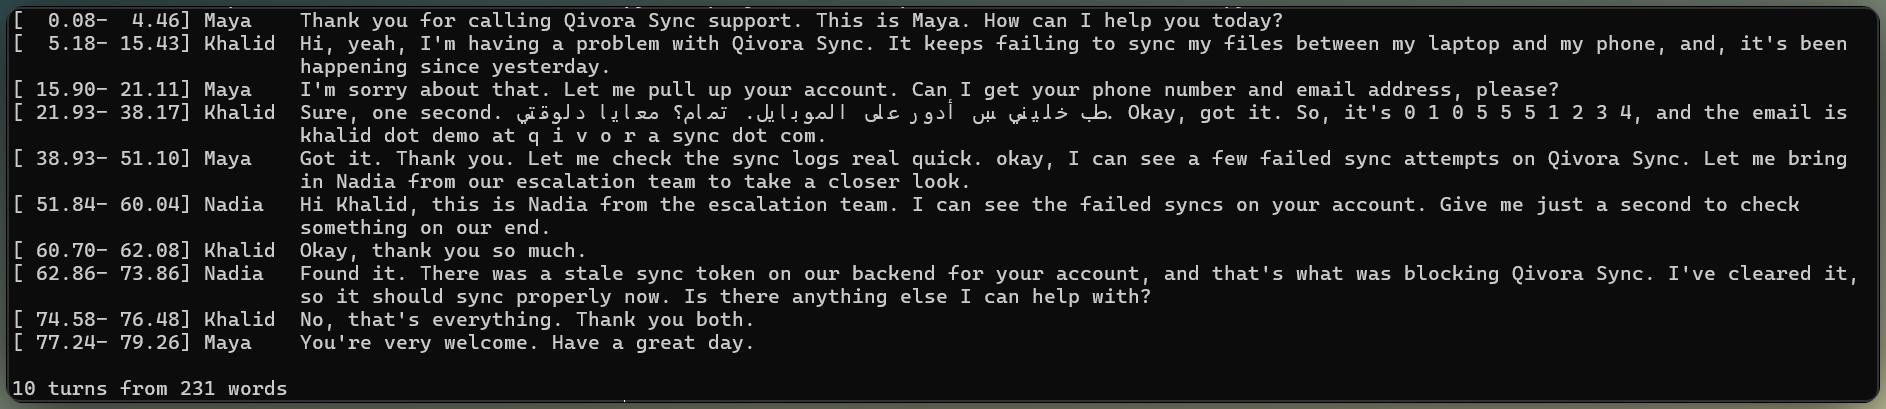
Áudio limpo mantém rótulos de falante consistentes. Imagem do autor.
O viés por termo-chave é uma dica por requisição, não treinamento. Passe keyterm=Qivora Sync (até 100 termos, 50 caracteres cada), e o modelo tende àquela grafia quando o áudio sustenta.
O termo-chave corrigiu o erro de grafia do nome do produto na linha de base sem alterar o restante da transcrição.
Em um teste à parte, com falante ao vivo, um vocabulário fortemente enviesado puxou um eco sutil para o termo-chave. Isso não significa que termos-chave criem texto falso sozinhos; significa que áudio ambíguo ainda precisa de checagem de eco.
Como a linha de base mostrou, o árabe do Khalid permaneceu em escrita árabe. O resultado foi o mesmo com detecção automática e com language=en, porque language define regras de formatação, não força um idioma de saída.
A linha de base manteve dígitos ditos de forma separada. A Inverse Text Normalization (ITN) transforma fala em escrita. format=true ativa isso e requer language, senão a requisição falha com 400.
O telefone virou uma sequência contínua de dígitos. O e-mail foi apenas parcialmente normalizado: a pontuação melhorou, mas o "at" falado e o domínio soletrado ainda precisaram de ajuste.
Esse resultado desigual frustra. ITN formata texto; não valida contatos. Eu validaria ambos os campos antes de armazenar.
A ITN também pode reescrever durações comuns como quantidades abreviadas. Na resposta formatada em lote deste cenário, apenas o text de nível superior foi normalizado; o array words manteve a forma falada.
Como a linha de base mostrou, preenchimentos são removidos de text e words por padrão. filler_words=true trouxe de volta os "uh" e "um" do Khalid nos pontos esperados. Deixe desligado para notas de suporte e ligado para registro verbatim de QA.
A saída em lote inclui falantes, vocabulário, formatação e controle de preenchimentos. Em seguida, envie o mesmo áudio como stream ao vivo.
A rota de streaming usa parâmetros de query em vez de mensagem de setup. Aguarde transcript.created, envie áudio binário bruto (sem base64) e finalize com {"type": "audio.done"}. Nosso tutorial do GPT Live Transcribe usa o mesmo padrão com outro modelo.
Comece entendendo os eventos e depois conecte o cliente.
Em lote, usa-se o format=true documentado com language=en. A documentação de streaming diz que language liga a ITN, mas, em uma sonda ao vivo, language=en sozinho não alterou a transcrição. A lista de query do WebSocket não inclui format, então este tutorial trata a ITN em streaming como comportamento a verificar, não como dependência.
Cada atualização de transcrição é um evento transcript.partial com dois booleanos. O texto intermediário ainda pode mudar. Um chunk final (is_final=true) trava cerca de 3 segundos de texto enquanto o turno permanece aberto, e um final de enunciado (speech_final=true) fecha o turno.
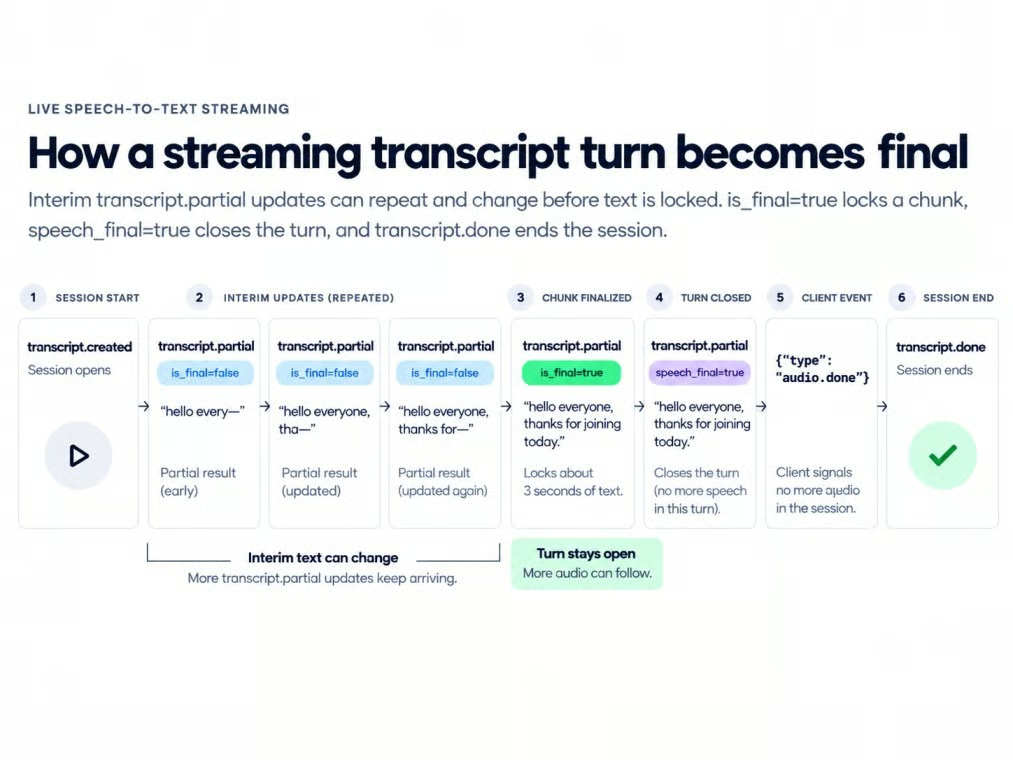
Os estados de streaming levam o texto à finalização. Imagem do autor.
Para streaming, reamostre a fonte para PCM mono 16 bits a 16 kHz antes. O cliente central envia blocos de 100 milissegundos em ritmo de tempo real enquanto outra tarefa recebe os eventos da transcrição:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
O texto intermediário cresceu cerca de a cada meio segundo. É uma medida local, não latência oficial.
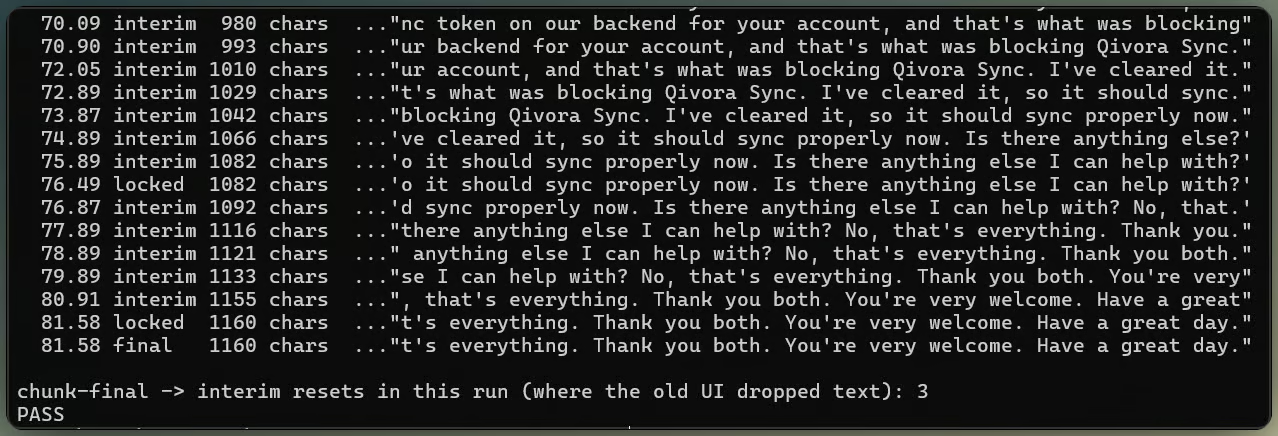
Legendas parciais se consolidam na transcrição final. Imagem do autor.
Chunks finais congelam o texto sem fechar o turno. O Smart Turn controla quando speech_final fecha o turno.
Exibir apenas o evento ativo faz as palavras anteriores desaparecerem após o final de cada chunk, porque o próximo interim recomeça a partir do áudio de entrada.
Guarde cada chunk travado, anexe o interim atual e deixe o final do enunciado substituir ambos.
Assim o texto cresce sem perder os chunks anteriores. Com o estado de exibição resolvido, as fronteiras de turno são o problema restante no streaming.
O Smart Turn avalia cada silêncio e estima se o falante terminou. Ele existe para o número do Khalid: "zero one zero, five five five, [pausa], one two three four", em que só o silêncio não distingue uma pausa de pensamento do fim.
O limiar não é a confiança de transcrição nem o limiar de VAD. É a probabilidade de fim de turno que um silêncio precisa superar para speech_final disparar; abaixo dela, o turno fica aberto. Dois parâmetros de query definem isso:
params += [
    ("smart_turn", "0.7"),           # prob. de fim de turno necessária para fechar
    ("smart_turn_timeout", "3000"),  # fecha de qualquer forma após 3 s de silêncio
]
A documentação chama 0,5 de equilibrado, 0,7 de conservador para sequências numéricas e 0,9 de muito conservador. Neste cenário, pausas mais curtas que a janela padrão de endpointing não produziram uma decisão útil do Smart Turn. É um resultado observado, não uma regra de tempo documentada.
No teste de streaming, parar de enviar quadros de áudio não avançou o temporizador de silêncio observado. Continuar enviando silêncio digital permite que o Smart Turn feche o enunciado.
Estender a pausa durante a ditagem do número torna o comportamento visível. Pausas curtas ficam dentro de um turno, enquanto uma pausa longa divide o turno em todos os limiares quando a confiança supera os três ajustes.
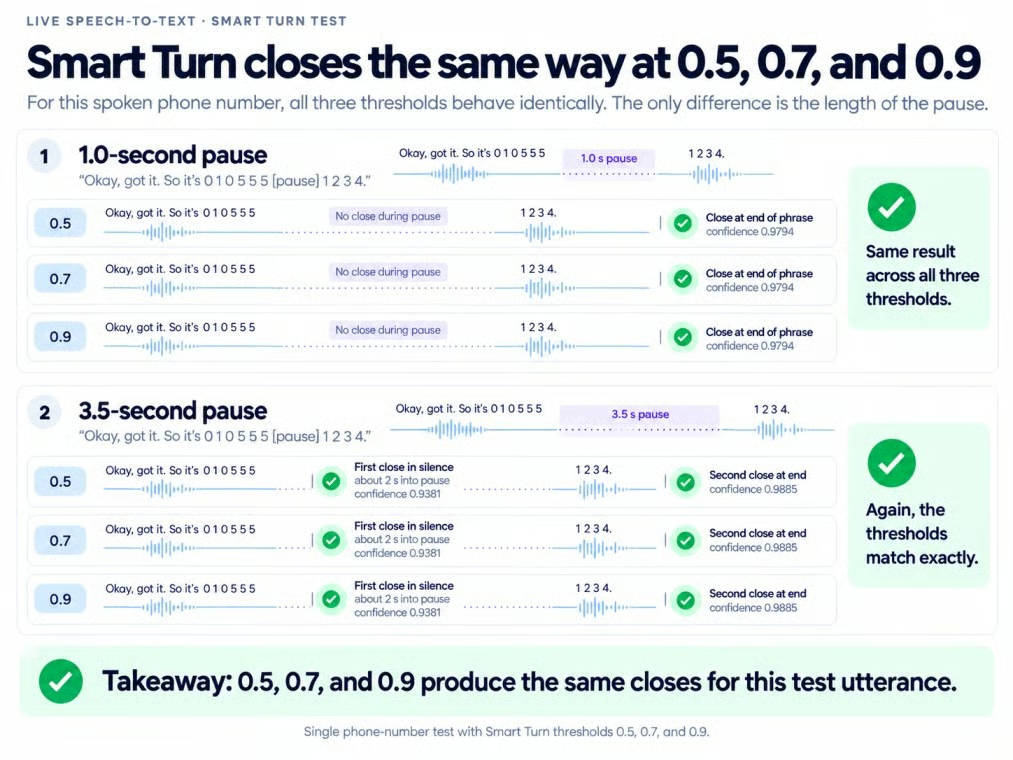
Pausas longas podem dividir a ditagem do número. Imagem do autor.
Chamadores humanos são menos previsíveis. Uma sequência curta de dígitos pode parecer concluída e, em seguida, o cliente continua.
Se o Smart Turn fechar durante a ditagem, aguarde um instante e una uma continuação antes de responder.
smart_turn_timeout fecha um turno após um silêncio fixo, mesmo quando o Smart Turn está inseguro. No stream rápido de três falantes, o Smart Turn agrupou vários turnos conhecidos antes de um timeout forçar o fechamento.
Se você já sabe onde os turnos acabam, envie {"type": "finalize"} em cada fronteira; caso contrário, combine Smart Turn com um timeout.
Com as fronteiras controladas, o mesmo interlocutor precisa sobreviver a uma linha de 8 kHz.
Aqui, áudio em qualidade telefônica é G.711 mu-law de 8 kHz, gerado da mesma chamada:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawÁudio de telefonia bruto não tem contêiner, então defina audio_format=mulaw e sample_rate=8000 no formulário em lote, ou encoding=mulaw&sample_rate=8000 no socket. Verifique texto e rótulos de falante separadamente.
As conclusões sobre termos-chave, formatação e troca de idioma mudaram pouco a 8 kHz.
Os rótulos de falante ficaram menos confiáveis. A versão telefônica introduziu um ID extra de falante e atribuiu um turno final à pessoa errada. Só contar segmentos esconde ambos os erros.
A versão instável limita a banda do áudio entre 300–3400 Hz, codifica em mu-law 8 kHz e descarta cada pacote de 20 ms com probabilidade de 0,03. Uma semente fixa 7 mantém as mesmas falhas em cada reprodução.
Essa perda de pacotes não alterou muito a transcrição em inglês neste sample, e os dados de contato ditados permaneceram na ordem. Este resultado vale apenas para este sample.
A simulação telefônica estreita o áudio e perde pacotes. Imagem do autor.
A detecção de atividade de voz (VAD) decide se há fala no áudio. A documentação sugere reduzir vad_threshold para fala telefônica mais baixa, com risco de texto espúrio por ruído.
Reduzir vad_threshold não mudou nada no áudio telefônico limpo porque não havia fala baixa a recuperar. O resultado nulo apoia uma regra: diminua o limiar apenas quando a fala telefônica estiver sumindo.
Use um formulário em lote novo, sem diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
A API detecta a contagem de canais a partir de um WAV ou outro contêiner. Para áudio multicanal bruto, adicione ("channels", "3"); no WebSocket, entrada multicanal também requer contagem explícita de canais.
Envie o formulário com o arquivo multicanal pela requisição REST mostrada antes e depois leia result["channels"]. Cada item contém um índice, texto e palavras com tempos. No cenário controlado de três canais, cada canal continha apenas seu falante atribuído. Em streaming, o mesmo corte se aplica e os eventos trazem channel_index.
Eu usaria perna separada sempre que o sistema telefônico fornecer. Diferente da diarização na seção de áudio telefônico, uma divisão conhecida não infere falantes.
O cliente completo expõe um conjunto de configurações e depois monta o formulário REST ou a URL do WebSocket separadamente. As configurações compartilhadas cobrem diarização, termos-chave, preenchimentos, codificação de áudio e tratamento de turnos; a formatação segue as regras específicas do transporte vistas antes.
Aplique as configurações finais a uma gravação em qualidade telefônica e depois verifique grafia do produto, trocas de idioma, dados de contato e rótulos de falante separadamente. No cenário controlado, os checks de texto passaram enquanto um rótulo de falante ainda exigiu revisão. Salve as configurações e o mapeamento de falantes com cada transcrição para que comparações futuras usem o mesmo setup.
O tutorial de transcrição de suporte termina nesse check final. O repositório também traz uma extensão de voice agent com respostas geradas, saída falada, interrupções e tratamento de eco.
No demo, Transcribe mantém o mesmo papel: produzir texto. Um modelo de linguagem escreve as respostas e o Grok TTS as fala.
Aprenda IA com a DataCamp!
Programa
Programa
Curso
Tutorial
Moez Ali
11 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Matt Crabtree
6 min
Tutorial
Abid Ali Awan
8 min
Tutorial
Zoumana Keita
14 min
Tutorial