Lernpfad
Associate AI Engineer für Entwickler
26 Std.
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) ist SpaceXAI's Speech-to-Text-Modell. Der REST-Pfad transkribiert eine fertige Datei, während der WebSocket-Pfad Live-Audio verarbeitet.
SpaceXAI's Ankündigung zu Grok Voice Transcribe 2.0 hebt Telefonanrufe, mehrere Sprecher, Zugangsdaten und mehrsprachige Sprache hervor. Für Benchmark-Vergleiche siehe unsere Grok Voice Transcribe 2.0 Übersicht.
Das kontrollierte Qivora Sync-Szenario bleibt konstant, während Audio und API-Einstellungen wechseln. Der Anruf enthält einen erfundenen Produktnamen, Füllwörter, einen Sprachwechsel, gesprochene Kontaktdaten, eine Pause beim Diktat und einen dritten Sprecher.
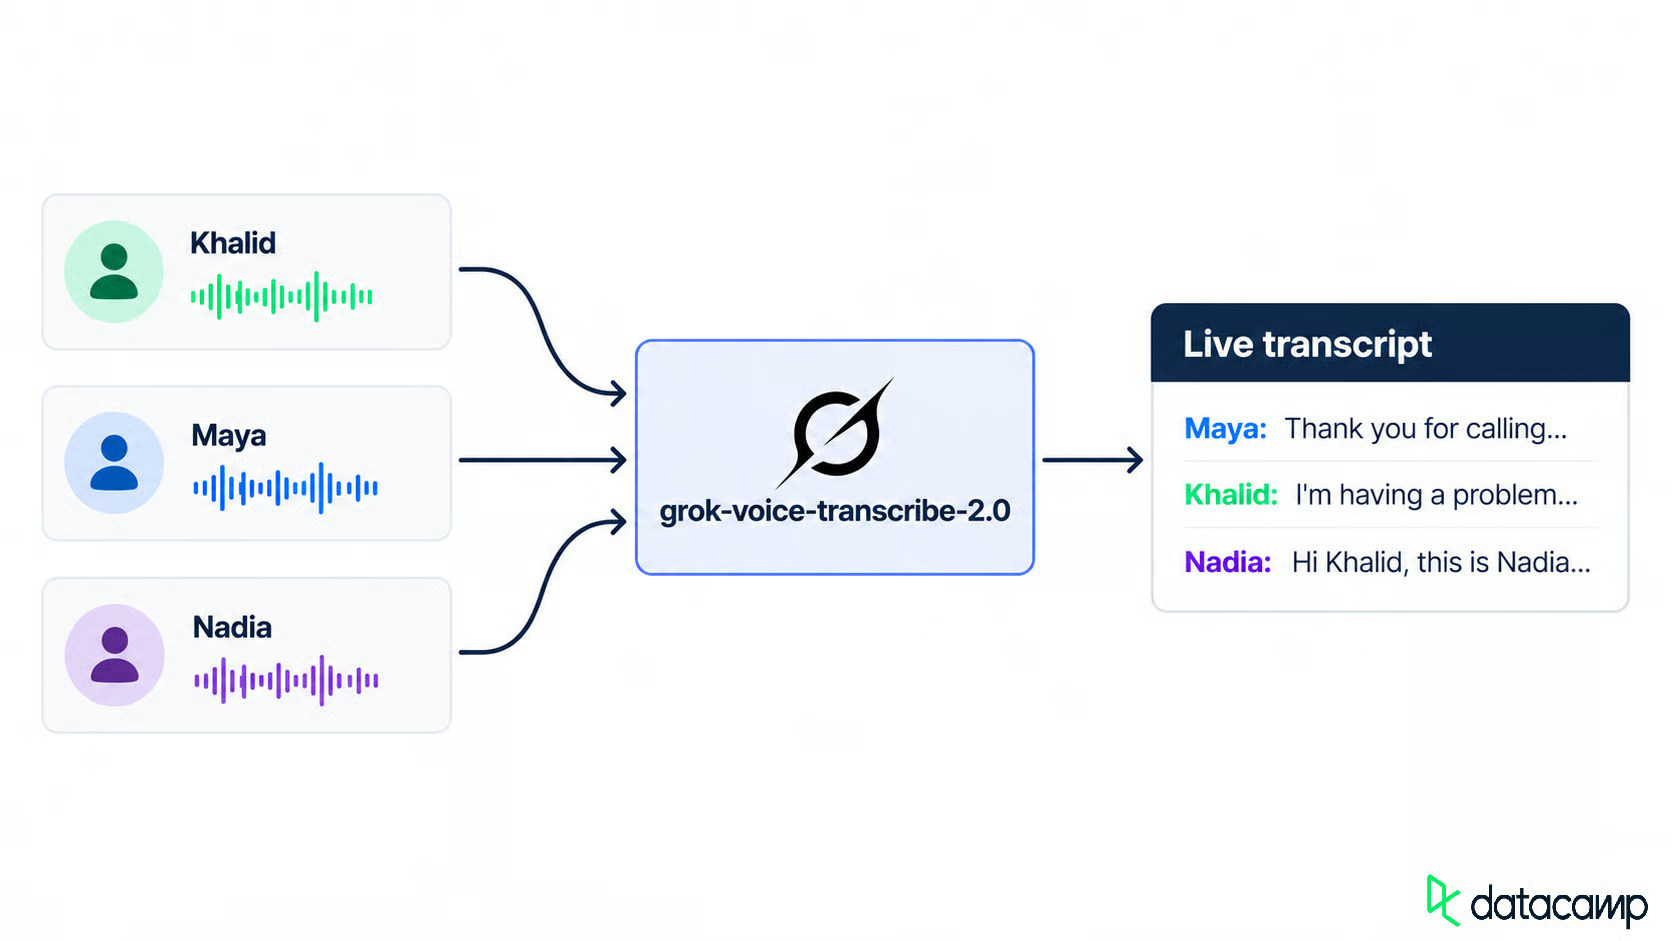
Drei Sprecher werden zu einem Live-Transkript. Bild: Autor.
Das kontrollierte Setup nutzt drei unterschiedliche Stimmen aus der Grok Text to Speech API. Jede Sprachsequenz wird separat synthetisiert und mit ffmpeg zusammengefügt, damit die Wechselpunkte exakt bleiben. Die API akzeptiert auch language=auto; separate Requests sind eine Designentscheidung für das Experiment, keine API-Vorgabe.
Lege vor dem ersten Request den erwarteten Text, die Sprecher, die Produktschreibweise, Kundendaten, Füllwörter und Pausen fest. Jede Konfiguration hat dann dasselbe Zielbild.
Installiere die Abhängigkeiten, bevor du Audio sendest.
Du brauchst Python 3.10 oder neuer, einen xAI API Key und ffmpeg zum Erstellen des Audios. Die Python-Clients verwenden requests, websockets und python-dotenv.
Die Speech-to-Text-Dokumentation nennt 2.0 als Standard, wenn du model weglässt, und grok-voice-transcribe-1.0 wurde am 2. Oktober 2026 abgekündigt. Ich würde die versionierte ID trotzdem festhalten.
Klon das Repository, füge deinen Key in .env ein und erstelle das Beispielaudio:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # dann deinen Key in .env eintragen
python project/scripts/make_fixtures.py
Der Setup-Befehl erzeugt den Dialog und die Audiodateien, die später verwendet werden. Wenn du deine eigene Aufnahme hast, kannst du diesen Schritt überspringen.
Eine auf Windows geschriebene .env kann ein \r am Key hinterlassen, und requests weist den Header ab, bevor etwas bei SpaceXAI ankommt. Entferne das Zeichen, bevor du den Key in den Authorization-Header setzt.
Eine Baseline ist das Modell ohne Extras, damit jede spätere Änderung einen Vergleich hat. Die erste Anfrage sendet die Datei und ein festgelegtes Modell:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
Die Antwort enthält text, erkannte language, duration und ein zeitgestempeltes words Array. Die REST-Referenz zeigt pro Wort eine confidence, die in den Batch-Antworten für dieses Setup jedoch nicht erschien. Behandle das Feld als optional und prüfe jede API-Antwort, bevor du es nutzt. Setze optionale Felder vor file; spätere Felder könnten ignoriert werden.
Die Baseline entfernte Füllwörter, behielt Arabisch in arabischer Schrift und ließ gesprochene Ziffern getrennt. Den erfundenen Produktnamen schrieb sie durchgängig falsch.
Ein Support-Transkript braucht Sprecherlabels, die korrekte Produktschreibweise und brauchbare Kundendaten. Jede Einstellung ist ein weiteres Formularfeld:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # eine Sprecher-ID auf jedem Wort
    ("keyterm", "Qivora Sync"),  # Feld wiederholen für weitere Begriffe
    ("language", "en"),          # von format erforderlich
    ("format", "true"),          # inverse Textnormalisierung
    ("filler_words", "false"),   # Standard; true behält "uh" und "um"
]
Füge Optionen nacheinander auf demselben Audio hinzu. Starte mit Sprecherlabels.
Speaker-Diarisierung vergibt Wörtern numerische Sprecher-IDs, keine Namen. Fasse aufeinanderfolgende Wörter mit gleicher ID zu Turns zusammen:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Bei sauberem Audio blieb jeder bekannte Turn konsistent bei einer Sprecher-ID. Namen nach der Reihenfolge des ersten Auftretens zuzuordnen, funktioniert nur, wenn die Anrufreihenfolge bekannt ist; produktive Systeme brauchen ihr eigenes Speaker-Mapping.
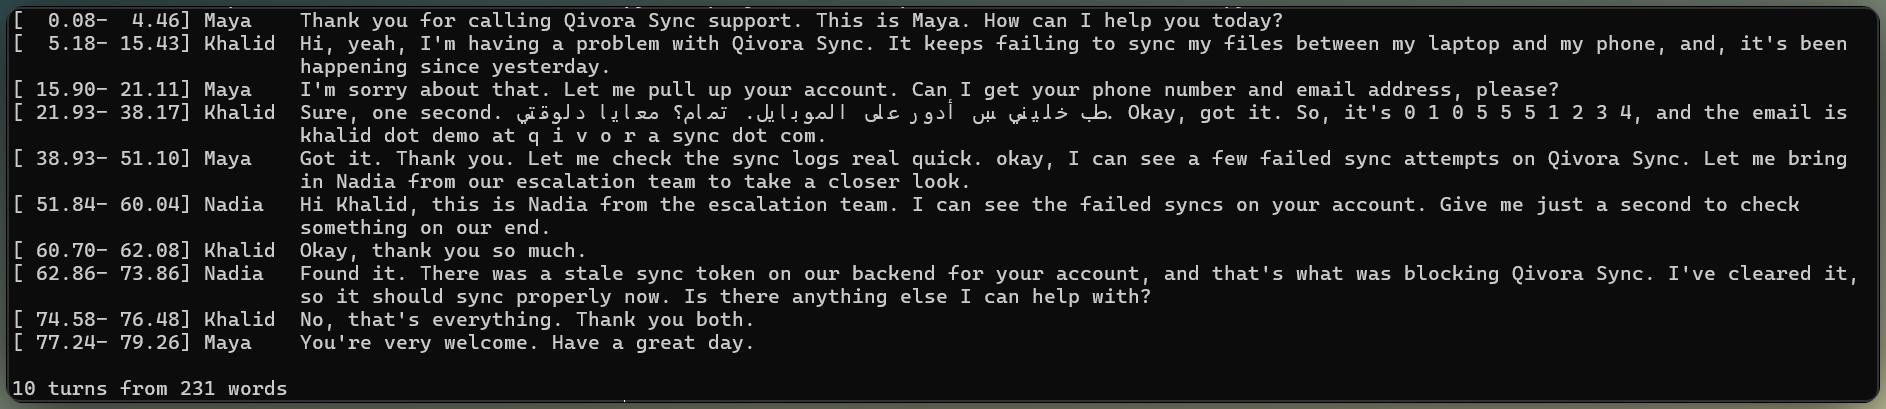
Sauberes Audio hält Sprecherlabels konsistent. Bild: Autor.
Keyterm-Biasing ist ein Hinweis pro Anfrage, kein Training. Übergebe keyterm=Qivora Sync (bis zu 100 Begriffe mit je 50 Zeichen), und das Modell tendiert zu dieser Schreibweise, wenn das Audio sie stützt.
Der Schlüsselbegriff korrigierte den Produktnamenfehler der Baseline, ohne das restliche Transkript zu verändern.
In einem separaten Live-Sprecher-Check zog starkes Biasing schwach hörbare Echos zum Keyterm hin. Das bedeutet nicht, dass Keyterms allein falschen Text erzeugen; mehrdeutiges Audio braucht weiterhin einen Echo-Check.
Wie in der Baseline blieb Khalids Arabisch in arabischer Schrift. Das Ergebnis war mit automatischer Erkennung und mit language=en gleich, weil language Formatierungsregeln auswählt statt eine Ausgabesprache zu erzwingen.
Die Baseline ließ gesprochene Ziffern getrennt. Inverse Textnormalisierung (ITN) verwandelt gesprochene in geschriebene Formen. format=true schaltet sie ein und erfordert language, sonst gibt es einen 400-Fehler.
Die Telefonnummer wurde zu einer durchgehenden Ziffernfolge. Die E-Mail wurde nur teilweise normalisiert: Die Zeichensetzung verbesserte sich, aber das gesprochene "at" und die buchstabierte Domain brauchten noch Nacharbeit.
Dieses uneinheitliche Ergebnis ist ernüchternd. ITN formatiert Text; es validiert keine Kontaktdaten. Ich würde beide Felder vor dem Speichern validieren.
ITN kann auch gewöhnliche Dauerangaben in abgekürzte Mengenangaben umschreiben. In der formatierten Batch-Antwort für dieses Setup wurde nur das oberste text normalisiert; das words-Array behielt die gesprochene Form.
Wie in der Baseline werden Füllwörter standardmäßig aus text und words entfernt. filler_words=true brachte Khalids "uh" und "um" wie erwartet zurück. Für Supportnotizen würde ich sie deaktiviert lassen, für ein wortgetreues QA-Protokoll aktivieren.
Batch-Ausgaben decken Sprecher, Vokabular, Formatierung und Füllwortsteuerung ab. Als Nächstes senden wir dasselbe Audio als Livestream.
Der Streaming-Pfad nutzt Query-Parameter statt einer Setup-Nachricht. Warte auf transcript.created, sende rohes Binäraudio (kein Base64) und schließe mit {"type": "audio.done"}. Unser GPT Live Transcribe Tutorial verwendet dasselbe Muster mit einem anderen Modell.
Starte mit den Events und verbinde dann den Client.
Batch nutzt das dokumentierte format=true mit language=en. Die Streaming-Dokumente sagen, dass language ITN aktiviert, aber in einem Live-Test änderte language=en allein das Transkript nicht. Die WebSocket-Query-Liste enthält format nicht, daher behandelt dieses Tutorial ITN im Stream als Verhalten, das man prüfen statt voraussetzen sollte.
Jedes Transkript-Update ist ein transcript.partial Event mit zwei Booleans. Zwischenstände können sich noch ändern. Ein Chunk-Finale (is_final=true) friert etwa 3 Sekunden Text ein, solange der Turn offen bleibt, und ein Utterance-Finale (speech_final=true) schließt den Turn.
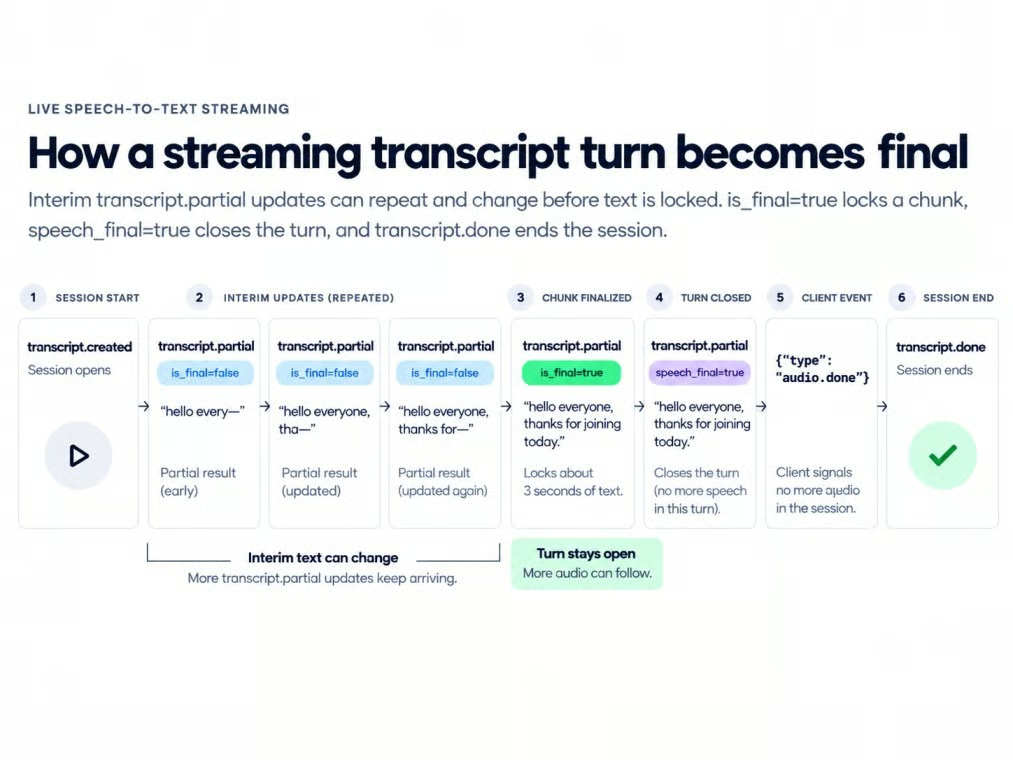
Streaming-Zustände führen den Text zur Finalisierung. Bild: Autor.
Für Streaming resample zuerst auf Mono 16-bit PCM bei 16 kHz. Der Kern-Client sendet 100-Millisekunden-Chunks in Echtzeit, während eine weitere Task Transkript-Events empfängt:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Interims-Text wuchs etwa alle halbe Sekunde. Das ist eine lokale Messung, keine offizielle Latenz.
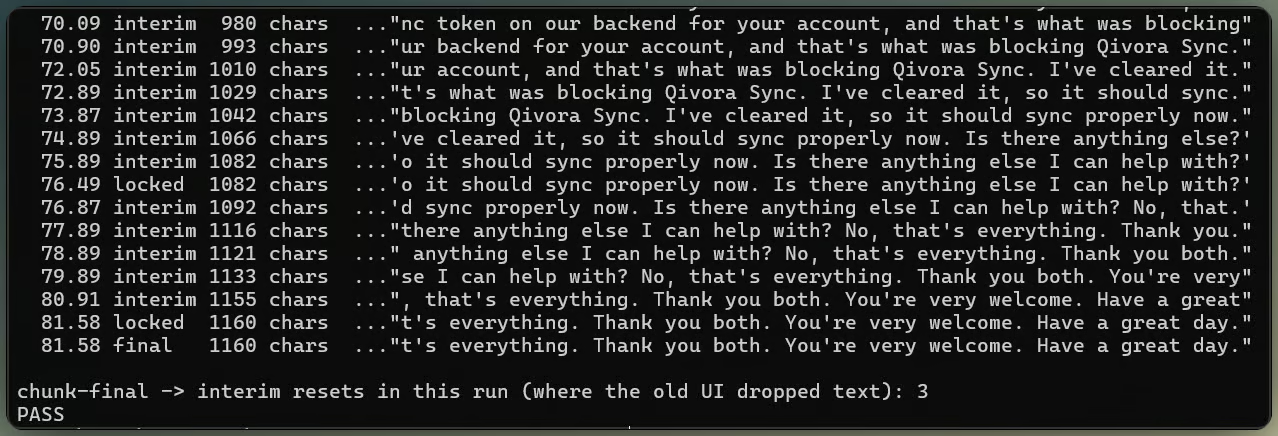
Partielle Untertitel werden zum finalen Transkript. Bild: Autor.
Chunk-Finals frieren Text ein, ohne den Turn zu schließen. Smart Turn steuert, wann speech_final ihn schließt.
Nur das aktive Event zu zeigen, lässt frühere Wörter nach jedem Chunk-Finale verschwinden, weil das nächste Interim vom eingehenden Audio neu beginnt.
Bewahre jeden fixierten Chunk auf, hänge das aktuelle Interim an und lass das Utterance-Finale beide ersetzen.
So kann der Text wachsen, ohne frühere Chunks zu verlieren. Mit geklärtem Anzeigezustand bleiben Turn-Grenzen als Streaming-Thema übrig.
Smart Turn bewertet jede Stille und schätzt, ob der Sprecher fertig ist. Es existiert für Khalids Nummer „zero one zero, five five five, [Pause], one two three four“, wo Stille allein keine Denkpause vom Ende unterscheidet.
Die Schwelle ist nicht die Transkriptionskonfidenz oder der VAD-Threshold. Sie ist die End-of-Turn-Wahrscheinlichkeit, die eine Stille überschreiten muss, bevor speech_final feuert; darunter bleibt der Turn offen. Zwei Query-Parameter setzen sie:
params += [
    ("smart_turn", "0.7"),           # End-of-Turn-Wahrscheinlichkeit zum Schließen
    ("smart_turn_timeout", "3000"),  # schließt trotzdem nach 3 s Stille
]
Die Doku nennt 0.5 ausgewogen, 0.7 konservativ für Zahlenfolgen und 0.9 sehr konservativ. In diesem Setup erzeugten Pausen kürzer als das Standard-endpointing-Fenster keine brauchbare Smart-Turn-Entscheidung. Das ist ein beobachteter Effekt, keine dokumentierte Timing-Regel.
Im Streaming-Test ließ das Stoppen der Audioframes den beobachteten Stillentimer nicht weiterlaufen. Wenn du digitale Stille weiter sendest, kann Smart Turn die Äußerung schließen.
Eine verlängerte Pause beim Zahldiktat macht das Verhalten sichtbar. Kurze Pausen bleiben in einem Turn, während eine lange Pause ihn bei jedem Schwellenwert teilt, sobald die Konfidenz alle drei Einstellungen übersteigt.
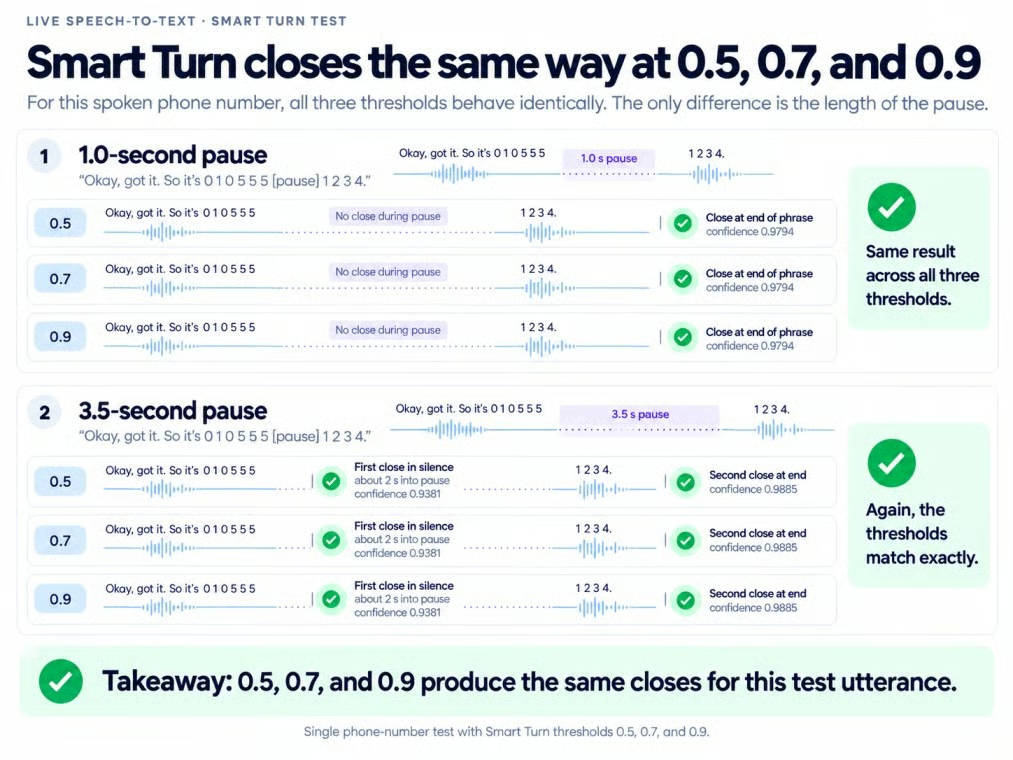
Lange Pausen können Zahldiktate aufsplitten. Bild: Autor.
Menschen sind weniger vorhersehbar. Eine kurze Ziffernfolge kann fertig wirken. Dann spricht der Anrufer weiter.
Wenn Smart Turn beim Zahldiktat schließt, warte kurz und füge eine Fortsetzung zusammen, bevor du antwortest.
smart_turn_timeout schließt einen Turn nach fixer Stille, auch wenn Smart Turn unsicher ist. Im schnellen Drei-Sprecher-Stream gruppierte Smart Turn mehrere bekannte Turns, bevor ein Timeout den Abschluss erzwang.
Wenn du Grenzen schon kennst, sende {"type": "finalize"} an jeder Stelle; sonst kombiniere Smart Turn mit einem Timeout.
Sind Turn-Grenzen im Griff, muss derselbe Anrufer noch eine 8-kHz-Leitung überstehen.
Telefonqualität ist hier 8 kHz G.711 mu-law, erzeugt aus demselben Anruf:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawRohes Telefonie-Audio hat keinen Container, daher setze im Batch-Formular audio_format=mulaw und sample_rate=8000, oder am Socket encoding=mulaw&sample_rate=8000. Prüfe Text und Sprecherlabels getrennt.
Die bisherigen Erkenntnisse zu Keyterms, Formatierung und Sprachwechsel änderten sich bei 8 kHz kaum.
Sprecherlabels wurden unzuverlässiger. Die Telefonversion führte eine zusätzliche Sprecher-ID ein und ordnete einen abschließenden Turn der falschen Person zu. Allein Segmente zu zählen, verdeckt beide Fehler.
Die wackelige Version bandbegrenzt den Anruf auf 300–3400 Hz, kodiert mit 8 kHz mu-law und verwirft jedes 20-ms-Paket mit Wahrscheinlichkeit 0,03. Ein fester Zufallssamen 7 behält dieselben Lücken bei jedem Replay.
Dieser Paketverlust änderte das englische Transkript in diesem Beispiel kaum, und die gesprochenen Kontaktdaten blieben in der Reihenfolge. Dieses Resultat gilt nur für dieses Sample.
Telefonsimulation verengt das Audio, Pakete gehen verloren. Bild: Autor.
Voice Activity Detection (VAD) entscheidet, ob Audio überhaupt Sprache ist. Die Doku empfiehlt, vad_threshold für leise Telefonsprache zu senken – mit dem Risiko, dass Störgeräusche als Text auftauchen.
Das Senken von vad_threshold änderte auf sauberem Telefon-Audio nichts, weil es keine leise Sprache zu retten gab. Das Nullergebnis stützt eine Regel: Senke die Schwelle nur, wenn Telefonsprache fehlt.
Nutze ein frisches Batch-Formular ohne diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
Die API erkennt die Kanalzahl aus einem WAV oder anderem Container. Für rohes Mehrkanal-Audio füge ("channels", "3") hinzu; WebSocket-Mehrkanalinput erfordert ebenfalls eine explizite Kanalzahl.
Sende das Formular mit der Mehrkanaldatei über den oben gezeigten REST-Request und lies dann result["channels"]. Jeder Eintrag enthält einen Index, Transkripttext und zeitgestempelte Wörter. Im kontrollierten Drei-Kanal-Setup enthielt jeder Kanal nur seinen zugewiesenen Sprecher. Streaming nutzt dieselbe Aufteilung und ergänzt channel_index in den Events.
Ich würde getrennte Leitungen nutzen, wann immer das Telefonsystem sie bereitstellt. Anders als die Diarisierung im Telefon-Audio-Abschnitt leitet ein bekannter Split keine Sprecher her.
Der vollständige Client stellt einen gemeinsamen Optionssatz bereit und baut dann separat das REST-Formular oder die WebSocket-URL. Geteilte Einstellungen umfassen Diarisierung, Schlüsselbegriffe, Füllwörter, Audio-Codierung und Turn-Handling; die Formatierung folgt den transportspezifischen Regeln von oben.
Wende die finalen Einstellungen auf eine Telefonaufnahme an und prüfe dann Produktschreibweise, Sprachwechsel, Kontaktdaten und Sprecherlabels getrennt. Im kontrollierten Setup bestanden die Textprüfungen, während ein Sprecherlabel noch Review brauchte. Speichere die Einstellungen und das Speaker-Mapping mit jedem Transkript, damit spätere Vergleiche dieselbe Konfiguration verwenden.
Das Support-Transkriptions-Tutorial endet mit diesem finalen Check. Das Repository enthält außerdem eine separate Voice-Agent-Erweiterung mit generierten Antworten, Sprachausgabe, Unterbrechungen und Echo-Handling.
Transcribe behält in diesem Demo dieselbe Rolle: Es liefert Text. Ein Sprachmodell schreibt die Antworten, und Grok TTS spricht sie.
Lerne KI mit DataCamp!
Lernpfad
Lernpfad
Kurs
Tutorial
Abid Ali Awan
7 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Allan Ouko
7 Min.