
Lộ trình
Kỹ sư Trợ lý Trí tuệ Nhân tạo (AI) cho Lập trình viên
26 giờ
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) là mô hình chuyển giọng nói thành văn bản của SpaceXAI. Đường REST chép lại một tệp đã hoàn tất, trong khi đường WebSocket xử lý âm thanh trực tiếp.
Thông báo Grok Voice Transcribe 2.0 của SpaceXAI nhấn mạnh cuộc gọi điện thoại, nhiều người nói, thông tin xác thực và giọng nói đa ngôn ngữ. Để so sánh benchmark, xem tổng quan Grok Voice Transcribe 2.0 của chúng tôi.
Bộ cố định Qivora Sync được kiểm soát giữ nguyên, trong khi âm thanh và cài đặt API thay đổi. Cuộc gọi gồm tên sản phẩm hư cấu, từ đệm, chuyển ngôn ngữ, thông tin liên hệ đọc bằng miệng, một khoảng ngắt khi đọc chính tả, và người nói thứ ba.
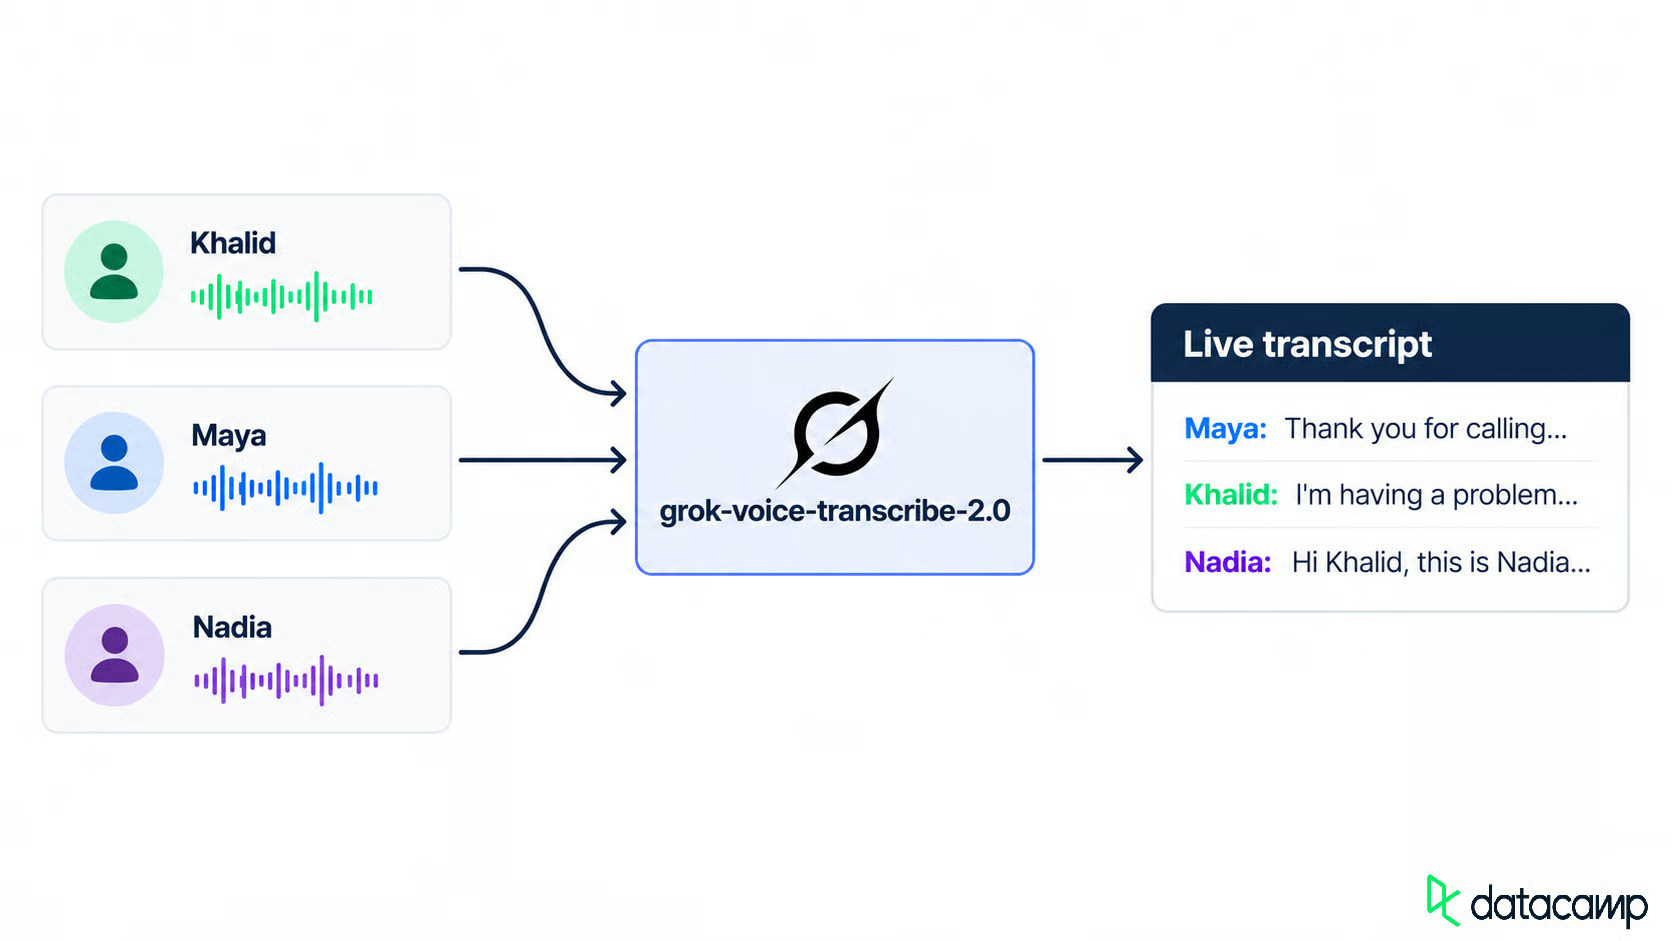
Ba người nói trở thành một bản chép trực tiếp. Ảnh: Tác giả.
Bộ cố định có kiểm soát sử dụng ba giọng khác biệt từ API Grok Text to Speech. Mỗi đoạn ngôn ngữ được tổng hợp riêng và ghép bằng ffmpeg để điểm chuyển đổi giữ nguyên. API cũng chấp nhận language=auto; gửi riêng là lựa chọn thiết kế thí nghiệm, không phải yêu cầu của API.
Trước yêu cầu đầu tiên, xác định văn bản kỳ vọng, người nói, cách viết tên sản phẩm, thông tin khách hàng, từ đệm và khoảng ngắt. Mỗi thiết lập sau đó đều có cùng mục tiêu.
Cài đặt phụ thuộc trước khi gửi âm thanh.
Bạn cần Python 3.10 trở lên, một khóa API xAI, và ffmpeg để dựng âm thanh. Các client Python dùng requests, websockets, và python-dotenv.
Tài liệu Speech to Text cho biết 2.0 là mặc định khi bạn bỏ qua model, và grok-voice-transcribe-1.0 đã hết vòng đời vào ngày 2/10/2026. Tôi vẫn sẽ ghim ID phiên bản.
Nhân bản kho, thêm khóa của bạn vào .env, và dựng âm thanh mẫu:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
Lệnh thiết lập tạo hội thoại và các tệp âm thanh dùng sau. Nếu bạn có bản ghi của riêng mình, hãy bỏ qua lệnh đó.
Một .env viết trên Windows có thể để lại \r trong khóa, và requests từ chối header trước khi bất cứ thứ gì đến SpaceXAI. Hãy loại ký tự đó khỏi khóa trước khi thêm vào header ủy quyền.
Đường cơ sở là mô hình khi chưa bật gì, để mọi thay đổi sau đều có cái so sánh. Yêu cầu đầu tiên gửi tệp và mô hình được ghim:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
Phản hồi chứa text, language được phát hiện, duration, và mảng words có thời điểm. Tham chiếu REST cho thấy confidence cho từng từ, nhưng nó không xuất hiện trong phản hồi theo lô cho bộ cố định này. Tôi sẽ coi trường này là tùy chọn và kiểm tra từng phản hồi API trước khi dùng. Đặt các trường tùy chọn trước file; các trường sau có thể bị bỏ qua.
Đường cơ sở đã bỏ các từ đệm, giữ tiếng Ả Rập ở chữ Ả Rập, và để các chữ số nói rời nhau. Nó nhất quán viết sai tên sản phẩm hư cấu.
Một bản chép hỗ trợ cần nhãn người nói, cách viết tên sản phẩm chính xác và thông tin khách hàng dùng được. Mỗi cài đặt là một trường biểu mẫu nữa:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
Thêm từng tùy chọn một vào cùng âm thanh. Bắt đầu với nhãn người nói.
Phân biệt người nói gán cho từ các ID người nói dạng số, không phải tên. Nhóm các từ liên tiếp có cùng ID để tạo lượt:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Với âm thanh sạch, mỗi lượt đã biết giữ nguyên một ID người nói nhất quán. Ánh xạ tên theo thứ tự xuất hiện đầu tiên chỉ hiệu quả khi thứ tự cuộc gọi đã biết; hệ thống sản xuất cần ánh xạ người nói riêng.
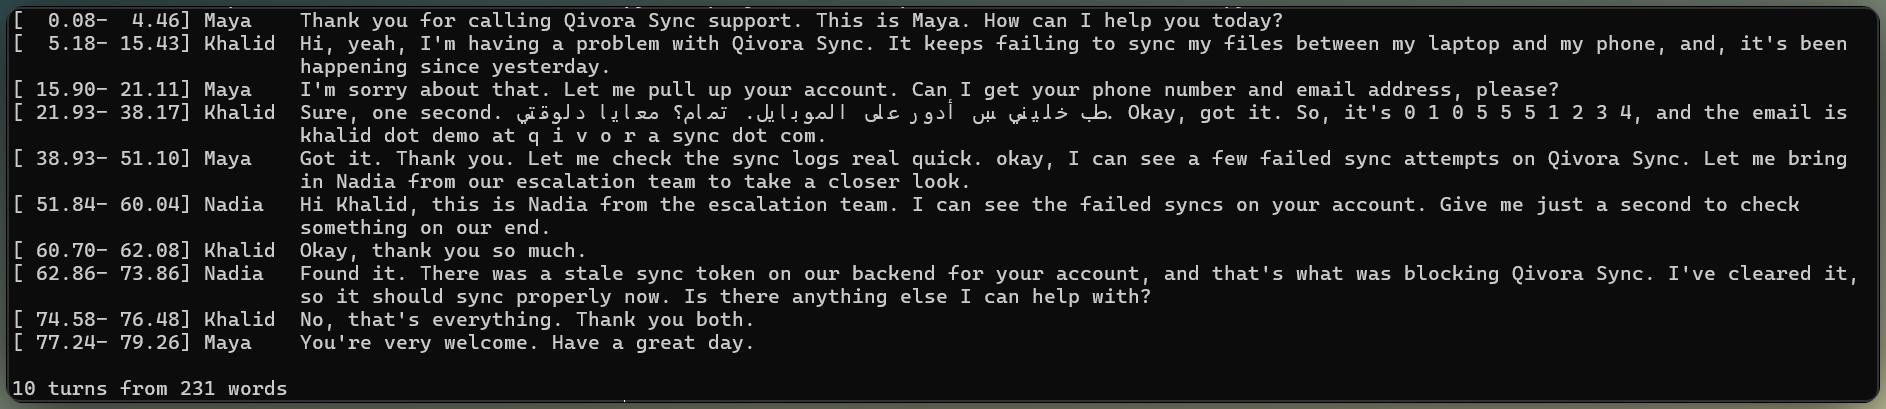
Âm thanh sạch giữ nhãn người nói nhất quán. Ảnh: Tác giả.
Thiên lệch thuật ngữ là gợi ý theo yêu cầu, không phải huấn luyện. Truyền keyterm=Qivora Sync (tối đa 100 thuật ngữ, 50 ký tự mỗi thuật ngữ), và mô hình thiên về cách viết đó khi âm thanh ủng hộ.
Thuật ngữ khóa đã sửa lỗi tên sản phẩm ở đường cơ sở mà không đổi phần bản chép xung quanh.
Trong một lần kiểm tra người nói trực tiếp riêng, từ vựng bị thiên lệch mạnh kéo một tiếng vọng mờ về phía thuật ngữ khóa. Kết quả đó không có nghĩa thuật ngữ khóa tự tạo văn bản sai; nó cho thấy âm thanh mơ hồ vẫn cần kiểm tra tiếng vọng.
Như đường cơ sở cho thấy, tiếng Ả Rập của Khalid giữ ở chữ Ả Rập. Kết quả giống nhau với phát hiện tự động và với language=en, vì language chọn quy tắc định dạng thay vì ép ngôn ngữ đầu ra.
Đường cơ sở giữ các chữ số nói rời nhau. Chuẩn hóa văn bản nghịch (ITN) chuyển các dạng nói thành dạng viết. format=true bật tính năng này và cần language, nếu không yêu cầu sẽ lỗi 400.
Số điện thoại trở thành một chuỗi số liên tục. Email chỉ được chuẩn hóa một phần: dấu câu cải thiện, nhưng từ "at" nói và tên miền đánh vần vẫn cần chỉnh sửa.
Kết quả không đồng đều đó thật khó chịu. ITN định dạng văn bản; nó không xác thực dữ liệu liên hệ. Tôi sẽ xác thực cả hai trường trước khi lưu.
ITN cũng có thể viết lại các cụm thời lượng thường gặp thành số viết tắt. Trong phản hồi theo lô đã định dạng cho bộ cố định này, chỉ text cấp cao nhất được chuẩn hóa; mảng words giữ dạng nói.
Như đường cơ sở cho thấy, từ đệm bị loại khỏi text và words mặc định. filler_words=true đưa "ờ" và "ừ" của Khalid trở lại đúng chỗ. Tắt với ghi chú hỗ trợ và bật với bản ghi QA nguyên văn.
Đầu ra theo lô bao gồm kiểm soát người nói, từ vựng, định dạng và từ đệm. Tiếp theo, gửi cùng âm thanh dưới dạng luồng trực tiếp.
Đường truyền trực tiếp dùng tham số truy vấn thay vì thông điệp thiết lập. Chờ transcript.created, gửi âm thanh nhị phân thô (không base64), và đóng bằng {"type": "audio.done"}. Hướng dẫn GPT Live Transcribe của chúng tôi dùng mẫu tương tự với mô hình khác.
Bắt đầu với các sự kiện, rồi kết nối client.
Theo lô dùng format=true có tài liệu cùng language=en. Tài liệu truyền trực tiếp nói rằng language bật ITN, nhưng trong một phép thử trực tiếp, chỉ language=en không làm đổi bản chép. Danh sách truy vấn WebSocket không gồm format, nên hướng dẫn này coi ITN khi streaming là hành vi cần xác minh thay vì phụ thuộc.
Mỗi cập nhật chép là một sự kiện transcript.partial với hai boolean. Văn bản tạm thời có thể vẫn thay đổi. Chunk cuối (is_final=true) khóa khoảng 3 giây văn bản trong khi lượt còn mở, và kết thúc phát ngôn (speech_final=true) đóng lượt.
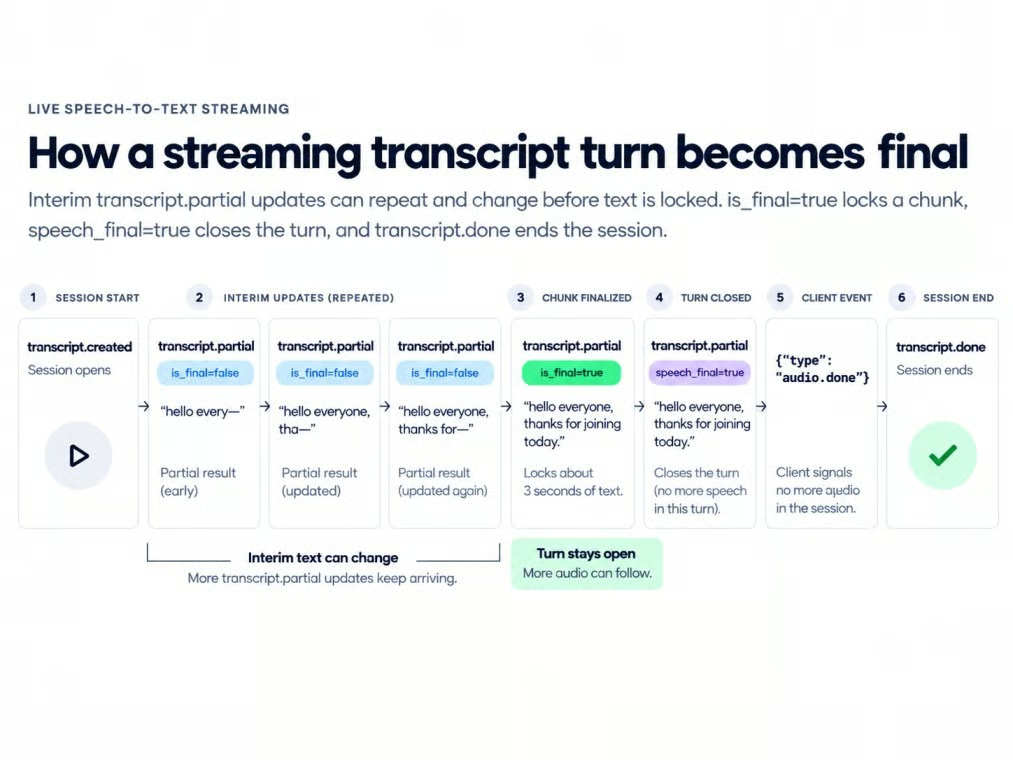
Các trạng thái streaming đẩy văn bản đến trạng thái cuối. Ảnh: Tác giả.
Với truyền trực tiếp, hãy lấy mẫu lại nguồn về mono PCM 16-bit ở 16 kHz trước. Client lõi gửi các khối 100 mili-giây với nhịp thời gian thực trong khi tác vụ khác nhận sự kiện bản chép:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Văn bản tạm tăng khoảng mỗi nửa giây. Đây là phép đo cục bộ, không phải độ trễ chính thức.
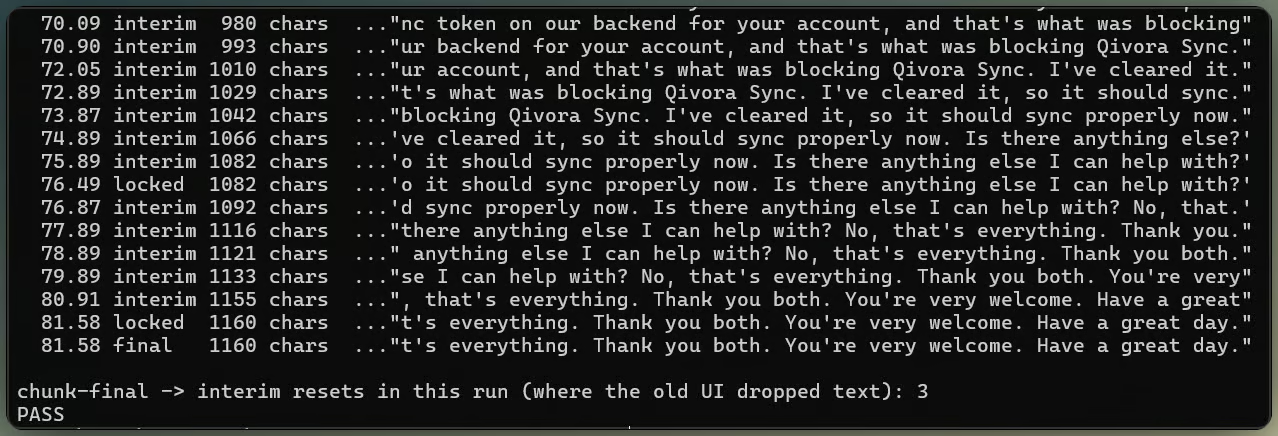
Phụ đề tạm ổn định thành bản chép cuối. Ảnh: Tác giả.
Chunk cuối đóng băng văn bản mà không đóng lượt. Smart Turn kiểm soát khi nào speech_final đóng lượt.
Chỉ hiển thị sự kiện đang hoạt động làm các từ trước biến mất sau mỗi chunk cuối, vì phần tạm tiếp theo bắt đầu lại từ âm thanh đi vào.
Giữ mọi chunk đã khóa, nối phần tạm hiện tại, và để kết thúc phát ngôn thay thế cả hai.
Văn bản có thể dài ra mà không mất các chunk trước. Khi trạng thái hiển thị đã xử lý, ranh giới lượt là vấn đề còn lại khi streaming.
Smart Turn đánh giá mỗi khoảng lặng và ước tính người nói đã kết thúc chưa. Nó tồn tại cho số của Khalid, "zero one zero, five five five, [pause], one two three four," nơi chỉ dựa vào im lặng không phân biệt được nghĩ ngợi hay kết thúc.
Ngưỡng không phải độ tin cậy chép hay ngưỡng VAD. Đó là xác suất kết thúc lượt mà một khoảng lặng phải vượt qua trước khi speech_final kích hoạt; dưới ngưỡng, lượt vẫn mở. Hai tham số truy vấn đặt nó:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
Tài liệu gọi 0,5 là cân bằng, 0,7 là thận trọng cho dãy số, và 0,9 là rất thận trọng. Với bộ cố định này, các khoảng ngắt ngắn hơn cửa sổ endpointing mặc định không tạo ra quyết định Smart Turn hữu ích. Đây là kết quả quan sát, không phải quy tắc thời gian được tài liệu hóa.
Trong thử nghiệm streaming, dừng khung âm thanh không làm bộ đếm khoảng lặng quan sát được tăng. Tiếp tục gửi im lặng kỹ thuật số cho phép Smart Turn đóng phát ngôn.
Kéo dài khoảng ngắt khi đọc số làm hành vi hiện rõ. Ngắt ngắn ở trong một lượt, còn ngắt dài tách lượt ở mọi ngưỡng khi độ tin cậy vượt cả ba cài đặt.
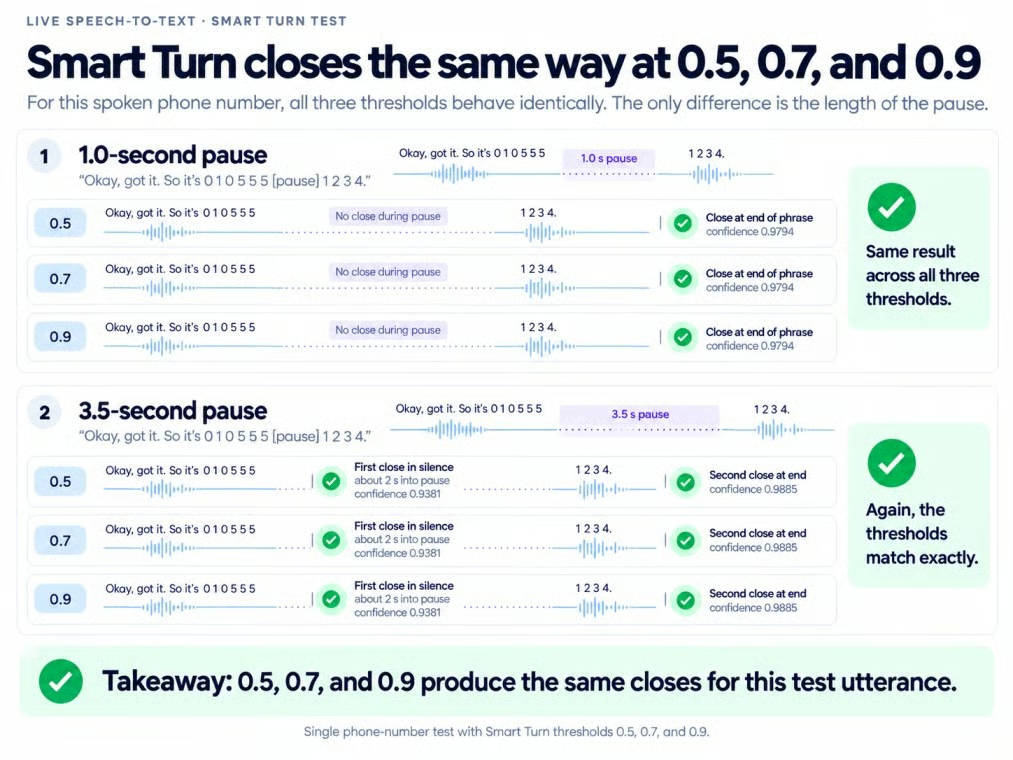
Ngắt dài có thể tách phần đọc số. Ảnh: Tác giả.
Người gọi thật kém dự đoán hơn. Một dãy số ngắn có thể trông như đã xong. Rồi người gọi tiếp tục.
Nếu Smart Turn đóng trong lúc đọc số, hãy chờ ngắn và gộp phần tiếp nối trước khi phản hồi.
smart_turn_timeout đóng một lượt sau một khoảng lặng cố định, ngay cả khi Smart Turn chưa chắc. Trên luồng ba người nói nhanh, Smart Turn nhóm vài lượt đã biết trước khi thời gian chờ buộc phải đóng.
Nếu bạn đã biết ranh giới lượt, hãy gửi {"type": "finalize"} tại mỗi điểm; nếu không, ghép Smart Turn với thời gian chờ.
Khi đã kiểm soát ranh giới lượt, cùng người gọi đó phải chịu đường dây 8 kHz.
Âm thanh chất lượng điện thoại ở đây là G.711 mu-law 8 kHz, tạo từ cùng cuộc gọi:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawÂm thanh viễn thông thô không có container, nên đặt audio_format=mulaw và sample_rate=8000 trong biểu mẫu theo lô, hoặc encoding=mulaw&sample_rate=8000 trên socket. Kiểm tra văn bản và nhãn người nói riêng rẽ.
Các phát hiện về thuật ngữ, định dạng và chuyển ngôn ngữ trước đó thay đổi ít ở 8 kHz.
Nhãn người nói kém tin cậy hơn. Bản điện thoại xuất hiện thêm một ID người nói và gán lượt kết thúc cho sai người. Chỉ đếm phân đoạn sẽ che hai lỗi đó.
Bản giả lập kém chất lượng giới hạn băng thông cuộc gọi còn 300–3400 Hz, mã hóa thành mu-law 8 kHz, và làm rơi mỗi gói 20 mili-giây với xác suất 0,03. Hạt giống ngẫu nhiên cố định 7 giữ nguyên các khoảng trống trong mọi lần phát lại.
Mất gói không thay đổi nhiều bản chép tiếng Anh trong mẫu này, và thông tin liên hệ nói vẫn theo thứ tự. Kết quả này chỉ áp dụng cho mẫu này.
Mô phỏng điện thoại thu hẹp âm thanh, làm rơi gói. Ảnh: Tác giả.
Phát hiện hoạt động giọng nói (VAD) quyết định liệu âm thanh có phải giọng nói không. Tài liệu gợi ý hạ vad_threshold cho giọng điện thoại nhỏ, với rủi ro văn bản lạc do nhiễu.
Hạ vad_threshold không thay đổi gì trên âm thanh điện thoại sạch vì không có giọng nhỏ để khôi phục. Kết quả bằng không này ủng hộ một quy tắc: chỉ hạ ngưỡng khi giọng điện thoại bị thiếu.
Dùng biểu mẫu theo lô mới không có diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API phát hiện số kênh từ WAV hoặc container khác. Với âm thanh đa kênh thô, thêm ("channels", "3"); đầu vào đa kênh WebSocket cũng cần chỉ rõ số kênh.
Gửi biểu mẫu với tệp đa kênh qua yêu cầu REST đã nêu, rồi đọc result["channels"]. Mỗi phần tử gồm chỉ số, văn bản bản chép và từ có thời điểm. Trong bộ cố định ba kênh được kiểm soát, mỗi kênh chỉ chứa người nói của mình. Streaming dùng cách tách tương tự và thêm channel_index vào sự kiện.
Tôi sẽ dùng các nhánh riêng bất cứ khi nào hệ thống điện thoại cung cấp. Không giống phân biệt người nói trong phần âm thanh điện thoại, tách kênh đã biết không suy diễn người nói.
Client hoàn chỉnh phơi bày một nhóm cài đặt, rồi dựng biểu mẫu REST hoặc URL WebSocket riêng. Cài đặt chung bao phủ phân biệt người nói, thuật ngữ khóa, từ đệm, mã hóa âm thanh và xử lý lượt; định dạng tuân theo quy tắc đặc thù theo phương thức truyền đã đề cập.
Áp dụng cài đặt cuối cùng cho bản ghi chất lượng điện thoại, rồi kiểm tra cách viết tên sản phẩm, chuyển ngôn ngữ, thông tin liên hệ và nhãn người nói riêng. Trong bộ cố định kiểm soát, các kiểm tra văn bản đạt trong khi một nhãn người nói vẫn cần rà soát. Lưu cài đặt và ánh xạ người nói cùng mỗi bản chép để các so sánh sau dùng cùng thiết lập.
Hướng dẫn chép hỗ trợ kết thúc với kiểm tra cuối đó. Kho còn có phần mở rộng tác tử thoại riêng với phản hồi sinh, âm thanh phát ra, ngắt lời và xử lý tiếng vọng.
Transcribe giữ cùng vai trò trong demo đó: nó tạo văn bản. Mô hình ngôn ngữ viết phản hồi, và Grok TTS đọc chúng.
Học AI cùng DataCamp!
Lộ trình
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
