
Leerpad
Associate AI Engineer voor ontwikkelaars
26 uur
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) is SpaceXAI's spraak-naar-tekstmodel. Het REST-pad transcribeert een afgerond bestand, terwijl het WebSocket-pad live audio verwerkt.
SpaceXAI's aankondiging van Grok Voice Transcribe 2.0 benadrukt telefoongesprekken, meerdere sprekers, inloggegevens en meertalige spraak. Voor benchmark-vergelijkingen, zie onze Grok Voice Transcribe 2.0-overzichtspost.
De gecontroleerde Qivora Sync-fixture blijft vast terwijl de audio en API-instellingen veranderen. Het gesprek bevat een verzonnen productnaam, stopwoordjes, een taalwissel, uitgesproken contactgegevens, een pauze tijdens dicteren en een derde spreker.
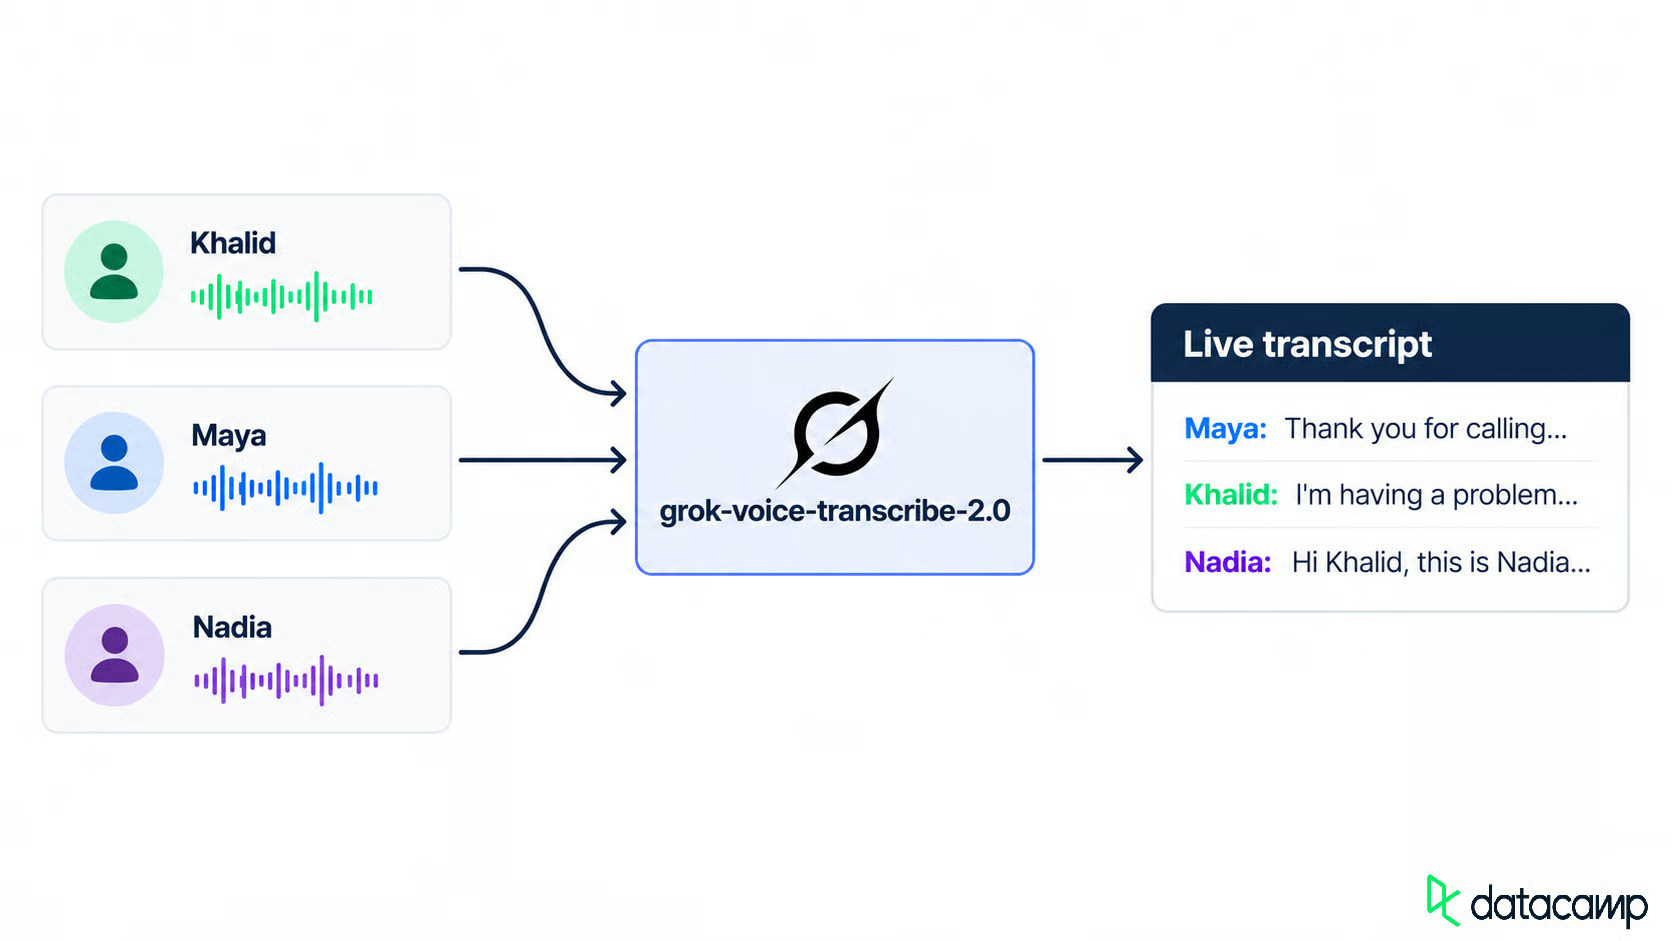
Drie sprekers worden één live transcript. Afbeelding door de auteur.
De gecontroleerde fixture gebruikt drie verschillende stemmen van de Grok Text to Speech API. Elke taalsectie is apart gesynthetiseerd en samengevoegd met ffmpeg zodat de schakelmomenten gelijk blijven. De API accepteert ook language=auto; aparte requests zijn een keuze in het experimentontwerp, geen API-vereiste.
Definieer vóór de eerste request de verwachte tekst, sprekers, productspelling, klantgegevens, stopwoordjes en pauzes. Elke setup heeft dan hetzelfde doel.
Installeer de afhankelijkheden voordat je audio verstuurt.
Je hebt Python 3.10 of nieuwer nodig, een xAI API-sleutel, en ffmpeg voor het bouwen van de audio. De Python-clients gebruiken requests, websockets en python-dotenv.
De Speech to Text-documentatie noemt 2.0 de standaard als je model weglaat, en grok-voice-transcribe-1.0 is end-of-life sinds 2 oktober 2026. Ik zou de versiegelabelde ID alsnog vastpinnen.
Kloon de repository, voeg je sleutel toe aan .env en bouw de voorbeeldaudio:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
De setup-opdracht maakt de dialoog en de audiobestanden die later gebruikt worden. Als je je eigen opname hebt, sla die opdracht dan over.
Een .env die op Windows is geschreven kan een \r achterlaten op de sleutel, en requests weigert de header voordat er iets bij SpaceXAI aankomt. Strip de sleutel voordat je hem aan de Authorization-header toevoegt.
Een baseline is het model met niets ingeschakeld, zodat elke latere wijziging iets heeft om mee te vergelijken. De eerste request verstuurt het bestand en een vastgepind model:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
De response bevat text, gedetecteerde language, duration en een getimede words array. De REST-referentie laat per-woord confidence zien, maar dat verscheen niet in de batchresponses voor deze fixture. Ik zou het veld als optioneel behandelen en elke API-response controleren voordat je het gebruikt. Zet optionele velden vóór file; latere velden kunnen genegeerd worden.
De baseline verwijderde stopwoordjes, behield het Arabisch in Arabisch schrift en liet de uitgesproken cijfers los van elkaar. De verzonnen productnaam werd consequent verkeerd gespeld.
Een supporttranscript heeft sprekerslabels nodig, de juiste productspelling en bruikbare klantgegevens. Elke instelling is één extra formfield:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
Voeg één optie tegelijk toe aan dezelfde audio. Begin met sprekerslabels.
Sprekerdiarisatie geeft woorden numerieke spreker-ID's, geen namen. Groepeer opeenvolgende woorden met dezelfde ID om beurten te bouwen:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Op schone audio bleef elke bekende beurt bij een consistente spreker-ID. Namen mappen op volgorde van eerste voorkomen werkt alleen als de belvolgorde al bekend is; productiesystemen hebben hun eigen spreker-mapping nodig.
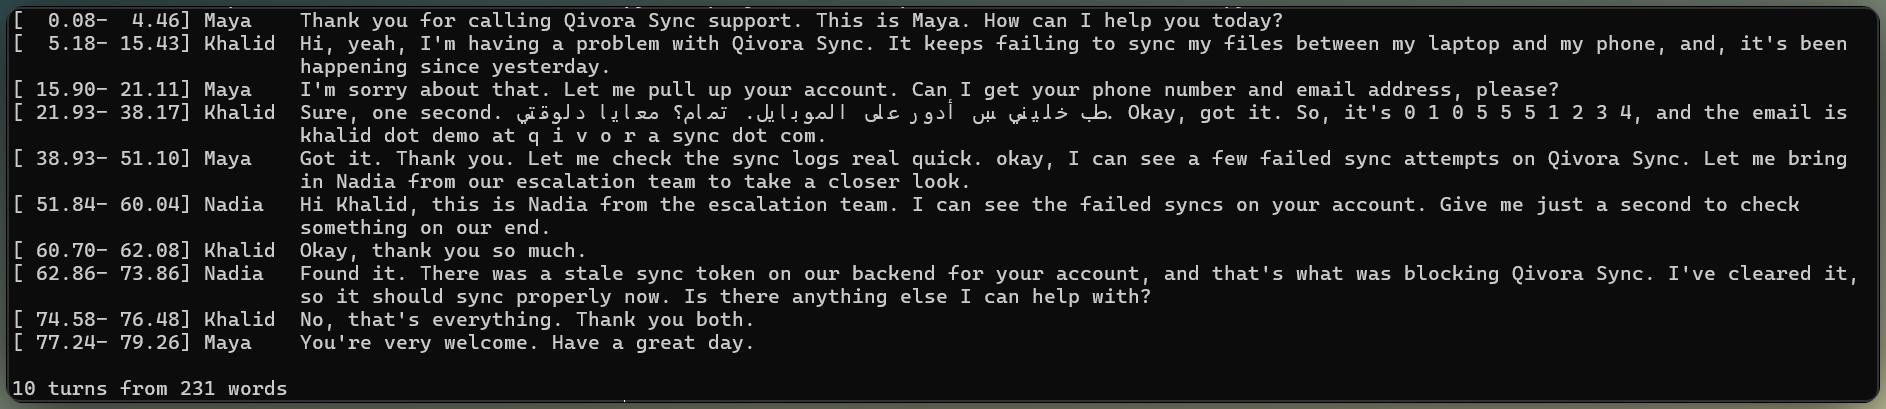
Schone audio houdt sprekerslabels consistent. Afbeelding door de auteur.
Sleuteltermbias is een hint per request, geen training. Geef keyterm=Qivora Sync door (tot 100 termen, 50 tekens elk) en het model neigt naar die spelling als de audio dat ondersteunt.
De sleutelterm corrigeerde de productnaamsfout van de baseline zonder de omliggende transcriptie te wijzigen.
In een aparte live-spreker-check trok sterk bevooroordeelde woordenschat een zwakke echo richting de sleutelterm. Dat betekent niet dat sleuteltermen op zichzelf valse tekst creëren; het betekent dat dubbelzinnige audio nog steeds een echocheck nodig heeft.
Zoals de baseline liet zien, bleef Khalids Arabisch in Arabisch schrift. Het resultaat was hetzelfde met automatische detectie en met language=en, omdat language opmaakregels selecteert in plaats van een uitvoertaal te forceren.
De baseline hield uitgesproken cijfers gescheiden. Inverse Text Normalization (ITN) zet die gesproken vormen om in geschreven vormen. format=true schakelt dit in en heeft language nodig, anders faalt de request met een 400.
Het telefoonnummer werd één aaneengesloten cijferreeks. Het e-mailadres werd slechts deels genormaliseerd: interpunctie verbeterde, maar het gesproken "at" en gespelde domein hadden nog opschoning nodig.
Die ongelijke uitkomst is frustrerend. ITN formatteert tekst; het valideert geen contactdata. Ik zou beide velden valideren vóór opslag.
ITN kan ook gewone duurzinnen herschrijven als afgekorte hoeveelheden. In de geformatteerde batchresponse voor deze fixture werd alleen de bovenliggende text genormaliseerd; de words array behield de gesproken vorm.
Zoals de baseline liet zien, worden stopwoordjes standaard uit text en words gefilterd. filler_words=true bracht Khalids "uh" en "um" terug waar verwacht. Laat ze uit voor supportnotities en aan voor een letterlijke QA-registratie.
Batchoutput omvat sprekers, woordenschat, opmaak en controle over stopwoordjes. Stuur nu dezelfde audio als livestream.
Het streamingpad gebruikt queryparameters in plaats van een setup-bericht. Wacht op transcript.created, stuur ruwe binaire audio (geen base64) en sluit af met {"type": "audio.done"}. Onze GPT Live Transcribe-tutorial gebruikt hetzelfde patroon met een ander model.
Begin met de events en verbind daarna de client.
Batch gebruikt de gedocumenteerde format=true met language=en. De streamingdocumentatie zegt dat language ITN inschakelt, maar in een liveproef veranderde language=en alleen de transcriptie niet. De WebSocket-querylijst bevat geen format, dus deze tutorial behandelt streaming-ITN als gedrag om te verifiëren in plaats van op te vertrouwen.
Elke transcriptie-update is een transcript.partial-event met twee booleans. Tussentijdse tekst kan nog veranderen. Een chunk-finaal (is_final=true) vergrendelt ongeveer 3 seconden tekst zolang de beurt open blijft, en een utterance-finaal (speech_final=true) sluit de beurt.
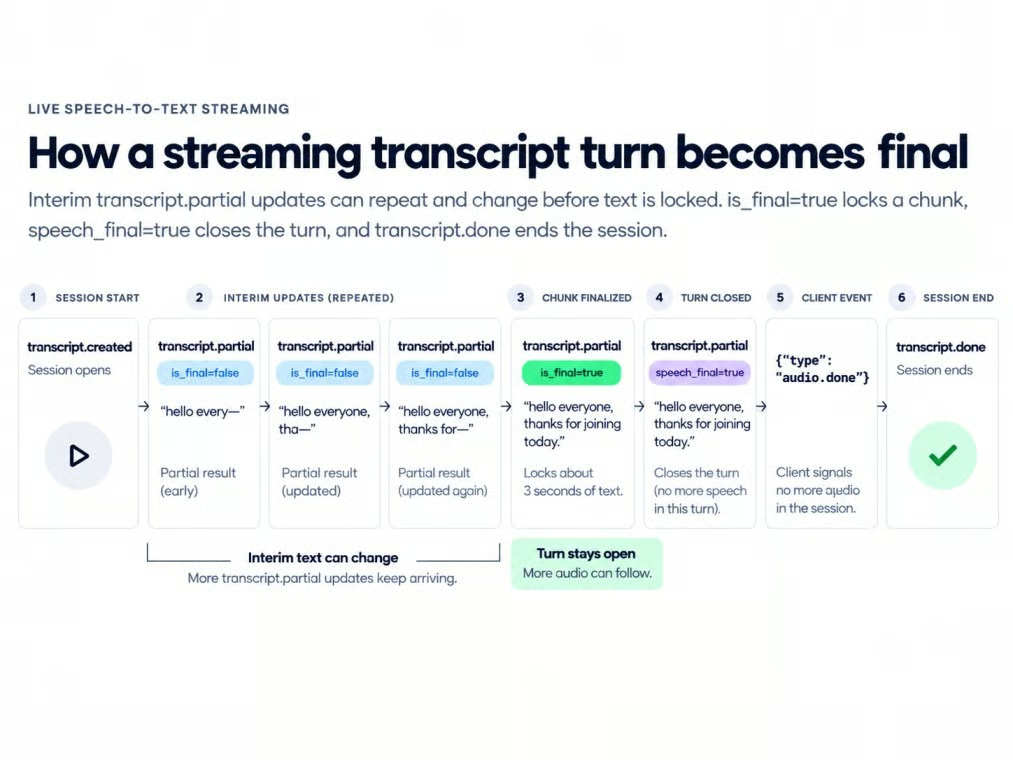
Streamingstatussen bewegen tekst richting finalisatie. Afbeelding door de auteur.
Resample voor streaming de bron eerst naar mono 16-bit PCM op 16 kHz. De kernclient stuurt chunks van 100 milliseconden in realtime, terwijl een andere taak transcript-events ontvangt:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Tussentijdse tekst groeide ongeveer elke halve seconde. Dit is een lokale meting, geen officiële latency.
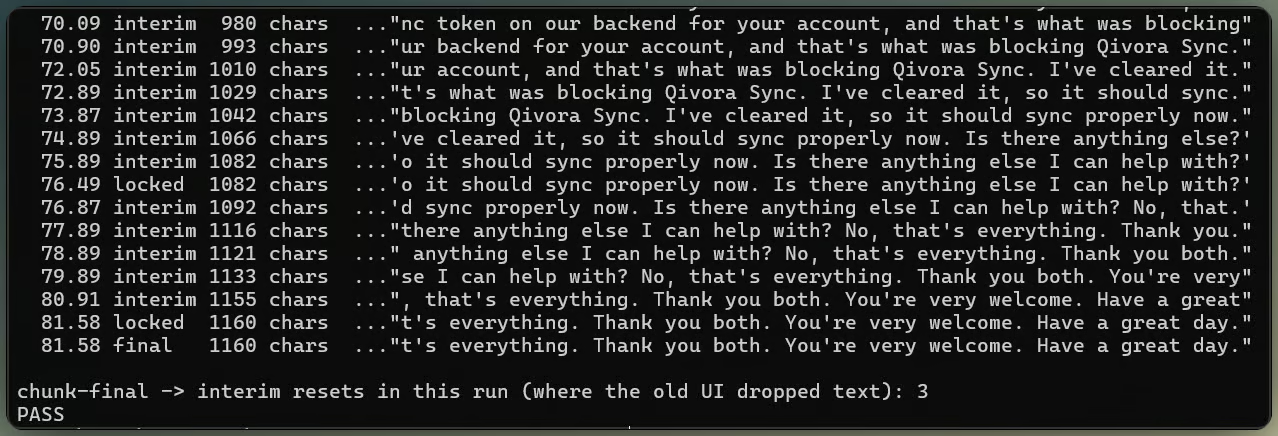
Partiële captions worden definitieve transcriptie. Afbeelding door de auteur.
Chunk-finals bevriezen tekst zonder de beurt te sluiten. Smart Turn bepaalt wanneer speech_final deze sluit.
Alleen het actieve event tonen laat eerdere woorden verdwijnen na elke chunk-final, omdat de volgende interim weer vanaf de inkomende audio begint.
Bewaar elke vergrendelde chunk, voeg de huidige interim toe en laat de utterance-final beide vervangen.
De tekst kan groeien zonder eerdere chunks te verliezen. Met de weergavestatus geregeld, blijven beurtgrenzen het resterende streamingprobleem.
Smart Turn evalueert elke stilte en schat in of de spreker klaar is. Het bestaat voor Khalids nummer: "zero one zero, five five five, [pauze], one two three four," waar stilte alleen geen denkpauze van het einde kan onderscheiden.
De drempel is geen transcriptie-zekerheid of de VAD-drempel. Het is de end-of-turn-waarschijnlijkheid die een stilte moet overschrijden voordat speech_final vuurt; eronder blijft de beurt open. Twee queryparameters stellen dit in:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
De documentatie noemt 0,5 gebalanceerd, 0,7 conservatief voor cijferreeksen en 0,9 zeer conservatief. In deze fixture leverden pauzes korter dan het standaardvenster endpointing geen bruikbare Smart Turn-beslissing op. Dat is een geobserveerd resultaat, geen gedocumenteerde timingregel.
In de streamingtest zorgde het stoppen van audioframes er niet voor dat de geobserveerde stilte-timer doorliep. Het blijven sturen van digitale stilte laat Smart Turn de uiting sluiten.
Het verlengen van de pauze tijdens nummerdicteren maakt het gedrag zichtbaar. Korte pauzes blijven binnen één beurt, terwijl een lange pauze deze splitst bij elke drempel wanneer de confidence alle drie de instellingen overschrijdt.
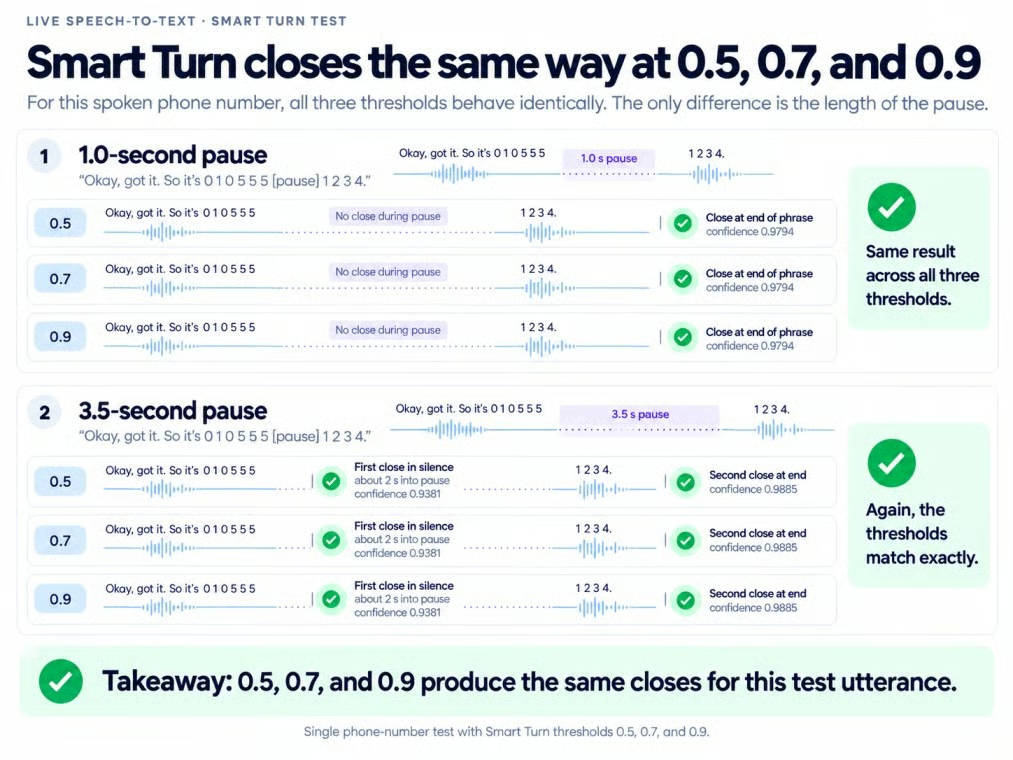
Lange pauzes kunnen nummerdicteren splitsen. Afbeelding door de auteur.
Mensen zijn minder voorspelbaar. Een korte cijferreeks kan klaar lijken. En dan gaat de beller door.
Als Smart Turn sluit tijdens nummerdicteren, wacht even en voeg een vervolg samen voordat je reageert.
smart_turn_timeout sluit een beurt na een vaste stilte, zelfs als Smart Turn onzeker is. Op de snelle driestromenstream groepeerde Smart Turn meerdere bekende beurten voordat een time-out de sluiting afdwong.
Als je al weet waar beurten eindigen, stuur dan {"type": "finalize"} op elke grens; zo niet, koppel Smart Turn dan aan een time-out.
Als de beurtgrenzen onder controle zijn, moet dezelfde beller nog een 8 kHz-lijn doorstaan.
Telefoonkwaliteit-audio is hier 8 kHz G.711 mu-law, gemaakt van hetzelfde gesprek:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawRuwe telefonie-audio heeft geen container, dus stel audio_format=mulaw en sample_rate=8000 in op het batchformulier, of encoding=mulaw&sample_rate=8000 op de socket. Controleer tekst en sprekerslabels apart.
De eerdere bevindingen over sleutelterm, opmaak en taalwissel veranderden weinig op 8 kHz.
Sprekerslabels werden minder betrouwbaar. De telefoonversie introduceerde een extra spreker-ID en kende een afsluitende beurt toe aan de verkeerde persoon. Alleen segmenten tellen maskeert beide fouten.
De wankele versie bandlimiteert het gesprek tot 300-3400 Hz, codeert het als 8 kHz mu-law en laat elk pakket van 20 milliseconden met een kans van 0,03 vallen. Een vaste random seed van 7 houdt dezelfde gaten bij elke herhaling.
Dat pakketverlies veranderde de Engelse transcriptie in dit sample niet veel, en de uitgesproken contactgegevens bleven op volgorde. Dit resultaat geldt alleen voor dit sample.
Telefoonsimulatie vernauwt audio en laat pakketten vallen. Afbeelding door de auteur.
Voice activity detection (VAD) beslist of audio überhaupt spraak is. De documentatie suggereert het verlagen van vad_threshold voor zachte telefoongesprekken, met het risico op losse tekst door ruis.
Het verlagen van vad_threshold veranderde niets op schone telefoonaudio omdat er geen zachte spraak terug te halen was. De nuluitslag ondersteunt één regel: verlaag de drempel alleen wanneer telefoongesprekken verdwijnen.
Gebruik een nieuw batchformulier zonder diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
De API detecteert het kanaalaantal uit een WAV of andere container. Voor ruwe multikanaalaudio, voeg ("channels", "3") toe; WebSocket-multikanaalinvoer vereist ook een expliciet kanaalaantal.
Stuur het formulier met het multikanaalbestand via de eerder getoonde REST-request en lees vervolgens result["channels"]. Elk item bevat een index, transcripttekst en getimede woorden. In de gecontroleerde driekanaalsfixture bevatte elk kanaal alleen zijn toegewezen spreker. Streaming gebruikt dezelfde splitsing en voegt channel_index toe aan zijn events.
Ik zou aparte lijnen gebruiken wanneer het telefoonsysteem die levert. In tegenstelling tot diarization in de telefoonaudiosectie leidt een bekende splitsing niet tot inferentie over sprekers.
De complete client biedt één groep instellingen en bouwt vervolgens het REST-formulier of de WebSocket-URL apart. Gedeelde instellingen dekken diarization, sleuteltermen, stopwoordjes, audio-encoding en beurtbehandeling; formattering volgt de transportspecifieke regels die eerder zijn behandeld.
Pas de definitieve instellingen toe op een opname van telefoonkvaliteit en controleer daarna productspelling, taalwissels, contactgegevens en sprekerslabels apart. In de gecontroleerde fixture slaagden de tekstcontroles terwijl één sprekerslabel nog beoordeling vergde. Sla de instellingen en de spreker-mapping samen met elk transcript op, zodat latere vergelijkingen dezelfde setup gebruiken.
De supporttranscriptie-tutorial eindigt met die laatste check. De repository bevat ook een aparte voice-agentextensie met gegenereerde antwoorden, uitgesproken output, onderbrekingen en echoafhandeling.
Transcribe houdt dezelfde rol in die demo: het levert tekst. Een taalmodel schrijft de antwoorden en Grok TTS spreekt ze uit.
Leer AI met DataCamp!
Leerpad
Leerpad
Cursus
blog
Adel Nehme
15 min

