Programma
Ingegnere AI associato per sviluppatori
26 ore
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) è il modello di speech-to-text di SpaceXAI. Il percorso REST trascrive un file già completo, mentre il percorso WebSocket gestisce l'audio live.
L'annuncio di Grok Voice Transcribe 2.0 di SpaceXAI mette in evidenza le chiamate telefoniche, più interlocutori, credenziali e parlato multilingue. Per i confronti di benchmark, vedi la nostra panoramica su Grok Voice Transcribe 2.0.
Il fixture controllato Qivora Sync resta fisso mentre cambiano audio e impostazioni API. La chiamata include un nome di prodotto inventato, filler, un cambio di lingua, dati di contatto dettati, una pausa durante la dettatura e un terzo speaker.
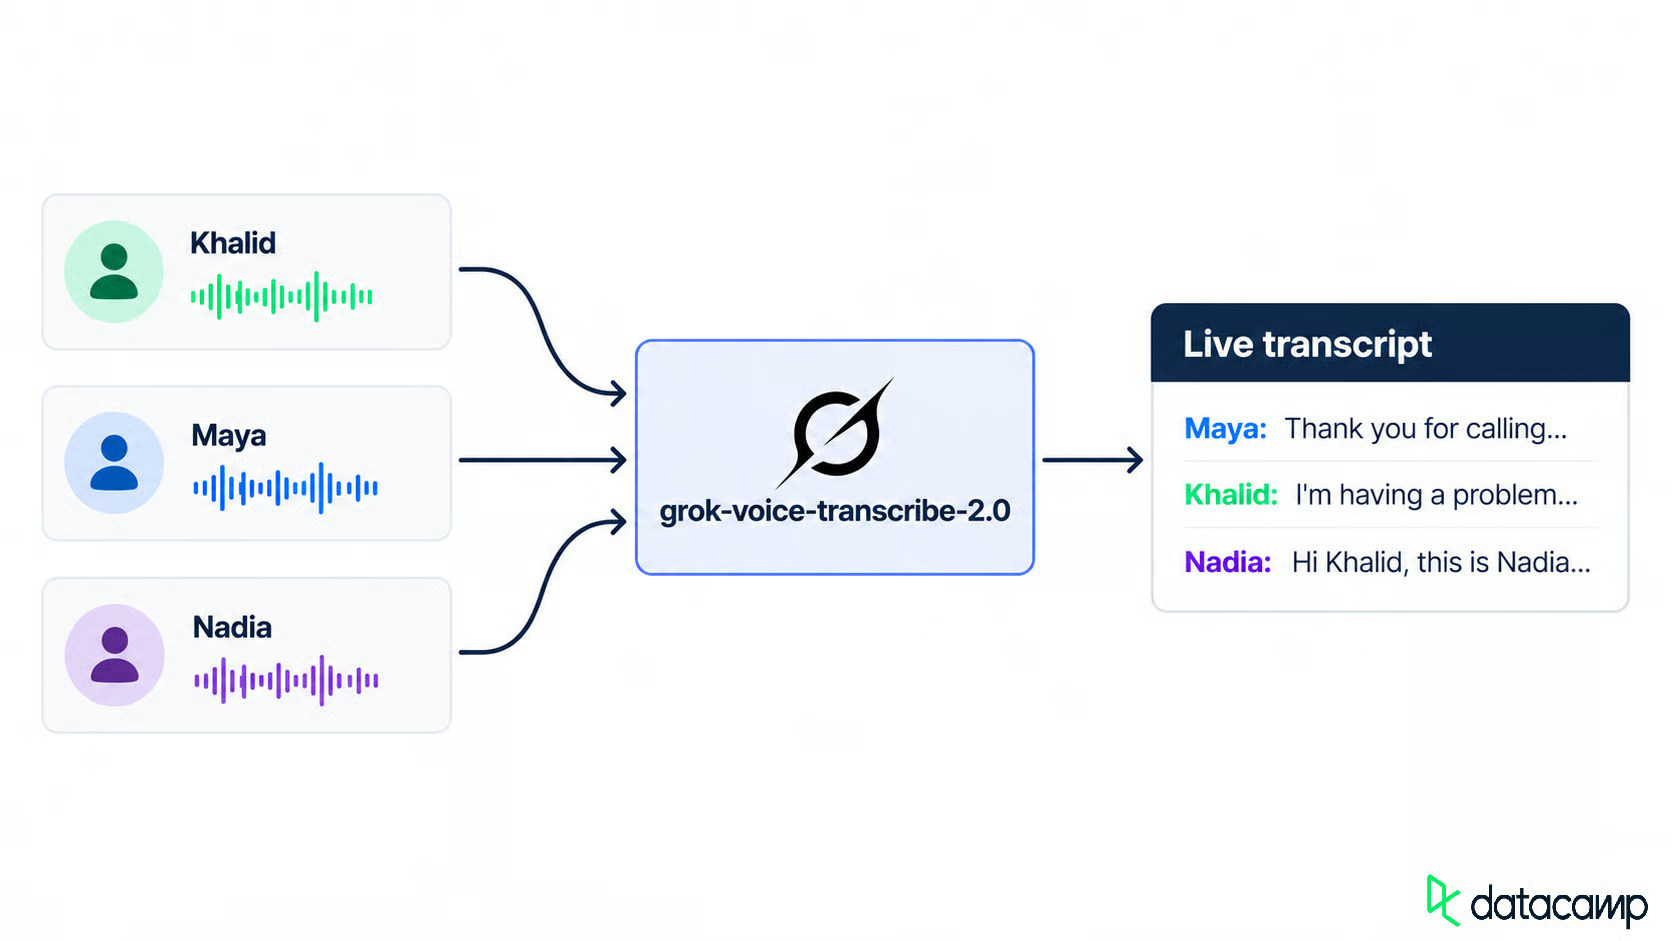
Tre speaker diventano un'unica trascrizione live. Immagine dell'autore.
Il fixture controllato usa tre voci distinte prese dall'API Grok Text to Speech. Ogni segmento linguistico è sintetizzato separatamente e unito con ffmpeg in modo che i punti di cambio restino fissi. L'API accetta anche language=auto; richieste separate sono una scelta di disegno sperimentale, non un requisito dell'API.
Prima della prima richiesta, definisci il testo atteso, gli speaker, l'ortografia del prodotto, i dati del cliente, i filler e le pause. Ogni configurazione avrà così lo stesso target.
Installa le dipendenze prima di inviare audio.
Ti serve Python 3.10 o superiore, una chiave API xAI e ffmpeg per costruire l'audio. I client Python usano requests, websockets e python-dotenv.
La documentazione Speech to Text indica la 2.0 come predefinita se ometti model, e grok-voice-transcribe-1.0 è arrivata a fine vita il 2 ottobre 2026. Io fisserei comunque l'ID versionato.
Clona il repository, aggiungi la tua chiave a .env e costruisci l'audio di esempio:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
Il comando di setup crea il dialogo e i file audio usati in seguito. Se hai una tua registrazione, salta quel comando.
Un .env scritto su Windows può lasciare un \r nella chiave, e requests rifiuta l'header prima che qualcosa arrivi a SpaceXAI. Ripulisci la chiave prima di aggiungerla all'header di autorizzazione.
Una baseline è il modello con tutto disattivato, così ogni modifica successiva ha un termine di paragone. La prima richiesta invia il file e un modello fissato:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
La risposta contiene text, language rilevata, duration e un array words temporizzato. La reference REST mostra la confidence per parola, ma non è apparsa nelle risposte batch per questo fixture. Tratterei il campo come opzionale e controllerei ogni risposta dell'API prima di usarlo. Metti i campi opzionali prima di file; i campi successivi potrebbero essere ignorati.
La baseline ha tolto i filler, mantenuto l'arabo in scrittura araba e lasciato le cifre pronunciate separate. Ha sbagliato costantemente l'ortografia del nome prodotto inventato.
Una trascrizione di supporto ha bisogno di etichette speaker, ortografia corretta del prodotto e dati cliente utilizzabili. Ogni impostazione è un campo form in più:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
Aggiungi un'opzione alla volta allo stesso audio. Parti dalle etichette speaker.
La diarizzazione speaker assegna alle parole ID numerici degli speaker, non nomi. Raggruppa parole consecutive con lo stesso ID per costruire i turni:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Su audio pulito, ogni turno noto è rimasto con un ID speaker coerente. Mappare i nomi in base all'ordine di prima apparizione funziona solo quando l'ordine della chiamata è già noto; i sistemi in produzione hanno bisogno di una propria mappatura degli speaker.
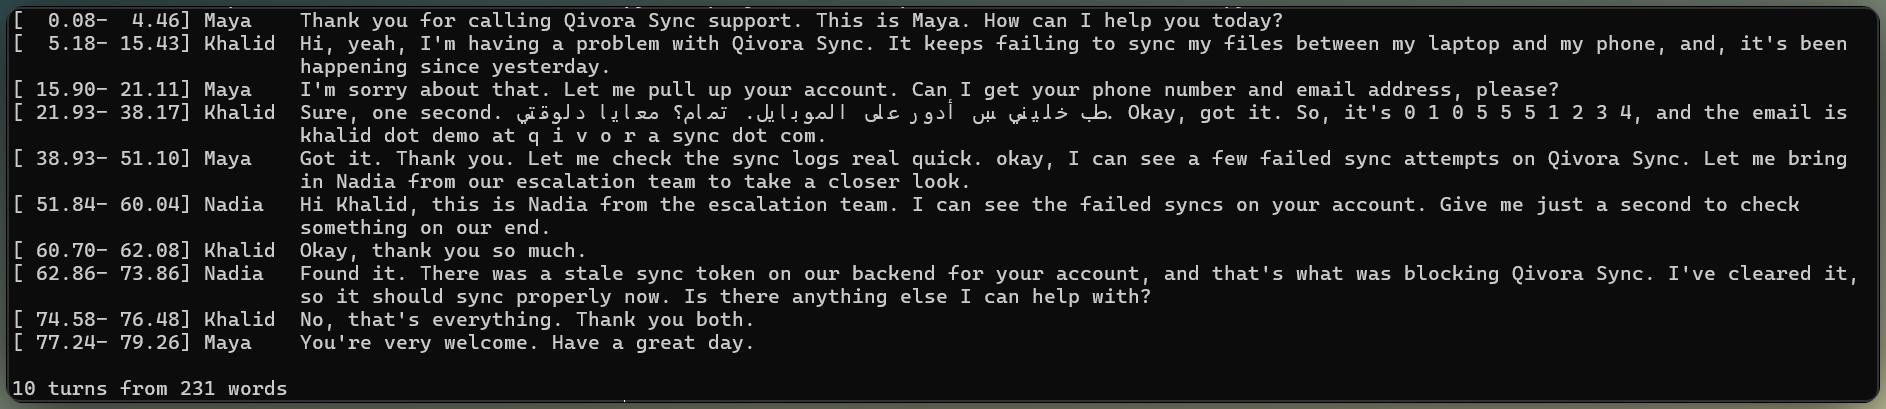
Audio pulito mantiene coerenti le etichette speaker. Immagine dell'autore.
Il bias dei termini chiave è un suggerimento per richiesta, non un addestramento. Passa keyterm=Qivora Sync (fino a 100 termini, 50 caratteri ciascuno) e il modello tenderà a quella grafia quando l'audio la supporta.
Il termine chiave ha corretto l'errore sul nome prodotto della baseline senza cambiare la trascrizione circostante.
In un controllo separato con speaker live, un vocabolario fortemente polarizzato ha trascinato una debole eco verso il termine chiave. Questo non significa che i termini chiave creino testo falso da soli; significa che audio ambiguo richiede comunque un controllo di eco.
Come mostrato dalla baseline, l'arabo di Khalid è rimasto in scrittura araba. Il risultato è stato lo stesso con rilevamento automatico e con language=en, perché language seleziona le regole di formattazione invece di forzare una lingua di output.
La baseline ha mantenuto separate le cifre pronunciate. L'Inverse Text Normalization (ITN) trasforma quelle forme pronunciate in forme scritte. format=true lo attiva e richiede language, altrimenti la richiesta fallisce con un 400.
Il numero di telefono è diventato una stringa di cifre continua. L'email è stata normalizzata solo in parte: la punteggiatura è migliorata, ma il "chiocciola" pronunciato e il dominio scandito richiedevano ancora pulizia.
Quel risultato disomogeneo è frustrante. L'ITN formatta il testo; non valida i dati di contatto. Validerei entrambi i campi prima dell'archiviazione.
L'ITN può anche riscrivere le normali frasi di durata come quantità abbreviate. Nella risposta batch formattata per questo fixture, solo il text di primo livello è stato normalizzato; l'array words ha mantenuto la forma pronunciata.
Come mostrato dalla baseline, per impostazione predefinita i filler sono rimossi da text e words. filler_words=true ha riportato gli "uh" e "um" di Khalid dove previsto. Tienili disattivati per note di supporto e attivati per un verbatim di QA.
L'output batch include controllo su speaker, vocabolario, formattazione e filler. Ora invia lo stesso audio come stream live.
Il percorso in streaming usa parametri di query invece di un messaggio di setup. Attendi transcript.created, invia audio binario grezzo (niente base64) e chiudi con {"type": "audio.done"}. Il nostro tutorial GPT Live Transcribe usa lo stesso schema con un altro modello.
Parti dagli eventi, poi collega il client.
Il batch usa il documentato format=true con language=en. I documenti dello streaming dicono che language attiva l'ITN, ma in una prova live language=en da solo non ha cambiato la trascrizione. La query del WebSocket non include format, quindi questo tutorial tratta l'ITN in streaming come un comportamento da verificare, non da dare per scontato.
Ogni aggiornamento di trascrizione è un evento transcript.partial con due booleani. Il testo intermedio può ancora cambiare. Un chunk finale (is_final=true) blocca circa 3 secondi di testo mentre il turno resta aperto, e un finale di enunciazione (speech_final=true) chiude il turno.
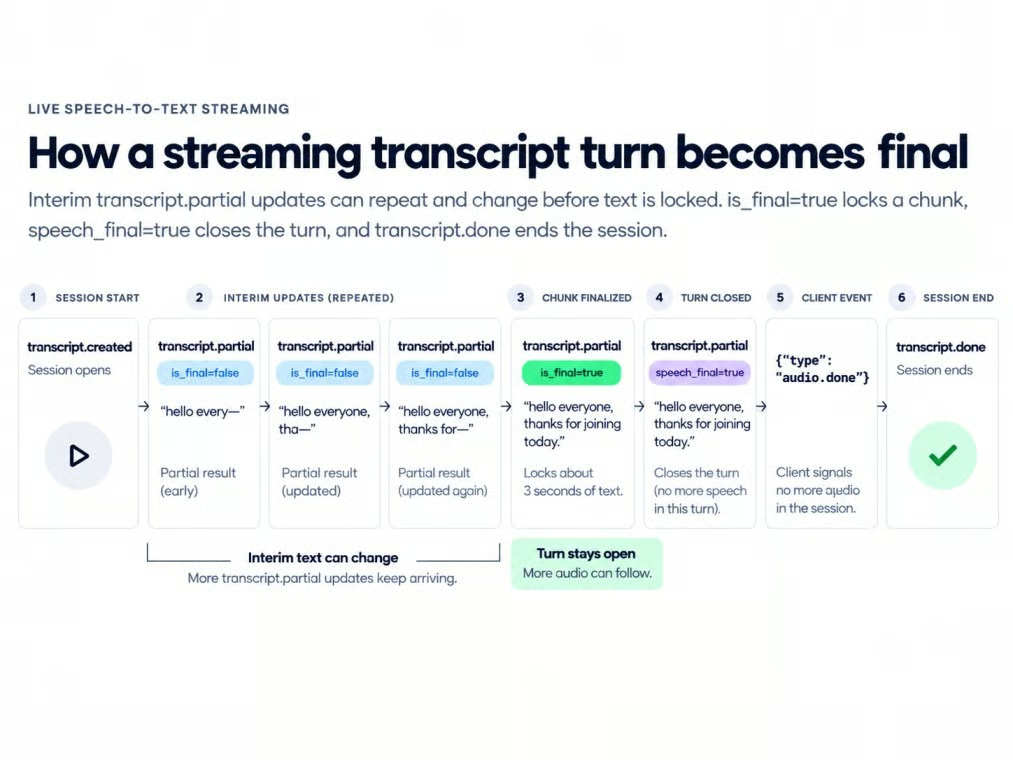
Gli stati dello streaming portano il testo verso la finalizzazione. Immagine dell'autore.
Per lo streaming, effettua prima il resampling della sorgente a PCM mono 16 bit a 16 kHz. Il client principale invia chunk da 100 millisecondi al ritmo del tempo reale mentre un altro task riceve gli eventi di trascrizione:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Il testo intermedio cresceva circa ogni mezzo secondo. Questa è una misurazione locale, non una latenza ufficiale.
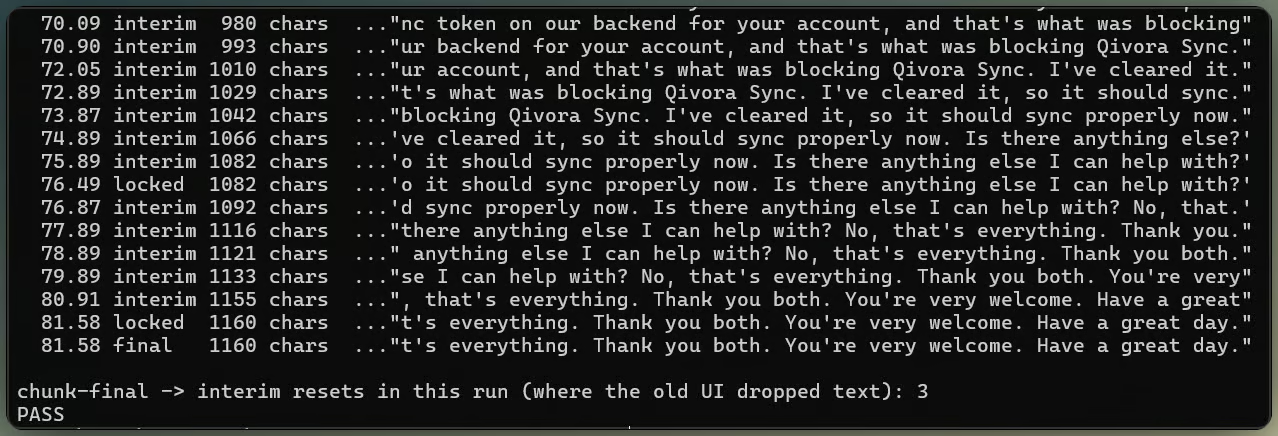
Le didascalie parziali si assestano nella trascrizione finale. Immagine dell'autore.
I chunk finali congelano il testo senza chiudere il turno. Smart Turn controlla quando speech_final lo chiude.
Mostrare solo l'evento attivo fa scomparire le parole precedenti dopo il finale di ogni chunk, perché l'interim successivo riparte dall'audio in arrivo.
Conserva ogni chunk bloccato, aggiungi l'interim corrente e lascia che il finale dell'enunciazione sostituisca entrambi.
Il testo può crescere senza perdere i chunk precedenti. Gestito lo stato a display, i confini di turno restano il problema dello streaming.
Smart Turn valuta ogni silenzio e stima se lo speaker ha finito. Serve per il numero di Khalid, "zero uno zero, cinque cinque cinque, [pausa], uno due tre quattro", dove il solo silenzio non distingue tra una pausa di riflessione e la fine.
La soglia non è la confidenza di trascrizione né la soglia VAD. È la probabilità di fine turno che un silenzio deve superare prima che speech_final scatti; sotto, il turno resta aperto. Due parametri di query la impostano:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
I documenti definiscono 0,5 bilanciato, 0,7 conservativo per sequenze numeriche e 0,9 molto conservativo. In questo fixture, pause più brevi della finestra endpointing predefinita non hanno prodotto una decisione utile di Smart Turn. È un risultato osservato, non una regola di timing documentata.
Nel test in streaming, fermare i frame audio non avanzava il timer del silenzio osservato. Continuare a inviare silenzio digitale permette a Smart Turn di chiudere l'enunciazione.
Estendere la pausa durante la dettatura del numero rende visibile il comportamento. Le pause brevi restano dentro un turno, mentre una pausa lunga lo divide a ogni soglia quando la confidenza supera tutte e tre le impostazioni.
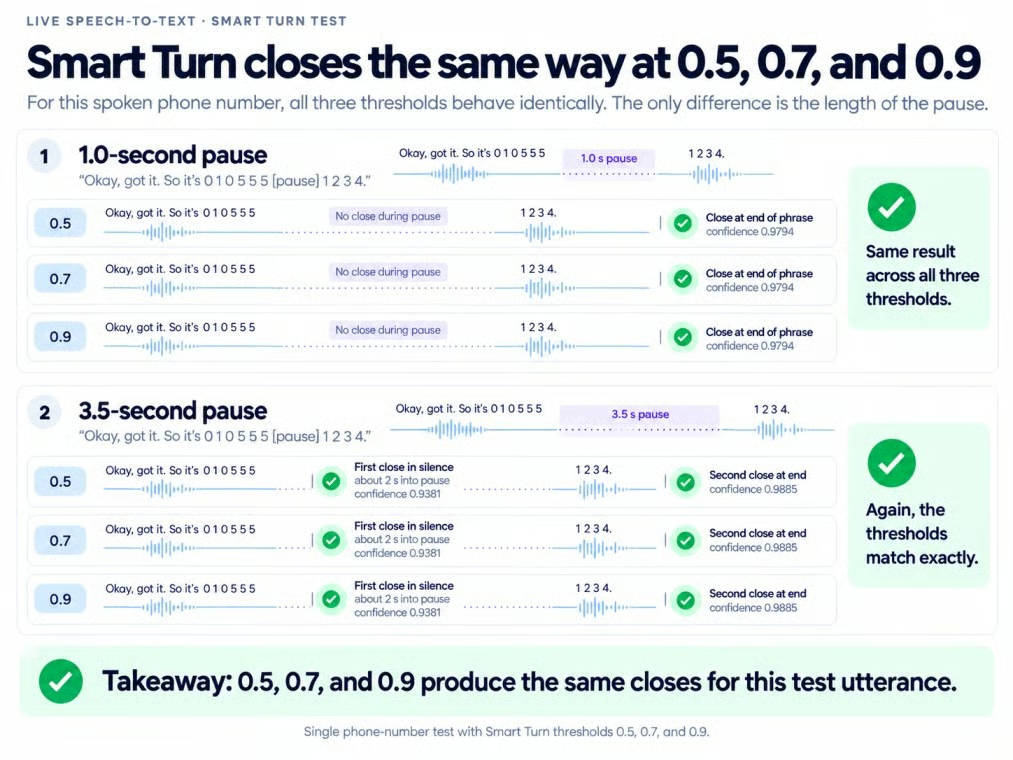
Le pause lunghe possono dividere la dettatura del numero. Immagine dell'autore.
I chiamanti umani sono meno prevedibili. Una sequenza breve di cifre può sembrare finita. Poi il chiamante continua.
Se Smart Turn chiude durante la dettatura del numero, attendi brevemente e unisci una continuazione prima di rispondere.
smart_turn_timeout chiude un turno dopo un silenzio fisso, anche quando Smart Turn è incerto. Nello stream rapido a tre speaker, Smart Turn ha raggruppato diversi turni noti prima che un timeout forzasse la chiusura.
Se sai già dove finiscono i turni, invia {"type": "finalize"} a ogni confine; altrimenti, abbina Smart Turn a un timeout.
Stabiliti i confini di turno, lo stesso chiamante deve resistere a una linea a 8 kHz.
L'audio in qualità telefonica qui è G.711 mu-law a 8 kHz, ricavato dalla stessa chiamata:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawL'audio di telefonia raw non ha container, quindi imposta audio_format=mulaw e sample_rate=8000 nel form batch, oppure encoding=mulaw&sample_rate=8000 sul socket. Controlla separatamente testo ed etichette speaker.
I risultati precedenti su termini chiave, formattazione e cambio di lingua sono cambiati poco a 8 kHz.
Le etichette speaker sono diventate meno affidabili. La versione telefonica ha introdotto un ID speaker extra e assegnato un turno finale alla persona sbagliata. Contare solo i segmenti nasconde entrambi gli errori.
La versione "ballerina" limita la banda della chiamata a 300-3400 Hz, la codifica come mu-law 8 kHz e lascia cadere ogni pacchetto da 20 millisecondi con probabilità 0,03. Un seed casuale fisso di 7 mantiene gli stessi vuoti a ogni replay.
Quella perdita di pacchetti non ha cambiato molto la trascrizione inglese in questo campione, e i dati di contatto pronunciati sono rimasti in ordine. Questo risultato vale solo per questo campione.
La simulazione telefonica restringe l'audio, facendo cadere pacchetti. Immagine dell'autore.
Il voice activity detection (VAD) decide se l'audio è parlato. I documenti suggeriscono di abbassare vad_threshold per parlato telefonico debole, con il rischio di testo spurio dal rumore.
Abbassare vad_threshold non ha cambiato nulla su audio telefonico pulito perché non c'era parlato debole da recuperare. Il risultato nullo supporta una regola: abbassa la soglia solo quando il parlato telefonico manca.
Usa un nuovo form batch senza diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
L'API rileva il numero di canali da un WAV o altro container. Per audio multicanale raw, aggiungi ("channels", "3"); l'input multicanale via WebSocket richiede anche un conteggio canali esplicito.
Invia il form con il file multicanale tramite la richiesta REST mostrata prima, poi leggi result["channels"]. Ogni elemento contiene un indice, il testo della trascrizione e parole temporizzate. Nel fixture controllato a tre canali, ogni canale conteneva solo il suo speaker assegnato. Lo streaming usa la stessa suddivisione e aggiunge channel_index ai suoi eventi.
Userei canali separati ogni volta che il sistema telefonico li fornisce. A differenza della diarizzazione nella sezione audio telefonico, una suddivisione nota non deduce gli speaker.
Il client completo espone un gruppo di impostazioni, poi costruisce separatamente il form REST o l'URL WebSocket. Le impostazioni condivise coprono diarizzazione, termini chiave, filler, codifica audio e gestione dei turni; la formattazione segue le regole specifiche del trasporto viste prima.
Applica le impostazioni finali a una registrazione in qualità telefonica, poi controlla separatamente ortografia del prodotto, cambi di lingua, dati di contatto ed etichette speaker. Nel fixture controllato, i controlli del testo sono passati mentre un'etichetta speaker richiedeva ancora revisione. Salva impostazioni e mappatura speaker con ogni trascrizione in modo che i confronti successivi usino la stessa configurazione.
Il tutorial sulla trascrizione di supporto si chiude con quel controllo finale. Il repository contiene anche un'estensione separata per agente vocale con risposte generate, output parlato, interruzioni e gestione dell'eco.
Transcribe mantiene lo stesso ruolo in quella demo: produce testo. Un modello linguistico scrive le risposte e Grok TTS le pronuncia.
Impara l'AI con DataCamp!
Programma
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min