
लर्निंग पाथ
डेवलपर्स के लिए एसोसिएट AI इंजीनियर
26 घंटा
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) SpaceXAI का स्पीच-टू-टेक्स्ट मॉडल है। REST पाथ एक पूरी फ़ाइल को ट्रांसक्राइब करता है, जबकि WebSocket पाथ लाइव ऑडियो संभालता है।
SpaceXAI की Grok Voice Transcribe 2.0 घोषणा फ़ोन कॉल्स, कई स्पीकर्स, क्रेडेंशियल्स, और बहुभाषी स्पीच पर प्रकाश डालती है। बेंचमार्क तुलना के लिए, देखें हमारा Grok Voice Transcribe 2.0 ओवरव्यू।
कंट्रोल्ड Qivora Sync फ़िक्स्चर स्थिर रहता है, जबकि ऑडियो और API सेटिंग्स बदलती हैं। कॉल में एक गढ़ा गया प्रोडक्ट नाम, फिलर्स, एक भाषा स्विच, बोले गए संपर्क विवरण, डिक्टेशन के दौरान एक विराम, और तीसरा स्पीकर शामिल है।
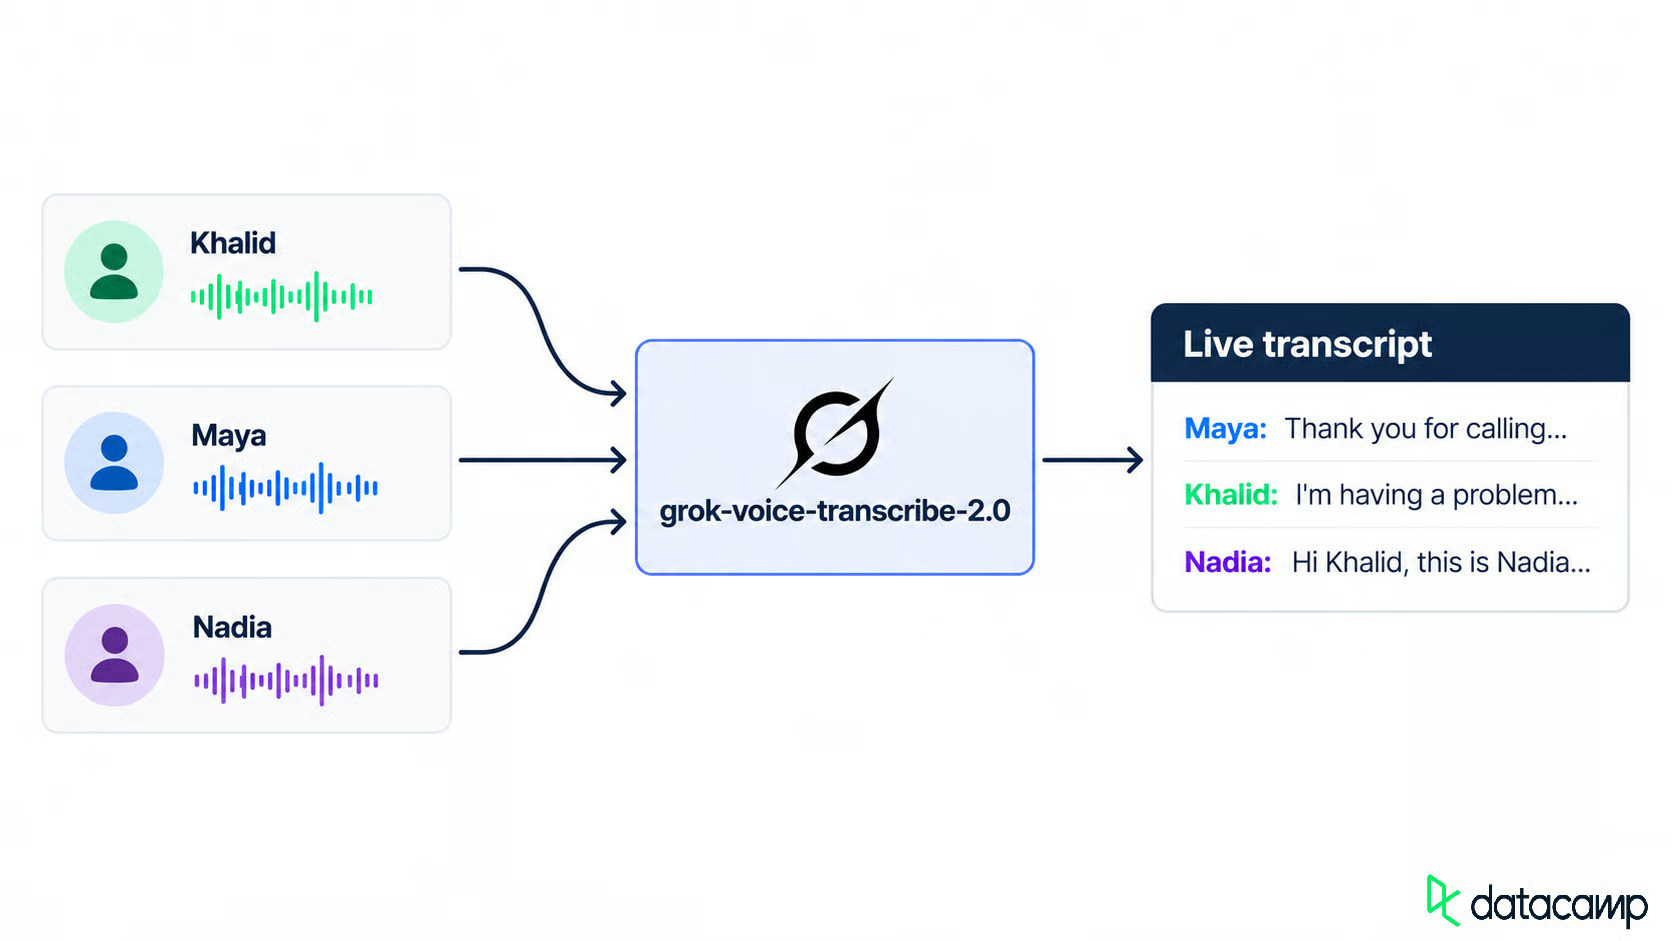
तीन स्पीकर्स एक लाइव ट्रांसक्रिप्ट बनते हैं। छवि: लेखक।
कंट्रोल्ड फ़िक्स्चर तीन अलग-अलग आवाज़ें इस्तेमाल करता है Grok Text to Speech API से। प्रत्येक भाषा खंड अलग से सिंथेसाइज़ किया गया है और ffmpeg से जोड़ा गया है ताकि स्विच पॉइंट्स स्थिर रहें। API language=auto भी स्वीकार करती है; अलग-अलग रिक्वेस्ट प्रयोग-डिज़ाइन का चयन है, API की आवश्यकता नहीं।
पहले रिक्वेस्ट से पहले, अपेक्षित टेक्स्ट, स्पीकर्स, प्रोडक्ट स्पेलिंग, ग्राहक विवरण, फिलर्स, और विराम परिभाषित करें। फिर हर सेटअप का लक्ष्य एक ही रहता है।
ऑडियो भेजने से पहले डिपेंडेंसीज़ इंस्टॉल करें।
आपको Python 3.10 या नया, एक xAI API कुंजी, और ऑडियो बनाने के लिए ffmpeg चाहिए। Python क्लाइंट्स requests, websockets, और python-dotenv का उपयोग करते हैं।
Speech to Text डॉक्स कहते हैं कि 2.0 डिफ़ॉल्ट है जब आप model छोड़ते हैं, और grok-voice-transcribe-1.0 2 अक्टूबर, 2026 को जीवन-समाप्ति पर पहुँच गया। फिर भी, मैं वर्ज़न वाले ID को पिन करूँगा।
रिपोजिटरी क्लोन करें, अपनी कुंजी .env में जोड़ें, और सैंपल ऑडियो बनाएं:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
सेटअप कमांड संवाद और आगे उपयोग की जाने वाली ऑडियो फ़ाइलें बनाता है। यदि आपके पास अपनी रिकॉर्डिंग है, तो उस कमांड को छोड़ दें।
Windows पर लिखा गया एक .env कुंजी पर \r छोड़ सकता है, और requests हेडर को अस्वीकार कर देता है इससे पहले कि कुछ SpaceXAI तक पहुँचे। ऑथराइज़ेशन हेडर में जोड़ने से पहले कुंजी को स्ट्रिप करें।
बेसलाइन वह मॉडल है जिसमें कुछ भी चालू नहीं है, ताकि बाद का हर बदलाव तुलना के लिए कुछ दे। पहली रिक्वेस्ट फ़ाइल और पिन किया हुआ मॉडल भेजती है:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
रिस्पॉन्स में text, डिटेक्टेड language, duration, और टाइम्ड words एरे होता है। REST रेफरेंस दिखाता है प्रति-शब्द confidence, लेकिन यह इस फ़िक्स्चर के बैच रिस्पॉन्सेज़ में दिखाई नहीं दिया। मैं इस फ़ील्ड को वैकल्पिक मानूँगा और उपयोग से पहले हर API रिस्पॉन्स की जाँच करूँगा। वैकल्पिक फ़ील्ड्स को file से पहले रखें; बाद के फ़ील्ड्स अनदेखे हो सकते हैं।
बेसलाइन ने फिलर्स हटा दिए, अरबी को अरबी लिपि में रखा, और बोले गए अंकों को अलग छोड़ा। इसने गढ़े गए प्रोडक्ट नाम की लगातार गलत वर्तनी की।
एक सपोर्ट ट्रांसक्रिप्ट को स्पीकर लेबल, सही प्रोडक्ट स्पेलिंग, और उपयोगी ग्राहक विवरण चाहिए। हर सेटिंग एक और फ़ॉर्म फ़ील्ड है:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
उसी ऑडियो पर एक समय में एक विकल्प जोड़ें। स्पीकर लेबल से शुरू करें।
स्पीकर डायरीज़ेशन शब्दों को अंकीय स्पीकर ID देता है, नाम नहीं। टर्न बनाने के लिए समान ID वाले लगातार शब्दों को समूहित करें:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
साफ़ ऑडियो पर, हर ज्ञात टर्न एक सुसंगत स्पीकर ID के साथ रहा। पहले उपस्थित होने के क्रम से नाम मैप करना तभी चलता है जब कॉल क्रम पहले से ज्ञात हो; प्रोडक्शन सिस्टम्स को अपना स्पीकर मैपिंग चाहिए।
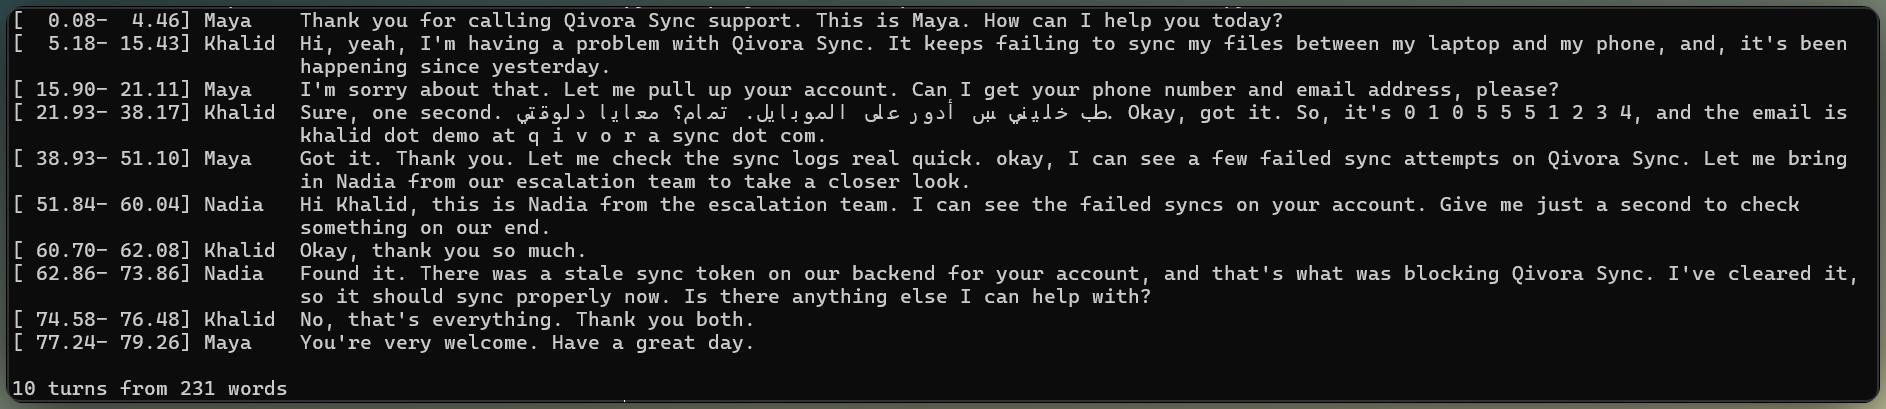
साफ़ ऑडियो स्पीकर लेबल्स को सुसंगत रखता है। छवि: लेखक।
की-टर्म बायसिंग प्रति-रिक्वेस्ट संकेत है, ट्रेनिंग नहीं। keyterm=Qivora Sync (अधिकतम 100 टर्म, प्रत्येक 50 अक्षर) पास करें, और जब ऑडियो समर्थन करता है तो मॉडल उस स्पेलिंग की ओर झुकता है।
की-टर्म ने बेसलाइन की प्रोडक्ट-नाम त्रुटि को सुधारा, बिना आस-पास के ट्रांसक्रिप्ट को बदले।
एक अलग लाइव-स्पीकर जांच में, कड़ी पक्षपाती शब्दावली ने एक हल्की गूंज को की-टर्म की ओर खींचा। इसका मतलब यह नहीं कि की-टर्म अपने आप झूठा टेक्स्ट बनाते हैं; इसका मतलब है कि संदिग्ध ऑडियो को अभी भी इको-चेक चाहिए।
जैसा कि बेसलाइन ने दिखाया, खालिद की अरबी अरबी लिपि में ही रही। परिणाम स्वचालित डिटेक्शन और language=en दोनों में समान रहा, क्योंकि language आउटपुट भाषा को बाध्य करने के बजाय फ़ॉर्मैटिंग नियम चुनता है।
बेसलाइन ने बोले गए अंकों को अलग रखा। इनवर्स टेक्स्ट नॉर्मलाइज़ेशन (ITN) उन बोले गए रूपों को लिखित में बदल देता है। format=true इसे ऑन करता है और language की ज़रूरत होती है, वरना रिक्वेस्ट 400 के साथ फेल होती है।
फ़ोन नंबर एक सतत अंक-स्ट्रिंग बन गया। ईमेल केवल आंशिक रूप से नॉर्मलाइज़ हुआ: विरामचिह्न सुधरे, लेकिन बोला गया "at" और हिज्जे से बोले गए डोमेन को अभी भी सफ़ाई चाहिए थी।
यह असमान परिणाम निराशाजनक है। ITN टेक्स्ट को फ़ॉर्मैट करता है; यह संपर्क डेटा को वैलिडेट नहीं करता। स्टोरेज से पहले मैं दोनों फ़ील्ड्स को वैलिडेट करूँगा।
ITN सामान्य अवधि वाक्यांशों को संक्षिप्त मात्राओं के रूप में भी लिख सकता है। इस फ़िक्स्चर के फ़ॉर्मेटेड बैच रिस्पॉन्स में, केवल टॉप-लेवल text नॉर्मलाइज़ हुआ; words एरे ने बोले गए रूप को ही रखा।
जैसा कि बेसलाइन ने दिखाया, फिलर्स डिफ़ॉल्ट रूप से text और words से हटा दिए जाते हैं। filler_words=true ने खालिद के "uh" और "um" को अपेक्षित जगहों पर वापस लाया। सपोर्ट नोट्स के लिए इन्हें ऑफ रखें और शब्दशः QA रिकॉर्ड के लिए ऑन रखें।
बैच आउटपुट में स्पीकर्स, शब्दावली, फ़ॉर्मैटिंग, और फिलर-शब्द नियंत्रण शामिल हैं। अब, उसी ऑडियो को लाइव स्ट्रीम के रूप में भेजें।
स्ट्रीमिंग पाथ सेटअप संदेश के बजाय क्वेरी पैरामीटर्स का उपयोग करता है। transcript.created का इंतज़ार करें, कच्चा बाइनरी ऑडियो भेजें (base64 नहीं), और {"type": "audio.done"} से बंद करें। हमारा GPT Live Transcribe ट्यूटोरियल इसी पैटर्न का उपयोग एक दूसरे मॉडल के साथ करता है।
ईवेंट्स से शुरू करें, फिर क्लाइंट को कनेक्ट करें।
बैच दस्तावेज़ित format=true के साथ language=en का उपयोग करता है। स्ट्रीमिंग डॉक्स कहते हैं कि language ITN ऑन करता है, लेकिन एक लाइव प्रॉब में, language=en अकेले ने ट्रांसक्रिप्ट नहीं बदला। WebSocket क्वेरी सूची में format शामिल नहीं है, इसलिए यह ट्यूटोरियल स्ट्रीमिंग ITN को भरोसे के बजाय सत्यापित करने योग्य व्यवहार मानता है।
हर ट्रांसक्रिप्शन अपडेट एक transcript.partial ईवेंट है जिसमें दो बूलियन होते हैं। अंतरिम टेक्स्ट अभी भी बदल सकता है। एक चंक फ़ाइनल (is_final=true) लगभग 3 सेकंड के टेक्स्ट को लॉक करता है जबकि टर्न खुला रहता है, और एक उच्चारण फ़ाइनल (speech_final=true) टर्न को बंद करता है।
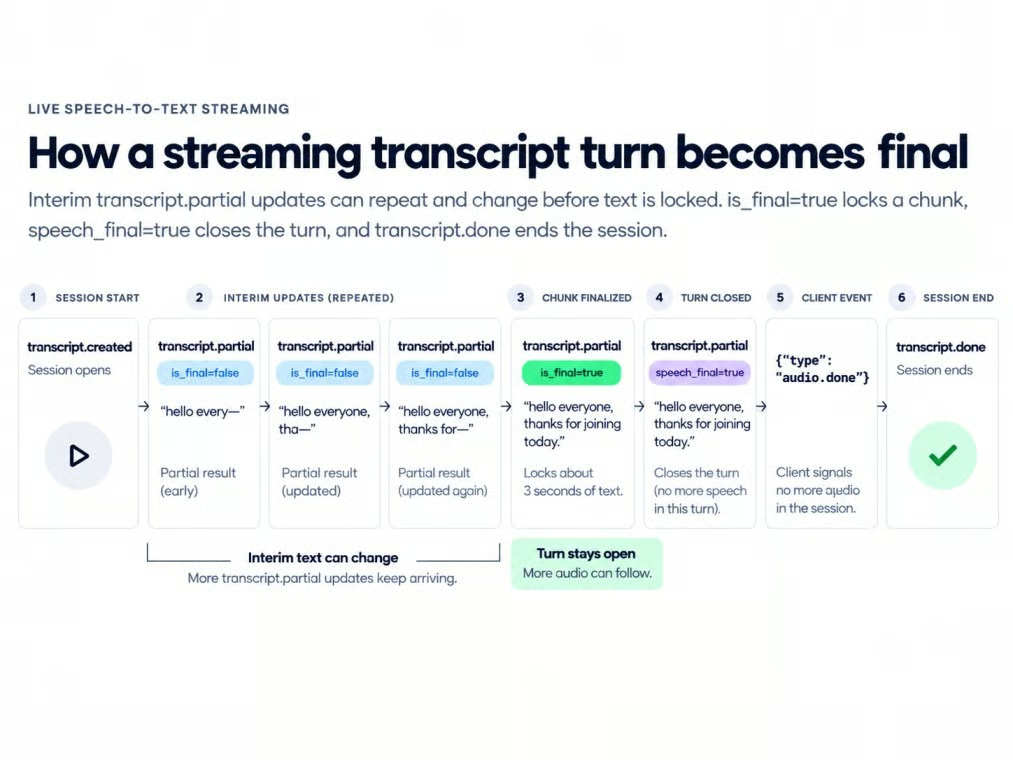
स्ट्रीमिंग अवस्थाएँ टेक्स्ट को फ़ाइनलाइज़ेशन की ओर ले जाती हैं। छवि: लेखक।
स्ट्रीमिंग के लिए, पहले सोर्स को मोनो 16-बिट PCM पर 16 kHz में रीसैंपल करें। कोर क्लाइंट 100-मिलीसेकंड चंक्स रीयल-टाइम गति से भेजता है जबकि दूसरा टास्क ट्रांसक्रिप्ट ईवेंट्स प्राप्त करता है:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
इंटरिम टेक्स्ट लगभग हर आधे सेकंड में बढ़ता गया। यह एक स्थानीय मापन है, आधिकारिक लेटेंसी नहीं।
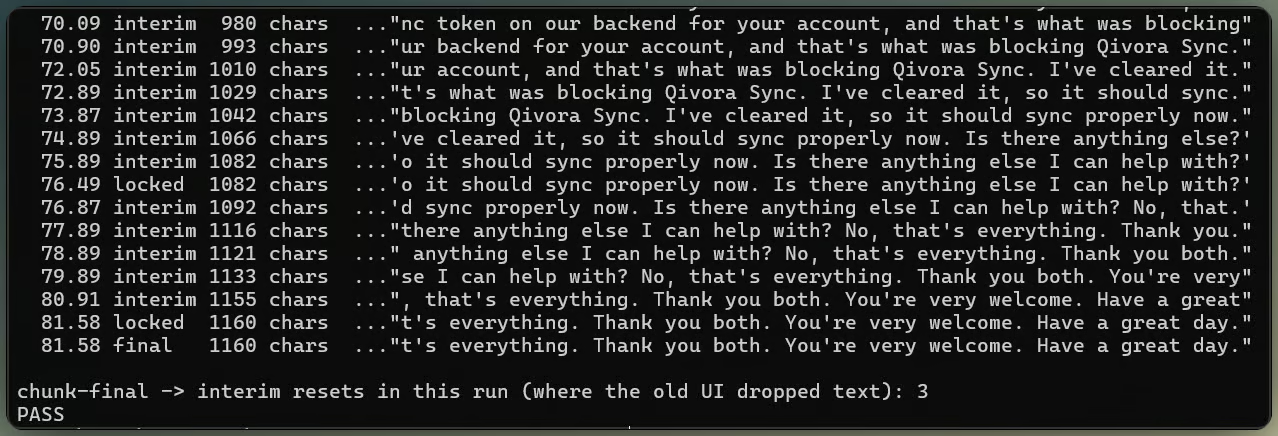
पार्शियल कैप्शन्स अंतिम ट्रांसक्रिप्ट में सैटल हो जाते हैं। छवि: लेखक।
चंक फ़ाइनल्स टर्न को बंद किए बिना टेक्स्ट को फ्रीज़ करते हैं। स्मार्ट टर्न नियंत्रित करता है कि speech_final कब इसे बंद करे।
केवल सक्रिय ईवेंट दिखाने से हर चंक के फ़ाइनल के बाद पहले के शब्द ग़ायब हो जाते हैं, क्योंकि अगला इंटरिम आने वाले ऑडियो से फिर से शुरू होता है।
हर लॉक्ड चंक रखें, मौजूदा इंटरिम जोड़ें, और उच्चारण फ़ाइनल दोनों को बदलने दें।
टेक्स्ट पहले के चंक्स खोए बिना बढ़ सकता है। डिस्प्ले स्टेट संभलने के बाद, टर्न सीमाएँ शेष स्ट्रीमिंग समस्या हैं।
स्मार्ट टर्न हर साइलेंस का आकलन करता है और अनुमान लगाता है कि क्या स्पीकर खत्म हो चुका है। यह खालिद के नंबर के लिए मौजूद है, "ज़ीरो वन ज़ीरो, फ़ाइव फ़ाइव फ़ाइव, [विराम], वन टू थ्री फ़ोर," जहाँ केवल साइलेंस से सोचना-विराम और अंत में अंतर नहीं किया जा सकता।
थ्रेशोल्ड ट्रांसक्रिप्शन कॉन्फिडेन्स या VAD थ्रेशोल्ड नहीं है। यह वह एंड-ऑफ़-टर्न प्रॉबेबिलिटी है जिसे साइलेंस को पार करना चाहिए, तभी speech_final फ़ायर होता है; इससे नीचे, टर्न खुला रहता है। दो क्वेरी पैरामीटर्स इसे सेट करते हैं:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
डॉक्स 0.5 को बैलेंस्ड, 0.7 को नंबर सीक्वेंस के लिए कंज़र्वेटिव, और 0.9 को बहुत कंज़र्वेटिव कहते हैं। इस फ़िक्स्चर में, डिफ़ॉल्ट endpointing विंडो से छोटे विराम ने कोई उपयोगी स्मार्ट टर्न निर्णय नहीं दिया। यह एक अवलोकित परिणाम है, डॉक्यूमेंटेड टाइमिंग नियम नहीं।
स्ट्रीमिंग टेस्ट में, ऑडियो फ़्रेम रोकने से अवलोकित साइलेंस टाइमर आगे नहीं बढ़ा। डिजिटल साइलेंस भेजना जारी रखने से स्मार्ट टर्न को उच्चारण बंद करने की अनुमति मिलती है।
नंबर डिक्टेशन के दौरान विराम बढ़ाने से व्यवहार दिखाई देता है। छोटे विराम एक ही टर्न में रहते हैं, जबकि लंबा विराम हर थ्रेशोल्ड पर इसे विभाजित कर देता है जब कॉन्फिडेंस तीनों सेटिंग्स से ऊपर चला जाता है।
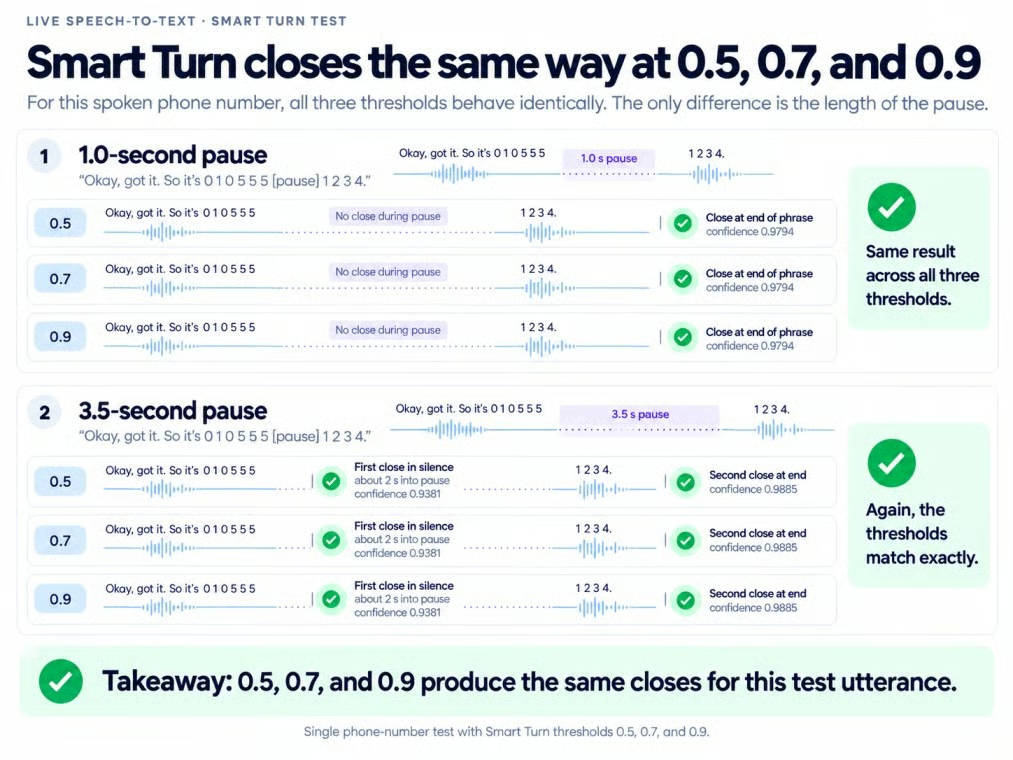
लंबे विराम नंबर डिक्टेशन को विभाजित कर सकते हैं। छवि: लेखक।
मानवीय कॉलर्स कम अनुमानित होते हैं। एक छोटी अंक-सीक्वेंस समाप्त लग सकती है। फिर कॉलर जारी रखता है।
यदि स्मार्ट टर्न नंबर डिक्टेशन के दौरान बंद कर देता है, तो जवाब देने से पहले थोड़ा रुकें और एक निरंतरता को मर्ज करें।
smart_turn_timeout एक निश्चित साइलेंस के बाद टर्न को बंद कर देता है, भले ही स्मार्ट टर्न अनिश्चित हो। तेज़ तीन-स्पीकर स्ट्रीम पर, स्मार्ट टर्न ने टाइमआउट के ज़बरदस्ती बंद करने से पहले कई ज्ञात टर्न समूहित किए।
यदि आपको पहले से पता है कि टर्न कहाँ खत्म होते हैं, तो हर सीमा पर {"type": "finalize"} भेजें; अन्यथा, स्मार्ट टर्न को टाइमआउट के साथ जोड़ें।
एक बार टर्न सीमाएँ नियंत्रण में आने के बाद, वही कॉलर 8 kHz लाइन पर भी टिकना चाहिए।
यहाँ फ़ोन-क्वालिटी ऑडियो 8 kHz G.711 mu-law है, जिसे उसी कॉल से बनाया गया है:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawकच्चे टेलिफ़ोनी ऑडियो का कोई कंटेनर नहीं होता, इसलिए बैच फ़ॉर्म में audio_format=mulaw और sample_rate=8000 सेट करें, या सॉकेट पर encoding=mulaw&sample_rate=8000। टेक्स्ट और स्पीकर लेबल्स को अलग-अलग जाँचें।
पहले के की-टर्म, फ़ॉर्मैटिंग, और भाषा-स्विच निष्कर्ष 8 kHz पर बहुत कम बदले।
स्पीकर लेबल्स कम भरोसेमंद हो गए। फ़ोन संस्करण ने एक अतिरिक्त स्पीकर ID जोड़ी और समापन टर्न को गलत व्यक्ति को असाइन कर दिया। केवल सेगमेंट्स गिनने से दोनों गलतियाँ छिप जाती हैं।
फ़्लैकी संस्करण कॉल को 300-3400 Hz तक बैंड-लिमिट करता है, इसे 8 kHz mu-law के रूप में एन्कोड करता है, और हर 20-मिलीसेकंड पैकेट को 0.03 प्रायिकता के साथ ड्रॉप करता है। एक फिक्स्ड रैंडम सीड 7 हर रीप्ले पर एक जैसे गैप्स रखता है।
इस सैंपल में उस पैकेट लॉस ने अंग्रेज़ी ट्रांसक्रिप्ट को बहुत नहीं बदला, और बोले गए संपर्क विवरण क्रम में ही रहे। यह परिणाम केवल इसी सैंपल पर लागू होता है।
फ़ोन सिमुलेशन ऑडियो को संकरा करता है, पैकेट गिराता है। छवि: लेखक।
वॉइस एक्टिविटी डिटेक्शन (VAD) तय करता है कि ऑडियो बिल्कुल स्पीच है या नहीं। डॉक्स शांत फ़ोन स्पीच के लिए vad_threshold घटाने का सुझाव देते हैं, शोर से भटके हुए टेक्स्ट के जोखिम पर।
साफ़ फ़ोन ऑडियो पर vad_threshold घटाने से कुछ नहीं बदला क्योंकि रिकवर करने के लिए कोई शांत स्पीच नहीं थी। यह शून्य-परिणाम एक नियम का समर्थन करता है: थ्रेशोल्ड तभी घटाएँ जब फ़ोन स्पीच गायब हो रही हो।
एक नया बैच फ़ॉर्म बिना diarize के उपयोग करें:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API WAV या अन्य कंटेनर से चैनल काउंट डिटेक्ट करती है। कच्चे मल्टीचैनल ऑडियो के लिए, ("channels", "3") जोड़ें; WebSocket मल्टीचैनल इनपुट के लिए भी स्पष्ट चैनल काउंट आवश्यक है।
पहले दिखाए गए REST रिक्वेस्ट से मल्टीचैनल फ़ाइल के साथ फ़ॉर्म भेजें, फिर result["channels"] पढ़ें। प्रत्येक आइटम में एक इंडेक्स, ट्रांसक्रिप्ट टेक्स्ट, और टाइम्ड शब्द होते हैं। कंट्रोल्ड तीन-चैनल फ़िक्स्चर में, हर चैनल में केवल उसका असाइन किया गया स्पीकर था। स्ट्रीमिंग भी यही विभाजन इस्तेमाल करती है और अपने ईवेंट्स में channel_index जोड़ती है।
जब भी फ़ोन सिस्टम अलग-अलग लेग्स देता है, मैं उनका उपयोग करूँगा। फ़ोन-ऑडियो सेक्शन में डायरीज़ेशन के विपरीत, एक ज्ञात विभाजन स्पीकर्स का अनुमान नहीं लगाता।
पूरा क्लाइंट सेटिंग्स का एक समूह उजागर करता है, फिर REST फ़ॉर्म या WebSocket URL को अलग से बनाता है। साझा सेटिंग्स में डायरीज़ेशन, की-टर्म्स, फिलर शब्द, ऑडियो एन्कोडिंग, और टर्न हैंडलिंग शामिल हैं; फ़ॉर्मैटिंग पहले कवर किए गए ट्रांसपोर्ट-विशिष्ट नियमों का पालन करती है।
अंतिम सेटिंग्स को एक फ़ोन-क्वालिटी रिकॉर्डिंग पर लागू करें, फिर प्रोडक्ट स्पेलिंग, भाषा स्विच, संपर्क विवरण, और स्पीकर लेबल्स को अलग-अलग जाँचें। कंट्रोल्ड फ़िक्स्चर में, टेक्स्ट जाँचें पास हुईं जबकि एक स्पीकर लेबल को अभी भी समीक्षा की ज़रूरत थी। हर ट्रांसक्रिप्ट के साथ सेटिंग्स और स्पीकर मैपिंग सहेजें ताकि बाद की तुलना में वही सेटअप इस्तेमाल हो।
सपोर्ट-ट्रांसक्रिप्शन ट्यूटोरियल उसी अंतिम जाँच के साथ समाप्त होता है। रिपोजिटरी में जेनरेटेड रिप्लाईज़, बोले गए आउटपुट, रुकावटें, और इको हैंडलिंग के साथ एक अलग वॉइस-एजेंट एक्सटेंशन भी है।
ट्रांसक्राइब उस डेमो में वही भूमिका रखता है: यह टेक्स्ट बनाता है। एक भाषा मॉडल जवाब लिखता है, और Grok TTS उन्हें बोलता है।
DataCamp के साथ AI सीखें!
लर्निंग पाथ
लर्निंग पाथ
कोर्स