トラック
開発者向けアソシエイトAIエンジニア
26時間
Grok Voice Transcribe 2.0(grok-voice-transcribe-2.0)は SpaceXAI の音声→テキストモデルです。REST パスは完了済みファイルを文字起こしし、WebSocket パスはライブ音声を処理します。
SpaceXAI の Grok Voice Transcribe 2.0 の発表では、電話通話、複数話者、認証情報、多言語音声が強調されています。ベンチマーク比較は、Grok Voice Transcribe 2.0 の概要を参照してください。
制御された Qivora Sync のフィクスチャは、音声と API 設定を変えても一定です。コールには、架空の製品名、フィラー、言語切り替え、読み上げられる連絡先、ディクテーション中のポーズ、3人目の話者が含まれます。
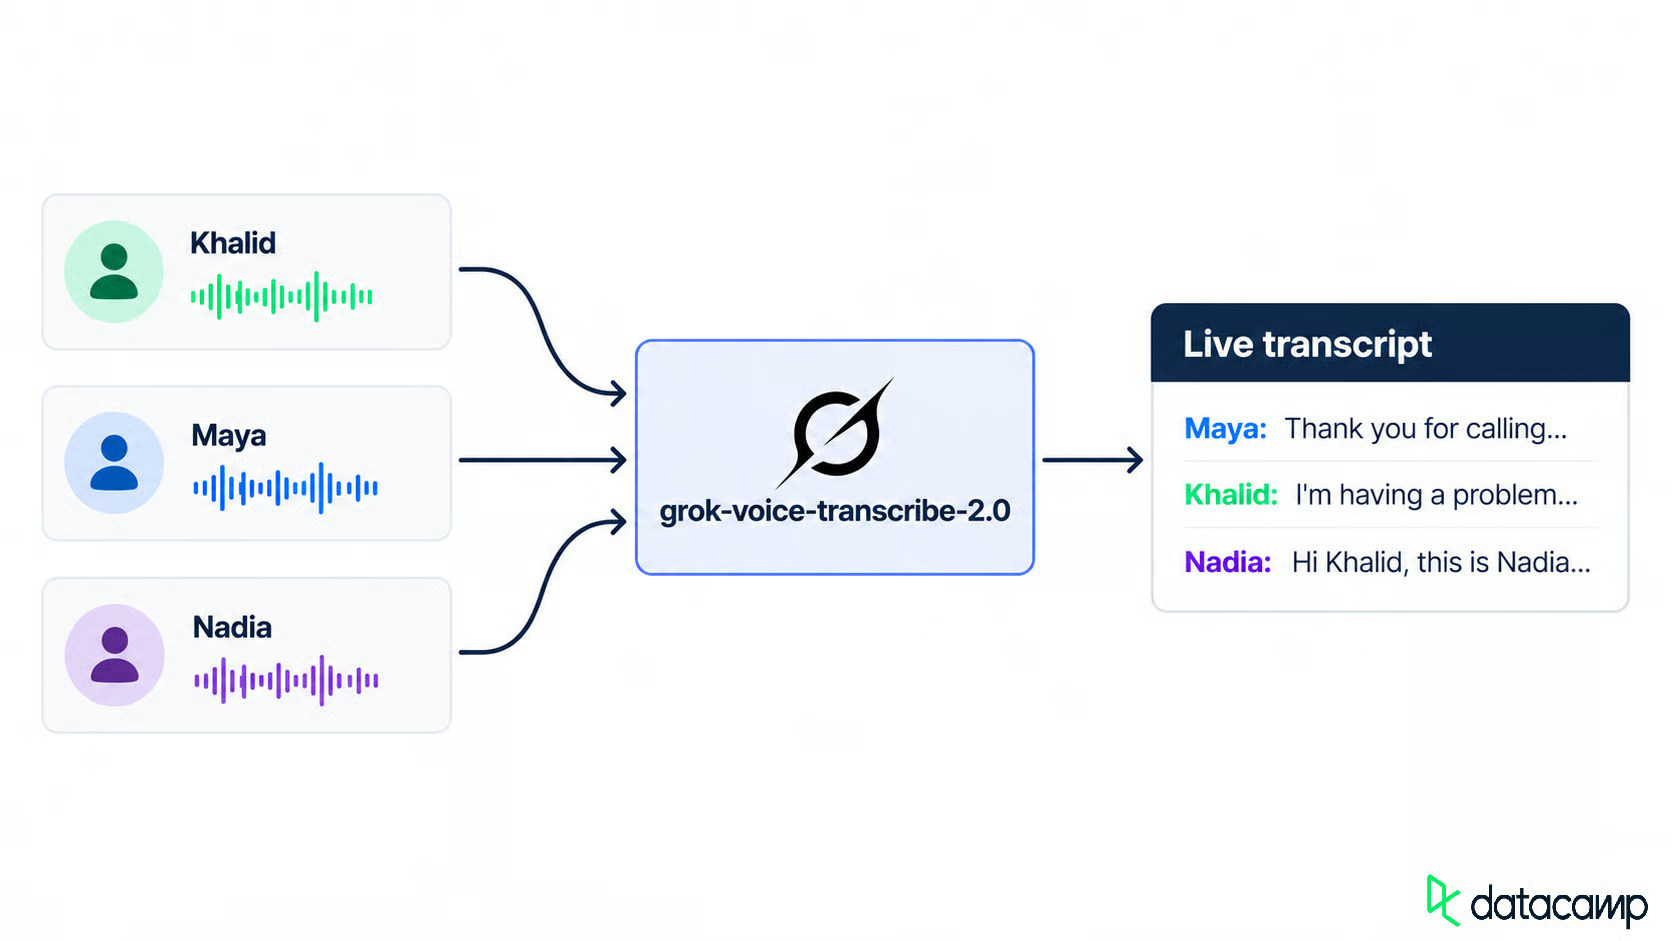
3人の話者が1つのライブ転記になります。画像:著者作成。
この制御フィクスチャでは、 Grok Text to Speech API の3つの異なる声を使います。各言語セグメントは個別に合成し、ffmpeg で結合して切り替えポイントを固定しています。API は language=auto も受け付けます。個別リクエストは実験設計上の選択であり、API の要件ではありません。
最初のリクエストの前に、想定するテキスト、話者、製品名の綴り、顧客情報、フィラー、ポーズを定義します。以後すべてのセットアップが同じターゲットを持てます。
音声を送る前に依存関係をインストールします。
Python 3.10 以降、xAI API キー、および音声作成用の ffmpeg が必要です。Python クライアントは requests、websockets、python-dotenv を使用します。
Speech to Text のドキュメントでは、 model を省略すると 2.0 がデフォルトとされています。また、grok-voice-transcribe-1.0 は 2026年10月2日にサポート終了となりました。私はバージョン付きIDを固定することを推奨します。
リポジトリをクローンし、キーを .env に追加し、サンプル音声を生成します。
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
セットアップコマンドは、後で使用するダイアログと音声ファイルを作成します。自前の録音があれば、このコマンドは不要です。
.env を Windows で作成すると \r がキー末尾に残ることがあり、requests は SpaceXAI に到達する前にヘッダーを拒否します。認可ヘッダーに入れる前にキーをトリムしてください。
ベースラインは、何も有効化しないモデルの出力で、以降の変更を比較する基準になります。最初のリクエストではファイルと固定モデルを送ります。
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()レスポンスには、text、検出されたlanguage、duration、タイムスタンプ付きの words 配列が含まれます。 REST リファレンスは単語ごとのconfidence を示していますが、本フィクスチャのバッチ応答では現れませんでした。このフィールドは任意とみなし、利用前に各API応答を確認するのがよいでしょう。オプションフィールドは file より前に置いてください。後続のフィールドは無視されることがあります。
ベースラインではフィラーが除去され、アラビア語はアラビア文字のまま保持され、読み上げられた数字は分割されたままでした。架空の製品名は一貫して誤綴りでした。
サポートの転記には、話者ラベル、正しい製品名の綴り、実用的な顧客情報が必要です。各設定はフォームフィールドを一つずつ追加します。
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
同じ音声に対して、オプションを1つずつ追加しましょう。話者ラベルから始めます。
話者分離は単語に名前ではなく数値の話者IDを付与します。同じIDが連続する単語をまとめてターンを構築します。
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
クリーンな音声では、既知の各ターンが一貫した話者IDのままでした。最初に登場した順で名前を対応づける方法は、通話順が既知の場合にのみ機能します。プロダクションでは独自の話者マッピングが必要です。
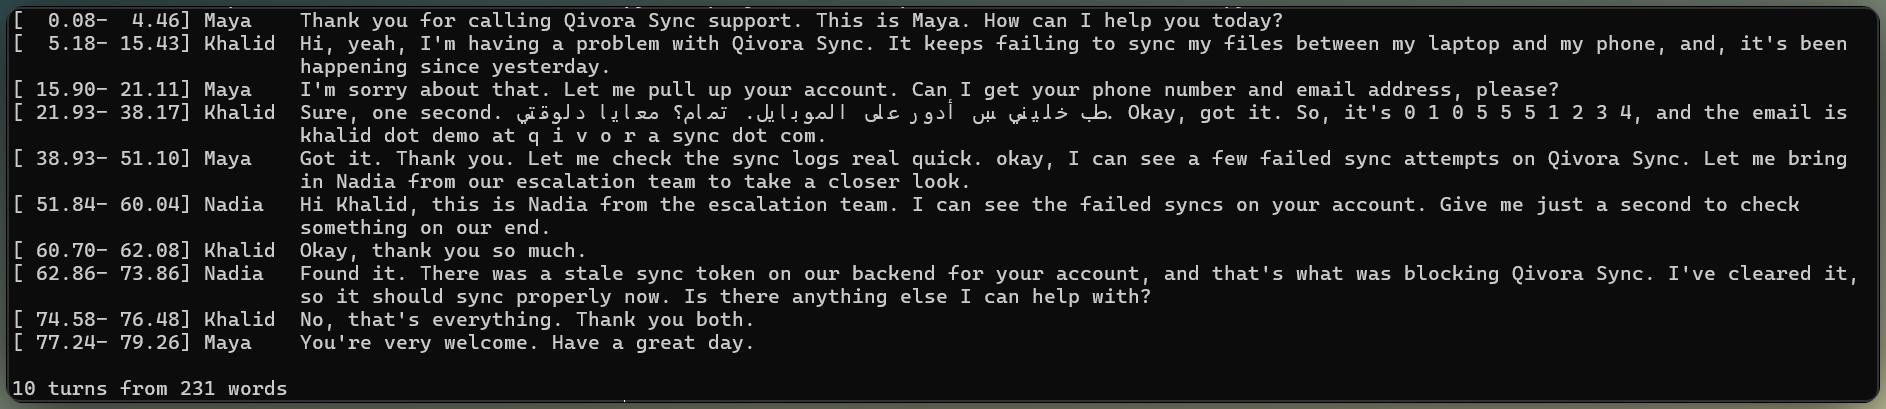
クリーンな音声では話者ラベルが安定します。画像:著者作成。
キータームのバイアスはリクエスト単位のヒントであり、学習ではありません。keyterm=Qivora Sync(最大100語、各50文字)を渡すと、音声が支持する範囲でその綴りに寄ります。
キータームにより、ベースラインの製品名の誤りが修正され、周囲の転記は変わりませんでした。
別のライブ話者チェックでは、強い語彙バイアスが微かなエコーをキータームに引き寄せました。これはキータームが単独で誤テキストを生成するという意味ではなく、曖昧な音声にはエコーチェックが必要であることを示します。
ベースラインで示したように、Khalid のアラビア語はアラビア文字のままでした。これは自動検出の場合も、language=en を指定した場合も同じです。なぜなら language は出力言語を強制するのではなく、整形ルールを選ぶためのものだからです。
ベースラインでは、読み上げられた数字は分割されたままでした。逆テキスト正規化(ITN)は、読み上げ形式を記述形式に変換します。format=true で有効になり、language が必要です。指定がないと 400 になります。
電話番号は連続した数字列になりました。メールは部分的にしか正規化されませんでした。句読点は改善されましたが、口頭の「at」やスペル読みのドメインは手直しが必要でした。
この不均一な結果はもどかしいものです。ITN はテキストの整形であり、連絡先データの検証ではありません。両フィールドとも保存前に検証することを推奨します。
ITN は、通常の所要時間表現を短縮表記に書き換えることもあります。本フィクスチャのフォーマット済みバッチ応答では、最上位の text のみが正規化され、words 配列は口頭形式のままでした。
ベースラインのとおり、デフォルトではフィラーは text と words から除去されます。filler_words=true を指定すると、Khalid の「uh」「um」が期待どおりに戻りました。サポートノートにはオフ、逐語的なQA記録にはオンがよいでしょう。
バッチ出力では、話者・語彙・整形・フィラー制御を確認できました。次に、同じ音声をライブ配信します。
ストリーミングパスはセットアップメッセージではなくクエリパラメータを使用します。transcript.created を待ち、生のバイナリ音声(base64 不要)を送り、最後に {"type": "audio.done"} で閉じます。当サイトの GPT Live Transcribe チュートリアルでは、別モデルで同じパターンを用いています。
まずイベントを理解し、次にクライアントを接続します。
バッチではドキュメントどおり format=true と language=en を使います。ストリーミングのドキュメントでは language が ITN を有効にするとありますが、実地のライブ検証では language=en だけでは転記は変わりませんでした。WebSocket のクエリ一覧に format がないため、本チュートリアルではストリーミングの ITN は「依存せず検証対象」として扱います。
すべての転記更新は transcript.partial イベントで届き、2つのブール値を持ちます。途中のテキストはまだ変わり得ます。チャンク確定(is_final=true)はターンを開いたまま約3秒分のテキストを固定し、発話確定(speech_final=true)はターンを閉じます。
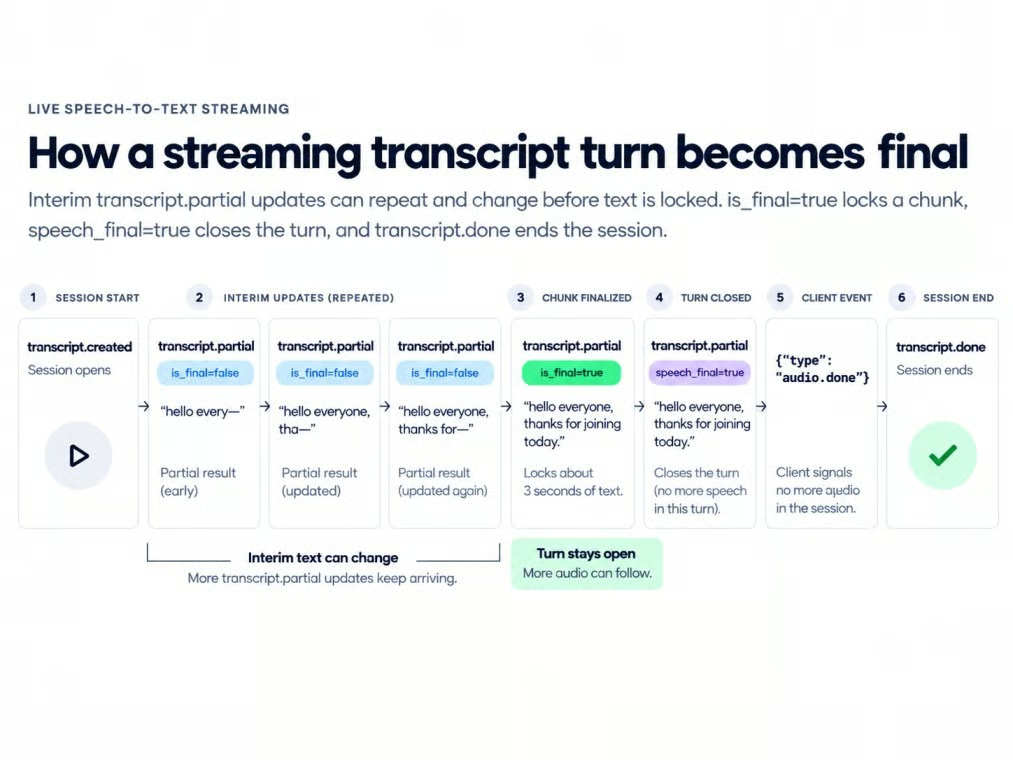
ストリーミングの状態はテキストを確定へと進めます。画像:著者作成。
ストリーミングでは、まずソースをモノラル16-bit PCM/16 kHz にリサンプリングします。コアクライアントは 100 ミリ秒のチャンクを実時間ペースで送信し、別タスクが転記イベントを受信します。
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
途中テキストは約0.5秒ごとに伸びていきました。これはローカル計測であり、公式レイテンシではありません。
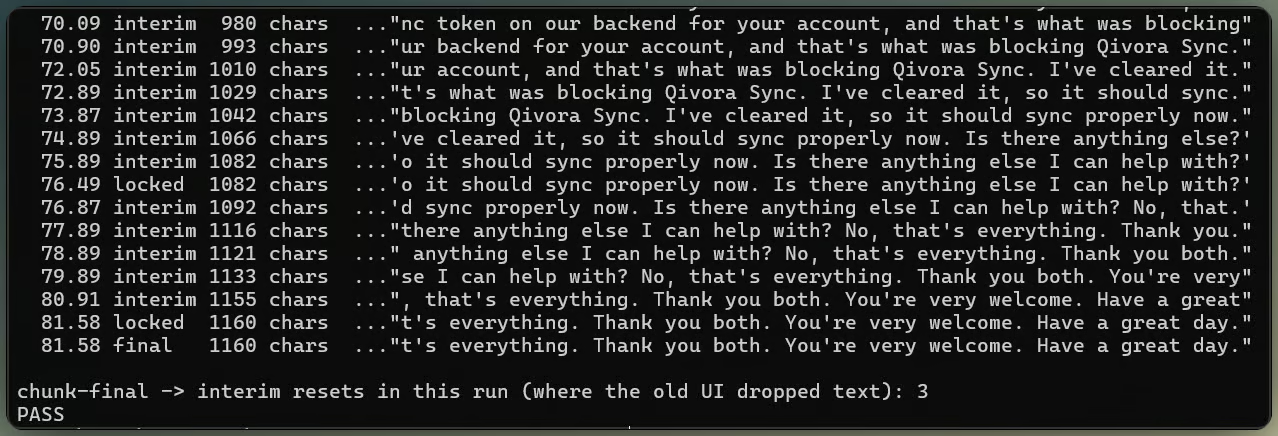
部分キャプションが最終転記へと収束します。画像:著者作成。
チャンク確定はターンを閉じずにテキストを固定します。Smart Turn はspeech_final をいつ閉じるかを制御します。
アクティブなイベントだけを表示すると、各チャンク確定のあとにそれまでの語が消えてしまいます。次の途中テキストは入力音声の先頭からやり直すためです。
固定済みチャンクはすべて保持し、現在の途中テキストを後ろに付け、発話確定で両方を置き換えます。
こうすれば、前のチャンクを失わずにテキストを伸ばせます。表示状態を処理できたら、残る課題はターン境界です。
Smart Turn は各無音を評価し、話者が話し終えたかを推定します。これは、Khalid の番号「zero one zero, five five five,(ポーズ)one two three four」のように、無音だけでは思考の間なのか終了なのか判断できない場合のためにあります。
このしきい値は転記の確信度でも、VAD のしきい値でもありません。これは、無音が speech_final を発火させるために越えるべきターン終了確率です。下回ればターンは開いたままです。2つのクエリパラメータで設定します。
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
ドキュメントでは 0.5 がバランス、0.7 が数字列向けの保守的、0.9 が非常に保守的とされています。本フィクスチャでは、デフォルトの endpointing ウィンドウより短いポーズでは有用な Smart Turn の判定は得られませんでした。これは観察結果であり、公式のタイミング規則ではありません。
ストリーミングテストでは、音声フレームの送出を止めても観測上の無音タイマーは進みませんでした。デジタル無音を送り続けると、Smart Turn が発話を閉じられます。
数字のディクテーション中のポーズを長くすると挙動が見やすくなります。短いポーズは1つのターン内に収まり、長いポーズは信頼度が3つの設定すべてを超えたとき、各しきい値で分割されます。
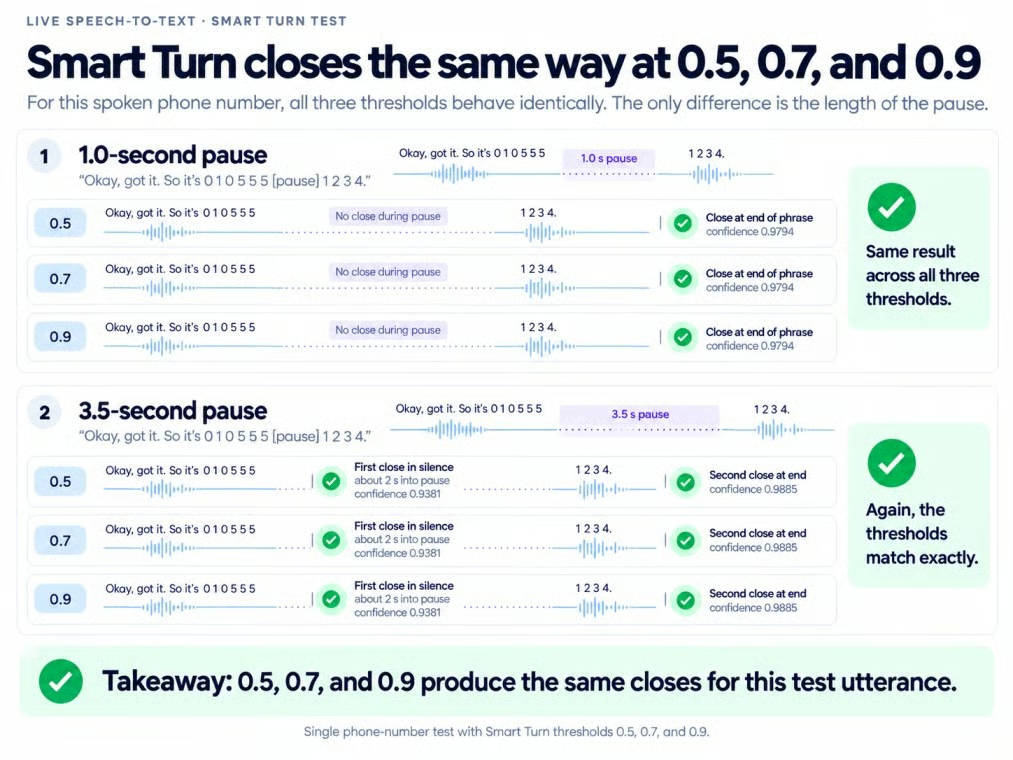
長いポーズは数字のディクテーションを分割し得ます。画像:著者作成。
人間の発話はもっと予測不能です。短い数字列でも完了に見えることがあります。すると発話者が続けます。
数字ディクテーション中に Smart Turn が閉じたら、少し待って継続分をマージしてから応答してください。
smart_turn_timeout は、Smart Turn が不確かでも一定の無音後にターンを閉じます。高速な3話者ストリームでは、Smart Turn が複数の既知のターンをまとめましたが、タイムアウトが強制的に閉じました。
ターンの終端が既知なら、各境界で {"type": "finalize"} を送ってください。不明な場合は、Smart Turn とタイムアウトを組み合わせます。
ターン境界を制御できたら、同じ発話者が 8 kHz 回線でも耐えられる必要があります。
ここでの電話品質音声は、同じコールから作った 8 kHz G.711 μ-law です。
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.raw生の電話音声はコンテナを持たないため、バッチのフォームでは audio_format=mulaw と sample_rate=8000 を、ソケットでは encoding=mulaw&sample_rate=8000 を設定します。テキストと話者ラベルは個別に確認してください。
先に確認したキーターム、整形、言語切り替えの所見は、8 kHz でも大きくは変わりませんでした。
一方で話者ラベルは信頼性が下がりました。電話版では余分な話者IDが導入され、クロージングターンが誤った人物に割り当てられました。セグメント数だけを数えると、この2つの誤りは見落とします。
不安定版は、通話を 300–3400 Hz に帯域制限し、8 kHz μ-law で符号化し、20 ミリ秒ごとの各パケットを確率 0.03 でドロップします。固定乱数シード 7 により、毎回同じ欠落が再現されます。
このサンプルでは、パケットロスは英語の転記に大きな影響を与えず、読み上げられた連絡先情報も順序通りでした。この結果はあくまで本サンプルに限ります。
電話シミュレーションは帯域を狭め、パケットをドロップします。画像:著者作成。
VAD(音声活動検出)は、音声かどうかを判定します。ドキュメントでは、静かな電話音声には vad_threshold を下げることが推奨されていますが、ノイズから不要なテキストが出るリスクがあります。
クリーンな電話音声では、vad_threshold を下げても何も変わりませんでした。回収すべき静かな発話がなかったためです。この無効結果は、「電話発話が欠落している場合にのみしきい値を下げる」という1つの指針を裏づけます。
新しいバッチフォームを用意し、diarize は指定しません。
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API は WAV などのコンテナからチャンネル数を検出します。生のマルチチャンネル音声では ("channels", "3") を追加します。WebSocket のマルチチャンネル入力も明示的なチャンネル数が必要です。
前述の REST リクエストでフォームとマルチチャンネルファイルを送信し、result["channels"] を読みます。各要素にはインデックス、転記テキスト、タイムスタンプ付き単語が含まれます。制御された3チャンネルのフィクスチャでは、各チャンネルは割り当てられた話者のみを含みました。ストリーミングでも同様に分割され、イベントに channel_index が追加されます。
PBX 等で通話の両レッグが提供されるなら、私は常に分離チャンネルを使います。電話音声セクションの話者分離と異なり、既知の分割は話者を推定しません。
完成版クライアントは一組の設定を公開し、REST フォームまたは WebSocket URL を個別に組み立てます。共通設定は話者分離、キーターム、フィラー、音声エンコーディング、ターン処理をカバーし、整形は前述のトランスポート固有の規則に従います。
最終設定を電話品質の録音に適用し、製品名の綴り、言語切り替え、連絡先、話者ラベルを個別に確認します。制御フィクスチャではテキストのチェックは通過し、話者ラベルは1箇所レビューが必要でした。後の比較で同じセットアップを使えるよう、各転記に設定と話者マッピングを保存してください。
サポート転記チュートリアルはこの最終チェックで終了です。リポジトリには、生成応答、音声出力、割り込み、エコー処理を備えた別の音声エージェント拡張も含まれています。
Transcribe はそのデモでも役割は同じで、テキストを生成します。応答は言語モデルが作成し、Grok TTS が読み上げます。
DataCamp で AI を学ぼう!
トラック
トラック
コース