
Program
Geliştiriciler için Yardımcı Yapay Zeka Mühendisi
26 sa
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0), SpaceXAI’nin konuşmadan-yazıya modelidir. REST yolu bitmiş bir dosyayı yazıya dökerken, WebSocket yolu canlı sesi işler.
SpaceXAI’nin Grok Voice Transcribe 2.0 duyurusu, telefon çağrılarını, birden çok konuşmacıyı, kimlik bilgilerini ve çok dilli konuşmayı vurgular. Kıyaslamalar için bkz. Grok Voice Transcribe 2.0 genel bakışımız.
Kontrollü Qivora Sync düzeni sabit kalırken ses ve API ayarları değişir. Çağrıda uydurma bir ürün adı, dolgu sözcükleri, dil geçişi, sözlü iletişim bilgileri, dikte sırasında bir duraklama ve üçüncü bir konuşmacı bulunur.
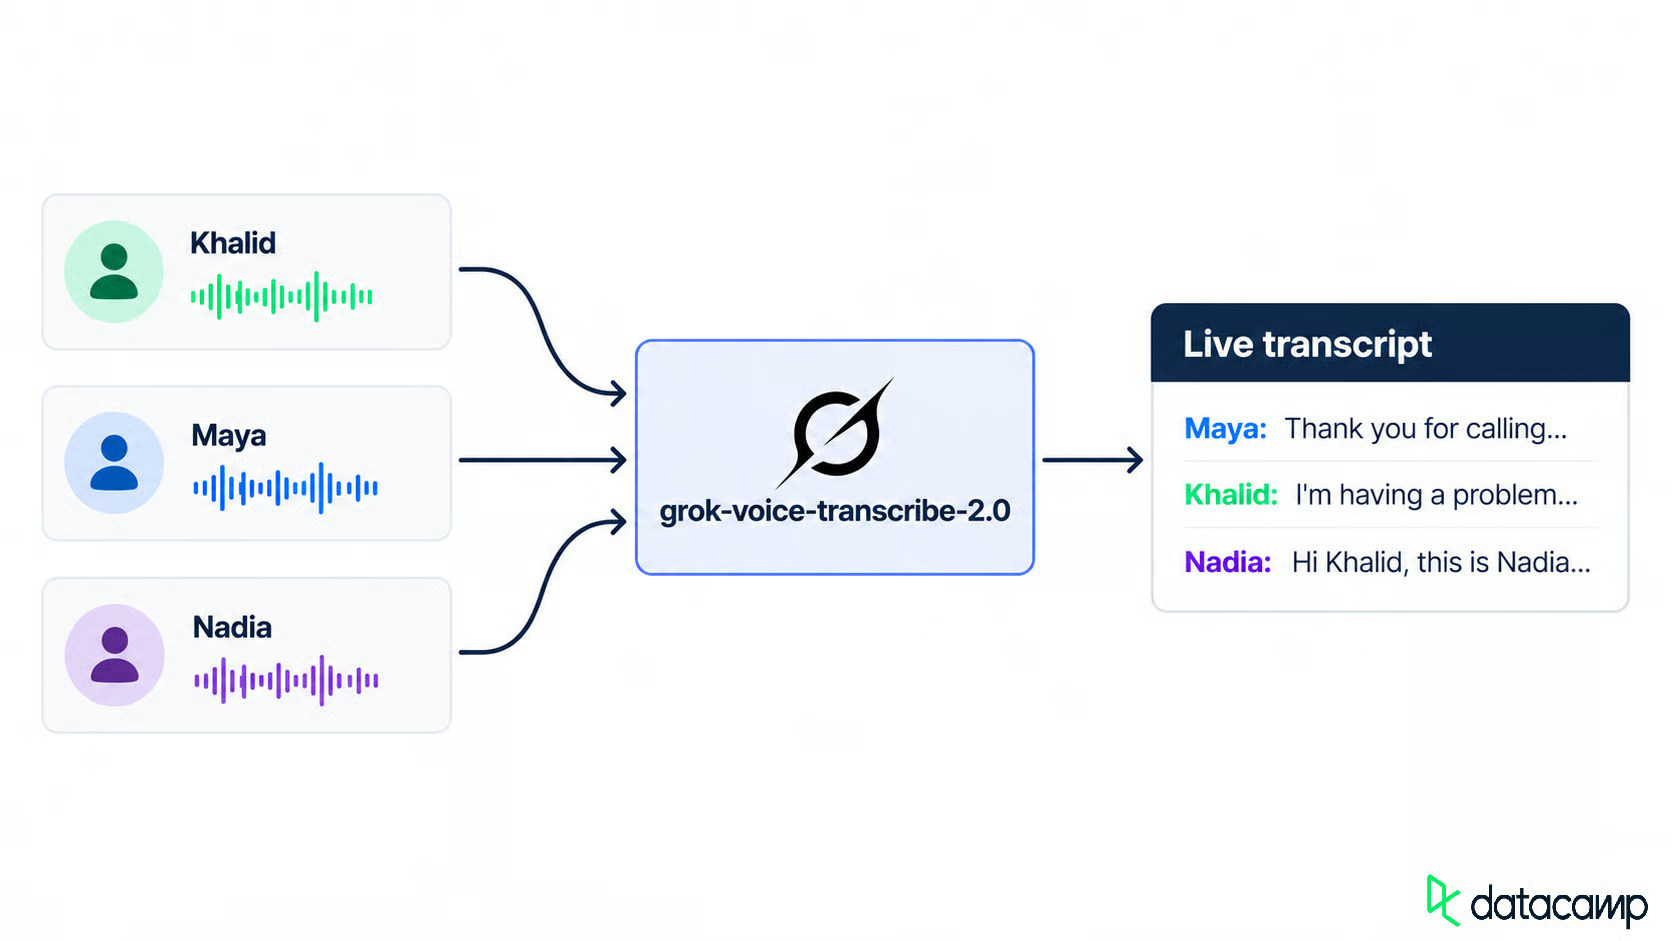
Üç konuşmacı tek bir canlı döküme dönüşür. Görsel: Yazar.
Kontrollü düzen, Grok Metinden Konuşmaya API’sinden üç farklı sesi kullanır. Her dil bölümü ayrı ayrı sentezlenir ve anahtar geçiş noktaları sabit kalacak şekilde ffmpeg ile birleştirilir. API ayrıca language=auto’yu kabul eder; ayrı istekler bir API gerekliliği değil, deney tasarımı tercihidir.
İlk istekten önce beklenen metni, konuşmacıları, ürün yazımını, müşteri bilgilerini, dolgu sözcüklerini ve duraklamaları tanımlayın. Böylece her kurulum aynı hedefe sahip olur.
Sesi göndermeden önce bağımlılıkları kurun.
Python 3.10 veya daha yenisi, bir xAI API anahtarı ve sesi oluşturmak için ffmpeg gerekir. Python istemcileri requests, websockets ve python-dotenv kullanır.
Konuşmadan Yazıya dokümanları, model alanını atladığınızda 2.0’ı varsayılan kabul eder ve grok-voice-transcribe-1.0’ın 2 Ekim 2026’da kullanım ömrünü tamamladığını belirtir. Yine de sürümlü kimliği sabitlemeyi öneririm.
Depoyu klonlayın, anahtarınızı .env’ye ekleyin ve örnek sesi oluşturun:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
Kurulum komutu, ileride kullanılacak diyaloğu ve ses dosyalarını oluşturur. Kendi kaydınız varsa bu komutu atlayın.
Windows’ta yazılmış bir .env anahtar üzerinde \r bırakabilir ve requests başlık daha SpaceXAI’ye ulaşmadan reddedilir. Anahtarınızı yetkilendirme başlığına eklemeden önce kırpın.
Temel düzey, modelin hiçbir özelliği açık değilken verdiği çıktıdır; böylece sonraki her değişikliğin karşılaştırabileceği bir referans olur. İlk istek, dosyayı ve sabitlenmiş modeli gönderir:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
Yanıt; text, algılanan language, duration ve zamanlanmış words dizisini taşır. REST referansı kelime başına confidence alanını gösterir; ancak bu düzen için toplu yanıtlarda görünmedi. Alanı isteğe bağlı kabul eder ve kullanmadan önce her API yanıtını kontrol ederdim. Opsiyon alanlarını file’dan önce verin; sonraki alanlar yoksayılabilir.
Temel düzey dolgu sözcüklerini attı, Arapçayı Arap yazısıyla tuttu ve söylenen rakamları ayrı bıraktı. Uydurma ürün adını tutarlı şekilde yanlış yazdı.
Bir destek dökümü; konuşmacı etiketlerine, doğru ürün yazımına ve kullanılabilir müşteri bilgilerine ihtiyaç duyar. Her ayar bir form alanıdır:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
Aynı ses üzerinde her seferinde bir seçeneği ekleyin. Konuşmacı etiketleriyle başlayın.
Konuşmacı diyalog ayrıştırma, kelimelere isim değil sayısal konuşmacı kimlikleri verir. Turları oluşturmak için aynı kimliğe sahip ardışık kelimeleri gruplayın:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Temiz seste, bilinen her tur tutarlı bir konuşmacı kimliğiyle kaldı. İsimleri ilk görünüme göre eşlemek, yalnızca çağrı sırası zaten biliniyorsa işe yarar; üretim sistemlerinin kendi konuşmacı eşlemesi gerekir.
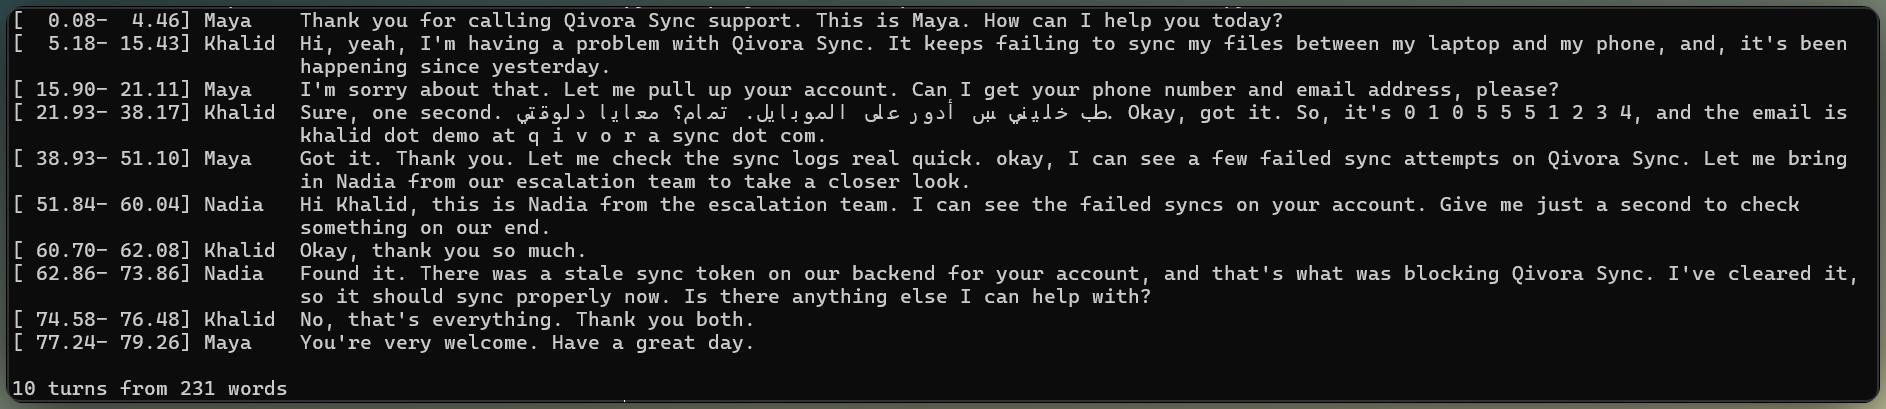
Temiz ses, konuşmacı etiketlerini tutarlı tutar. Görsel: Yazar.
Anahtar terim önyargısı eğitim değil, istek başına bir ipucudur. keyterm=Qivora Sync (en fazla 100 terim, her biri 50 karakter) geçin; ses desteklediğinde model o yazıma meyleder.
Anahtar terim, temel düzeydeki ürün adı hatasını çevredeki dökümü değiştirmeden düzeltti.
Ayrı bir canlı konuşmacı kontrolünde, güçlü biçimde önyargılı sözlük zayıf bir yankıyı anahtar terime doğru çekti. Bu, anahtar terimlerin kendi başına sahte metin ürettiği anlamına gelmez; belirsiz sesin yine de yankı kontrolüne ihtiyaç duyduğu anlamına gelir.
Temel düzeyin gösterdiği üzere, Khalid’in Arapçası Arap harfleriyle kaldı. Otomatik algılamada da language=en ile de sonuç aynıydı; çünkü language bir çıktı dili dayatmak yerine biçimlendirme kurallarını seçer.
Temel düzey, söylenen rakamları ayrı tuttu. Ters Metin Normalleştirme (ITN), bu sözlü biçimleri yazılı biçimlere çevirir. format=true ITN’i açar ve language gerektirir; aksi halde istek 400 ile başarısız olur.
Telefon numarası tek bir kesintisiz rakam dizisine dönüştü. E-posta yalnızca kısmen normalleşti: noktalama düzeldi, ancak söylenen “at” ve hecelenen alan adı hâlâ temizlik gerektirdi.
Bu dengesiz sonuç can sıkıcıdır. ITN metni biçimlendirir; iletişim verilerini doğrulamaz. Her iki alanı da depolamadan önce doğrulardım.
ITN ayrıca sıradan süre ifadelerini kısaltılmış niceliklere dönüştürebilir. Bu düzen için biçimlendirilmiş toplu yanıtta yalnızca üst düzey text normalleştirildi; words dizisi sözlü biçimi korudu.
Temel düzeyin gösterdiği gibi, dolgu sözcükleri varsayılan olarak text ve words’tan çıkarılır. filler_words=true, Khalid’in “ıı” ve “ım”larını beklendiği gibi geri getirdi. Destek notları için kapalı, bire bir QA kaydı için açık tutun.
Toplu çıktı; konuşmacılar, söz varlığı, biçimlendirme ve dolgu sözcüğü kontrolünü içerir. Sırada aynı sesi canlı akış olarak göndermek var.
Yayın yolu bir kurulum mesajı yerine sorgu parametreleri kullanır. transcript.created’ı bekleyin, ham ikili sesi (base64 değil) gönderin ve {"type": "audio.done"} ile kapatın. GPT Live Transcribe eğitimimiz aynı deseni başka bir modelle kullanır.
Önce olaylarla başlayın, sonra istemciyi bağlayın.
Toplu isteklerde belgelenen format=true, language=en ile birlikte kullanılır. Yayın belgeleri, language parametresinin ITN’i açtığını söyler, ancak canlı bir denemede yalnızca language=en dökümü değiştirmedi. WebSocket sorgu listesi format’ı içermediğinden, bu eğitimde akış ITN’i, güvenmek yerine doğrulanacak bir davranış olarak ele alınır.
Her yazıya döküm güncellemesi iki mantıksal değer taşıyan bir transcript.partial olayıdır. Ara metin hâlâ değişebilir. Bir parça finali (is_final=true), tur açık kalırken yaklaşık 3 saniyelik metni kilitler; bir söyleyiş finali (speech_final=true) ise turu kapatır.
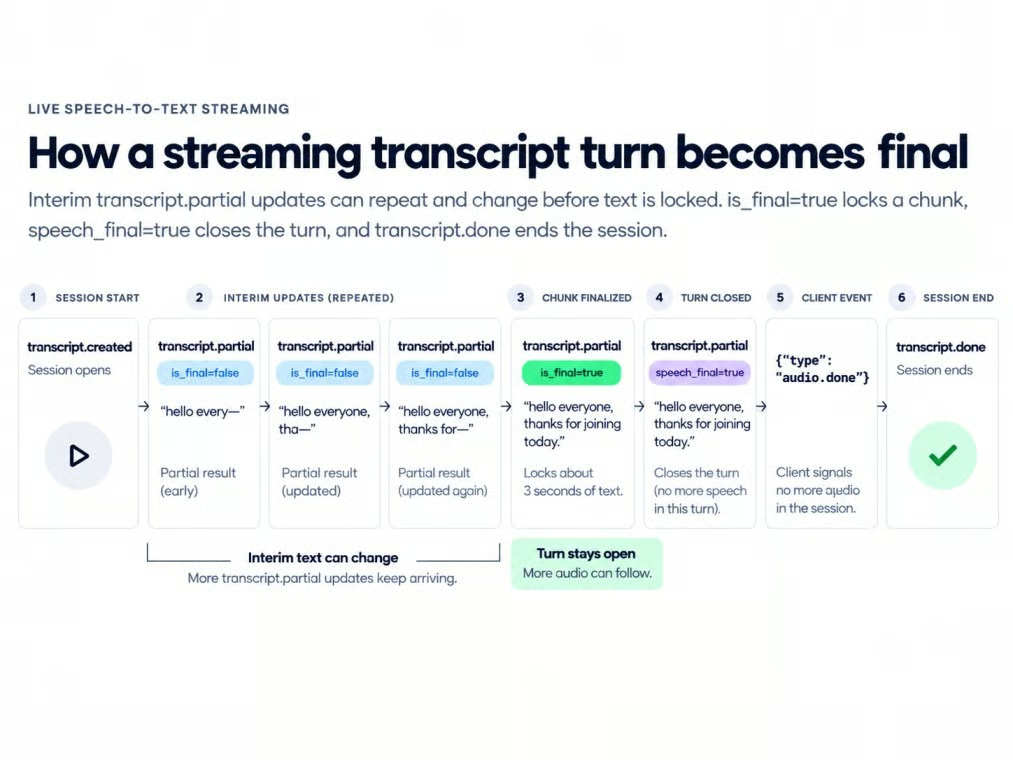
Akış durumları metni nihayete taşır. Görsel: Yazar.
Yayın için, önce kaynağı mono 16 bit PCM 16 kHz’e yeniden örnekleyin. Çekirdek istemci, gerçek zamanlı tempoda 100 milisaniyelik parçalar gönderirken başka bir görev döküm olaylarını alır:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Ara metin yaklaşık her yarım saniyede bir büyüdü. Bu yerel bir ölçümdür, resmi gecikme değildir.
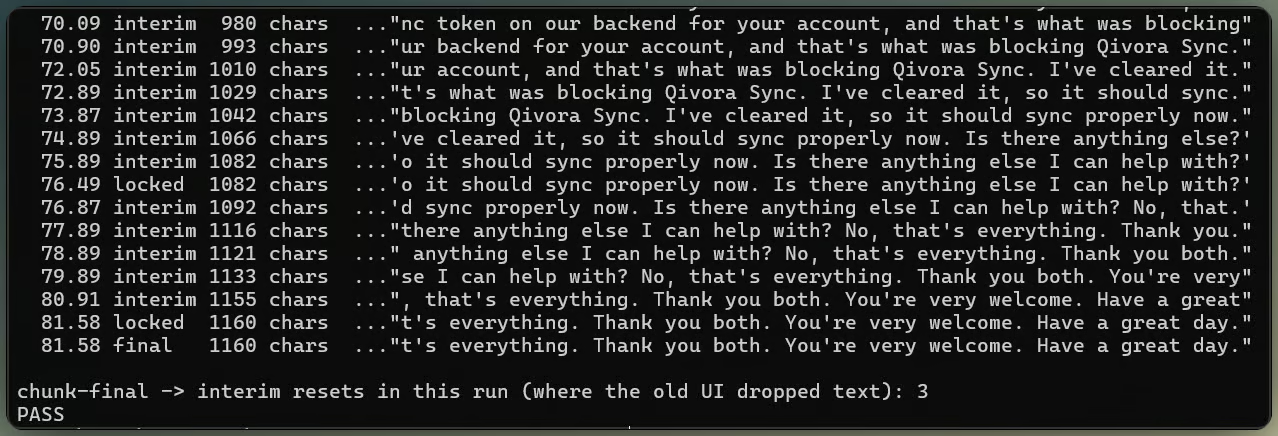
Kısmi alt yazılar final döküme oturur. Görsel: Yazar.
Parça finalleri, turu kapatmadan metni dondurur. Smart Turn, speech_final’ın ne zaman kapatacağını kontrol eder.
Yalnızca etkin olayı göstermek, her parçanın finalinden sonra önceki kelimeleri siler; çünkü sonraki ara döküm, gelen sesten baştan başlar.
Kilitlenen her parçayı tutun, mevcut ara metni ekleyin ve söyleyiş finaline ikisini de değiştirmesine izin verin.
Metin, önceki parçaları kaybetmeden büyüyebilir. Görüntüleme durumu ele alındığında, kalan yayın sorunu tur sınırlarıdır.
Smart Turn, her sessizliği değerlendirir ve konuşmacının bitirip bitirmediğini tahmin eder. Khalid’in numarası için vardır: “sıfır bir sıfır, beş beş beş, [duraklama], bir iki üç dört”; burada yalnızca sessizlik bir düşünme molasıyla sonu ayırt edemez.
Eşik, yazıya döküm güveni veya VAD eşiği değildir. Bir sessizliğin speech_final’ı tetiklemesi için aşması gereken tur-sonu olasılığıdır; altında kalırsa tur açık kalır. İki sorgu parametresi bunu ayarlar:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
Dokümanlar 0.5’i dengeli, 0.7’yi sayı dizileri için temkinli, 0.9’u ise çok temkinli olarak niteler. Bu düzende, varsayılan endpointing penceresinden kısa duraklamalar, faydalı bir Smart Turn kararı üretmedi. Bu bir gözlem sonucudur, belgelenmiş bir zamanlama kuralı değildir.
Yayın testinde, ses çerçevelerini durdurmak gözlenen sessizlik sayacını ilerletmedi. Dijital sessizlik göndermeye devam etmek, Smart Turn’ün söyleyişi kapatmasına izin verir.
Numara diktesi sırasında duraklamayı uzatmak davranışı görünür kılar. Kısa duraklamalar tek bir turun içinde kalır; uzun bir duraklama ise güven tüm ayarları aştığında her eşiği aşarak bölünür.
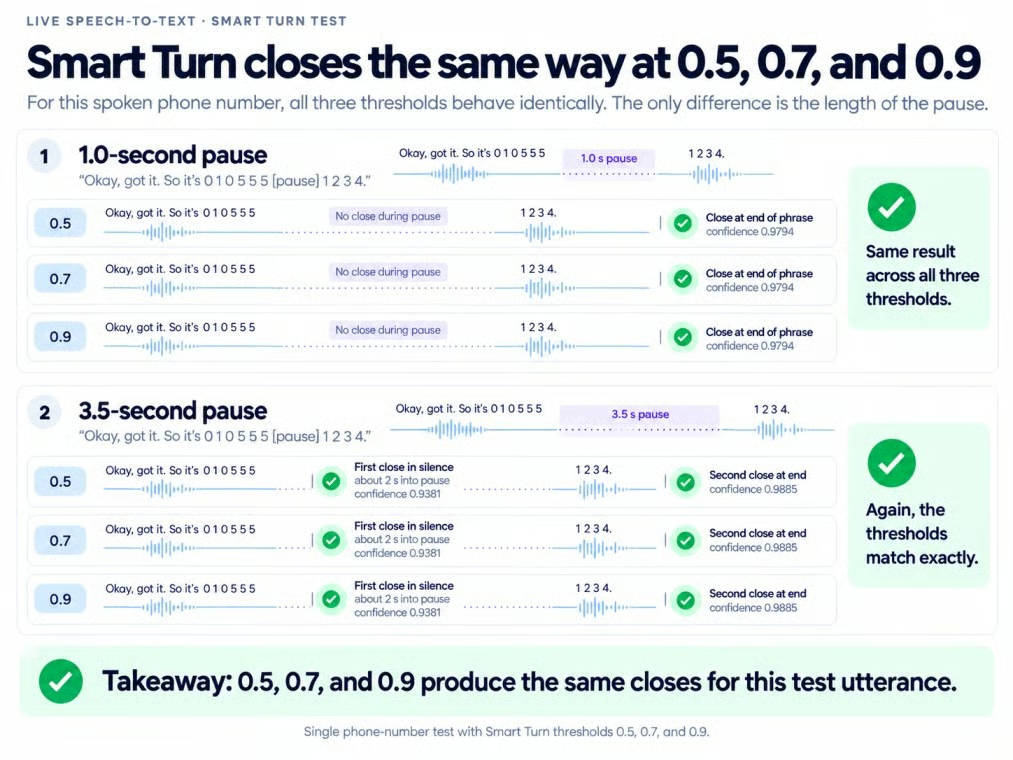
Uzun duraklamalar numara diktesini bölebilir. Görsel: Yazar.
İnsan arayanlar daha az öngörülebilirdir. Kısa bir rakam dizisi bitmiş gibi görünebilir. Sonra arayan devam eder.
Smart Turn numara diktesi sırasında kapatırsa, yanıtlamadan önce kısaca bekleyin ve bir devamı birleştirin.
smart_turn_timeout Smart Turn emin olmasa da sabit bir sessizlikten sonra turu kapatır. Hızlı üç konuşmacılı akışta, Smart Turn bilinen birkaç turu zaman aşımı zorlamasıyla kapatılana kadar bir araya getirdi.
Turların nerede bittiğini zaten biliyorsanız, her sınırda {"type": "finalize"} gönderin; aksi halde Smart Turn’ü bir zaman aşımıyla eşleştirin.
Tur sınırları kontrol altına alındıktan sonra, aynı arayan 8 kHz hattan da geçmek zorunda.
Buradaki telefon kalitesi 8 kHz G.711 mu-law’dır ve aynı çağrıdan üretilir:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawHam telefon sesinin bir konteyneri yoktur; bu yüzden toplu formda audio_format=mulaw ve sample_rate=8000 ayarlayın veya sokette encoding=mulaw&sample_rate=8000 kullanın. Metni ve konuşmacı etiketlerini ayrı ayrı kontrol edin.
Önceki anahtar terim, biçimlendirme ve dil geçişi bulguları 8 kHz’te çok az değişti.
Konuşmacı etiketleri daha az güvenilir hale geldi. Telefon sürümü fazladan bir konuşmacı kimliği tanıttı ve kapanış turunu yanlış kişiye atadı. Yalnızca segmentleri saymak her iki hatayı da gizler.
Dalgalı sürüm, çağrıyı 300-3400 Hz ile bant sınırlar, 8 kHz mu-law olarak kodlar ve her 20 milisaniyelik paketi 0.03 olasılıkla düşürür. 7 sabit bir rastgele tohum, her yeniden çalmada aynı boşlukları korur.
Bu paket kaybı, bu örnekte İngilizce dökümü pek değiştirmedi ve sözlü iletişim bilgileri sırayı korudu. Bu sonuç yalnızca bu örnek için geçerlidir.
Telefon simülasyonu sesi daraltır, paketleri düşürür. Görsel: Yazar.
Ses etkinliği algılama (VAD), sesin konuşma olup olmadığını belirler. Dokümanlar, gürültüden kaynaklı uydurma metin riskiyle birlikte, kısık telefon konuşması için vad_threshold’u düşürmeyi önerir.
vad_threshold’u düşürmek, temiz telefon sesinde hiçbir şeyi değiştirmedi; çünkü kurtarılacak kısık konuşma yoktu. Bu boş sonuç, şu kuralı destekler: eşiği yalnızca telefon konuşması kaybolduğunda düşürün.
diarize olmadan yeni bir toplu form kullanın:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API, kanal sayısını bir WAV veya başka bir kaptan algılar. Ham çok kanallı ses için ("channels", "3") ekleyin; WebSocket çok kanallı girdi de açık bir kanal sayısı ister.
Formu çok kanallı dosyayla, daha önce gösterilen REST isteği üzerinden gönderin, ardından result["channels"]’ı okuyun. Her öğe bir indeks, döküm metni ve zamanlı kelimeler içerir. Kontrollü üç kanallı düzende, her kanalda yalnızca kendisine atanmış konuşmacı vardı. Yayın, aynı bölmeyi kullanır ve olaylarına channel_index ekler.
Telefon sistemi ayrı bacaklar sağladığında her zaman onları kullanırdım. Telefon sesi bölümündeki diyalog ayrıştırmanın aksine, bilinen bir bölme konuşmacıları çıkarım yapmaz.
Tam istemci, tek bir ayar grubunu ortaya çıkarır ve ardından REST formunu veya WebSocket URL’sini ayrı ayrı oluşturur. Paylaşılan ayarlar; diyalog ayrıştırma, anahtar terimler, dolgu sözcükleri, ses kodlaması ve tur işlemesini kapsar; biçimlendirme ise önceki bölümde ele alınan iletim-özel kuralları izler.
Nihai ayarları telefon kalitesinde bir kayda uygulayın, ardından ürün yazımını, dil geçişlerini, iletişim bilgilerini ve konuşmacı etiketlerini ayrı ayrı kontrol edin. Kontrollü düzende, metin kontrolleri geçti; ancak bir konuşmacı etiketi hâlâ inceleme gerektirdi. Daha sonra yapılacak karşılaştırmalar aynı kurulumla gerçekleştirilebilsin diye, her dökümle birlikte ayarları ve konuşmacı eşlemeyi kaydedin.
Destek-yazıya-döküm eğitimi, bu son kontrolle biter. Depoda ayrıca, üretilmiş yanıtlar, sesli çıktı, kesintiler ve yankı işleme içeren ayrı bir sesli ajan uzantısı bulunur.
Transcribe bu demoda aynı rolü korur: metin üretir. Bir dil modeli yanıtları yazar ve Grok TTS onları seslendirir.
DataCamp ile AI Öğrenin!
Program
Program
Kurs